Hinweis des Autors: Dieser Artikel erklärt drei Auslösezeitpunkte für die automatische Komprimierung des Agent-Kontexts, Strategien für Zusammenfassungen und ausführbaren Code. So lässt sich der Token-Verbrauch in langen Gesprächen begrenzen, ohne wichtige Informationen zur Aufgabe zu verlieren.
Wer mehrere Stunden am Stück mit einem Coding-Agent wie Codex arbeitet, stellt sich irgendwann dieselbe Frage: Am Eingabefeld werden nur der Berechtigungsmodus und das aktuelle Modell angezeigt, aber nicht, wie viel Kontext bereits belegt ist. Wann sollte man also ein neues Fenster öffnen? Je länger das Gespräch dauert, desto mehr Verlauf muss bei jeder Anfrage mitgeschickt werden – und desto schneller ist das Nutzungskontingent aufgebraucht. In diesem Artikel geht es um Auslösezeitpunkte und Zusammenfassungsstrategien für die automatische Komprimierung des Agent-Kontexts (Context Compaction). Sie erfahren, wie diese Funktion in Tools wie Codex funktioniert und wie Sie sie in Ihrem eigenen Agent implementieren.
Dies ist kein weiterer allgemeiner Ratschlag nach dem Motto „Chatverlauf regelmäßig aufräumen“, sondern ein praktischer Ansatz, der auf den öffentlich dokumentierten Komprimierungsmechanismen von OpenAI und Anthropic sowie auf praktischen Erfahrungen aus der Softwareentwicklung basiert.
Das nehmen Sie mit: Nach der Lektüre wissen Sie, wann die automatische Kontextkomprimierung eines Agent auslöst, was in einer Zusammenfassung erhalten bleiben sollte und was wegfallen kann. Dazu erhalten Sie eine Python-Implementierung, die Sie direkt anpassen und verwenden können.
Das Wichtigste zur automatischen Komprimierung des Agent-Kontexts
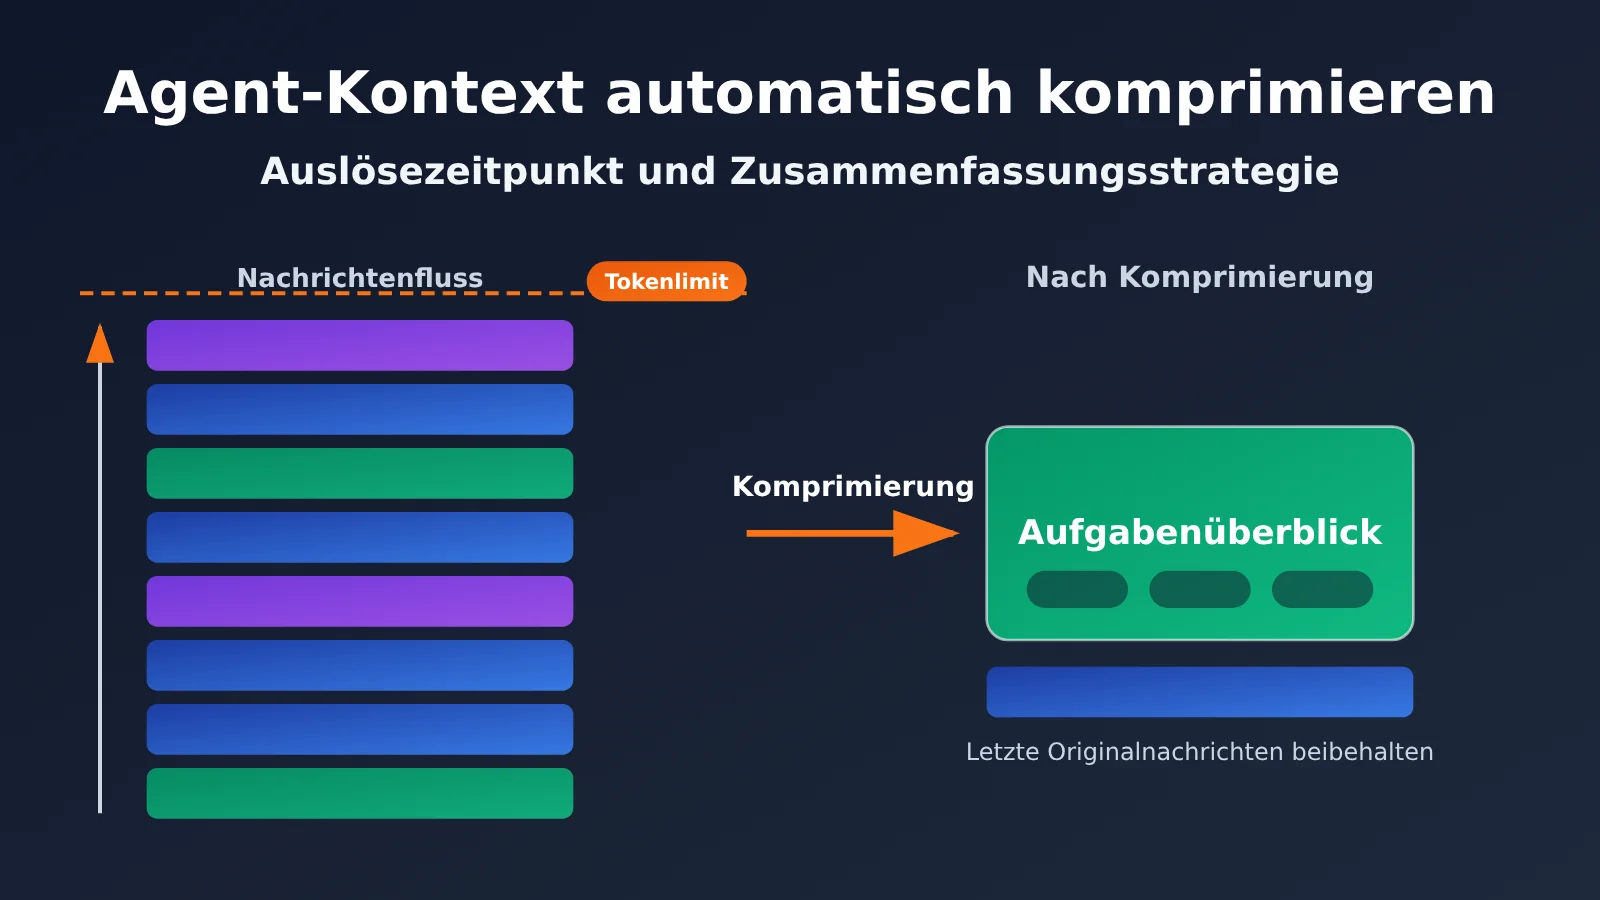
Das Wichtigste vorweg: Die automatische Kontextkomprimierung wird in der Regel ausgelöst, wenn der Kontext einen festgelegten Token-Schwellenwert erreicht. Ältere Gesprächsverläufe und Tool-Aufrufe werden dabei zu einer Zustandsbeschreibung zusammengefasst, mit der der Agent weiterarbeiten kann. Ziel ist nicht bloß ein kürzerer Chatverlauf: Aufgabenfortschritt, wichtige Fakten, ausgeführte Aktionen, zentrale Entscheidungen und nächste Schritte sollen erhalten bleiben, während überflüssige Prozessdetails entfallen.
| Aspekt | Erklärung | Vorteil |
|---|---|---|
| Auslösung durch Token-Schwellenwert | Der Kontext wird automatisch komprimiert, sobald eine festgelegte Token-Zahl erreicht ist | Kein manueller Eingriff nötig; verhindert ein Überlaufen des Kontextfensters |
| Proaktive Komprimierung | Die Anwendung stößt die Komprimierung zu einem bestimmten Zeitpunkt an, etwa nach Abschluss einer Aufgabenphase | Komprimierung an einer inhaltlich sinnvollen Grenze mit möglichst geringem Informationsverlust |
| Automatische Verwaltung durch das Framework | Das SDK oder die Agent-Runtime entscheidet anhand der Kontextauslastung | Sofort einsatzbereit und für einen schnellen Einstieg geeignet |
| Zusammenfassung statt Abschneiden | Fortschritt, Fakten, Entscheidungen und nächste Schritte bleiben erhalten | Der Agent kann nach der Komprimierung weiterarbeiten |
| Komprimierung nach Phasen | Eine Komprimierung nach jeder Runde ist nicht empfehlenswert | Berücksichtigt sowohl Cache-Treffer als auch die Vollständigkeit der Informationen |
Warum Agents eine automatische Kontextkomprimierung brauchen
APIs für Große Sprachmodelle sind grundsätzlich zustandslos. Bei einer „Unterhaltung über mehrere Runden“ wird daher bei jeder Anfrage der vollständige messages-Verlauf erneut an das Modell gesendet. Die Anfrage in Runde 50 enthält also den gesamten Inhalt der vorherigen 49 Runden. Die Zahl der Eingabe-Tokens wächst dadurch linear oder sogar noch schneller. Bei Agents verschärft sich das Problem, weil die Ergebnisse von Tool-Aufrufen – etwa Dateiinhalte, Terminalausgaben oder Suchergebnisse – oft sehr lang sind. Schon wenige Tool-Aufrufe können einen Großteil des Kontextfensters füllen.
Das bringt zwei unmittelbare Probleme mit sich: Erstens steigen die Kosten, denn je mehr Eingabe-Tokens jede Runde enthält, desto schneller wird das Kontingent verbraucht. Zweitens leidet die Qualität: Bei einem sehr langen Kontext kann das Modell frühere wichtige Informationen weniger stark berücksichtigen. Wird das Kontextfenster überschritten, kommt es sogar zu einem Fehler. Die automatische Kontextkomprimierung schafft hier einen Ausgleich: Solange die Informationen noch vollständig sind und das Fenster noch nicht voll ist, wird der Verlauf zu einer kompakten Zustandsbeschreibung verdichtet. So können die nächsten Anfragen mit weniger Ballast weiterlaufen.
Warum Codex die Kontextauslastung nicht anzeigt
Warum der Client die Größe des Kontextfensters nicht mehr anzeigt, ist unseres Wissens nach nicht offiziell erklärt worden. Wir verzichten deshalb auf Spekulationen. Fest steht: Codex verfügt über eine eigene Kontextkomprimierung. Bei langen Unterhaltungen wird also nicht unbegrenzt der gesamte ursprüngliche Verlauf angesammelt. Wer den Verbrauch jeder Runde genau beobachten möchte, schaut am besten in die Aufrufprotokolle auf API-Ebene. Wie das geht, erklären wir später.
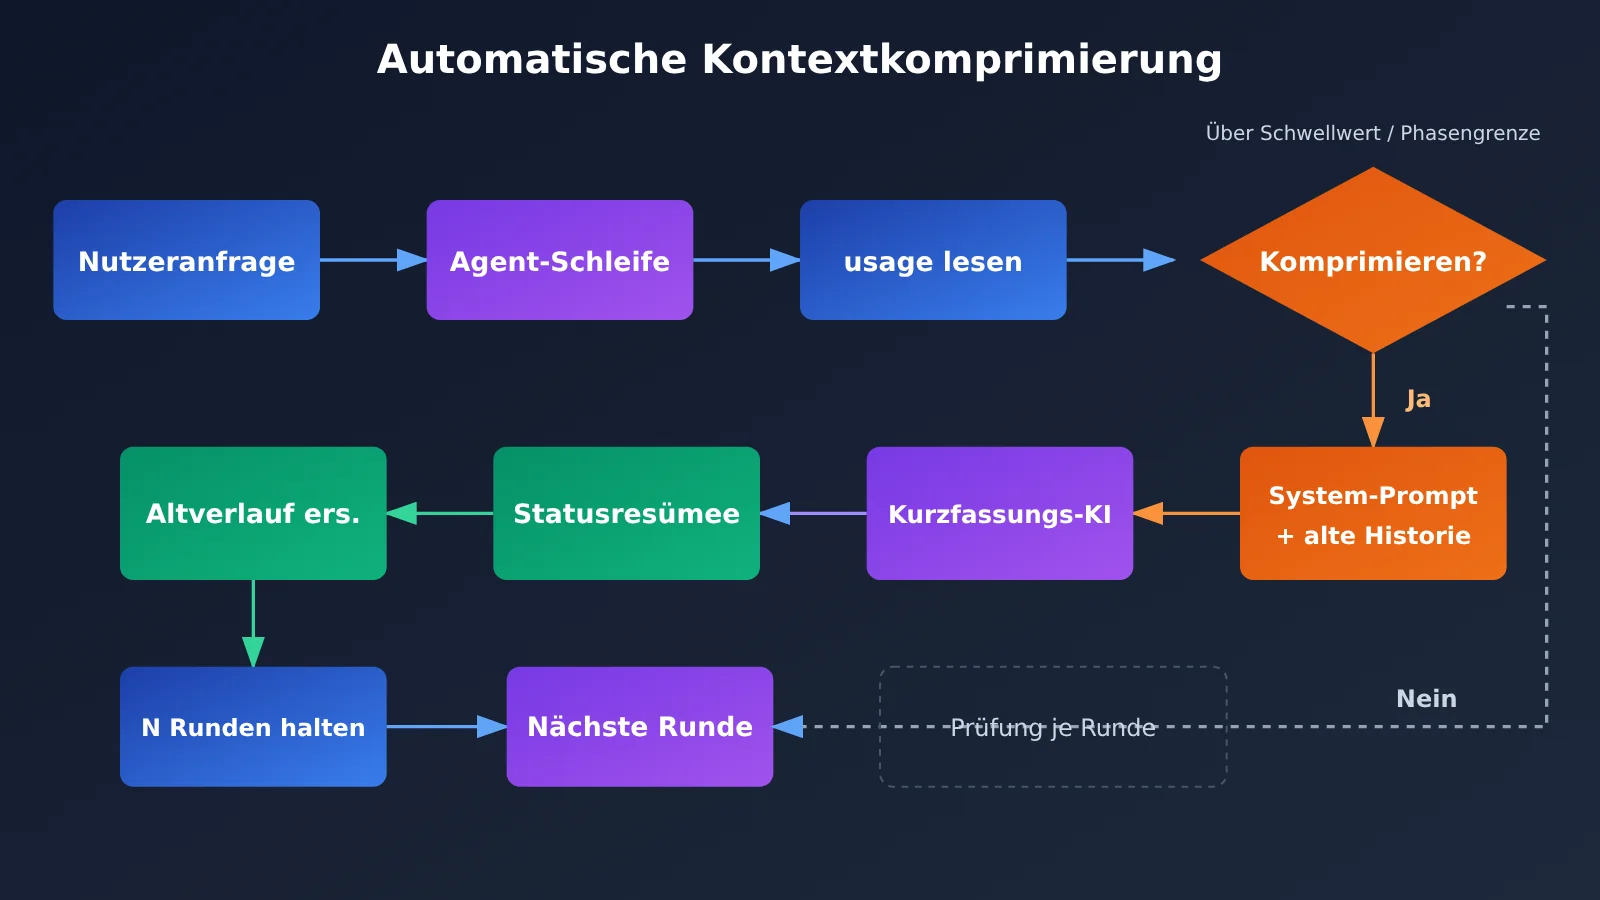
Drei Auslöser für die automatische Komprimierung des Agent-Kontexts
Oft wird angenommen: „Sobald das Kontextfenster zu 80 % gefüllt ist, wird komprimiert.“ Das ist aber keine offizielle Regel. Die API-Dokumentation definiert die Auslöser hauptsächlich über Token-Schwellenwerte, nicht über einen festen Prozentsatz des Kontextfensters. Außerdem muss die Komprimierung nicht bis kurz vor das Limit warten: OpenAI und Anthropic unterstützen beide eine frühzeitige, gezielt ausgelöste Komprimierung.
Auslöseregeln der offiziellen Implementierungen im Vergleich
| Implementierung | Automatische Auslöseregel | Offizielle Angaben |
|---|---|---|
| OpenAI Responses API | Die Anzahl der Token nach der Aufbereitung erreicht compact_threshold |
Schwellenwert ist konfigurierbar, Verarbeitung erfolgt automatisch auf dem Server |
| OpenAI Agents SDK | Kontextauslastung oder eine explizite Schwellenwertstrategie | Unterstützt automatische, schwellenwertbasierte und erzwungene Komprimierung |
| Anthropic Messages API | Die Anzahl der Eingabe-Token erreicht trigger.value |
Standard: 150.000, Minimum: 50.000 |
| Anthropic Tool Runner | context_token_threshold wird erreicht |
Standard: 100.000 |
| Anthropic-Komprimierung auf Abruf | Wird aktiv von der Anwendung ausgelöst | Kann nach Abschluss eines vollständigen Gesprächszugs aufgerufen werden |
Die Tabelle zeigt eine Gemeinsamkeit: Fast alle automatischen Auslöser orientieren sich an der Anzahl der Eingabe-Token, und die Schwellenwerte sind konfigurierbar. Gleichzeitig bieten alle Ansätze die Möglichkeit, dass die Anwendung den Zeitpunkt der Komprimierung selbst bestimmt.
Zeitpunkt 1: Auslösung durch einen Token-Schwellenwert
Das ist der einfachste Absicherungsmechanismus. Nach jedem Modellaufruf liest du die von der Schnittstelle zurückgegebene Anzahl der Eingabe-Token aus. Sobald sie den festgelegten Schwellenwert überschreitet, wird komprimiert. Der Schwellenwert sollte nicht zu nah am Limit des Kontextfensters liegen: Für die Komprimierung muss der bisherige Verlauf erneut an das Modell zur Zusammenfassung gesendet werden. Außerdem braucht die nächste Runde noch Platz für Tool-Ausgaben.
In der Praxis kannst du dich an Anthropics Standardwerten orientieren: Setze den Schwellenwert bei Modellen mit großem Kontextfenster in der Größenordnung von hunderttausend Token an. Achte darauf, dass oberhalb des Schwellenwerts noch genug Platz für die vollständige Rückgabe eines Tool-Aufrufs bleibt.
Zeitpunkt 2: Gezielte Komprimierung nach einer Aufgabenphase
Bei diesem Ansatz gehen am wenigsten Informationen verloren. OpenAI empfiehlt, erst nach Abschluss einer sinnvollen Arbeitsphase zu komprimieren statt nach jeder Runde. Hat ein Agent zum Beispiel gerade den gesamten Ablauf „Bug lokalisieren → Code ändern → Tests erfolgreich ausführen“ abgeschlossen, sind die zwischenzeitlichen Versuche nicht mehr relevant. Merken muss er sich nur noch, welche Datei er geändert hat, warum und dass die Tests bestanden wurden.
An solchen Phasengrenzen lässt sich leichter eine genaue Zusammenfassung erstellen: Die Aufgabe befindet sich in einem „sauberen“ Zustand, und es gibt keine halbfertigen Tool-Aufrufe.
Zeitpunkt 3: Das Framework nach Kontextauslastung entscheiden lassen
Wenn du ein Framework wie das Agents SDK oder den Tool Runner verwendest, kannst du die integrierte Komprimierungsstrategie aktivieren. Die Laufzeitumgebung entscheidet dann anhand der Kontextauslastung automatisch, wann komprimiert wird. Das ist bequem, gibt dir aber weniger Kontrolle über den Inhalt der Zusammenfassung. Der Ansatz eignet sich daher für Prototypen oder allgemeine Anwendungsfälle.
🎯 Technische Empfehlung: Die drei Zeitpunkte schließen sich nicht gegenseitig aus. Empfehlenswert ist eine Kombination: primär gezielt nach Aufgabenphasen komprimieren und einen Token-Schwellenwert als Absicherung setzen. Wenn du prüfen möchtest, ob deine Schwellenwerte für verschiedene Modelle sinnvoll sind, kannst du über APIYI apiyi.com mit demselben API-Schlüssel zwischen OpenAI-, Claude- und Gemini-Modellen wechseln und Vergleichstests durchführen.
Zusammenfassungsstrategie für die automatische Komprimierung des Agent-Kontexts
Der Auslösezeitpunkt bestimmt, wann komprimiert wird. Die Zusammenfassungsstrategie bestimmt, was dabei herauskommt. Ein häufiges Anzeichen für eine fehlgeschlagene Komprimierung: Der Agent vergisst die ursprünglichen Vorgaben des Nutzers oder wiederholt bereits ausgeführte Schritte. Der Grund dafür ist meist, dass die Zusammenfassung nur festhält, „worüber gesprochen wurde“, nicht aber, „wie der aktuelle Aufgabenstand ist“.
Was in der Zusammenfassung bleiben sollte – und was entfallen kann
| Kategorie | Beibehalten | Kann entfallen |
|---|---|---|
| Aufgabenziel | Ursprüngliche Nutzeranforderung, verbindliche Vorgaben, Abnahmekriterien | Begrüßungen, wiederholte Bestätigungen |
| Aufgabenfortschritt | Abgeschlossene Schritte, aktuelle Phase | Detaillierte Überlegungen zu jedem Schritt |
| Wichtige Fakten | Dateipfade, Funktionsnamen, Konfigurationswerte, entscheidende Fehlerzeilen | Vollständige Dateiinhalte, lange Protokolle |
| Zentrale Entscheidungen | Gewählter Ansatz und Gründe dafür | Ausführliche Diskussion verworfener Ansätze |
| Nächste Schritte | Aufgabenliste, offene Fragen | Abgeschlossene Details ohne weitere Auswirkungen |
Zusammenfassungsstrategie in 5 Schritten umsetzen
- System-Eingabeaufforderung immer beibehalten: Die System-Eingabeaufforderung wird nicht komprimiert und steht in
messagesimmer an erster Stelle. - Die letzten N Gesprächsrunden im Original behalten: Die jüngsten Gesprächsrunden sind meist eng mit der aktuellen Arbeit verknüpft. Sie bleiben unverändert; nur ältere Teile werden komprimiert.
- Strukturierte Zusammenfassungsvorlage nutzen: Das Modell soll seine Zusammenfassung in fünf Abschnitte gliedern: „Ziel / Fortschritt / Fakten / Entscheidungen / Nächste Schritte“. So gehen durch freie Formulierungen weniger Informationen verloren.
- Tool-Ergebnisse vorab kürzen: Bei sehr langen Tool-Ausgaben nur die wichtigsten Ausschnitte behalten, etwa die ersten und letzten Zeilen einer Fehlermeldung oder die Titel und Schlussfolgerungen von Suchergebnissen.
- Nutzervorgaben separat im Wortlaut speichern: Explizite Vorgaben des Nutzers, etwa „Die öffentliche Schnittstelle nicht ändern“, sollten möglichst wortwörtlich erhalten und nicht vom Modell umformuliert werden.
Die strukturierte Vorlage ist dabei der wichtigste Schritt. Bei einer „freien Zusammenfassung“ neigen Modelle dazu, den allgemeinen Gesprächsverlauf zusammenzufassen. Feste Abschnitte halten sie dagegen dazu an, jeden Punkt einzeln zu prüfen und Informationen zum aktuellen Stand zu bewahren, mit denen sich weiterarbeiten lässt.
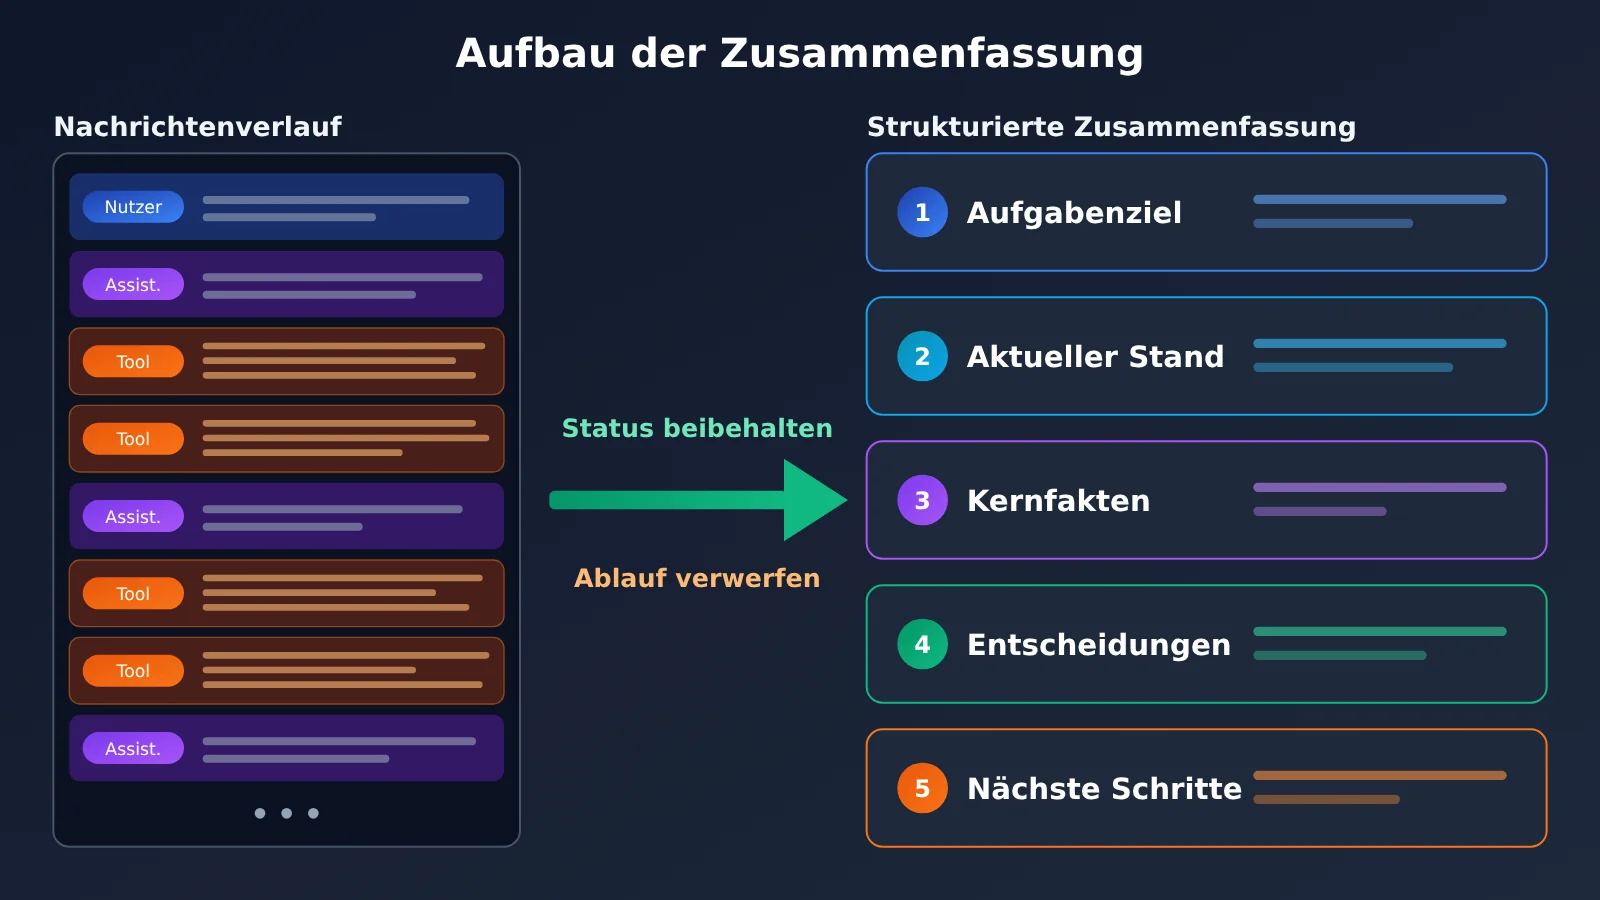
Schnellstart: Automatische Komprimierung des Agent-Kontexts
Im folgenden Beispiel verwaltet der Client messages selbst. Dieser allgemeine Ansatz funktioniert mit jeder OpenAI-kompatiblen Schnittstelle: Nach jedem Aufruf wird die Anzahl der Eingabe-Token aus usage.prompt_tokens ausgelesen. Überschreitet sie einen Schwellenwert, fasst ein Modell den früheren Gesprächsverlauf zusammen.
Minimalbeispiel
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Vollständigen Implementierungscode für die automatische Komprimierung des Agent-Kontexts anzeigen
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Schnellstart: Registrieren Sie sich bei APIYI auf apiyi.com, um kostenloses Testguthaben zu erhalten. Im Code oben müssen Sie nur den API-Schlüssel ersetzen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle. Für das Hauptmodell und das Zusammenfassungsmodell können Sie Modelle unterschiedlicher Anbieter wählen und so die Kosten steuern.
Ansätze zur automatischen Komprimierung des Agent-Kontexts im Vergleich
| Ansatz | Hauptmerkmal | Einsatzszenario | Verfügbare Plattformen |
|---|---|---|---|
| Manuelle clientseitige Komprimierung | messages selbst zusammensetzen, volle Kontrolle über die Zusammenfassungslogik |
Eigene Agents, individuelle Zusammenfassungsvorlagen | APIYI apiyi.com, offizielle APIs verschiedener Anbieter |
| Serverseitige Komprimierung per Schwellenwert | Zum Beispiel compact_threshold der Responses API |
Weniger Zustandsverwaltung auf Clientseite | Plattformen, die diese Schnittstelle unterstützen |
| Integrierte Komprimierung im Framework | Automatische Verwaltung durch Agents SDK oder Tool Runner | Prototypen, allgemeine Aufgaben | Abhängig vom jeweiligen SDK |
| Neue Sitzung beginnen | Manuell zusammenfassen und ein neues Fenster öffnen | Alltägliche Nutzung von Clients wie Codex | Beliebiger Client |
Die manuelle clientseitige Komprimierung bietet die meiste Kontrolle, erfordert aber eine eigene Token-Zählung und Qualitätskontrolle der Zusammenfassungen. Die serverseitige Komprimierung erspart das Zusammensetzen des Gesprächsverlaufs, allerdings bleiben die Details der Zusammenfassung für Entwickler undurchsichtig. Für selbst entwickelte Agents ist eine Kombination aus „strukturierter clientseitiger Zusammenfassung und Schwellenwert als Absicherung“ meist die zuverlässigere Wahl.
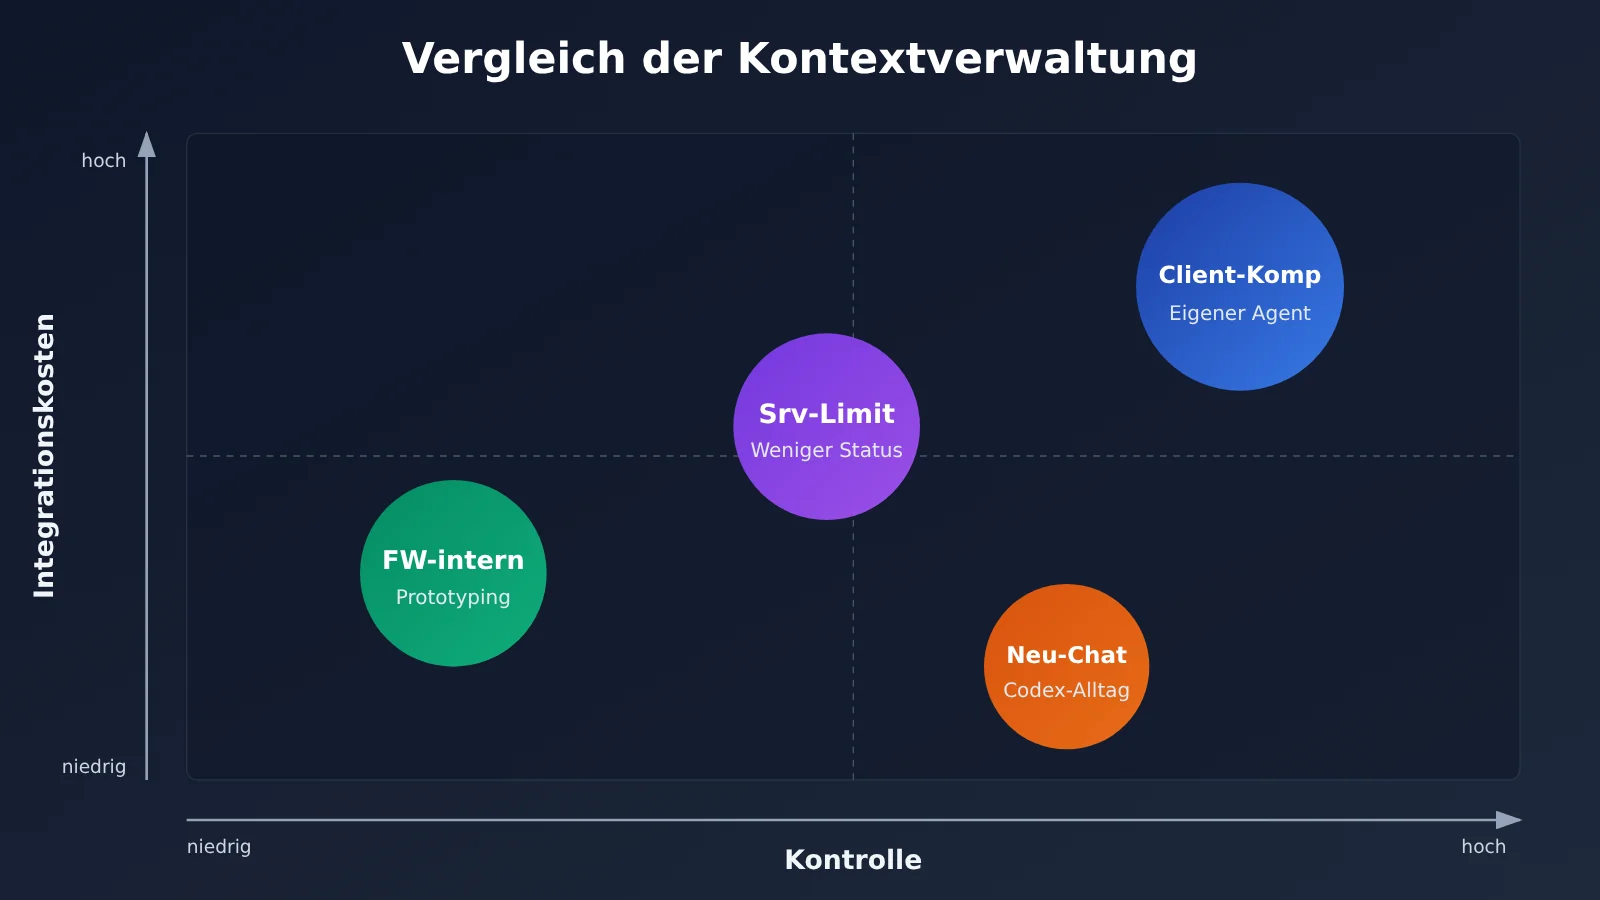
Wie die automatische Komprimierung des Agent-Kontexts die Caching-Kosten beeinflusst
Komprimierung scheint auf den ersten Blick immer Geld zu sparen. Dabei muss man aber auch Prompt Caching berücksichtigen. Laut den Angaben von APIYI zur OpenAI-Cache-Abrechnung werden Eingabe-Token bei einem Cache-Treffer nur mit 10 % des regulären Eingabepreises berechnet. In langen Gesprächen kommt es leicht zu Cache-Treffern, solange der Präfix mit dem Gesprächsverlauf unverändert bleibt. Pro Runde kommen dann nur wenige Token hinzu, für die der volle Preis anfällt.
Bei einer Komprimierung wird der Nachrichtenpräfix jedoch durch eine neue Zusammenfassung ersetzt. Die nächste Anfrage erzielt daher keinen Cache-Treffer und muss einmal vollständig zum regulären Preis verarbeitet werden. Genau deshalb wird offiziell davon abgeraten, „nach jeder Runde zu komprimieren“: Häufiges Komprimieren unterbricht die Cache-Nutzung immer wieder und kann dadurch teurer sein als der Verzicht darauf. Sinnvoller ist es, den Verlauf über eine Phase hinweg wachsen zu lassen und den Cache auszunutzen. Erst am Ende der Phase oder kurz vor Erreichen des Schwellenwerts wird dann einmal komprimiert.
Häufige Fragen (FAQ)
Q1: Was ist die automatische Kontextkomprimierung bei Agents?
Dabei werden frühere Gespräche und Werkzeugaufrufe in einer Zusammenfassung des Aufgabenstands verdichtet, sobald der Kontext eine bestimmte Token-Anzahl erreicht oder eine Aufgabenphase endet. Die Zusammenfassung ersetzt den ursprünglichen Verlauf. So sinkt die Zahl der Eingabe-Token pro Runde, während Fortschritt, Fakten, Entscheidungen und nächste Schritte erhalten bleiben und der Agent weiterarbeiten kann.
Q2: Was ist der Unterschied zwischen Kontextkomprimierung und dem einfachen Abschneiden des Verlaufs?
Beim Abschneiden werden lediglich die ältesten Nachrichten gelöscht. Das ist einfach umzusetzen, kann aber die ursprünglichen Anforderungen und Vorgaben des Nutzers entfernen. Bei der Komprimierung fasst ein Modell den Verlauf strukturiert zusammen, sodass deutlich mehr Informationen erhalten bleiben. Dafür ist ein zusätzlicher Aufruf zur Zusammenfassung nötig, und der Cache muss nach der Komprimierung neu aufgebaut werden.
Q3: Gibt es eine allgemeine Regel, bei 80 % Auslastung zu komprimieren?
Nein. Die offiziellen Dokumentationen definieren die Auslöser hauptsächlich über Schwellenwerte für die Token-Anzahl: etwa standardmäßig 150.000 und mindestens 50.000 bei der Anthropic Messages API oder standardmäßig 100.000 beim Tool Runner. Der Schwellenwert sollte zur Fenstergröße des verwendeten Modells und zum Umfang einzelner Werkzeugausgaben passen.
Q4: Wann sollte ich in Codex ein neues Fenster öffnen?
Am besten nach dem Abschluss einer vollständigen Aufgabenphase, zum Beispiel wenn eine Funktion fertig entwickelt und getestet ist. Vorher kannst du den Agent eine Zusammenfassung nach dem Schema „Ziel / Fortschritt / Fakten / Entscheidungen / nächste Schritte“ erstellen lassen und sie am Anfang der neuen Sitzung einfügen. Auch wenn du zu einem neuen, unabhängigen Thema wechselst, solltest du direkt ein neues Fenster öffnen. So verbraucht der irrelevante Verlauf nicht weiter dein Kontingent.
Q5: Wie kann ich den Token-Verbrauch beobachten, wenn der Client die Kontextauslastung nicht anzeigt?
Du kannst den Verbrauch auf API-Ebene einsehen. Wenn du die Schnittstelle von Codex wie in der Dokumentation zu OpenAI-Codex-Anwendungsfällen beschrieben auf APIYI konfigurierst, hinterlässt jeder Aufruf detaillierte Protokolle und Nutzungsstatistiken im Backend von APIYI auf apiyi.com. So siehst du, wie die Zahl der Eingabe-Token pro Runde in langen Gesprächen steigt, und kannst entscheiden, wann du komprimieren oder eine neue Sitzung starten solltest.
Q6: Wie kann ich schnell prüfen, ob meine Komprimierungsstrategie funktioniert?
Führe dieselbe mehrstufige Aufgabe mit dem vollständigen Code aus diesem Artikel in drei Modi aus: „ohne Komprimierung“, „Komprimierung bei einem Schwellenwert“ und „Komprimierung nach Aufgabenphasen“. Vergleiche anschließend den gesamten Token-Verbrauch und die Qualität des Ergebnisses. Über APIYI auf apiyi.com kannst du mit einem einzigen API-Schlüssel für das Hauptmodell und das Zusammenfassungsmodell Modelle verschiedener Anbieter nutzen. So findest du leichter das passende Gleichgewicht zwischen Kosten und Qualität.
Q7: Welche bekannten Einschränkungen hat die Kontextkomprimierung?
Erstens kann eine Zusammenfassung Details auslassen, insbesondere unauffällige Konfigurationswerte im Code. Zweitens wird der Cache bei jeder Komprimierung ungültig, sodass häufiges Komprimieren die Kosten erhöhen kann. Drittens ergänzt das Zusammenfassungsmodell gelegentlich Informationen, die nicht vorhanden sind. Dagegen helfen strukturierte Vorlagen, die wörtliche Übernahme von Nutzervorgaben und eine externe Notizdatei für wichtige Fakten wie Dateipfade, statt sich allein auf die Zusammenfassung zu verlassen.
Automatische Komprimierung des Agent-Kontexts: Das Wichtigste auf einen Blick
- Worum es bei der Komprimierung geht: Eine lange Verlaufshistorie wird in einen Aufgabenstatus überführt, mit dem der Agent weiterarbeiten kann – statt Einträge einfach nur zu kürzen.
- Drei Auslöser: Ein Token-Schwellenwert als Absicherung, proaktive Komprimierung an Phasengrenzen und die kontextabhängige Steuerung durch das Framework.
- Keine 80-%-Regel: Offiziell zählen Token-Schwellenwerte. Diese sollten auf das Kontextfenster und den Umfang der Tool-Ausgaben abgestimmt sein.
- Strukturierte Zusammenfassung: Ziele, Fortschritt, Fakten, Entscheidungen und nächste Schritte in fünf Abschnitten festhalten; Vorgaben der Nutzer wörtlich übernehmen.
- Nicht nach jeder Runde komprimieren: Häufiges Komprimieren kann Cache-Treffer verhindern. Eine gebündelte Komprimierung nach Phasen spart mehr Kosten.
- Logs schließen die Lücke: Zeigt der Client keinen Verbrauch an, lässt sich das Token-Wachstum pro Runde in den Aufrufprotokollen von APIYI apiyi.com beobachten.
Zusammenfassung
Die wichtigsten Punkte zur automatischen Komprimierung des Agent-Kontexts:
- Zeitpunkt: Vor allem an Phasengrenzen proaktiv komprimieren und einen Token-Schwellenwert als Absicherung nutzen. Die integrierte Strategie des Frameworks eignet sich für einen schnellen Einstieg.
- Zusammenfassungsstrategie: System-Prompt und die letzten Gesprächsrunden im Original behalten; den älteren Verlauf in eine strukturierte Zusammenfassung mit fünf Abschnitten verdichten.
- Kostenbalance: Durch die Komprimierung wird der Cache ungültig. Deshalb sollte der Kontext innerhalb einer Phase stabil wachsen und erst am Phasenende gebündelt komprimiert werden.
Wenn Sie regelmäßig Codex nutzen, können Sie nach jeder abgeschlossenen Phase eine Zusammenfassung erstellen und ein neues Fenster öffnen – als manuelle Variante der Komprimierung. Wenn Sie einen eigenen Agent entwickeln, können Sie den Code aus diesem Artikel direkt anpassen. Über APIYI apiyi.com lässt sich das Ergebnis schnell überprüfen: Die Plattform bietet kostenloses Testguthaben und eine einheitliche Schnittstelle für mehrere Modelle. Anhand der Aufrufprotokolle sehen Sie genau, wie sich die Token-Zahl durch die Komprimierung verändert.
📚 Referenzen
- Dokumentation zur OpenAI Responses API: Kontextkomprimierung und Konfiguration von
compact_threshold - Link:
platform.openai.com/docs/api-reference/responses -
Details: Offizielle Informationen zur automatischen serverseitigen Komprimierung und Zustandsverwaltung
-
Dokumentation zum OpenAI Agents SDK: Strategien für die Kontextverwaltung zur Laufzeit eines Agenten
- Link:
openai.github.io/openai-agents-python -
Details: Konfiguration automatischer Komprimierung, fester Schwellenwerte und erzwungener Komprimierung
-
Anthropic-Dokumentation zur Kontextkomprimierung: Auslöseparameter für die Komprimierung in der Messages API und im Tool Runner
- Link:
docs.anthropic.com - Details: Standardwerte für
trigger.valueundcontext_token_thresholdsowie Komprimierung bei Bedarf
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI. Weitere Informationen zur Codex-Konfiguration, zu Dialogen über mehrere Gesprächsrunden und zur Cache-Abrechnung finden Sie im Dokumentationszentrum unter docs.apiyi.com.