Anmerkung des Autors: Dieser Artikel erklärt anhand der offiziellen Preise und drei Rechenbeispielen, wie sich die Kosten für GPT-6.1 Terra zusammensetzen, wann der Langkontext-Tarif greift und wie viel Caching spart.
GPT-6.1 Terra wurde am 26. Oktober 2026 veröffentlicht und setzt auf „schnell und günstig“. Viele merken sich beim ersten Blick auf die Preisseite nur „1 Dollar für die Eingabe“ – und wundern sich später über die Rechnung. Der Grund: Der Terra-Preis ergibt sich aus vier Abrechnungsposten, zwei Kontextstufen und drei Verarbeitungsmodi.
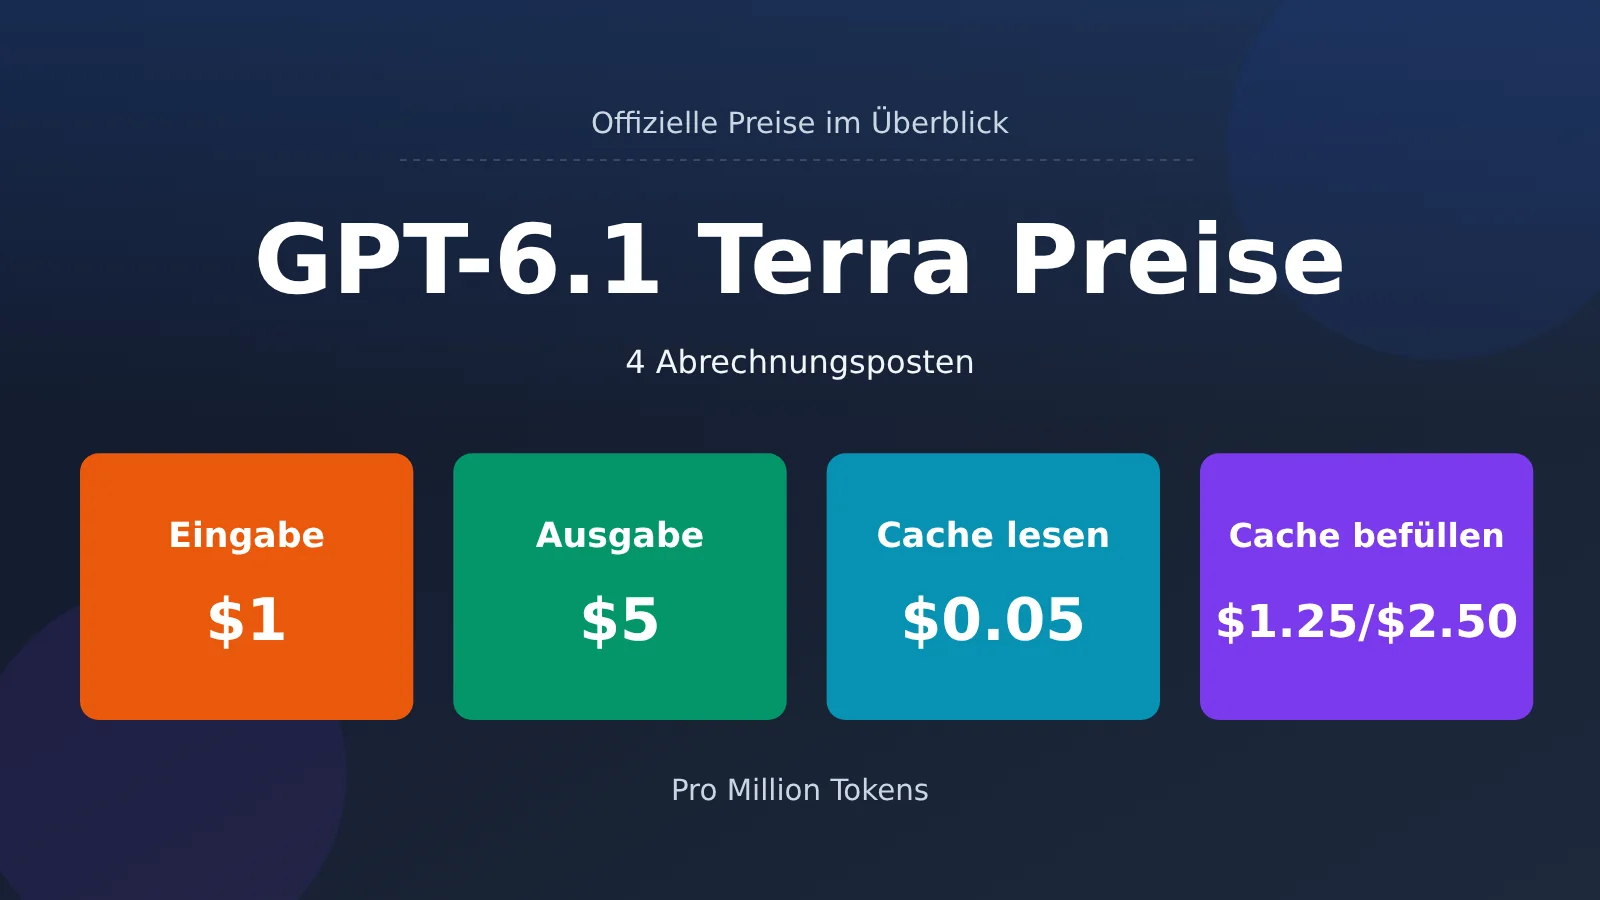
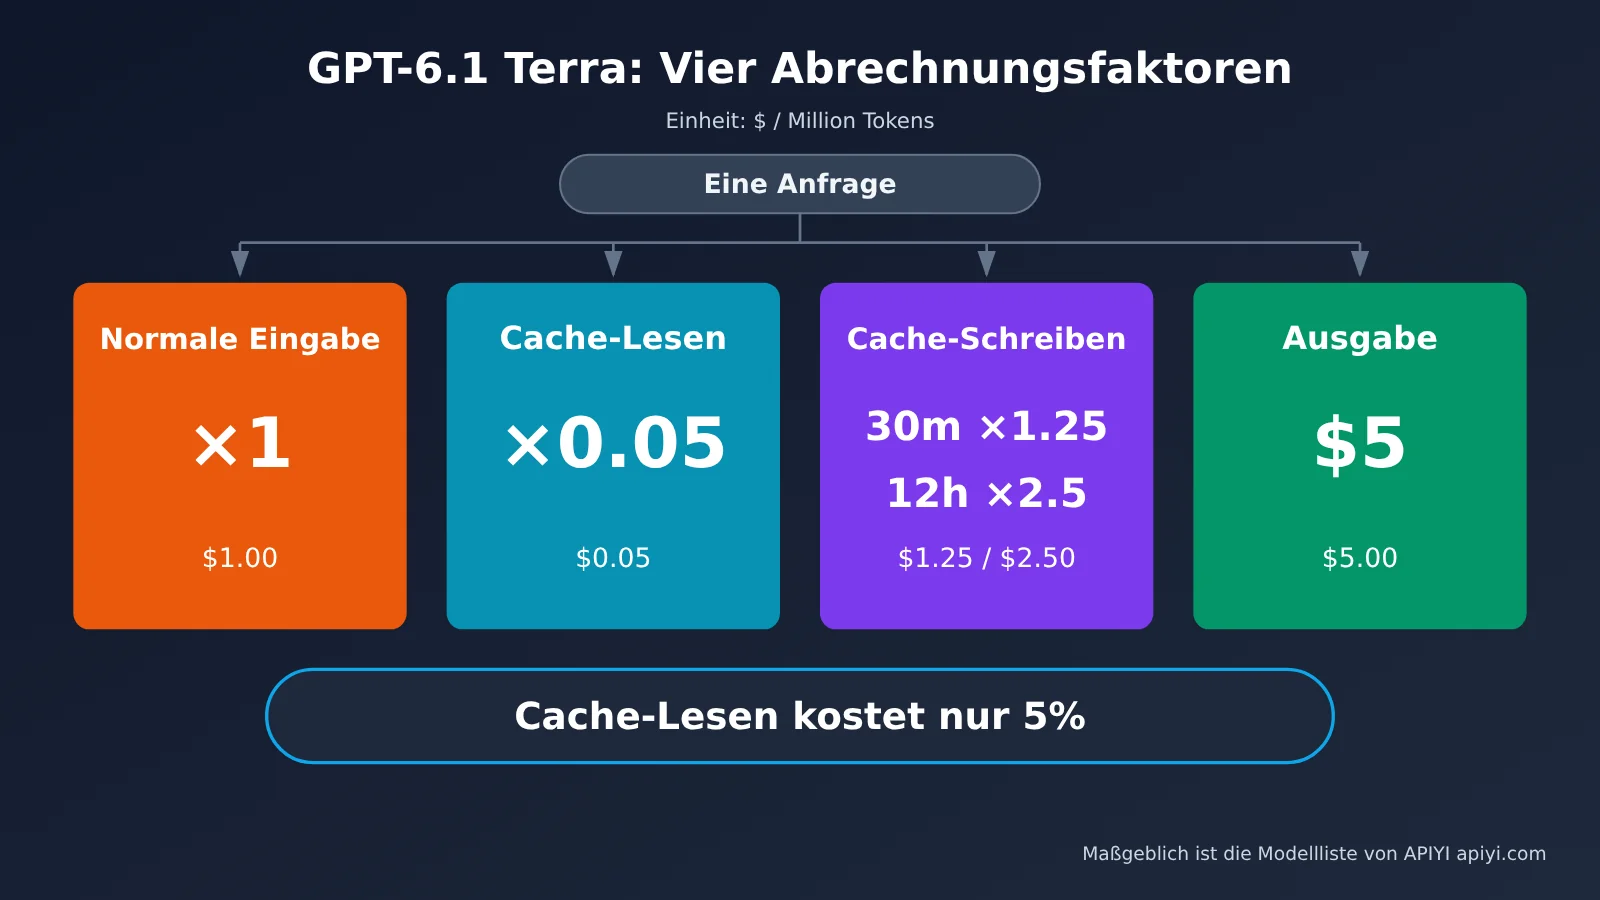
Die Preisstruktur von Terra auf einen Blick: Jede Anfrage wird nach vier Posten abgerechnet: reguläre Eingabe, Ausgabe, Cache-Lesezugriffe und Cache-Schreibzugriffe. Beim Schreiben in den Cache gibt es zwei Aufbewahrungszeiten: 30 Minuten und 12 Stunden. Überschreitet die Eingabe einer einzelnen Anfrage 272K Tokens, wird die gesamte Anfrage nach der zweiten Stufe abgerechnet. Daneben gibt es drei Verarbeitungsmodi: Batch und Flex kosten jeweils die Hälfte, Fast das Doppelte.
Zu den Quellen: Die offiziellen Preise stammen von der OpenAI-Modellseite und der Preisseite. Die Angaben des Anbieters stammen aus dem Veröffentlichungsblog vom 26. Oktober 2026. Daten von Drittanbietern stammen von Artificial Analysis und wurden am 27. Oktober 2026 abgerufen.
GPT-6.1 Terra: Die wichtigsten Preise im Überblick
Zunächst zum Modell selbst: Die Modell-ID lautet gpt-6.1-terra, und es gibt nur einen Snapshot. Das Kontextfenster umfasst 1.050.000 Tokens. Pro Anfrage sind maximal 922.000 Eingabe- und 128.000 Ausgabe-Tokens möglich. Der Wissensstand reicht bis zum 01.06.2026. Als Eingabe werden Text und Bilder unterstützt, als Ausgabe nur Text. Audio und Video werden nicht unterstützt.
Der Standardpreis gilt für Anfragen mit höchstens 272K Eingabe-Tokens. Alle Preise gelten pro Million Tokens:
| Abrechnungsposten | Standardpreis (≤272K) | Erläuterung |
|---|---|---|
| Eingabe | $1.00 | Eingabe ohne Cache-Treffer |
| Ausgabe | $5.00 | Einschließlich der durch Reasoning erzeugten Ausgabe |
| Cache-Lesen | $0.05 | Das 0,05-Fache des Eingabepreises |
| Cache-Schreiben (30 Minuten) | $1.25 | Das 1,25-Fache des Eingabepreises |
| Cache-Schreiben (12 Stunden) | $2.50 | Das 2,5-Fache des Eingabepreises |
Details zur Cache-Abrechnung bei GPT-6.1 Terra
Für das Lesen aus dem Cache fallen nur 5 % des Eingabepreises an. Bei den meisten Modellen derselben Generation sind es 10 %. Hier liegt Terras größte Preissenkung gegenüber der Vorgängergeneration.
Der Preis für das Schreiben in den Cache ist der Gesamtpreis, keine zusätzliche Gebühr zum Eingabepreis. Die im Cache gespeicherten Tokens werden direkt mit $1.25 oder $2.50 abgerechnet; die $1.00 für die Eingabe fallen dafür nicht nochmals an. Außerdem gelten folgende Regeln:
- Das mindestens cachefähige Präfix beträgt 1.024 Tokens. Kürzere Präfixe werden nicht im Cache gespeichert.
- Die Speicherdauer von 12 Stunden lässt sich nur in der Responses API über
prompt_cache_options.ttleinstellen. - Wird für
ttlein ungültiger Wert übergeben, gibt die Schnittstelle400 invalid_request_errorzurück.
GPT-6.1 Terra: Preisstaffel für lange Kontexte ab 272K
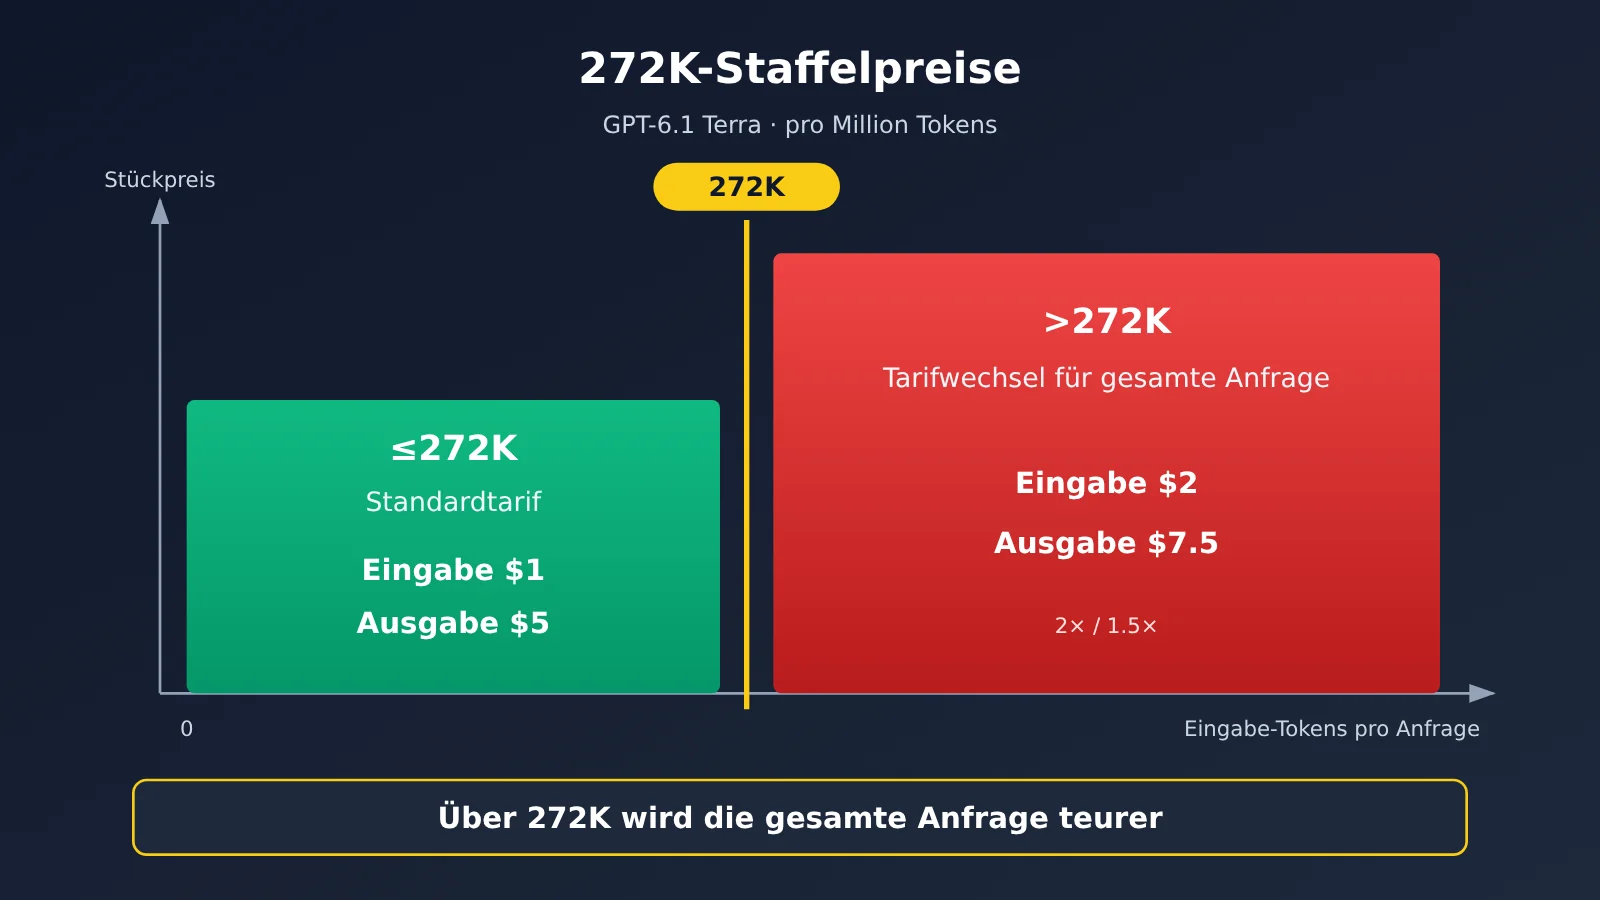
Diese Regel wird leicht übersehen: Überschreitet die Eingabe einer einzelnen Anfrage 272K Tokens, fällt die gesamte Anfrage in die zweite Preisstufe. Die Preise für Eingabe und Cache verdoppeln sich, der Ausgabepreis steigt auf das 1,5-Fache. Die neuen Preise gelten für alle Tokens der Anfrage, nicht nur für den Teil oberhalb der Grenze.
| Abrechnungsposten | ≤272K | >272K (gesamte Anfrage) | Faktor |
|---|---|---|---|
| Eingabe | $1.00 | $2.00 | 2× |
| Ausgabe | $5.00 | $7.50 | 1,5× |
| Cache-Lesen | $0.05 | $0.10 | 2× |
| Cache-Schreiben 30 Minuten | $1.25 | $2.50 | 2× |
| Cache-Schreiben 12 Stunden | $2.50 | $5.00 | 2× |
Weitere Preisstufen für GPT-6.1 Terra
| Modus | Preisregel | Einsatzbereich |
|---|---|---|
| Batch / Flex | 50 % des Standardpreises: Eingabe $0.50, Ausgabe $2.50, Cache-Lesen $0.025, Cache-Schreiben $0.625 (30 Min.) / $1.25 (12 Std.) | Offline-Stapelverarbeitung und Aufgaben, bei denen die Latenz weniger wichtig ist |
| Fast | Doppelter Standardpreis: Eingabe $2.00, Ausgabe $10.00 | Online-Anwendungen, bei denen die Latenz wichtig ist |
| Ultrafast | Nicht für Terra verfügbar, nur für gpt-6-astra und gpt-6.1-sol | — |
| Regionale Verarbeitung / FedRAMP | 10 % Aufpreis für Modelle, die nach dem 05.03.2026 veröffentlicht wurden | Datenresidenz und Compliance |
Für die Cache-Preise im Fast-Modus haben wir auf der abgerufenen offiziellen Seite keine konkreten Zahlen gefunden. Sie gelten hier daher als „offiziell nicht veröffentlicht“. Ausserdem wurde Priority processing am 30.07.2026 in Fast mode umbenannt – beim Lesen älterer Dokumentationen ist das zu beachten.
GPT-6.1 Terra im Preisvergleich: aktuelle und vorherige Generation
| Modell | Eingabe | Ausgabe | Cache-Lesen | Cache-Schreiben 30 Min. | Modellliste von APIYI apiyi.com (2026-10-27) |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | $12.50 | Verfügbar |
| gpt-6.1-sol | $2.00 | $10.00 | $0.10 | $2.50 | Verfügbar |
| gpt-6.1-terra | $1.00 | $5.00 | $0.05 | $1.25 | Verfügbar |
| gpt-6-sol | $2.00 | $10.00 | $0.20 | $2.50 | Verfügbar |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.125 | Verfügbar |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | $2.50 | Verfügbar |
Im Vergleich zu GPT-5.6 Terra ist der Eingabepreis von Terra um 50 % gesunken, der Ausgabepreis um rund 58 % und der Preis für Cache-Lesezugriffe um 75 %. Laut offiziellem Blog liegt der Standard-API-Preis 50 % unter dem von GPT-5.6 Terra und GPT-6.1 Sol.
GPT-6.1 Terra: Drei Preisbeispiele
Alle folgenden Berechnungen basieren auf dem Preis pro Million Tokens: Anzahl der Tokens × Preis ÷ 1.000.000.
Beispiel 1: Stapelverarbeitung von Rechnungen
Nehmen wir an, jeder Aufruf enthält 2.000 Eingabe-Tokens (einschliesslich eines Rechnungsbilds) und erzeugt 300 Ausgabe-Tokens. Pro Tag erfolgen 5.000 Aufrufe.
Ohne Cache-Treffer:
- Eingabe: 2.000 × $1 ÷ 1 Mio. = $0,0020
- Ausgabe: 300 × $5 ÷ 1 Mio. = $0,0015
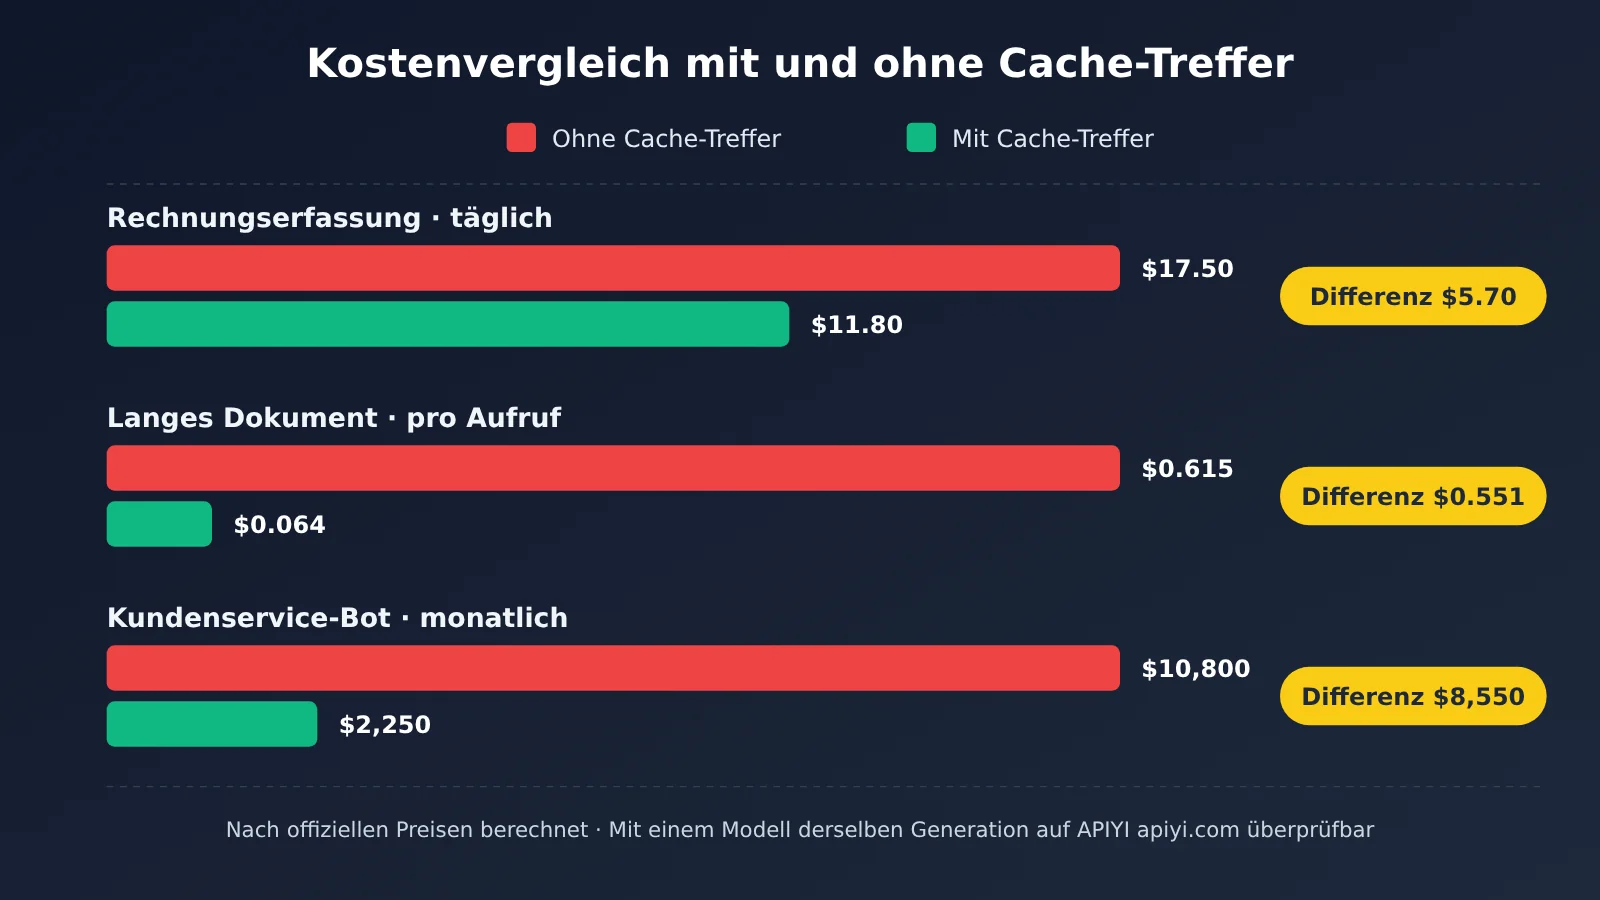
- Insgesamt $0,0035 pro Aufruf, bei 5.000 Aufrufen pro Tag × $0,0035 = $17,50
Mit Cache-Treffer: Angenommen, die festen Systemanweisungen und Feldbeschreibungen umfassen zusammen 1.200 Tokens und werden aus dem Cache gelesen (sie überschreiten den Schwellenwert von 1.024 Tokens). Die übrigen 800 Tokens entfallen auf wechselnde Inhalte wie das Bild.
- Lesen aus dem Cache: 1.200 × $0,05 ÷ 1 Mio. = $0,00006
- Reguläre Eingabe: 800 × $1 ÷ 1 Mio. = $0,0008
- Ausgabe: $0,0015
- Insgesamt $0,00236 pro Aufruf, also $11,80 pro Tag – $5,70 weniger als ohne Cache-Treffer
Nach Ablauf des Caches müssen die Daten erneut geschrieben werden. Bei einer Aufbewahrungsdauer von 30 Minuten kostet das Schreiben 1.200 × $1,25 ÷ 1 Mio. = $0,0015. Verteilt auf 5.000 Aufrufe pro Tag ist das vernachlässigbar. Bei der Rechnungserfassung wird das Ergebnis in der Regel nicht in Echtzeit benötigt. Über Batch kostet ein Aufruf ohne Cache-Treffer 2.000 × $0,5 ÷ 1 Mio. + 300 × $2,5 ÷ 1 Mio. = $0,00175, also $8,75 pro Tag.
Beispiel 2: Prüfung eines langen Dokuments (über 272K)
Angenommen, ein einzelner Aufruf umfasst 300.000 Eingabe- und 2.000 Ausgabe-Token. Da die Eingabe 272K überschreitet, wird der gesamte Aufruf nach der zweiten Preisstufe berechnet.
Ohne Cache-Treffer:
- Eingabe: 300.000 × $2 ÷ 1M = $0.60
- Ausgabe: 2.000 × $7.5 ÷ 1M = $0.015
- Pro Aufruf $0.615
Mit Cache-Treffer: Bei mehreren Nachfragen zum selben Dokument nehmen wir an, dass 290.000 Token des Dokumentpräfixes im Cache gefunden werden. Die neue Frage umfasst 10.000 Token.
- Cache-Lesezugriff: 290.000 × $0.10 ÷ 1M = $0.029
- Reguläre Eingabe: 10.000 × $2 ÷ 1M = $0.020
- Ausgabe: $0.015
- Pro Aufruf $0.064 – also $0.551 weniger als ohne Cache-Treffer
Bei der ersten Anfrage muss der Inhalt in den Cache geschrieben werden. Bei einer Aufbewahrungsdauer von 30 Minuten betragen die Kosten für den ersten Aufruf 290.000 × $2.5 ÷ 1M + $0.02 + $0.015 = $0.76. Schon nach einer einzigen Nachfrage zum selben Dokument liegen die Gesamtkosten für beide Aufrufe bei $0.824 – weniger als die $1.23 für zwei Aufrufe ohne Cache.
Es gibt noch eine einfachere Möglichkeit, Kosten zu sparen: die Eingabe auf höchstens 272K zu reduzieren. Bei 270.000 Eingabe- und 2.000 Ausgabe-Token betragen die Kosten 270.000 × $1 ÷ 1M + 2.000 × $5 ÷ 1M = $0.28 – weniger als die Hälfte der Kosten in der zweiten Preisstufe.
Beispiel 3: Kundenservice-Chatbot mit hoher Cache-Trefferquote
Angenommen, jede Gesprächsrunde umfasst 50.000 Eingabe-Tokens, von denen 45.000 aus dem Cache gelesen werden, und 800 Ausgabe-Tokens. Pro Monat fallen 200.000 Runden an.
Ohne Cache-Treffer:
- Eingabe: 50.000 × $1 ÷ 1 Mio. = $0,05, Ausgabe: 800 × $5 ÷ 1 Mio. = $0,004
- Pro Runde $0,054, pro Monat 200.000 × $0,054 = $10.800
Mit Cache-Treffer:
- Cache-Lesen: 45.000 × $0,05 ÷ 1 Mio. = $0,00225
- Reguläre Eingabe: 5.000 × $1 ÷ 1 Mio. = $0,005
- Ausgabe: $0,004
- Pro Runde $0,01125, pro Monat $2.250 – das sind $8.550 weniger pro Monat als ohne Cache-Treffer
Würde das Cache-Lesen wie bei den meisten Modellen derselben Generation mit dem 0,1-Fachen des Eingabepreises berechnet, lägen die Kosten bei $0,0135 pro Runde und $2.700 pro Monat. Terras Faktor von 0,05 spart in diesem Szenario zusätzlich $450 pro Monat. Die anteiligen Kosten für das Schreiben in den Cache sind in diesen Berechnungen nicht enthalten.
GPT-6.1 Terra: Kosten pro Aufgabe laut Drittanbieter
Die folgenden Daten stammen von Artificial Analysis (abgerufen am 27.10.2026). Es handelt sich um eine Bewertung durch einen Drittanbieter, nicht um Ihre tatsächlichen Betriebskosten. Die Token-Verteilung der Testaufgaben unterscheidet sich von der Ihrer Anfragen. Genauer ist es, anhand der offiziellen Einzelpreise und Ihrer eigenen Token-Verteilung zu rechnen.
| Modell | Intelligence Index | Kosten pro Aufgabe | Ausgabegeschwindigkeit |
|---|---|---|---|
| GPT-6.1 Terra(max) | 48 | $0.40 | 91 t/s |
| GPT-6.1 Sol | 52 | $0.72 | 69.4 t/s |
| GPT-5.6 Terra | 42 | $1.40 | 135.4 t/s |
| GPT-6 Astra | 53 | $3.26 | 67.8 t/s |
| Claude Opus 5.5(Max) | 58 | $5.98 | — |
Diesen Daten zufolge liegt Terra im Index 5 Punkte hinter Astra. Die Kosten pro Aufgabe betragen etwa ein Achtel der Kosten von Astra und ein Fünfzehntel der Kosten von Opus 5.5.
Der offizielle Blog nennt weitere Kostenvergleiche. Diese Angaben stammen vom Hersteller und wurden nicht unabhängig überprüft:
- Bei Agents‘ Last Exam erzielt die Einstellung „medium“ ein um 15 Prozentpunkte höheres Ergebnis als GPT-5.6 Terra, bei etwa einem Drittel der Kosten.
- Die Einstellung „max“ ist bei der Token-Nutzung mehr als dreimal so effizient wie Claude Opus 5.5. Die Kosten pro Aufgabe sind etwa neunmal niedriger.
GPT-6.1 Terra: Erste Schritte zur Anbindung
Stand 27.10.2026 lässt sich gpt-6.1-terra direkt über APIYI apiyi.com aufrufen: Die Preise betragen 1 $ für Eingabe, 5 $ für Ausgabe, 0,05 $ für Cache-Lesezugriffe und 1,25 $ für Cache-Schreibzugriffe – jeweils pro Million Tokens. Das entspricht einem Modellmultiplikator von 0,5 und einem Completion-Multiplikator von 5 auf der Plattform. Die Preise stimmen in jedem Punkt mit der Preisstufe ≤272K auf der offiziellen Website überein. Auch die Modelle gpt-6.1-sol und gpt-6-astra aus derselben Generation sowie gpt-5.6-terra, gpt-6-sol und gpt-6-luna aus der Vorgängergeneration sind verfügbar. Maßgeblich für Modelle und Preise ist die Modellliste der Plattform; die endgültigen Kosten für lange Kontextfenster stehen in der Abrechnung der Konsole.
Die Anbindung erfordert nur vier Schritte:
- Registriere ein Konto bei APIYI apiyi.com und erstelle einen API-Schlüssel.
- Setze im OpenAI-kompatiblen SDK
base_urlaufhttps://api.apiyi.com/v1und trage deinen Schlüssel beiapi_keyein. - Rufe vor dem Modellaufruf die aktuelle Modellliste unter
api.apiyi.com/api/pricingab. Prüfe den Einzelpreis und die verfügbaren Gruppen fürgpt-6.1-terraund setze anschließend das Feldmodelauf diese ID. - Setze
reasoning.effortpassend zur Aufgabe. Zur Auswahl stehennone / low / medium / high / xhigh / max; der Standardwert istmedium. - Wenn du eine Cache-Dauer von 12 Stunden benötigst, verwende stattdessen die Responses API und setze
prompt_cache_options.ttl. - Prüfe vor dem Produktivstart anhand der zurückgegebenen Usage-Statistik, wie viele Tokens aus dem Cache abgerufen wurden. Schätze anschließend die Kosten mit der Formel in diesem Artikel.
🚀 Schnellstart: Maßgeblich für Modelle und Preise ist die Modellliste der Plattform. Neue Konten erhalten ein Testguthaben von 0,05 US-Dollar. Setze bei APIYI apiyi.com
modelaufgpt-6.1-terra, um den Modellaufruf und die Cache-Logik zu testen. Für einen Preisvergleich kannst du anschließend zugpt-6.1-solwechseln.
Häufig gestellte Fragen (FAQ)
F1: Was kostet GPT-6.1 Terra in einem Satz?
Im Standardtarif (bis zu 272K Tokens pro Eingabe) kostet eine Million Tokens: Eingabe $1, Ausgabe $5, Cache-Lesezugriff $0,05 und Cache-Schreibzugriff $1,25 für 30 Minuten bzw. $2,50 für 12 Stunden.
F2: Wird bei mehr als 272K Tokens nur für den überschüssigen Teil mehr berechnet?
Nein. Überschreitet eine Eingabe 272K Tokens, fällt die gesamte Anfrage in die zweite Preisstufe: Die Preise für Eingabe und Cache verdoppeln sich, für die Ausgabe gilt der 1,5-fache Preis.
F3: Wann sollte ich Batch und wann Fast wählen?
Für Offline-Aufgaben eignen sich Batch oder Flex: Alle Abrechnungspositionen kosten dann die Hälfte. Für Aufgaben, bei denen es auf kurze Antwortzeiten ankommt, gibt es Fast – allerdings zum doppelten Preis. Terra unterstützt Ultrafast nicht.
F4: Kostet das Schreiben in den Cache extra?
Der Preis für den Cache-Schreibzugriff ist der Gesamtpreis, kein Zuschlag. Für die geschriebenen Tokens wird das 1,25- oder 2,5-Fache des Eingabepreises berechnet; der reguläre Eingabepreis fällt nicht zusätzlich an. Wird derselbe Präfix einmal wiederverwendet, rechnet sich das in der Regel bereits.
F5: Kann ich Terra bei APIYI nutzen?
Ja. Seit dem 27.10.2026 ist `gpt-6.1-terra` bei APIYI auf apiyi.com verfügbar. Alle vier Abrechnungspositionen entsprechen den offiziellen Preisen für die Stufe bis 272K. Massgeblich für Modelle und Preise ist die Modellliste der Plattform.
F6: Kann ich die von Dritten ermittelten Kosten pro Aufgabe direkt für meine Budgetplanung nutzen?
Das ist nicht empfehlenswert. Diese Werte beziehen sich auf Benchmark-Aufgaben und deren Token-Verteilung kann sich von der Ihrer Anwendung unterscheiden. Verlässlicher ist es, die Token-Verteilung mit echten Anfragen bei APIYI auf apiyi.com zu messen und die Kosten anhand der offiziellen Einzelpreise zu berechnen.
GPT-6.1 Terra: Das Wichtigste zu den Preisen
- Vier Abrechnungsposten: Eingabe $1, Ausgabe $5, Cache-Lesezugriff $0,05; für das Schreiben in den Cache gelten zwei Preisstufen: $1,25 und $2,50.
- 272K ist die Grenze: Wird sie überschritten, gilt für die gesamte Anfrage die höhere Preisstufe. Die Eingabe kostet dann doppelt so viel, die Ausgabe das 1,5-Fache.
- Der Cache bietet das größte Sparpotenzial: In einem Kundenservice-Szenario sinken die monatlichen Kosten von $10.800 auf $2.250.
- Batch und Flex kosten die Hälfte, Fast das Doppelte; Ultrafast wird von Terra nicht unterstützt.
- Kosten pro Aufgabe von Drittanbietern sind nur Richtwerte. Für die Budgetplanung ist es genauer, anhand der offiziellen Preise selbst zu rechnen.
- Plattformzugang: Bei APIYI auf apiyi.com lässt sich das Modell aufrufen, indem das Feld
modelaufgpt-6.1-terragesetzt wird. Maßgeblich für Modelle und Preise ist die Modellliste der Plattform.
Fazit
Die Kosten für Terra hängen vor allem von drei Faktoren ab: ob die Eingabe 272K überschreitet, wie hoch die Cache-Trefferquote ist und ob Batch oder Fast gewählt wird. Je nach Einstellung können sich die Kosten bei gleichem Nutzungsumfang um ein Vielfaches unterscheiden.
Am besten ermitteln Sie zunächst anhand Ihrer eigenen Anfragen, wie sich die Tokens verteilen, und berechnen die Kosten dann mit den Formeln aus diesem Artikel. Sie können echte Anfragen direkt bei APIYI auf apiyi.com mit gpt-6.1-terra ausführen und die Kosten anschließend mit gpt-6.1-sol aus derselben Generation vergleichen.
📚 Quellen
- OpenAI-Modellseite für GPT-6.1 Terra: Spezifikationen und Kontextparameter
- Link:
platform.openai.com/docs/models/gpt-6.1-terra - Inhalt: Kontext, Eingabe- und Ausgabemodalitäten sowie Reasoning-Stufen
- OpenAI-Preisseite: Standardpreise, langer Kontext, Batch/Flex/Fast
- Link:
platform.openai.com/docs/pricing - Inhalt: Offizielle Angaben zu allen Abrechnungspositionen
- OpenAI-Leitfaden zu Prompt Caching: Caching-Regeln
- Link:
platform.openai.com/docs/guides/prompt-caching - Inhalt: Mindestpräfix, TTL-Einstellungen und Abrechnung von Schreibvorgängen
- Blogbeitrag zur Veröffentlichung von GPT-6.1 Terra: Kostenangaben des Herstellers
- Link:
openai.com/index/introducing-gpt-6-1-terra - Hinweis: Am 26.10.2026 veröffentlicht; die Daten wurden nicht unabhängig reproduziert
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.