Viele Entwickler berichten derzeit von einer „kontraintuitiven“ Erfahrung: claude-opus-5-5 fühlt sich überhaupt nicht langsam an und erledigt viele Aufgaben sogar früher als claude-sonnet-5-5. Wenn das Flaggschiffmodell also sowohl schnell als auch leistungsstark ist – bleibt Sonnet dann nur noch der Vorteil, halb so teuer zu sein? So einfach ist die Antwort nicht. Dieser Artikel analysiert anhand von sechs öffentlichen Datensätzen die tatsächlichen Unterschiede zwischen claude-sonnet-5-5 und claude-opus-5-5 und beantwortet vor allem eine praxisnähere Frage: Wie sollten die beiden Modelle in Enterprise-Agent-Szenarien mit langen Ein- und Ausgaben zusammenspielen?
Kernnutzen: Nach diesem Artikel wissen Sie, warum Opus tatsächlich „schnell“ wirkt, welche handfesten Vorteile Sonnet neben dem Preis bietet und wie eine direkt umsetzbare Agent-Architektur mit Opus und Sonnet aussieht.
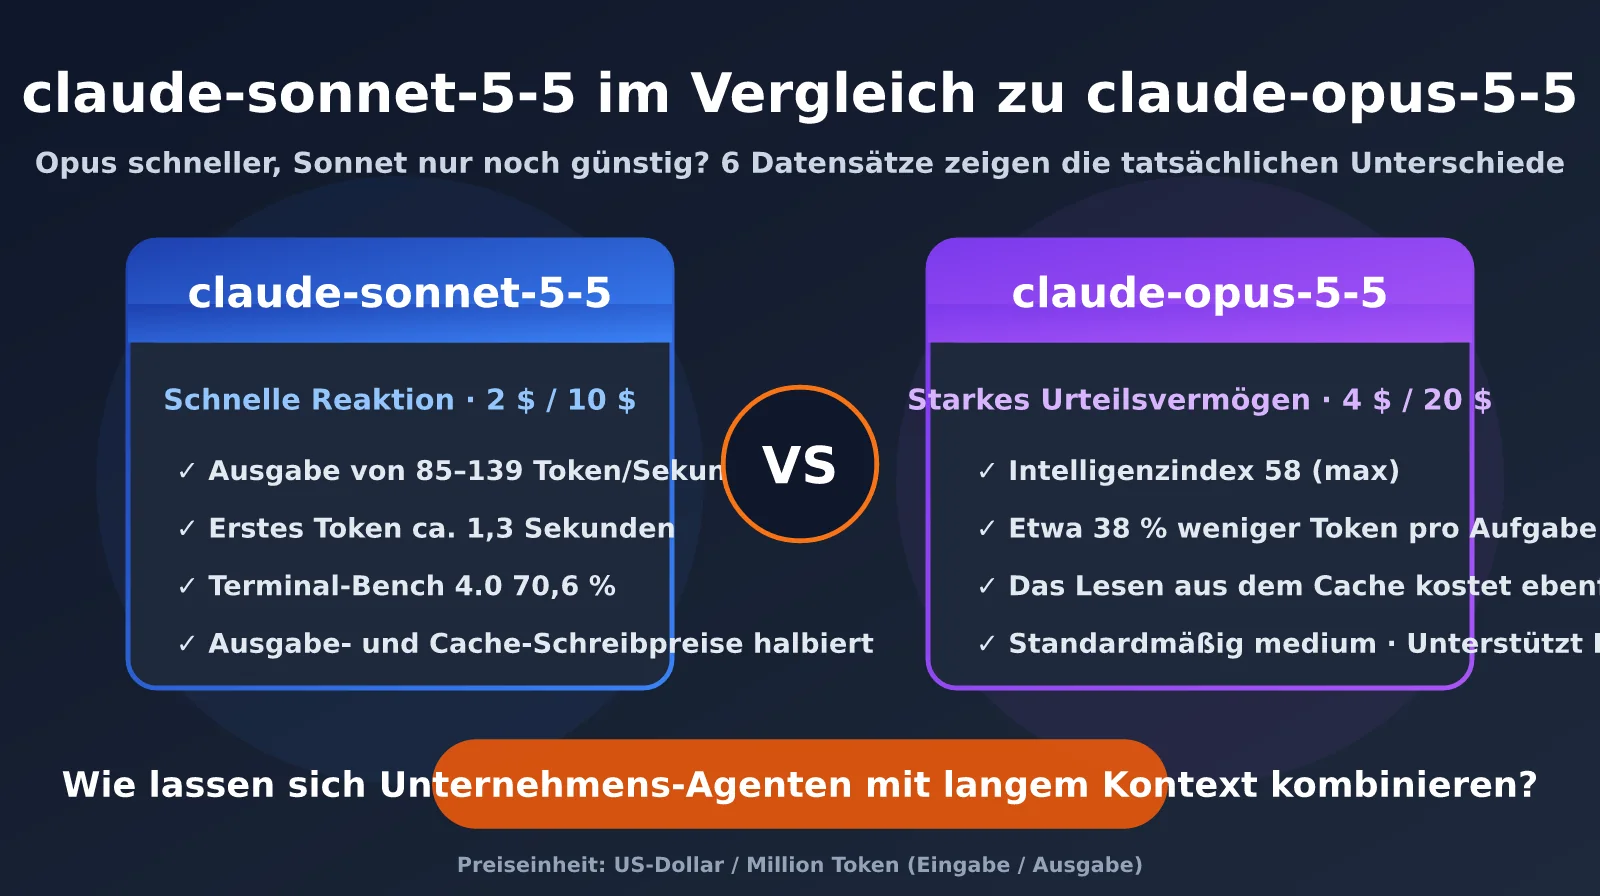
Überblick über die wichtigsten Parameter von claude-sonnet-5-5 und claude-opus-5-5
claude-opus-5-5 wurde am 22. September 2026 veröffentlicht, claude-sonnet-5-5 folgte am 28. September. Beide gehören zur Claude-5.5-Familie. Die wichtigste Neuerung dieser Generation: Opus ist günstiger geworden. Der Listenpreis sank gegenüber Opus 5 um 20 % – von $5/$25 auf $4/$20. Besonders deutlich fällt die Preissenkung beim Cache-Lesen aus: von $0.50 auf $0.20, also auf denselben Preis wie bei Sonnet. Sonnet 5.5 bleibt bei $2/$10; laut Anbieter liegen die Kosten pro Aufgabe damit gegenüber der vorherigen Generation um bis zu rund 30 % niedriger.
| Parameter | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| Veröffentlichungsdatum | 2026-09-28 | 2026-09-22 |
| Preis für Eingabe / Ausgabe | $2 / $10 | $4 / $20 |
| Cache-Lesen | $0.20 | $0.20 (5 % des regulären Eingabepreises) |
| 5-Minuten-Cache-Schreiben | $2.50 | $5 |
| Batch-Preis | $1 / $5 | $2 / $10 |
| Kontextfenster | 1 Million Token, kein Aufpreis für lange Kontexte | 1 Million Token, kein Aufpreis für lange Kontexte |
| Maximale Ausgabe | 128K (300K in der Batch-Betaversion) | 128K (300K in der Batch-Betaversion) |
| Standardmäßige Reasoning-Stufe der API | high | medium |
| Fast-Modus | Nicht unterstützt | Unterstützt, etwa 2,5-mal höhere Ausgabegeschwindigkeit, $8 / $40 |
| Verfügbare Plattformen | APIYI apiyi.com, offizielle Anthropic API | APIYI apiyi.com, offizielle Anthropic API |
In der Tabelle stecken zwei Details, die die praktische Erfahrung unmittelbar beeinflussen. Erstens: Die standardmäßige Reasoning-Stufe ist nicht gleich. Opus verwendet standardmäßig medium, Sonnet in der API hingegen high. Das ist der wichtigste Grund, warum viele Nutzer Opus als schneller wahrnehmen. Zweitens: Der Preis für das Cache-Lesen ist identisch. In Agent-Szenarien, die lange Kontexte häufig wiederverwenden, wird der Unterschied bei den Eingabekosten dadurch erheblich kleiner.
🎯 Testempfehlung: Legen Sie beim Vergleich der beiden Modelle unbedingt explizit dieselbe Reasoning-Stufe fest, sonst werden die Ergebnisse stark verzerrt. Über APIYI apiyi.com können Sie mit demselben Key jeweils claude-sonnet-5-5 und claude-opus-5-5 aufrufen; für einen sauberen Vergleich müssen Sie nur die beiden Parameter
modelundreasoning_effortwechseln.
Warum fühlt sich claude-opus-5-5 schneller an als claude-sonnet-5-5?
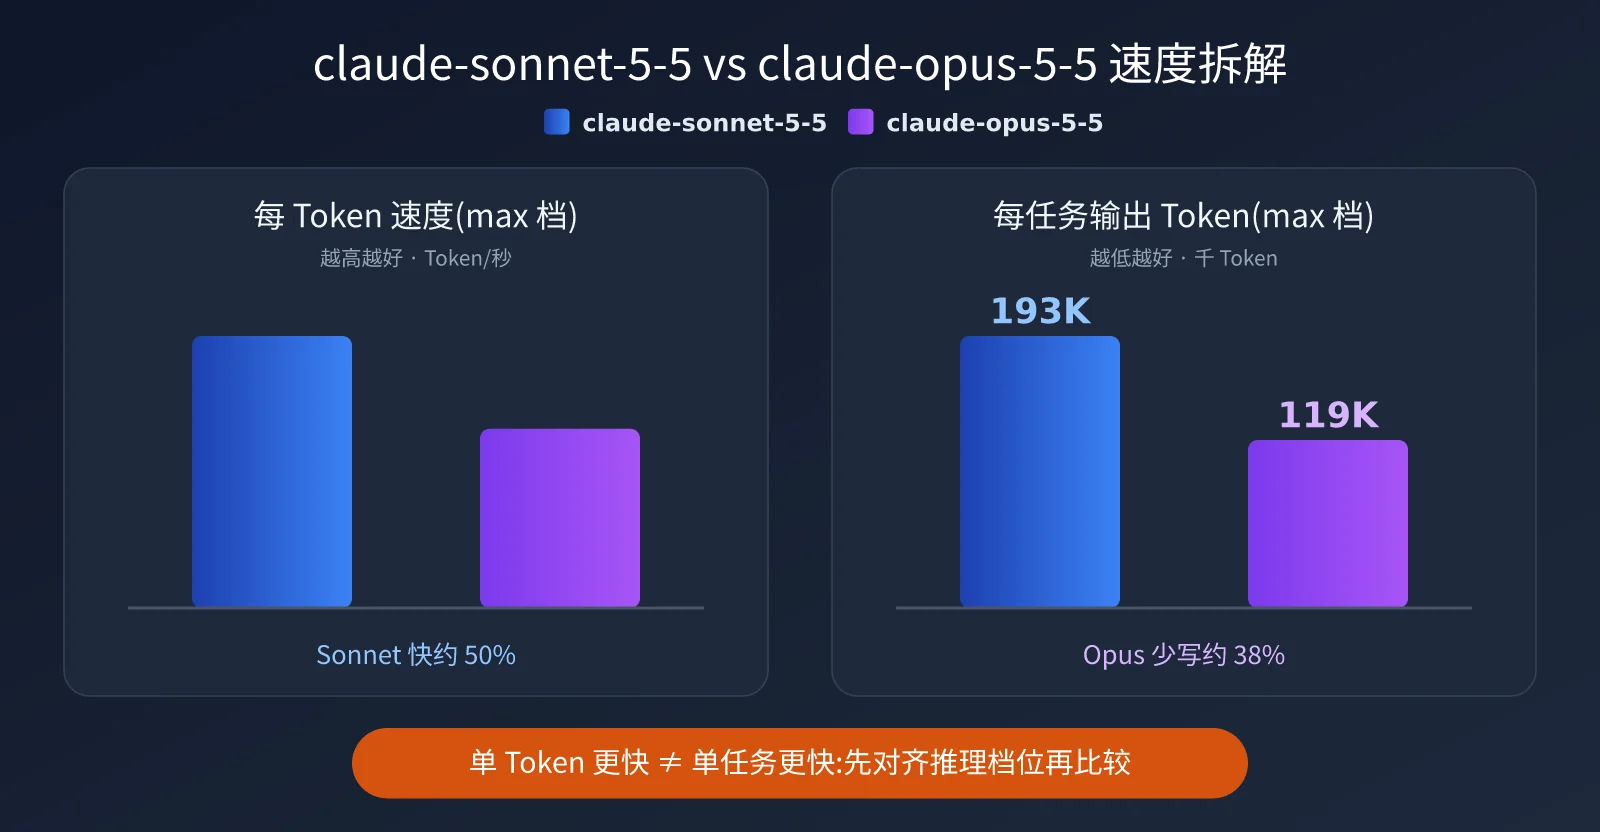
Bei der reinen Generierungsgeschwindigkeit ist claude-sonnet-5-5 tatsächlich deutlich schneller. Messungen von Artificial Analysis zeigen für Sonnet 5.5 je nach Reasoning-Stufe eine Ausgabegeschwindigkeit von 85–139 Token pro Sekunde, bei Opus 5.5 sind es 74–93 Token pro Sekunde. Auch Anthropic selbst stuft die Latenz von Sonnet als „schnell“ und die von Opus als „mittel“ ein. Woher kommt also der Eindruck, dass Opus schneller sei? Dafür gibt es vor allem drei Gründe.
Grund 1: Unterschiedliche Standardstufen – Sonnet denkt standardmässig eine Stufe länger nach
Opus 5.5 hat die API-Standardstufe gegenüber der Vorgängergeneration von high auf medium abgesenkt. Laut Anthropic erreicht oder übertrifft die medium-Stufe bereits das Niveau von Opus 5 auf high. Bei Sonnet 5.5 bleibt die API-Standardstufe dagegen high; zudem lässt sich der Denkmodus nicht deaktivieren. Unabhängige Tests zeigen, dass Sonnet auf high ungefähr doppelt so viele Ausgabe-Token erzeugt wie auf medium – ohne einen klar erkennbaren Qualitätsgewinn. Wer beide Modelle direkt mit den Standardparametern aufruft, lässt Sonnet also faktisch „eine Stufe länger nachdenken“. Entsprechend dauert die Antwort länger.
Grund 2: Opus arbeitet Token-effizienter
Im Intelligence-Index-Test von Artificial Analysis erzeugte Sonnet 5.5 auf der Stufe max durchschnittlich rund 193.000 Token pro Aufgabe – der höchste von der Organisation gemessene Wert. Opus 5.5 kam auf derselben Stufe auf etwa 119.000 Token. Schnellere einzelne Token bedeuten nicht automatisch eine schnellere Aufgabe insgesamt. Sonnet kann pro Sekunde etwa 50 % mehr Token ausgeben; wenn es dafür aber 60 % mehr Inhalt erzeugt, kann Opus bei der End-to-End-Zeit gleichziehen oder sogar schneller sein.
Grund 3: Nur Opus bietet den Fast-Modus
Opus 5.5 unterstützt einen Fast-Modus als Research Preview. Dabei verwendet dasselbe Modell eine schnellere Inferenzkonfiguration, die die Ausgabegeschwindigkeit um bis zu etwa das 2,5-Fache erhöhen kann. Die Preise liegen bei $8/$40. Wenn Sie in einem Programmierwerkzeug für Opus den Fast-Modus aktiviert haben, verstärkt das den Eindruck, dass Opus sehr schnell ist. Wichtig: Der Fast-Modus erhöht nur die Anzahl der ausgegebenen Token pro Sekunde. Die Latenz bis zum ersten Token verbessert er nicht. Zudem wird der Eingabeaufforderungs-Cache nicht mit der Standardgeschwindigkeit geteilt.
| Geschwindigkeitskennzahl | claude-sonnet-5-5 | claude-opus-5-5 | Erläuterung |
|---|---|---|---|
| Ausgabegeschwindigkeit (Token/Sekunde) | 85–139 | 74–93 | Sonnet ist pro Token schneller |
Ausgabe-Token pro Aufgabe (max) |
ca. 193.000 | ca. 119.000 | Opus benötigt weniger Token |
| Latenz bis zum ersten Token (niedrige Stufen) | ca. 1,3 Sekunden (medium) |
ca. 14,3 Sekunden (low) |
Sonnet reagiert schneller |
| Offizielle Latenzbewertung | Schnell | Mittel | Laut Anthropic-Modellseite |
| Dauer realer Programmieraufgaben (Drittanbieter) | 29 Min. 27 Sek. | 44 Min. 50 Sek. | Sonnet ist etwa 1,5-mal schneller |
Das Fazit: Mit den Standardparametern kann Opus schneller wirken. Werden beide Modelle jedoch mit passenden Stufen eingesetzt, hat Sonnet bei der Reaktionsgeschwindigkeit weiterhin einen klaren Vorteil. Besonders relevant ist die Latenz bis zum ersten Token: Sonnet beginnt auf medium bereits nach etwa 1,3 Sekunden mit der Ausgabe. Das ist für interaktive, nutzernahe Agenten entscheidend.
Hat claude-sonnet-5-5 nur einen Preisvorteil? Die Leistungsdaten im Vergleich
Zunächst eine möglicherweise überraschende Zahl: Auf der Stufe max ist Sonnet nicht günstiger als Opus. Für den vollständigen Intelligence-Index von Artificial Analysis kostete Sonnet 5.5 (max) rund $8.977, Opus 5.5 (max) etwa $8.708. Opus war also sogar leicht günstiger und erzielte zugleich die höhere Punktzahl: 58 gegenüber 56. Der Grund ist genau die zuvor erwähnte Token-Effizienz. Wer Sonnet ausschliesslich auf max nutzt, hat also nicht unbedingt einmal einen Preisvorteil.
Wo liegt dann der Wert von Sonnet? Die folgende Tabelle zeigt die Intelligence-Index-Werte beider Modelle nach Reasoning-Stufe und macht deutlich, wie Sonnet sinnvoll eingesetzt wird:
| Reasoning-Stufe | Intelligence Index: claude-sonnet-5-5 | Intelligence Index: claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
Bei der allgemeinen Intelligenz liegt Opus auf derselben Stufe durchgehend vorn. Besonders deutlich ist der Vorsprung bei Faktenkorrektheit (AA-Omniscience: 66 % gegenüber 54 %), Recht, Finanzen und strategischen Fachgebieten. Dennoch hat Sonnet in mehreren Bereichen klare Vorteile, die Opus nicht ersetzen kann:
- Agentisches Programmieren im Terminal: Im Terminal-Bench 4.0 erreicht Sonnet (
max) 70,6 % und liegt damit über Opus (xhigh) mit 66,4 %. Auf derselben Stufexhighführt Opus allerdings weiterhin mit 66,4 % gegenüber 61,5 %. Sonnet muss also voll aufgedreht werden, um vorbeizuziehen. - Reaktionslatenz: Sowohl die Latenz bis zum ersten Token als auch die Ausgabe pro Sekunde sind deutlich besser. Das eignet sich besonders für Echtzeitinteraktionen und Frontend-Szenarien mit Streaming-Ausgabe.
- Nicht im Cache vorhandene Eingaben und Cache-Schreibvorgänge: Beide Preise liegen nur bei der Hälfte von Opus. Das ist vorteilhaft für einmalige Aufgaben mit langen, stets neuen Dokumenten.
- Lange Ausgaben und Batch-Verarbeitung: Der Ausgabepreis beträgt $10 gegenüber $20, im Batch $5 gegenüber $10. Bei der grossflächigen Erstellung langer Berichte oder Dokumente halbieren sich die Kosten damit direkt.
- Ausführung mit hoher Parallelität: In Anthropics eigener Positionierung ist Sonnet der schnellere und kostengünstigere Partner von Opus. Es eignet sich als Sub-Agent, der viele klar abgegrenzte Teilaufgaben parallel bearbeitet.
In weiteren öffentlichen Benchmarks liegt Opus im CursorBench 4.0 (57,8 % gegenüber 55,5 %), FrontierCode 1.1 (54,4 % gegenüber 52,1 %) und OSWorld 2.1 (81,8 % gegenüber 80,1 %) jeweils um rund zwei Punkte vorn. Im von Drittanbietern zusammengetragenen ProgramBench für Programmrekonstruktion mit langem Kontext erreicht Opus 91,2 %, Sonnet dagegen 79,7 % – hier wird der Abstand deutlich grösser. Das zeigt: Je stärker eine Aufgabe präzise Entscheidungen in extrem langen Kontexten erfordert, desto grösser ist der Vorteil von Opus.
💡 Hinweis zur Modellauswahl: Sonnet wird am sinnvollsten auf den Stufen
mediumbisxhighals „Ausführender“ eingesetzt. Opus eignet sich dagegen abmediumals „Entscheider“. Wenn Sie die Unterschiede für Ihren eigenen Anwendungsfall prüfen möchten, können Sie bei APIYI apiyi.com dieselbe Aufgabe mit einem langen Dokument jeweils einmal ausführen und Ergebnisqualität sowie tatsächliche Kosten vergleichen.
Die tatsächlichen Kosten von Enterprise-Agent-Szenarien mit langem Kontext
Die typische Auslastung eines Enterprise-Agenten sieht so aus: Am Eingabeende stehen oft Verträge, Codebasen oder Wissensdatenbanken mit mehreren hunderttausend Token; am Ausgabeende lange Berichte, Stapelumformulierungen oder Code über mehrere Dateien hinweg. Da beide Modelle ein Kontextfenster von 1 Million Token unterstützen und keinen Aufpreis für lange Kontexte verlangen, werden die Kosten vor allem durch die Cache-Trefferquote und die Ausgabelänge bestimmt. Die folgenden typischen Szenarien sind anhand der offiziellen Preise geschätzt (für Sonnet werden 1,6-mal so viele Ausgabe-Token wie für Opus angesetzt, entsprechend dem Unterschied in der Token-Effizienz beider Modelle auf der Stufe „max“):
| Szenario | Zusammensetzung der Last | claude-sonnet-5-5 | claude-opus-5-5 | Kostenverhältnis |
|---|---|---|---|---|
| Mehrstufige Rückfragen mit langem Kontext | 500.000 Token Kontext, 95 % Cache-Treffer, 25.000 neue Token zum Schreiben | ca. 0,28 $ (12.000 Ausgabe-Token) | ca. 0,37 $ (7.500 Ausgabe-Token) | 1 : 1,3 |
| Erstmaliges Laden eines langen Dokuments | 500.000 Token in den 5-Minuten-Cache schreiben + 10.000 Ausgabe-Token | ca. 1,35 $ | ca. 2,70 $ | 1 : 2 |
| Erstellung eines langen Berichts | 50.000 Eingabe- + 50.000 Ausgabe-Token (gleiche Ausgabemenge) | ca. 0,60 $ | ca. 1,20 $ | 1 : 2 |
| Offline-Generierung im Stapel | Batch-Modus, jeweils 100.000 Eingabe- und Ausgabe-Token | ca. 0,60 $ | ca. 1,20 $ | 1 : 2 |
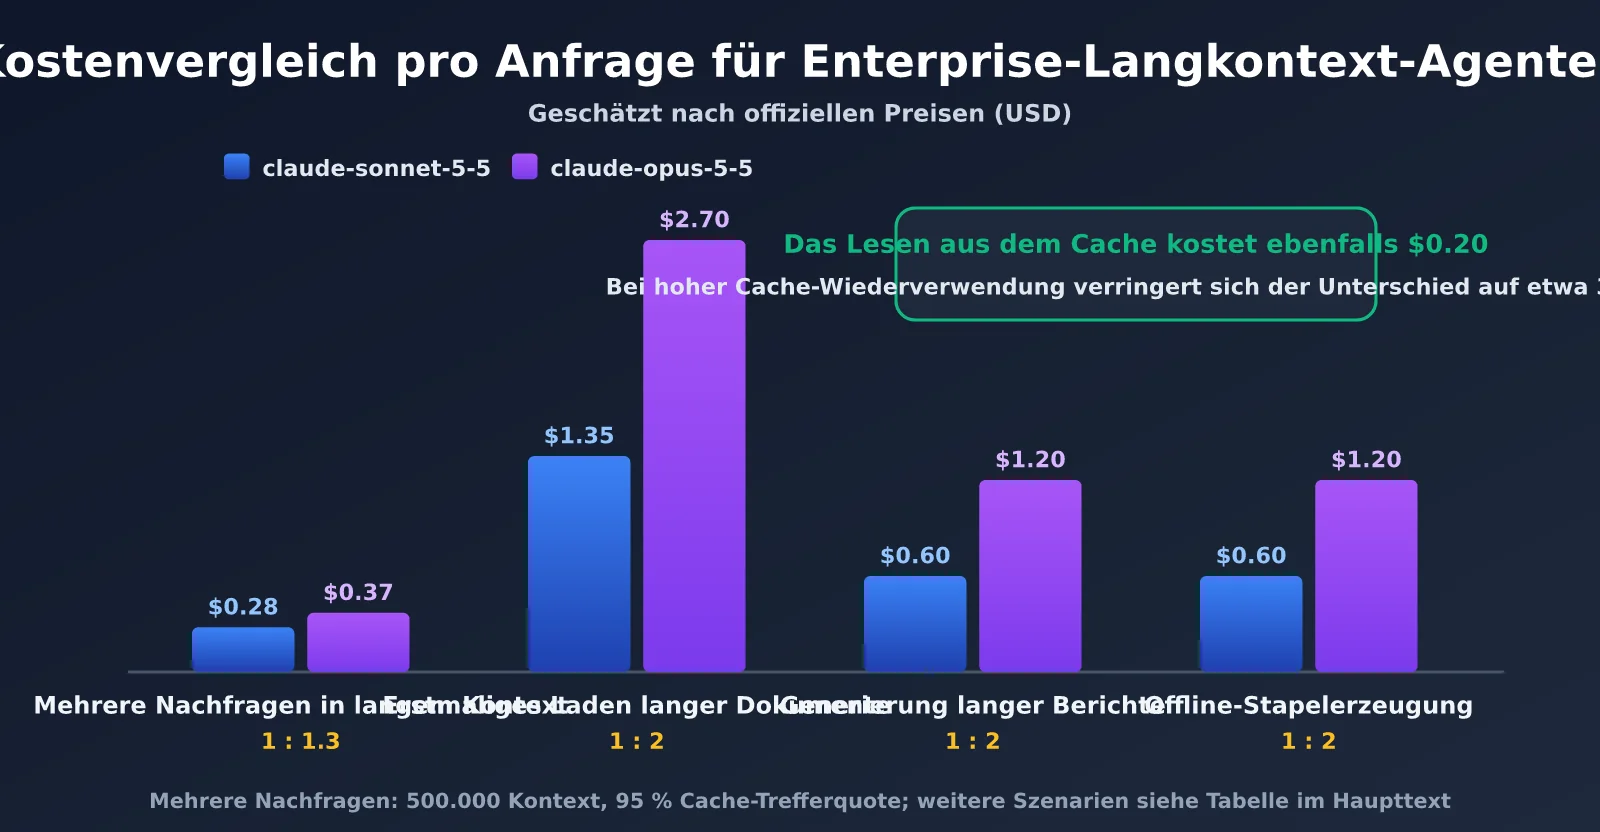
Diese Tabelle zeigt ein wichtiges Muster: Bei mehrstufigen Rückfragen mit langem Input, hoher Cache-Trefferquote und kurzer Ausgabe ist Opus nur rund 30 % teurer als Sonnet. Denn der größte Kostenblock – das Lesen aus dem Cache – kostet bei beiden Modellen gleich viel, während Opus zudem weniger Ausgabe-Token benötigt. Beim erstmaligen Laden neuer Dokumente und bei der Erzeugung langer Ausgaben kehrt der vollständige Kostenvorteil von Sonnet auf etwa die Hälfte zurück. Anders gesagt: Opus eignet sich besonders dafür, dieselben umfangreichen Unterlagen wiederholt zu lesen und fundierte Entscheidungen zu treffen. Sonnet ist die bessere Wahl, wenn neues Material einmalig verarbeitet oder viel Text erzeugt werden soll.
Ein weiteres Detail, das leicht übersehen wird: Der Prompt-Cache kann nicht modellübergreifend geteilt werden. Wird dasselbe Dokument mit 500.000 Token einmal von Opus und anschließend von Sonnet gelesen, fallen die Kosten für das Schreiben in den Cache zweimal an. Der Schlüssel einer Architektur mit zwei Modellen liegt daher darin, den langen Kontext möglichst nur bei einem Modell vorzuhalten. Das andere Modell sollte lediglich komprimierte Aufgaben-Zusammenfassungen erhalten.
Sinnvolle Kombination von claude-sonnet-5-5 und claude-opus-5-5
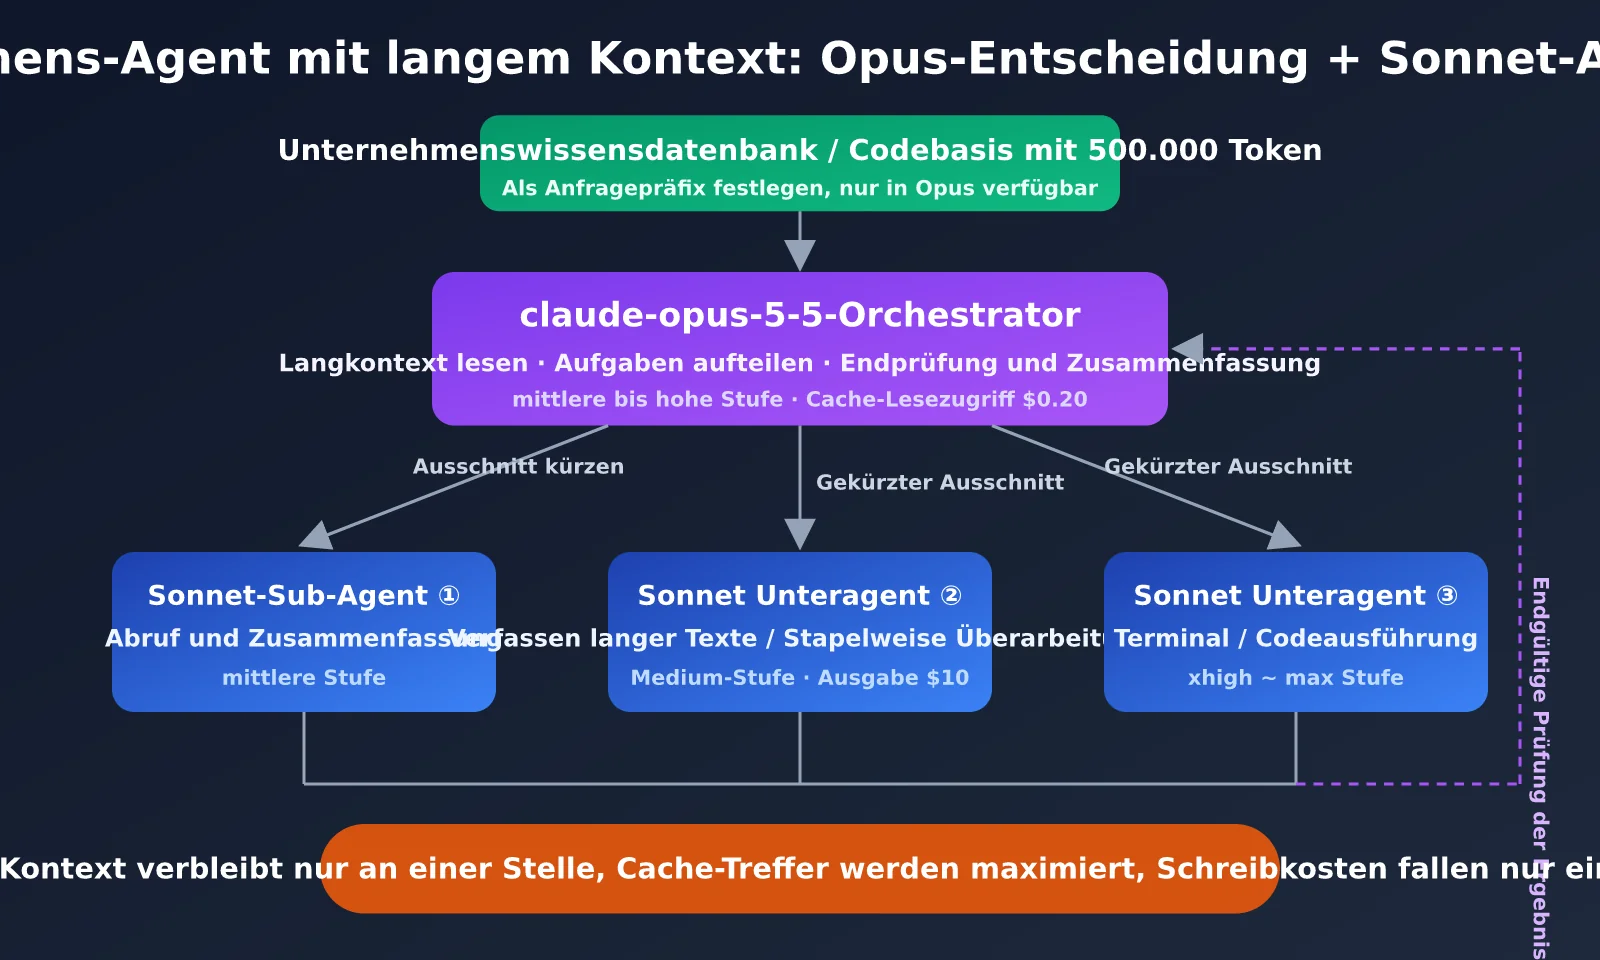
Auf Basis dieser Daten empfehlen wir für Enterprise-Agenten mit langen Inhalten eine geschichtete Architektur nach dem Prinzip „Opus entscheidet, Sonnet führt aus“. Je nachdem, welches Modell den langen Kontext hält, bieten sich zwei Betriebsmodi an.
Modus 1: Opus orchestriert, Sonnet-Sub-Agenten arbeiten parallel
Dieser Modus eignet sich für Szenarien, in denen auf Basis umfangreicher Unterlagen komplexe Entscheidungen getroffen werden müssen – etwa Vertragsprüfungen, Migrationen über mehrere Repositories oder Due-Diligence-Prüfungen. Opus hält den vollständigen langen Kontext vor und erzielt langfristig Cache-Treffer. Es versteht das Gesamtbild, zerlegt die Aufgabe und delegiert sie an mehrere Sonnet-Sub-Agenten. Jeder Sonnet-Sub-Agent erhält nur den für ihn relevanten Materialauszug sowie klare Anweisungen und arbeitet auf der Stufe „medium“ schnell parallel. Anschließend fasst Opus die Ergebnisse zusammen und nimmt die finale Prüfung vor.
So werden die Kosten für das Caching des teuren langen Kontexts nur einmal fällig. Sonnet übernimmt dagegen die umfangreiche Texterzeugung und profitiert vom halbierten Preis für Ausgabe-Token.
Modus 2: Sonnet im Frontend, Opus als Eskalationsinstanz
Dieser Modus passt zu interaktiven Szenarien mit hohem Anfragevolumen, etwa Fragen zu Unternehmenswissensdatenbanken, Kundenservice-Agenten oder internen IT-Assistenten. Sonnet hält den langen Kontext vor und liefert auf der Stufe „medium“ die ersten Token in etwa einer Sekunde. Bei geringer Zuversicht, Compliance-relevanten Einschätzungen oder expliziter Unzufriedenheit von Nutzern werden die verdichtete Anfrage und die wichtigsten Auszüge zur Bearbeitung an Opus eskaliert.
Der Großteil des Datenverkehrs wird so kostengünstig von Sonnet verarbeitet; nur wenige schwierige Anfragen erfordern Opus.
| Agent-Rolle | Empfohlenes Modell | Empfohlene Stufe | Begründung |
|---|---|---|---|
| Orchestrierung / Planung | claude-opus-5-5 | medium bis high | Höhere Gesamtintelligenz und faktische Genauigkeit, gute Token-Effizienz |
| Analyse langer Kontexte und finale Prüfung | claude-opus-5-5 | high bis xhigh | Deutliche Vorteile bei präzisen Entscheidungen in langen Kontexten |
| Verfassen langer Texte / Stapelumformulierungen | claude-sonnet-5-5 | medium | Halbierter Preis für Ausgabe-Token, schnellere Ausgabe pro Sekunde |
| Terminal- / Code-ausführende Sub-Agenten | claude-sonnet-5-5 | xhigh bis max | Bestes Ergebnis im Terminal-Bench bei maximaler Stufe |
| Echtzeit-Dialog im Frontend | claude-sonnet-5-5 | medium | Latenz bis zum ersten Token von etwa 1,3 Sekunden |
| Offline-Stapelverarbeitung | claude-sonnet-5-5 | medium | Batch: 1 $ / 5 $, unterstützt lange Ausgaben bis 300.000 Token |
Opus-Orchestrierung und Sonnet-Ausführung über dieselbe Schnittstelle
Im Folgenden ein minimales Beispiel für Modus 1. Beide Modelle werden über eine OpenAI-kompatible Schnittstelle aufgerufen und verwenden denselben API-Schlüssel:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
Aufklappen: vollständiges Beispiel mit parallelen Sub-Agenten und festem Langkontext-Präfix
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 长文档固定放在 system 前缀,只驻留在 Opus 上,便于多轮命中缓存
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet 子 Agent 只接收精简片段,并行执行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. 回到 Opus 终审,复用同一长上下文前缀
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 Schnellstart: Für Claude-Originalkonten gelten bei Registrierungsregion und Zahlungsmethode oft hohe Anforderungen, weshalb Unternehmen bereits bei der Freischaltung hängen bleiben. Registrieren Sie sich zunächst bei APIYI auf apiyi.com und nutzen Sie das Testguthaben. Mit einem API-Schlüssel können Sie sowohl claude-opus-5-5 als auch claude-sonnet-5-5 aufrufen, die oben beschriebene Architektur mit zwei Modellen testen und anschließend die Kosten für die Skalierung bewerten.
Entscheidungsempfehlungen für claude-sonnet-5-5 vs. claude-opus-5-5
Die vorangegangene Analyse lässt sich auf vier umsetzbare Grundsätze verdichten:
- Zuerst die Leistungsstufe festlegen, dann die Modelle vergleichen: Für Sonnet
mediumbisxhighnutzen, für Opusmediumbishigh. So vermeiden Sie die Token-Verschwendung durch die Sonnet-Standardstufehigh. - Lange Kontexte mit hoher Cache-Wiederverwendung an Opus übergeben: Cache-Lesezugriffe kosten bei beiden gleich viel. Opus ist nur rund 30 % teurer, liefert dafür aber höhere Genauigkeit und weniger Nacharbeit.
- Neue Materialien und lange Ausgaben an Sonnet übergeben: Cache-Schreibvorgänge und Output-Tokens kosten nur die Hälfte von Opus. Bei Offline-Aufgaben reduziert der Batch-Rabatt die Kosten zusätzlich um 50 %.
- Lange Kontexte nur an einer Stelle vorhalten: Caches können nicht modellübergreifend genutzt werden. Sub-Agenten sollten daher nur verdichtete Ausschnitte erhalten, damit Cache-Schreibvorgänge nicht mehrfach bezahlt werden.
Der Fast-Modus von Opus eignet sich für Szenarien, in denen die Antwortgeschwindigkeit einer einzelnen Anfrage extrem wichtig ist und genügend Budget vorhanden ist. Allerdings verdoppeln sich die Kosten, und der Cache wird nicht geteilt. Für die meisten Enterprise-Agenten ist es günstiger, Echtzeitinteraktionen mit Sonnet auf der Stufe medium abzuwickeln, statt für Opus den Fast-Modus zu aktivieren.
Häufige Fragen
Q1: claude-opus-5-5 ist bereits schnell – ist claude-sonnet-5-5 trotzdem noch sinnvoll?
Ja. Die hohe Geschwindigkeit von Opus resultiert vor allem aus einer niedrigeren Standard-Leistungsstufe und einer besseren Token-Effizienz. Bei Ausgabetokens pro Sekunde und der Latenz bis zum ersten Token liegt Sonnet jedoch weiterhin deutlich vorn; auch der Preis für Output-Tokens beträgt nur die Hälfte. Für lange Texte, Echtzeitdialoge und parallel arbeitende Sub-Agenten bleibt Sonnet daher die passendere Wahl.
Q2: Kann claude-sonnet-5-5 auf der Stufe max Opus ersetzen?
Bei speziellen Aufgaben wie Terminal-Programmierung ist das möglich: Sonnet (max) erzielt im Terminal-Bench 4.0 sogar ein besseres Ergebnis als Opus. Beim Gesamtindex der Intelligenz liegt es jedoch weiterhin 2 Punkte zurück. Zudem verbraucht Sonnet auf der Stufe max mehr Tokens, sodass die Gesamtkosten auf dem Niveau von Opus liegen oder dieses sogar leicht übersteigen. Wenn Sie maximale Qualität benötigen, ist Opus direkt einzusetzen meist wirtschaftlicher.
Q3: Wie lassen sich die Kosten beider Modelle für Enterprise-Agenten mit langen Dokumenten kontrollieren?
Entscheidend ist eine hohe Cache-Trefferquote: Halten Sie lange Dokumente als festen Anfragepräfix vor und lassen Sie nur ein Modell den vollständigen Kontext verwalten. Sub-Agenten erhalten ausschließlich verdichtete Ausschnitte. Empfehlenswert ist der Modellaufruf über APIYI apiyi.com: Beobachten Sie dabei die zurückgegebenen Cache-Token und passen Sie die Präfixstruktur schrittweise an. Die Cache-Trefferquote ist in der Regel der wirksamste Hebel zur Kostensenkung.
Q4: Was ist bei der Migration von Sonnet 5 oder Opus 5 auf 5.5 zu beachten?
Beide 5.5-Modelle enthalten Breaking Changes in der Schnittstelle: Der Denkmodus lässt sich nicht deaktivieren, erzwungene Tool-Aufrufe (tool_choice mit any oder tool) führen zu einem 400-Fehler, und das ältere Tool zur Computerbedienung muss aktualisiert werden. Führen Sie Regressionstests daher zunächst in einer Testumgebung aus, vergleichen Sie die Ausgaben alter und neuer Modelle parallel und schalten Sie den Produktionsverkehr erst danach um.
Fazit
Der Vergleich zwischen claude-sonnet-5-5 und claude-opus-5-5 ist nicht so simpel wie „teurer ist besser, günstiger ist schlechter“. Nach der Preissenkung kostet das Lesen aus dem Cache bei Opus 5.5 genauso viel wie bei Sonnet. Zudem ist die Standardstufe „medium“ bereits sehr effizient. Bei präzisen Bewertungen in langen Kontexten und bei der umfassenden Intelligenz liegt Opus klar vorn. Sonnet 5.5 bietet dagegen unersetzliche Vorteile bei Reaktionsgeschwindigkeit, Ausgabekosten, terminalnaher Programmierung und Ausführung mit hoher Parallelität. Sonnet hat also nicht nur einen Preisvorteil – seine Stärken kommen lediglich in der passenden Stufe und Rolle richtig zur Geltung.
Für Unternehmens-Agenten mit umfangreichen Eingaben und Ausgaben ist die sinnvollste Kombination: „Opus entscheidet, Sonnet führt aus“. Opus hält den langen Kontext und übernimmt Planung sowie abschließende Prüfung. Sonnet erledigt parallel das Schreiben und die Ausführung in der Stufe „medium“, während Offline-Anteile über Batch verarbeitet werden. In der Praxis empfiehlt es sich, zunächst Vergleichstests mit fest eingestellten Stufen durchzuführen, dann die Agenten anhand der in diesem Artikel beschriebenen Rollen aufzuteilen und die Kosten kontinuierlich über Cache-Trefferquote und Anzahl der Ausgabe-Token zu optimieren.
Wenn Sie dieses Zwei-Modell-Konzept schnell validieren möchten, empfiehlt sich der einheitliche Aufruf von claude-opus-5-5 und claude-sonnet-5-5 über APIYI apiyi.com. Die Plattform-API ist mit dem OpenAI-Format kompatibel. Mit einem einzigen Key können Sie flexibel zwischen beiden Modellen wechseln – ideal für Evaluierungstests und die Orchestrierung mehrerer Modelle in Produktionsumgebungen.
Quellen:
– Anthropic-Preisübersicht: platform.claude.com/docs/en/about-claude/pricing
– Anthropic-Dokumentation zum Fast-Modus: platform.claude.com/docs/en/build-with-claude/fast-mode
– Vergleich von Sonnet 5.5 und Opus 5.5 bei Artificial Analysis: artificialanalysis.ai
– Einordnung zur Veröffentlichung von Opus 5.5 bei Digital Applied: digitalapplied.com
– Vergleiche Sonnet 5.5 vs. Opus 5.5 von Kingy AI und Emergent: kingy.ai, emergent.sh
Über die Autoren: Das technische Team von APIYI konzentriert sich auf die API-Anbindung Großer Sprachmodelle und deren praktische Umsetzung in der Softwareentwicklung. Tauschen Sie sich gerne über APIYI apiyi.com zu Agent-Orchestrierung und Kostenoptimierung mit claude-opus-5-5 und claude-sonnet-5-5 aus.