Anmerkung des Autors: Teams, die OpenAI, Claude, Gemini und Qwen gleichzeitig anbinden, können innerhalb eines Kontos Token nach Projekt aufteilen und dann für jedes Token ein Kontingent, eine Gültigkeitsdauer, eine Modell-Whitelist und eine Gruppe festlegen – und über die Token-Logs die Abrechnung abgleichen.
Entwicklungsverantwortliche, die mehrere Modelle gleichzeitig anbinden, stoßen in der Regel auf drei Probleme. Erstens: Die Schlüssel liegen verstreut in den Backends der verschiedenen Anbieter, und es ist kaum noch nachvollziehbar, wer welchen Schlüssel in der Hand hat. Zweitens: Am Monatsende passen die Rechnungen nicht zu den Projekten – man weiß nicht, welches Projekt wie viel ausgegeben hat. Drittens: Sobald ein Schlüssel an mehrere Personen gemeinsam weitergegeben wird und man eine einzelne Person ausschließen möchte, bleibt nur, den ganzen Schlüssel ungültig zu machen. Dieser Artikel stellt ein Verwaltungsmodell mit einem APIYI-Konto + Token-Aufteilung nach Projekt vor und bringt Multimodell-Management im Unternehmen auf Konfigurationsschritte, die man tatsächlich ausführen kann.
Das hier ist kein weiterer Aufklärungsartikel zu der Frage, „warum man einen API-Proxy-Dienst braucht“. Jeder der unten beschriebenen Konfigurationspunkte entspricht den Erläuterungen zu Token und Gruppen in der APIYI-Dokumentation unter apiyi.com. Bei allen Zahlen zu Rate und Gruppierung ist jeweils angegeben, dass sie aus dem Originaltext der Dokumentation stammen.
Der Kernnutzen: Nach dem Lesen dieses Artikels können Sie für jedes Projekt ein eigenes Token anlegen, begrenzen, wie viel es ausgeben darf, wie lange es gültig ist, welche Modelle es aufrufen darf und welche Gruppe es verwendet – und im Token-Log den Verbrauch jedes einzelnen Projekts nachschlagen.
Kernpunkte für das Multi-Modell-Management im Unternehmen: Schlüssel, Kontingente und Logs pro Projekt getrennt verwalten
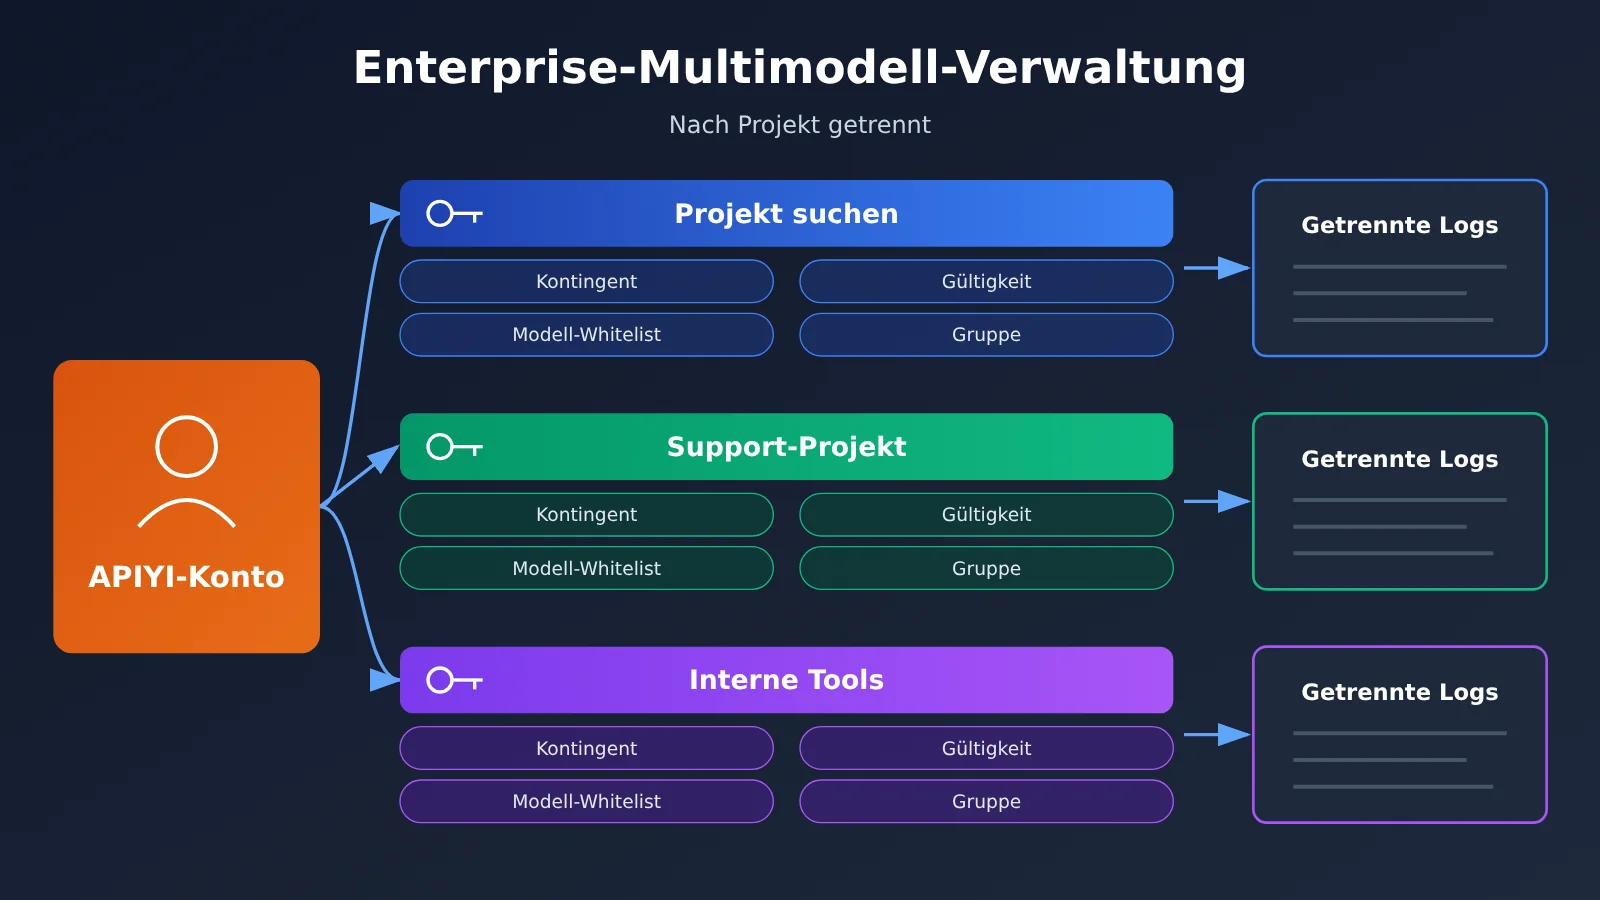
Beim Multi-Modell-Management im Unternehmen kommt es darauf an, die Verwaltungsgrenzen aufzuteilen, statt alles in einem Universalschlüssel zu bündeln. Bei APIYI ist ein Token gleichbedeutend mit einem API-Schlüssel und beginnt mit sk-. In der Dokumentation heißt es: Für jedes Token lassen sich Kontingent, Ablaufzeit, verfügbare Modelle und Gruppe separat festlegen; auch Verbrauch, Restkontingent und Aufrufprotokolle werden getrennt erfasst.
| Punkt | Erläuterung | Nutzen für Entwicklungsverantwortliche |
|---|---|---|
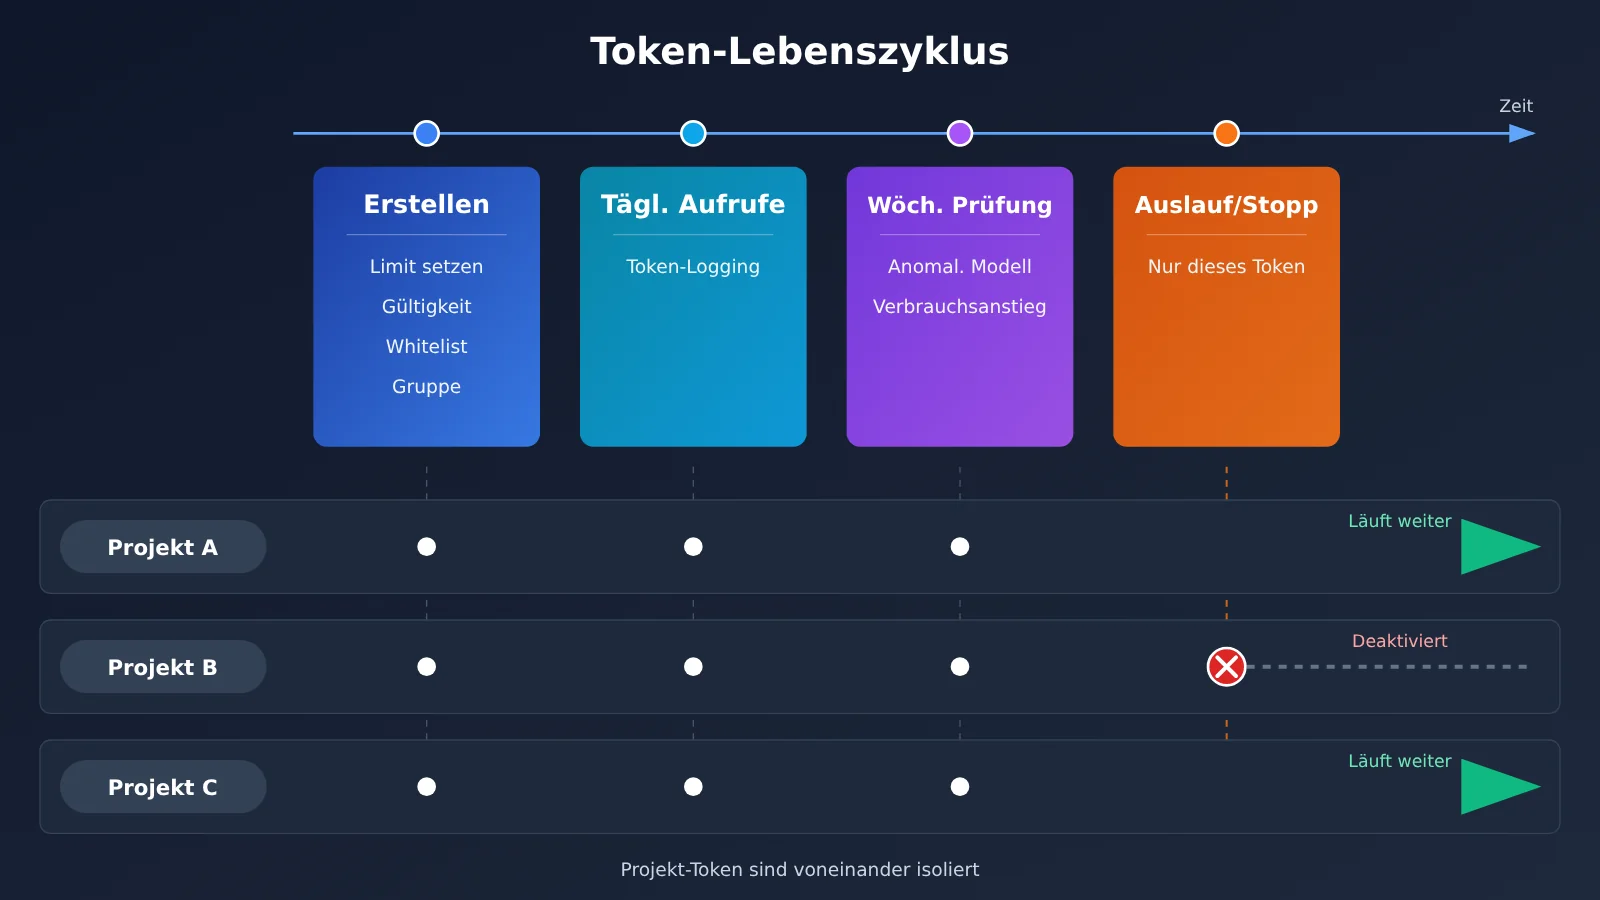
| Token pro Projekt anlegen | Nach der Registrierung gibt es ein Standard-Token; zusätzlich lässt sich für jedes Projekt und jedes Teammitglied ein eigenes Token anlegen | Wird eine Person oder ein Projekt deaktiviert, bleiben andere Aufrufer davon unberührt |
| Kontingent und Gültigkeit separat festlegen | Für jedes Token lassen sich Obergrenze und Ablaufzeit setzen | Budgetüberschreitungen und auslaufende Outsourcing-Verträge lassen sich im Voraus begrenzen |
| Modell-Whitelist | Ohne Whitelist stehen alle über 200 ausgewählten Modelle der Plattform zur Verfügung (so steht es im Originaldokument); nach dem Festlegen sind nur die angegebenen Modelle nutzbar | Verhindert, dass ein Projekt eigenmächtig auf teure Modelle umschwenkt |
| Die Gruppe bestimmt Kanal und Multiplikator | Die Gruppe legt Upstream, verfügbare Modelle und Abrechnungsmultiplikator fest | Dasselbe Modell kann in unterschiedlichen Gruppen zu unterschiedlichen Rechnungen führen |
| Logs pro Token getrennt | Verbrauch und Aufrufprotokolle jedes Tokens lassen sich separat einsehen | Die Monatsabrechnung lässt sich direkt pro Projekt zuordnen |
Warum im Enterprise-Multi-Modell-Management Tokens pro Projekt aufgeteilt werden
Ein Punkt aus der Dokumentation sollte vorab klar sein: Wenn ein Token von mehreren Personen genutzt wird, richtet sich das Rate Limit nach dem Account und nicht nach der Anzahl der Tokens. Im Originaltext der Dokumentation steht, dass ein einzelner Account in der Regel bis zu 100 RPM unproblematisch ist und TPM nicht bewertet wird. Das ist eine Aussage aus der Dokumentation, kein Ergebnis eines Lasttests, und stellt auch keine SLA dar.
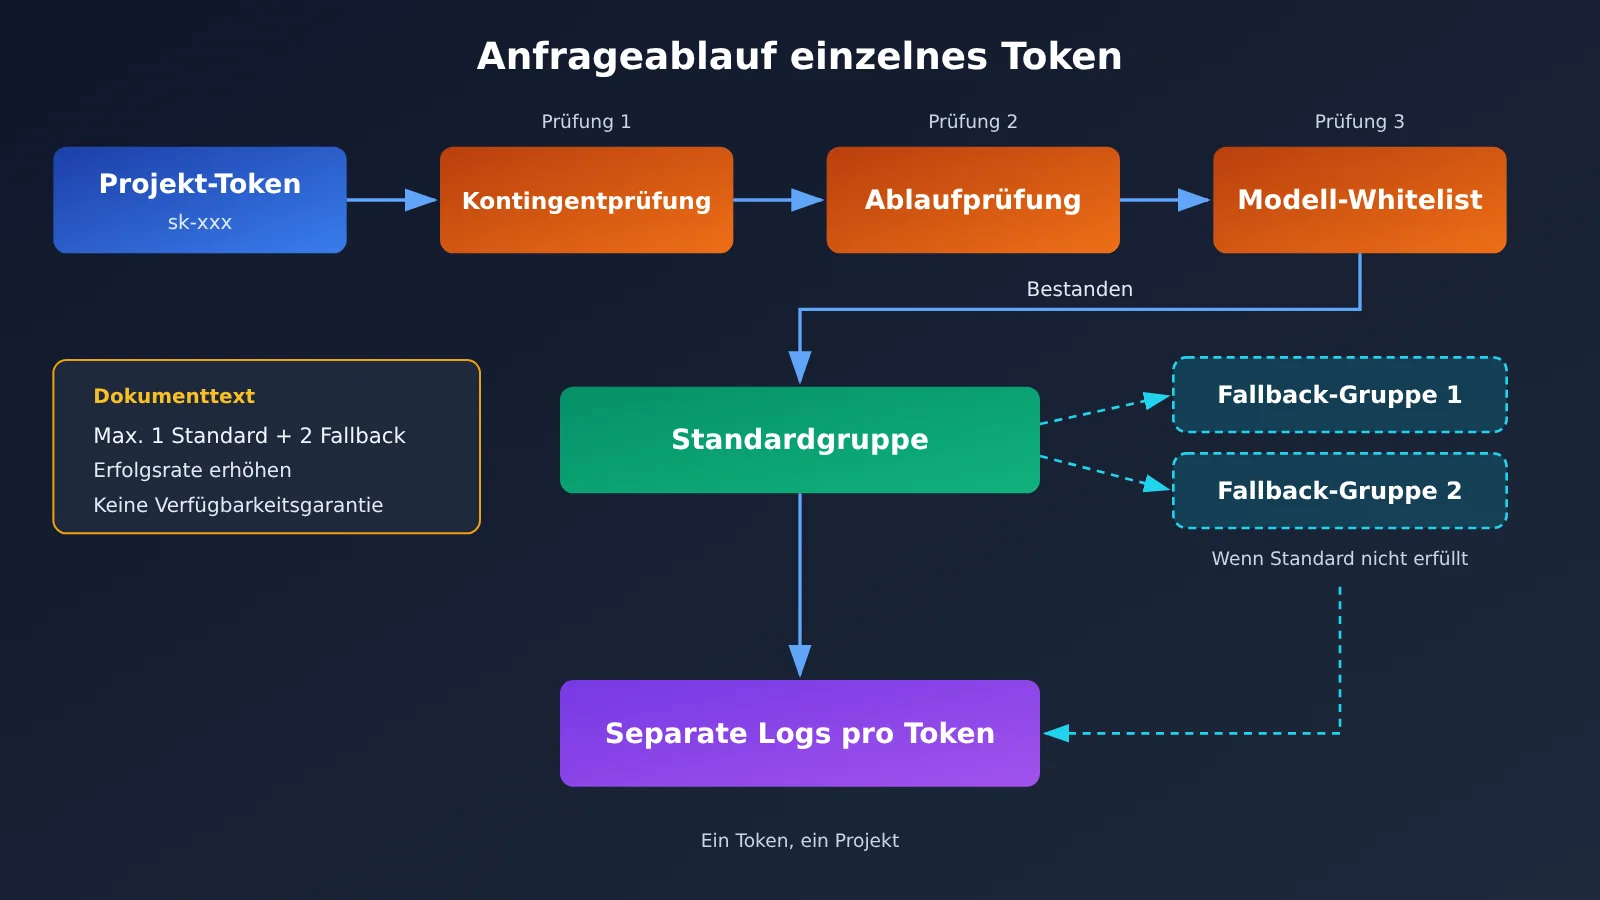
Der Zweck der Token-Aufteilung besteht daher nicht darin, das Rate Limit zu umgehen, sondern darin, eine Isolierung auf Managementebene zu schaffen. Ein Token entspricht einem Projekt oder einem Mitglied: Tritt ein Problem auf, lässt sich genau dieses eine Token stoppen, und bei der Abrechnung kann man genau dieses eine Token betrachten. Wenn alle das Standard-Token gemeinsam nutzen, vermischt sich der Verbrauch in den Logs, lässt sich nicht nach Projekt aufteilen, und man kann einen bestimmten Aufrufer nicht gezielt abschalten.
Gruppen und Fallback-Regeln im Enterprise-Multi-Modell-Management
Eine Gruppe ist ein Ressourcenkanal. Laut Originaltext der Dokumentation lassen sich pro Token maximal 1 Standardgruppe und 2 Fallback-Gruppen konfigurieren. Fallback bedeutet: Kann die Standardgruppe die Anfrage nicht erfüllen, wechselt das System automatisch zur Fallback-Gruppe. Die Dokumentation beschreibt den Fallback als „Erhöhung der Erfolgsquote beim Aufruf“ und nicht als Verfügbarkeitsversprechen – man sollte es also nicht als „fällt niemals aus“ verstehen.
Die überwiegende Mehrheit der Textmodelle lässt sich einfach mit der Gruppe Default nutzen. Spezifische Modelle wie etwa Video-Modelle benötigen eine andere Gruppe; fehlt diese Gruppe im Token, kann das entsprechende Modell nicht aufgerufen werden. Außerdem gilt zu beachten: „200+ Modelle“ bezeichnet die Gesamtzahl der ausgewählten Modelle auf der gesamten Plattform und bedeutet nicht, dass jedes Modell in der Gruppe Default liegt. Maßgeblich ist die Gruppe, die auf der Seite des jeweiligen Modelltyps angegeben ist.
Schnelleinstieg ins Multi-Modell-Management für Unternehmen: In 5 Schritten projektspezifische API-Token anlegen
Am Beispiel eines Teams mit drei Projekten – einem Projekt zur Suchanreicherung, einem Kundenservice-Chatbot-Projekt und einem internen Schreibtool – zeigen wir den vollständigen Konfigurationsablauf. Einstiegspunkt ist die API-Token-Seite https://api.apiyi.com/token.
Schritt 1: Token planen – ein API-Token pro Projekt oder Person
Erstellen Sie zuerst eine Token-Planungstabelle und legen Sie die Token anschließend im Backend an. So vermeiden Sie, dass Sie beim Anlegen ständig Änderungen vornehmen und am Ende wieder bei „ein Schlüssel für alle“ landen.
| API-Token-Name | Verwendet von | Modell-Whitelist | Standardgruppe | Fallback-Gruppe | Empfehlung für Kontingent und Gültigkeit |
|---|---|---|---|---|---|
proj-search |
Dienst zur Suchanreicherung | gemini-3.8-flash, qwen3.8-max |
Default |
Gruppen laut Modellseite konfigurierbar | Kontingent am Monatsbudget ausrichten, langfristig gültig |
proj-support |
Kundenservice-Chatbot | claude-sonnet-5-5 |
Default |
Gruppen laut Modellseite konfigurierbar | Kontingent am Monatsbudget ausrichten |
team-writing-zhang |
Persönliches Tool eines Teammitglieds | claude-opus-5-5 |
Default |
Nicht festgelegt | Kleines Kontingent, Ablaufdatum festlegen |
vendor-outsource |
Outsourcing-Team | Nur die für die Lieferung benötigten Modelle eintragen | Default |
Nicht festgelegt | Kontingent an Vertragslaufzeit ausrichten; läuft bei Ablauf automatisch aus |
Die Verwaltungsempfehlungen in der Tabelle geben unsere Einschätzung wieder. Welche Gruppen ein konkretes Modell umfasst, richtet sich nach der jeweiligen Modellseite; übernehmen Sie die Tabelle nicht ungeprüft.
Schritt 2: Token anlegen und vier Einschränkungen setzen
Wenn Sie auf der Token-Seite ein neues Token anlegen, füllen Sie der Reihe nach vier Punkte aus:
- Kontingent: Nach dem Monatsbudget des Projekts eintragen. Ist das Kontingent aufgebraucht, bucht dieses Token nichts mehr ab, andere Tokens bleiben unberührt.
- Ablaufdatum: Bei Outsourcing und temporären Mitgliedern unbedingt setzen – nach Ablauf ist kein manuelles Einsammeln nötig.
- Verfügbare Modelle (Whitelist): Nur die Modelle ankreuzen, die das Projekt wirklich braucht. Leer lassen heißt, alle Modelle der Plattform freizuschalten – davon raten wir ab.
- Gruppe: Zuerst die Standardgruppe wählen, dann nach Bedarf bis zu 2 Ausweichgruppen ergänzen.
Schritt 3: Schlüssel in Umgebungsvariablen ablegen und Variablennamen je Projekt trennen
Schlüssel gehören nicht fest in den Code oder ins Repository. Besser: Jedes Projekt bekommt einen eigenen Umgebungsvariablennamen, zum Beispiel in der Deployment-Umgebung APIYI_KEY_SEARCH=sk-... und APIYI_KEY_SUPPORT=sk-..., die dann vom jeweiligen Dienst gelesen werden. So muss beim Rotieren eines Projektschlüssels nur eine einzige Variable geändert werden.
Schritt 4: Aufruf über die OpenAI-kompatible Schnittstelle
APIYI bietet eine OpenAI-kompatible Schnittstelle – bei der Anbindung müssen nur zwei Dinge geändert werden:
base_urlaufhttps://api.apiyi.com/v1setzenapi_keyaus der eigenen Umgebungsvariable des Projekts lesen, zum Beispielos.environ["APIYI_KEY_SEARCH"]
Mit dem offiziellen Python-SDK besteht der Kern im Grunde aus einer einzigen Initialisierungszeile: client = OpenAI(api_key=os.environ["APIYI_KEY_SEARCH"], base_url="https://api.apiyi.com/v1"). Danach genügt der Aufruf von client.chat.completions.create(model="gemini-3.8-flash", messages=[...]). Wenn Sie model auf eine Modellbezeichnung außerhalb der Whitelist setzen, lässt sich das Modell mit diesem Token nicht aufrufen. Genau das soll die Whitelist bewirken.
Schritt 5: Wöchentlich die Token-Logs prüfen, am Monatsende pro Token abrechnen
Verbrauch, verbleibendes Guthaben und Aufruf-Logs lassen sich für jedes Token einzeln einsehen. Wir empfehlen, die Logs der einzelnen Token einmal pro Woche durchzugehen und dabei vor allem zwei Dinge zu prüfen: ob unerwartete Modellbezeichnungen auftauchen und ob die Verbrauchskurve plötzlich ansteigt. Am Monatsende lässt sich dann pro Token zusammenfassen, sodass eine nach Projekten aufgeschlüsselte Kostenübersicht entsteht.
🎯 Technischer Tipp: Bei der erstmaligen Einführung sollten Sie zunächst das Standard-Token deaktivieren oder nur Administratoren vorbehalten und dann auf der Token-Seite von APIYI apiyi.com gemäß der obigen Planungstabelle Token für Token anlegen. So lässt sich vom ersten Tag an jeder Aufruf im Log einem konkreten Projekt zuordnen.
Die Abrechnung beim Multi-Modell-Management im Unternehmen: Ein Modellwechsel ändert die Rechnung
Der am leichtesten übersehene Punkt in Multi-Modell-Teams: Ein anderes Modell oder eine andere Gruppe – und die Rechnung ändert sich gleich mit. Die folgenden Preise stammen aus der Modell-Gesamtliste von APIYI, es sind die Standard-Listenpreise pro Million Token, Datenstand 2026-11-16 09:39 (UTC+8).
| Modell-ID | Eingabepreis | Ausgabepreis | Cache-Lesen | In der Doku angegebene Endpunkte / Gruppen | Verfügbare Plattform |
|---|---|---|---|---|---|
claude-opus-5-5 |
$4 | $20 | $0.2 | Endpunkte chat und messages | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | maßgeblich ist die Modellseite | APIYI |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Endpunkte chat und messages; Gruppen ClaudeCode, Default, SVIP | APIYI |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse Faktor 0.5×, Default und SVIP 1× | APIYI |
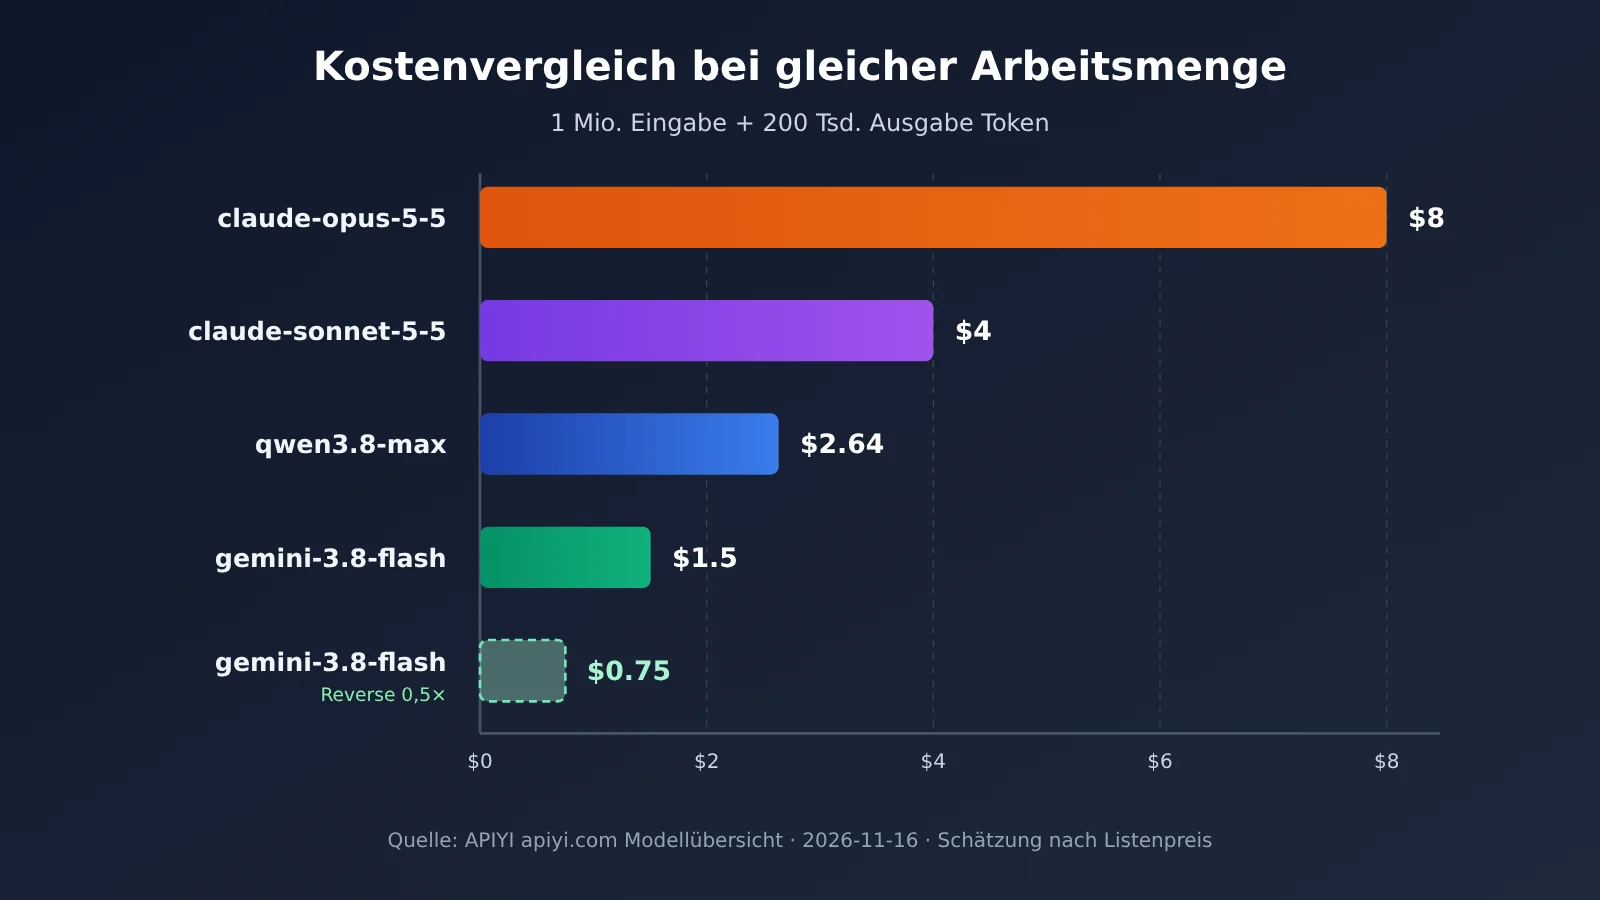
Laut Dokumentation lautet die Formel für die nutzungsbasierte Abrechnung: Eingabe-Token × Eingabepreis + Ausgabe-Token × Ausgabepreis. Nehmen wir an, ein Projekt verbraucht monatlich 1 Million Eingabe-Token und 200.000 Ausgabe-Token – geschätzt nach Listenpreis:
claude-opus-5-5: 4 + 0.2 × 20 = $8claude-sonnet-5-5: 2 + 0.2 × 10 = $4qwen3.8-max: 1.65 + 0.2 × 4.95 = $2.64gemini-3.8-flash(Default, 1×): 0.75 + 0.2 × 3.75 = $1.5; über Gemini_Reverse (0.5×) sind es nach Faktor umgerechnet etwa $0.75
Man sieht: Bei gleicher Arbeit kann ein Modellwechsel die Kosten um ein Mehrfaches verschieben, und eine andere Gruppe verändert direkt die tatsächliche Abbuchung. Wer Tokens über Whitelist und Gruppe zuordnet, setzt damit im Grunde eine Obergrenze für den Stückpreis des Projekts. Bei Modell- und Preisrecherchen gilt die Modellliste von APIYI apiyi.com als Referenz. Erst prüfen, in welchen Gruppen ein Modell läuft und wie der Faktor aussieht, dann in das passende Token aufnehmen. Die Aufrufadresse ist einheitlich https://api.apiyi.com/v1; für einen Modellwechsel muss nur der model-Parameter geändert werden, base_url bleibt gleich.
Wenn das Team gerade ein neu veröffentlichtes Modell prüft, etwa das am 2026-11-16 von Alibaba Cloud veröffentlichte qwen4-max, gilt: Es steht derzeit nicht in der Gesamtliste und ist auch über die Preisschnittstelle der Plattform nicht abfragbar. Noch nicht verfügbar – wir stellen dieses Modell so bald wie möglich bereit; Modelle und Preise richten sich nach der Modellliste der Plattform. Vor der Bereitstellung sollte es in keiner Whitelist-Planung für Tokens auftauchen.
Abrechnungsmodelle in der Unternehmens-Multimodell-Verwaltung: mengenbasiert und pro Aufruf nicht vermischen
Die Dokumentation empfiehlt für Textmodelle den Vorrang der mengenbasierten Abrechnung. Die Abrechnung pro Aufruf ist ein Festpreis je Anfrage und wird vor allem für Bilder und Videos verwendet. Wenn dasselbe API-Token sowohl Text- als auch Bildaufgaben ausführt, erscheinen im Log gleichzeitig zwei Arten von Einträgen – token-basierte Abrechnung und Abrechnung pro Aufruf –, die unterschiedliche Einheiten haben und sich nicht direkt summieren lassen.
Sicherer ist es, für Textprojekte und für Bild- bzw. Videoprojekte getrennte API-Token anzulegen. Exklusive Modelle wie Video benötigen ohnehin eine eigene Gruppe; nach der Trennung sind Gruppenkonfiguration und Abrechnungseinheiten deutlich übersichtlicher.
| Abrechnungsart | Berechnungsweise (Originaltext der Dokumentation) | Typischer Einsatz | Empfehlung zur Token-Aufteilung |
|---|---|---|---|
| mengenbasiert | Eingabe-Token × Eingabepreis + Ausgabe-Token × Ausgabepreis | Textdialoge, Code, Zusammenfassungen | ein eigenes Token für Textprojekte, die Dokumentation empfiehlt mengenbasiert |
| pro Aufruf | Festpreis je Anfrage | Bilderzeugung, Videogenerierung | ein eigenes Token für Bilder / Videos, dazu die passende exklusive Gruppe |
Zur Abrechnung schreibt die Dokumentation, dass Aufladungen zu einem festen Kurs von 1:7 verrechnet werden, kombinierbar mit Auflade-Rabatten; die tatsächliche Belastung richtet sich nach der Konsole. Beschaffungsprozesse, Verträge und Rechnungen sind nicht Gegenstand dieses Artikels – wenden Sie sich bei Bedarf direkt an die Plattform.
💡 Auswahl-Tipp: Legen Sie für teure Modelle (z. B.
claude-opus-5-5) ein eigenes API-Token mit kleinem Limit an und geben Sie es nur an die Personen weiter, die es wirklich brauchen. In das Token für alltägliche Batch-Aufgaben kommen nur Modelle mit niedrigem Stückpreis. Wenn Sie bei APIYI apiyi.com anhand der Modellliste erst Gruppen und Multiplikatoren prüfen und dann zuweisen, vermeiden Sie überraschende Rechnungen am Monatsende.
Häufig gestellte Fragen (FAQ) zum Unternehmens-Multimodell-Management
Q1: Was ist Unternehmens-Multimodell-Management mit projektbezogener Token-Aufteilung?
Dabei wird in einem Konto für jedes Projekt oder jedes Teammitglied ein eigener API-Schlüssel (Token) angelegt. Für jedes Token werden separat Kontingent, Ablaufzeit, Modell-Whitelist und Gruppe festgelegt. Verbrauch und Aufrufprotokolle werden pro Token getrennt erfasst, sodass sich Deaktivierung und Abrechnung projektgenau nachvollziehen lassen.
Q2: Wenn ich viele Token anlege, verdoppelt sich dann die Ratenbegrenzung?
Nein. Die Dokumentation stellt klar, dass die Ratenbegrenzung am Konto hängt und unabhängig von der Anzahl der Token ist. Im Originaltext der Dokumentation steht, dass ein einzelnes Konto in der Regel bis zu 100 RPM problemlos verkraftet und TPM nicht bewertet wird. Das ist lediglich eine Aussage der Dokumentation, kein SLA. Das Aufteilen von Token dient der Verwaltungsisolierung, nicht der Erhöhung des Kontingents.
Q3: Bedeutet die Konfiguration einer Fallback-Gruppe, dass es keine Fehler mehr gibt?
Nein. Laut Originaltext der Dokumentation hat ein Token maximal 1 Standardgruppe plus 2 Fallback-Gruppen. Die Fallback-Gruppe springt automatisch ein, wenn die Standardgruppe eine Anfrage nicht erfüllen kann; ihr Zweck ist die Erhöhung der Erfolgsrate von Aufrufen. Auf der Geschäftsseite müssen dennoch Retry- und Degradationslogik beibehalten werden.
Q4: Was passiert, wenn keine Modell-Whitelist gesetzt wird?
Originaltext der Dokumentation: Ohne Whitelist kann das Token alle über 200 ausgewählten Modelle der gesamten Plattform nutzen. Für die Verwaltung ist das mit relativ hohem Risiko verbunden, da ein Projekt versehentlich auf ein teures Modell umschalten könnte. In Unternehmensszenarien empfiehlt es sich, jedem Token nur die Modelle zuzuweisen, die das Projekt tatsächlich benötigt.
Q5: Wie ändere ich vorhandenen OpenAI-SDK-Code so, dass er projektbezogene Token verwendet?
Es sind nur zwei Änderungen nötig: Setzen Sie `base_url` auf `https://api.apiyi.com/v1` und ändern Sie `api_key` so, dass er aus der projekteigenen Umgebungsvariable gelesen wird. Token werden auf der Token-Seite von APIYI apiyi.com erstellt; zum Wechseln des Modells muss nur der `model`-Parameter geändert werden.
Q6: Warum kann ein bestimmtes Videomodell mit meinem Token nicht aufgerufen werden?
Exklusive Modelle wie Videomodelle benötigen eine eigene Gruppe. Ist diese Gruppe im Token nicht konfiguriert, ist das Modell nicht verfügbar. Sehen Sie auf der Seite des jeweiligen Modells nach, zu welcher Gruppe es gehört, und ergänzen Sie sie in den Gruppeneinstellungen des Tokens; alternativ können Sie für das Videogeschäft ein eigenes Token anlegen.
Q7: Warum unterscheidet sich die Abrechnung desselben Modells zwischen verschiedenen Projekten?
Das liegt meist an unterschiedlichen Gruppen-Multiplikatoren. Beispielsweise ist auf der Modellseite von `gemini-3.8-flash` angegeben, dass der Gruppen-Multiplikator für Gemini_Reverse 0,5× beträgt, während Default und SVIP 1× sind. Bei der Abrechnung müssen Modell und Gruppe gemeinsam geprüft werden, nicht nur der Listenpreis.
Q8: Welche Einschränkungen hat diese Vorgehensweise?
Die Token-Aufteilung löst das Problem der Isolation von Schlüsseln, Kontingenten und Protokollen, kann aber weder die Ratenbegrenzung des Kontos erhöhen noch die Retry- und Monitoring-Logik der Geschäftsseite ersetzen. Neu veröffentlichte Modelle können erst in die Whitelist aufgenommen werden, nachdem sie auf der Plattform verfügbar sind. Konkrete Preise und Gruppen richten sich nach der Modellliste von APIYI apiyi.com.
Kernpunkte für das Multi-Modell-Management im Unternehmen
- Token sind Schlüssel: Sie beginnen mit
sk-; legen Sie je Projekt oder Teammitglied ein eigenes Token an, damit Sie es separat deaktivieren können. - Alle vier Begrenzungen gemeinsam setzen: Kontingent, Ablaufzeit, Modell-Allowlist und Gruppe – fehlt eine davon, bleibt eine Verwaltungslücke.
- Das Rate-Limit hängt am Konto: Laut Dokumentation sind bis zu 100 RPM in der Regel unproblematisch, TPM wird nicht bewertet; das Aufteilen von Tokens erhöht das Kontingent nicht.
- Fallback ist keine Garantie: Maximal 1 Standard- plus 2 Fallback-Gruppen (laut Dokumentation); sie sollen die Erfolgsquote erhöhen.
- Modellwechsel ändert die Abrechnung: Stückpreis des Modells und Gruppenmultiplikator bestimmen gemeinsam die tatsächliche Belastung; nur mit einem Abgleich pro Token wird das nachvollziehbar.
- Text und Bilderzeugung getrennt halten: Die Einheiten für verbrauchsbasierte und aufrufbasierte Abrechnung unterscheiden sich; getrennte Tokens erleichtern den Abgleich.
- Einheitlicher Einstiegspunkt: Alle Projekte laufen über
https://api.apiyi.com/v1; Berechtigungen und Abrechnung werden ausschließlich über Tokens unterschieden.
Zusammenfassung
Für das Multi-Modell-Management im Unternehmen braucht es keinen Generalschlüssel, der alle Hersteller-Backends öffnet. Stattdessen sollten Sie Berechtigungen nach Projekt aufteilen:
- Schlüssel nach Projekt trennen: ein Token pro Projekt oder Person; Deaktivierung und Rotation wirken sich nicht gegenseitig aus.
- Kontingente und Modelle begrenzen: Gesamtkosten über Kontingente steuern, Preise über Allowlist und Gruppen.
- Logs pro Token abgleichen: wöchentlich Anomalien prüfen, am Monatsende Kosten pro Token zusammenfassen.
Empfehlung: Erstellen Sie zuerst anhand des ersten Schritts in diesem Artikel eine Token-Planungstabelle und legen Sie dann auf der Token-Seite von APIYI apiyi.com jedes Token einzeln an. Prüfen Sie Modell, Preis und Gruppe anhand der Modellliste der Plattform – so bringen Sie die Abrechnung für mehrere Modelle in einem Durchgang in Ordnung.
📚 Referenzen
-
APIYI-Dokumentationszentrum: Tokens und Gruppen, Abrechnungsmodelle, Modellübersicht
- Link:
docs.apiyi.com - Beschreibung: Entspricht den Pfaden
/faq/token-and-groups.md,/faq/token-billing-modes.md,/models.mdund/models/gemini-3-8-flash.md. Die Angaben zu Tokens, Gruppen und Preisen in diesem Artikel richten sich nach diesen Quellen.
- Link:
-
Alibaba Cloud Bailian Qwen4-Max – Herstellerangaben: Informationen zur Veröffentlichung durch den Hersteller
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Beschreibung: Dieses Modell wurde am 16.11.2026 vom Hersteller veröffentlicht; der Verfügbarkeitsstatus auf der Plattform richtet sich nach der Modellliste.
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Hinweise zur Konfiguration von Tokens und Gruppen finden Sie im Dokumentationszentrum.