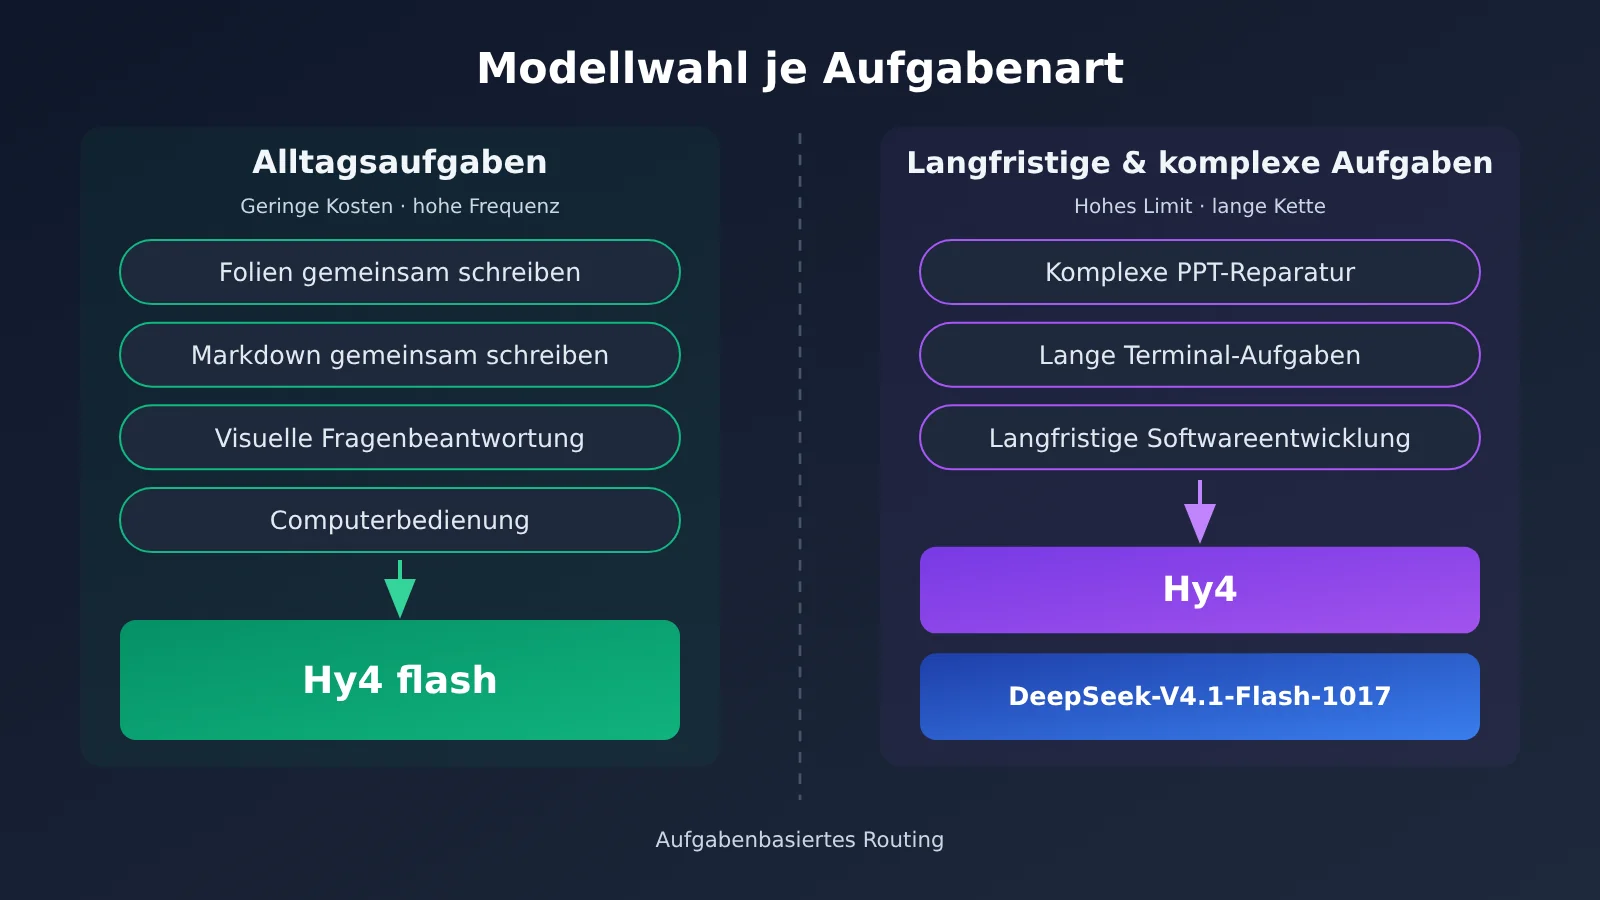
Anmerkung des Autors: Dieser Artikel zerlegt Hy4 flash nach Aufgaben: Spezifikationen, manuelle Blindtests, WorkIndex und die Punktzahlen im Anhang. Das Fazit: Für alltägliche Aufgaben wie gemeinsames Erstellen von Folien, Markdown, Visual Question Answering und Computer-Bedienung kann man es durchaus in Betracht ziehen; bei komplexer PPT-Reparatur, langen Terminal-Aufgaben und langfristiger Softwareentwicklung sollte man weiterhin Hy4 oder DeepSeek-V4.1-Flash-1017 verwenden.
Zuerst die Schlussfolgerung. Wenn Sie ein Modell für den alltäglichen Bürogebrauch oder leichte Agenten auswählen, eignet sich Hy4 flash für Alltagsaufgaben wie gemeinsames Erstellen von Folien, gemeinsames Erstellen von Markdown, Visual Question Answering und Computer-Bedienung. Wenn es um die Reparatur komplexer PPTs, lange Terminal-Aufgaben oder langfristige Softwareentwicklung geht, ist ein Wechsel von Hy4 oder DeepSeek-V4.1-Flash-1017 nicht zu empfehlen.
Tencent Hunyuan hat am 16.11.2026 eine Forschungsseite und einen offiziellen Beitrag veröffentlicht, in denen behauptet wird, Hy4 flash komme in manuellen Blindtests bei alltäglichen Arbeitsschritten nahe an Claude Haiku 5.5 heran, bei deutlich niedrigeren Aufgabenkosten. Das ist nicht die Geschichte von „ein günstiges Modell erledigt alles“. Der Anhang derselben Forschungsseite zeigt, dass es bei Terminal- und langfristigen Coding-Benchmarks deutlich hinter Hy4 zurückliegt. Die in diesem Artikel zitierten Blindtests, WorkIndex-Werte, Anhänge und Produktaussagen stammen alle aus Tencent-eigenen Angaben bzw. aus dem Originaltext der Forschungsseite; eine Replikation durch Dritte gibt es nicht.
Kernaussage: Nach dem Lesen dieses Artikels haben Sie eine Auswahltabelle nach Aufgaben vor sich und wissen genau, wo Hy4 flash stark ist, wo es schwach ist und wann ein Wechsel nicht sinnvoll ist.
Wie leistungsstark ist Hy4 flash? Die task-spezifische Auswahl im Überblick
Die folgende Tabelle ist nach Aufgabentypen gegliedert. Grundlage sind die empfohlenen Einsatzbereiche und die Anhangswerte der Forschungsseite. Die „bevorzugte Auswahl“ ist lediglich eine Einschätzung zur Auswahl und bedeutet nicht, dass ein Modell bei dieser Aufgabenart umfassend führend ist.
| Aufgabentyp | Bevorzugte Auswahl | Grundlage (Originaltext der Forschungsseite/Anhang) |
|---|---|---|
| Präsentationen gemeinsam verfassen (Mensch + KI) | Hy4 flash | PPTCoEditBench 74.0, Hy4 78.9, Kosten pro Aufgabe etwa 1/16 der Kosten von Hy4 |
| Markdown gemeinsam verfassen (Mensch + KI) | Hy4 flash | MdCoEditBench 56.9, nahe an 57.7 bei Hy4, deutlich höher als 29.2 bei DeepSeek |
| Visuelle Fragebeantwortung (ohne Tools) | Hy4 flash nutzbar, aber nicht der Beste | BuddyVQA 48.5, höher als 43.7 bei DeepSeek, niedriger als 55.5 bei Hy4 |
| Computerbedienung | Hy4 flash nutzbar | OSWorld 2.1: 68.1, nahe an 68.4 bei DeepSeek; Hy4: 78.9 |
| Komplexe PPTs reparieren | Hy4 oder DeepSeek-V4.1-Flash-1017 | PPTFixBench 23.7, Hy4 45.6, DeepSeek 45.3 |
| Lange Terminal-Aufgaben | Hy4 oder DeepSeek-V4.1-Flash-1017 | Terminal-Bench 4.0 nur 19.2, Hy4 44.4 |
| Softwareentwicklung mit langem Zeithorizont | Hy4 | Forschungsseite empfiehlt es ausdrücklich; ProgramBench 16.0 gegenüber 30.0 bei Hy4 |
Die Logik hinter dieser Tabelle ist einfach: Bei Aufgaben mit kurzen Ergebnissen, vielen Interaktionsrunden und Kostenempfindlichkeit geht es an Hy4 flash. Aufgaben mit langen Schrittketten, kontinuierlichem Schlussfolgern und wiederholtem Reparieren gehen an ein Modell mit höherem Intelligenzlimit. Die Forschungsseite empfiehlt genau das: Für Deep Search, Dokumentenverarbeitung, Präsentationserstellung, einfache Frontend-Demos und Computerbedienung Hy4 flash verwenden, für Softwareentwicklung mit langem Zeithorizont weiterhin Hy4.
Die häufigsten Fallstricke bei der Auswahl von Hy4 flash
Das häufigste Missverständnis besteht darin, „nahe an Haiku“ als „umfassend besser als Haiku“ zu lesen. Im Blindtest liegt die Zufriedenheit mit Hy4 flash 0.02 Punkte niedriger als mit Haiku; die Forschungsseite verwendet dafür den Begriff close to. Das zweite Missverständnis ist das Vermischen mehrerer Sätze von Kostenmultiplikatoren. Die Werte 1/8, 1/13 und 1/20 im WorkIndex folgen einer Berechnungsgrundlage; die Renminbi-Kosten pro Aufgabe in der Blindtest-Tabelle folgen einer anderen. Beide lassen sich nicht gegeneinander austauschen.
Kernfunktionen und Spezifikationen von Hy4 flash
Die Forschungsscite nennt folgende Spezifikationen. Eine API-Modell-ID wird dort nicht angegeben, deshalb erfindet dieser Artikel keinen Modellnamen. Wer das Modell aufrufen möchte, sollte den Namen verwenden, der in der Tencent-Cloud-TokenHub-Konsole angezeigt wird.
| Punkt | Hy4 flash (Originaltext der Forschungsscite) |
|---|---|
| Gesamtparameter | 224B, davon 64B Engram-Parameter |
| Aktivierung pro Token | 12B |
| Modalität | Nativ multimodal, identisch mit Hy4 |
| Kontext | 1M Token |
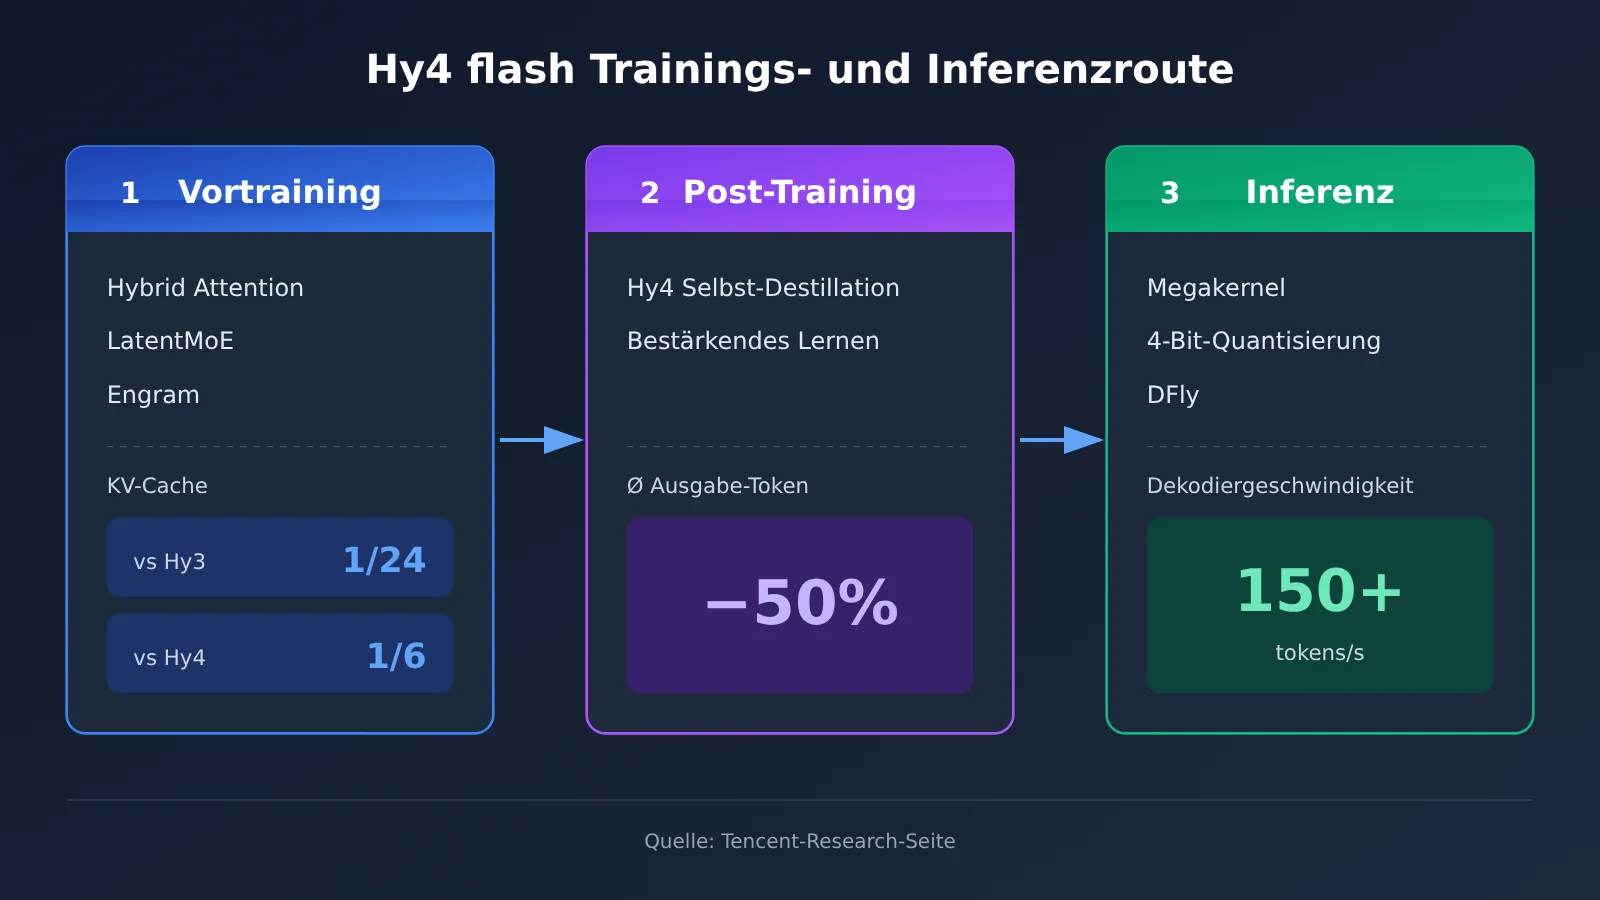
| KV-Cache | 1/24 von Hy3, 1/6 von Hy4 |
| Dekodiergeschwindigkeit | über 150 Tokens/s |
| Kanäle | Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeChat Work, QQ, ima, Marvis; OpenRouter folgt in Kürze |
| Gewichte | Open Source geplant, die Seite sagt nicht, dass sie bereits veröffentlicht sind |
Trainings- und Inferenzpfad von Hy4 flash
In der Pre-Training-Phase kamen drei Designelemente zum Einsatz: Hybrid Attention, LatentMoE und Engram. Sie sind der Hauptgrund dafür, dass der KV-Cache so deutlich kleiner geworden ist. Im Post-Training erfolgt zunächst eine Selbstdistillation aus Hy4, danach senkt Reinforcement Learning die durchschnittliche Anzahl der Ausgabe-Tokens pro End-to-End-Durchlauf um 50%. Für den Büroalltag ist das entscheidend: Die Kosten einer Aufgabe hängen nicht nur vom Stückpreis ab, sondern auch davon, wie viel das Modell redet und wie viele Schritte es macht.
Auf der Inferenzseite kommen Megakernel, 4-Bit-Quantisierung und DFly zum Einsatz; laut Forschungsscite liegt die Dekodiergeschwindigkeit über 150 Tokens/s. Beim Benchmarking beruft sich Tencent nicht auf Platzierungen in öffentlichen Ranglisten, sondern hat einen eigenen WorkIndex aufgebaut und ergänzt diesen durch menschliche Bewertung. Gemessen werden Lieferqualität, Ausgabelänge pro Runde und Aufgabenlaufzeit. Diese Messlatte ist näher an der Frage „Kriegt es die Arbeit fertig, und was kostet das?“, aber es ist ein internes Set von Tencent, das von außen nicht direkt reproduzierbar ist.
Hy4 flash Praxisdaten 1: Menschlicher Blindtest im Vergleich zu Haiku
Die Aussage „annähernd Haiku“ stammt aus einem menschlichen Blindtest. Auf der Forschungsseite heißt es, dass 85 interne WorkBuddy-Nutzer teilnahmen und 259 Aufgaben in 27 Kategorien abdeckten. Die folgenden Daten sind Tencent-eigene Angaben.
| Modell | Zufriedenheit (4-Punkte-Skala) | Mediane Ende-zu-Ende-Zeit | Kosten pro Aufgabe (Yuan) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3.09 | 10.3 Minuten | 1.20 Yuan |
| Hy4 flash | 2.79 | 6.7 Minuten | 0.26 Yuan |
| Claude-Haiku-5.5 | 2.81 | 6.8 Minuten | 4.73 Yuan |
| GLM-5.3-Flash | 2.53 | 7.6 Minuten | 0.81 Yuan |
Beim Lesen dieser Tabelle sind drei Punkte zu beachten. Erstens: Die höchste Zufriedenheit erreicht DeepSeek-V4.1-Flash-1017 mit 3.09 – nicht Hy4 flash. Zweitens: Hy4 flash liegt 0.02 Punkte unter Haiku; man kann also nur von „annähernd“ sprechen, nicht von „übertroffen“. Drittens: Bei den externen Modellen wird durchgängig die Stufe high verwendet, während in der Zeile für Hy4 flash keine Stufe angegeben ist.
Der eigentliche Vorteil von Hy4 flash liegt bei Zeit und Kosten. Es hat die kürzeste mediane Ende-zu-Ende-Zeit, und die Kosten pro Aufgabe sind die niedrigsten in der Tabelle. Die im offiziellen Beitrag genannte „18-fache Senkung der Aufgabenkosten“ ergibt sich aus 4.73 Yuan geteilt durch 0.26 Yuan, also rund 18.2; der Vergleich bezieht sich auf Haiku. Dieser Faktor lässt sich weder auf DeepSeek noch auf Hy4 anwenden.
Hy4 flash Praxisdaten Teil 2: WorkIndex-Kostenbasis
Die Forschungsseite kommt bei WorkIndex zu dem Gesamturteil: Hy4 flash schneidet bei der Gesamtleistung über alle Aufgaben hinweg etwas besser ab als Hy4 preview. Bei den durchschnittlichen Kosten pro Aufgabe liegt es bei 1/13 von Hy4 preview, bei 1/20 von Hy4 und bei 1/8 von DeepSeek-V4.1-Flash-1017 (Max-Stufe, Spitzenpreis).
Diese drei Verhältnisse gelten ausschließlich für WorkIndex. WorkIndex besteht aus 8 internen Sets und deckt Folienerstellung, Folienbearbeitung, gemeinsames Verfassen von Folien durch Mensch und KI, gemeinsames Verfassen von Markdown durch Mensch und KI, Dokumentbearbeitung, Tabellenreparatur, Audio- und Videoverarbeitung sowie visuelles Verständnis ab. Es und die oben genannte Blindtest-Tabelle mit 85 Personen stehen für zwei unterschiedliche Aufgabensets und zwei unterschiedliche Kostenberechnungsverfahren. Deshalb lässt sich das Verhältnis 1/8 nicht auf die 1,20 Yuan von DeepSeek in der Blindtest-Tabelle übertragen, und ebenso wenig der 18-fache Wert auf WorkIndex.
Auch die Formulierung „etwas besser als Hy4 preview“ will mit Vorsicht gelesen werden. Sie zeigt, dass Hy4 flash bei Alltagsaufgaben zur Vorschauversion der vorherigen Generation aufgeschlossen hat; das heißt aber nicht, dass es das finale Hy4 erreicht hat. Der Anhang im nächsten Abschnitt zeigt diese Lücke auf.
Hy4 flash im Praxistest, Teil 3: Der Abstand zwischen Hy4 und preview laut Anhang
Der Anhang der Forschungsseite listet die Punktzahlen von Hy4 flash, Hy4, Hy4 preview, DeepSeek-V4.1-Flash-1017, Qwen3.8-Flash-Next, GLM-5.3-Flash und GPT-6 Luna auf – samt der Kosten pro Aufgabe in Renminbi. Die folgende Tabelle greift nur die vier Spalten heraus, die für die Auswahl am wichtigsten sind. Alle Modelle laufen in ihrer jeweils höchsten Inferenzstufe, der interne buddy index wird auf der workbuddy cli evaluiert. Claude Haiku 5.5 steht nicht in dieser Tabelle – ziehen Sie sie also nicht heran, um daraus Haikus Punktzahlen abzuleiten.
| Benchmark (Anhang der Forschungsseite, Original) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|
| PPTCoEditBench | 74.0 | 78.9 | 71.5 | 76.8 |
| MdCoEditBench | 56.9 | 57.7 | 49.2 | 29.2 |
| AutomationBench v1.0.6 | 52.2 | 56.2 | 36.3 | 54.3 |
| OSWorld 2.1 (Full, partial) | 68.1 | 78.9 | – | 68.4 |
| PPTFixBench | 23.7 | 45.6 | 23.8 | 45.3 |
| ExcelFixBench | 15.6 | 27.8 | 11.7 | 20.0 |
| DeepSWE v1.1 | 64.6 | 74.9 | 64.3 | 73.8 |
| ProgramBench (nahezu gelöst) | 16.0 | 30.0 | 17.5 | 29.0 |
| Terminal-Bench 4.0 | 19.2 | 44.4 | 26.3 | 40.0 |
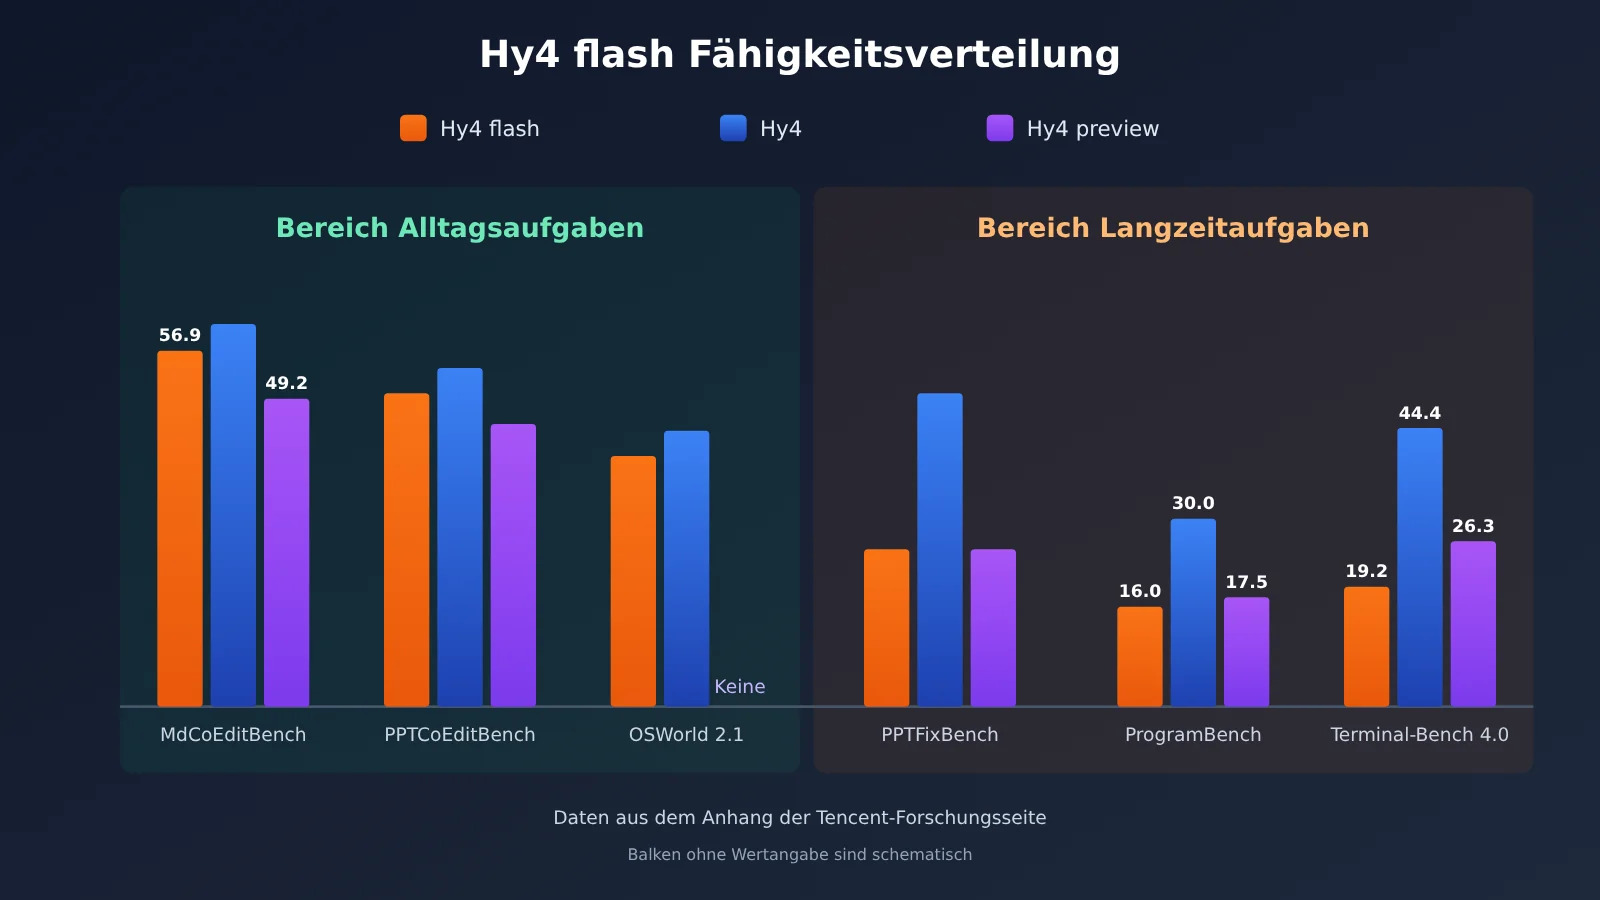
Im Vergleich zu preview liegt Hy4 flash bei Co-Writing- und Automatisierungsaufgaben meist gleichauf oder darüber. MdCoEditBench steigt von 49.2 auf 56.9, AutomationBench von 36.3 auf 52.2. Bei PPTFixBench und DeepSWE bleibt es dagegen praktisch auf preview-Niveau. Bei ProgramBench und Terminal-Bench 4.0 liegt es sogar unter preview.
Gegenüber der finalen Hy4-Version wächst der Abstand mit der Aufgabenschwierigkeit. Bei Co-Writing-Aufgaben sind es nur wenige Punkte, bei Fix- und Terminal-Aufgaben etwa das Doppelte. Bei den Kosten liegt Hy4 flash auf PPTCoEditBench bei rund 0.105 Yuan pro Aufgabe, Hy4 bei rund 1.714 Yuan. Diese Yuan-Beträge beruhen auf den offiziellen Preisen der jeweiligen Modelle bei einem Kurs von 1 US-Dollar zu 7.2 Yuan; für DeepSeek wurde der Spitzenpreis zugrunde gelegt. Es sind die Zahlen, die Tencent für seine Tabellen verwendet hat – betrachten Sie sie nicht als Ihre tatsächliche Rechnung.
Schwachstellen von Hy4 flash: Terminal-Bench 4.0 und ProgramBench
Diese beiden Punkte müssen separat betrachtet werden, denn genau hier liegen die Schwächen von Hy4 flash. Bei Terminal-Bench 4.0 erreicht Hy4 flash nur 19,2, Hy4 kommt auf 44,4, DeepSeek-V4.1-Flash-1017 auf 40,0 – sogar die Preview-Version mit 26,3 liegt darüber. Dieser Benchmark verwendet das Claude Code Harness, erlaubt bis zu 500 Runden und dauert pro Durchlauf höchstens 13 Stunden. Gerade solche langkettigen Terminal-Aufgaben hängen am stärksten von der oberen Grenze der Modellintelligenz ab.
Beim ProgramBench-Kennwert „almost solved“ liegt Hy4 flash bei 16,0, Hy4 bei 30,0 und DeepSeek bei 29,0. Die Forschungsseite selbst schreibt ausdrücklich, dass für Software-Engineering über lange Zeiträume weiterhin Hy4 verwendet werden sollte. Auch in der Aussage von WorkBuddy heißt es: „Beim Coding über lange Zeiträume ist es etwas schwächer“. Wenn dein Agent hauptsächlich im Terminal Code ändert, Tests ausführt und wiederholt Fehler behebt, solltest du nicht allein wegen des niedrigeren Stückpreises auf Hy4 flash wechseln.
Aussagen der Produktteams zu Hy4 flash: Jede Seite hat ihre eigene Sicht
Die Forschungsseite enthält Aussagen mehrerer interner Produkte. Alle folgenden Angaben sind Selbstauskünfte der Produktteams; die Vergleichsobjekte und Messgrundlagen unterscheiden sich, sodass sie sich nicht zu dem Fazit „umfassend führend“ zusammenfassen lassen.
- WorkBuddy (Anne): Im Vergleich zu Hy4 ist die durchschnittliche Aufgabenzeit um 70 % kürzer und die Kosten liegen bei etwa 1/15; die Qualität bei Alltagsaufgaben entspricht Hy4, beim Coding über lange Zeiträume ist sie etwas schwächer. Diese 1/15 sind WorkBuddys eigene Schätzung und nicht dieselbe Kennzahl wie 1/20 bei WorkIndex.
- Yuanbao (Logan): Im Vergleich zu Hy3 ist die Agent-Leistung um 13,6 % höher, im manuellen Side-by-Side-Vergleich um 7,56 %; bei allgemeinen Dialogen liegt es um 2,52 % über GLM-5.3-Flash, wobei die Verbesserung bei Multi-Turn-Dialogen am deutlichsten ausfällt.
- WeChat Pay (Yilin und Simba): Im Vergleich zu DeepSeek-V4.1-Flash-1017 liegt die Durchschnittsbewertung der vier Workflows gleichauf oder höher, die Ausführungsschritte sind etwa 6 % geringer, die Ausgabelänge pro Runde etwa 29 % kürzer; die Zeit bis zum Abschluss statischer Code-Scans ist um 37 % geringer, der Token-Verbrauch um 46 % niedriger, und die Inferenzleistung bleibt gleichauf.
- WeCom (Dylan): Im Vergleich zu Hy4 ist die Ausgabegeschwindigkeit um 88 % höher, und im Denkmodus fallen etwa 60 % weniger Ausgabe-Token an.
- Honor of Kings (TH): Im Vergleich zu DeepSeek-V4.1-Flash-1017 und GLM-5.3-Flash ist die Fähigkeit zur Ursachenanalyse ähnlich, die Modellanfragen sind um 22,0 % bis 39,1 % geringer, die Token um 40,5 % bis 61,2 % niedriger; allerdings sind die Tool-Aufrufe um 51,2 % bzw. 7,7 % höher.
- ima (Kaycee): Im Vergleich zu den beiden oben genannten ist die durchschnittliche Wartezeit um 18 % bis 35 % kürzer, die Antwortbewertung um 1,8 % höher und die Inhaltsqualität um 8,1 % besser.
- QQ (Red und Look): Im Vergleich zu DeepSeek-V4.1-Flash (ohne die Kennung 1017 im Original) ist die Rate zufriedenstellender Antworten in mehreren Szenarien um 0,92 bis 6,16 Prozentpunkte höher; die Genauigkeit der Intent-Klassifizierung des Channel-Assistenten bleibt gleichauf, und die P90-Kommentarlatenz ist um 39 % geringer.
- Marvis (Baihan): Im Vergleich zu DeepSeek-V4.1-Flash-1017 ist die Zufriedenheit bei Unterpunkten wie App-Installation, Systemeinstellungen und Dokumentenrecherche höher, während die Gesamtzufriedenheit gleichauf bleibt.
Der gemeinsame Tenor dieser Aussagen lautet „schneller, sparsamer mit Token, Qualität gleichauf oder etwas besser“; die Vergleichsszenarien betreffen überwiegend Dialoge, Kundenservice, Workflows und Alltags-Agenten. Kein Team setzt es für Software-Engineering über lange Zeiträume ein und behauptet, dort besser zu sein. Das deckt sich mit dem Fazit im Anhang.
Hy4 flash: Preise und Konditionen – Modellnamen prüfen, Preise zuordnen
Listenpreise auf der Research-Seite (USD pro Million Token): Hy4 flash liegt bei Cache-Eingabe 0.003, Eingabe 0.070 und Ausgabe 0.281; für Hy4 sind es 0.042, 0.834 und 2.501. Bis zum 30. November 2026 ist die API von Tencent Cloud TokenHub um 50 % reduziert; innerhalb von WorkBuddy ist die Nutzung kostenlos. Die Research-Seite führt den reduzierten Preis nicht separat auf. Halbiert man den Listenpreis, kommt man auf etwa 0.035 für die Eingabe und 0.1405 für die Ausgabe; nach dem 30. November 2026 gilt wieder der Listenpreis.
Bei APIYI ist Hy4 flash derzeit noch nicht verfügbar; wir werden dieses Modell so bald wie möglich aufnehmen. Maßgeblich sind die Modellbezeichnungen und Preise in der Modellliste der Plattform. Das aktuell auf der Plattform verfügbare hy4 ist die reguläre Hy4-Version, nicht flash. Die folgende Tabelle listet die APIYI-Listenpreise der verfügbaren Modelle getrennt von den offiziellen Preisen auf (USD pro Million Token, Reihenfolge: Eingabe, Ausgabe, Cache-Lesen).
| Modell | APIYI-Listenpreis (apiyi.com-Modellliste) | Offizieller Preis / Preis auf der Research-Seite | Endpunkt |
|---|---|---|---|
| Hy4 flash | noch nicht verfügbar | 0.070 / 0.281 / 0.003 (Listenpreis der Research-Seite) | — |
hy4 |
0.85 / 2.55 / 0.045 | 0.834 / 2.501 / 0.042 (Listenpreis der Research-Seite) | chat |
deepseek-v4.1-flash-1017 |
0.30 / 1.20 / 0.006 | Zu Spitzenzeiten 0.30 / 1.20 / 0.006; außerhalb der Spitzenzeiten halbiert | chat, messages |
claude-haiku-5-5 |
0.10 / 0.50 / 0.01 | ≤ 100.000 Token: 0.10 / 0.50 / 0.01; > 100.000: 0.50 / 2.50 / 0.05 | chat, messages |
glm-5.3-flash |
0.15 / 0.50 / 0.03 | — | nur Chat Completions |
Ein paar Details verdienen eine separate Erläuterung. Bei APIYI haben die drei Namen deepseek-v4.1-flash, deepseek-v4.1-flash-1017 und deepseek-flash denselben Preis und entsprechen dem offiziellen Spitzenlastpreis; deepseek-v4-1-flash-260910 und deepseek-v4-1-flash-economy-261017 sind separate Kanäle mit unterschiedlichen Preisen und repräsentieren nicht die gesamte V4.1-Flash-Serie. Laut offiziellen Regeln für Haiku wird bei einer Eingabeaufforderung von mehr als 100.000 Token die gesamte Anfrage zum höheren Tarif abgerechnet; die Fußnote der APIYI-Übersicht nennt nur 0.50 für die zweite Eingabestufe. Prüfen Sie vor dem Aufruf bei Aufgaben mit langen Eingabeaufforderungen auf der apiyi.com-Modellseite die Ausgabestufe.
Verfügbare Modelle rufen Sie mit einem API-Schlüssel von apiyi.com auf. Senden Sie die Anfrage an https://api.apiyi.com/v1 und tragen Sie base_url und model im OpenAI-kompatiblen Format ein, zum Beispiel hy4 oder deepseek-v4.1-flash-1017. Wenn Sie das Anthropic-Messages-Format benötigen, wählen Sie ein Modell, das den messages-Endpunkt unterstützt. glm-5.3-flash unterstützt nur Chat Completions; deepseek-v4.1-flash-1017 ist nicht in der CodexResponses-Gruppe enthalten. Prüfen Sie die Gruppe, bevor Sie Codex-ähnliche Tools anbinden.
Vor- und Nachteile von Hy4 flash
Vorteile
- Gutes Preis-Leistungs-Verhältnis bei alltäglichen Aufgaben: Die Zufriedenheit im Blindtest liegt nahe bei Haiku, die Kosten pro Aufgabe betragen 0,26 Yuan – etwa 1/18 von Haiku (nach Angaben des Anbieters).
- Hohe Geschwindigkeit: Die mediane Bearbeitungszeit im Blindtest ist am kürzesten; die Forschungsseite gibt eine Dekodiergeschwindigkeit von über 150 tokens/s an.
- Knappe Ausgabe: Nach dem Reinforcement Learning halbiert sich die durchschnittliche Anzahl ausgegebener Tokens; auch Erfahrungsberichte aus mehreren Produkten erwähnen weniger Tokens und Schritte.
- Solide beim gemeinsamen Schreiben: Beim gemeinsamen Verfassen von Markdown liegt es nahezu gleichauf mit Hy4, beim gemeinsamen Erstellen von Folien beträgt der Unterschied nur wenige Punkte.
Einschränkungen
- Schwach bei Terminal-Aufgaben und Long-Horizon-Coding: Terminal-Bench 4.0 und ProgramBench liegen deutlich hinter Hy4 zurück, sogar noch unter preview. Für solche Aufgaben sollten Sie weiterhin Hy4 oder DeepSeek-V4.1-Flash-1017 verwenden.
- Schwierig bei Fix-Aufgaben: PPTFixBench und ExcelFixBench erreichen nur etwa die Hälfte von Hy4. Beim Reparieren komplexer Dokumente ist es nicht empfehlenswert, damit das bestehende Modell zu ersetzen.
- Nur eine Evidenzquelle: WorkIndex ist ein interner Datensatz, die Blindtest-Teilnehmer sind interne Nutzer, derzeit gibt es keine Reproduktion durch Dritte, und die Modell-ID ist auf der Forschungsseite noch nicht angegeben.
- Vision ist nicht die stärkste Seite: BuddyVQA und MMMU-Pro sind nicht die höchsten Werte in der Tabelle; das Modell eignet sich für visuelle Frage-Antwort-Szenarien, bei denen „ausreichend“ genügt.
Häufig gestellte Fragen (FAQ)
F1: Was ist Hy4 flash?
Hy4 flash ist ein leichtgewichtiges Modell, das Tencent Hunyuan am 16.11.2026 veröffentlicht hat: 224 Mrd. Gesamtparameter, 12 Mrd. pro Token aktiviert, nativ multimodal, Kontextfenster 1M. Es entstand durch Selbst-Distillation aus Hy4 und ist auf alltägliche Produktivitätsaufgaben ausgerichtet.
F2: Ist Hy4 flash wirklich besser als Claude Haiku 5.5?
So kann man das nicht sagen. Im offiziellen Blindtest liegt die Zufriedenheit bei 2,79, Haiku erreicht 2,81 – die Forschungsseite spricht hier von „nahezu gleichauf“. Der Vorteil liegt in der etwas kürzeren Bearbeitungszeit und den deutlich niedrigeren Kosten pro Aufgabe. Die höchste Zufriedenheit im Blindtest erzielte übrigens DeepSeek-V4.1-Flash-1017.
F3: Wann ist Hy4 flash verfügbar?
Laut der Forschungsseite ist es bereits über Kanäle wie Tencent Cloud TokenHub, WorkBuddy und Yuanbao verfügbar, OpenRouter folgt in Kürze. Die Aktion – kostenlos in WorkBuddy und 50 % Rabatt auf die TokenHub-API – läuft bis zum 30.11.2026. Die Gewichte sollen als Open Source veröffentlicht werden, sind aber derzeit noch nicht verfügbar.
F4: Bei welchen Aufgaben sollte man nicht von Hy4 auf Hy4 flash wechseln?
Bei lang laufenden Terminal-Aufgaben, langfristigem Software-Engineering, komplexen PowerPoint-Präsentationen und der Reparatur von Tabellen. Im Anhang erreichen diese Aufgabenkategorien nur etwa die Hälfte der Punkte von Hy4; die Forschungsseite empfiehlt ebenfalls, für langfristiges Software-Engineering weiterhin Hy4 einzusetzen.
F5: Kann man Hy4 flash derzeit über APIYI aufrufen?
Derzeit nicht – die Plattform bietet vorerst nur die offizielle Version `hy4` an. Sobald das Modell verfügbar ist, gelten die Bezeichnung und der Preis in der Modellliste auf apiyi.com. Bis dahin können Sie mit demselben API-Schlüssel `hy4`, `deepseek-v4.1-flash-1017` und `claude-haiku-5-5` aufrufen und Ihren Vergleichs-Workflow aufbauen.
F6: Lassen sich der Faktor 18 aus dem Blindtest und die 1/20 aus dem WorkIndex ineinander umrechnen?
Nein. Der Faktor 18 stammt aus der Blindtest-Tabelle und ist das Verhältnis der Kosten pro Aufgabe in Renminbi zwischen Haiku und Hy4 flash; 1/8, 1/13 und 1/20 stammen aus dem WorkIndex und beziehen sich auf DeepSeek, Hy4 preview bzw. Hy4. Die 1/15 aus dem WorkBuddy-Zitat gehört wiederum zu einer anderen Bewertung. Aufgaben-Set und Kostenbasis unterscheiden sich in allen drei Fällen.
Hy4 flash: Die wichtigsten Erkenntnisse
- Klare Positionierung: Hy4 flash ist ein kostengünstiges Modell für den Büroalltag und leichtgewichtige Agenten.
- Näher dran, aber nicht vorbei: Zufriedenheit im Blindtest 2.79, Haiku 2.81, DeepSeek mit 3.09 am höchsten.
- Kosten getrennt betrachten: Der Faktor 18 bezieht sich auf Haiku, 1/20 auf Hy4 im WorkIndex.
- Co-Writing direkt nutzbar: Beim gemeinsamen Schreiben von Markdown und Folien reicht es fast an Hy4 heran.
- Klare Schwachpunkte: Terminal-Bench 4.0 erreicht 19.2 Punkte, ProgramBench 16.0 Punkte.
- Verfügbarkeit: APIYI hat Hy4 flash noch nicht im Angebot; die bereits angebotenen Modelle laufen einheitlich über eine OpenAI-kompatible Schnittstelle.
Zusammenfassung
Wie leistungsfähig Hy4 flash ist, hängt davon ab, welche Aufgaben du ihm gibst:
- Alltagsaufgaben: gemeinsames Erstellen von Folien, Markdown, visuelle Fragen beantworten, Computerbedienung – mit sehr niedrigen Kosten erreicht es eine Zufriedenheit nahe Haiku (offizieller Blindtest).
- Komplexe Aufgaben: aufwendige PPT-Reparaturen, lange Terminal-Aufgaben, lang laufende Software-Engineering-Aufgaben – hier ist der Abstand zu Hy4 deutlich; du solltest weiterhin Hy4 oder DeepSeek-V4.1-Flash-1017 einsetzen.
- Art der Belege: Alle Daten stammen aus offiziellen Angaben von Tencent; sie eignen sich als Referenz für die Auswahl, vor dem Produktivstart solltest du sie jedoch mit deinen eigenen Aufgaben prüfen.
Praktisch ist eine aufgabenbezogene Aufteilung: Ein Teil des Traffics für Alltagsaufgaben geht zunächst an Hy4 flash, lang laufende Aufgaben bleiben unverändert. Sobald Hy4 flash bei APIYI verfügbar ist, kannst du auf apiyi.com mit demselben API-Schlüssel seine tatsächliche Leistung mit der von hy4 und deepseek-v4.1-flash-1017 vergleichen.
📚 Referenzen
-
Tencent Hunyuan Hy4 flash Forschungsseite: Spezifikationen, Blindtests, WorkIndex, Anhang und Produktaussagen
- Link:
hy.tencent.ai/research/hy4-flash - Hinweis: Die Originalquelle aller in diesem Artikel verwendeten Benchmark-Daten; die Seite trägt das Datum 2026-11-16
- Link:
-
Offizieller Veröffentlichungsbeitrag von Tencent Hunyuan: 18-fache Aufgabenkosten und API-Listenpreise
- Link:
x.com/TencentHunyuan/status/2122217770314301469 - Hinweis: Die offizielle Außendarstellung; Vergleichsgegenstand ist Claude Haiku 5.5
- Link:
-
Offizielle Preisseite von DeepSeek: Spitzen- und Nebenzeitenpreise für V4.1 Flash
- Link:
api-docs.deepseek.com/quick_start/pricing - Hinweis: Hier können Sie die Definition der Spitzenzeiten und die Zuordnung zu den Aufrufnamen nachlesen
- Link:
-
Offizielle Dokumentation zu Claude Haiku 5.5: Modell-ID und zwei Abrechnungsstufen
- Link:
platform.claude.com/docs/en/models/haiku-5-5/overview - Hinweis: Erläutert die Regel, dass bei einer Eingabeaufforderung von über 100.000 Token die gesamte Anfrage abgerechnet wird
- Link:
Autor: APIYI-Technikerteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Informationen zu Modellen und Endpunkten finden Sie im Dokumentationszentrum unter docs.apiyi.com