Catatan penulis: Semua nama mengandung Flash, tetapi modalitas input, endpoint, dan pengali grupnya berbeda-beda. Artikel ini mengikuti urutan “lihat halaman model dulu, lalu bandingkan harga, pilih berdasarkan tugas” untuk menjelaskan cara memilih model Flash.
Banyak orang memilih model kelas Flash dengan cara: selama namanya ada Flash, langsung dianggap “cepat dan murah”, lalu coding, melihat gambar, dan menghitung rumus diserahkan ke model yang sama. Masalah dari cara ini adalah, model dengan nama Flash tidak selalu punya modalitas input dan endpoint yang sama. Ada yang hanya menerima teks, ada yang bisa membaca gambar dan video, ada pula yang bahkan tidak bisa melewati /v1/messages.
Ini bukan daftar peringkat “siapa yang terkuat”. Artikel ini tidak menyatakan model mana yang secara menyeluruh lebih kuat atau lebih murah; artikel ini hanya memberikan serangkaian langkah pemilihan model Flash yang bisa dijalankan: pertama lihat jenis input dan kegunaan yang tertulis di halaman model, lalu bandingkan harga input, harga output, dan pembacaan cache, terakhir pilih model spesifik sesuai tugas.
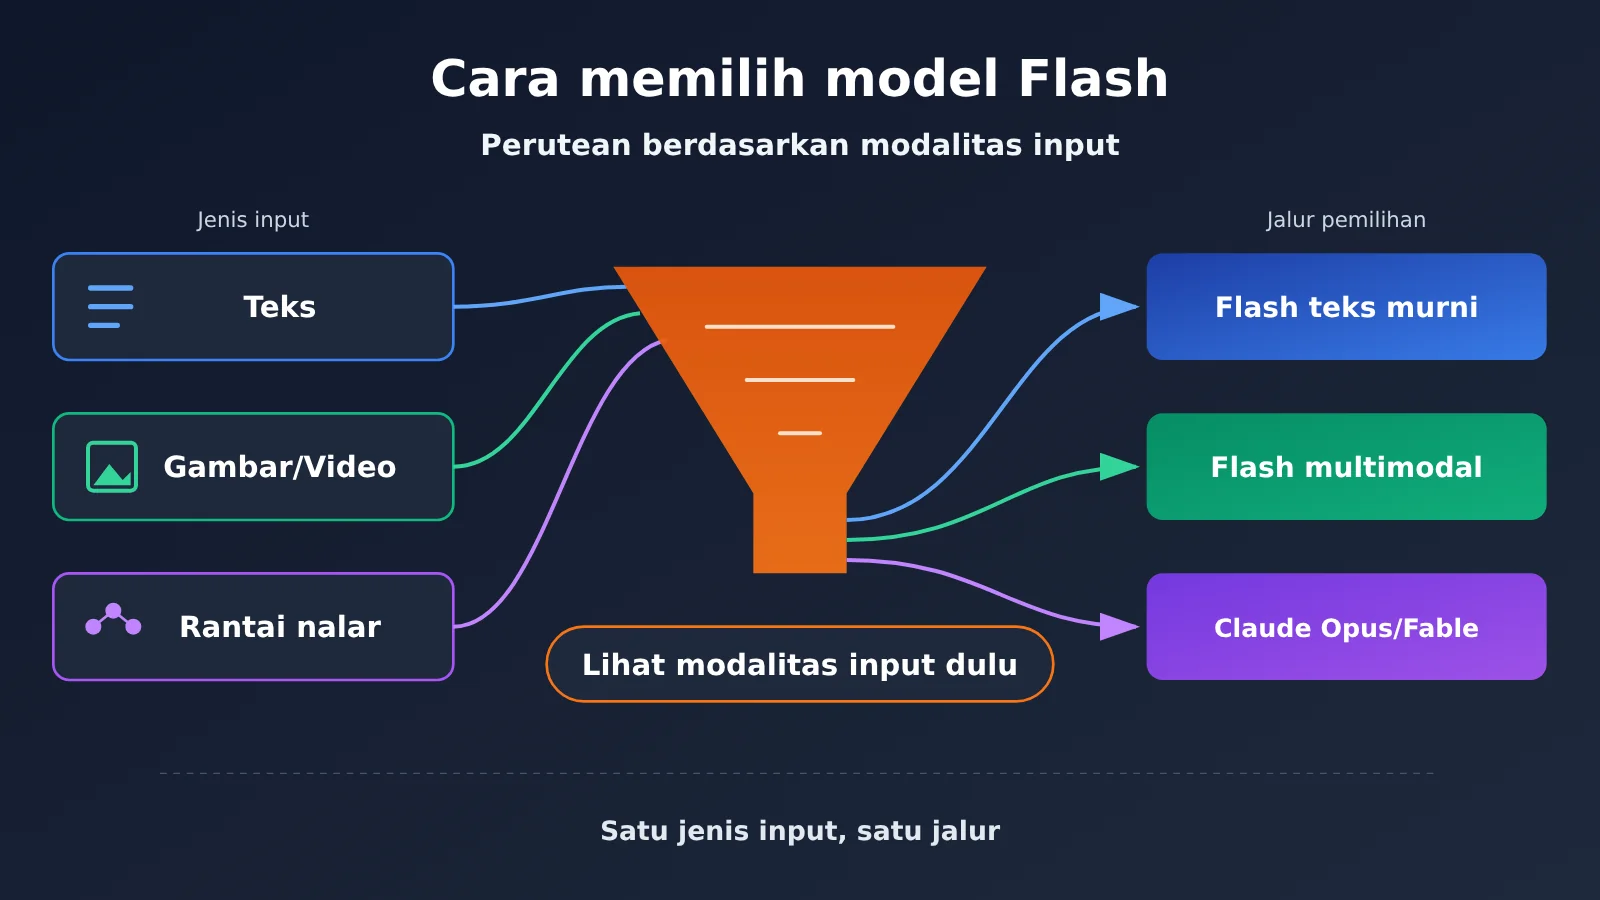
Nilai inti: Setelah membaca artikel ini, Anda dapat memilih model Flash yang modalitasnya cocok berdasarkan jenis input Anda (teks murni, tangkapan layar grafik, video panjang). Anda juga akan tahu tugas penalaran berat mana yang tidak seharusnya diserahkan ke Flash secara default.
Poin-poin inti dalam memilih model Flash
| Poin | Penjelasan | Nilai |
|---|---|---|
| Cek dulu modalitas input | Jenis input yang tertulis di halaman model (teks/gambar/video/audio) menentukan apakah model bisa menerima data Anda | Menghindari mengirim tangkapan layar ke model yang hanya menerima teks |
| Lihat endpoint berikutnya | Dukungan endpoint chat, messages, dan gemini berbeda-beda per model | Menghindari error antarmuka langsung setelah mengganti model |
| Bandingkan tiga komponen harga | Harga input, harga output, dan pembacaan cache harus dilihat bersamaan, lalu dikalikan pengali grup | Estimasi tagihan lebih mendekati kenyataan |
| Bagi tugas sesuai kebutuhan | Membaca grafik atau mengubah kode pendek gunakan Flash yang modalitasnya cocok | Biaya tugas bervolume tetap terkendali |
| Pilih model lain untuk penalaran berat | Rumus, pembuktian, dan pekerjaan teknis berantai panjang tidak diarahkan ke Flash secara default | Serahkan soal sulit ke model dengan posisi lebih tinggi |
Mengapa model Flash tidak bisa dipukul rata berdasarkan nama
“Flash” hanyalah nama yang diberikan vendor untuk satu tingkat model, dan definisinya di tiap vendor tidak seragam. Dari halaman model APIYI (docs.apiyi.com/models.md) dapat dilihat bahwa beberapa model yang sama-sama bernama Flash memiliki modalitas input mulai dari “hanya teks” hingga “teks, gambar, video, audio”. Endpoint pun bervariasi, dari “chat plus messages” hingga “hanya chat”.
Jadi saat memilih model Flash, nama hanya membantu Anda menentukan bahwa “ini adalah kelas model yang cenderung berorientasi volume dan latensi rendah”. Yang benar-benar menentukan apakah model bisa dipakai adalah tiga kolom informasi di halaman model: jenis input, endpoint yang didukung, dan pengali grup. Semua data di bawah ini berasal dari halaman model dan tabel total model. Tanggal verifikasi adalah 2026-11-17, data tabel total diperbarui pada 2026-11-16 09:39 (UTC+8), dan satuan harga adalah harga default per juta token.
Perbandingan Modalitas Input dan Endpoint Model Flash
Tabel berikut merangkum modalitas input dan endpoint beberapa model Flash dalam satu tampilan. Langkah pertama dalam memilih model adalah menyingkirkan model yang “modalitasnya tidak cocok” dan “endpoint-nya tidak cocok”.
| ID Model | Modalitas input | Output | Endpoint | Keterangan lain di halaman model |
|---|---|---|---|---|
deepseek-v4-flash |
Hanya teks | Teks | chat, messages | Output terstruktur tidak didukung; mendukung pemanggilan alat, penalaran mendalam opsional, cache petunjuk |
deepseek-v4.1-flash |
Tidak ada halaman model terpisah | — | chat, messages | Hanya satu baris di tabel ringkasan; kemampuan mengacu pada penjelasan resmi berikutnya |
gemini-3.8-flash |
Teks, gambar, video, audio | Teks | chat, gemini (tanpa messages) | Penalaran mendalam aktif secara default, tingkat penalaran low/medium/high; spesifikasi resmi belum diumumkan |
qwen3.8-flash |
Teks, gambar, video | Teks | Hanya chat | Konteks 1,000,000, output maksimum 131,072 |
glm-5.3-flash |
Teks, gambar, video | Teks | Hanya chat | Konteks 1,000,000, output maksimum 128,000; penalaran mendalam aktif secara default |
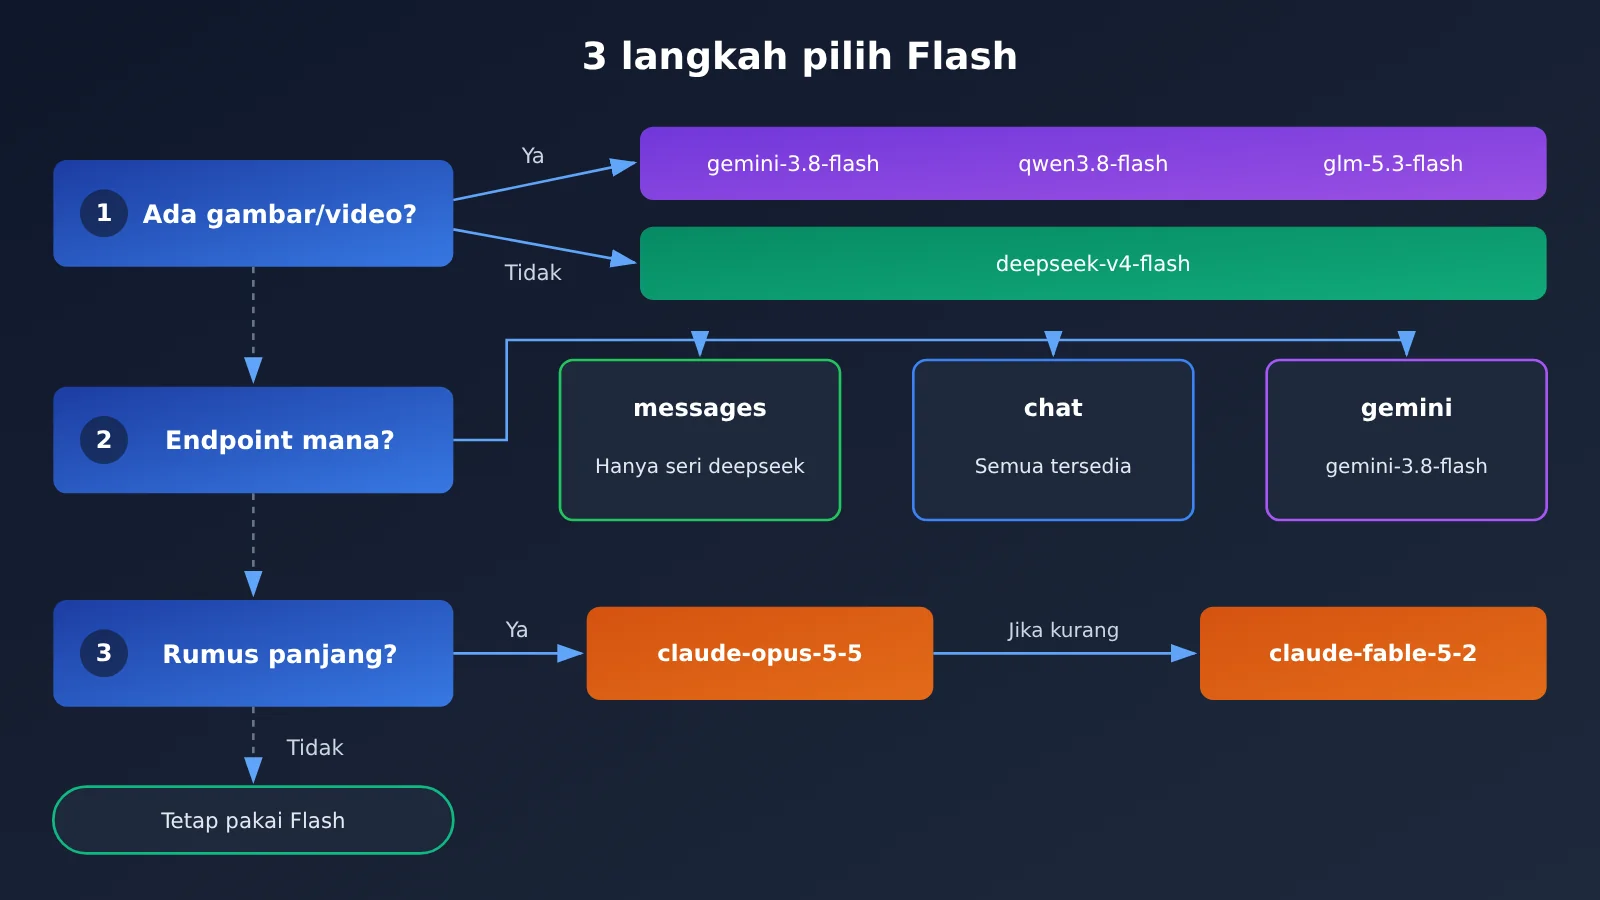
Ada dua hal yang perlu diperhatikan secara khusus. Pertama, “hanya teks”, konteks 1,048,576, dan output maksimum 393,216 milik deepseek-v4-flash adalah data halaman model v4, tidak bisa dipindahkan ke deepseek-v4.1-flash. v4.1 saat ini hanya memiliki satu baris di tabel ringkasan; jika kemampuannya tidak dijelaskan dengan jelas, jangan berasumsi. Kedua, jika proyek Anda menggunakan antarmuka /v1/messages bergaya Anthropic, beberapa model Flash multimodal tidak dapat digunakan, dan Anda perlu beralih ke endpoint chat.
Cara mencocokkan harga dan grup model Flash
Setelah modalitas dan endpoint lolos, cek harganya. Mengganti model akan langsung mengubah tagihan, dan harga yang tertera tidak sama dengan penagihan sebenarnya, karena grup token di APIYI apiyi.com memiliki pengali. Tabel berikut mencantumkan harga default dan grup yang tercantum di halaman model.
| ID Model | Harga input | Harga output | Baca cache | Grup & pengali |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95×; CodexResponses, Default, SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode, CodexResponses, Default, SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5×; Default, SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default, SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses, Default, SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | Lihat tabel model lengkap |
claude-fable-5-2 |
$8 | $40 | $0.2 | Tidak ada grup Claude_Reverse |
Tiga titik rekonsiliasi tagihan model Flash
Artikel ini tidak memberi kesimpulan “mana yang lebih murah” untuk Anda, karena biaya sebenarnya bergantung pada rasio input-output dan tingkat cache hit Anda. Sebaiknya lakukan pencocokan sendiri dengan tiga langkah berikut:
- Perhatikan rasio input-output: Untuk tugas seperti melihat gambar dan membaca dokumen, input besar dan output kecil, sehingga bobot harga input lebih tinggi; untuk tugas seperti menghasilkan kode panjang dan laporan panjang, bobot harga output lebih tinggi.
- Perhatikan baca cache: Pada skenario petunjuk sistem tetap dan dipanggil berulang, harga baca cache akan sangat memengaruhi total tagihan.
- Kalikan pengali grup: Untuk
gemini-3.8-flashyang sama, jika lewat grup Gemini_Reverse dihitung 0.5×, sedangkan lewat Default dihitung 1×, tagihannya bukan angka yang sama.
💰 Saran biaya: Grup tempat token terikat akan langsung mengubah hasil penagihan. Sebelum mengganti model, cek dulu grup token saat ini di konsol APIYI apiyi.com, lalu estimasikan dengan mengalikan harga di tabel atas dengan pengali, agar tidak baru sadar tagihan berubah setelah go-live.
Pilih Model Flash Berdasarkan Tugas
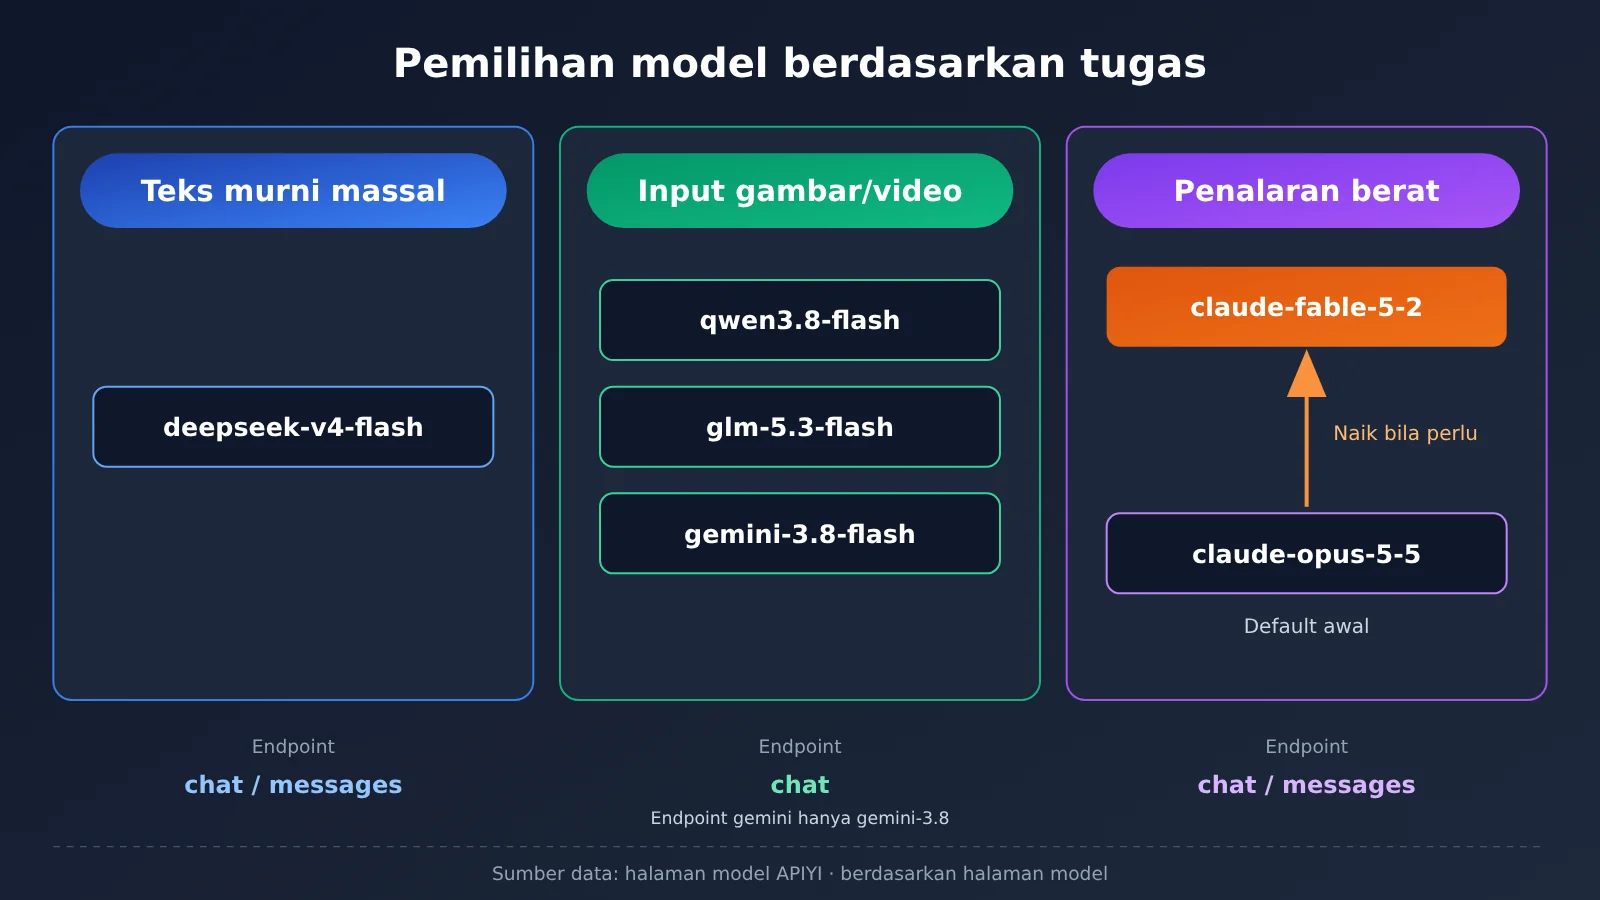
Setelah modalitas, endpoint, dan harga dicocokkan, Anda bisa mulai menerapkannya berdasarkan tugas. Tabel berikut memberikan panduan pemilihan menurut tugas. Pembagian peran di dalamnya merupakan penilaian berdasarkan informasi halaman model; kemampuan spesifik tetap mengacu pada halaman model.
| Jenis tugas | Karakteristik input | Model kandidat | Dasar pemilihan |
|---|---|---|---|
| Mengubah kode pendek, pemrosesan teks dengan konkurensi tinggi | Teks saja | deepseek-v4-flash |
Teks asli halaman model menyebut fokus pada konkurensi tinggi dan latensi rendah; mendukung endpoint messages |
| Mengubah kode dari tangkapan layar, membaca diagram | Teks + gambar | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
Modalitas input mencakup gambar, mendukung pemahaman visual |
| Analisis dokumen dan video panjang | Teks + video | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
Modalitas input mencakup video; teks asli halaman model qwen menyebutkan skenario volume tinggi seperti ini |
| Input yang menyertakan audio | Teks + audio | gemini-3.8-flash |
Di antara beberapa model tersebut, hanya halaman model ini yang mencantumkan input audio |
| Rumus, pembuktian, pekerjaan teknis berantai panjang | Penalaran berat | claude-opus-5-5 → claude-fable-5-2 |
Keempat halaman model Flash tidak mencantumkan komputasi ilmiah sebagai spesialisasi |
Pilihan Model Flash untuk Tugas Pengkodean
Jika input hanya berupa kode dan penjelasan teks, modalitas yang cocok adalah deepseek-v4-flash. Teks asli halaman modelnya menulis “MoE dengan 284B total parameter dan 13B aktif, berfokus pada konkurensi tinggi dan latensi rendah”; ini adalah teks asli halaman model, bukan data yang diukur dalam artikel ini. Model ini mendukung endpoint chat dan messages sekaligus, sehingga perubahan yang diperlukan saat terhubung ke klien bergaya Anthropic paling minimal. Perlu diperhatikan, kolom output terstruktur ditandai tidak didukung; jika Anda mengandalkan JSON Schema untuk membatasi output, perlu penanganan terpisah.
Jika tugas pengkodean menyertakan tangkapan layar, misalnya “ubah frontend mengikuti desain ini”, Anda perlu beralih ke Flash multimodal. Teks asli halaman model qwen3.8-flash menulis “cocok untuk pengkodean visual, analisis dokumen, dan video panjang, yaitu skenario volume tinggi seperti ini”. Teks asli halaman model glm-5.3-flash menulis 320B total parameter, 18B aktif, dan skor Terminal-Bench 2.1 sebesar 84.3. Kedua kelompok angka ini adalah teks asli halaman model, bukan hasil pengukuran dalam artikel ini, dan bukan berarti model ini secara menyeluruh lebih kuat daripada model lainnya.
Memilih model Flash untuk membaca gambar dan video panjang
Membaca grafik, mengurai tangkapan layar PDF, menganalisis video panjang — modalitas ketiga model Flash multimodal itu sama-sama cocok. Bedanya terutama ada di endpoint dan kolom fitur: gemini-3.8-flash mendukung input audio dan eksekusi kode, serta bisa lewat endpoint gemini; qwen3.8-flash dan glm-5.3-flash hanya punya endpoint chat. Pada gemini-3.8-flash dan glm-5.3-flash, berpikir mendalam aktif secara default, jadi untuk tugas bervolume tinggi yang sensitif latensi hal ini perlu diperhatikan.
Tugas penalaran berat bukan jatah default model Flash
Di sini batasannya perlu diperjelas: Flash bukan berarti sama sekali tidak bisa melakukan komputasi, hanya saja keempat halaman model tidak mencantumkan komputasi ilmiah, pembuktian, atau fisika sebagai keahlian khusus, sehingga sebaiknya tidak menyerahkan tugas seperti itu ke Flash secara default. Dalam pengumuman 9 November 2026, Anthropic memposisikan Claude Fable 5.2 untuk pekerjaan teknis tersulit, dan menyarankan sebagian besar tugas coding dan pengetahuan dimulai dari Opus 5.5, baru naik ke Fable bila belum cukup.
Keduanya sudah tersedia di APIYI dengan ID model claude-opus-5-5 dan claude-fable-5-2. Harganya jelas lebih tinggi daripada kelas Flash, jadi pembagian tugas yang lebih masuk akal: tugas bervolume tinggi pakai Flash, dan hanya penurunan rumus, pembuktian, serta analisis teknis berantai panjang yang perlu naik kelas.
Memulai Cepat dengan Model Flash
Setelah menentukan model, langkah integrasinya sederhana. APIYI menyediakan antarmuka yang kompatibel dengan OpenAI, satu kunci API saja cukup untuk memanggil semua model di atas. Berikut poin-poin konfigurasi yang disusun mengikuti format dokumen help.
Langkah Pertama: Konfigurasi base_url dan Endpoint Model Flash
- Di klien, setel base_url ke
https://api.apiyi.com/v1, lalu isi kunci API dengan token yang Anda buat di konsol. - Pilih jalur sesuai model: semua model dapat menggunakan
/v1/chat/completions; hanyadeepseek-v4-flash(sertadeepseek-v4.1-flashyang ditandai di tabel ringkasan) yang dapat menggunakan/v1/messages;gemini-3.8-flashjuga dapat menggunakan endpoint gemini. - Isi bidang
modelpada body permintaan dengan ID model, misalnyaqwen3.8-flash.
Langkah Kedua: Menyusun Permintaan Model Flash Berdasarkan Modalitas Input
- Teks murni: cukup letakkan
roledancontentberupa teks di dalammessages, cocok untukdeepseek-v4-flash. - Dengan gambar: dalam format chat, tulis
contentsebagai array, item teks memakaitypebernilaitext, item gambar memakaitypebernilaiimage_url. Kirimkan hanya ke model yang mendukung input gambar. - Mengaktifkan streaming: setel
streamketrue, cocok untuk skenario konkurensi tinggi yang membutuhkan respons kata pertama dengan cepat.
Langkah Ketiga: Daftar Periksa Sebelum Beralih Model Flash
- Apakah model baru mendukung endpoint yang sedang Anda gunakan? Pengguna endpoint messages yang beralih ke Flash multimodal harus mengganti jalur ke chat.
- Apakah model baru mendukung fitur yang Anda andalkan? Misalnya, output terstruktur ditandai tidak didukung pada
deepseek-v4-flash. - Berapa rasio pengali model baru pada grup token Anda saat ini?
🚀 Mulai Cepat: sebaiknya coba dulu kuota uji gratis pengguna baru di APIYI apiyi.com, kirim sekumpulan input nyata yang sama ke dua atau tiga kandidat model Flash, bandingkan kualitas output dan pemakaian token, lalu tentukan peralihan resminya. Cukup ubah bidang
modeluntuk beralih antar model.
Pertanyaan Umum (FAQ)
Q1: Apa arti model Flash?
Flash adalah nama yang diberikan vendor untuk model kelas yang condong ke throughput tinggi dan latensi rendah, dan bukan standar yang seragam. Flash dari vendor berbeda sangat bervariasi dalam modalitas input, endpoint, dan dukungan fitur, jadi pemilihan model harus melihat halaman model, bukan hanya namanya.
Q2: Apakah deepseek-v4-flash dan deepseek-v4.1-flash bisa saling menggantikan?
Tidak bisa diasumsikan begitu saja. v4.1 saat ini hanya punya satu baris di tabel ringkasan: input $0.3, output $1.2, baca cache $0.006, endpoint chat dan messages. Jumlah parameter, konteks, dan sifat “hanya teks” milik v4 tidak bisa diterapkan ke v4.1; sebelum mengganti, silakan berpegang pada tabel ringkasan dan penjelasan model selanjutnya.
Q3: Mengapa klien bergaya Claude saya tidak bisa memanggil gemini-3.8-flash?
Karena endpoint `gemini-3.8-flash` adalah chat dan gemini, tidak ada messages. `qwen3.8-flash` dan `glm-5.3-flash` juga hanya punya chat. Kalau butuh endpoint messages, kandidat yang tersisa hanya Flash dari keluarga deepseek.
Q4: Mengapa model yang sama bisa menghasilkan penagihan berbeda dengan token berbeda?
Karena pengali grupnya berbeda. Misalnya `gemini-3.8-flash` di grup Gemini_Reverse adalah 0.5×, sedangkan di Default adalah 1×. Hubungan antara token dan grup dapat dilihat di dokumentasi APIYI docs.apiyi.com/faq/token-and-groups.md.
Q5: Bagaimana cara memanggil model Flash ini dengan cepat melalui API?
Daftar di APIYI apiyi.com dan buat token, setel base_url ke `https://api.apiyi.com/v1`, pilih path chat atau messages sesuai model, dan isi `model` dengan ID yang sesuai. Pengguna baru mendapat kuota uji gratis, jadi bisa verifikasi dulu dalam skala kecil.
Q6: Apakah model Flash bisa melakukan derivasi matematika atau komputasi ilmiah?
Bisa menangani perhitungan umum, tetapi beberapa halaman model tidak menuliskan komputasi ilmiah, pembuktian, atau fisika sebagai keahlian khusus. Untuk rumus, pembuktian, dan pekerjaan teknis berantai panjang, disarankan mulai dari `claude-opus-5-5`, lalu tingkatkan ke `claude-fable-5-2` bila kurang.
Q7: Apakah skor Terminal-Bench di halaman model bisa langsung dijadikan dasar pemilihan?
Halaman model `glm-5.3-flash` menuliskan skor Terminal-Bench 2.1 sebesar 84.3; ini adalah teks asli halaman model, bukan hasil pengujian artikel ini. Angka itu bisa menjadi sinyal referensi, tetapi tidak berarti model tersebut lebih unggul pada semua tugas. Pada akhirnya tetap disarankan memverifikasi dengan data nyata Anda sendiri.
Poin-Poin Penting Pemilihan Model Flash
- Nama bukan jaminan kemampuan: Model berlabel Flash punya modalitas input dan endpoint yang berbeda-beda.
- Langkah pertama, lihat modalitasnya: Untuk teks murni pilih
deepseek-v4-flash, untuk yang menyertakan gambar dan video pilih Flash multimodal. - Langkah kedua, lihat endpoint-nya:
messageshanya didukung keluarga deepseek, Flash multimodal kebanyakan hanya lewatchat. - Langkah ketiga, cek tagihan: Lihat harga input, harga output, dan baca cache sekaligus, lalu kalikan dengan pengali grup.
- Angka di halaman model wajib ada sumbernya: Jumlah parameter, Terminal-Bench, dan “cocok untuk pengodean visual” semuanya kutipan asli dari halaman model.
- Tugas penurunan rumus jangan default ke Flash: Pembuktian rumus mulai dari
claude-opus-5-5, kalau masih kurang baru naik keclaude-fable-5-2. - Verifikasi batch kecil sebelum beralih: Di APIYI pakai kuota gratis untuk menjalankan input nyata, baru putuskan peralihan resmi.
Ringkasan
Cara memilih model Flash, intinya cuma satu kalimat: cocokkan berdasarkan modalitas input, jangan tebak berdasarkan nama.
- Lihat halaman model dulu: Pastikan jenis input, endpoint, dan dukungan fitur, lalu singkirkan model yang tidak cocok.
- Baru cocokkan harga: Harga input, harga output, dan baca cache dilihat sesuai proporsi pemanggilanmu, lalu kalikan dengan pengali grup token.
- Bagi tugas sesuai jenisnya: Tugas baca grafik dan ubah kode pendek yang bervolume besar serahkan ke Flash yang modalitasnya cocok, tugas penurunan rumus berat serahkan ke Claude Opus 5.5 atau Fable 5.2.
Harga dan kemampuan akan terus diperbarui, jadi saat memilih model acuannya adalah halaman model pada hari itu. Disarankan di APIYI apiyi.com pakai kunci API yang sama untuk membandingkan beberapa model kandidat dalam batch kecil, lalu putuskan berdasarkan tagihan dan kualitas outputmu sendiri.
📚 Referensi
-
Pengumuman Anthropic – Claude Fable dan Mythos 5.2: Posisi Fable 5.2 dan saran penggunaan awal Opus 5.5
- Tautan:
anthropic.com/claude-fable-and-mythos-5-2 - Keterangan: Memahami dasar pembagian tugas model untuk tugas penalaran ulang (re-derivation)
- Tautan:
-
Ikhtisar Model Claude: Daftar model resmi Anthropic dan penjelasan cara penggunaannya
- Tautan:
platform.claude.com/docs/en/about-claude/models/overview - Keterangan: Saran penggunaan Opus dan Fable yang konsisten dengan pengumuman
- Tautan:
-
Tabel Induk Model APIYI dan Halaman Model: Harga, grup, endpoint, dan modalitas input
- Tautan: Pusat dokumentasi models.md dan halaman tiap model (deepseek-v4-flash, gemini-3-8-flash, qwen3-8-flash, glm-5-3-flash)
- Keterangan: Sumber semua data harga dan kemampuan dalam artikel ini, sebelum memilih mohon mengacu pada versi terbaru
Penulis: Tim Teknis APIYI
Komunikasi Teknis: Silakan hubungi kami di halaman utama situs APIYI, penjelasan lebih lanjut tentang model dan grup dapat diakses di pusat dokumentasi docs.apiyi.com