Anmerkung des Autors: Heute müssen wir die API ansprechen, also bleibt es bei grok-4.7. Bis zum 2026-11-13 hat Grok 4.8 noch keine Modell-ID. Dieser Artikel prüft anhand der Quellen die drei Schwachstellen von Grok 4.7 und schaut, ob für 4.8 bereits Belege vorliegen, dass sie behoben wurden.
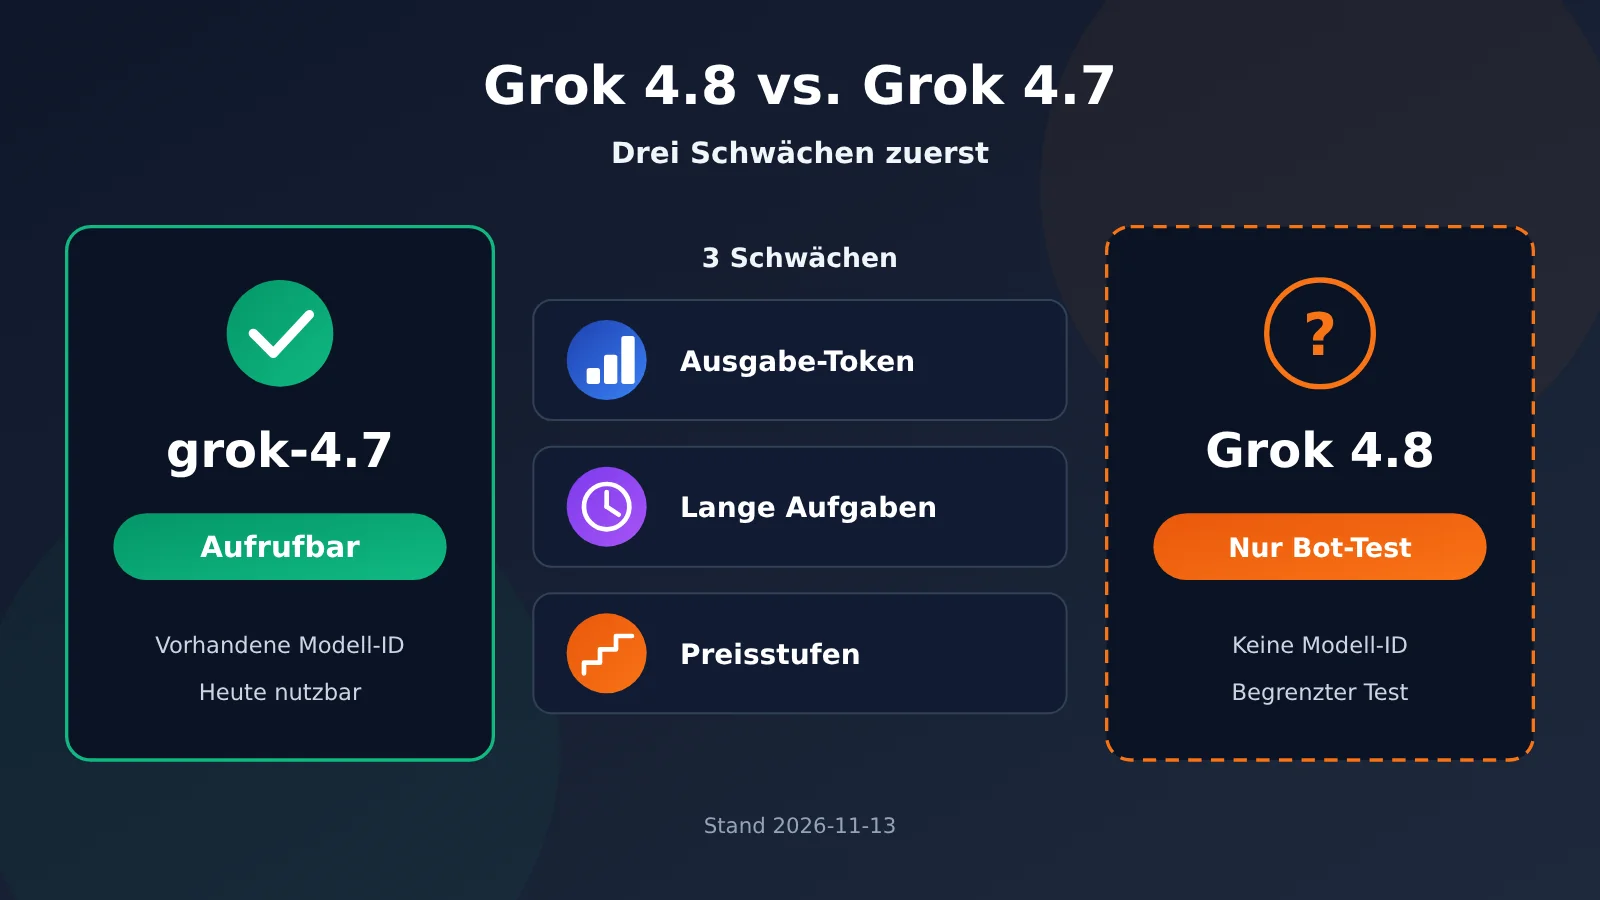
Wenn du in der Produktion bereits grok-4.7 aufrufst, wirst du dich in letzter Zeit wahrscheinlich bei einer Sache unsicher fühlen: Solltest du besser innehalten und auf Grok 4.8 warten? Fazit vorweg: Wenn du heute die API aufrufen willst, nimm grok-4.7. Stand 2026-11-13 hat Grok 4.8 keine Modell-ID, keine Modellkarte, keine Leaderboard-Punktzahlen und keinen Preis. Was Musk mit „diese Woche“ meinte, ist nur ein kleiner Testlauf (Soft Rollout) für Grok-Bot-Nutzer, keine API-Freigabe.
Das ist kein Vorab-Artikel nach dem Motto „die neue Version ist zwangsläufig stärker“. Dieser Artikel vergleicht nur die drei Schwachstellen, die sich mit den öffentlichen Daten von Grok 4.7 belegen lassen. Bei jeder Stelle ist die Quelle angegeben: offizielle Selbstauskunft, unabhängige Rangliste oder Musks eigene Worte. Danach schauen wir, ob es für Grok 4.8 derzeit Belege gibt, dass diese behoben wurden.
Der Kernwert: Nach dem Lesen weißt du, wo genau die Schwachstellen von Grok 4.7 liegen, aus wessen Daten sie stammen und wie du vor dem Start von Grok 4.8 die Kosten nach Stufen von 200.000 Token steuerst.
Grok 4.8 im Vergleich zu Grok 4.7: Was heute die richtige Wahl ist
Dieser Vergleich unterscheidet sich von den üblichen Neu-gegen-alt-Vergleichen. Zu Grok 4.8 gibt es derzeit nur ein paar Sätze von Musk auf X – keine überprüfbaren Scores. Der „Vergleich“ bedeutet hier also praktisch: Welche Schwächen von Grok 4.7 sind durch öffentliche Daten belegt, und passen die bekannten Änderungen von Grok 4.8 überhaupt zu diesen Schwächen?
| Deine Situation | Empfehlung | Begründung |
|---|---|---|
| Diese Woche Launch oder Schnittstellenänderung | grok-4.7 verwenden | In der Modellliste der Plattform steht nur grok-4.7 |
| Du prüfst eine langfristige Auswahl | Zuerst mit grok-4.7 eine Baseline fahren | 4.8 hat keine Ranglisten, ein Quervergleich ist nicht möglich |
| Du willst 4.8 sofort ausprobieren | Die Modellliste der Plattform beobachten | Ein Soft-Launch des Bots heißt nicht, dass die API verfügbar ist |
| Du hast extrem hohe Anforderungen an lange Aufgaben | Setz deine Hoffnungen nicht auf 4.8 | Es gibt keine Belege dafür, dass die Lücke bei langen Aufgaben kleiner geworden ist |
Zur Klarstellung: „Bot users“ meint die Nutzer des Grok Bot, nicht Hardware-Roboter. Ein „soft rollout“ ist eine schrittweise Einführung in kleinem Umfang, keine für Entwickler freigegebene Schnittstelle. Wer das als „Modell-ID, die man schon austauschen kann“ versteht, bekommt beim Modellaufruf direkt einen Fehler.
Grok 4.8 vs. Grok 4.7: die zentralen Unterschiede – woher die 3 Schwachstellen kommen
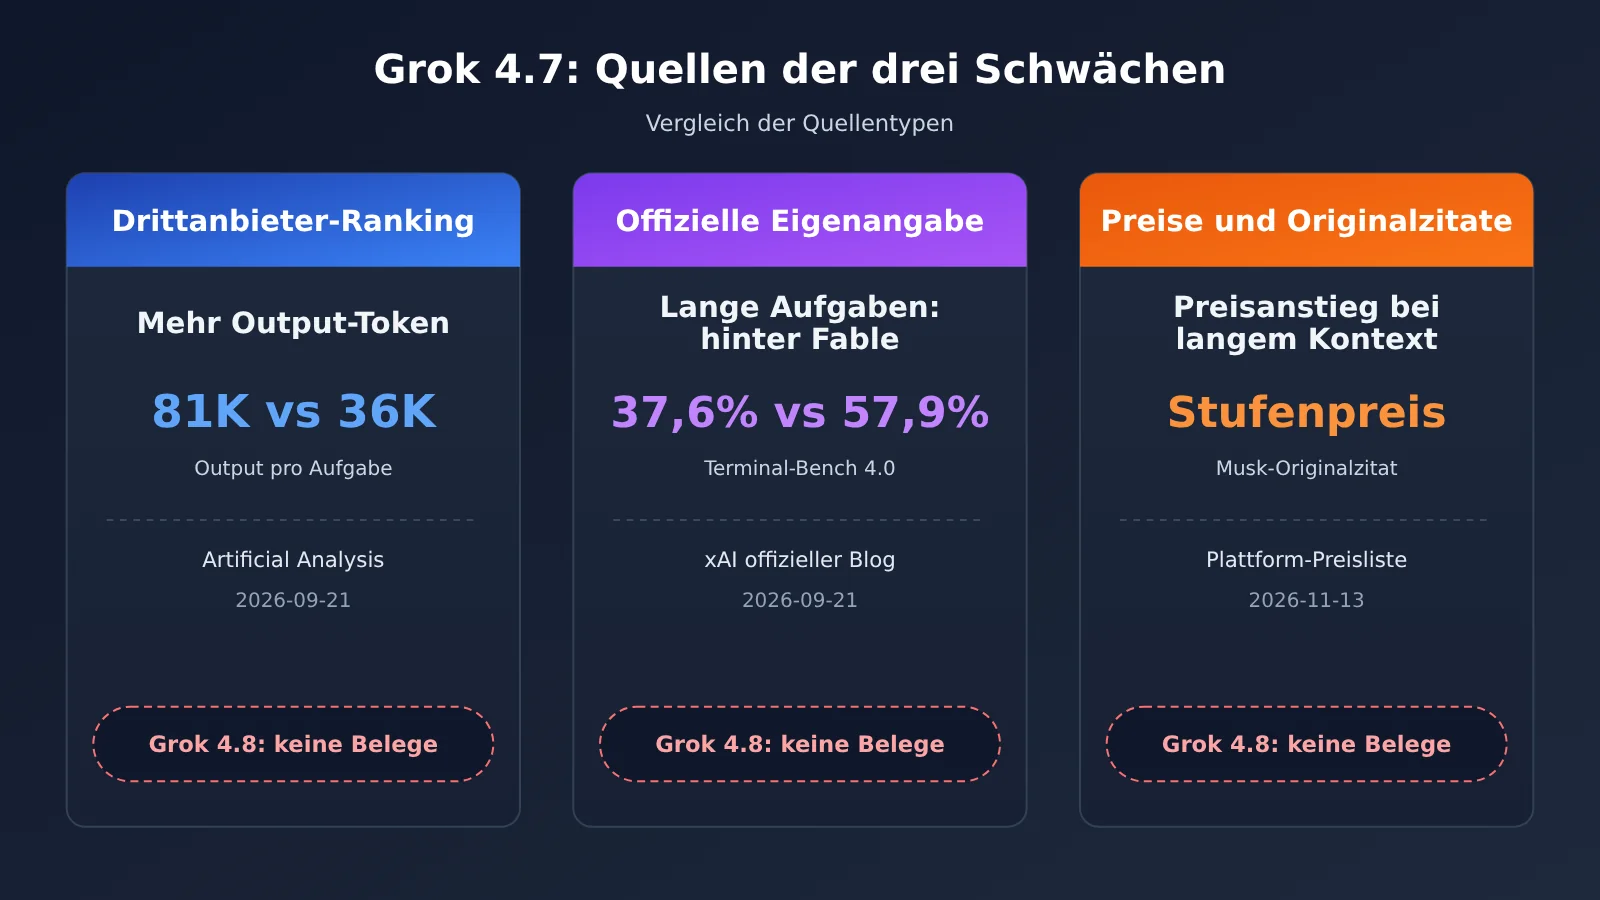
Die folgende Tabelle listet zunächst für jede der drei Schwachstellen den jeweiligen Quellentyp. Die anschließende Ausführung folgt strikt dieser Reihenfolge.
| Schwachstelle | Quellentyp | Quellendatum | Gibt es bei Grok 4.8 Belege, die das ausgleichen? |
|---|---|---|---|
| Zu viele Output-Token | Drittanbieter-Ranking (Artificial Analysis) | 2026-09-21 | Nein |
| Bei mehrstündigen Langzeitaufgaben hinter Fable zurück | Offizielle Selbstauskunft (xAI-Blog-Tabelle) | 2026-09-21 | Nein |
| Long-Context-Preise nach Stufen gestaffelt + Musk erkennt die Grundlage nicht an | Plattform-Preisliste + Originalzitat von Musk | 2026-11-13 / 2026-11-10 | Nein |
Schwachstelle 1: Grok 4.7 produziert zu viele Output-Token (Drittanbieter-Ranking)
Die Quelle hier ist die Grok-4.7-Evaluierung von Artificial Analysis, veröffentlicht am 2026-09-21. Sie stammt von einem Drittanbieter-Ranking, ist also weder eine offizielle Angabe noch ein Test des Autors dieses Artikels. Getestet wurde im xhigh-Modus; Grok 4.7 erreicht dabei einen Intelligenzindex von 46, das sind 2 Punkte mehr als bei Grok 4.6. Der Score ist gestiegen, aber der Preis dafür sind deutlich mehr Output-Token.
Die Output-Mengen aus derselben Evaluierung im Vergleich – beachten Sie, dass die beiden Grok-4.6-Werte zu unterschiedlichen Stufen gehören und nicht zu einem einzigen Wert zusammengefasst werden dürfen:
- Grok 4.7 (xhigh): pro Intelligenzindex-Aufgabe etwa
81,000Output-Token - Grok 4.6 (high): etwa
36,000Output-Token - Grok 4.6 (xhigh): etwa
38,000Output-Token; laut Evaluierung liegt 4.7 damit bei mehr als dem Doppelten - GPT-6 Astra (max): etwa
27,000Output-Token
Um die Größenordnung einzuordnen, lässt sich mit dem offiziellen Output-Preis von $6 / 1M tokens grob rechnen: 81,000 Output kosten rund $0.49, 36,000 rund $0.22. Das ist lediglich eine Umrechnung für die Aufgaben des Rankings, um zu zeigen, „wo bei derselben Aufgabe das Geld hingeht“ – es handelt sich nicht um tatsächliche Abrechnungen irgendeiner Plattform.
Artificial Analysis gibt zugleich an, dass der Kontext von Grok 4.7 500K beträgt und die Preise $2 / $6 sowie $0.50 bei Cache-Treffern identisch mit 4.6 sind. Mit anderen Worten: Der Stückpreis ist nicht gestiegen, aber jeder Task wirft mehr Token aus – die Kosten pro Aufgabe steigen also faktisch.
Schwachpunkt zwei: Grok 4.7 liegt bei mehrstündigen Langzeitaufgaben weiterhin hinter Fable (offizielle Selbstauskunft)
Diese Angabe stammt aus der Vergleichstabelle im offiziellen xAI-Blog (2026-09-21) und ist eine Selbstauskunft des Anbieters. Die vier Spaltenköpfe lauten der Reihe nach Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max und Fable 5.1 Max. Am deutlichsten zeigt sich der Rückstand bei Langzeitaufgaben in den folgenden beiden Punkten:
- Terminal-Bench 4.0: Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.6 liegt bei20.3%, GPT-5.6 Sol bei37.3%) - CursorBench 4.0: Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.6 liegt bei40.4%, GPT-5.6 Sol bei41.7%)
Doch die offizielle Tabelle bedeutet keine „umfassende Unterlegenheit“. Der Zugewinn von Grok 4.7 gegenüber 4.6 ist real, und bei zwei spezialisierten Benchmarks liegt das Modell sogar vorn:
- EEBench: Grok 4.7
64.0%– höher als die53.0%von 4.6, die39.4%von GPT-5.6 Sol und die56.4%von Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7
19.6%– höher als15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7
71.0%, laut offizieller Anmerkung mit high effort statt xhigh gemessen, knapp unter den72.7%von GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7
1657, knapp unter den1678von Fable - HealthBench Professional: Grok 4.7
56.7%– niedriger als die60.5%von GPT-5.6 Sol und die62.1%von Fable
| Benchmark der offiziellen Tabelle | Gegenüber Grok 4.6 | Gegenüber GPT-5.6 Sol | Gegenüber Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | deutlich höher | praktisch gleichauf, leicht höher | deutlicher Abstand |
| CursorBench 4.0 | höher | höher | niedriger |
| DeepSWE v1.1 | höher | etwas niedriger | etwas höher |
| EEBench | höher | höher | höher |
| Harvey Legal Agent | höher | höher | höher |
| HealthBench Professional | höher | niedriger | niedriger |
Für die Ranglisten von Drittanbietern gibt es noch einen weiteren Datensatz, der gesondert gekennzeichnet werden muss. Die Auswertung von Artificial Analysis zeigt: Gegenüber Grok 4.6 liegt Grok 4.7 bei Terminal-Bench 4.0 um 4.5 Punkte höher und bei GDP.pdf um 3.0 Punkte; bei AA-LCR dagegen 3.7 Punkte niedriger und bei AutomationBench-AA 1.1 Punkte niedriger. Die hier genannten „+4.5 Punkte“ und die 37.6% gegenüber 20.3% aus der offiziellen Tabelle beruhen nicht auf derselben absoluten Skala und dürfen nicht miteinander vermischt werden.
Schwachpunkt drei: Preisstaffelung von Grok 4.7 und Musks Originalzitate (Preisliste + Zitate)
Der dritte Punkt hat zwei Teile: erstens den Preis für langen Kontext, zweitens Musks eigene Haltung zu 4.7. Zuerst der Preis. Die Plattform-Modellübersicht und das Preis-API stimmen bei Angaben über 200.000 Token nicht vollständig überein:
| Preisposition | Plattform-Modellübersicht | Preis-API billing_expr |
|---|---|---|
| ≤ 200.000 Token Eingabe / Ausgabe / Cache-Lesen | Angegeben | Angegeben, stimmt mit der Übersicht überein |
| Eingabe über 200.000 | Angegeben | Angegeben, stimmt mit der Übersicht überein |
| Ausgabe über 200.000 | Nicht separat angegeben | Angegeben |
| Cache-Lesen über 200.000 | Nicht separat angegeben | Angegeben |
Die konkreten Zahlen lauten wie folgt; die Preisdaten haben den Stand 2026-11-13, alle Angaben gelten pro 1 Mio. Tokens:
- Niedrige Stufe (0–200.000 Token): Eingabe
$2, Ausgabe$6, Cache-Lesen$0.5; Übersicht und Preisausdruck stimmen überein - Hohe Stufe (200.001–500.000 Token), Eingabe:
$4; Übersicht und Preisausdruck stimmen überein - Hohe Stufe, Ausgabe: Der Preisausdruck lautet
$12; die Stufenangabe fehlt in der Übersicht - Hohe Stufe, Cache-Lesen: Der Preisausdruck lautet
$1; die Stufenangabe fehlt in der Übersicht
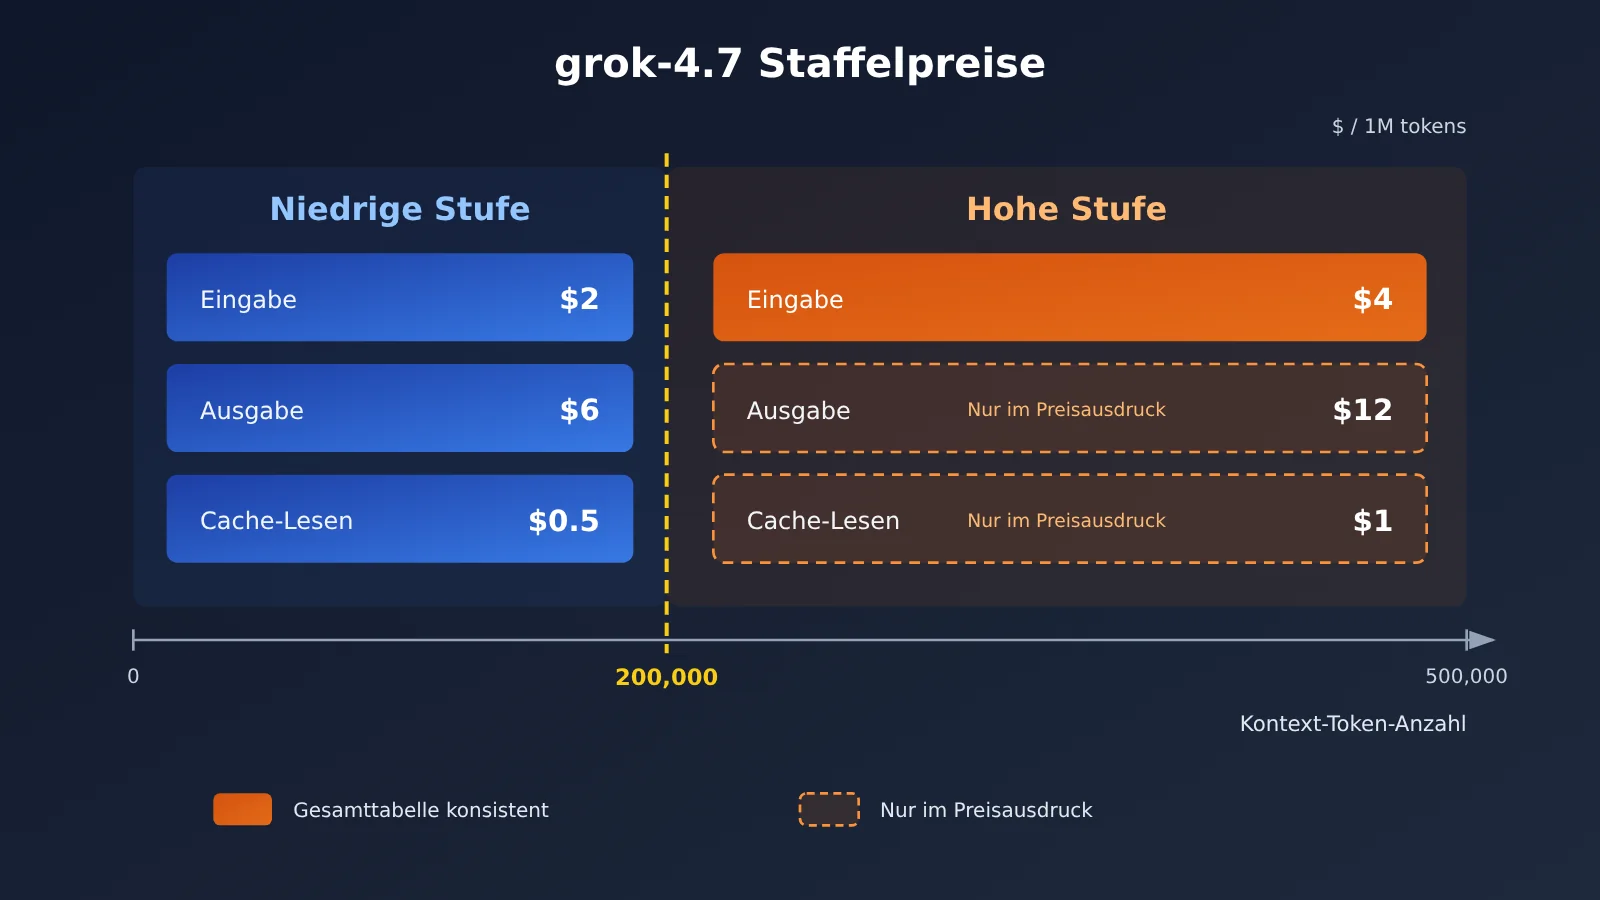
Die Preisinformationen in der obigen Abbildung stammen aus dem Preis-API und der Modellübersicht von APIYI apiyi.com; Prüfdatum: 2026-11-13; maßgeblich ist die Modellliste der Plattform.
Kommen wir nun zu den Originalzitaten. Am 2026-11-10 um 17:35 schrieb Musk auf X, Grok 4.8 „will bear no resemblance to 4.7 (thankfully). It is not yet incredible“. Am selben Tag um 18:22 schrieb er in einer Antwort außerdem: „Not as good. Opus 5.5 is a masterpiece.“ Das heißt, 4.8 ist nicht so gut wie Opus 5.5. Zugleich erwartet er, dass Grok 5 Opus 5.5 innerhalb von zwei bis drei Monaten übertreffen könnte.
Das sind Haltungen, keine Bewertungen für Grok 4.8. Wenn ein Gründer sagt, die neue Version „ähnelt 4.7 nicht, zum Glück“, zeigt das nur, dass er die Basis von 4.7 nicht anerkennt; daraus lässt sich nicht ableiten, dass 4.8 bei den oben genannten drei Schwachpunkten bereits besser geworden ist.
Kann Grok 4.8 diese 3 Schwächen beheben?
Verlässlich sagen lässt sich nur, was in Musks ursprünglichem Beitrag steht. Er erwähnt, dass JAX/SGLang aufgegeben und der Reinforcement-Learning-(RL-) und Inferenz-Stack von Grund auf in C/C++ neu geschrieben wurden; das Pretraining ist abgeschlossen; die SFT-Daten wurden kräftig bereinigt; 4.8 befindet sich derzeit in der RL-Phase, „evals are starting to climb“. Der Beitrag nennt weder Benchmark-Namen noch Punktzahlen, auch keine Parameteranzahl.
Vergleicht man diese Informationen mit den drei Schwachstellen, fällt das Fazit sehr vorsichtig aus:
- Zu viele Output-Token: Die RL-Phase kann die Ausgabelänge durchaus beeinflussen, aber er erwähnt keine Token-Effizienz.
- Rückstand bei langen Aufgaben gegenüber Fable: Weder Terminal-Bench noch CursorBench werden genannt, es gibt auch keinerlei Daten zu langen Aufgaben.
- Preis oberhalb von 200.000 Token: Es gibt überhaupt keine Preisinformationen, und 4.8 steht in keiner Preistabelle.
Die Vermutung bleibt also auf der Ebene stehen: „RL- und Inferenz-Stack neu geschrieben, SFT-Daten bereinigt.“ Aktuell gibt es keinen Beleg dafür, dass die drei Punkte oben bereits behoben sind. Erst wenn 4.8 eine Modellkarte und unabhängige Benchmarks hat, lohnt sich ein Punkt-für-Punkt-Vergleich.
Wie man heute grok-4.7 aufruft und die 200.000-Token-Grenze staffelt
Bevor 4.8 verfügbar ist, ist es die praktischere Variante, die Kosten von grok-4.7 im Griff zu haben. Der entscheidende Punkt liegt genau bei der 200.000-Token-Grenze: Sobald die Eingabe sie überschreitet, verdoppelt sich der Stückpreis direkt, und laut Preisausdruck verdoppeln sich auch Ausgabe und Cache-Read. Hier die konkreten Integrationsinfos und Empfehlungen zur Staffelung:
- Modell-ID:
grok-4.7, Endpoint chat, GruppenCodexResponses,Default,SVIP - API-Adresse: OpenAI-kompatibles Format, base_url auf
https://api.apiyi.com/v1setzen, model aufgrok-4.7stellen - Untere Stufe: Kontext pro Anfrage möglichst unter
200,000Token halten; statt ganzer Dokumente lieber Zusammenfassungen oder Retrieval-Slices einspielen - Obere Stufe/Budget: Wenn langer Kontext wirklich nötig ist, mit Input
$4, Output$12und Cache-Read$1rechnen – und beachten, dass die Gesamttabelle für die obere Stufe keinen Output-Preis ausweist - Ausgabelänge: Passend zu Schwachstelle 1 max_tokens setzen, damit die Ausgabe auf hohen Reasoning-Stufen nicht ausufert
Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform; die aktuellsten Infos gibt es unter docs.apiyi.com/models. Im offiziellen Blog wird außerdem erwähnt, dass Grok 4.7 eine fast-Variante hat – etwa doppelte Ausgabegeschwindigkeit zum etwa doppelten Preis. In der Gesamttabelle der Plattform gibt es dafür jedoch keine eigene Modell-ID; beim Aufruf also nichts selbst zusammenbauen.
🚀 Schnellstart: Sobald grok-4.8 verfügbar ist, wird APIYI apiyi.com das Modell so schnell wie möglich anbieten. Bis dahin lässt sich mit demselben API-Schlüssel erst einmal eine grok-4.7-Baseline aufsetzen; wenn 4.8 verfügbar ist, genügt ein Wechsel des model-Parameters für den Vergleich.
Grok 4.8 vs. Grok 4.7: Szenarioempfehlungen
Szenarien, in denen Sie weiterhin Grok 4.7 verwenden sollten
- Fachliche Aufgaben in den Bereichen Recht und Ingenieurwesen: In der offiziellen Tabelle belegt Grok 4.7 bei EEBench und Harvey Legal Agent jeweils Platz eins. Bei solchen Aufgaben gibt es keinen Grund zu warten.
- Geschäftsprozesse mit einem kontrollierbaren Kontextfenster von bis zu 200.000 Token: Sie lassen sich stabil in der niedrigen Preiskategorie halten; der Stückpreis entspricht dem von 4.6.
- Projekte, die sofort live gehen müssen: grok-4.7 ist derzeit die einzige Version, die sich aufrufen lässt.
Szenarien, bei denen sich ein weiteres Beobachten von Grok 4.8 lohnt
- Agenten, die mehrere Stunden laufen / lange Terminal-Aufgaben: Bei Terminal-Bench 4.0 und Fable 5.1 sind die Unterschiede deutlich. Bewerten Sie parallel andere Modelle als Alternativen.
- Batch-Aufgaben, die empfindlich auf Kosten für Ausgabe-Token reagieren: Drittanbieter-Ranglisten zeigen, dass die Ausgaben von 4.7 eher lang sind. Würde 4.8 das verbessern, senkte das direkt die Kosten; bisher gibt es dafür jedoch keine Belege.
- Anwendungen, die stark auf Kontextfenster über 200.000 Token angewiesen sind: Der Preis der hohen Kategorie verdoppelt sich. Achten Sie auf die Preisgestaltung, sobald 4.8 verfügbar ist.
Grok 4.8 vs. Grok 4.7: Entscheidungshilfe
| Fokus | Aktuelle Maßnahme | Wann neu bewerten |
|---|---|---|
| Stabilität im Produktivbetrieb | grok-4.7 verwenden | wenn 4.8 in der Modellliste der Plattform erscheint |
| Kosten pro Aufgabe | Kontext- und Ausgabelänge begrenzen | wenn für 4.8 Tokenverbrauchsdaten von Drittanbietern vorliegen |
| Fähigkeit bei langen Aufgaben | alternative Modelle parallel bewerten | wenn für 4.8 Ergebnisse zu Terminal-Bench und weiteren Benchmarks veröffentlicht werden |
| Preistransparenz | Budget auf Basis der Preis-API planen | wenn die Plattformübersicht die Ausgabepreise der hohen Kategorie ergänzt |
💡 Auswahlempfehlung: Welche Version Sie wählen, hängt davon ab, ob Ihre Aufgabe eine lange Aufgabe ist und ob Sie häufig die Grenze von 200.000 Token überschreiten. Testen Sie über APIYI apiyi.com mit derselben API Ihre eigenen Beispiele und entscheiden Sie dann, ob Sie lange Aufgaben auf andere Modelle verlagern.
Häufig gestellte Fragen (FAQ)
Q1: Lässt sich Grok 4.8 inzwischen über die API aufrufen?
Nein. Stand 2026-11-13 hat Grok 4.8 keine Modell-ID. Sowohl in der Modellübersichtstabelle der Plattform als auch in der Preis-API findet sich ausschließlich grok-4.7. Der von Musk angekündigte Soft-Launch in dieser Woche richtet sich nur an Nutzer von Grok Bot.
Q2: Wer ist besser – Grok 4.8 oder Grok 4.7?
Das lässt sich derzeit nicht beurteilen. Grok 4.8 hat keine öffentlichen Rankings oder Scores. Musk sagt lediglich, die Benchmarks würden „steigen“, sie seien „noch nicht beeindruckend“ und „nicht so gut wie Opus 5.5“. Das sind Haltungen, keine vergleichbaren Daten.
Q3: Woher stammt die Aussage, dass Grok 4.7 mehr Ausgabe-Tokens erzeugt?
Sie stammt aus der Drittanbieter-Bewertung von Artificial Analysis vom 2026-09-21, Teststufe xhigh. Pro Aufgabe fallen rund 81.000 Ausgabe-Tokens an, im Vergleich zu 36.000 bei 4.6 high und 38.000 bei 4.6 xhigh. Das sind keine offiziellen Daten.
Q4: Ist Grok 4.7 durchgängig schlechter geworden als Grok 4.6?
Nein. In der offiziellen Tabelle liegt Grok 4.7 bei Terminal-Bench, CursorBench, EEBench und mehreren weiteren Benchmarks über 4.6. Die Drittanbieter-Rangliste zeigt bei AA-LCR 3,7 Punkte weniger und bei AutomationBench-AA 1,1 Punkte weniger – das sind einzelne Rückschritte.
Q5: Wie rufe ich grok-4.7 schon jetzt auf?
Registrieren Sie sich bei APIYI apiyi.com und holen Sie sich einen API-Schlüssel; neue Nutzer erhalten ein kostenloses Testkontingent. Verwenden Sie das OpenAI-kompatible SDK, tragen Sie als base_url die Adresse der Plattform-API ein und setzen Sie model auf grok-4.7.
Q6: Wie wird eine Ausgabe von über 200.000 Tokens genau abgerechnet?
Der Preisausdruck nennt für die Ausgabe $12 und für das Cache-Lesen $1. Die Staffelung in der Übersichtstabelle nennt dagegen nur $4 für die Eingabe in der hohen Stufe, ohne eine separate Ausgabe in der hohen Stufe auszuweisen. Die beiden Angaben stimmen nicht vollständig überein. Für die Budgetplanung empfiehlt sich eine konservative Schätzung anhand des Preisausdrucks; maßgeblich ist die Modellliste der Plattform.
Q7: Wie migriere ich, sobald Grok 4.8 verfügbar ist?
In den Echtzeit-Updates der Plattform gibt es noch keinen Eintrag zur Aufnahme von Grok 4.8. Nach der Aufnahme reicht in der Regel das Ersetzen des model-Parameters. Empfohlen ist, zuerst mit derselben Stichprobe Ausgabe-Tokens, Erfolgsquote bei langen Aufgaben und gestaffelte Kosten zu vergleichen und erst dann den Traffic umzustellen.
Grok 4.8 vs. Grok 4.7: Die wichtigsten Erkenntnisse
- Was heute geht: Für API-Aufrufe nutzen Sie grok-4.7; für Grok 4.8 gibt es noch keine Modell-ID.
- Schwachpunkt eins (Drittanbieter-Bestenliste): Bei xhigh fallen pro Aufgabe rund 81.000 Ausgabe-Token an – das ist recht lang.
- Schwachpunkt zwei (offizielle Angabe): Bei Terminal-Bench und CursorBench liegt Grok 4.7 weiterhin hinter Fable 5.1.
- Nicht durchgehend schlechter: Bei EEBench und Harvey belegt Grok 4.7 jeweils Platz eins.
- Schwachpunkt drei (Preisliste + Originalzitat): Bei mehr als 200.000 Token Input verdoppelt sich der Preis; Elon Musk erkennt 4.7 nicht als Grundlage an.
- Bekannte Änderungen in 4.8: RL- und Inferenz-Stack wurden neu geschrieben, SFT bereinigt – es gibt aber keine Belege dafür, dass die drei Schwachpunkte behoben wurden.
- So legen Sie los: Starten Sie über APIYI apiyi.com zunächst mit einer grok-4.7-Baseline und vergleichen Sie direkt, sobald 4.8 verfügbar ist.
Zusammenfassung
Die Kernpunkte im Vergleich von Grok 4.8 und Grok 4.7:
- Verfügbarkeit: Stand 2026-11-13 lässt sich nur grok-4.7 aufrufen. Ein Soft Launch im Bot bedeutet nicht, dass die API offen ist.
- Drei Schwachpunkte: zu viele Ausgabe-Token (Drittanbieter-Bestenliste), Rückstand bei langen Aufgaben gegenüber Fable (offizielle Angabe), Preiserhöhung für langen Kontext und Aussage des Gründers (Preisliste und Originalzitat) – die Quellen sind jeweils unterschiedlich.
- Belege für 4.8: Bislang gibt es nur Aussagen zu neu geschriebenem RL- und Inferenz-Stack sowie bereinigtem SFT; keine Scores, Preise oder Modellkarte.
Statt abzuwarten, sollten Sie zunächst die Kontextstufen und die Ausgabelänge von grok-4.7 im Griff haben und dann, sobald für 4.8 überprüfbare Daten vorliegen, Punkt für Punkt vergleichen. Empfohlen: Prüfen Sie über APIYI apiyi.com mit einer einheitlichen Schnittstelle zuerst, wie grok-4.7 in Ihren Anwendungsfällen abschneidet, und sichern Sie so eine Baseline für den späteren Wechsel.
📚 Referenzen
- Offizieller xAI-Blog – Veröffentlichung von Grok 4.7: die vom Unternehmen selbst gemeldete Benchmark-Vergleichstabelle und Preisgestaltung
- Link:
x.ai/news/grok-4-7 -
Beschreibung: Datenquellen für Terminal-Bench 4.0, CursorBench 4.0, EEBench und weitere
-
Artificial Analysis – Bewertung von Grok 4.7: eine Rangliste von Drittanbietern, einschließlich des Verbrauchs an Output-Token
- Link:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Beschreibung: Veränderungen beim Intelligenzindex, beim Output-Token-Vergleich, bei AA-LCR und weiteren Punkten
-
Musk-Beitrag auf X (10.11.2026): das wörtliche Zitat zum Fortschritt von Grok 4.8
- Link:
x.com/elonmusk/status/2120088070443655190 -
Beschreibung: Neufassung von RL und Inferenz-Stack, SFT-Bereinigung, Soft-Release des Bots
-
Musk-Antwort auf X (10.11.2026): eine Aussage zum Vergleich von 4.8 mit Opus 5.5
- Link:
x.com/elonmusk/status/2120099798078656909 -
Beschreibung: die Quelle für „Not as good“
-
APIYI-Modellübersicht: grok-4.7-Modelle, Gruppen und gestaffelte Preise
- Link:
docs.apiyi.com/models - Beschreibung: Modelle und Preise gelten gemäß dieser Übersicht; Stand der Prüfung: 13.11.2026
Autor: APIYI-Technikteam
Technischer Austausch: Sie können uns gerne über die Startseite der APIYI-Website kontaktieren; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com