Catatan penulis: Hari ini mau memanggil API, lanjut pakai grok-4.7. Hingga 2026-11-13, Grok 4.8 belum punya ID model; artikel ini memeriksa tiga kelemahan Grok 4.7 berdasarkan sumber, untuk melihat apakah 4.8 sudah punya bukti yang menutupinya.
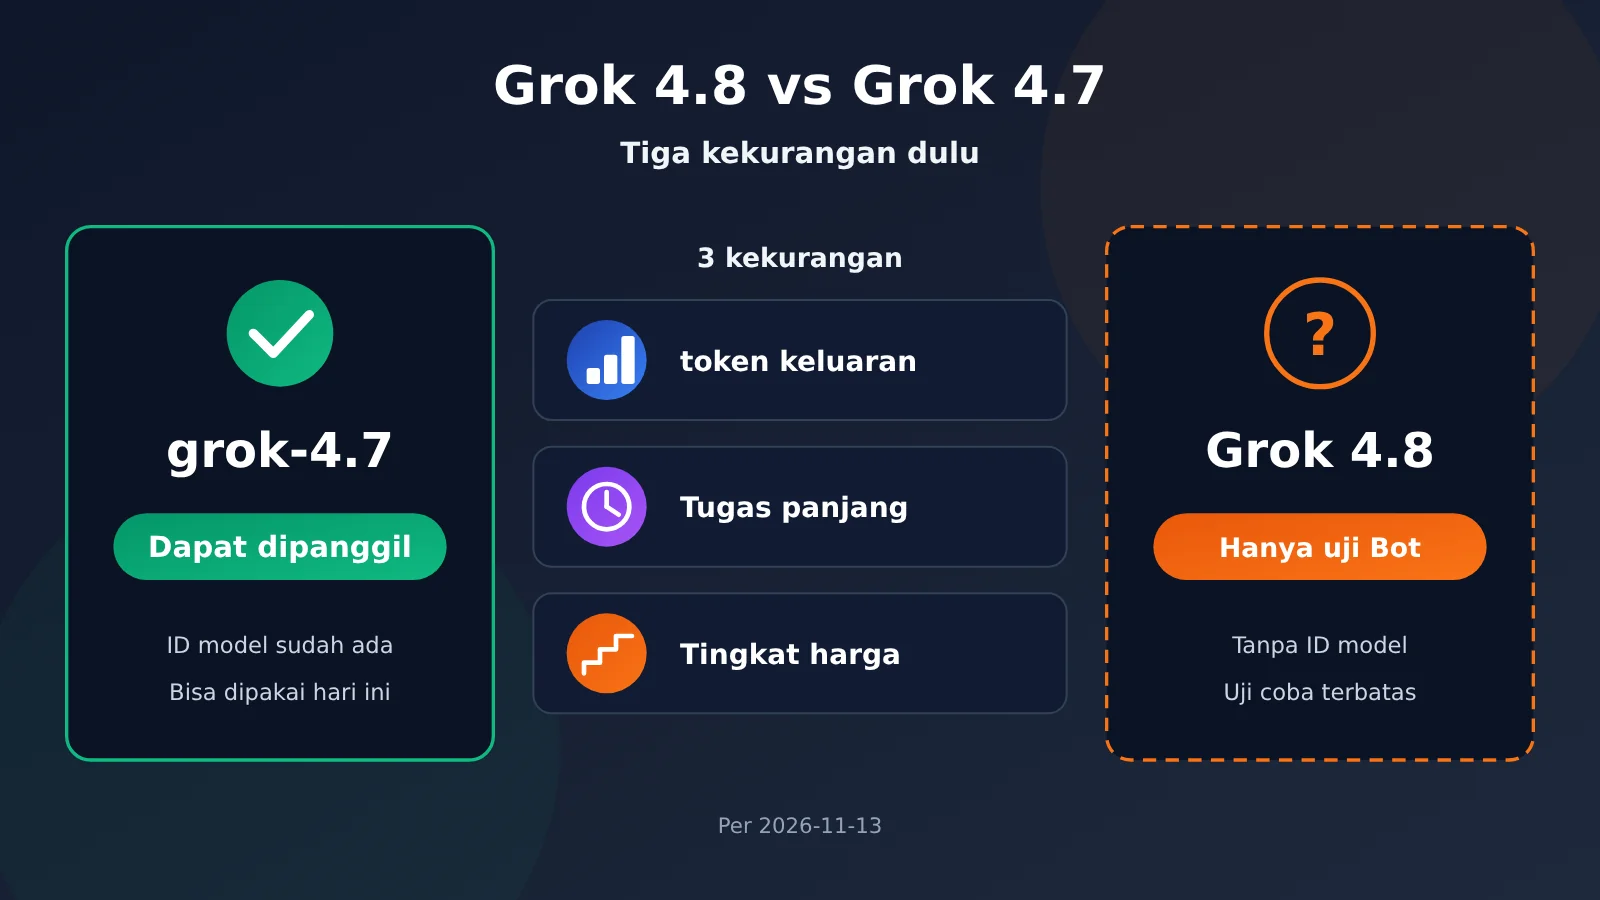
Jika Anda sudah memanggil grok-4.7 di produksi, akhir-akhir ini mungkin Anda ragu soal satu hal: apakah harus berhenti dan menunggu Grok 4.8. Langsung ke kesimpulan: kalau hari ini mau memanggil API, pakai grok-4.7. Per 2026-11-13, Grok 4.8 belum punya ID model, model card, skor leaderboard, maupun harga. Pernyataan Musk soal “minggu ini” hanyalah uji coba terbatas (soft rollout) untuk pengguna Grok Bot, bukan pembukaan API.
Ini bukan artikel pratinjau yang mengasumsikan “versi baru pasti lebih kuat”. Artikel ini hanya membandingkan tiga kelemahan yang bisa dicocokkan dari data publik Grok 4.7. Setiap poin mencantumkan sumbernya: klaim resmi sendiri, leaderboard pihak ketiga, atau kata-kata langsung Musk. Setelah itu, kita lihat apakah Grok 4.8 saat ini punya bukti untuk menutupinya.
Nilai inti: Setelah membaca artikel ini, Anda akan tahu persis di mana kelemahan Grok 4.7, berasal dari data siapa, dan bagaimana mengontrol biaya berdasarkan tier 200 ribu token sebelum Grok 4.8 tersedia.
Grok 4.8 vs Grok 4.7: bagaimana memilih hari ini
Perbandingan ini berbeda dari perbandingan versi baru dan lama yang biasa. Untuk Grok 4.8 saat ini hanya ada beberapa kalimat dari Elon Musk di X, tanpa skor apa pun yang bisa diverifikasi. Jadi, makna “perbandingan” di sini sebenarnya adalah: kekurangan Grok 4.7 mana yang sudah tercatat dalam data publik, dan apakah perubahan Grok 4.8 yang diketahui bisa menjawab kekurangan tersebut.
| Kondisi Anda | Saran | Alasan |
|---|---|---|
| Perlu rilis atau mengubah API minggu ini | Gunakan grok-4.7 | Di daftar model platform hanya ada grok-4.7 |
| Sedang mengevaluasi pilihan jangka panjang | Jalankan baseline dengan grok-4.7 terlebih dahulu | 4.8 belum punya papan peringkat, jadi tidak bisa dibandingkan secara berdampingan |
| Ingin mencoba 4.8 secepat mungkin | Pantau daftar model platform | Rilis lunak Bot tidak sama dengan API yang tersedia |
| Persyaratan untuk tugas panjang sangat tinggi | Jangan menggantungkan harapan pada 4.8 | Tidak ada bukti bahwa kesenjangan pada tugas panjang sudah menyempit |
Perlu dijelaskan bahwa “Bot users” merujuk pada pengguna Grok Bot, bukan robot perangkat keras. “soft rollout” adalah peluncuran bertahap dalam lingkup kecil, bukan antarmuka yang dibuka untuk pengembang. Jika menganggapnya sebagai “ID model yang sudah bisa diganti”, akan langsung menyebabkan error saat pemanggilan.
Grok 4.8 vs Grok 4.7: perbedaan inti — asal-usul 3 kelemahan
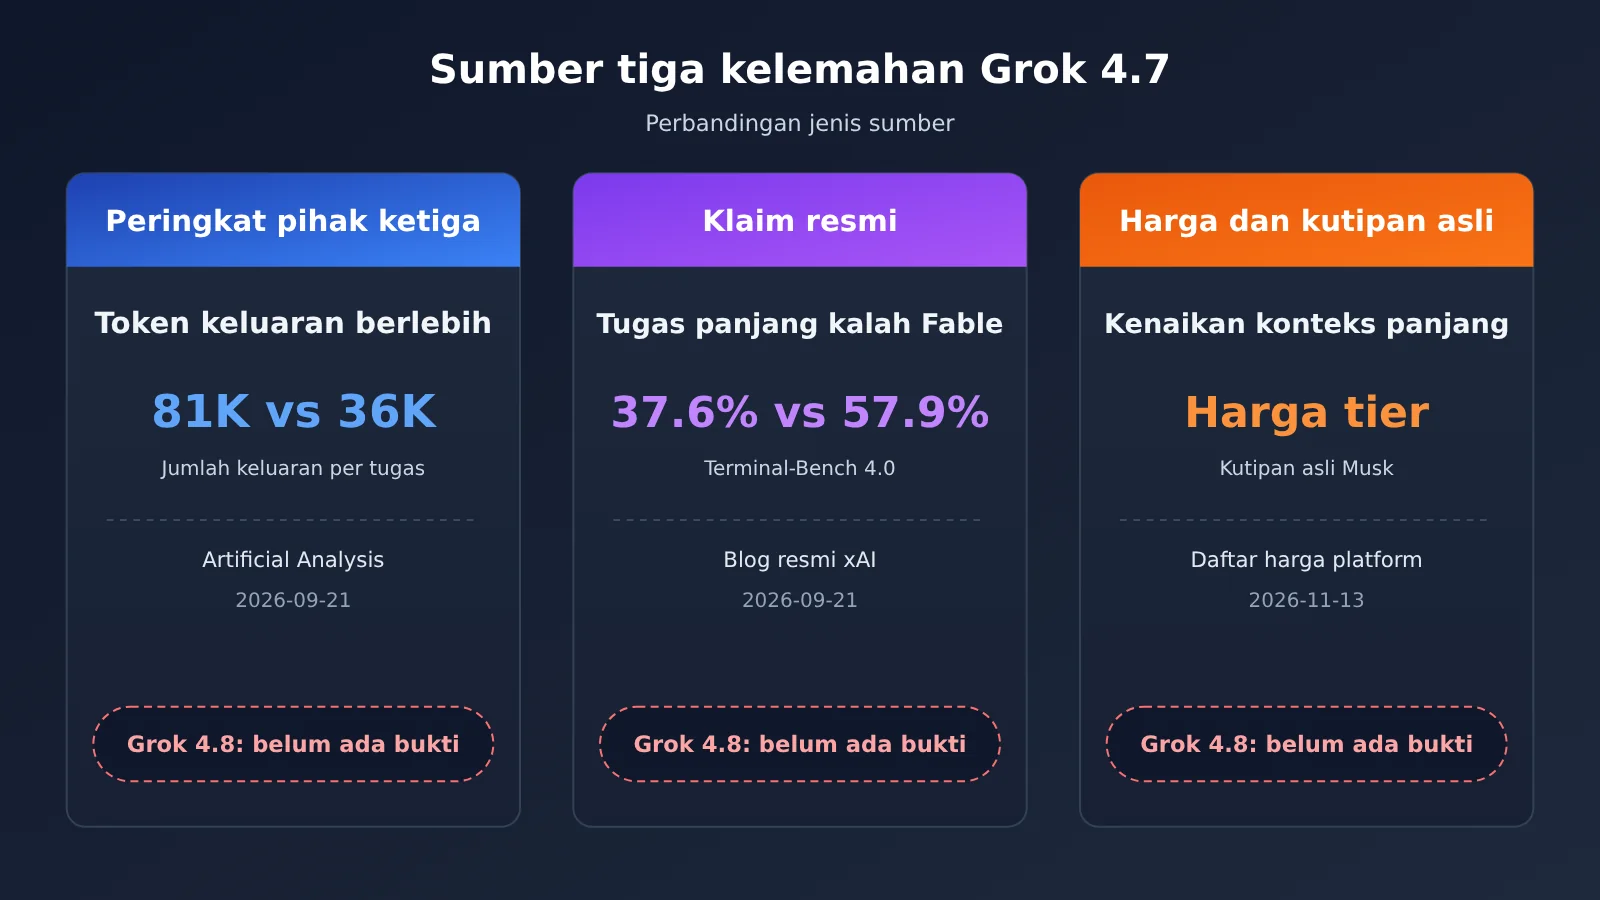
Tabel berikut terlebih dahulu mencantumkan jenis sumber untuk masing-masing dari tiga kelemahan. Pembahasan setelahnya akan mengikuti urutan ini secara ketat.
| Kelemahan | Jenis sumber | Tanggal sumber | Apakah Grok 4.8 punya bukti untuk menutupinya |
|---|---|---|---|
| Token output terlalu banyak | Papan peringkat pihak ketiga (Artificial Analysis) | 2026-09-21 | Tidak |
| Tertinggal dari Fable pada tugas panjang berjam-jam | Laporan resmi sendiri (tabel blog xAI) | 2026-09-21 | Tidak |
| Harga bertingkat untuk konteks panjang + Elon Musk tidak mengakui kemampuan dasarnya | Daftar harga platform + kutipan langsung Musk | 2026-11-13 / 2026-11-10 | Tidak |
Kelemahan pertama: token output Grok 4.7 terlalu banyak (papan peringkat pihak ketiga)
Sumber untuk bagian ini adalah evaluasi Grok 4.7 yang dirilis Artificial Analysis pada 2026-09-21; ini termasuk papan peringkat pihak ketiga, bukan data resmi, dan juga bukan pengujian penulis artikel ini. Mereka menguji pada tingkat xhigh; indeks kecerdasan Grok 4.7 adalah 46, lebih tinggi 2 poin daripada Grok 4.6. Skornya naik, tetapi konsekuensinya adalah jumlah token output yang meningkat jelas.
Perbandingan volume output dalam evaluasi yang sama adalah sebagai berikut; perhatikan bahwa dua angka Grok 4.6 mengacu pada tingkat berbeda dan tidak bisa digabungkan menjadi satu:
- Grok 4.7 (xhigh): sekitar
81,000token output per tugas indeks kecerdasan - Grok 4.6 (high): sekitar
36,000token output - Grok 4.6 (xhigh): sekitar
38,000token output; evaluasi menyebut 4.7 lebih dari dua kali lipatnya - GPT-6 Astra (max): sekitar
27,000token output
Untuk merasakan skalanya, kita bisa menghitung kasar dengan harga output resmi $6 / 1M tokens: output 81 ribu sekitar $0.49, sedangkan 36 ribu sekitar $0.22. Ini hanyalah metode konversi untuk tugas papan peringkat, dipakai untuk menjelaskan “untuk soal yang sama, uangnya habis di mana”, bukan tagihan aktual platform mana pun.
Artificial Analysis juga menulis bahwa konteks Grok 4.7 adalah 500K, harga tercantumnya $2 / $6, cache hit $0.50, semuanya sama dengan 4.6. Dengan kata lain, harga satuan tidak naik, tetapi token yang dikeluarkan per tugas lebih banyak, sehingga biaya per tugas sebenarnya meningkat.
Kekurangan kedua: tugas panjang multi-jam Grok 4.7 masih tertinggal dari Fable (laporan resmi sendiri)
Sumber bagian ini adalah tabel perbandingan dalam blog resmi xAI (2026-09-21), dan sifatnya adalah laporan resmi sendiri. Empat kolom header secara berurutan adalah Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max, dan Fable 5.1 Max. Dua butir berikut paling jelas menunjukkan kesenjangan pada tugas panjang:
- Terminal-Bench 4.0: Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.620.3%, GPT-5.6 Sol37.3%) - CursorBench 4.0: Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.640.4%, GPT-5.6 Sol41.7%)
Namun tabel resmi tidak berarti “tertinggal di semua aspek”. Peningkatan Grok 4.7 dibandingkan 4.6 memang nyata, dan Grok 4.7 berada di peringkat pertama pada dua benchmark profesional:
- EEBench: Grok 4.7
64.0%, lebih tinggi dari53.0%milik 4.6,39.4%milik GPT-5.6 Sol, dan56.4%milik Fable 5.1 - Harvey Legal Agent Benchmark: Grok 4.7
19.6%, lebih tinggi dari15.8%/2.5%/6.7% - DeepSWE v1.1: Grok 4.7
71.0%, dicatat resmi sebagai high effort dan bukan xhigh, sedikit lebih rendah dari72.7%milik GPT-5.6 Sol - AA Briefcase v1.1: Grok 4.7
1657, sedikit lebih rendah dari1678milik Fable - HealthBench Professional: Grok 4.7
56.7%, lebih rendah dari60.5%milik GPT-5.6 Sol dan62.1%milik Fable
| Benchmark di tabel resmi | Dibanding Grok 4.6 | Dibanding GPT-5.6 Sol | Dibanding Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | Jelas lebih tinggi | Praktis setara, sedikit lebih tinggi | Kesenjangan jelas |
| CursorBench 4.0 | Lebih tinggi | Lebih tinggi | Lebih rendah |
| DeepSWE v1.1 | Lebih tinggi | Sedikit lebih rendah | Sedikit lebih tinggi |
| EEBench | Lebih tinggi | Lebih tinggi | Lebih tinggi |
| Harvey Legal Agent | Lebih tinggi | Lebih tinggi | Lebih tinggi |
| HealthBench Professional | Lebih tinggi | Lebih rendah | Lebih rendah |
Ada satu set data lain dari peringkat pihak ketiga yang perlu ditandai secara terpisah. Evaluasi Artificial Analysis menunjukkan bahwa dibandingkan Grok 4.6, Grok 4.7 lebih tinggi 4.5 poin pada Terminal-Bench 4.0 dan 3.0 poin pada GDP.pdf; tetapi lebih rendah 3.7 poin pada AA-LCR dan 1.1 poin pada AutomationBench-AA. Angka “+4.5 poin” di sini bukan skor absolut yang sama dengan 37.6% versus 20.3% pada tabel resmi, jadi keduanya tidak boleh dicampur.
Kekurangan ketiga: tingkatan harga Grok 4.7 dan kutipan langsung Elon Musk (daftar harga + kutipan)
Poin ketiga ini punya dua bagian: pertama, harga untuk konteks panjang; kedua, sikap Elon Musk sendiri terhadap 4.7. Kita lihat harganya dulu. Tabel ringkasan platform dan antarmuka daftar harga tidak sepenuhnya konsisten dalam mencatat token di atas 200 ribu:
| Item harga | Tabel model platform | Ekspresi billing antarmuka harga |
|---|---|---|
| Input / output / cache read ≤ 200 ribu token | sudah dicantumkan | sudah dicantumkan, konsisten dengan tabel ringkasan |
| Input di atas 200 ribu | sudah dicantumkan | sudah dicantumkan, konsisten dengan tabel ringkasan |
| Output di atas 200 ribu | tidak dicantumkan secara terpisah | sudah dicantumkan |
| Cache read di atas 200 ribu | tidak dicantumkan secara terpisah | sudah dicantumkan |
Angka rincinya sebagai berikut; tanggal data harga 2026-11-13, satuannya per 1M token:
- Tarif rendah (0–200,000 token): input
$2, output$6, cache read$0.5; tabel ringkasan dan ekspresi harga konsisten - Input tarif tinggi (200,001–500,000 token):
$4; tabel ringkasan dan ekspresi harga konsisten - Output tarif tinggi: ekspresi harga
$12; tingkatan di tabel ringkasan tidak ditulis - Cache read tarif tinggi: ekspresi harga
$1; tingkatan di tabel ringkasan tidak ditulis
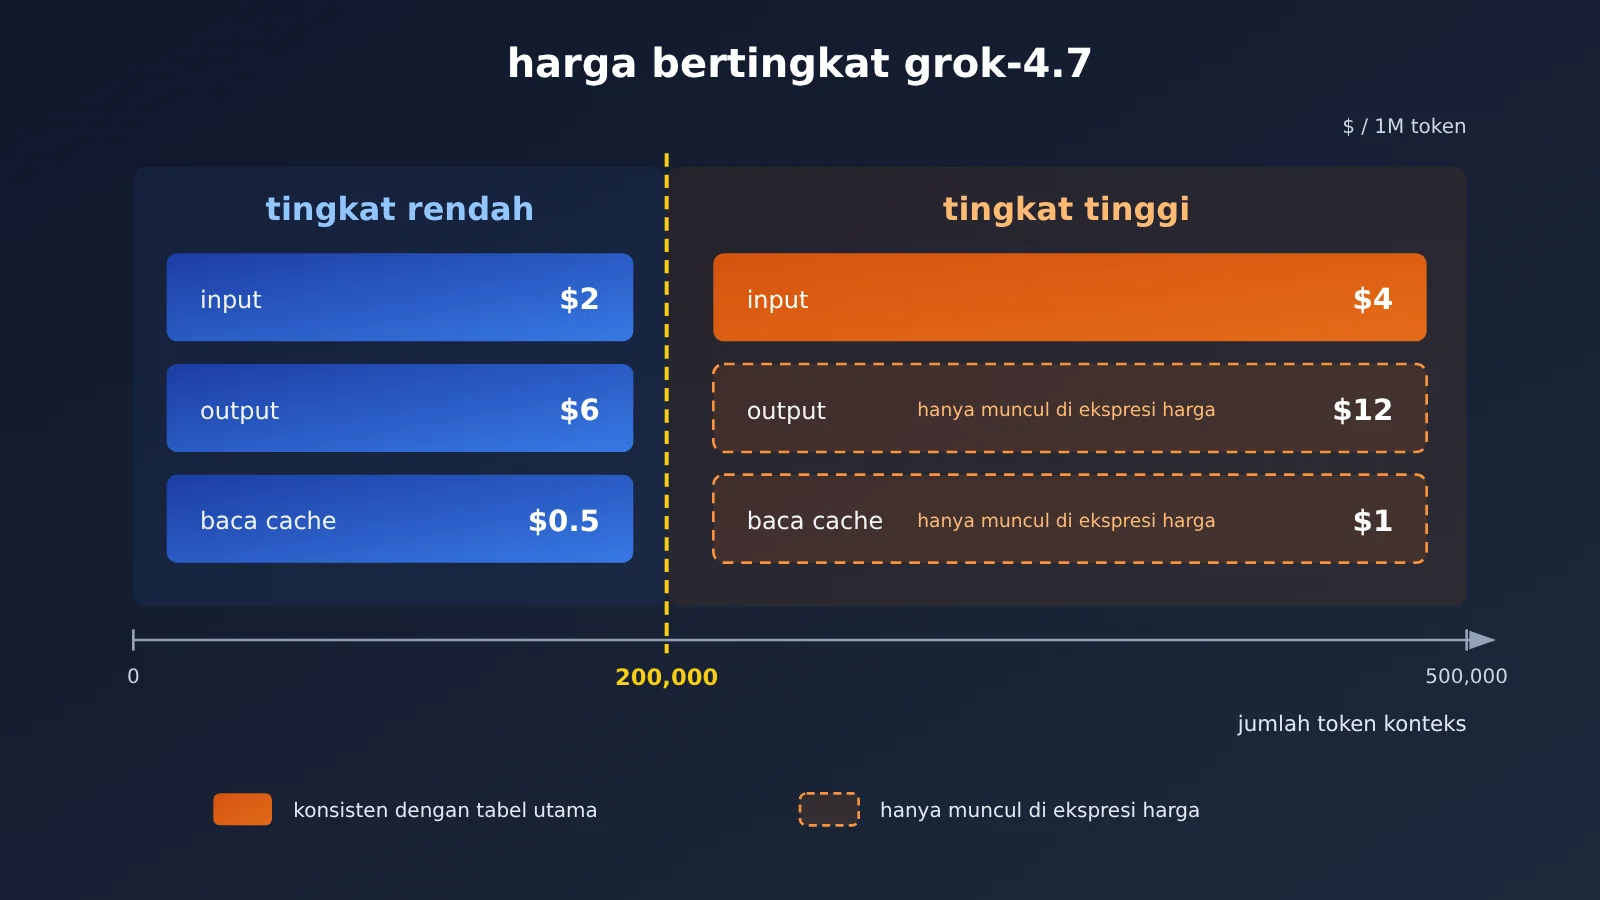
Informasi harga pada gambar di atas berasal dari antarmuka daftar harga dan tabel ringkasan model APIYI apiyi.com, tanggal verifikasi 2026-11-13, dengan daftar model platform sebagai acuan.
Sekarang kutipannya. Pada 2026-11-10 pukul 17:35, Elon Musk mengatakan di X bahwa Grok 4.8 “will bear no resemblance to 4.7 (thankfully). It is not yet incredible”. Pada hari yang sama pukul 18:22, dalam balasannya ia juga berkata “Not as good. Opus 5.5 is a masterpiece.”, yang berarti 4.8 masih belum sebaik Opus 5.5. Ia juga memperkirakan Grok 5 berpeluang melampaui Opus 5.5 dalam dua hingga tiga bulan.
Ini soal sikap, bukan nilai Grok 4.8. Pernyataan seorang pendiri bahwa versi baru “tidak mirip 4.7, untunglah” hanya menunjukkan bahwa ia tidak mengapresiasi fondasi 4.7; itu bukan bukti bahwa 4.8 sudah membaik pada tiga titik lemah di atas.
Bisakah Grok 4.8 menutup 3 kekurangan ini?
Yang bisa dikatakan hanya sebatas isi postingan asli Musk. Ia menyebut telah meninggalkan JAX/SGLang dan menulis ulang stack reinforcement learning (RL) serta inference dari nol dengan C/C++; pretraining sudah selesai; data SFT dibersihkan besar-besaran; 4.8 saat ini berada di fase RL, “evals are starting to climb”. Postingan itu tidak menyebutkan nama benchmark atau skor apa pun, juga tidak menyebut jumlah parameter.
Jika informasi ini dibandingkan dengan tiga kekurangan tadi, kesimpulannya sangat konservatif:
- Output token cenderung berlebihan: fase RL memang mungkin memengaruhi panjang output, tetapi ia tidak menyinggung efisiensi token.
- Tertinggal dari Fable pada tugas panjang: tidak ada penyebutan Terminal-Bench atau CursorBench, juga tidak ada data tugas panjang apa pun.
- Harga untuk konteks di atas 200 ribu token: tidak ada informasi harga sama sekali, dan 4.8 juga belum masuk daftar harga mana pun.
Jadi, dugaan hanya bisa berhenti pada lapisan “menulis ulang stack RL dan inference, serta membersihkan data SFT”. Saat ini belum ada bukti bahwa tiga kekurangan di atas sudah diperbaiki. Baru setelah 4.8 punya model card dan peringkat pihak ketiga, perbandingan per poin menjadi bermakna.
Sekarang mau pakai grok-4.7, bagaimana pembagian tier untuk 200 ribu token?
Sebelum 4.8 dirilis, cara yang lebih praktis adalah mengendalikan biaya grok-4.7 dengan baik. Poin kuncinya ada di garis 200 ribu token: begitu input melewati batas itu, harga satuan langsung dua kali lipat, dan menurut ekspresi daftar harga, output serta cache read juga ikut dua kali lipat. Berikut informasi akses dan saran pembagian tier yang bisa langsung diterapkan:
- ID model:
grok-4.7, endpoint chat, grup meliputiCodexResponses,Default,SVIP - Alamat API: format kompatibel OpenAI, isi base_url dengan
https://api.apiyi.com/v1, lalu set model kegrok-4.7 - Kendali tier rendah: usahakan konteks per permintaan tetap di bawah
200,000token; bisa gunakan ringkasan atau potongan hasil retrieval sebagai ganti menjejalkan seluruh dokumen - Anggaran tier tinggi: bila benar-benar butuh konteks panjang, perkirakan dengan input
$4, output$12, cache read$1, dan perhatikan ketidaksesuaian karena tabel total tidak mencantumkan output tier tinggi - Panjang output: mengacu pada kekurangan pertama, set max_tokens untuk tugas yang membutuhkannya, agar output tidak lepas kendali pada tingkat reasoning tinggi
Model dan harga mengacu pada daftar model platform; informasi terbaru bisa dilihat di docs.apiyi.com/models. Blog resmi juga menyebut Grok 4.7 punya varian fast dengan kecepatan output sekitar dua kali dan harga sekitar dua kali, tetapi tabel total platform tidak memiliki ID model fast tersendiri, jadi jangan menulisnya sendiri saat memanggil.
🚀 Mulai cepat: setelah grok-4.8 dirilis, APIYI apiyi.com akan segera memasukkan model ini. Sebelum itu, jalankan dulu baseline grok-4.7 dengan kunci API yang sama; ketika 4.8 tersedia, cukup ubah satu parameter model untuk membandingkan.
Rekomendasi Skenario: Grok 4.8 vs Grok 4.7
Skenario yang Cocok Tetap Memakai Grok 4.7
- Tugas profesional di bidang hukum dan teknik: Pada tabel resmi, Grok 4.7 menempati peringkat pertama untuk EEBench dan Harvey Legal Agent. Untuk tugas seperti ini, tidak ada alasan untuk menunggu.
- Bisnis dengan konteks yang bisa dijaga di bawah 200 ribu token: Dapat tetap stabil di tingkat harga rendah, dengan harga per unit yang sama seperti 4.6.
- Proyek yang perlu segera diluncurkan: grok-4.7 adalah satu-satunya versi yang saat ini bisa digunakan.
Skenario yang Layak Terus Dipantau untuk Grok 4.8
- Agent multi-jam / tugas terminal berdurasi panjang: Selisih pada Terminal-Bench 4.0 dan Fable 5.1 cukup jelas; Anda bisa sekaligus mengevaluasi model lain sebagai cadangan.
- Tugas batch yang sensitif terhadap biaya token output: Peringkat pihak ketiga menunjukkan output 4.7 cenderung terlalu panjang. Jika 4.8 membaik, biaya bisa langsung turun, tetapi saat ini belum ada bukti.
- Aplikasi yang sangat bergantung pada konteks di atas 200 ribu token: Harga tier tinggi menjadi dua kali lipat, jadi perlu mencermati cara penetapan harga setelah 4.8 tersedia.
Saran Keputusan: Grok 4.8 vs Grok 4.7
| Fokus Utama | Tindakan Saat Ini | Kapan Mengevaluasi Ulang |
|---|---|---|
| Stabilitas peluncuran | Gunakan grok-4.7 | Saat 4.8 muncul di daftar model platform |
| Biaya per tugas | Kendalikan panjang konteks dan output | Saat tersedia data penggunaan token pihak ketiga untuk 4.8 |
| Kemampuan tugas panjang | Evaluasi model alternatif secara paralel | Saat 4.8 merilis skor Terminal-Bench dan metrik sejenis |
| Transparansi harga | Buat anggaran berdasarkan endpoint daftar harga | Saat tabel ringkasan platform mencantumkan harga output tier tinggi |
💡 Saran pemilihan: Versi mana yang dipilih bergantung pada apakah tugas Anda termasuk tugas panjang dan apakah sering melewati 200 ribu token. Sebaiknya jalankan sampel Anda sendiri melalui APIYI di apiyi.com dengan set API yang sama, lalu putuskan apakah tugas panjang perlu dialihkan ke model lain.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apakah Grok 4.8 sekarang bisa dipanggil lewat API?
Tidak bisa. Per 2026-11-13, Grok 4.8 belum punya model ID; di tabel lengkap model platform maupun endpoint daftar harga hanya ada grok-4.7. Soft launch minggu ini yang disebut Musk hanya ditujukan untuk pengguna Grok Bot.
Q2: Antara Grok 4.8 dan Grok 4.7, siapa yang lebih kuat?
Saat ini belum bisa dinilai. Grok 4.8 tidak punya papan peringkat atau skor publik apa pun; Musk hanya bilang “evaluasi sedang menanjak”, “belum mengesankan”, dan “masih di bawah Opus 5.5”. Itu semua sikap, bukan data yang bisa dibandingkan.
Q3: Klaim bahwa Grok 4.7 menghasilkan banyak token output berasal dari mana?
Dari evaluasi pihak ketiga Artificial Analysis tertanggal 2026-09-21, dengan tingkat pengujian xhigh. Setiap tugas menghasilkan sekitar 81 ribu token output, dibandingkan 36 ribu pada 4.6 high dan 38 ribu pada 4.6 xhigh. Ini bukan data resmi.
Q4: Apakah Grok 4.7 jadi lebih buruk secara menyeluruh dibanding Grok 4.6?
Bukan. Di tabel resmi, Grok 4.7 lebih tinggi dari 4.6 pada beberapa item seperti Terminal-Bench, CursorBench, dan EEBench. Papan peringkat pihak ketiga menunjukkan AA-LCR lebih rendah 3,7 poin dan AutomationBench-AA lebih rendah 1,1 poin — itu termasuk penurunan pada item tertentu saja.
Q5: Bagaimana cara memanggil grok-4.7 sekarang juga?
Daftar di APIYI apiyi.com dan dapatkan kunci API; pengguna baru mendapat kuota uji coba gratis. Gunakan SDK yang kompatibel dengan OpenAI, isi base_url dengan alamat endpoint platform, dan setel model ke grok-4.7.
Q6: Output di atas 200 ribu token sebenarnya ditagih berapa?
Ekspresi harga menulis output $12 dan baca cache $1; tabel total bertingkat hanya menulis input tier tinggi $4, tanpa menulis output tier tinggi secara terpisah. Kedua catatan tidak sepenuhnya konsisten, jadi saat menyusun anggaran sebaiknya estimasi secara konservatif mengikuti ekspresi harga, dan mengacu pada daftar model platform.
Q7: Setelah Grok 4.8 tersedia, bagaimana cara migrasinya?
Di dinamika real-time platform belum ada catatan peluncuran Grok 4.8. Setelah tersedia, biasanya cukup mengganti parameter model; disarankan membandingkan output token, tingkat keberhasilan tugas panjang, dan biaya per tier pada sampel yang sama terlebih dahulu, baru kemudian memindahkan trafik.
Poin-Poin Utama Grok 4.8 vs Grok 4.7
- Pilihan hari ini: kalau mau memanggil API, pakai grok-4.7; Grok 4.8 belum punya ID model.
- Kelemahan pertama (leaderboard pihak ketiga): pada xhigh sekitar 81 ribu token output per tugas, terbilang terlalu panjang.
- Kelemahan kedua (laporan resmi sendiri): Terminal-Bench dan CursorBench masih tertinggal dari Fable 5.1.
- Bukan tertinggal di semua hal: pada EEBench dan Harvey, Grok 4.7 ada di peringkat pertama.
- Kelemahan ketiga (daftar harga + pernyataan langsung): input di atas 200 ribu token harganya jadi dua kali lipat, Elon Musk tidak mengakui fondasi 4.7.
- Perubahan yang diketahui pada 4.8: menulis ulang RL dan stack inferensi, membersihkan SFT, tanpa bukti yang menambal tiga kelemahan itu.
- Cara memulai: lewat APIYI apiyi.com jalankan dulu baseline grok-4.7, setelah 4.8 tersedia tinggal bandingkan langsung.
Ringkasan
Poin-Poin Utama Grok 4.8 vs Grok 4.7:
- Ketersediaan: per 2026-11-13, hanya grok-4.7 yang bisa dipanggil; rilis lunak lewat Bot tidak sama dengan API yang sudah dibuka.
- Tiga kelemahan: output token terlalu banyak (leaderboard pihak ketiga), tertinggal dari Fable pada tugas panjang (laporan resmi sendiri), kenaikan harga konteks panjang dan pernyataan pendiri (daftar harga dan pernyataan langsung) — sumbernya berbeda-beda.
- Bukti untuk 4.8: saat ini baru sebatas klaim penulisan ulang RL dan stack inferensi serta pembersihan SFT; belum ada skor, harga, dan kartu model.
Daripada berhenti dan menunggu, lebih baik rapikan dulu pembagian tier konteks dan panjang output grok-4.7, lalu bandingkan satu per satu setelah 4.8 punya data yang bisa diperiksa ulang. Disarankan lewat APIYI apiyi.com memakai antarmuka terpadu untuk memverifikasi dulu performa grok-4.7 di bisnis Anda, supaya ada baseline untuk peralihan berikutnya.
📚 Referensi
- Blog resmi xAI – Peluncuran Grok 4.7: Tabel perbandingan benchmark dan harga yang dilaporkan sendiri oleh pihak resmi
- Tautan:
x.ai/news/grok-4-7 -
Keterangan: Sumber data Terminal-Bench 4.0, CursorBench 4.0, EEBench, dan lainnya
-
Artificial Analysis – Evaluasi Grok 4.7: Papan peringkat pihak ketiga, termasuk penggunaan token output
- Tautan:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Keterangan: Perubahan pada indeks kecerdasan, perbandingan token output, AA-LCR, dan lainnya
-
Postingan X Musk (2026-11-10): Kutipan asli tentang kemajuan Grok 4.8
- Tautan:
x.com/elonmusk/status/2120088070443655190 -
Keterangan: Penulisan ulang RL dan stack inferensi, pembersihan SFT, peluncuran lunak Bot
-
Balasan X Musk (2026-11-10): Pernyataan perbandingan 4.8 dengan Opus 5.5
- Tautan:
x.com/elonmusk/status/2120099798078656909 -
Keterangan: Sumber kutipan “Not as good”
-
Daftar Model APIYI: Model grok-4.7, grup, dan harga bertingkat
- Tautan:
docs.apiyi.com/models - Keterangan: Model dan harga mengacu pada ini, tanggal verifikasi 2026-11-13
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com