Anmerkung des Autors: xAI hat am 2. November 2026 die Modellkennung grok-imagine-image-quality offiziell ausgemustert. Alte Anfragen liefern weiterhin keinen Fehler, werden im Hintergrund aber von Image 2.0 Low verarbeitet. Ausgehend von dieser Grok-Imagine-Migration beleuchtet dieser Artikel die Risiken beim Versionsmanagement von KI-APIs und zeigt, wie sich ihnen begegnen lässt.
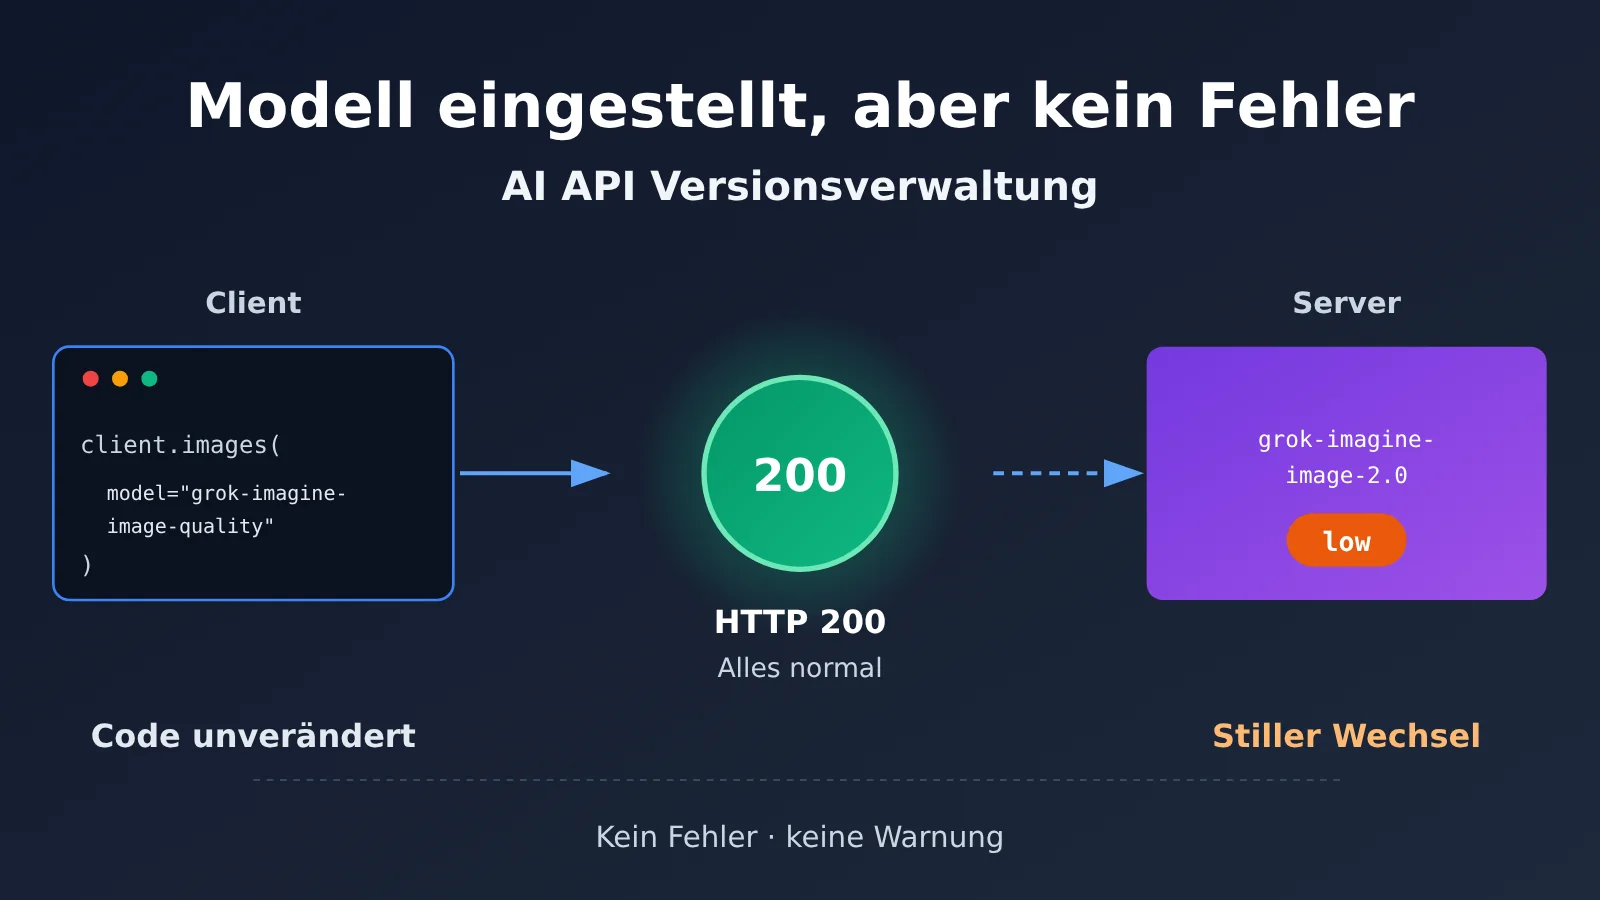
xAI setzt heute, am 2. November 2026, die zuvor angekündigte Migration seines Bildmodells um. Die alte Kennung grok-imagine-image-quality lässt sich weiterhin aufrufen, tatsächlich kommt aber grok-imagine-image-2.0 zum Einsatz – fest eingestellt auf die Qualitätsstufe low. Für die meisten Anwendungen bedeutet das: Keine Zeile Code wurde geändert, Anfragen liefern weiterhin Antworten und auf dem Monitoring-Dashboard erscheint keine rote Warnung.
Dies ist keine Störungsmeldung. Die Migrationsregeln stammen aus der offiziellen Mitteilung von xAI vom 2. September und wurden damit 60 Tage im Voraus angekündigt. Aktuell gibt es keine Hinweise auf grössere Ausfälle bei Nutzern. Interessant ist vielmehr das technische Problem, das dieser Fall sichtbar macht: Eine kompatible Schnittstelle und erfolgreiche Modellaufrufe bedeuten nicht, dass Modell, Ausgabequalität und Kosten unverändert bleiben.
Darum lohnt sich der Artikel: Sie erfahren, was sich bei der Migration von Grok Imagine geändert hat und warum KI-APIs ein Versionsmanagement brauchen, das über die übliche Verfügbarkeitsüberwachung hinausgeht. Ausserdem erhalten Sie eine Checkliste, mit der Sie Ihr System sofort überprüfen können.
Grok Imagine: Das Wichtigste zur Einstellung des Modells
Zunächst die Fakten, die durch die offizielle Dokumentation bestätigt sind. Wichtig: Der 2. November ist nicht das Veröffentlichungsdatum von Image 2.0 – das Modell erschien bereits am 7. August. An diesem Tag tritt vielmehr die Einstellung einer bestimmten alten API-Kennung in Kraft.
| Information | Details |
|---|---|
| Inkrafttreten | 2. November 2026 (angekündigt am 2. September, Vorankündigungsfrist: 60 Tage) |
| Quelle | Offizieller Migrationsleitfaden von xAI |
| Eingestellte Kennung | grok-imagine-image-quality |
| Übernehmendes Modell | grok-imagine-image-2.0, quality fest auf low gesetzt |
| Betroffene Endpunkte | /v1/images/generations und /v1/images/edits |
| Kompatibilität | Die alte Kennung wird weiterhin aufgelöst, die Struktur von Anfragen und Antworten bleibt kompatibel |
| Nicht betroffen | grok-imagine-image (1.0) ist laut offizieller Angabe ausdrücklich nicht von dieser Änderung betroffen |
| Überprüfung | Das Feld model in der Antwort zeigt das tatsächlich verwendete Modell an |
Die Weiterleitungskette der alten Grok-Imagine-Kennungen
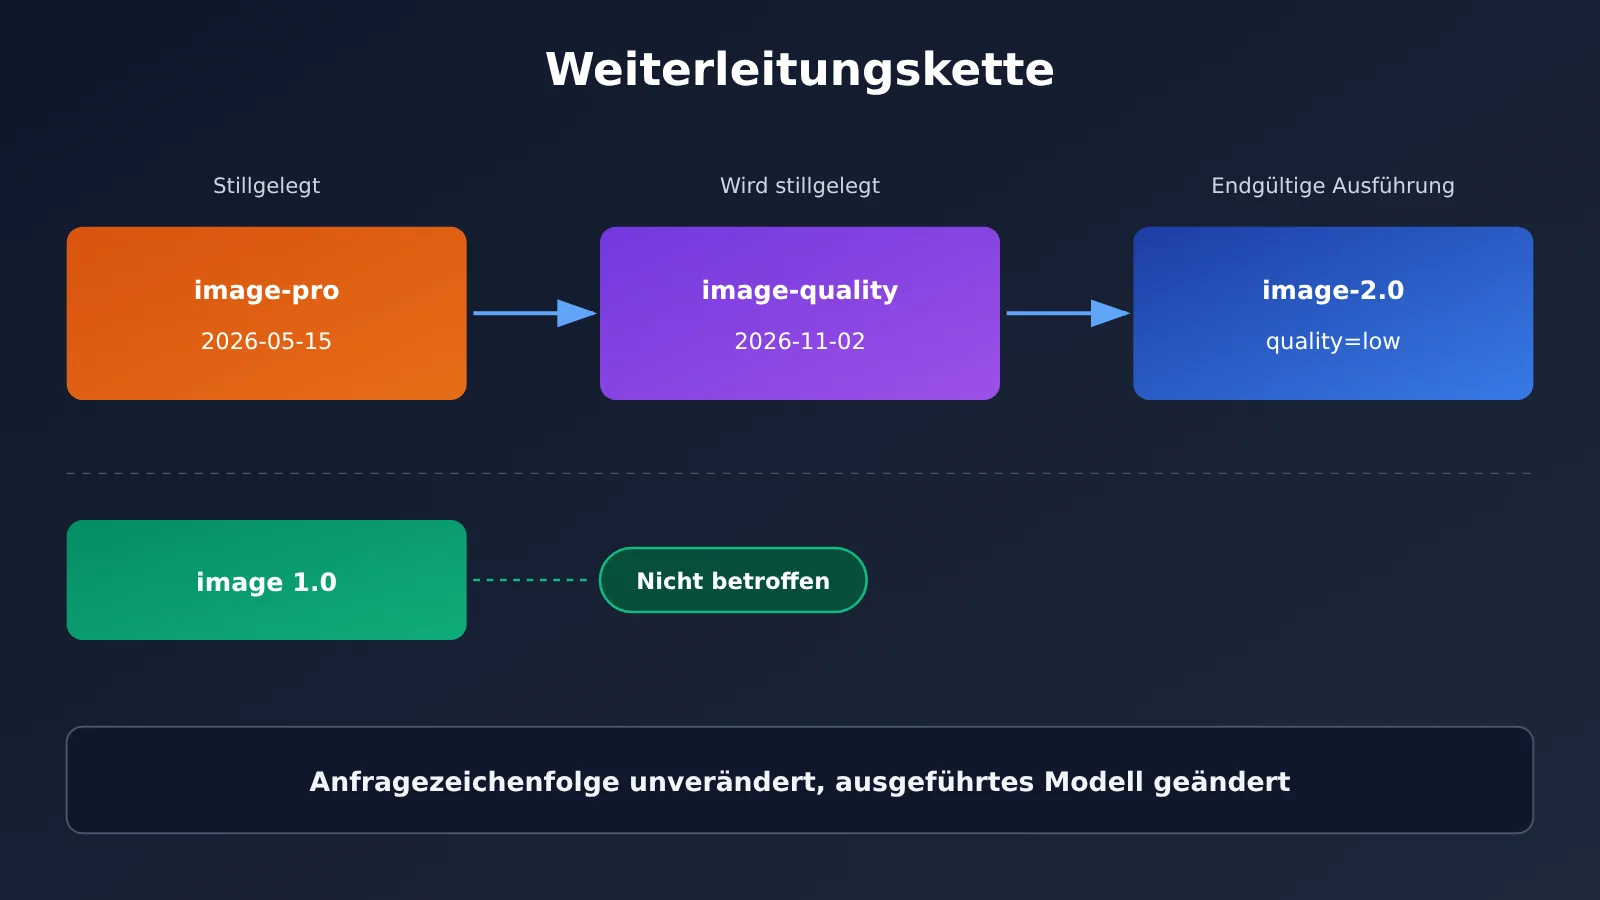
Ein leicht zu übersehender Punkt bei dieser Migration ist die „Weiterleitungskette“. Bereits am 15. Mai 2026 hat xAI die noch ältere Kennung grok-imagine-image-pro eingestellt und deren Anfragen an grok-imagine-image-quality weitergeleitet. Nach dem 2. November wird diese Kette um ein weiteres Glied verlängert.
Eine Anwendung, deren Konfiguration nie aktualisiert wurde und die noch die pro-Kennung verwendet, nutzt also tatsächlich Image 2.0 Low. Ein Blick auf den model-String in der Konfigurationsdatei reicht nicht mehr aus, um das tatsächlich verwendete Modell zu bestimmen.
| In der Anwendung konfigurierte Kennung | Status | Tatsächlicher Pfad nach dem 2. November |
|---|---|---|
grok-imagine-image-pro |
Am 15. Mai eingestellt | pro → quality → 2.0 (low) |
grok-imagine-image-quality |
Am 2. November eingestellt | quality → 2.0 (low) |
grok-imagine-image-2.0 |
Offiziell verfügbar | 2.0, low / medium / auto wählbar |
grok-imagine-image |
1.0, weiterhin verfügbar | Von dieser Änderung nicht betroffen |
Vier Risiken bei der Verwaltung von AI-API-Versionen durch die Grok-Imagine-Migration
Die folgende Analyse leitet technische Risiken aus den offiziellen Mechanismen ab. Sie ist keine Statistik über bereits eingetretene Vorfälle bei xAI. Die Risiken lassen sich in vier Bereiche aufteilen: Modellidentität, Ausgabequalität, Abrechnung und Monitoring.
Risiko 1: Änderung der Modellidentität
Der Modellname in der Client-Anfrage bleibt gleich, aber auf dem Server wird ein anderes Modell ausgeführt. Die gute Nachricht: xAI gibt im Feld model der Antwort an, welches Modell tatsächlich verwendet wurde. Das hilft allerdings nur, wenn Ihr System dieses Feld auch protokolliert und abgleicht. Viele Anwendungen legen den Modellnamen lediglich in der Anfrage fest und lesen die Modellinformationen aus der Antwort nie aus.
Risiko 2: Änderungen bei Ausgabequalität und Stil
Offiziell bestätigt ist die „Kompatibilität der Anfragestruktur“, nicht aber eine gleichbleibende Bildausgabe. Bei der Einführung von Image 2.0 hob xAI vor allem hervor, dass das Modell Eingabeaufforderungen mit mehreren Vorgaben besser folgt, kleine Schrift und komplexe Layouts beherrscht und Bilder anhand mehrerer Referenzbilder bearbeiten kann. Gleichzeitig berichteten einzelne Nutzer auf Reddit r/grok, dass sie mit Version 2.0 bei Hautdetails, natürlichem Licht und Schatten sowie beim Erhalt des Originalbilds weniger gut zurechtkämen als zuvor.
Diese Bewertungen sind subjektive Einzelerfahrungen und beziehen sich hauptsächlich auf das Endkundenprodukt. Daraus lässt sich nicht ableiten, dass 2.0 insgesamt schlechter geworden ist. Sie zeigen aber: Dieselbe Eingabeaufforderung kann nach einem Modellwechsel zu anderen Bildkompositionen, Stilen oder Ergebnissen bei lokalen Bearbeitungen führen. Das sollte durch Regressionstests geprüft werden, statt davon auszugehen, dass Kompatibilität automatisch Problemlosigkeit bedeutet.
Risiko 3: Änderungen bei Abrechnung und Qualitätsstufen
Diese Migration ist zwar ein Beispiel für sinkende Preise, zeigt aber gerade deshalb, wie wichtig die Konfiguration der Qualitätsstufe ist. Die folgende Tabelle enthält die offiziellen xAI-Preise pro ausgegebenem Bild in US-Dollar, ohne Eingabegebühren für Referenzbilder:
| Auflösung | Bisheriges Quality | 2.0 Low | 2.0 Medium |
|---|---|---|---|
| 1K | $0.05 | $0.04 | $0.06 |
| 1.5K | $0.06 | $0.05 | $0.07 |
| 2K | $0.07 | $0.06 | $0.08 |
Bei 10.000 Bildern in 1K pro Monat ergeben sich folgende theoretische Ausgabekosten: Wer die alte Modellkennung weiterverwendet und damit automatisch 2.0 Low nutzt, zahlt rund $400 – also $100 weniger als die $500 für das bisherige Quality. Wer dagegen gezielt auf 2.0 Medium umstellt, zahlt $600 und damit $100 mehr als zuvor. Bei der Bildbearbeitung kommen $0.01 Eingabegebühr pro Referenzbild hinzu. Für ein Referenzbild und ein ausgegebenes 1K-Bild betragen die Kosten beispielsweise $0.06 mit dem bisherigen Quality, $0.05 mit 2.0 Low und $0.07 mit 2.0 Medium.
Weniger offensichtlich sind die Unterschiede bei den Standardwerten. Ab dem 28. August verwendet 2.0 standardmäßig auto, wenn quality nicht angegeben wird. auto wählt derzeit low für Text-zu-Bild und medium für die Bildbearbeitung. Die offizielle Dokumentation spricht von „currently“ – die Zuordnung ist also nicht dauerhaft garantiert. Für Bildbearbeitungsanwendungen sind „alte Modellkennung beibehalten“ und „auf 2.0 umstellen, aber quality nicht angeben“ daher nicht gleichwertig; auch die Kosten unterscheiden sich. Außerdem führt die Preistabelle zwar 1.5K auf, die Parameterdokumentation zur Bilderzeugung nennt für resolution derzeit aber ausdrücklich nur 1k und 2k. Ob sich 1.5K angeben lässt, muss durch Tests geklärt werden.
Risiko 4: Blinde Flecken im Monitoring
Wenn eine Anwendung nur HTTP-Statuscodes, Erfolgsraten und Antwortzeiten überwacht, bleibt ein Modellwechsel in den Metriken fast unsichtbar. Der asynchrone Modus (deferred) der xAI-Bilderzeugung liefert ein weiteres Beispiel: pending gibt HTTP 202 zurück, done HTTP 200. Auch failed gibt jedoch HTTP 200 zurück und enthält die Fehlerinformation in der Antwort. HTTP 200 bedeutet nicht automatisch, dass der Vorgang erfolgreich war.
Vergleich der Modellversionsverwaltung verschiedener Anbieter
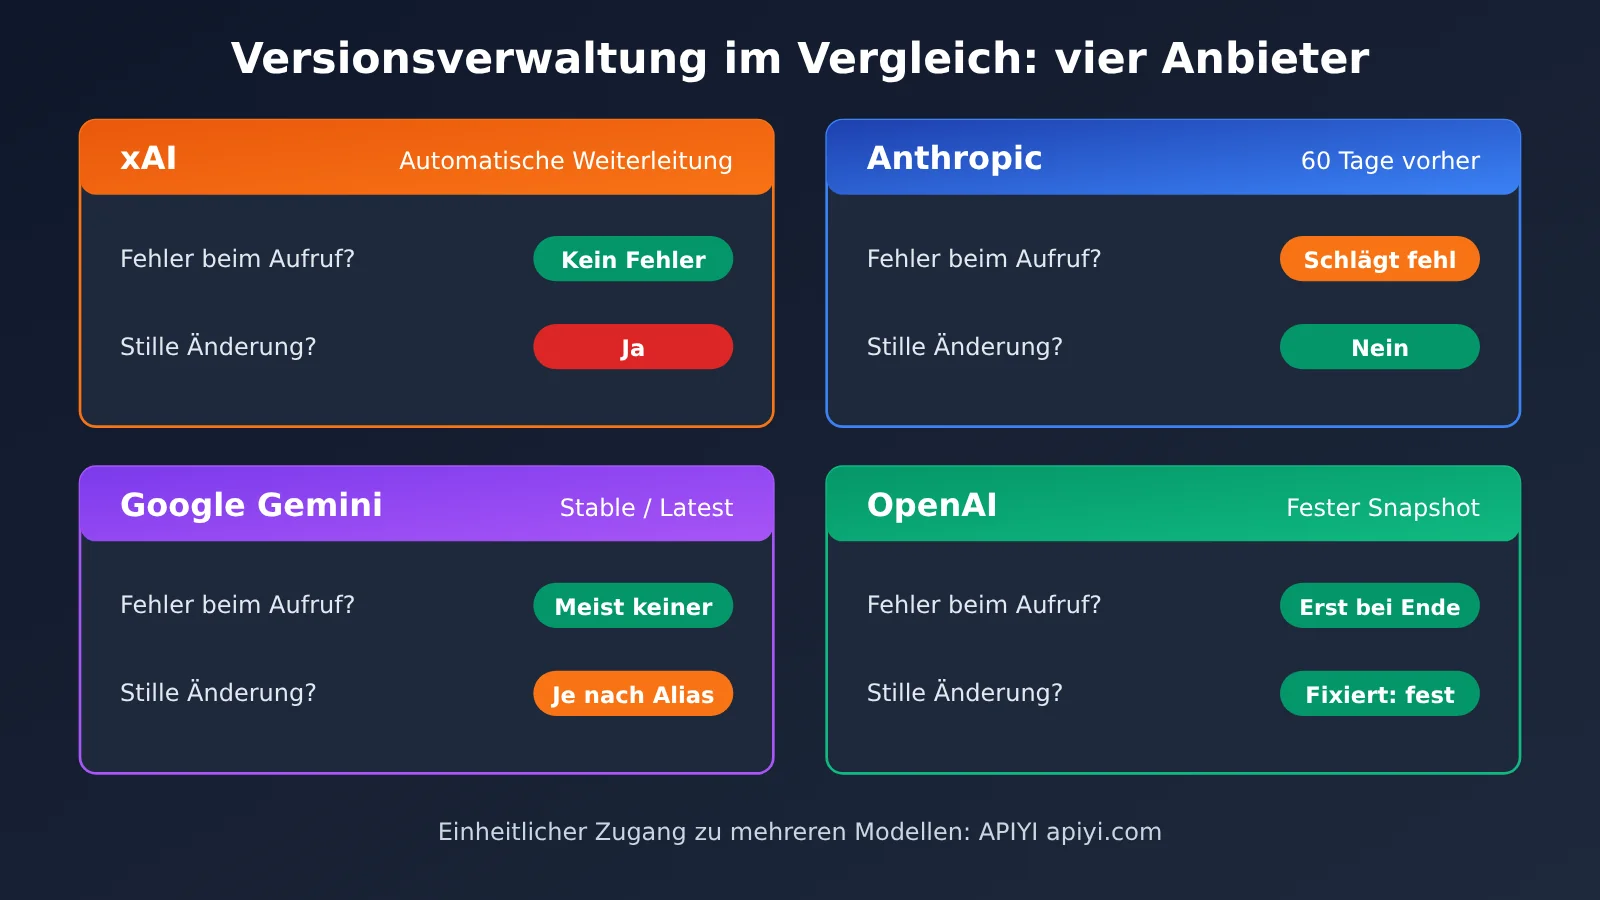
Dass xAI alte Modellkennungen weiterhin auflöst und das Modell serverseitig ersetzt, ist nur eine mögliche Strategie. Sie lässt sich nicht als allgemeine Regel für alle Anbieter betrachten. Ein Blick in die offiziellen Dokumentationen zeigt deutliche Unterschiede.
| Anbieter | Offizielle Versionsstrategie | Verhalten nach Ausmusterung oder Änderung | Bedeutung für Entwickler |
|---|---|---|---|
| xAI | Ausgemusterte Kennungen bleiben auflösbar, serverseitige Weiterleitung | Kein Fehler, das tatsächlich verwendete Modell ändert sich | Das Feld model in der Antwort muss überprüft werden |
| Anthropic | Vier Phasen: Active / Legacy / Deprecated / Retired | Nach Retired schlagen Anfragen fehl; öffentliche Modelle werden mindestens 60 Tage im Voraus angekündigt | Fehler werden unmittelbar sichtbar, Abkündigungen müssen verfolgt werden |
| Google Gemini | Stable / Preview / Latest / Experimental | Der Alias Latest wechselt automatisch auf neue Versionen; Änderungen, die die Kompatibilität beeinträchtigen, werden vorab angekündigt | Für den Produktionseinsatz wird Stable empfohlen; Latest mit Vorsicht verwenden |
| OpenAI | Empfiehlt feste Modell-Snapshots für den Produktionseinsatz | Rückwärtskompatibilität der API-Struktur garantiert keine gleichbleibenden Ausgaben | Snapshots fixieren und Evaluierungsdatensätze anlegen, Ausmusterungsdaten trotzdem im Blick behalten |
Vergleich mit xAI: xAI gestaltet die Kompatibilität auf Clientseite besonders reibungslos: Alter Code funktioniert zunächst weiter. Der Nachteil ist, dass Modelländerungen nicht durch einen Fehler sichtbar werden. Im Vergleich dazu ist Anthropics Fehlerverhalten nach Retired zwar auffälliger, macht Probleme aber auch früher sichtbar.
Vergleich von Google und OpenAI: Bei Googles Alias Latest ist ausdrücklich vorgesehen, dass sich die Version bei gleichbleibender Kennung ändert. Das zeigt, dass solche Mechanismen öffentlich dokumentiert und verbreitet sind. OpenAI empfiehlt dagegen, für den Produktionseinsatz Snapshots zu fixieren und Evaluierungsdatensätze anzulegen. Beide Ansätze zeigen: Versionsverwaltung ist kein Einzelfall, sondern eine technische Herausforderung bei der Nutzung jeder KI-API.
💡 Empfehlung: Die Bedeutung von Modellversionen unterscheidet sich je nach Anbieter erheblich. Wer mehrere Modelle einbindet, sollte daher sowohl das „angefragte Modell“ als auch das „ausgeführte Modell“ einheitlich protokollieren. Wenn Sie über APIYI apiyi.com Modelle mehrerer Anbieter über eine OpenAI-kompatible Schnittstelle anbinden, sollten Sie diese beiden Felder ebenfalls auf Anwendungsebene speichern. Das erleichtert den anbieterübergreifenden Vergleich.
AI-API-Versionen steuern: Logs, Kosten und schrittweise Einführung
Schritt 1: Angefordertes und tatsächlich verwendetes Modell unterscheiden
Die semantischen Konventionen von OpenTelemetry für generative KI enthalten zwei wichtige Attribute: gen_ai.request.model bezeichnet das vom Client angeforderte Modell, gen_ai.response.model das Modell, das die Antwort tatsächlich erzeugt hat. xAI gibt nicht automatisch alle Telemetrie-Felder aus; die Anwendung muss die Zuordnung selbst erfassen. Für die Anwendungslogs empfehlen sich folgende Felder. Es handelt sich um technische Empfehlungen, nicht um offizielle Pflichtvorgaben:
| Feld | Zweck | Hinweise |
|---|---|---|
requested_model / served_model |
Stillschweigende Weiterleitungen erkennen | served_model wird aus dem Feld model der Antwort übernommen |
quality_requested / quality_effective |
Qualitätsstufe nachverfolgen | Lässt sich quality_effective nur anhand der Dokumentation ableiten, muss der Wert als abgeleitet gekennzeichnet werden |
response_status / business_status |
HTTP-Status und Anwendungsergebnis unterscheiden | Auch ein asynchroner Status failed kann mit HTTP 200 einhergehen |
cost_usd |
Tatsächliche Kosten pro Aufruf | Bei xAI aus cost_in_usd_ticks umrechenbar |
reference_image_count / resolution |
Kosten zuordnen | Bei der Bildbearbeitung müssen Eingabekosten berücksichtigt werden |
prompt_template_version / evaluation_result |
Regressionen vergleichen | Sensible Eingabeaufforderungen und Nutzerbilder nicht standardmässig protokollieren |
Schritt 2: Tatsächlich verwendetes Modell und Kosten im Code erfassen
Laut der offiziellen Cost-Tracking-Dokumentation von xAI (aktualisiert am 10.10.2026) kann das usage-Objekt der Antwort das Feld cost_in_usd_ticks enthalten. Die Umrechnung lautet cost_usd = cost_in_usd_ticks / 10000000000. Im offiziellen Beispiel entsprechen 400000000 Ticks 0,04 US-Dollar. Dieses Feld ist xAI-spezifisch. Bei Aufrufen über ein SDK oder eine Drittanbieterplattform sollten Sie prüfen, ob es unverändert weitergegeben wird.
Das folgende Minimalbeispiel zeigt, wie sich das Modell direkt bei jeder Anfrage überprüfen lässt:
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
REQUESTED_MODEL = "grok-imagine-image-2.0"  # 示例名称,可用模型以平台实际列表为准

resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"model": REQUESTED_MODEL, "prompt": "A tech magazine cover",
          "quality": "low", "resolution": "1k", "n": 1},
    timeout=180,
).json()

served = resp.get("model")
if served and served != REQUESTED_MODEL:
    print(f"[版本告警] 请求 {REQUESTED_MODEL},实际执行 {served}")
Vollständige Implementierung mit Kosten- und Ergebnisprüfung anzeigen
import time
import logging
import requests
from typing import Optional

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("model_governance")

BASE_URL = "https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
TICKS_PER_USD = 10_000_000_000  # xAI 官方换算:1 美元 = 10^10 ticks


def generate_image(
    prompt: str,
    model: str,
    quality: str = "low",          # 显式填写,避免 auto 默认值随上游变化
    resolution: str = "1k",
    api_key: str = "YOUR_API_KEY",
    expected_unit_cost: Optional[float] = None,
) -> dict:
    start = time.time()
    r = requests.post(
        f"{BASE_URL}/images/generations",
        headers={"Authorization": f"Bearer {api_key}"},
        json={"model": model, "prompt": prompt, "quality": quality,
              "resolution": resolution, "n": 1},
        timeout=180,
    )
    latency_ms = int((time.time() - start) * 1000)
    body = r.json() if r.content else {}

    # 1. 执行模型校验
    served_model = body.get("model")

    # 2. 业务结果校验:HTTP 200 不等于拿到可用图片
    data = body.get("data") or []
    has_image = bool(data and (data[0].get("url") or data[0].get("b64_json")))
    business_ok = r.status_code == 200 and has_image and not body.get("error")

    # 3. 成本:字段可能不被透传,缺失时记录为 None 而不是 0
    ticks = (body.get("usage") or {}).get("cost_in_usd_ticks")
    cost_usd = ticks / TICKS_PER_USD if ticks is not None else None

    record = {
        "requested_model": model,
        "served_model": served_model,
        "quality_requested": quality,
        "resolution": resolution,
        "response_status": r.status_code,
        "business_status": "ok" if business_ok else "failed",
        "latency_ms": latency_ms,
        "cost_usd": cost_usd,
    }

    if served_model and served_model != model:
        log.warning("模型重定向: %s -> %s", model, served_model)
    if cost_usd is not None and expected_unit_cost is not None \
            and abs(cost_usd - expected_unit_cost) > 1e-6:
        log.warning("单价偏离预期: 预期 %.4f 实际 %.4f", expected_unit_cost, cost_usd)

    log.info("generation record: %s", record)
    return record


if __name__ == "__main__":
    generate_image(
        prompt="A clean product shot on white background",
        model="grok-imagine-image-2.0",  # 以平台模型列表为准
        quality="low",
        expected_unit_cost=0.04,
    )
🚀 Schnellstart: Wenn Sie die Protokollierung zunächst testen möchten, können Sie sich bei APIYI unter apiyi.com registrieren und Testguthaben erhalten. Führen Sie einige Eingabeaufforderungen aus Ihrem Anwendungsfall aus, um die Protokollfelder zu prüfen. Welche Bildmodelle verfügbar sind, welche Qualitätsparameter sie unterstützen und was sie kosten, entnehmen Sie bitte der Modellliste und der Preisseite der Plattform. Die Preise von Drittanbietern entsprechen nicht zwangsläufig den offiziellen Preisen von xAI.
Schritt 3: Festen Testsatz und Canary-Validierung einrichten
In Anlehnung an die Canary-Release-Methode von Google SRE und die Empfehlungen von OpenAI zu Evaluierungssets lässt sich die Migration von Bildmodellen so angehen:
Bereiten Sie zunächst einen festen Testsatz vor, der Textplakate, Produktbilder, Porträtbearbeitung, Kompositionen mit mehreren Motiven und lokale Änderungen abdeckt. Legen Sie dann Eingabeaufforderung, Eingabebild, Auflösung, Qualität, Seitenverhältnis und Anzahl der generierten Bilder fest. Vergleichen Sie anschliessend, wie gut die Modelle Anweisungen befolgen, Motive erhalten und Text korrekt darstellen. Prüfen Sie auch Änderungen ausserhalb des Bearbeitungsbereichs, die Erfolgsquote bei der manuellen Abnahme und die Kosten pro akzeptiertem Bild. Leiten Sie schliesslich zunächst einen kleinen Teil der Anfragen um, sofern sich das Routing kontrollieren lässt, und erhöhen Sie den Anteil erst nach Auswertung der Kennzahlen.
Wichtig ist eine realistische Einschätzung: Die Abschaltung wird diesmal von xAI als vorgelagertem Anbieter durchgesetzt. Entwickler können daher nicht davon ausgehen, dass sie zum ausgemusterten Quality-Basismodell zurückkehren können. „Rollback“ bedeutet hier, auf ein geprüftes und weiterhin verfügbares alternatives Modell zu wechseln, betroffene Funktionen zu pausieren oder den Parameter quality anzupassen – nicht, eine nicht mehr zugängliche alte Version wiederherzustellen.
Auswirkungen der Grok-Imagine-Migration auf Entwickler und API-Plattformen
Auswirkungen auf Entwickler
- Suche ausweiten: Suchen Sie nicht nur nach
grok-imagine-image-quality, sondern auch nach älteren Aliasnamen wiegrok-imagine-image-pro. - Parameter explizit setzen: Legen Sie bei der direkten Migration auf 2.0 ausdrücklich low oder medium fest. Überlassen Sie die Wahl der Qualitätsstufe und damit der Kosten für die Bildbearbeitung nicht auto.
- Kostenberechnung aktualisieren: Die offizielle Angabe „$0.01 weniger pro Bild“ bezieht sich auf den Ausgabepreis. Bei der Bildbearbeitung mit Referenzbildern fällt die Gesamtersparnis anders aus.
- Abnahme separat durchführen: Ergänzen Sie die Erfolgsquote der Modellaufrufe um fachliche Abnahmekriterien und Kennzahlen zu den Kosten pro akzeptiertem Ergebnis.
Auswirkungen auf API-Aggregationsplattformen
Für Plattformen, die mehrere Modelle anbinden, wird das Versionsmanagement zu einem konkreten Kundenbedarf: Kunden müssen wissen, an welches vorgelagerte Modell ihre Anfrage geht. Sie müssen sehen können, wann Modelle eingestellt oder Anfragen umgeleitet werden und wie sich die Preise ändern. Außerdem müssen wichtige Parameter wie quality korrekt weitergereicht werden. Nachvollziehbare Modell- und Abrechnungsinformationen sind ebenfalls wichtig. Diese Anforderungen sollten Aggregationsplattformen bei ihrer Weiterentwicklung berücksichtigen.
🎯 Technischer Tipp: Wenn Sie über eine Aggregationsplattform wie APIYI apiyi.com Modelle verschiedener Anbieter nutzen, prüfen Sie während der Migration drei Dinge: Gibt das Feld model in der Antwort das tatsächlich verwendete vorgelagerte Modell an? Wird der Parameter quality weitergereicht? Stimmt die Abrechnung mit dem erwarteten Stückpreis überein? Bewahren Sie bei Abweichungen die Anfrage-ID für die Kommunikation mit dem technischen Support der Plattform auf. Das ist deutlich effizienter, als später die Abrechnungen zu durchsuchen.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet die Einstellung des Grok-Imagine-Modells konkret?
Seit dem 2. November 2026 ist die Modellkennung `grok-imagine-image-quality` in der xAI API eingestellt. Sie lässt sich aber weiterhin aufrufen: Der Server leitet Anfragen an `grok-imagine-image-2.0` weiter und verwendet dabei fest die Qualitätsstufe low. Betroffen sind sowohl die Schnittstelle zur Bilderzeugung als auch die zur Bildbearbeitung. Das 1.0-Modell `grok-imagine-image` ist nicht betroffen.
Q2: Gibt alter Code einen 404-Fehler zurück oder schlägt er sofort fehl?
Nein. Laut offizieller Mitteilung wird die alte Kennung weiterhin erkannt und automatisch umgeleitet. Die Struktur von Anfrage und Antwort bleibt kompatibel. Genau hier ist Vorsicht geboten: Dass kein Fehler auftritt, bedeutet nicht, dass sich Ausgabequalität und Stückpreis nicht geändert haben. Das unterscheidet sich von Anthropics Vorgehen, bei dem Anfragen an Modelle im Status „Retired“ fehlschlagen.
Q3: Ist nach dem Wechsel zu grok-imagine-image-2.0 alles wie vorher?
Nicht ganz. Wenn Sie zu 2.0 wechseln und keinen Wert für `quality` angeben, gilt standardmäßig auto. Aktuell wird bei Text-zu-Bild low und bei der Bildbearbeitung medium verwendet. Bei Beibehaltung der alten Kennung ist dagegen low fest eingestellt. Läuft die Bildbearbeitung mit medium, kostet eine 1K-Ausgabe $0.06 und damit mehr als die $0.05 des alten Quality-Modells. Geben Sie die Stufe am besten ausdrücklich an und überprüfen Sie die Ergebnisse mit einem festen Testdatensatz.
Q4: Wie finde ich heraus, welches Modell mein System tatsächlich verwendet?
Lesen und protokollieren Sie das Feld `model` in der Antwort und vergleichen Sie es mit dem angefragten Modell. Protokollieren Sie auch die tatsächlichen Kosten, die sich aus `cost_in_usd_ticks` berechnen lassen, sofern das Feld verfügbar ist. Bei Aufrufen über Drittplattformen wie APIYI apiyi.com sollten Sie zusätzlich prüfen, ob diese Felder unverändert durchgereicht werden. Für die Verfügbarkeit und Preise der Modelle auf der Plattform gelten deren offizielle Angaben.
Q5: Kann ich zum alten Quality-Modell zurückkehren, wenn mir die Ergebnisse des neuen Modells nicht gefallen?
Darauf sollten Sie sich nicht verlassen. Die Einstellung wird vom vorgelagerten Anbieter durchgesetzt, und der Zugriff auf das zugrunde liegende alte Quality-Modell ist nicht garantiert. Sie können den Parameter `quality` anpassen, zu einem für Ihren Anwendungsfall getesteten Alternativmodell wechseln oder betroffene Funktionen vorübergehend deaktivieren. Bereiten Sie am besten eine getestete Alternative vor: Über die einheitliche Schnittstelle von APIYI apiyi.com können Sie zwischen mehreren Modellen wechseln und diese testen, statt erst im Notfall reagieren zu müssen.
Q6: Ist Image 2.0 besser als die alte Version?
Darauf gibt es keine pauschale Antwort. Bei der Veröffentlichung gab xAI an, dass das Modell in den damaligen Arena-Ranglisten für Text-zu-Bild und Bildbearbeitung auf Platz zwei lag. Das war der Stand vom 7. August. Ein Arena-Snapshot von Ende Oktober zeigte es auf Platz 5 der Gesamtrangliste für die Bearbeitung einzelner Bilder und auf Platz 6 bei Text-zu-Bild. In der Community äußerten sich einzelne Nutzer auch unzufrieden mit dem realistischen Bildeindruck und dem Erhalt des Originalbildes. Offizielle Leistungsangaben, unabhängige Tests und subjektive Vorlieben sind unterschiedliche Bewertungsmaßstäbe. Die zuverlässigste Grundlage ist ein Testdatensatz für Ihren eigenen Anwendungsfall.
Die wichtigsten Punkte zur Versionsverwaltung von KI-APIs
- Ein erfolgreicher Aufruf ≠ ein unverändertes Modell: Der alte Modellbezeichner von Grok Imagine liefert keinen Fehler, wurde aber stillschweigend auf 2.0 Low umgestellt.
- Aliase können verkettet weiterleiten: pro → quality → 2.0 Low. Es reicht nicht, nur den konfigurierten Modellbezeichner zu prüfen.
- Auch Standardwerte können sich ändern: auto wählt derzeit low für die Generierung und medium für die Bearbeitung. Gib den Wert deshalb explizit an.
- Für die Kosten zählt die tatsächliche Abrechnung: Bei der Bildbearbeitung fallen auch Eingabekosten für Referenzbilder an. Die Gesamtkosten sinken daher nicht im gleichen Verhältnis wie der Ausgabepreis.
- HTTP 200 bedeutet nicht, dass die Aufgabe erfolgreich war: Auch fehlgeschlagene asynchrone Aufgaben können 200 zurückgeben.
- Anbieter verfolgen unterschiedliche Strategien: Weiterleitungen, Fehler, sofortige Latest-Wechsel und festgelegte Snapshots müssen jeweils anders behandelt werden.
- Der Einstieg beginnt bei den Logs: Nutze das Testguthaben bei APIYI auf apiyi.com, um das angefragte und das tatsächlich ausgeführte Modell in zwei Feldern zu protokollieren.
Fazit
Die Migration von Grok Imagine zeigt vor allem drei Dinge:
- Kompatibilitätsstrategien können Änderungen verdecken: xAI hat sich für eine Weiterleitung entschieden, die für Clients möglichst reibungslos ist. Änderungen an Modell, Qualitätsstufe und Einzelpreis machen sich deshalb nicht durch Fehlermeldungen bemerkbar.
- Versionsverwaltung braucht eigene Mechanismen: Die getrennte Protokollierung von angefragtem und ausgeführtem Modell, die Nachverfolgung der tatsächlichen Kosten und fachliche Abnahmetests gehen über die gewöhnliche Verfügbarkeitsüberwachung hinaus.
- Rückfalloptionen müssen frühzeitig geplant werden: Eine erzwungene Ausmusterung durch den Anbieter lässt sich nicht rückgängig machen. Verlassen kannst du dich nur auf alternative Modelle und Parameterkonfigurationen, die du vorher getestet hast.
Prüfe am besten noch heute deine Konfiguration: Suche im Code nach alten Modellbezeichnern, vergleiche sie mit dem Feld model in den Antworten, lege den Parameter quality für Bildbearbeitung und -generierung explizit fest und stelle einen festen Satz an Testbeispielen zusammen. Über APIYI auf apiyi.com kannst du mit einer einheitlichen Schnittstelle eine Testumgebung für den Vergleich mehrerer Modelle aufbauen. So schaffst du die nötige Transparenz über Modellversionen, bevor der Anbieter die nächste Änderung vornimmt.
📚 Quellen
- xAI-Migrationsleitfaden für Bildmodelle vom 02.11.2026: Regeln zur Einstellung und Weiterleitung
- Link:
docs.x.ai/developers/migration/imagine-image-quality-nov-2 -
Beschreibung: Primärquelle zu eingestellten Modellkennungen, Ersatzmodellen, Qualitätsstufen und Auswirkungen
-
xAI-Einstellungshistorie vom 15.05.2026: Migration der pro-Kennung
- Link:
docs.x.ai/developers/migration/may-15-retirement -
Beschreibung: Wichtige Quelle zum Verständnis verketteter Weiterleitungen
-
Offizielle xAI-Preisübersicht und Image-2.0-Modellseite: Auflösungen und Einzelpreise je Qualitätsstufe
- Link:
docs.x.ai/developers/pricing -
Beschreibung: Grundlage für die Berechnung der Kosten für Ausgaben und Referenzbilder als Eingabe
-
xAI-Dokumentation zu Parametern der Bilderzeugung: quality-Standardwert und asynchroner Status
- Link:
docs.x.ai/developers/model-capabilities/images/generation -
Beschreibung: Verhalten von auto und HTTP-Status im deferred-Modus
-
xAI Cost Tracking: Tatsächliche Kostenfelder auf Anfrageebene
- Link:
docs.x.ai/developers/cost-tracking -
Beschreibung: Bedeutung und Umrechnung von cost_in_usd_ticks
-
Anthropic-Dokumentation zur Einstellung von Modellen: Vier Phasen des Modelllebenszyklus
- Link:
docs.anthropic.com/en/docs/about-claude/model-deprecations -
Beschreibung: Vergleich des Verhaltens bei Anfragen nach der Einstellung eines Modells
-
Google-Dokumentation zu Gemini-Modellversionen: Unterschied zwischen Stable und Latest
- Link:
ai.google.dev/gemini-api/docs/models -
Beschreibung: Automatischer Wechselmechanismus für Aliase
-
OpenAI-Leitfaden für Eingabeaufforderungen und API-Überblick: Feste Snapshots und Evaluierung
- Link:
developers.openai.com/api/docs/guides/prompt-engineering -
Beschreibung: Offizielle Empfehlung, in Produktionsumgebungen Snapshots festzulegen und Evaluierungssets zu erstellen
-
Google SRE Canary Release: Methode für schrittweise Rollouts
- Link:
sre.google/workbook/canarying-releases/ -
Beschreibung: Tests mit einem kleinen Teil des Datenverkehrs begrenzen die Auswirkungen von Änderungen
-
OpenTelemetry-Semantikkonventionen für generative KI: Modellattribute für Anfragen und Antworten
- Link:
opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/ - Beschreibung: Definitionen von gen_ai.request.model und gen_ai.response.model
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.