Anmerkung des Autors: Dieser Beitrag zeigt, wie Sie Fehler von Modell-APIs anhand ihrer Fehlercodes einordnen: Wann lohnt sich ein erneuter Versuch, wann ein Wechsel zum Fallback-Modell und wann sollten Sie anhalten und die Konfiguration korrigieren? Dazu gibt es eine Fehlercode-Tabelle, eine Checkliste für Fallback-Modelle und eine Checkliste für den Produktivstart.
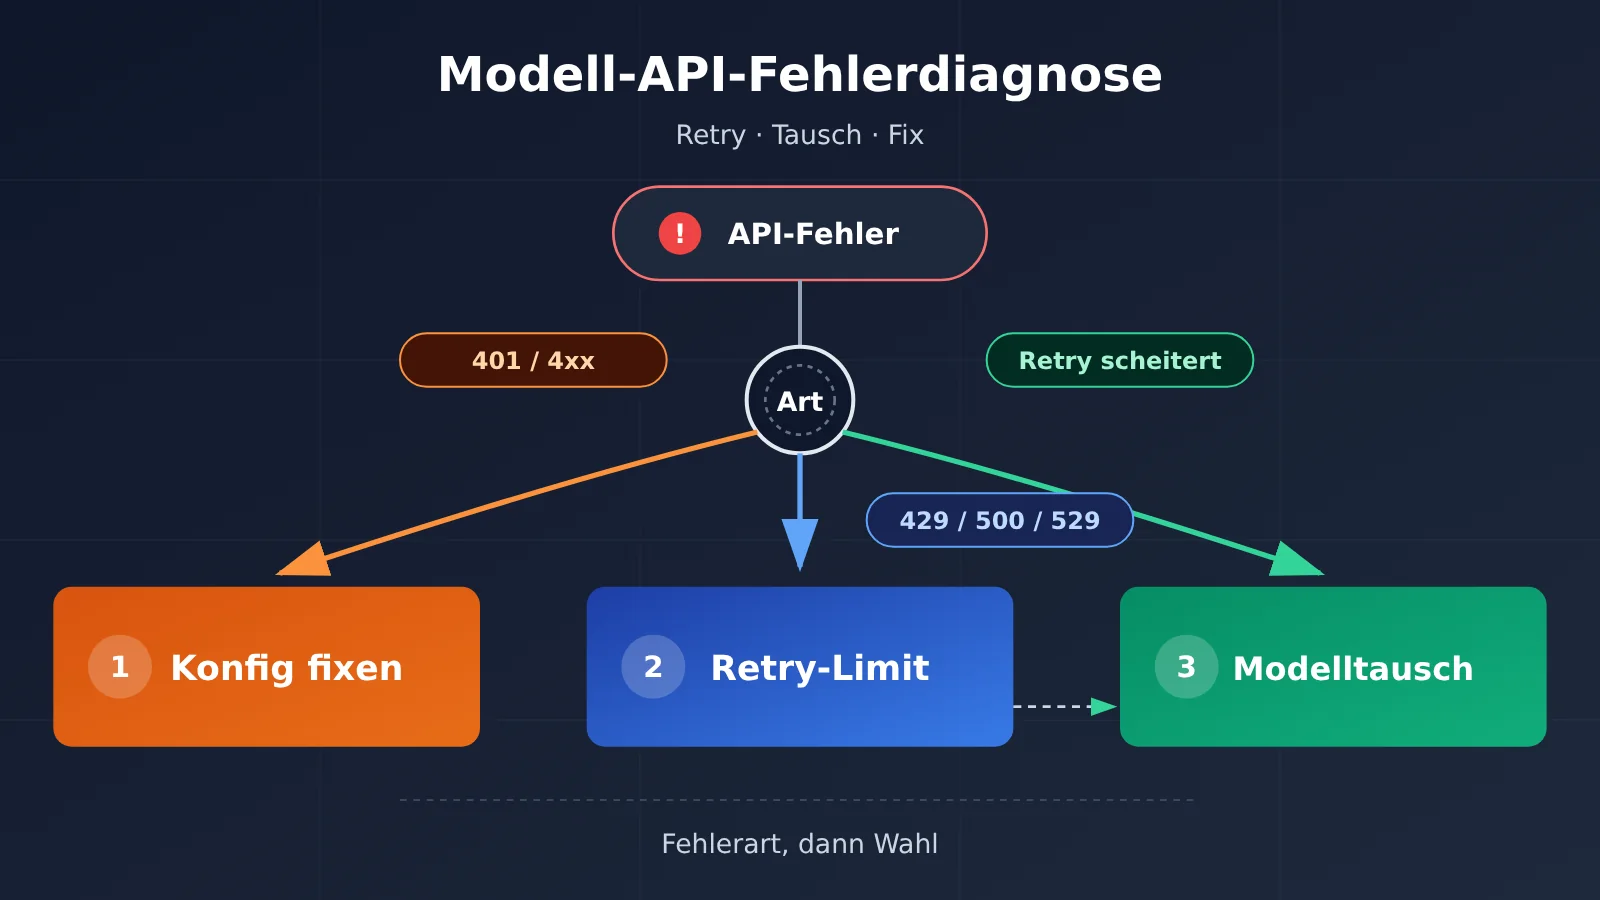
Wenn eine Modell-API einen Fehler meldet, sollten Sie zuerst die Fehlerart bestimmen und dann entscheiden, was zu tun ist. 4xx-Fehler liegen meist an der Anfrage oder der Konfiguration – erneute Versuche helfen dann nicht. Bei 5xx, 529 und Timeouts sind begrenzte erneute Versuche sinnvoll; schlagen auch diese fehl, wechseln Sie zum Fallback-Modell. Anfragen ohne Idempotenzgarantie sollten Sie nicht automatisch wiederholen. Ein erneuter Versuch ist nicht immer die richtige Reaktion, und auch ein Modellwechsel löst nicht jedes Problem. Bei vielen Vorfällen in Produktion ist nicht das Modell ausgefallen. Stattdessen hat die Fehlerbehandlung eine kleine Störung zu mehrfachen Abbuchungen, doppelten Datenbankeinträgen und einer Ratenbegrenzung der gesamten Verarbeitungskette aufgebauscht.
Dieser Beitrag ist keine Übersetzung eines Fehlercode-Lexikons. Er richtet sich an Entwickler, die Modell-APIs bereits in Produktions- oder produktionsnahe Umgebungen integriert haben. Im Mittelpunkt steht die Frage, wie Sie vermeiden, eine Fehlersituation noch zu verschlimmern. Sie erhalten eine Tabelle zur Einordnung von Fehlercodes, eine Strategie für erneute Versuche und Fallbacks, eine Checkliste für die Fähigkeiten von Fallback-Modellen und eine direkt umsetzbare Checkliste für den Produktivstart. Die Grundregel lässt sich in einem Satz zusammenfassen: Bei 4xx zuerst den Fehler beheben, bei 5xx über erneute Versuche nachdenken und bei nicht idempotenten Anfragen erst einmal stoppen.
5 Fehlerkategorien für Modell-APIs: Erst einordnen, dann erneut versuchen oder wechseln
Das Wichtigste vorweg: Fehler bei Modell-APIs lassen sich in fünf Kategorien einteilen. Für jede ist die grundsätzliche Vorgehensweise weitgehend festgelegt. Wer zuerst den Fehlercode einordnet, kann anschließend gezielt über Wiederholung oder Wechsel entscheiden.
| Fehlerkategorie | Typische Statuscodes | Ursache | Standardaktion |
|---|---|---|---|
| Anfragefehler | 400, 404, 409, 422 |
Request-Body, Parameter, Modell-ID, Endpunkt | Nicht wiederholen, Anfrage korrigieren |
| Authentifizierungs- oder Berechtigungsfehler | 401, 403 |
API-Schlüssel, Header, Berechtigungen, Region oder Richtlinien | Nicht wiederholen, API-Schlüssel und Berechtigungen prüfen |
| Kontingent oder Ratenbegrenzung | 402, 429 |
Guthaben, parallele Anfragen, Anfragerate, Modellkontingent | Bei 402 stoppen; bei 429 den Fehler-Body prüfen und dann verzögert wiederholen oder wechseln |
| Upstream-Fehler | 500, 502, 503, 529 |
Gateway, Upstream-Dienst, Überlastung | Begrenzt wiederholen, bei weiterem Fehlschlag wechseln |
| Timeout oder Stream-Abbruch | 408, 504, Netzwerk-Timeout, Stream-Abbruch |
Verbindung, lange Ausgabe, langsame Upstream-Antwort | Zuerst prüfen, ob die Anfrage bereits ausgeführt oder abgerechnet wurde; nur bei Idempotenz wiederholen |
Der Schlüssel zur Fehlerdiagnose: „Wiederholen“ und „Wechseln“ unterscheiden
Beim Wiederholen wird dieselbe Anfrage über dieselbe Verbindung an dasselbe Modell gesendet. Das eignet sich, um vorübergehende Störungen abzufangen. Beim Wechseln wird ein anderes Modell oder eine andere Verbindung gewählt. Das hilft, wenn ein bestimmter Upstream-Dienst dauerhaft nicht verfügbar ist. Beides hat unterschiedliche Kosten: Wiederholungen erhöhen die Latenz und können zu doppelter Abrechnung führen. Bei einem Wechsel können sich Ausgabequalität, Kompatibilität von Tool-Aufrufen und Kosten ändern.
Die Diagnose folgt deshalb drei Schritten: Zuerst die Fehlerkategorie bestimmen, dann prüfen, ob die Anfrage idempotent ist, und schließlich entscheiden, ob wiederholt, gewechselt oder gestoppt wird. Den zweiten Schritt zu überspringen, ist besonders riskant: Wird ein bereits ausgeführter Tool-Aufruf erneut ausgeführt, kann das mehr Folgen haben als nur höhere Kosten.
Warum „alles erneut versuchen“ API-Fehler bei Modellaufrufen verschlimmert
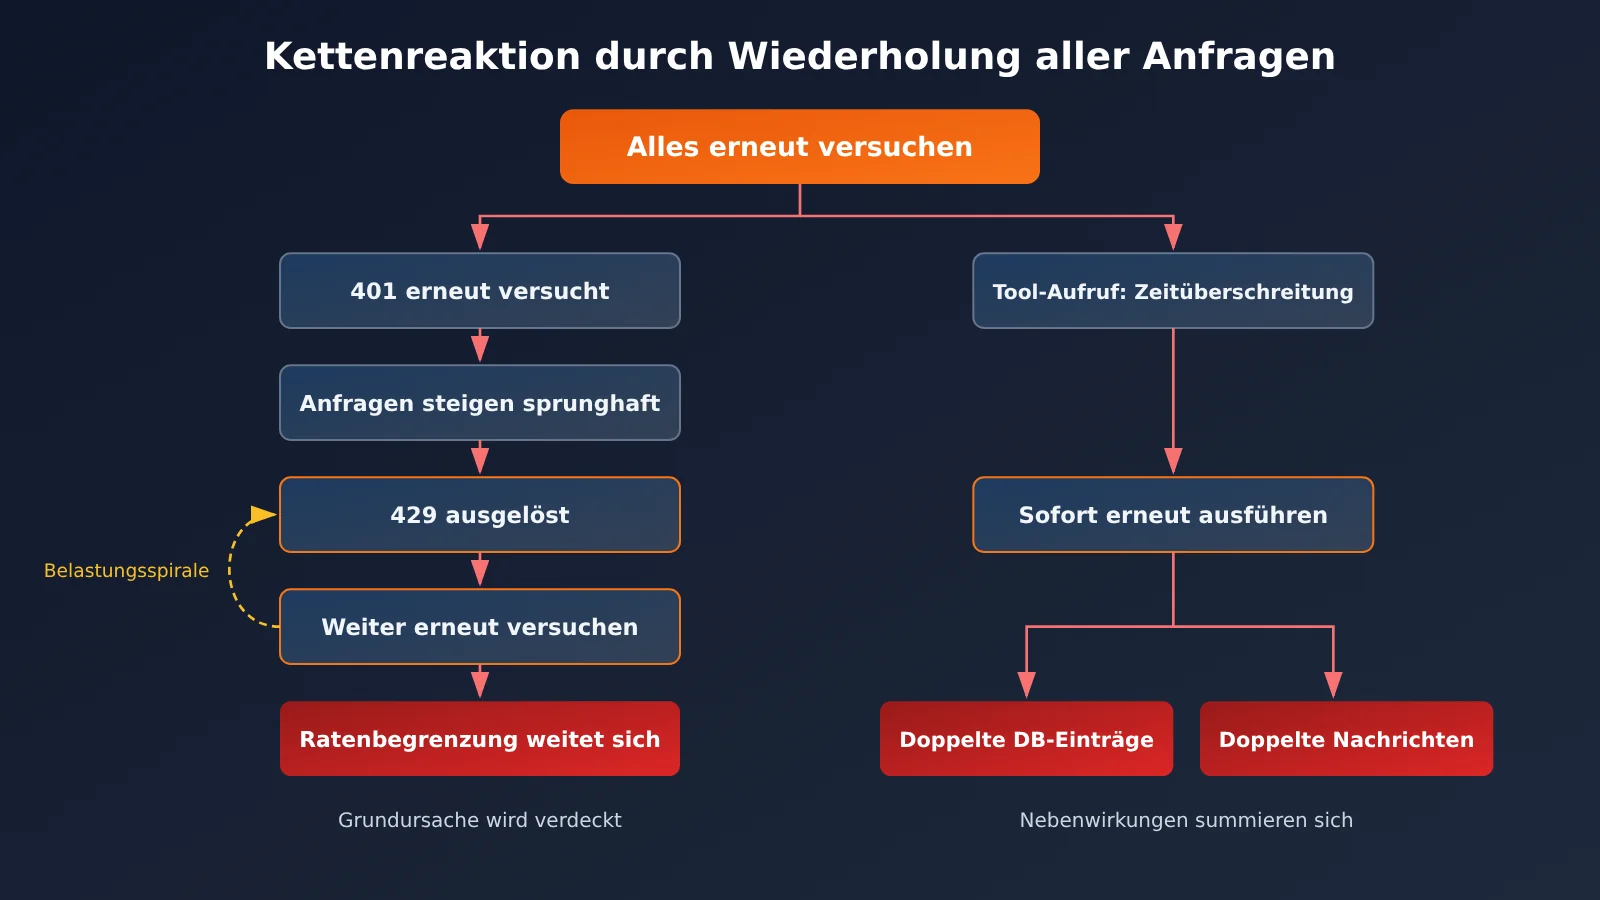
Das Fazit: Alle Fehler pauschal erneut zu versuchen, wirkt zunächst sicher, verstärkt aber Kosten, Nebenwirkungen und Rate-Limits. In Produktionsumgebungen sind die dadurch verursachten Störungen oft schwieriger zu untersuchen als der ursprüngliche Fehler.
Das erste Problem sind doppelte Kosten. Wenn eine gestreamte Antwort abbricht, bedeutet das nicht unbedingt, dass die Anfrage fehlgeschlagen ist. Der Anbieter hat möglicherweise bereits einen Teil der Tokens generiert und dafür Kosten berechnet. Wer die Anfrage blind erneut sendet, bezahlt möglicherweise zweimal für dieselbe Aufgabe. Bei langen Ausgaben fällt das besonders ins Gewicht.
Das zweite Problem ist die doppelte Ausführung. In Agent-Szenarien kann eine Modellanfrage Datenbankeinträge, Nachrichten, die Erstellung von Aufgaben oder sogar Zahlungen auslösen. Tritt während eines Tool-Aufrufs ein Timeout auf, ist unklar, ob das Tool bereits ausgeführt wurde. Wer dann die gesamte Anfrage erneut sendet, riskiert beispielsweise doppelte Bestellungen oder E-Mails.
Das dritte Problem: Rate-Limits verschärfen sich. Mit 429 signalisiert der Anbieter bereits, dass Anfragen langsamer erfolgen sollen. Wenn der Client sofort mehrere Wiederholungsversuche parallel startet, erhöht er die Last zusätzlich. Ein häufiges Gegenbeispiel sind Wiederholungsversuche bei allen 4xx-Fehlern: Bei 401 ist beispielsweise der API-Schlüssel falsch. Nach mehreren Versuchen wird das Anfrage-Limit ausgeschöpft und in den Logs erscheinen vor allem 429-Fehler. Die eigentliche Ursache gerät dadurch aus dem Blick.
Übersicht der Fehlercodes 401, 429, 500 und 529: Wann wiederholen, wann wechseln?
Das Wichtigste vorweg: Die Tabelle deckt 14 Statuscodes ab, die im Produktionsbetrieb häufig vorkommen. Nur bei wenigen lohnt sich ein erneuter Versuch. Ein Wechsel ist erst sinnvoll, wenn sich Wiederholungen als wirkungslos erwiesen haben. „Wechseln“ bedeutet hier, auf ein Ersatzmodell oder eine alternative Verbindung umzusteigen. Die genaue Bedeutung hängt vom jeweiligen Fehlerinhalt und der Dokumentation des Anbieters ab.
| Statuscode | Häufige Bedeutung | Wiederholen? | Wechseln? | Maßnahme |
|---|---|---|---|---|
400 |
Fehler im Anfrageformat oder in den Parametern | Nein | Nein | Request-Body korrigieren, Felder und Typen prüfen |
401 |
Ungültiger API-Schlüssel oder fehlgeschlagene Authentifizierung | Nein | Nein | API-Schlüssel, Authorization-Header und Base URL prüfen |
402 |
Guthaben oder Kontingent aufgebraucht | Nein | Je nach Situation Verbindung wechseln | Guthaben aufladen oder zu einer Verbindung mit verfügbarem Kontingent wechseln und Alarm auslösen |
403 |
Ablehnung aufgrund von Berechtigungen, Region oder Richtlinien | Nein | Nein | Kontoberechtigungen, Modellfreigabe und regionale Einschränkungen prüfen |
404 |
Modell oder Endpunkt nicht vorhanden | Nein | Nein | Modell-ID und Endpunktpfad prüfen |
408 |
Zeitüberschreitung bei der Anfrage | Begrenzte Wiederholung bei Idempotenz | Optional | Prüfen, dass die Anfrage nicht ausgeführt wurde, und einmal wiederholen |
409 |
Konflikt oder inkonsistenter Zustand | Nein | Nein | Anwendungszustand prüfen und gleichzeitige Schreibvorgänge vermeiden |
422 |
Parametervalidierung fehlgeschlagen | Nein | Nein | Parameter korrigieren; tritt häufig beim Schema strukturierter Ausgaben auf |
429 |
Rate-Limit, Parallelitätslimit oder Kontingent | Nach Wartezeit wiederholen | Bei erfolgloser Wiederholung wechseln | Zuerst Fehlerinhalt und Retry-After lesen |
500 |
Interner Fehler beim vorgelagerten Dienst | Begrenzt wiederholen | Bei wiederholtem Fehlschlag wechseln | Request-ID und Fehlerinhalt protokollieren |
502 |
Gateway-Fehler | Begrenzt wiederholen | Wechsel möglich | Zwischen Gateway-Problem und Fehler beim vorgelagerten Dienst unterscheiden |
503 |
Dienst nicht verfügbar | Begrenzt wiederholen | Wechsel möglich | Retry-After beachten, bei Bedarf Funktionalität reduzieren |
504 |
Gateway-Zeitüberschreitung | Nur bei Idempotenz wiederholen | Wechsel möglich | Zuerst prüfen, ob die Aufgabe bereits ausgeführt wurde |
529 |
Vorgelagerter Dienst überlastet | Begrenzt wiederholen | Wechsel möglich | Mit Backoff und Jitter wiederholen; bei anhaltender Überlastung wechseln |
429 bedeutet nicht immer Rate-Limit: Erst den Fehlerinhalt lesen
429 wird besonders leicht falsch eingeordnet. Der Code kann ein Rate-Limit anzeigen, aber auch ein überschrittenes Parallelitätslimit oder ein aufgebrauchtes Modellkontingent. In Einzelfällen hängt er mit dem Guthaben zusammen. Bei einem Rate-Limit reicht oft eine Wartezeit von wenigen Sekunden. Ist dagegen das Kontingent aufgebraucht, helfen auch zahlreiche Wiederholungen nicht. Direkt zum teuersten Modell zu wechseln, erhöht nur die Kosten, während das Problem bestehen bleibt.
So gehen Sie bei 429 vor:
- Den
Retry-After-Header der Antwort lesen und, falls vorhanden, die angegebene Zeit abwarten. - Das Feld für den Fehlertyp im Fehlerinhalt lesen und zwischen Rate-Limit, Parallelität und Kontingent unterscheiden.
- Bei Rate- oder Parallelitätsproblemen: ein- bis zweimal mit Backoff wiederholen und die lokale Parallelität reduzieren.
- Bei Kontingentproblemen: Wiederholungen stoppen, Alarm auslösen und zu einer Verbindung mit verfügbarem Kontingent wechseln.
Bei 500 ist das Vorgehen ähnlich. Der Fehler bedeutet nicht zwangsläufig, dass das Modell selbst defekt ist. Die Ursache kann sowohl im Gateway als auch beim vorgelagerten Dienst liegen. Halten Sie zunächst die Request-ID und eine Zusammenfassung des Fehlerinhalts fest – beides wird für die Fehlersuche und den Abgleich benötigt.
Wiederholungsstrategie bei Modell-API-Fehlern: Anzahl, Backoff, Retry-After und Idempotenz
Fazit: Nur bei vorübergehenden Fehlern wiederholen, die Anzahl auf 1 bis 2 begrenzen, exponentielles Backoff mit zufälligem Jitter verwenden und nur idempotente Anfragen automatisch wiederholen. Sind diese vier Bedingungen nicht erfüllt, sollte keine automatische Wiederholung erfolgen.
| Parameter | Empfohlener Wert | Erklärung |
|---|---|---|
| Wiederholbare Fehler | 429, 500, 502, 503, 504, 529, Netzwerk-Timeouts |
Unter den 4xx-Fehlern sind nur 408 und 429 Ausnahmen |
| Maximale Anzahl der Wiederholungen | 1–2 | Danach wechseln oder einen Alarm auslösen, statt es immer wieder auf dieselbe Weise zu versuchen |
| Backoff-Intervall | 1s, 2s, 4s, exponentiell steigend | Jedes Mal zufälligen Jitter hinzufügen, damit nicht mehrere Instanzen gleichzeitig erneut anfragen |
| Retry-After | Wenn vorhanden, vorrangig beachten | Hat Vorrang vor dem lokalen Backoff-Algorithmus |
| Idempotenz als Voraussetzung | Muss erfüllt sein | Schreiboperationen, Tool-Aufrufe, das Versenden von Nachrichten und Zahlungen standardmäßig nicht automatisch wiederholen |
Schritte zur Umsetzung der Wiederholungsstrategie
- Eine Funktion zur Fehlerklassifizierung erstellen. Sie erhält den Statuscode und den Fehler-Body und gibt eine von fünf Kategorien zurück. Die übrige Logik baut auf dieser Klassifizierung auf, statt überall im Anwendungscode Zahlencodes zu prüfen.
- Anfragen als idempotent oder nicht idempotent kennzeichnen. Reine Textgenerierung, Zusammenfassung und Übersetzung können in der Regel als idempotent gelten. Sobald eine Anfrage Tools auslöst oder externe Schreiboperationen verursacht, wird sie als nicht idempotent markiert.
- Bei nicht idempotenten Anfragen zuerst den Status prüfen. Nach einem Timeout bei einem Tool-Aufruf zunächst den Status der Aufgabe oder der Datenbank abfragen. Erst wiederholen, wenn feststeht, dass die Aktion nicht ausgeführt wurde. Falls nötig, einen anwendungsseitigen Idempotenzschlüssel zur Deduplizierung verwenden.
- Eine maximale Gesamtdauer festlegen. Die gesamte Wiederholungszeit pro Anfrage braucht eine Obergrenze. Sonst wird im Hintergrund weiter versucht, obwohl die Anfrage auf Nutzerseite längst abgelaufen ist.
- Jeden Versuch protokollieren. Mindestens Request-ID, Modell-ID, Statuscode, Fehlerklasse, Latenz, Token-Verbrauch und Anzahl der Wiederholungen erfassen.
Der letzte Schritt wird häufig ausgelassen, ist aber für die Abrechnungskontrolle und Fehlersuche unverzichtbar. Bei der Anbindung über APIYI apiyi.com lassen sich Verbrauch und Aufrufprotokolle in der Konsole nach Key anzeigen. Gleichen Sie die lokal erfasste Request-ID mit den Fehlermeldungen der Plattform ab, um festzustellen, ob ein Fehler am Gateway, beim vorgeschalteten Anbieter oder im eigenen Request-Body aufgetreten ist.
Stream-Abbrüche gesondert behandeln. Wenn eine Streaming-Anfrage abbricht, prüfen Sie zunächst, wie viele Token bereits eingegangen sind und ob der Inhalt schon nutzbar ist. Entscheiden Sie dann, ob Sie die Generierung fortsetzen, den Inhalt verwerfen oder die Anfrage erneut ausführen. Bedenken Sie bei Aufgaben mit langer Ausgabe vor einer erneuten Ausführung: Die vorherige Generierung wurde möglicherweise bereits berechnet.
🎯 Tipp zur Fehlersuche: Bei Fehlern wie
500und529, deren Ursache sich schwer zuordnen lässt, speichern Sie zuerst den vollständigen Fehler-Body und die Request-ID. Gleichen Sie anschließend Verbrauch und Protokolle für denselben Zeitraum in der Konsole von APIYI apiyi.com ab. Ziehen Sie keine Schlüsse allein aus dem Statuscode.
Strategie für den Wechsel auf ein Ersatzmodell: Fähigkeitsstufen, Modellzuordnung und Kompatibilitätsprüfung
Fazit: Voraussetzung für einen Wechsel ist, dass das Ersatzmodell nachweislich dieselben Aufgaben übernehmen kann. Wird der Fallback-Pfad erst im Störungsfall zum ersten Mal genutzt, ist ein zweiter Fehler wahrscheinlich.
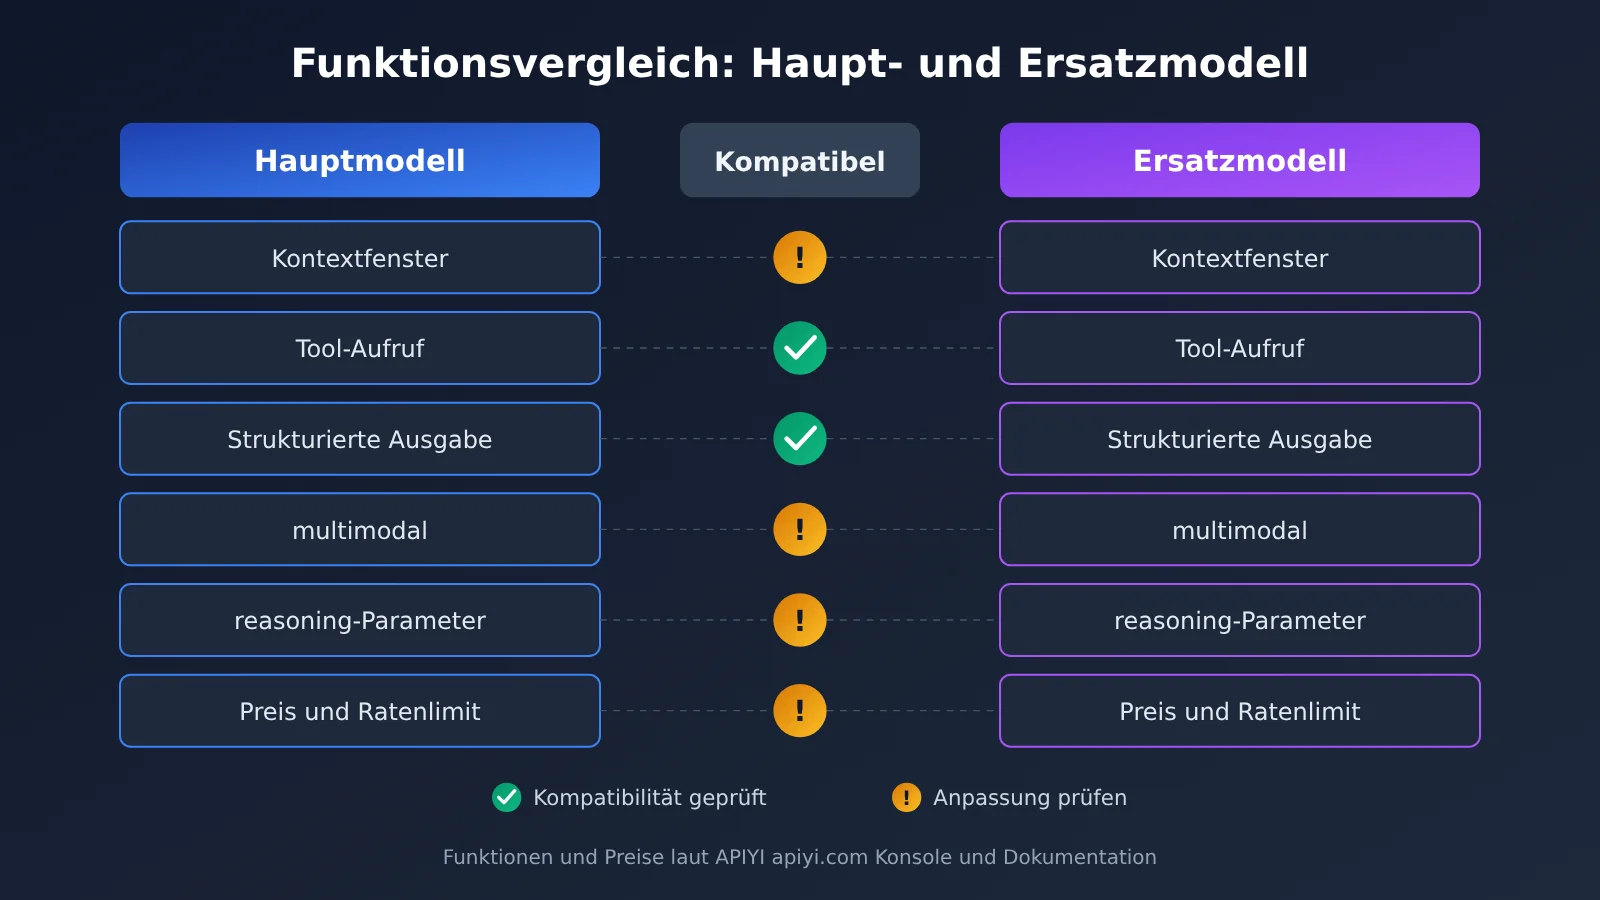
Teilen Sie die Modelle zunächst in Stufen ein: Flaggschiff, Allrounder und leichtgewichtig. Ordnen Sie jedem Aufgabentyp ein Hauptmodell und ein Ersatzmodell aus derselben oder einer benachbarten Stufe zu. Leiten Sie nicht alle Anfragen auf das teuerste Modell um: Schon eine kurzzeitige Störung beim Anbieter könnte sonst die Kosten in die Höhe treiben. Für viele einfache Aufgaben bringt ein Flaggschiffmodell zudem keinen Vorteil.
| Fähigkeit | Hauptmodell | Ersatzmodell | Kompatibel? | Vor dem Wechsel zu prüfen |
|---|---|---|---|---|
| Kontextfenster | Tatsächliches Limit eintragen | Tatsächliches Limit eintragen | Noch zu prüfen | Sicherstellen, dass die längste reale Eingabe hineinpasst; andernfalls zuerst eine Kürzungsstrategie festlegen |
| Tool-Aufrufe | Tool-Schema, parallele Aufrufe | Wie links | Noch zu prüfen | Rückgabeformat der Aufruf-ID und Parameterstruktur überprüfen |
| Strukturierte Ausgabe | JSON-Schema oder striktes JSON | Wie links | Noch zu prüfen | Erfolgsquote mit demselben Schema testen, um 422 zu vermeiden |
| Multimodale Eingabe | Bilder, Audio, Video | Wie links | Noch zu prüfen | Eingabeformate und Grössenbeschränkungen prüfen |
| Reasoning-Parameter | Reasoning-Stufe oder Denkfeld | Wie links | Noch zu prüfen | Nicht unterstützte Parameter beim Wechsel entfernen oder zuordnen |
| Preise und Ratenlimits | Massgeblich ist die Konsole | Massgeblich ist die Konsole | Noch zu prüfen | Kosten nach dem Wechsel schätzen und prüfen, ob die Limits ausreichen |
| Region und Compliance | Zulässiger Bereich | Zulässiger Bereich | Noch zu prüfen | Sicherstellen, dass der Ersatzweg innerhalb der geschäftlich zulässigen Regionen und Compliance-Vorgaben liegt |
Füllen Sie diese Tabelle am besten für jeden Aufgabentyp aus. In die Spalte „Kompatibel?“ gehören nur überprüfte Ergebnisse, keine Einschätzungen aus dem Gedächtnis. Besonders anfällig sind Reasoning-Parameter: Ein Feld für die Reasoning-Stufe, das das Hauptmodell unterstützt, kann beim Ersatzmodell direkt zu 400 oder 422 führen. Die Umschaltlogik braucht daher eine Parameteranpassung, statt alles unverändert weiterzuleiten.
Modellzuordnung: Modell-IDs anhand der Konsole prüfen
Ein häufiger vermeidbarer Fehler beim Wechsel ist eine falsch geschriebene Modell-ID, die zu 404 führt. Pflegen Sie am besten eine Zuordnung von logischen Modellnamen zu tatsächlichen Modell-IDs. Der Anwendungscode verwendet dann nur die logischen Namen. Bei Aufrufen über APIYI apiyi.com sind für die genauen IDs, die Verfügbarkeit und die Preise der Modelle die Konsole und die Dokumentation massgeblich. Für die Anbindung wird einheitlich https://api.apiyi.com/v1 als base_url verwendet. Testen Sie Änderungen an der Zuordnung vor der Veröffentlichung mit einer Canary-Anfrage.
Fallback-Modelle validieren und Multi-Modell-Gateways nutzen: Canary-Tests, Logs und automatisches Fallback
Fazit: Ein Fallback-Modell sollte vor dem Einsatz mit realen Aufgaben validiert werden. Nach einem Fallback muss auch die Ausgabe geprüft werden – ein Statuscode 200 allein reicht nicht. Ein Multi-Modell-Gateway erleichtert den Wechsel, übernimmt aber nicht die Qualitätsprüfung.
Fallback-Modelle in drei Schritten validieren
- Canary-Anfragen. Wählen Sie eine Reihe realer Geschäftsaufgaben und senden Sie dieselbe Eingabeaufforderung mit denselben Tools und Eingaben jeweils an das primäre Modell und das Fallback-Modell.
- Dieselben Aufgaben vergleichen. Vergleichen Sie Erfolgsquote, Latenz, Zeit bis zum ersten Token, Token-Kosten und Fehlerrate. Prüfen Sie bei Aufgaben mit Tool-Aufrufen zusätzlich, ob Aufruf-IDs, Parameter- und Rückgabestrukturen jeweils kompatibel sind.
- Ausgaben nach dem Fallback prüfen. Validieren Sie die Ausgabe nach einem tatsächlichen Wechsel automatisch: Lässt sich das JSON parsen? Sind alle Pflichtfelder vorhanden? Sind die Tool-Parameter gültig? Protokollieren Sie außerdem den Grund für den Wechsel und das Prüfergebnis.
Der Fallback-Pfad sollte regelmäßig getestet werden. Sie können beispielsweise jede Woche einen kleinen Teil des Datenverkehrs gezielt auf das Fallback-Modell umleiten. So stellen Sie sicher, dass die Verbindung weiterhin funktioniert und Abhängigkeiten, Parameter oder Modell-IDs nicht unbemerkt ungültig geworden sind.
Die Logs sollten mindestens folgende Felder enthalten:
- Anfrage-ID, Modell-ID, Endpunkt, Statuscode, Fehlerklasse, Zusammenfassung des Fehlerinhalts
- Latenz, Zeit bis zum ersten Token, Gesamtdauer, Anzahl der Wiederholungsversuche, Wechselziel
- Eingabe-Token, Ausgabe-Token, Cache-Treffer, geschätzte Kosten
- Name des Tool-Aufrufs, Aufruf-ID, Erfolg der Ausführung
- Grund für den Wechsel, Ergebnis der Prüfung nach dem Wechsel
Die Rolle von Multi-Modell-Gateways bei der Ausfallsicherung
Wer für die Ausfallsicherung mehrere Anbieter selbst integriert, muss mindestens mehrere API-Schlüssel, SDKs und Fehlerformate verwalten. Mit einem aggregierenden Gateway wie APIYI apiyi.com lassen sich gängige Modelle wie OpenAI, Claude, Gemini, DeepSeek und Qwen mit einem einzigen API-Schlüssel aufrufen. Die Schnittstelle ist mit dem OpenAI-Standard kompatibel und unterstützt auch die nativen Formate von Claude und Gemini. Primäres und Fallback-Modell können so denselben Integrationscode nutzen. Beim Wechsel wird dann die Modell-ID geändert, nicht die gesamte Integration.
Die Plattform bietet außerdem die Bereitstellung über mehrere Knoten, intelligentes Routing, automatisches Fallback und Lastverteilung. Damit kann sie einen Teil der Schwankungen bei vorgelagerten Anbietern abfangen. Das automatische Fallback auf Gateway-Ebene ersetzt aber nicht die Prüfung auf Anwendungsebene: Idempotenzprüfungen, die Deduplizierung von Tool-Aufrufen und die Validierung der Ausgabe müssen weiterhin im eigenen Code erfolgen. Eine sinnvolle Aufteilung ist: Das Gateway kümmert sich um die Verfügbarkeit von Verbindungen und Knoten, die Anwendung um die korrekte Ausführung der Aufgaben.
💡 Tipp zur Ausfallsicherung: Lassen Sie bei der Planung von primärem und Fallback-Modell zunächst dieselbe Reihe von Canary-Aufgaben mit demselben API-Schlüssel über APIYI apiyi.com laufen. Tragen Sie anschließend die erfolgreich validierten Kombinationen in die Modell-Zuordnungstabelle ein. Neue Nutzer können für die Validierung zunächst das kostenlose Testguthaben verwenden.
FAQ: Häufige Fragen zu Fehlern bei Modell-APIs
Die folgenden fünf Fragen decken Szenarien ab, die im Produktionsbetrieb besonders häufig für Diskussionen sorgen. Für alle Antworten gilt dasselbe Prinzip: erst prüfen, dann handeln.
Q1: Soll man bei einem 401-Fehler erneut versuchen?
Nein. `401` bedeutet, dass die Authentifizierung fehlgeschlagen ist. Wiederholungen erhöhen nur das Anfragevolumen und können das Problem sogar in einen `429`-Fehler verwandeln. Prüfen Sie, ob der API-Schlüssel gültig ist, das Format des `Authorization`-Headers stimmt und die Base URL zur selben Plattform wie der API-Schlüssel gehört. Bei APIYI apiyi.com können Sie den Status des API-Schlüssels in der Konsole prüfen.
Q2: Soll man bei einem 429-Fehler sofort das Modell wechseln?
Ein sofortiger Wechsel ist nicht empfehlenswert. Prüfen Sie zunächst den Fehlertext und `Retry-After`: Bei einer Begrenzung der Anfragerate oder gleichzeitiger Anfragen reichen nach einer Wartezeit meist ein bis zwei Wiederholungen. Erst wenn das Kontingent aufgebraucht ist, sollten Sie auf eine alternative Route wechseln. Wählen Sie dabei ein Ersatzmodell derselben Leistungsklasse und nicht pauschal das teuerste Modell.
Q3: Soll man eine Anfrage bei unterbrochener Streaming-Ausgabe erneut senden?
Nicht sofort. Eine Unterbrechung des Streams bedeutet nicht zwangsläufig, dass die Anfrage fehlgeschlagen ist. Möglicherweise wurden bereits Inhalte erzeugt und Kosten verursacht. Prüfen Sie zunächst die Anzahl der empfangenen Token und ob der Inhalt nutzbar ist: Ist er brauchbar, behalten Sie ihn oder lassen Sie ihn fortsetzen. Ist er nicht brauchbar und die Anfrage idempotent, senden Sie sie einmal erneut. Für die tatsächliche Abrechnung sind die Nutzungsdaten in der Konsole massgeblich.
Q4: Was tun, wenn ein Tool-Aufruf mehrfach ausgeführt wird?
Die grundlegende Lösung ist Idempotenz auf Tool-Ebene: Nutzen Sie einen Idempotenzschlüssel aus der Anwendung oder eine Aufgaben-ID zur Deduplizierung. Jede ID darf nur einmal ausgeführt werden. Prüfen Sie nach einem Timeout zuerst den Aufgabenstatus und wiederholen Sie den Aufruf erst, wenn feststeht, dass er nicht ausgeführt wurde. Kam es bereits zu doppelten Ausführungen, verfolgen Sie die Logs anhand der Aufruf-ID zurück und gleichen Sie die zusätzlichen Aktionen aus oder machen Sie sie rückgängig.
Q5: Was tun, wenn das Ersatzmodell 200 zurückgibt, aber das Ergebnis falsch ist?
200 bedeutet nur, dass die Anfrage erfolgreich war – nicht, dass die Aufgabe erfolgreich abgeschlossen wurde. Prüfen Sie die Ausgabe automatisch, zum Beispiel auf eine gültige JSON-Struktur, erforderliche Felder und zulässige Tool-Parameter. Fehlgeschlagene Prüfungen sollten in die Fehlerrate einfliessen und eine Warnung oder manuelle Prüfung auslösen. Schlägt die Abnahme bei einer Ersatzkombination häufig fehl, entfernen Sie sie aus der Zuordnungstabelle und wiederholen Sie den Canary-Test.
Checkliste vor dem Go-live und Fazit: Wann wiederholen, wechseln oder stoppen?
Fazit: Gehen Sie diese Checkliste vor dem Go-live Punkt für Punkt durch. Das ist deutlich zuverlässiger, als die Logik erst nach einem Ausfall zu ergänzen. Die Faustregel lautet: Bei 4xx zuerst den Fehler beheben, erst bei 5xx über Wiederholungen nachdenken und bei nicht idempotenten Anfragen zunächst stoppen.
| Nr. | Prüfpunkt | Kriterium |
|---|---|---|
| 1 | Zuerst den Fehlertyp bestimmen | Alle Statuscodes lassen sich einer von fünf Kategorien zuordnen; unbekannte Fehler werden standardmäßig nicht wiederholt |
| 2 | 4xx nicht automatisch wiederholen | Bei 400, 401, 402, 403, 404, 409 und 422 direkt einen Alarm auslösen oder den Fehler beheben |
| 3 | Dann über Wiederholung oder Wechsel entscheiden | Nur vorübergehende Fehler wiederholen, höchstens 1 bis 2 Mal, mit Backoff und Jitter |
| 4 | Retry-After beachten | Wenn der Response-Header vorhanden ist, vorrangig die dort angegebene Wartezeit einhalten |
| 5 | Idempotenz prüfen | Bei Tool-Aufrufen, Schreibvorgängen, Nachrichten und Zahlungen standardmäßig stoppen und erst nach einer Statusprüfung entscheiden |
| 6 | Stream-Abbrüche behandeln | Zuerst bereits empfangene Token und angefallene Kosten prüfen, die Anfrage nicht blind wiederholen |
| 7 | Ersatzmodell prüfen | Die Fähigkeiten des Ersatzmodells sind für jeden Aufgabentyp in der Checkliste dokumentiert und überprüft |
| 8 | Modellzuordnung prüfen | Die Zuordnung logischer Namen zu Modell-IDs stimmt mit der Konsole überein |
| 9 | Ausgabe abschließend prüfen | Nach einem Wechsel Struktur und Felder validieren, nicht nur auf 200 achten |
| 10 | Logs und Übungen | Alle wichtigen Felder sind vorhanden, der Fallback-Pfad wird regelmäßig getestet |
Die wichtigsten Erkenntnisse zur Fehlerbehandlung bei Modell-APIs
- Wann wiederholen? Bei
429,500,502,503,529und Timeouts idempotenter Anfragen – mit begrenzter Anzahl und Backoff. - Wann wechseln? Wenn Wiederholungen fehlschlagen, der vorgeschaltete Dienst dauerhaft nicht verfügbar oder das Kontingent ausgeschöpft ist und das Ersatzmodell geprüft wurde.
- Wann stoppen? Bei 4xx-Konfigurationsfehlern wie
401und bei nicht idempotenten Anfragen mit unklarem Status. - Ein Wechsel ist noch kein Erfolg: Auch wenn das Ersatzmodell 200 zurückgibt, muss die Ausgabe geprüft werden.
- Aufgabenteilung zwischen Gateway und Anwendung: Das Gateway kümmert sich um die Verfügbarkeit der Verbindungen, der Anwendungscode um die korrekte Ausführung der Aufgabe.
Gute Fehlerbehandlung zeigt sich nicht daran, wie oft ein System Anfragen wiederholt, sondern daran, ob es bei jedem Fehler richtig entscheidet. Ergänzen Sie zunächst die Fehlerklassifizierung, Idempotenzkennzeichnungen und Log-Felder und führen Sie anschließend schrittweise Ersatzmodelle ein. Als Fallback-Verbindung kommt APIYI apiyi.com infrage: Ein API-Schlüssel deckt mehrere gängige Modelle ab, sodass sich Haupt- und Ersatzmodelle mit demselben Code prüfen und wechseln lassen. Für Preise und Verfügbarkeit sind die Konsole und die Dokumentation maßgeblich.
📚 Referenzen
- APIYI-Dokumentationszentrum: Anbindung, Modellliste und Abrechnung
- Link:
docs.apiyi.com -
Hinweis: Maßgeblich für Modell-IDs, Preise und Verfügbarkeit sind die Dokumentation und die Konsole.
-
Bedeutung der HTTP-Statuscodes: Standard-Response-Header wie
Retry-After - Link:
developer.mozilla.org/docs/Web/HTTP/Status - Hinweis: Die Dokumentation erklärt die allgemeine Bedeutung von 4xx- und 5xx-Codes. Die genaue Bedeutung ergibt sich aus der Fehlerantwort der jeweiligen Modellplattform.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns auf der Startseite der offiziellen APIYI-Website apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.