Hinweis des Autors: Google veröffentlicht am 12.11.2026 Gemini 4 Hydrogen. Dieser Artikel fasst die 10-Punkte-Vergleichstabelle der offiziellen Modellkarte, die Verbesserungen gegenüber Gemini 3.8 Flash, die Spezifikationen und den Preis im Standardtarif zusammen und benennt für jeden Punkt die jeweilige Zahlenbasis.
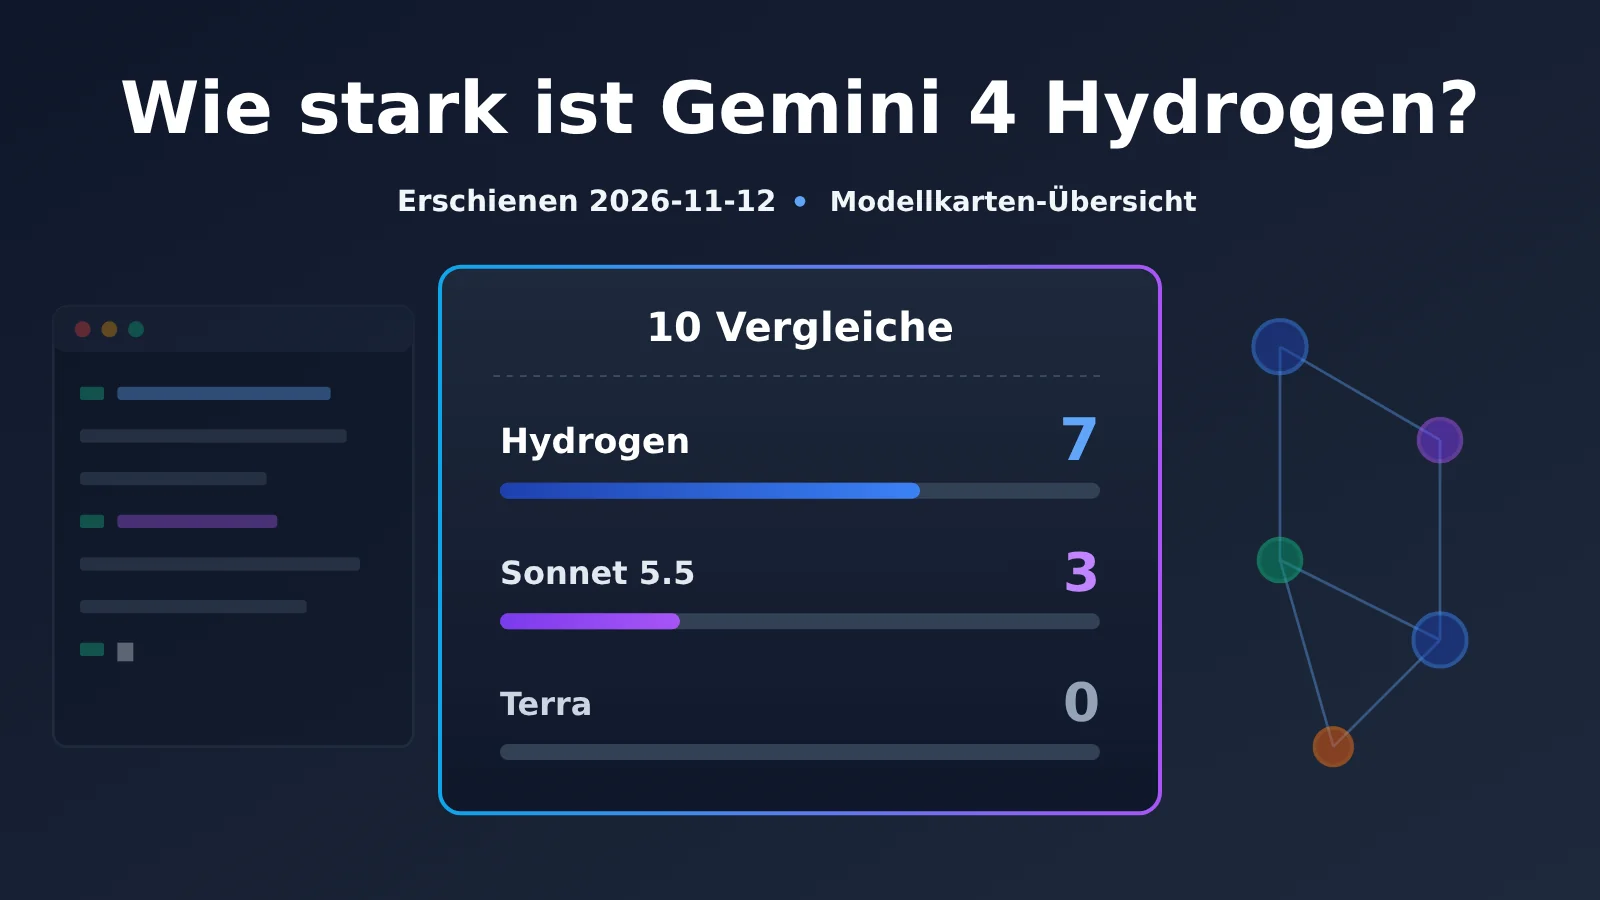
Google hat am 12.11.2026 Gemini 4 Hydrogen offiziell veröffentlicht; die Modell-ID lautet gemini-4-hydrogen. Die Positionierung ist schnelleres alltägliches Coding und die Ausführung verschiedenartiger Agenten, nicht die Art von Carbon oder Argon, die für das anspruchsvollste Reasoning über lange Zeiträume zuständig sind. Der offizielle globale Standardtarif liegt bei $1.50 für Eingabe und $7.50 für Ausgabe (pro Million Tokens). In der 10-Punkte-Vergleichstabelle der DeepMind-Modellkarte erzielt es bei 7 der 10 Punkte die Bestnote.
Das ist kein Codename-Gerücht aus der Zeit vor der Veröffentlichung. Der Google-Blog, der Entwickler-Newsletter und die DeepMind-Modellkarte sind bereits online; der Testlink in AI Studio verwendet genau die ID gemini-4-hydrogen. Wichtig: Alle in diesem Artikel zitierten Scores stammen aus offiziellen Eigenangaben oder der Zusammenfassung der offiziellen Modellkarte und nicht aus Nachtestungen von APIYI.
Der Kernnutzen: Nach dem Lesen dieses Artikels wissen Sie, bei welchen Aufgaben Gemini 4 Hydrogen die Nase vorn hat und bei welchen es hinter Claude Sonnet 5.5 liegt – und wie diese Zahlen zu lesen sind.
Gemini 4 Hydrogen: Die Kernfakten im Überblick
Zuerst die grundlegenden Fakten. Die Angaben in der folgenden Tabelle stammen aus dem Google-Blog, aus Entwickler-Kurzmeldungen und der DeepMind-Modellkarte (veröffentlicht im November 2026); Überprüfungsdatum ist der 13.11.2026.
| Information | Details zu Gemini 4 Hydrogen |
|---|---|
| Veröffentlichungsdatum | 12.11.2026, ab diesem Tag weltweit verfügbar |
| Anbieter | Google / Google DeepMind |
| Modell-ID | gemini-4-hydrogen |
| Quelle | Die Modellkarte gibt an: „adapted from Gemini 4 Carbon“, also aus Carbon abgeleitet |
| Offizielle Positionierung | Alltägliches Coden, Agent-Ausführung; kann allein oder als Ausführungs-Engine in Multi-Modell-Workflows eingesetzt werden |
| Denkstufen | vier Stufen: low, medium, high (Standard), xhigh |
| Wissensstand | März 2026, in manchen Bereichen möglicherweise älter |
| Offizielle Kanäle | AI Studio (alle Stufen), Gemini API, Android Studio, Gemini for business, Gemini App, Google Search |
Google beschreibt die Arbeitsteilung innerhalb der Gemini-4-Familie ziemlich direkt: Carbon und Argon übernehmen das anspruchsvollste Reasoning über lange Zeiträume, Hydrogen kümmert sich um die schnelleren Alltagsaufgaben. Deshalb ist es nicht sinnvoll, Hydrogen und Carbon als „alte und neue Version desselben Modells“ zu vergleichen. Das Verhältnis zu Carbon gleicht eher zwei Rollen auf derselben Basis.
Bei den Nutzungskanälen gilt: Zahlende Google AI Pro- und Ultra-Nutzer können Hydrogen zusätzlich in Google Antigravity verwenden. Sheets wird zunächst für Pro / Ultra und berechtigte Unternehmensabos geöffnet. AI Studio bestätigt offiziell, dass alle Stufen verfügbar sind; die genauen Limits der kostenlosen Stufe wurden diesmal nicht überprüft und sollen hier nicht weiter vertieft werden.
Die vier Denkstufen von Gemini 4 Hydrogen
Die vier Denkstufen sind ein wichtiger Punkt bei der Nutzung von Hydrogen. Laut offizieller Beschreibung steigen Qualität, Latenz und Kosten zwischen den Stufen gleichmäßig an, sodass Entwickler nur für die tatsächlich benötigte Reasoning-Tiefe zahlen. Die Standardstufe ist high – das schlägt sich direkt in der Rechnung nieder, worauf wir im Preisabschnitt später noch zurückkommen.
Offizielle 10-Punkte-Vergleichstabelle von Gemini 4 Hydrogen
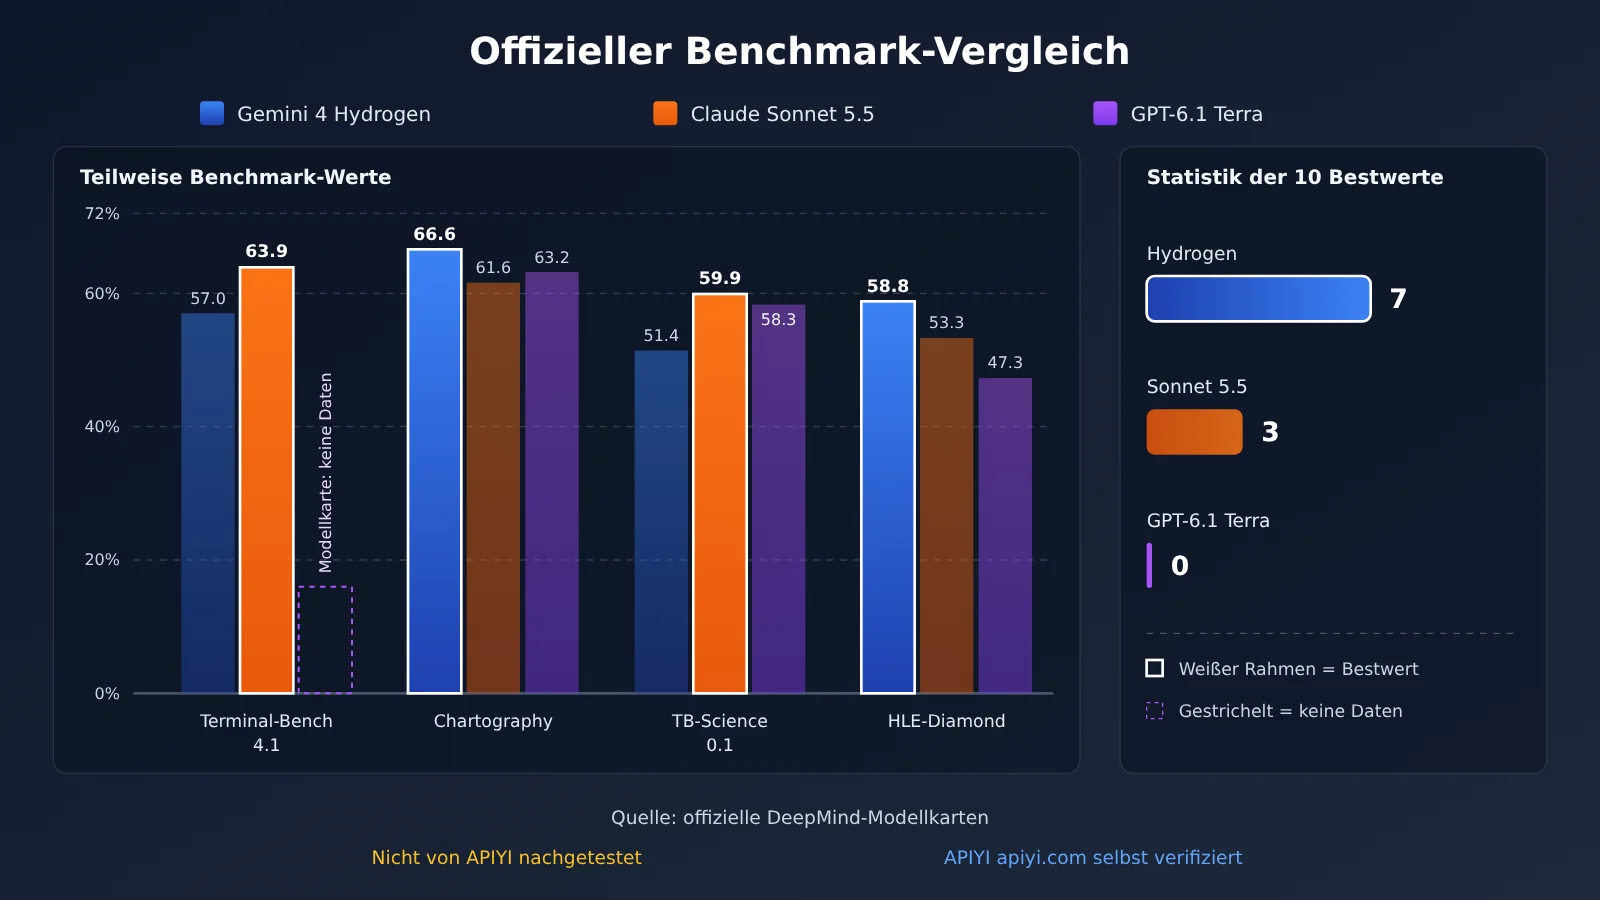
Das ist der Kern dieses Artikels. Die Modellkarte von DeepMind enthält eine Vergleichstabelle mit 10 Benchmarks, in der Gemini 4 Hydrogen, Claude Sonnet 5.5 und GPT-6.1 Terra gegenübergestellt werden.
| Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Bestwert |
|---|---|---|---|---|
| SWE-sweep | 13,5 % | 3,1 % | 5,8 % | Hydrogen |
| Terminal-Bench 4.1 (cheating-adjusted) | 57,0 % | 63,9 % | keine Daten | Sonnet |
| Agents‘ Last Exam v1.1 | 71,6 % | 60,4 % | 69,8 % | Hydrogen |
| AutomationBench-AA | 76,1 % | 71,8 % | 60,2 % | Hydrogen |
| Vending-Bench 2 (Kontostand, US-Dollar) | 14549 | 11165 | 9107 | Hydrogen |
| OSWorld-2.1 (offline subset) | 77,6 % | 83,9 % | 74,2 % | Sonnet |
| MKA (Climb WSR accuracy) | 53,4 % | 52,0 % | 43,8 % | Hydrogen |
| Chartography | 66,6 % | 61,6 % | 63,2 % | Hydrogen |
| Terminal-Bench-Science 0.1 | 51,4 % | 59,9 % | 58,3 % | Sonnet |
| HLE-Diamond | 58,8 % | 53,3 % | 47,3 % | Hydrogen |
Die Auszählung ergibt: Hydrogen führt bei 7 Kategorien, Sonnet 5.5 bei 3 – nämlich Terminal-Bench 4.1, OSWorld-2.1 (Computerbedienung) und Terminal-Bench-Science. GPT-6.1 Terra belegt in keiner der Zellen mit Wert den ersten Platz.
Zwei Punkte verdienen besondere Beachtung. Erstens: In der Zeile Terminal-Bench 4.1 ist die Terra-Zelle leer, die Modellkarte nennt dort keine Zahl – daraus lässt sich also nicht ableiten, dass „Terra im Terminal schwächer ist“. Zweitens: „7 von 10 gewinnen“ bedeutet keine umfassende Überlegenheit; bei Terminal- und Computerbedienungsaufgaben, also genau den beiden Kategorien, die eng mit agentischer Ausführung zusammenhängen, liegt Hydrogen weiterhin hinter Sonnet 5.5.
Wie man diese Vergleichstabelle zu Gemini 4 Hydrogen liest
Die methodischen Hinweise im Model Card bestimmen, wie weit man diese Tabelle interpretieren kann. Die Werte von Hydrogen sind – sofern nicht anders angegeben – durchgängig im höchsten Denkmodus, pass@1, mit einem einzelnen Versuch und über die Gemini API ausgeführt. Für Sonnet 5.5 und GPT-6.1 Terra wird standardmäßig die jeweils öffentlich dokumentierte maximale Denk- bzw. Reasoning-Stufe angesetzt; liegen keine öffentlichen Ergebnisse vor, greift man auf die bestmöglichen verfügbaren Werte zurück.
Anders gesagt: Das ist kein erneuter Durchlauf aller drei Modelle am selben Tag mit demselben Skript. Besonders deutlich wird das beim SWE-sweep: Die Werte der Wettbewerber stammen aus öffentlichen Ranglisten und nicht aus einer Nachmessung durch Google mit demselben Scaffold. Die Tabelle eignet sich also, um die ungefähre Richtung der Stärkeverhältnisse einzuschätzen – nicht aber, um jeden Prozentpunkt Unterschied als präzises Ergebnis zu lesen.
Außerdem sind die Hydrogen-Werte in der Tabelle Ergebnisse im höchsten Denkmodus, während standardmäßig high gilt. Wenn Sie im Produktivbetrieb die Standardstufe nutzen, kann die tatsächliche Leistung von den Zahlen in der Tabelle abweichen. Das lohnt sich, an den eigenen Aufgaben zu überprüfen.
Die Verbesserungen von Gemini 4 Hydrogen gegenüber Gemini 3.8 Flash
Für Entwickler, die bereits Gemini 3.8 Flash einsetzen, ist dieser Abschnitt womöglich hilfreicher als der direkte Vergleich. Alle folgenden Zahlen sind offizielle Selbstauskünfte.
| Dimension | Gemini 3.8 Flash | Gemini 4 Hydrogen | Erläuterung |
|---|---|---|---|
| Geschwindigkeit der Aufgabenerledigung (Standard high) | Referenz | 2,5-mal schneller | Offizielle Selbstauskunft |
| Terminal-Bench 4.1 | 18,2 % | 57 % | Mehr als das Dreifache |
| Erfundene Aussagen | Referenz | um mehr als das Fünffache reduziert | Offizielle Selbstauskunft |
| Bei Tool-Fehlern / leerer Suche | — | leitet aktiver um | Qualitative offizielle Beschreibung |
| Geschwindigkeit im frühen Partner-Test | Referenz | 2- bis 2,8-mal schneller | Diagramme, SQL, datenintensive Abläufe |
| Token-Verbrauch im frühen Partner-Test | Referenz | 12 % bis 23 % weniger | Offiziell wiedergegeben, keine öffentliche Rangliste |
Der Sprung der Terminal-Aufgaben von 18,2 % auf 57 % ist die deutlichste Veränderung dieses Releases. Das zeigt, dass Hydrogen bei der Frage, ob ein kleines Modell Kommandozeilenaufgaben wirklich ausführen kann, eine Nutzbarkeitsschwelle überschritten hat. Betrachtet man es jedoch wieder in der Vergleichstabelle, liegt 57 % immer noch unter den 63,9 % von Sonnet 5.5.
Auch die frühen Testdaten der Partner sollte man separat betrachten. Es handelt sich um offiziell wiedergegebene Partnerergebnisse, nicht um eine öffentliche Rangliste; die Szenarien konzentrieren sich auf komplexe Diagramme, SQL und datenintensive Abläufe und lassen sich nicht unbedingt auf alle Geschäftsbereiche übertragen.
Weitere offizielle Selbstauskünfte zu Gemini 4 Hydrogen
Neben der Tabelle mit den 10 Punkten führen Blog und Modellkarte noch einige weitere Ergebnisse auf, die ebenfalls offizielle Selbstauskünfte sind:
- Artificial Analysis Intelligence Index: In der Standardstufe high liegt er bei 51, für Argon bei 50, und in der Stufe xhigh erreicht er 54. Dies ist die von Google zitierte AA-Zahl. Carbon hatte zuvor einen AA Index v5 von 59 Punkten veröffentlicht, aber die Ankündigung sagt nicht, ob Hydrogen denselben Index verwendet; die beiden sollten nicht direkt voneinander abgezogen und verglichen werden.
- Agent Arena: Rang 5 bei offenen Agent-Aufgaben.
- Vals Tax Agent Bench: 52,3 %, laut offizieller Angabe Gesamtrang 1.
- Vals Legal Research Bench: 55,8 %, laut offizieller Angabe gemeinsam auf Rang 1.
- HLE-Diamond: 58,8 %, laut offizieller Angabe führend in seiner Klasse.
Die Rolle von Gemini 4 Hydrogen in Multi-Modell-Prozessen
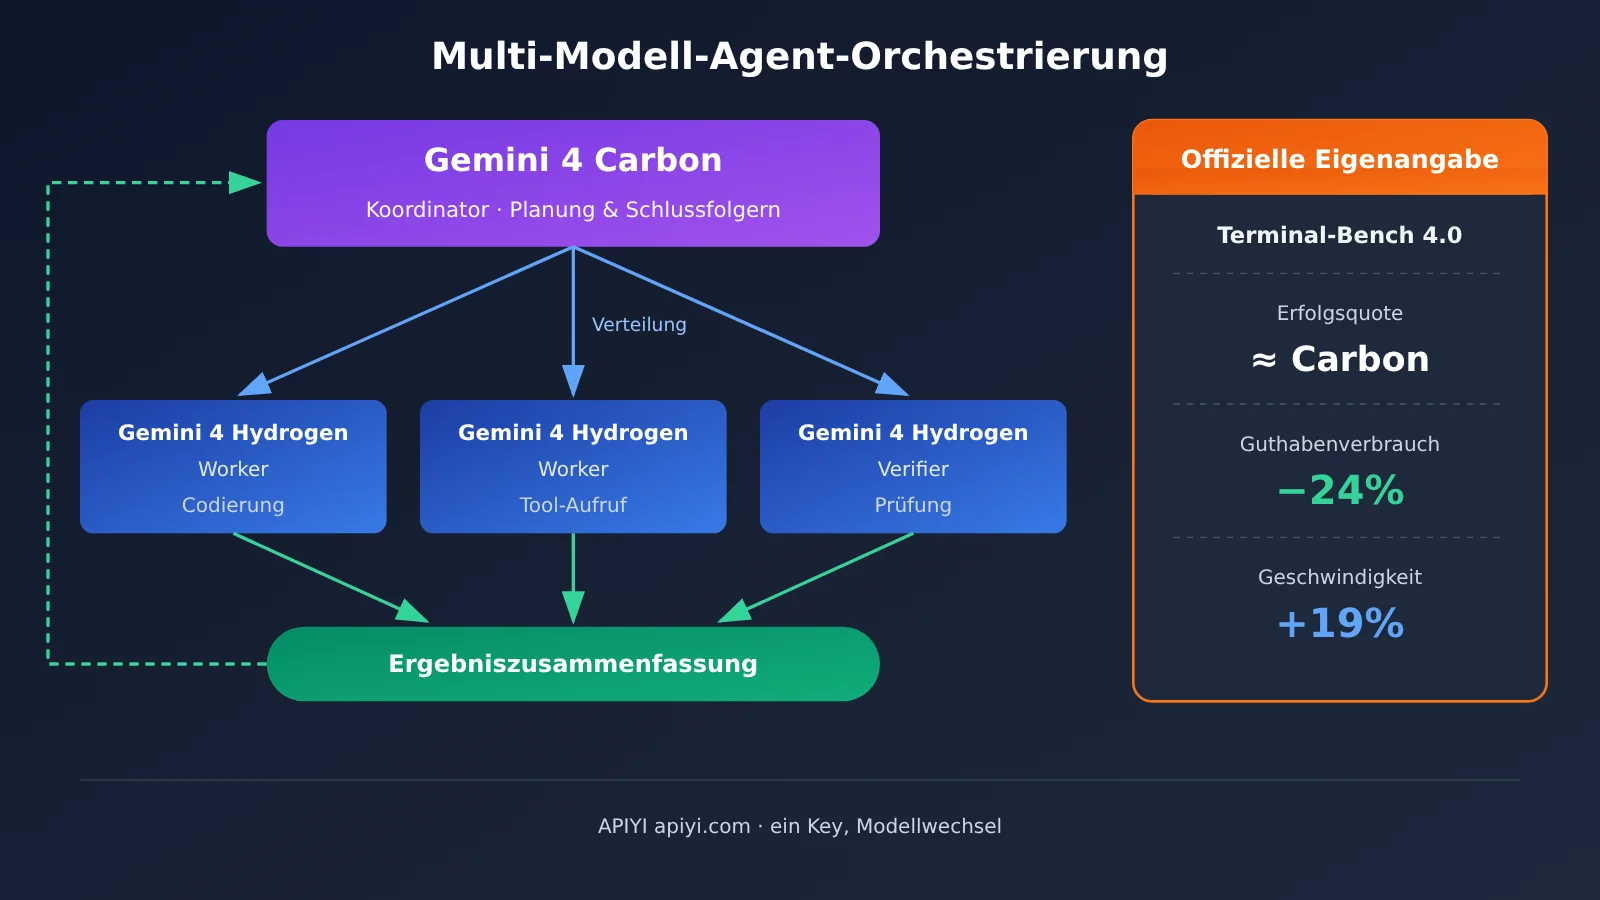
Offiziell wurde außerdem ein Datensatz zur kombinierten Nutzung angegeben. Im Antigravity Orchestrator wechselt das System zwischen Carbon und Hydrogen; auf Terminal-Bench 4.0 liegt die Erfolgsquote der Aufgaben nahe an der von reinem Carbon, bei durchschnittlich 24 % weniger verbrauchtem Kontingent und 19 % höherer Geschwindigkeit. Im parallelen Modus übernimmt Carbon die Rolle des Koordinators, Hydrogen die des Workers oder Verifiers.
Diese Daten verdeutlichen die Designabsicht von Google für Hydrogen recht gut: Es soll Carbon nicht ersetzen, sondern eine Vielzahl konkreter Ausführungen übernehmen und die teure Inferenz für die wirklich notwendigen Schritte reservieren.
Gemini 4 Hydrogen: Spezifikationen und Preise
Kontextfenster: Modellkarte und Blog formulieren es unterschiedlich
Beim Kontextfenster weichen Modellkarte und Blog voneinander ab. Hier stehen beide Aussagen nebeneinander:
- Modellkarte: „combined input-output token context window of up to 1M“, also Eingabe und Ausgabe zusammen maximal 1 Million Tokens; bei synchronen Aufrufen standardmäßig maximal 64.000 Ausgabe-Tokens; beim Long-Decode im Hintergrund maximal 1 Million Ausgabe-Tokens.
- Blog: nativ 1 Million Tokens Eingabe, Ausgabe bis zu 1 Million Tokens.
Für die Praxis empfiehlt es sich, bei der Budgetplanung lieber die konservativere „Gesamtfenster“-Angabe aus der Modellkarte zugrunde zu legen und dabei das Standardlimit von 64.000 Ausgabe-Tokens bei synchronen Aufrufen im Auge zu behalten. Für sehr lange Ausgaben braucht es den Long-Decode im Hintergrund. Bei den Eingabemodalitäten unterstützt Hydrogen Text, Bilder, Audio und Video.
Offizielle Standardpreise für Gemini 4 Hydrogen
Laut Blog gibt es für das gesamte 1-Million-Token-Fenster einen Pauschalpreis. Die folgende Tabelle stammt von der Google-Cloud-Preisseite (abgerufen am 13.11.2026) und zeigt nur den Standardtarif, in US-Dollar pro Million Tokens.
| Abrechnungsposition | Globaler Standardtarif | Nicht global |
|---|---|---|
| Eingabe (Text, Bild, Video, Audio) | $1.50 | $1.65 |
| Cache-Lesen | $0.075 | $0.0825 |
| Ausgabe (Antwort und Reasoning zusammen) | $7.50 | $8.25 |
| Cache-Schreiben | Listenpreis $1.875, Abrechnung erst ab 12.01.2027 | — |
Ein Punkt, der leicht übersehen wird: Der Ausgabepreis umfasst Antwort und Reasoning gemeinsam. Hydrogens Standard-Denkstufe ist high, deshalb enthalten die Ausgabekosten auch die Thinking-Tokens. Die Modellkarte weist ebenfalls darauf hin, dass höhere Denkstufen mehr Tokens verbrauchen können. Bei einfachen Aufgaben lässt sich die Stufe auf low oder medium senken, um Kosten zu sparen.
Wo man heute Gemini 4 Hydrogen aufrufen kann
Was die offiziellen Kanäle angeht, waren Google AI Studio und die Gemini API am selben Tag bereits verfügbar. Auf der Seite von APIYI haben wir am 2026-11-13 die Übersichtstabelle unter docs.apiyi.com/models, die Modellseiten sowie die Preisschnittstelle api.apiyi.com/api/pricing geprüft – nirgends fand sich gemini-4-hydrogen. Die Modellseite liefert 404, und in den 282 Modellen, die an diesem Tag in der Preisschnittstelle gelistet waren, brachte die Suche nach hydrogen ebenfalls kein Ergebnis. Das Modell ist also noch nicht verfügbar; wir werden es so schnell wie möglich aufnehmen. Modell und Preis richten sich nach der Modellliste der Plattform.
Bevor Hydrogen verfügbar ist, lassen sich über APIYI apiyi.com bereits die beiden Konkurrenten aus der 10-Punkte-Tabelle sowie Hydrogens „Muttermodell“ Carbon aufrufen – ideal, um den Vergleichsablauf schon einmal aufzusetzen:
| Modell-ID | Eingabe | Ausgabe | Cache-Lesen | Endpunkt | Verfügbare Plattform |
|---|---|---|---|---|---|
gemini-4-carbon |
$2 | $10 | $0.1 | chat、gemini | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | chat、messages | APIYI |
gpt-6.1-terra |
$1 | $5 | $0.05 | responses(首选)、chat | APIYI |
Zu den Carbon-Preisen noch eine Anmerkung: In der APIYI-Dokumentation steht, dass $2 / $10 Googles Aktionspreis ist, gültig bis zum 2026-11-30; ab dem 2026-12-01 wird er offiziell auf $4 / $20 angepasst, Cache-Lesen $0.10.
Der Zugang läuft über die OpenAI-kompatible Schnittstelle: base_url auf https://api.apiyi.com/v1 setzen und im Modellfeld gemini-4-carbon, claude-sonnet-5-5 oder gpt-6.1-terra eintragen. Sobald Hydrogen verfügbar ist, musst du nur das Modellfeld auf gemini-4-hydrogen umstellen, um im selben Code dieselben Aufgabentypen wie in der 10-Punkte-Tabelle oben abzubilden.
🎯 Technischer Tipp: Die Konkurrenzwerte auf den offiziellen Modellkarten stammen aus den öffentlich veröffentlichten Ergebnissen der einzelnen Anbieter und passen nicht unbedingt zu deinem Geschäftsszenario. Vergleiche am besten zuerst über APIYI apiyi.com mit denselben echten Aufgaben Sonnet 5.5 und Terra und ergänze nach dem Hydrogen-Launch eine weitere Spalte – so bekommst du deine eigene Gewinn-/Verlust-Tabelle.
Gemini 4 Hydrogen – Auswirkungsanalyse
Auswirkungen auf Entwickler
- Eine zusätzliche Option auf der Agenten-Ausführungsebene: Bei Agenten-Aufgaben wie AutomationBench-AA, Agents‘ Last Exam und Vending-Bench 2 liegt Hydrogen laut offiziellen Ergebnissen vorn. Das Modell eignet sich daher, um in Workflows zahlreiche Ausführungsschritte zu übernehmen.
- Terminal- und Computerbedienung muss weiterhin bewertet werden: Auf Terminal-Bench 4.1 und OSWorld-2.1 liegt Sonnet 5.5 vorn. Wenn Ihr Kernszenario ein Kommandozeilen-Agent oder Desktop-Automatisierung ist, sollten Sie sich nicht allein auf die „7 Siege“ verlassen.
- Nutzer von 3.8 Flash sollten einen Umstieg prüfen: Geschwindigkeit, Erfolgsquote im Terminal und Halluzinationsrate haben sich laut offiziellen Angaben deutlich verbessert. Prüfen Sie dies jedoch mit Ihren eigenen Daten.
- Die Kosten hängen von der Thinking-Stufe ab: Die Standardstufe
highrechnet Thinking-Tokens zur Ausgabe hinzu. Die gewählte Stufe entscheidet daher direkt über die Rechnung.
Auswirkungen auf die Arbeitsteilung zwischen Modellen
Mit der Veröffentlichung von Hydrogen wird das Schichtenmodell „Orchestrator + Executor“ weiter gestärkt. Offizielle Daten von Orchestrator zeigen: Wenn ein günstiges Modell die Ausführung und ein teures Modell die Planung übernimmt, lässt sich bei nahezu gleicher Erfolgsquote Budget sparen. Das bedeutet, dass Multi-Modell-Orchestrierung vom experimentellen Ansatz zur offiziell vom Anbieter empfohlenen Praxis wird. Eine einheitliche Zugriffsschicht, über die sich mehrere Modelle wechseln lassen, wird dadurch ebenfalls immer wichtiger.
Bekannte Einschränkungen von Gemini 4 Hydrogen
Ohne die Schwächen zu beschönigen: Das Model Card nennt unter anderem folgende Einschränkungen:
- Das Modell kann weiterhin halluzinieren, langsamer werden oder Timeouts bekommen. Höhere Thinking-Stufen können mehr Tokens verbrauchen. Der Wissensstand endet im März 2026.
- In der automatisierten Sicherheitsbewertung verschlechtern sich zwei Werte gegenüber 3.8 Flash: Der Ablehnungston liegt bei -0,65 Prozentpunkten; der Anteil der Fälle, in denen das Modell ablehnt, obwohl es nicht ablehnen sollte, stieg um 5,57 Prozentpunkte (bei diesem Wert ist niedriger besser).
- Bei Frontier-Safety gibt es gegenüber Argon keinen materiellen Fähigkeitssprung. Weder bei CBRN noch bei Cybersicherheit wird CCL erreicht, aber die Warnschwelle wurde erreicht. Das heißt nicht, dass keine entsprechenden Risiken bestehen. Der vollständige Sicherheitsbericht soll laut offiziellen Angaben später veröffentlicht werden.
Es gibt aber auch positive Zahlen: Out-of-Bounds-Verhalten von Agenten wurde um bis zu 81 % reduziert, die interne Honesty-Evaluierung ergab 96,7 %, der Widerstand gegen indirekte Prompt-Injection bei Gray Swan stieg um mehr als das 2,3-Fache, und die False-Refusal-Rate bei HealthBench Pro liegt unter 0,4 %. Auch diese Werte stammen aus offiziellen Angaben.
Häufige Fragen (FAQ)
F1: Was ist das Modell Gemini 4 Hydrogen?
Es ist ein Mitglied der Gemini-4-Familie, die Google am 2026-11-12 veröffentlicht hat. Die Modell-ID lautet `gemini-4-hydrogen`. Es wurde aus Gemini 4 Carbon abgeleitet und ist als schnelleres Modell für alltägliches Coding und Agent-Ausführung positioniert. Die schwierigsten Aufgaben im Long-Range-Reasoning übernehmen Carbon und Argon.
F2: Wer ist stärker – Gemini 4 Hydrogen oder Claude Sonnet 5.5?
Laut der offiziellen Modellkarte mit 10 Punkten gewinnt Hydrogen 7 Punkte, Sonnet 5.5 gewinnt 3 Punkte. Sonnets Vorteile konzentrieren sich auf Terminal-Aufgaben, Computer-Bedienung und Scientific Terminal. Die Werte der Wettbewerber stammen aus den jeweils öffentlich veröffentlichten Ergebnissen der höchsten Denkstufe und nicht aus einem erneuten Durchlauf mit demselben Skript. Wir empfehlen, über APIYI apiyi.com eigene Vergleichstests mit den eigenen Aufgaben durchzuführen.
F3: Sind die „10 Punkte, 7 gewonnen“ von Dritten gemessen?
Nein. Das ist die offizielle Zusammenfassung von der DeepMind-Modellkarte; Hydrogen nutzt dabei die höchste Denkstufe und pass@1 bei einem einzigen Versuch. Es ist auch kein Nachtest von APIYI und sollte als offizielle, selbst gemeldete Angabe betrachtet werden.
F4: Für welche Szenarien eignet sich Gemini 4 Hydrogen?
Zu den Szenarien mit guten offiziellen Ergebnissen gehören: mehrstufige automatisierte Workflows (AutomationBench-AA), Diagrammverständnis (Chartography), multimodale Wissens-Agents (MKA) sowie die Rolle als Worker oder Verifier in Multi-Modell-Pipelines. Bei Kommandozeilen-Agents und Desktop-Bedienung empfehlen wir, Sonnet 5.5 ebenfalls zu bewerten.
F5: Kann man Gemini 4 Hydrogen jetzt schon über APIYI aufrufen?
Stand 2026-11-13 ist das Modell noch nicht gelistet. Wir werden es so bald wie möglich aufnehmen; Modellbezeichnung und Preis richten sich nach der Modellliste der Plattform. Derzeit lassen sich über APIYI apiyi.com `gemini-4-carbon`, `claude-sonnet-5-5` und `gpt-6.1-terra` aufrufen. Verwenden Sie für `base_url` den Wert `https://api.apiyi.com/v1` und bauen Sie zuerst den Vergleichsablauf auf.
F6: Warum kann die Ausgabe von Gemini 4 Hydrogen teurer ausfallen als erwartet?
Der offizielle Ausgabepreis von $7.50 gilt für Antwort und Reasoning zusammen, und die standardmäßige Denkstufe ist high – Denk-Tokens fließen also in die Ausgaberechnung ein. Bei einfachen Aufgaben lässt sich zur Kostensenkung auf die Stufe low oder medium umschalten.
Gemini 4 Hydrogen – die wichtigsten Punkte
- Klare Positionierung: Veröffentlichung am 12.11.2026, Fokus auf alltägliches Coding und Agent-Ausführung, aus Carbon weiterentwickelt.
- In der offiziellen 10-Punkte-Tabelle 7 Siege: Sonnet 5.5 gewinnt die drei Kategorien Terminal, Computerbedienung und wissenschaftliches Terminal; Terra erreicht keinen ersten Platz.
- Bezugsrahmen beachten: Die Werte sind offiziell selbst gemeldet; bei den Wettbewerbern wird jeweils die öffentlich verfügbare höchste Denkstufe verwendet – es ist kein erneuter Lauf mit identischem Skript.
- Deutlicher Sprung gegenüber 3.8 Flash: 2,5-mal so schnell; Terminal-Bench 4.1 von 18,2 % auf 57 %.
- Preis der Standardstufe: global Input $1.50, Output $7.50; der Output enthält Denk-Tokens.
- Zwei Angaben zum Kontextfenster: Die Modellkarte nennt insgesamt 1 Million; der Blog nennt 1 Million Input und maximal 1 Million Output.
- Aktueller Modellaufruf-Status: Bei APIYI noch nicht gelistet; für einen Vergleich können Sie auf apiyi.com zunächst Carbon, Sonnet und Terra nutzen.
Zusammenfassung
Die wichtigsten Punkte zu Gemini 4 Hydrogen:
- Stark bei der Agent-Ausführung: In der offiziellen 10-Punkte-Tabelle gewinnt es 7 Kategorien; bei Automatisierung, Agent-Tests, Diagrammen und HLE-Diamond liegt es vorn.
- Schwach bei Terminal und Computerbedienung: In den drei Kategorien Terminal-Bench 4.1, OSWorld-2.1 und wissenschaftliches Terminal liegt es hinter Claude Sonnet 5.5.
- Zahlen mit dem richtigen Bezugsrahmen lesen: Alle Werte sind offiziell selbst gemeldet oder aus Modellkarten zusammengefasst; die Werte der Wettbewerber stammen aus öffentlichen Ergebnissen und nicht aus einem gemeinsamen erneuten Lauf.
Wenn Sie an Agent-Workflows arbeiten, gehört Hydrogen auf die Kandidatenliste – besonders als Ausführungsschicht in Multi-Modell-Workflows. Die endgültige Bewertung sollte sich jedoch an den Ergebnissen Ihrer eigenen Aufgaben orientieren. Empfehlung: Erstellen Sie über APIYI auf apiyi.com zunächst mit den vorhandenen Carbon, Sonnet 5.5 und Terra eine Baseline; sobald Hydrogen gelistet ist, können Sie direkt nachtesten.
📚 Referenzen
- Google Blog: Introducing Gemini 4 Hydrogen: Ankündigung und Positionierung
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
Beschreibung: Offizielle Positionierung, AA Index, Verbesserungen gegenüber 3.8 Flash
-
Google Developer-Newsletter: Build with Gemini 4 Hydrogen: Informationen zum Entwicklerzugang
- Link:
blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-hydrogen -
Beschreibung: Verfügbare Kanäle und Hinweise für Entwickler
-
DeepMind-Modellkarte: Gemini 4 Hydrogen: Spezifikationen, 10-Punkte-Vergleichstabelle, Sicherheitsbewertung
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen -
Beschreibung: Hauptquelle für die 10-Punkte-Tabelle und die Einschränkungen in diesem Artikel
-
DeepMind-Bewertungsmethodik: Methodische Grundlage der Vergleichstabelle
- Link:
deepmind.google/models/evals-methodology/gemini-4-hydrogen -
Beschreibung: Thinking-Stufen, pass@1, Quellen der Vergleichswerte
-
Google Cloud-Preisseite: Preise für die Standardstufe
- Link:
cloud.google.com/vertex-ai/generative-ai/pricing - Beschreibung: Preise pro Einheit für globale und nicht-globale Standardstufen, Inkrafttreten der Cache-Schreibgebühren
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com