Ein Laptop fährt hoch. Auf dem Bildschirm erscheint weder Windows noch eine Linux-Distribution, sondern ein Betriebssystem, das eine KI von einem leeren Ordner aus aufgebaut hat. Am 9. November 2026 gab Anthropic beim Release von Claude Fable 5.2 dieses interne Experiment bekannt: Fable 5.2 koordinierte mehr als 1.000 Sub-Agents, arbeitete acht Tage am Stück und entwickelte einen Betriebssystem-Prototyp, der auf einem echten Laptop startet.
Kernnutzen: Anhand des Betriebssystem-Experiments zeigt dieser Artikel, worin der eigentliche Durchbruch von Claude Fable 5.2 liegt, wie die 1.000 KI-Agents zu verstehen sind und wie weit der Prototyp noch von einem ausgereiften Produkt entfernt ist. Zum Schluss geht es aus Entwicklersicht darum, welche Anforderungen Workflows mit langfristig arbeitenden Agents an die API-Infrastruktur stellen.
Zentrale Informationen zum Betriebssystemexperiment mit Claude Fable 5.2
Zunächst ein Blick auf die offiziell bestätigten Fakten. Die folgende Tabelle enthält nur Angaben, die Anthropic in seiner Ankündigung bestätigt hat.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 9. November 2026, zusammen mit der Veröffentlichung von Claude Fable 5.2 bekannt gegeben |
| Herausgeber | Anthropic (internes Engineering-Experiment) |
| Ausgangspunkt der Aufgabe | Ein Ingenieur stellte die Aufgabe, ausgehend von einem leeren Ordner ein Prototyp-Betriebssystem zu entwerfen und umzusetzen |
| Umfang der Ausführung | Mehr als 1.000 Subagenten arbeiteten acht Tage lang rund um die Uhr |
| Hauptaktivitäten | Code schreiben, Komponenten testen, Code prüfen und Probleme beheben |
| Ergebnis | Kernel, Treiber für Festplatten, Tastaturen und Netzwerke, dauerhafte Dateispeicherung, Fenstersystem, Anmeldebildschirm, Installationsprogramm und integrierte Claude-Funktionen |
| Wichtiger Nachweis | Das System konnte auf einem echten Laptop gestartet werden (Boot) |
| Noch nicht veröffentlicht | Quellcode und Build-Prozess, Architekturunterlagen, Anzahl der Codezeilen, Kommunikationsarchitektur der Agenten, Token-Verbrauch, Kosten des Experiments, Kompatibilitätstests mit unterschiedlicher Hardware und unabhängiges Sicherheitsaudit |
Welche Module umfasst das von 1.000 KI-Agenten entwickelte Betriebssystem?
Einige wichtige Module und ihre Aufgaben im Überblick: Der Kernel ist die zentrale Software zur Verwaltung von Hardware und Systemressourcen. Er plant Prozesse, weist Speicher zu und verarbeitet Unterbrechungen. Treiber ermöglichen dem Betriebssystem die Kommunikation mit Hardware wie Festplatten, Tastaturen und Netzwerkkarten. Ohne Treiber kann der Kernel die Peripheriegeräte nicht „sehen“.
Dauerhafte Dateispeicherung bedeutet, dass Daten auch nach einem Neustart erhalten bleiben. Dafür braucht das System ein echtes Dateisystem – und darf nicht bloß eine Demonstration ausführen, die nur im Arbeitsspeicher läuft.
Fenstersystem, Anmeldebildschirm und Installationsprogramm sind dagegen direkt für die Nutzer sichtbar. Besonders der Installationsschritt ist interessant: Er zeigt, dass das System zumindest den vollständigen Ablauf vom Schreiben auf die Festplatte bis zum Starten von dort durchlaufen hat.
Erst das Zusammenspiel dieser Module macht deutlich, warum der erfolgreiche Start auf einem Laptop ein beachtliches Ergebnis ist. Dafür müssen mehrere Subsysteme tatsächlich miteinander verbunden sein – es reicht nicht, wenn jedes für sich ein paar plausibel wirkende Codezeilen hervorbringt.
Damit sind wir bei der Kernfrage dieses Artikels: Wie haben mehr als 1.000 Agenten zusammengearbeitet, um ein vollständiges technisches System zu entwickeln?
Der Durchbruch von Claude Fable 5.2: KI beginnt, Engineering zu organisieren
Fable 5.2 hat sich bei Programmier-Benchmarks deutlich verbessert. Anthropic veröffentlichte für FrontierCode 2.0 ein Ergebnis von 49,1 Prozent; der Vorgänger Fable 5.1 erreichte 32,4 Prozent. Bei FrontierSWE v2 lag das Ergebnis bei 69,9 Prozent, gegenüber 56,3 Prozent beim Vorgänger.
Dabei handelt es sich allerdings um allgemeine Programmier-Benchmarks, nicht um Testergebnisse des Betriebssystem-Experiments selbst. Das eigentlich Interessante an diesem Experiment ist nicht, wie gut der Code geschrieben wurde, sondern dass sich die Organisation des Engineerings verändert hat.
Der Unterschied zwischen herkömmlichen KI-Programmierassistenten und langfristigem Agent-Engineering
Herkömmliche KI-Programmierassistenten arbeiten nach dem Muster „Frage und Antwort“: Der Nutzer formuliert eine Anforderung, die KI schreibt einen Codeabschnitt, der Nutzer prüft ihn und bittet anschließend um Änderungen. Dieser Ablauf wiederholt sich. In diesem Modell übernimmt der Mensch die Aufgabenzerlegung, das Fortschrittsmanagement und die Integration des Ganzen. Die KI ist lediglich ein sehr effizienter Ausführender.
Beim langfristigen Agent-Engineering werden mehr Aufgaben an das Modell übertragen. Die folgende Tabelle zeigt die Unterschiede zwischen den beiden Ansätzen:
| Dimension | Herkömmlicher KI-Programmierassistent | Langfristiges Agent-Engineering |
|---|---|---|
| Aufgabenumfang | Einzelne Funktion, Datei oder Funktionalität | Vollständiges Projekt, das selbstständig in Teilaufgaben zerlegt werden muss |
| Laufzeit | Ein Gespräch, von wenigen Minuten bis zu einigen Stunden | Durchgehend mehrere Stunden bis mehrere Tage |
| Ausführung | Einzelner Ablauf, wartet auf menschliches Feedback | Mehrere Subagenten bearbeiten verschiedene Module parallel |
| Qualitätssicherung | Vorwiegend manuelle Prüfung | Automatisierte Tests, gegenseitige Prüfung und Beauftragung von Korrekturen bei Problemen |
| Integration | Wird vom Menschen erledigt | Ein Koordinator führt die Ergebnisse zusammen und prüft die Kompatibilität der Module |
| Rolle des Menschen | Schrittweise Anweisungen geben | Ziele festlegen, den Prozess überwachen und das Ergebnis abschließend abnehmen |
Bei einem Projekt wie einem Betriebssystem liegt die Herausforderung in der rechten Spalte. Zwischen Kernel, Treibern und Dateisystem gibt es zahlreiche Schnittstellenvereinbarungen. Änderungen an einem Modul können dazu führen, dass die Tests eines anderen Moduls fehlschlagen.
Acht Tage lang Probleme zu erkennen, Korrekturen zu veranlassen und an offenen Aufgaben weiterzuarbeiten, zeigt Projektmanagement-Fähigkeiten – und nicht nur die Fähigkeit, Code zu schreiben.
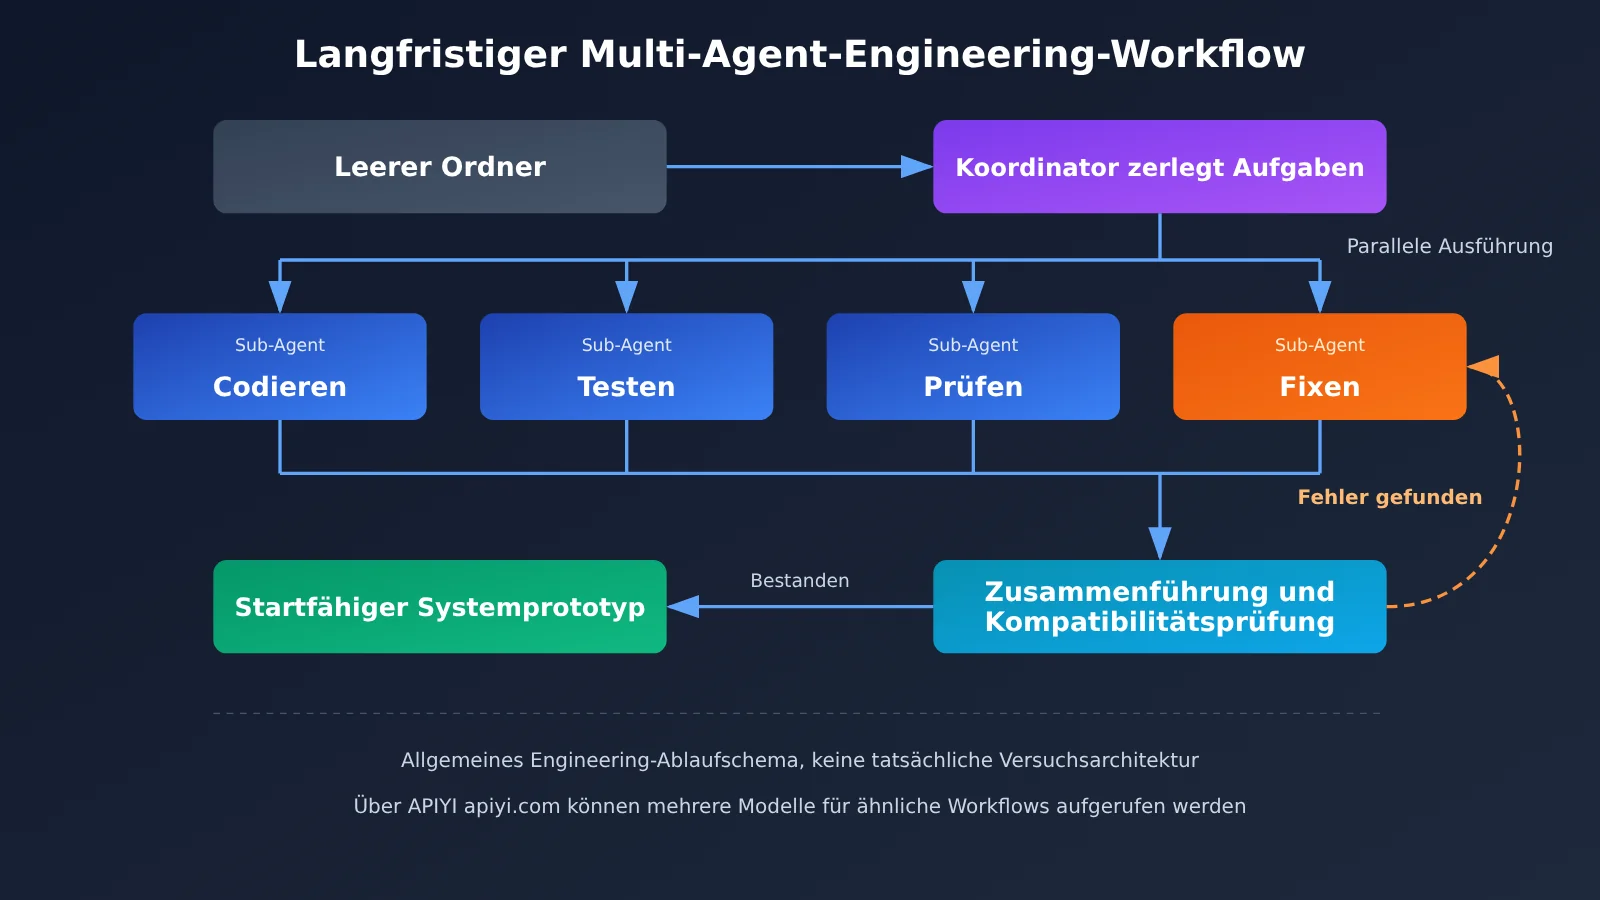
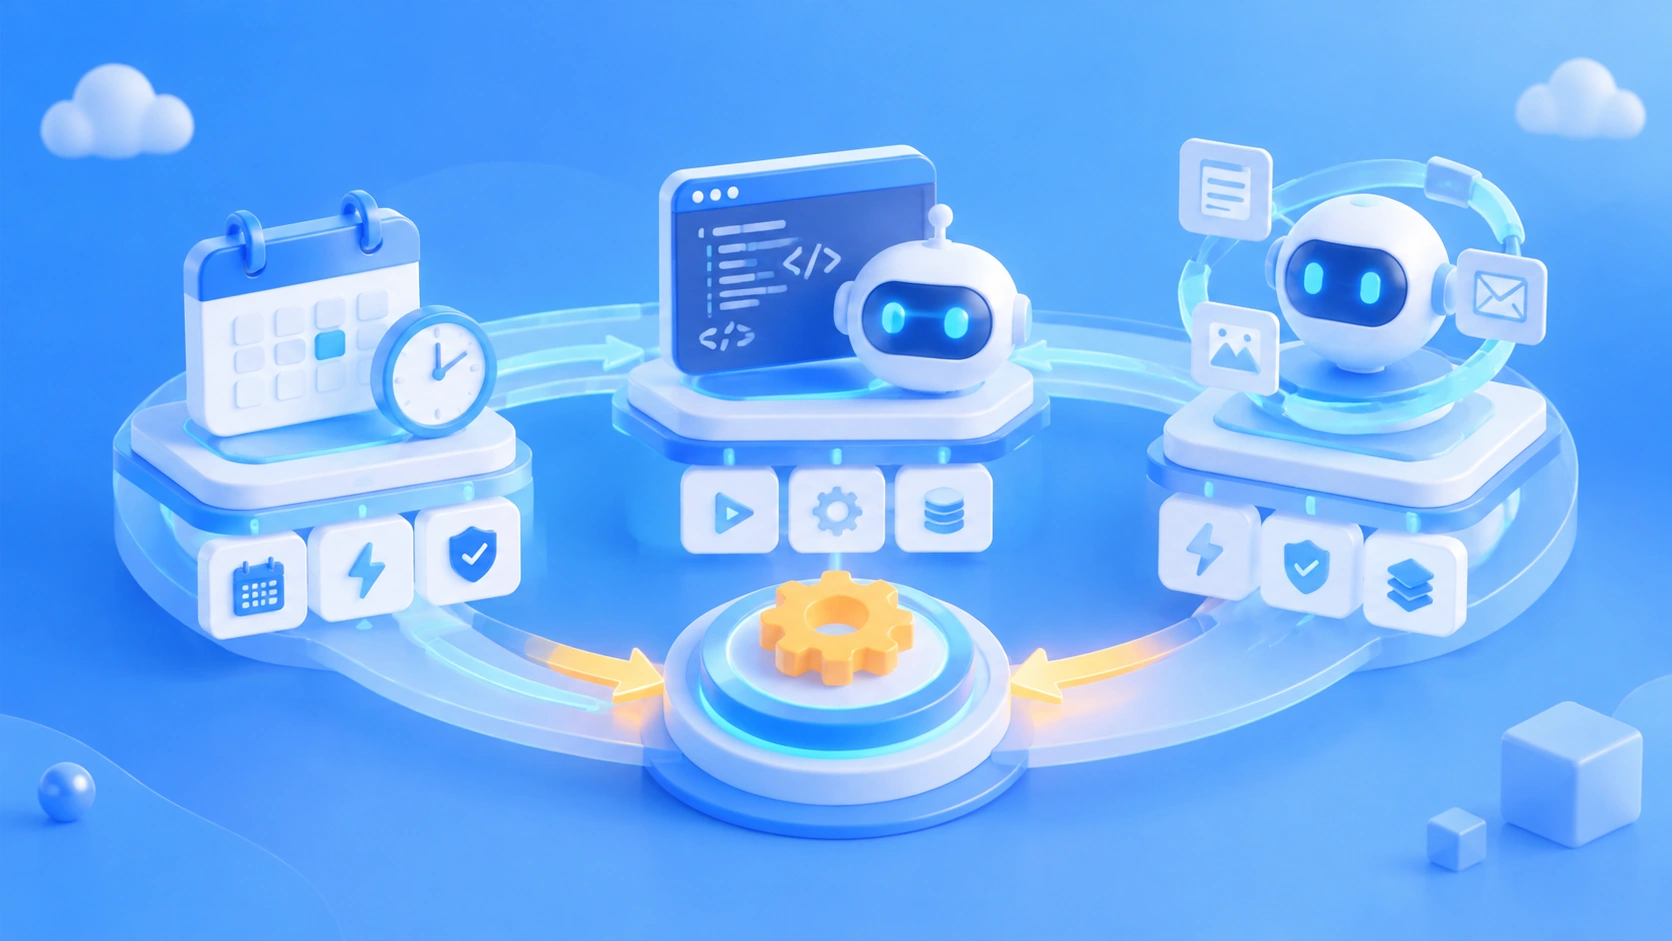
Zur Einordnung: Die obige Grafik analysiert einen allgemeinen Ablauf für umfangreiche Engineering-Projekte. Anthropic hat weder die konkrete Aufgabenverteilung im Betriebssystem-Experiment noch Harness, Kommunikationsprotokolle oder Programmiersprachen offengelegt.
Bei einem anderen Experiment zum Großen Satz von Fermat wurden zeitgleich Details zur Architektur veröffentlicht, darunter „1 Lead + 999 Helper“. Dabei handelte es sich jedoch um ein unabhängiges Experiment, dessen Architektur sich nicht ohne Weiteres auf das Betriebssystem-Projekt übertragen lässt.
Die Rolle des „Koordinators“ aus Sicht der frühen Unternehmenstester
Anthropic veröffentlichte zum Start Rückmeldungen von mehreren frühen Testpartnern. Dabei handelt es sich um praktische Erfahrungen von Unternehmensingenieuren, nicht um unabhängige Blindtests. Sie weisen jedoch alle in dieselbe Richtung: Das Modell übernimmt zunehmend Planungs- und Koordinationsaufgaben.
- Vercel: Joe Haddad (Member of Technical Staff) berichtete, dass ein Projekt, für das man mit anderen Modellen zuvor mehrere Wochen gebraucht hätte, mit Fable 5.2 in wenigen Tagen abgeschlossen und vom Team geprüft worden sei. Die Code-Reviewer hätten zudem weniger Änderungen anfordern müssen.
- Shopify: Tom Pritchard (Staff Engineer) zufolge kann das Modell eine grobe Idee aufnehmen, sie in mehreren Gesprächsrunden zu einem Konzept ausarbeiten und die anschließenden Aufgaben selbstständig erledigen. Die Zusammenarbeit fühle sich an, als würde man mit einem anderen Staff Engineer arbeiten.
- Datadog: Matt Lee (Senior Staff Engineer) verglich das Modell mit einem Incident Commander: Bei einem unbekannten System rufe es ein schnelleres Modell auf, um Informationen zu sammeln, und koordiniere anschließend verschiedene Aufgaben. So werde der menschliche Operator von Koordinationsaufgaben entlastet.
- Uber: Andrew Mager (Staff Engineer, Agentic Systems) berichtete von einem Sicherheits-Audit, das 10 bis 12 Stunden am Stück lief. Das Modell setzte etwa 170 Prüf-Agenten ein und lieferte schließlich einen Auditbericht, Pull Requests mit Korrekturen und einen Vorschlag für eine Richtlinie. Besonders hob er hervor, dass das Modell so lange weiterarbeite, bis die Aufgabe tatsächlich abgeschlossen sei – statt bei einem plausibel wirkenden Zwischenergebnis aufzuhören.
Der Fall von Uber ähnelt dem Betriebssystem-Experiment in seiner Vorgehensweise am meisten: In beiden Fällen setzt ein Modell zahlreiche Sub-Agenten für eine längere Aufgabe ein. Die beiden Projekte sind jedoch vollständig unabhängig voneinander.
Claude Fable 5.2 ist im produktiven Einsatz
Wäre nur das Betriebssystem-Experiment bekannt, könnte man es für eine sorgfältig vorbereitete Demo halten. Zwei weitere Datensätze aus dem Unternehmen, die Anthropic gleichzeitig veröffentlichte, zeigen jedoch, dass diese technischen Fähigkeiten bereits im Softwarealltag zum Einsatz kommen.
Der erste betrifft den Anteil an der Codeproduktion. Anthropic zufolge wurden mehr als 90 % der letztlich zusammengeführten Codeänderungen in der zentralen Codebasis des Unternehmens von Claude geschrieben – unter menschlicher Anleitung. Diese Zahl bezieht sich auf den Anteil der zusammengeführten Änderungen, die Claude verfasst hat. Sie bedeutet weder, dass 90 % der Entwicklungsarbeit ohne Beteiligung von Menschen stattfanden, noch, dass der gesamte Code von Fable 5.2 stammt.
Der zweite Datensatz betrifft die Migration eines produktiven Dienstes. Ein Agententeam, das eine frühe Version von Fable 5.2 nutzte, migrierte einen wichtigen Produktionsdienst von Python zu Rust. Danach verbesserten sich Effizienz und Zuverlässigkeit des Dienstes; der Startvorgang war etwa 26-mal schneller. Eine Sprachmigration ist ein typisches Beispiel für eine langwierige Aufgabe, die wiederholte Überprüfungen erfordert. Um sicherzustellen, dass sich das Programm weiterhin gleich verhält, ist Testen und Fehlerbeheben oft aufwendiger als die eigentliche Übersetzung.
Die folgenden Beispiele sind unterschiedlicher Natur. Die Tabelle ordnet sie ein:
| Beispiel | Art | Quelle der Belege | Was es zeigt | Was es nicht zeigt |
|---|---|---|---|---|
| Betriebssystem-Prototyp | Internes Experiment bei Anthropic | Offizielle Ankündigung und Demo | Das Modell kann ein umfangreiches, mehrmoduliges Entwicklungsprojekt über längere Zeit koordinieren | Dass es bereits das Niveau eines kommerziellen Betriebssystems erreicht hat oder von Dritten reproduziert wurde |
| 90 % der zusammengeführten Codeänderungen von Claude geschrieben | Interne Produktionsdaten | Offizielle Ankündigung | KI ist bereits tief in die tägliche Codeproduktion eingebunden | Dass der Code keine menschliche Prüfung benötigt |
| Migration von Python zu Rust | Interner Anwendungsfall aus der Produktion | Offizielle Ankündigung | Agenten können zur Optimierung realer Infrastruktur eingesetzt werden | Dass dabei dieselbe Methode wie beim Betriebssystem-Experiment zum Einsatz kam |
| Rückmeldungen von Vercel / Shopify / Datadog / Uber | Erfahrungen früher Tester | In der offiziellen Ankündigung zitierte Aussagen | Ingenieurinnen und Ingenieure in Unternehmen erleben die Koordinationsfähigkeit im Arbeitsalltag | Dass sie unabhängige Benchmarks ersetzen |
Zusammengenommen zeigen diese Beispiele, wie sich die technischen Möglichkeiten zur Ausführung von Entwicklungsaufgaben erweitern. Das bedeutet jedoch nicht, dass sich alle Aufgaben ohne Aufsicht erledigen lassen.
Was bedeuten 1000 KI-Agenten wirklich?
„1000 Agenten“ ist die auffälligste Zahl dieses Experiments – und zugleich diejenige, die am leichtesten missverstanden wird.
Die Gesamtzahl der Agenten entspricht nicht der Zahl der gleichzeitig laufenden Agenten
Anthropic teilte zunächst mit, dass „mehr als 1000 Subagenten beteiligt“ waren. Ob sie gleichzeitig liefen, wurde nicht angegeben. Innerhalb des achttägigen Zeitraums wurden die Subagenten wahrscheinlich nach und nach gestartet: Sie erledigten ihre Aufgaben, wurden beendet und anschließend durch neue Agenten ersetzt.
1000 Agenten sind außerdem nicht gleichbedeutend mit 1000 gleich kompetenten, völlig unabhängig arbeitenden Ingenieuren. Die tatsächliche Effizienz hängt gemeinsam davon ab, wie gut sich Aufgaben parallelisieren lassen, wie hoch der Koordinationsaufwand ist, wie der gemeinsame Zustand verwaltet wird, ob es zu Codekonflikten kommt, wie gut die Tests abdecken und welche Kosten die Aufrufe verursachen.
Ein anschauliches Beispiel: Solange die Speicherverwaltung des Kernels noch nicht feststeht, lassen sich Dateisystem und Treiber kaum wirklich voranbringen. Solche Abhängigkeiten machen deutlich, dass sich große Engineering-Projekte nicht beliebig in parallele Aufgaben zerlegen lassen.
Zwei Orchestrierungsmodi in den öffentlich dokumentierten Managed Agents
Die Managed-Agents-Dokumentation von Anthropic für Entwickler bietet einen Einblick in produktiv eingesetzte Multi-Agenten-Systeme. Sie beschreibt zwei Orchestrierungsmodi.
Subagent-Modus: Der Haupt-Agent kann Subagenten erstellen. Jeder Subagent verfügt über einen eigenen Session Thread und einen eigenen Kontexthistorie. Der Haupt-Agent kann ihnen weitere Aufgaben zuweisen. In einer einzelnen Session können gleichzeitig höchstens 25 direkte untergeordnete Threads existieren. Die direkte Delegation ist auf eine Ebene beschränkt.
Dynamic-Workflow-Modus: Dieser Modus ist für größere Aufgaben gedacht. Zunächst schreibt der Haupt-Agent ein Workflow-Programm. Dieses erstellt mehrere Agenten, die parallel arbeiten, fasst die Ergebnisse der einzelnen Phasen zusammen und legt anhand der Ergebnisse der vorherigen Phase die nächsten Schritte fest. Fehlgeschlagene Agenten werden vom Server üblicherweise einmal in einem neuen Thread erneut gestartet. Die offizielle Dokumentation nennt folgende Einschränkungen:
| Kennzahl | Offizielle Einschränkung |
|---|---|
| Gleichzeitig laufende Threads pro Workflow | 64 (konfigurierbare Obergrenze des Produkts, deren Erreichen offiziell nicht garantiert wird) |
| Im Lebenszyklus eines Workflows gestartete Agenten | 1000 |
| Standardmäßige Lebensdauer eines Workflows | 24 Stunden |
| Gleichzeitig geöffnete Workflows pro Session (Standard) | 10 |
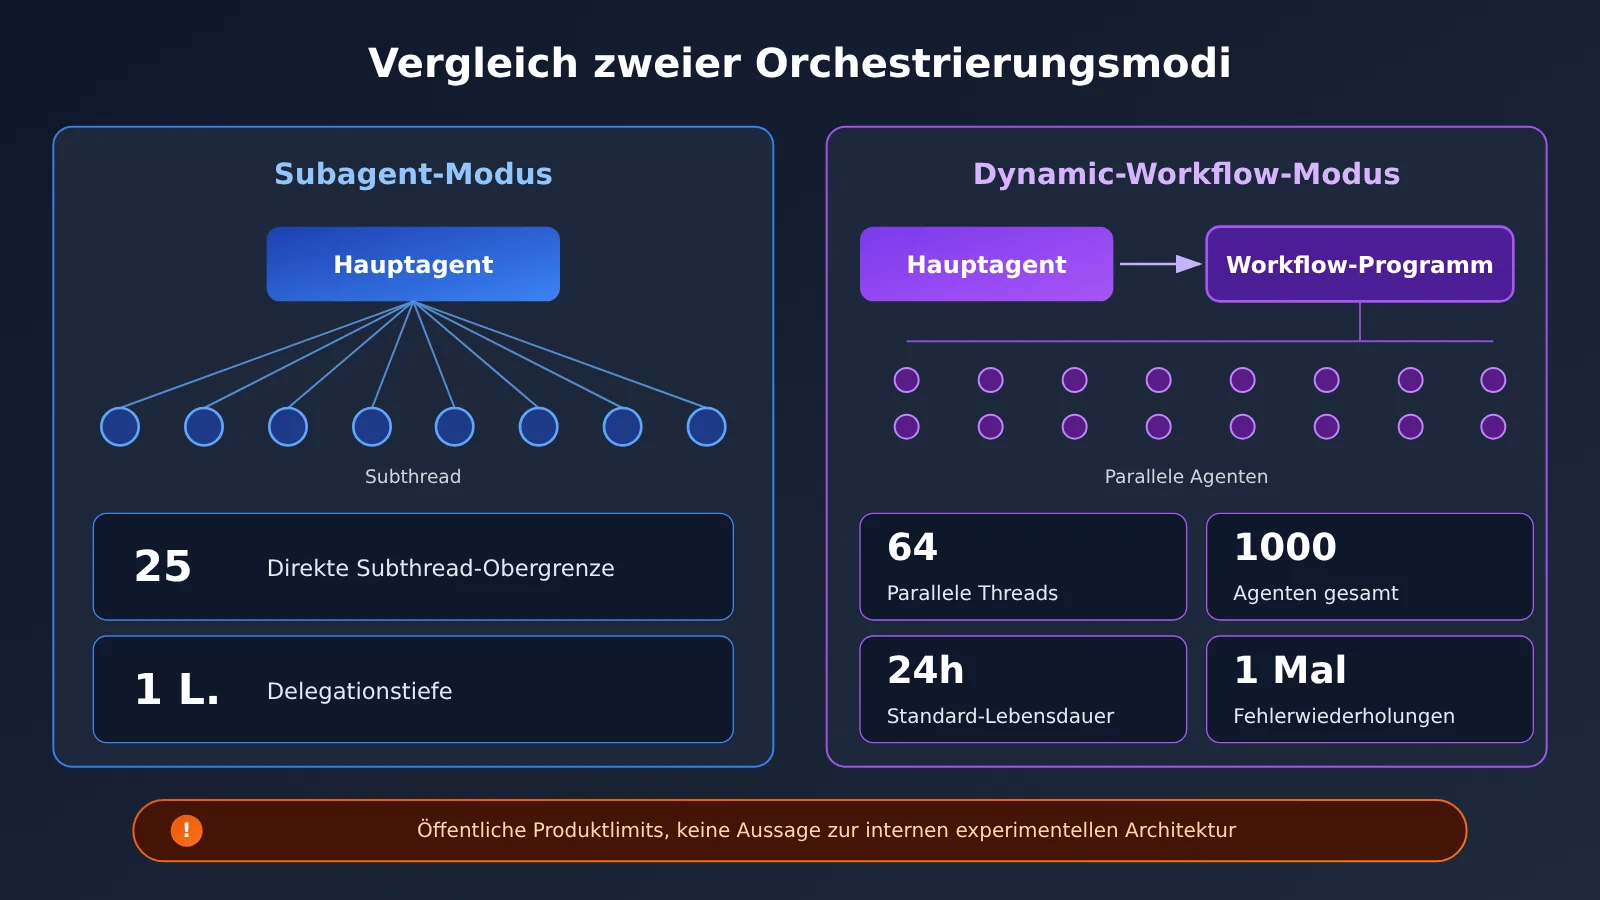
Wichtig ist: Das Betriebssystem-Experiment war ein internes Engineering-Experiment von Anthropic, die öffentlich verfügbaren Managed Agents sind dagegen ein Produkt. Daraus lässt sich weder schließen, dass das Experiment mit Managed Agents durchgeführt wurde, noch lässt sich die Parallelitätsgrenze von 64 Threads auf das Experiment übertragen. Die Zahlen verdeutlichen jedoch eines: Die Orchestrierung großer Agentengruppen hängt nicht allein vom Modell ab. Dafür braucht es auch einen Scheduler, eine Verwaltung des Aufgabenstatus, Parallelitätskontrolle, Wiederholungsmechanismen und ein Budgets, das die Ausgaben im Blick behält. Hinter der Zahl „1000“ ist die Infrastruktur ebenso wichtig wie das Modell.
Die Grenzen des Betriebssystemprototyps Claude Fable 5.2
„Es lässt sich starten“ ist ein bedeutender Meilenstein. Bis zu „für den produktiven Einsatz geeignet“ ist es jedoch noch ein weiter Weg. Hinter ausgereiften Betriebssystemen wie Windows, Linux und macOS stehen Jahrzehnte der Hardwareanpassung, Sicherheitsverbesserungen und Community-Pflege.
| Technische Anforderung | Startfähiger Prototyp (bisher bekannt) | Ausgereiftes kommerzielles Betriebssystem |
|---|---|---|
| Hardwarekompatibilität | Start auf einem echten Laptop | Unterstützung zahlreicher Kombinationen aus Chips, Peripheriegeräten und Firmware |
| Sicherheit | Kein unabhängiges Sicherheitsaudit durch Dritte bekannt | Laufende Reaktion auf Sicherheitslücken, Berechtigungstrennung und Patch-Mechanismen |
| Langfristige Zuverlässigkeit | Keine Tests mit langen Laufzeiten bekannt | Über lange Zeit und von sehr vielen Nutzern erprobt |
| Systempflege | Quellcode und Build-Prozess nicht veröffentlicht | Versionsverwaltung, Release-Zyklen und langfristiger Support |
| Codeprüfung | Zahl der Codezeilen und Architekturdokumentation nicht veröffentlicht | Prüfbarer Code und umfassende Architekturdokumentation |
| Reproduzierbarkeit | Noch keine unabhängige Reproduktion durch Dritte | Öffentlicher und reproduzierbarer Build-Prozess |
Diese Tabelle soll das Experiment nicht abwerten, sondern verdeutlichen, was es tatsächlich belegt. Das Experiment zeigt, dass ein Modell über einen längeren Zeitraum ein Softwareprojekt mit mehreren Modulen organisieren und ein Ergebnis liefern kann, dessen Teilsysteme tatsächlich miteinander verbunden sind. Es belegt nicht, dass ein von KI geschriebenes Betriebssystem bestehende Produkte direkt ersetzen kann.
Menschliche Ingenieure bleiben bei solchen Projekten entscheidend. Die Verantwortung für die Zielsetzung, Architekturentscheidungen, Sicherheitsgrenzen und die abschließende Abnahme liegt weiterhin bei Menschen. Auch Anthropic formuliert es zurückhaltend: 90 % des zusammengeführten Codes wurden von Claude geschrieben, aber „unter menschlicher Anleitung“.
Eine vorsichtige Schlussfolgerung lautet: KI hat bereits gezeigt, dass sie komplexe Softwareprojekte organisieren kann. Das bedeutet jedoch nicht, dass ausgereifte Softwareentwicklungsteams künftig auf Menschen verzichten können.
Auswirkungen von Claude Fable 5.2 auf Entwickler
Von einzelnen Aufrufen zu langfristigen Agent-Workflows
Die meisten Entwickler werden kurzfristig kein Betriebssystem entwickeln. Die Arbeitsweise, die dieses Experiment zeigt, dürfte jedoch nach und nach auch in alltägliche Projekte einfließen – etwa in die gebündelte Codeprüfung, Refactorings auf Repository-Ebene, Sprachmigrationen und Sicherheitsaudits.
Damit verschiebt sich der Fokus der Entwickler von der Frage „Wie gut ist die Antwort auf diesen Aufruf?“ hin zu stärker ingenieurtechnischen Themen:
- Aufgabenverwaltung: Wie lassen sich Aufgaben aufteilen und die Status jedes Teilauftrags festhalten? Kann die Arbeit nach einem Fehler an der Abbruchstelle fortgesetzt werden?
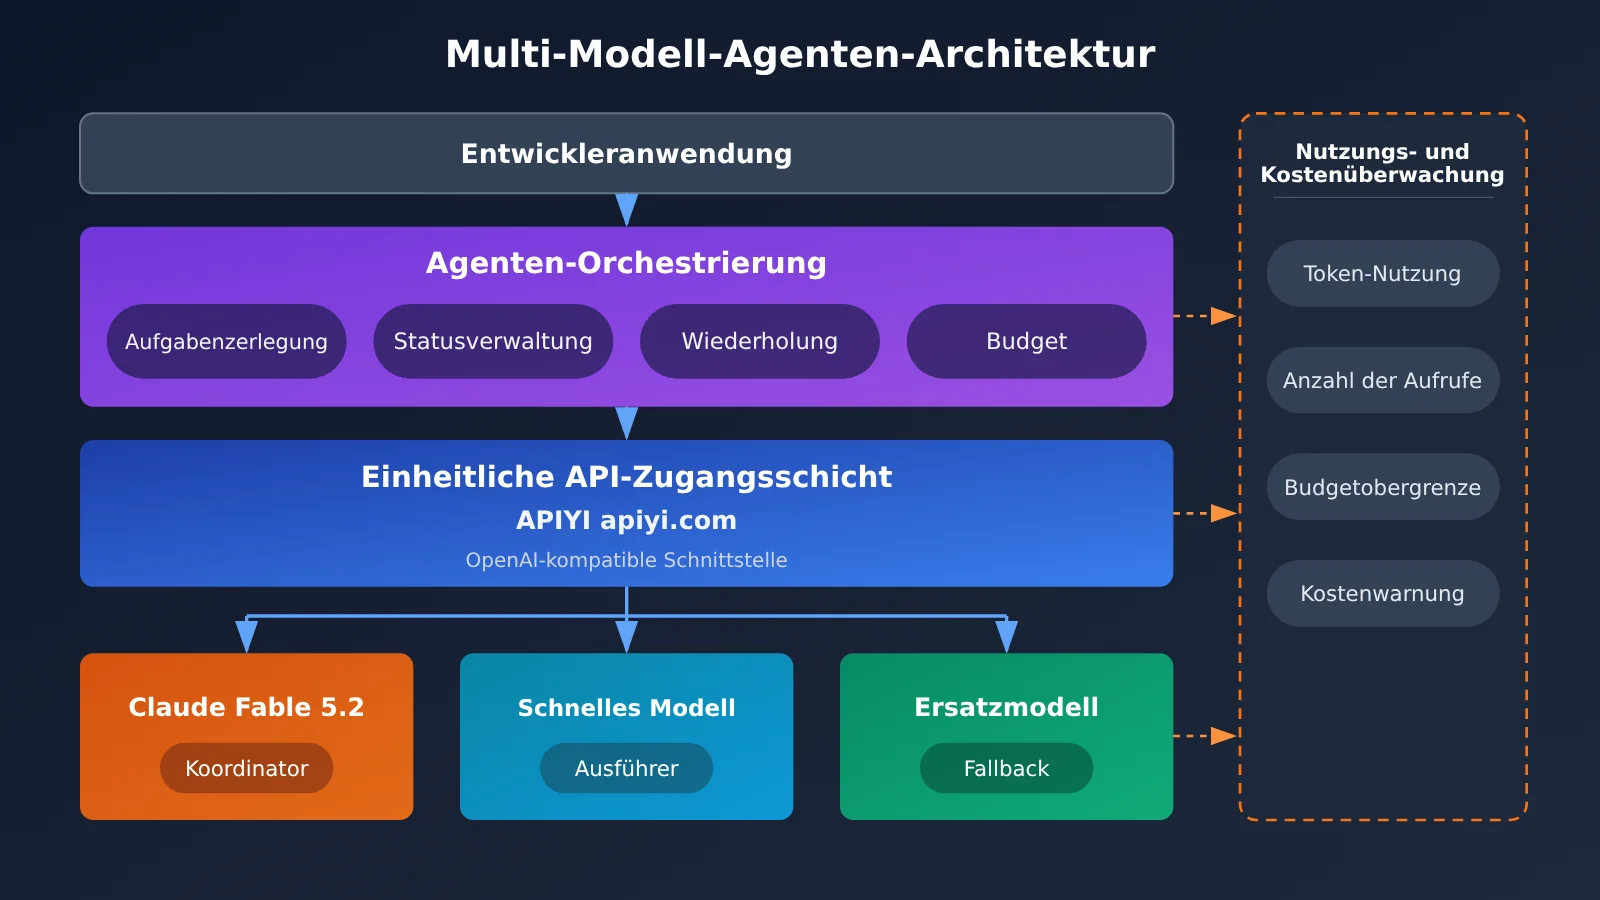
- Aufgabenteilung zwischen mehreren Modellen: Im Datadog-Beispiel ruft Fable 5.2 ein „schnelleres Modell“ ab, um Informationen zu sammeln. Ein leistungsstarkes Modell als Koordinator und schnellere oder günstigere Modelle für die Ausführung einzusetzen, ist eine gängige Kostenstruktur.
- Zuverlässigkeit der Aufrufe: Ein Workflow kann Hunderte oder Tausende Aufrufe umfassen. Selbst eine niedrige Ausfallrate pro Aufruf führt in der Summe zu häufigen Unterbrechungen. Deshalb sind Wiederholungsversuche und ein Failover erforderlich.
- Budgetkontrolle: Laut öffentlicher API-Preisliste kostet Fable 5.2 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token. Im Fast Mode verdoppeln sich die Preise. Anthropic hat die tatsächlichen Kosten des Betriebssystemexperiments nicht veröffentlicht. Es ist jedoch davon auszugehen, dass die Kosten langfristiger Aufgaben mit mehreren Agents kontinuierlich überwacht werden müssen.
- Aufgabenüberwachung: Es muss ersichtlich sein, woran jeder Agent arbeitet, wie viel er verbraucht und an welcher Stelle er feststeckt.
Am selben Tag gab Vercel bekannt, dass AI Gateway Fable 5.2 unterstützt. Der Dienst bietet Failover zwischen Anbietern, Fallback-Modelle, Nutzungs- und Kostenstatistiken sowie Regeln für Budgets und Wiederholungsversuche. Das ist ein weiteres Indiz dafür, dass sich die Infrastruktur für Modellaufrufe in komplexen Agent-Anwendungen gerade herausbildet.
So rufen Sie Claude Fable 5.2 über eine OpenAI-kompatible Schnittstelle auf
Die offizielle API-Modell-ID von Fable 5.2 lautet claude-fable-5-2. Das Modell unterstützt ein Kontextfenster mit 1M Token und eine maximale Ausgabe von 128K Token. Der einfachste Aufruf über eine OpenAI-kompatible Schnittstelle sieht so aus. (Den Modellnamen entnehmen Sie der Modellliste in der Plattformkonsole.)
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche API von APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
Vollständiges Beispiel anzeigen: Koordinator, parallele Ausführung sowie Wiederholungen und Budgetkontrolle
Das folgende vereinfachte Beispiel zeigt, wie ein Koordinator Aufgaben aufteilt und Ausführende sie parallel bearbeiten. Es umfasst Wiederholungsversuche bei Fehlern und eine grobe Kontrolle des Token-Budgets. Es veranschaulicht allgemeine Vorgehensweisen in der Softwareentwicklung und ist keine tatsächliche Umsetzung des Betriebssystem-Experiments von Anthropic.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche API von APIYI, mit der sich verschiedene Modellanbieter nutzen lassen
)

PLANNER_MODEL = "claude-fable-5-2"   # Koordinator: für Aufteilung und Zusammenfassung zuständig
WORKER_MODEL = "gpt-4o-mini"         # Ausführender: durch das tatsächlich verwendete schnelle Modell ersetzen
TOKEN_BUDGET = 200_000               # Token-Budget für den gesamten Workflow
MAX_WORKERS = 8                      # Maximale Anzahl paralleler Aufgaben, bei Bedarf anpassen
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 Tipp für den schnellen Einstieg: In Agent-Workflows mit mehreren Modellen stammen Koordinator und Ausführende oft von unterschiedlichen Anbietern. Über APIYI unter apiyi.com können Sie Claude, OpenAI, Gemini und weitere führende Modelle mit einem einzigen API-Schlüssel nutzen. Die Abrechnung erfolgt nach Verbrauch, und neue Nutzer erhalten ein kostenloses Testkontingent. So können Sie zunächst mit kleinen Aufgaben die Ablaufsteuerung und Kosten überprüfen.
Häufig gestellte Fragen (FAQ)
F1: Was wurde mit dem Betriebssystem-Experiment von Claude Fable 5.2 tatsächlich erreicht?
Anthropic zufolge startete Fable 5.2 mit einem leeren Ordner und koordinierte mehr als 1.000 Sub-Agenten, die acht Tage lang ununterbrochen arbeiteten. Das Ergebnis war ein Betriebssystem-Prototyp, der sich auf einem echten Laptop starten lässt. Er umfasst einen Kernel, Treiber für Festplatten, Tastaturen und Netzwerke, dauerhafte Dateispeicherung, ein Fenstersystem, eine Anmeldeoberfläche, ein Installationsprogramm und integrierte Claude-Funktionen.
F2: Waren die 1.000 KI-Agenten gleichzeitig aktiv?
Dazu gibt es keine offiziellen Angaben. „Mehr als 1.000 beteiligte Sub-Agenten“ bedeutet weder, dass 1.000 Agenten die ganze Zeit gleichzeitig liefen, noch, dass es sich um 1.000 unabhängige Entwickler handelte. Für einen einzelnen Workflow mit Managed Agents liegt die öffentlich angegebene Obergrenze bei 64 parallelen Threads und bis zu 1.000 gestarteten Agenten über die gesamte Laufzeit. Dabei handelt es sich jedoch um Produktbeschränkungen, die sich nicht auf das interne Experiment übertragen lassen.
F3: Kann das von der KI entwickelte Betriebssystem Windows oder Linux ersetzen?
Nein. Offiziell wird es als „funktionsfähiger Prototyp“ bezeichnet. Bislang wurden weder der Quellcode noch eine Architekturdokumentation, Kompatibilitätstests mit verschiedenen Hardwarekonfigurationen oder unabhängige Sicherheitsaudits veröffentlicht. Auch eine unabhängige Reproduktion gibt es nicht. Das Experiment belegt die Fähigkeit von KI, komplexe technische Projekte zu organisieren – nicht die Produktreife des Betriebssystems.
F4: Wie lauten die API-Preise und technischen Daten von Claude Fable 5.2?
Der öffentlich angegebene Preis beträgt 8 US-Dollar pro Million Token für Eingaben und 40 US-Dollar pro Million Token für Ausgaben. Damit liegt er 20 % unter dem Preis des Standardmodus von Fable 5.1. Im Fast Mode verdoppelt sich der Preis; die Ausgabegeschwindigkeit kann dabei bis zu 2,5-mal so hoch sein wie im Standardmodus. Das Kontextfenster umfasst 1 Million Token, die maximale Ausgabe 128.000 Token. Für Ein- und Ausgaben über die Batch API gibt es jeweils 50 % Rabatt. Das sind die veröffentlichten Listenpreise, nicht die tatsächlichen Kosten des Betriebssystem-Experiments.
F5: Wie können Entwickler Claude Fable 5.2 schnell für Agenten-Experimente nutzen?
Am besten prüfst du die Orchestrierungslogik zunächst mit kleinen Aufgaben:
1. Registriere dich bei APIYI unter apiyi.com und rufe deinen API-Schlüssel sowie ein kostenloses Testguthaben ab.
2. Setze im Beispiel aus diesem Artikel `base_url` auf `https://api.apiyi.com/v1`. Den Modellnamen findest du in der Liste in der Konsole.
3. Bringe zunächst den einfachen Ablauf „Aufgabe aufteilen → parallel ausführen → Ergebnisse zusammenführen“ zum Laufen. Ergänze anschließend schrittweise Wiederholungsversuche und eine Budgetkontrolle.
F6: Wo treten bei langfristigen Workflows mit mehreren Agenten am häufigsten Probleme auf?
Die häufigsten Probleme betreffen drei Bereiche: Erstens können die Kosten außer Kontrolle geraten, weil die Zahl der Aufrufe mit der Anzahl der Agenten steigt. Deshalb sollte unbedingt eine Budgetobergrenze festgelegt werden. Zweitens summieren sich Fehler: Gelegentliche Fehler bei einzelnen Aufrufen können sich in langen Abläufen verstärken. Wiederholungsversuche und ein Ersatzmodell helfen dagegen. Drittens entsteht Koordinierungsaufwand. Sind die Abhängigkeiten zwischen Aufgaben nicht klar, können parallele Prozesse zu Konflikten im Code führen. Über APIYI unter apiyi.com lassen sich mehrere Modelle zentral anbinden. So können Ersatzmodelle einfacher eingerichtet und die Nutzung zentral überwacht werden.
Claude Fable 5.2 und 1000 KI-Agenten: Die wichtigsten Erkenntnisse
- Fakten zum Experiment: Mehr als 1000 Subagenten arbeiteten acht Tage lang daran, aus einem leeren Ordner einen startfähigen Betriebssystem-Prototyp zu entwickeln.
- Der eigentliche Durchbruch: Das Modell übernimmt zunehmend Aufgabenzerlegung, parallele Ausführung, fortlaufende Fehlerbehebung und Ergebnisintegration.
- Signal aus der Praxis: Bei Anthropic stammt mehr als 90 % des zusammengeführten Codes von Claude. Die Migration zu Rust beschleunigte den Start um etwa das 26-Fache.
- Grenzen der Zahlen: 1000 Agenten bedeuten nicht, dass 1000 eigenständige Entwickler durchgehend parallel gearbeitet haben.
- Grenzen des Prototyps: Ohne unabhängige Prüfung und Reproduktion ist es noch ein weiter Weg bis zu einem ausgereiften kommerziellen Betriebssystem.
- Wichtig für Entwickler: Planung, Wiederholungsversuche, Budgetierung und Monitoring sind ebenso wichtig wie die Fähigkeiten des Modells. Für den einheitlichen Zugriff auf mehrere Modelle bietet sich APIYI (apiyi.com) an.
Zusammenfassung
Die Nachricht, dass 1000 KI-Agenten in acht Tagen ein Betriebssystem entwickelt haben, ist vor allem aus drei Gründen bemerkenswert – nicht wegen der Zahl allein:
- Die Fähigkeiten verändern sich: Claude Fable 5.2 zeigt, dass Modelle zunehmend komplexe Entwicklungsprozesse organisieren können – nicht nur Code generieren.
- Belege müssen differenziert betrachtet werden: Das Betriebssystem-Experiment, interne Produktionsdaten und frühe Rückmeldungen aus Unternehmen sind unterschiedliche Arten von Belegen und sollten getrennt bewertet werden.
- Der Mensch bleibt das letzte Glied: Der Prototyp lässt sich starten, doch Architekturentscheidungen, Sicherheit und Abnahme liegen weiterhin in der Verantwortung menschlicher Entwickler.
Für Entwickler heißt der nächste Schritt, über einzelne Aufrufe hinauszudenken und langfristige Workflows aufzubauen. Dabei sollte man früh klären, wie mehrere Modelle zusammenarbeiten, wie stabil die Aufrufe sind und wie sich die Kosten kontrollieren lassen. Über APIYI (apiyi.com) lassen sich mehrere führende Modelle mit einem API-Schlüssel anbinden. Am besten beginnt man mit Agentenaufgaben in kleinem Umfang und prüft den Ansatz zunächst in der Praxis.
📚 Referenzen
- Offizielle Ankündigung von Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Hinweis: Primärquelle zu Betriebssystem-Experimenten, internen Produktionsdaten und Rückmeldungen von Unternehmen
-
Dokumentation zu den Claude-Platform-Modellspezifikationen: Fable 5.2 Overview
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Hinweis: Spezifikationen wie Kontextfenster, maximale Ausgabe und Model ID
-
Dokumentation zur Managed-Agents-Orchestrierung mehrerer Agents: Subagent und Dynamic Workflow
- Link:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Hinweis: Angaben zu parallelen Threads, Agent-Anzahl und Lebenszyklusbeschränkungen im öffentlich verfügbaren Produkt
-
Ankündigung zur Anbindung über Vercel AI Gateway: Claude Fable 5.2 now available on AI Gateway
- Link:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
Hinweis: Failover-, Budget- und Wiederholungsfunktionen eines Drittanbieter-API-Gateways
-
Bericht von The Verge: Anthropic launches new Claude Fable and Mythos 5.2 models
- Link:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - Hinweis: Zeitgleiche Berichterstattung eines unabhängigen Mediums zur Veröffentlichung
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der APIYI-Website. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.