Autorhinweis: Wie lässt sich nach der Veröffentlichung eines neuen Modells mit eigenen Long-Horizon-Aufgaben prüfen, ob ein Wechsel sich lohnt? Dieser Artikel zerlegt die Frage in einen umsetzbaren 5-Schritte-Prozess.
Neue Modelle erscheinen fast jeden Monat, und die Benchmark-Ranglisten ändern sich ständig. Nehmen wir Tencent Hunyuan Hy4, das im November 2026 offiziell veröffentlicht wurde: Laut Hersteller wurde es gegenüber der Preview-Version gezielt bei Agent-Fähigkeiten und Long-Horizon-Aufgaben verbessert und erreicht in mehreren Benchmarks die vorderen Ränge der Open-Source-Modelle. Für Entwickler gibt es aber nur eine wirklich relevante Frage: Ist es bei meinen Aufgaben besser als das Modell, das ich derzeit einsetze? Dieser Artikel stellt eine Methode zur Vergleichsvalidierung neuer Modelle anhand eigener Long-Horizon-Aufgaben vor, mit der Sie innerhalb von ein bis zwei Tagen zu einer datengestützten Entscheidung kommen.
Das ist keine weitere Benchmark-Interpretation. Ranglisten messen allgemeine Fähigkeiten; Ihr Geschäftsbetrieb misst, ob ein mehrstufiger Vorgang von Anfang bis Ende erledigt wird, ob das Modell Fehler selbst korrigieren kann und was ein abgeschlossener Auftrag kostet.
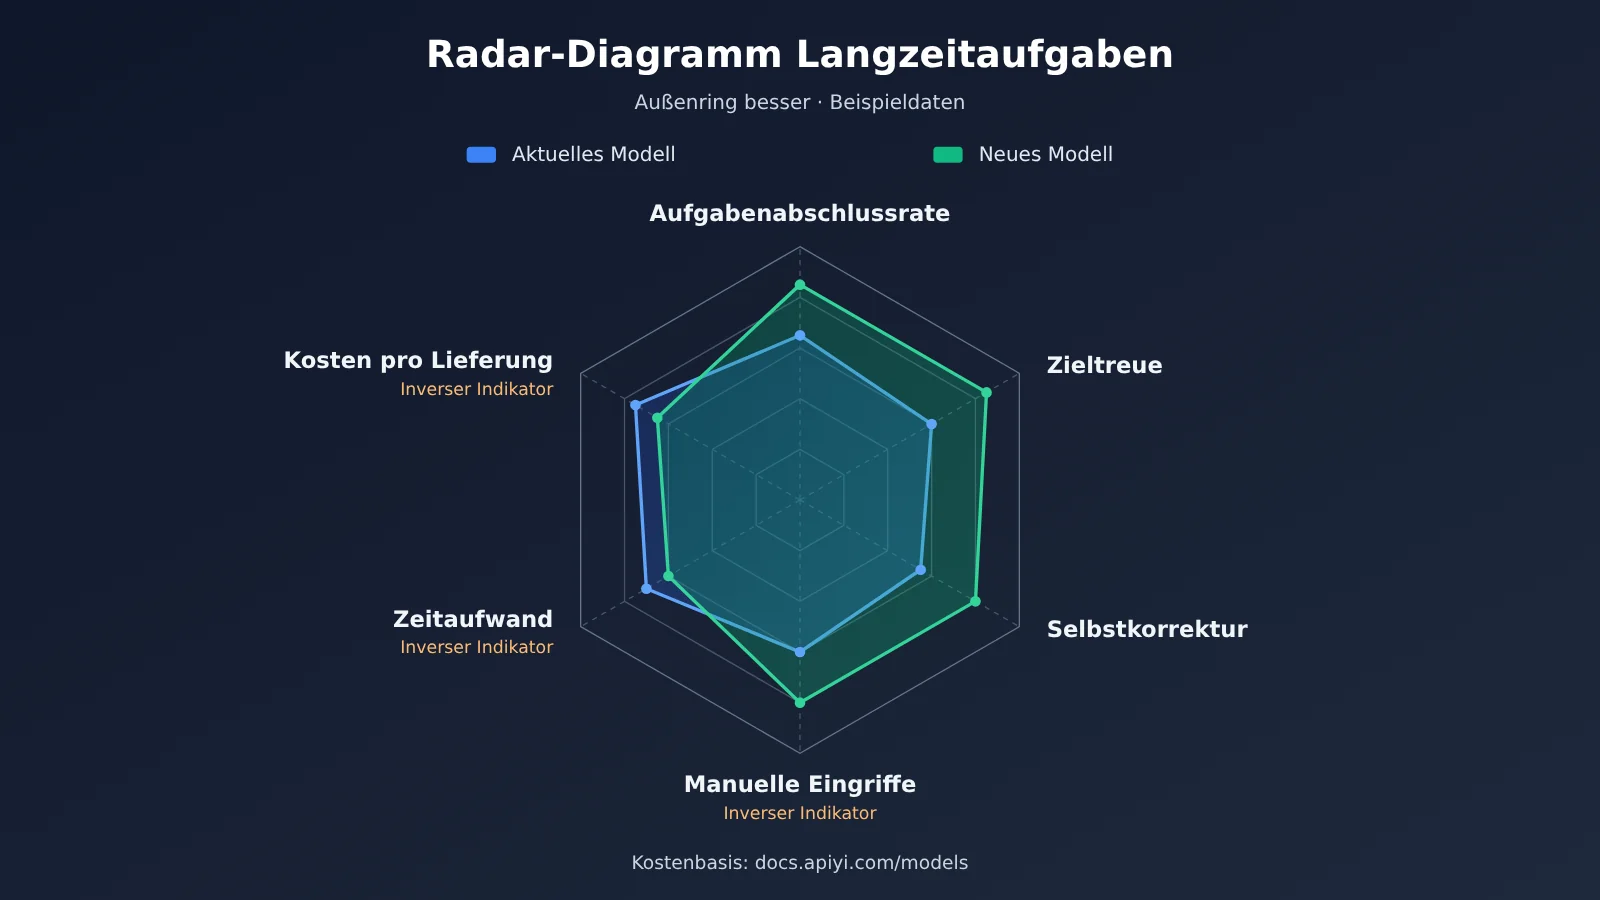
Der Kernnutzen: Nach der Lektüre können Sie einen kleinen, präzisen Validierungssatz für Long-Horizon-Aufgaben aufbauen, alte und neue Modelle anhand von sechs Kennzahlen vergleichen, mit der tatsächlichen Abrechnung die „Kosten pro erfolgreicher Lieferung“ berechnen und schließlich entscheiden, ob Sie wechseln oder nicht.
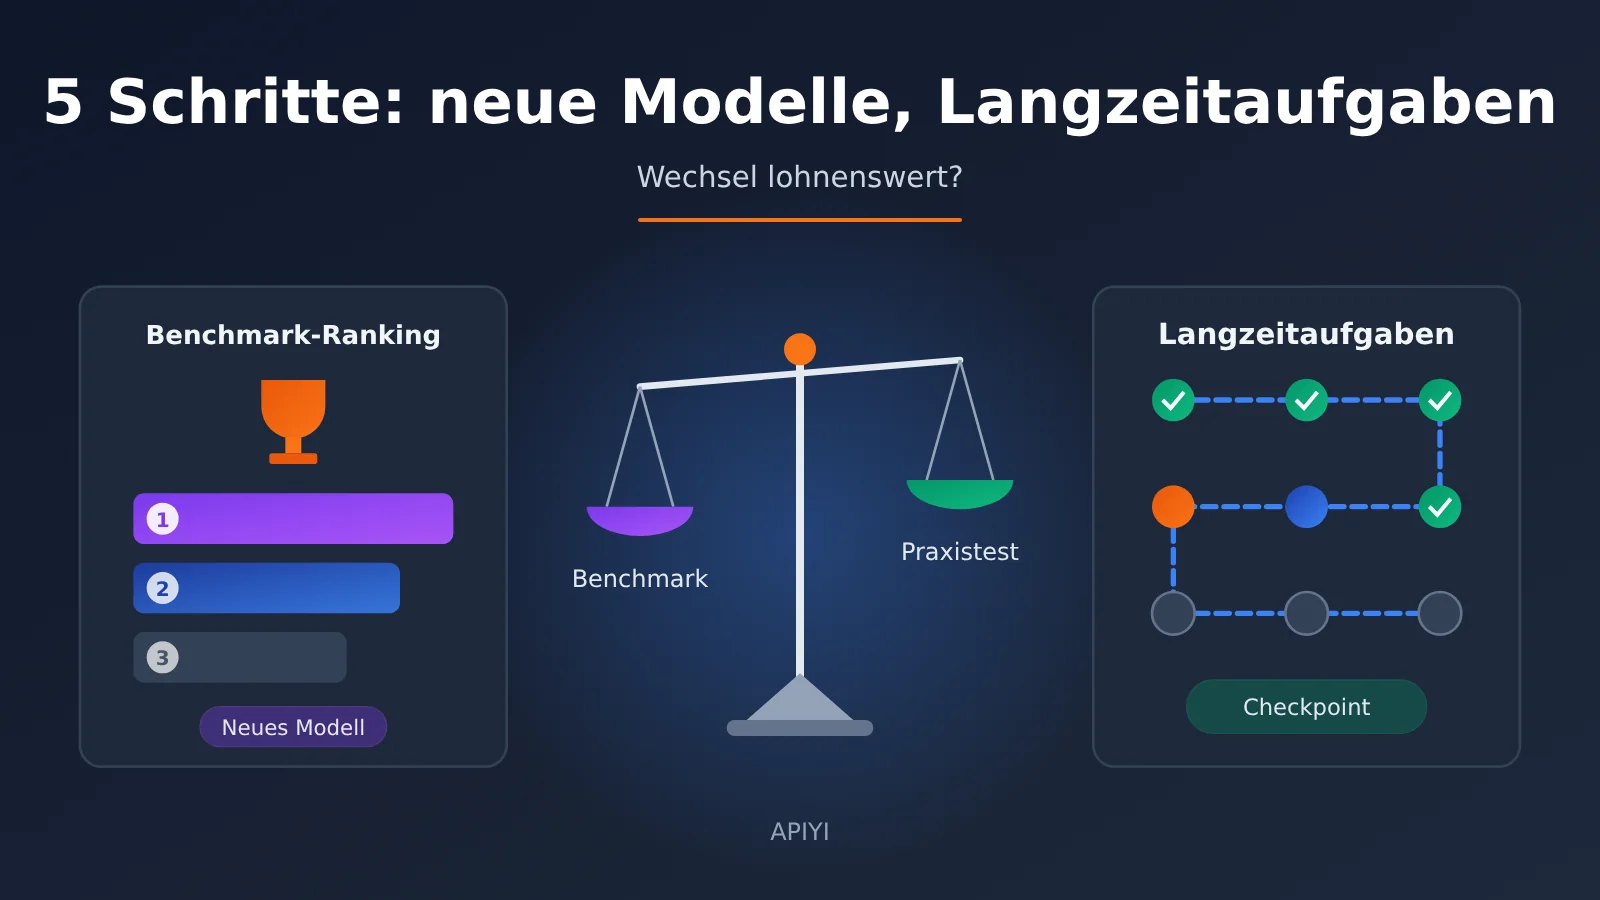
Die Kernpunkte bei der Validierung neuer Modelle in Langzeitaufgaben
Bevor Sie loslegen, sollten Sie den Unterschied zwischen der Validierung von Langzeitaufgaben und einem gewöhnlichen Einzeltest klären. Beim Einzeltest zählt, wie überzeugend eine einzelne Antwort aussieht. Bei der Validierung von Langzeitaufgaben zählt, ob das Ziel nach Dutzenden aufeinanderfolgenden Schritten noch steht.
| Punkt | Beschreibung | Nutzen |
|---|---|---|
| Eigene Aufgaben verwenden | Aus dem echten Geschäft 3–5 mehrstufige Aufgaben entnehmen statt öffentlicher Beispiele | Ergebnisse lassen sich direkt dem Geschäftserfolg zuordnen |
| Feste Kontrollgruppe | Das aktuell eingesetzte Modell und das neue Modell laufen mit derselben Aufgabe und derselben Toolchain | Unterschiede bei Eingabeaufforderungen und Umgebung ausschließen |
| Prozesskennzahlen priorisieren | Zieltreue, Selbstkorrektur und Anzahl manueller Eingriffe erfassen | Stabilitätsprobleme aufdecken, die reine Benchmarks nicht zeigen |
| Kosten pro Lieferung berechnen | Token-Kosten pro erfolgreicher Lieferung kalkulieren | Fehlurteile vermeiden, die durch reine Stückpreisbetrachtung entstehen |
| Wechselschwelle für das Modell festlegen | Vorab schriftlich festhalten, wie viel Verbesserung einen Wechsel rechtfertigt | Verhindern, dass man sich von einem einzelnen beeindruckenden Fall in die Irre führen lässt |
Warum die Validierung von Langzeitaufgaben verlässlicher ist als Benchmarks
Die Aufgaben öffentlicher Ranglisten sind meist geschlossen und kurzgliedrig, während echte Agentenarbeit genau das Gegenteil ist. In der Referenzbewertung verlangte eine Langzeitaufgabe von Hy4, von Recherche über Entwicklung und Prüfung bis zur Nachbesserung ein spielbares 3D-Spiel zu erstellen; zwischendurch kamen noch ein Referenzvideo und neue Anforderungen hinzu. Solche Aufgaben prüfen, ob das Modell bei wachsender Schrittzahl den ursprünglichen Plan im Gedächtnis behält, erledigte von unerledigten Punkten unterscheidet und den Plan anpasst, wenn Zwischenergebnisse nicht den Erwartungen entsprechen.
Ein weiteres bemerkenswertes Phänomen ist der Synergieeffekt von „Modell + Toolchain“. In derselben Bewertung erzeugte Hy4 in WorkBuddy innerhalb einer halben Stunde 14 PPTs, eine Excel-Datei und ein 19-seitiges Word-Dokument. Die Tester stellten außerdem ausdrücklich klar, dass das Modell für Verstehen, Planen und Beurteilen zuständig ist, während die Toolchain für Lesen, Berechnen, Rendern und Schreiben zuständig ist. Das bedeutet: Wenn Sie ein neues Modell validieren, müssen Sie es in Ihrer eigenen Toolchain laufen lassen; Ergebnisse außerhalb dieser Umgebung haben nur begrenzten Aussagewert.
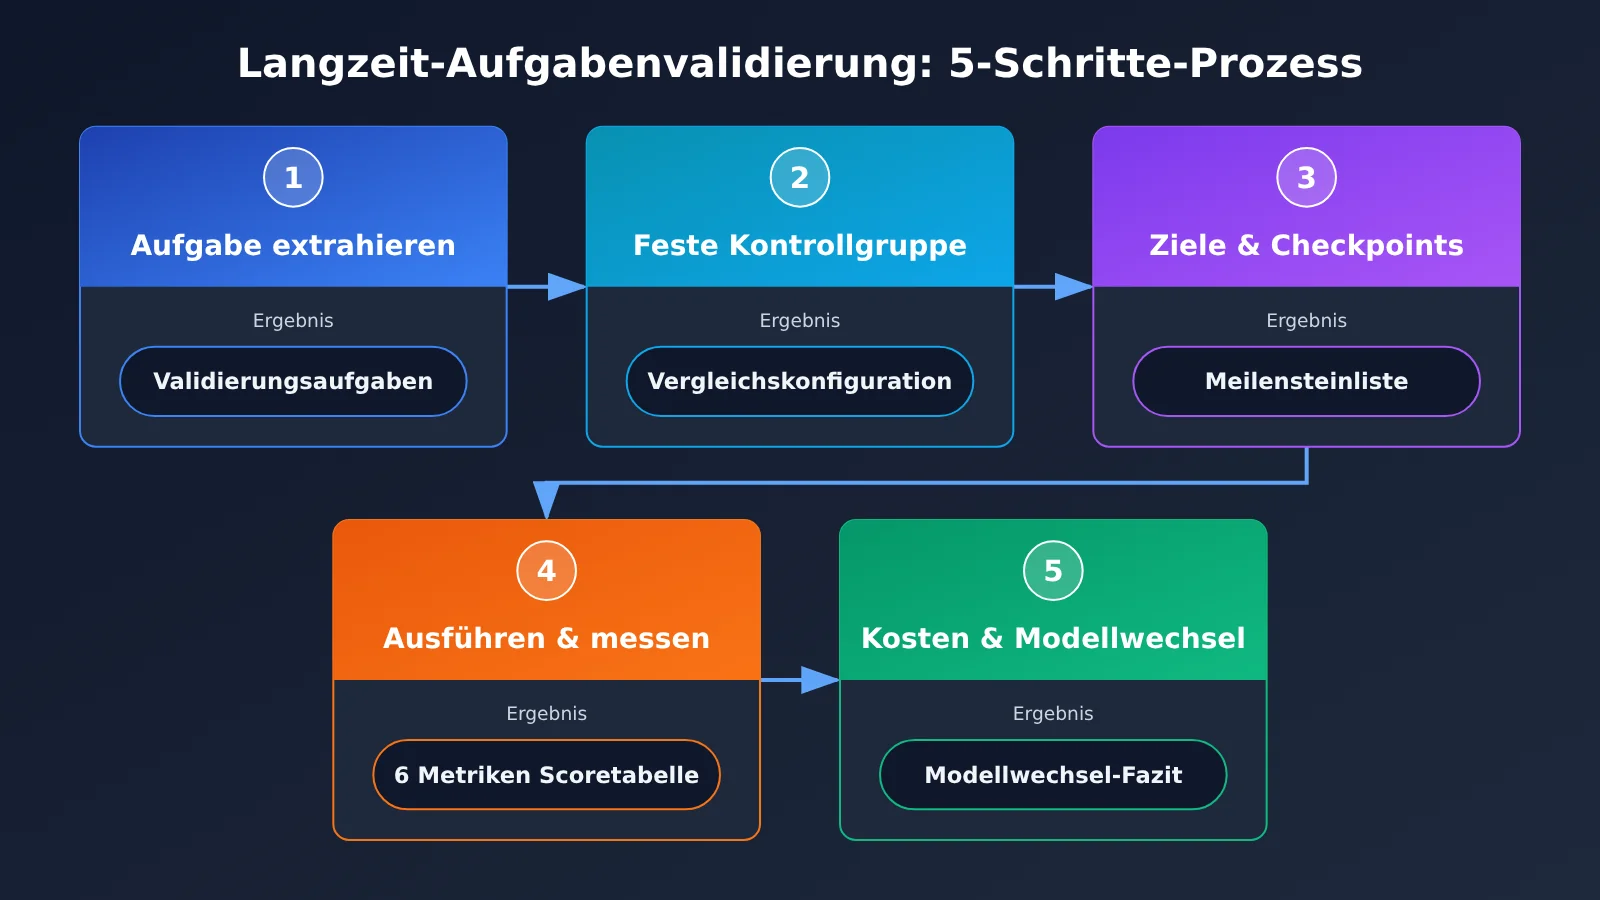
Schnellstart zur Validierung von Long-Horizon-Aufgaben neuer Modelle: 5-Schritte-Ablauf
Dieser Ablauf hängt von keinem bestimmten Framework ab. Solange Ihre Modellaufrufe über eine einheitliche Schnittstelle laufen, können Sie mit geringem Aufwand zwischen Modellen wechseln und vergleichende Tests durchführen.
Schritt 1: Long-Horizon-Aufgaben aus dem echten Geschäftsbetrieb herausziehen
Beim Validierungsset zählt nicht die Menge, sondern die Ähnlichkeit zur Realität. Wählen Sie am besten 3-5 Aufgaben aus, die die drei Szenariotypen in Ihrem Geschäftsbetrieb abdecken, die am häufigsten vorkommen, am meisten Personal binden und am fehleranfälligsten sind. Jede Aufgabe sollte idealerweise die drei Bedingungen erfüllen: „mindestens 10 Schritte, erfordert den Aufruf von Tools, hat ein klares lieferbares Ergebnis“.
Orientieren Sie sich für Ihre eigene Version an den folgenden typischen Long-Horizon-Aufgaben:
- Dokumenten-Stapelverarbeitung: Ein Ordner mit einem Dutzend Dokumenten wird vorgegeben; das Modell soll jedes Dokument einzeln zusammenfassen, Berichtsmaterial erzeugen und alles in einer Tabelle sowie einem Bericht bündeln.
- Anwendungsentwicklung: Ausgehend von einer Anforderungsbeschreibung werden Entwicklung, Selbsttest und Nachbesserung durchgeführt, am Ende wird ein lauffähiges Produkt geliefert.
- Multimodale Nachbildung: Ein Screenshot oder eine Bildschirmaufnahme wird hochgeladen; das Modell soll den Inhalt verstehen und die entsprechende Benutzeroberfläche bzw. Interaktion nachbauen.
- Computerbedienung: Das Modell soll auf den Bildschirm schauen, Schaltflächen finden, klicken und Eingaben machen, um einen softwareübergreifenden Bedienablauf abzuschließen.
Schritt 2: Kontrollgruppe und Laufzeitumgebung fixieren
Der Schlüssel zu einem kontrollierten Experiment lautet: „Nur eine Variable ändern“. Altes und neues Modell müssen dieselbe System-Eingabeaufforderung, dieselben Tool-Definitionen und dasselbe Eingangsmaterial verwenden. Es empfiehlt sich, jede Aufgabe mindestens dreimal laufen zu lassen und sowohl den Durchschnitt als auch den schlechtesten Wert zu betrachten, denn bei Aufgaben mit langem Zeithorizont ist die Zufälligkeit deutlich höher als bei Single-Turn-Fragen und -Antworten.
| Konfigurationselement | Empfohlene Einstellung | Erläuterung |
|---|---|---|
model |
Aktuelles Modell vs. neues Modell | Der einzige Parameter, der sich ändern darf |
temperature |
In beiden Gruppen gleich halten, eher niedrig | Verringert den Einfluss von Zufälligkeit auf die Schlussfolgerung |
max_tokens |
Reserve entsprechend der längsten Aufgabenausgabe einplanen | Vermeidet Fehlurteile über die Modellfähigkeit durch Abschneiden |
Tool-Definitionen tools |
Vollkommen identische Funktionsliste und Beschreibungen | Unterschiede in den Tool-Beschreibungen beeinflussen das Aufrufverhalten deutlich |
| System-Eingabeaufforderung | Dieselbe Version, nicht auf das neue Modell abgestimmt | Zuerst „Out of the Box“ testen, dann die Leistung nach dem Tuning |
| Wiederholungen | Mindestens 3 pro Aufgabe | Stabilität statt Bestwert beobachten |
Wenn Ihr Projekt sowohl OpenAI- als auch Anthropic-Schnittstellen nutzt, bedeutet ein Modellwechsel oft, das SDK, die Authentifizierung und das Anforderungsformat zu ändern – das macht kontrollierte Experimente mühsam. Über eine einheitliche API-Aggregationsplattform lässt sich der Wechsel allein durch Ändern des Felds model erledigen.
🚀 Schnellstart-Tipp: APIYI apiyi.com bietet API-Aufrufe für die in diesem Artikel behandelten gängigen Modelle und ist sowohl mit OpenAI- als auch mit Anthropic-Schnittstellenformaten kompatibel. Für kontrollierte Experimente müssen Sie nur den Parameter
modelersetzen, um zwischen altem und neuem Modell zu wechseln. Die Anbindung,base_urlund die Authentifizierungskonfiguration entnehmen Sie bitte dem APIYI-Dokumentationszentrum docs.apiyi.com.
Schritt 3: Zielanker und Checkpoints für die Aufgabe setzen
Der häufigste Fehlermodus bei langfristigen Aufgaben ist nicht „kann es nicht“, sondern „beim Arbeiten vergisst man, was eigentlich zu tun war“. In der Referenz-Evaluierung wurde die /goal-Anweisung verwendet, um das Modell zu zwingen, durchgehend ein konkretes Ziel im Blick zu behalten – dieser Ansatz lässt sich auf jede Validierungsumgebung übertragen. Du kannst zu Beginn der Aufgabe das Endziel klar aufschreiben und die Liefergegenstände in mehrere überprüfbare Meilensteine aufteilen.
Nehmen wir die Aufgabe „realistisches 3D-Minispiel“: Die Evaluatoren haben das Ziel in 5 Punkte aufgeteilt: Spielszene, Visuals und Spielgefühl, Sound und Gameplay, Workflow, finale Lieferung. Deine eigene Aufgabe solltest du genauso aufteilen – jeder Meilenstein entspricht einem Checkpoint, bei dem objektiv „erledigt/nicht erledigt“ beurteilt werden kann. Die spätere Bewertung wird dadurch deutlich einfacher.
Schritt 4: Ausführen und 6 Kennzahlen erfassen
Bei jedem Lauf müssen die vollständigen Dialog- und Tool-Aufrufprotokolle aufbewahrt werden, danach wird anhand der folgenden Tabelle bewertet. Die ersten 4 Punkte messen „ob es überhaupt fertig wird“, die letzten 2 messen „ob es sich lohnt“.
| Kennzahl | Wie messen | Bewertungsmethode |
|---|---|---|
| Aufgabenabschlussrate | Erledigte Checkpoints / Gesamtzahl der Checkpoints | Prozentwert, Durchschnitt aus 3 Läufen |
| Zieltreue | Ob in der zweiten Hälfte noch am ursprünglichen Ziel gearbeitet wird, ob etwas fehlt oder abgeschweift wird | Manuelle Bewertung mit 1–5 Punkten |
| Selbstkorrekturfähigkeit | Ob nach Fehlern (Fehlermeldungen, fehlgeschlagene Tests) selbst repariert werden kann | „Anzahl Fehler / Anzahl Selbstheilungen“ erfassen |
| Anzahl menschlicher Eingriffe | Runden, in denen menschliche Ergänzungen oder Korrekturen nötig sind | je weniger, desto besser |
| Zeitaufwand | Wall-Clock-Zeit von Start bis Lieferung | Minuten, inklusive Tool-Ausführungszeit |
| Kosten pro Lieferung | Gesamte Token-Kosten / Anzahl erfolgreicher Lieferungen | nach der tatsächlichen Abrechnungsgrundlage |
Besonders die „Anzahl menschlicher Eingriffe“ verdient Aufmerksamkeit. Das Fazit der Referenz-Evaluierung lautet: Hy4 kann bei den meisten alltäglichen Büro- und Kreativaufgaben im Grunde in einem Durchgang liefern, aber bei vielen Computer-Bedienvorgängen und komplexen Abläufen sind weiterhin mehrere Interaktionsrunden nötig, damit es die Absicht versteht. Genau diese Differenz musst du bei deinen eigenen Aufgaben quantifizieren: Ein Eingriff bedeutet einen zusätzlichen Personalaufwand.
Schritt 5: Kosten kalkulieren und die Entscheidung für einen Modellwechsel treffen
Die Kostenkalkulation sollte auf Basis „jeder erfolgreichen Auslieferung“ erfolgen und nicht nur die Preise für Ein- und Ausgabe vergleichen. Ein Modell, das pro Token günstig ist, aber zweimal neu laufen muss, kann in der Praxis teurer sein. Long-Horizon-Aufgaben haben noch eine Besonderheit: Der Kontext führt historische Inhalte wiederholt mit, und die Cache-Trefferquote hat großen Einfluss auf die Gesamtkosten.
Die Rechnung lautet: Kosten einer einzelnen Aufgabe = Eingabe-Tokens ohne Cache-Treffer × Eingabepreis + Eingabe-Tokens mit Cache-Treffer × Cache-Preis + Ausgabe-Tokens × Ausgabepreis; anschließend werden die Gesamtkosten mehrerer Läufe durch die Anzahl erfolgreicher Auslieferungen geteilt. Für die Eingabepreise, Ausgabepreise, Cache-Preise und Abrechnungsgrundlagen der einzelnen Modelle, sind die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models maßgeblich; in diesem Artikel nennen wir keine konkreten Zahlen, um Irreführungen durch Preisänderungen zu vermeiden.
💰 Tipp zur Kostenkalkulation: Für Vergleichstests sollten altes und neues Modell auf derselben Plattform aufgerufen werden, damit Nutzungsstatistik und Abrechnungsgrundlage identisch sind; nur dann sind die berechneten „Kosten pro Auslieferung“ vergleichbar. Die APIYI-Preisseite docs.apiyi.com/models listet die Eingabe-, Ausgabe- und Cache-Preise der einzelnen Modelle auf und kann direkt als Kalkulationsgrundlage dienen.
Entscheidungskriterien für die Validierung neuer Modelle bei Long-Horizon-Aufgaben
Wenn die Daten erst einmal vorliegen, ist die größte Sorge: „Jeder Kandidat hat seine Stärken, und man kann sich nicht entscheiden.“ Legen Sie die Entscheidungsregeln am besten schon vor Beginn des Experiments fest. Die folgende Tabelle kann als Ausgangspunkt dienen; passen Sie die Schwellenwerte anschließend an die Geschäftssensibilität an.
| Vergleichsergebnis | Empfohlene Entscheidung | Begründung |
|---|---|---|
| Abschlussrate deutlich gestiegen, Kosten pro Lieferung unverändert oder gesunken | Direkt wechseln | Qualität und Kosten profitieren gleichzeitig |
| Abschlussrate deutlich gestiegen, Kosten gestiegen | Szenariobasiert wechseln | Neues Modell nur für hochwertige, anspruchsvolle Aufgaben einsetzen |
| Abschlussrate unverändert, Kosten deutlich gesunken | Gestaffelt wechseln | Zuerst bei risikoarmen Aufgaben ersetzen und eine Zeit lang beobachten |
| Abschlussrate unverändert, Anzahl manueller Eingriffe gesunken | Wechsel priorisieren | Eingesparte Arbeitskraft ist oft wertvoller als Tokenkosten |
| Abschlussrate gesunken oder Stabilität schlechter | Vorerst nicht wechseln | Auf die nächste Version warten oder die Eingabeaufforderung anpassen und erneut testen |
Ein weiterer leicht übersehener Aspekt ist die Aufgabenrestrukturierung durch neue Fähigkeiten. Zum Beispiel bringt Hy4 diesmal visuelles Verständnis mit: Es kann Bildschirmaufzeichnungen direkt lesen und Frame für Frame analysieren sowie kontinuierlich Screenshots der selbst erzeugten Artefakte aufnehmen und sich durch Selbstfeedback optimieren. Wenn Ihr alter Prozess erfordert, dass Menschen Screenshots in Textbeschreibungen umwandeln, dann bringt das neue Modell möglicherweise nicht „dieselbe Aufgabe besser erledigen“, sondern „einen Schritt im gesamten Prozess einsparen“. Solche Gewinne sollten separat erfasst werden und nicht nur anhand der Punktzahl bei alten Aufgaben gemessen werden.
Auswahlreferenz beim Vergleich gängiger Modelle
Beim Vergleich lässt man in der Regel das neue Modell, das aktuell eingesetzte Modell und andere Kandidaten derselben Klasse gemeinsam laufen. Die folgende Tabelle zeigt die Auswahlüberlegungen; die konkreten Fähigkeiten sollten Sie anhand Ihrer eigenen Tests mit Long-Horizon-Aufgaben bewerten.
| Kandidatentyp | Geeignete Long-Horizon-Aufgaben | Validierungsschwerpunkt | Verfügbare Plattform |
|---|---|---|---|
| Neu veröffentlichtes Open-Source-/chinesisches Modell | Stapelverarbeitung von Bürodokumenten, Agenten für chinesischsprachige Szenarien | Zielbeibehaltung, Preis-Leistungs-Verhältnis | APIYI apiyi.com usw. |
| Etabliertes proprietäres Hauptmodell | Komplexe Programmierung, anspruchsvolle Reasoning-Aufgaben | Als Qualitätsbasislinie | APIYI apiyi.com usw. |
| Modell mit multimodalen Fähigkeiten | Reproduktion von Screenshots/Bildschirmaufzeichnungen, Verständnis von Benutzeroberflächen | Genauigkeit des visuellen Verständnisses, Selbstkorrektur | APIYI apiyi.com usw. |
| Leichtgewichtiges, schnelles Modell | Verteilung von Teilaufgaben, Formatierung | Zeitaufwand und Kosten | APIYI apiyi.com usw. |
💡 Auswahlhinweis: Vergleichen Sie nicht nur einen Kandidaten mit dem etablierten Modell. Wenn Sie über eine einheitliche Schnittstelle zwei oder drei weitere Kandidaten in denselben Validierungssatz aufnehmen, entdecken Sie oft eine bessere Lösung: die „szenariobasierte Kombination“. APIYI unterstützt den einheitlichen Aufruf mehrerer gängiger Modelle, sodass sich solche Kombinationslösungen schnell umsetzen lassen.
Häufige Fragen (FAQ)
F1: Was bedeutet Langstrecken-Aufgabenvalidierung bei neuen Modellen?
Bei der Validierung mit langlaufenden Aufgaben testet man Modelle mit realen Aufgaben, die mehrere Schritte umfassen, Werkzeugaufrufe erfordern und ein klar definiertes Ergebnis liefern. Im Fokus steht, ob das Modell über aufeinanderfolgende Schritte hinweg sein Ziel behält, ob es sich nach Fehlern selbst korrigieren kann und was die finale Lieferung kostet – nicht die Qualität einer einzelnen Antwort.
F2: Worin unterscheidet sich die Validierung langlaufender Aufgaben von öffentlichen Benchmarks?
Benchmarks sind wertvoll für den horizontalen Vergleich allgemeiner Fähigkeiten, doch die Aufgaben weichen stark von deinem Geschäftsumfeld ab und sind meist kurz und geradlinig. Die Validierung langlaufender Aufgaben läuft dagegen direkt auf deiner Toolchain und deinen Daten und legt Probleme offen wie das Vergessen von Zielen, falsche Werkzeugnutzung oder die Notwendigkeit, ständig manuell nachzujustieren. Am sichersten ist die Kombination beider Ansätze: erst mit Ranglisten Kandidaten vorfiltern, dann mit eigenen Aufgaben entscheiden.
F3: Wie lange nach der Veröffentlichung eines neuen Modells sollte man mit der Validierung beginnen?
Am besten sofort nach dem Release eine Runde „Out-of-the-box“-Tests laufen lassen, denn viele neue Modelle bieten eine zeitlich begrenzte kostenlose Phase oder Testphase. Im Referenzmaterial hatte Hy4 in WorkBuddy eine kostenlose Phase vom 4. bis 15. November. Sind die Ergebnisse der ersten Runde gut, lohnt es sich, Zeit in eine zweite Testrunde zu investieren und die Eingabeaufforderungen für das neue Modell anzupassen.
F4: Wie viele Aufgaben sollte ein Validierungsset umfassen?
3–5 Aufgaben, die sehr nah am Geschäft liegen, reichen meist für eine richtungsweisende Aussage – jede Aufgabe dreimal wiederholt, um die Stabilität zu beobachten. Statt Masse zählt, dass die Aufgaben deine häufigsten, personalintensivsten und fehleranfälligsten Szenarien abdecken und für jede Aufgabe klare Prüfpunkte definiert sind.
F5: Wie wechselt man kostengünstig zwischen mehreren Modellen für einen Vergleich?
Am einfachsten über eine Plattform mit einheitlicher Schnittstelle. APIYI apiyi.com unterstützt sowohl das OpenAI- als auch das Anthropic-API-Format: Zum Modellwechsel muss nur der Parameter `model` geändert werden, Werkzeugdefinitionen und Eingabeaufforderungen bleiben unverändert. Die genauen Integrationsschritte findest du im Dokumentationszentrum docs.apiyi.com.
F6: Wie berechnet man die Kosten langlaufender Aufgaben korrekt?
Rechne mit den „Kosten pro erfolgreicher Lieferung“, also die gesamten Token-Kosten mehrerer Läufe geteilt durch die Anzahl erfolgreicher Lieferungen – und unterscheide dabei zwischen Eingaben mit und ohne Cache-Treffer. Die Einzelpreise und Cache-Preise der Modelle entnimm bitte den tatsächlichen Daten der APIYI-Preisseite docs.apiyi.com/models; eine einheitliche Abrechnungsgrundlage auf derselben Plattform macht den Vergleich fairer.
F7: Welche Grenzen hat die Validierung langlaufender Aufgaben?
Erstens ist die Stichprobe klein – ein einzelner beeindruckender Erfolg oder Fehlschlag kann Zufall sein, daher sollte man mehrfach laufen lassen. Zweitens ist die menschliche Bewertung subjektiv; am besten bewerten zwei Personen unabhängig und bilden den Durchschnitt. Drittens hängen die Ergebnisse stark von der Toolchain ab: Nach einem Wechsel des Agent-Frameworks muss man erneut testen. Außerdem hängt die Obergrenze der Modellfähigkeiten oft vom Schwierigkeitsgrad der Testaufgaben ab – das Validierungsset sollte regelmäßig um schwierigere Aufgaben ergänzt werden.
Wichtige Erkenntnisse zur Validierung neuer Modelle bei Long-Horizon-Aufgaben
- Eigene Aufgaben sprechen lassen: 3–5 echte mehrstufige Aufgaben kommen dem Nutzen eines Modellwechsels näher als jede Bestenliste.
- Nur eine Variable ändern: Alt- und Neumodell nutzen dieselbe Eingabeaufforderung, dieselben Tools und dieselben Eingaben; jede Aufgabe mindestens 3-mal laufen lassen.
- Zielanker sind unverzichtbar: Orientieren Sie sich am
/goal-Ansatz, zerlegen Sie Aufgaben in Meilensteine; je objektiver die Checkpoints, desto genauer die Bewertung. - 6 Kennzahlen für das Gesamtbild: Abschlussrate, Zielbeibehaltung, Selbstkorrektur, Anzahl der Eingriffe, Zeitaufwand und Lieferkosten.
- Kosten pro Lieferung berechnen: Cache-Treffer unterscheiden; als Abrechnungsgrundlage dient die APIYI-Preisseite unter docs.apiyi.com/models.
- Prozessumbau im Blick behalten: Neue Fähigkeiten wie visuelles Verständnis können manuelle Schritte in alten Prozessen direkt überflüssig machen.
Zusammenfassung
Die Kernpunkte zur Validierung neuer Modelle bei Long-Horizon-Aufgaben:
- Realistische Aufgaben: Das Validierungsset stammt aus dem Geschäftsbetrieb und deckt häufige, zeitintensive und fehleranfällige Szenarien ab.
- Saubere Kontrolle: Feste Umgebung, wiederholte Läufe und vorab definierte Schwellenwerte für den Modellwechsel.
- Sauber kalkuliert: Kosten pro erfolgreicher Lieferung und Anzahl manueller Eingriffe messen den tatsächlichen Nutzen.
Jede Veröffentlichung eines neuen Modells ist eine Gelegenheit, den eigenen Workflow neu zu überdenken. Statt sich von Ranglisten und Demo-Videos leiten zu lassen, sollte man ein bis zwei Tage investieren und mit eigenen Long-Horizon-Aufgaben eine belastbare Antwort finden. Empfohlen: Alt- und Neumodelle über APIYI apiyi.com unter derselben Schnittstelle schnell gegenüberstellen; Hinweise zur Integration finden sich unter docs.apiyi.com, Abrechnungsdaten unter docs.apiyi.com/models.
📚 Referenzen
- 爱范儿 – Praxis-Test von Tencent Hy4: Praktische Fallbeispiele zu Hy4 bei langfristigen Aufgaben, Multimodalität und Computerbedienung
- Link:
ifanr.com/1687613 -
Beschreibung: Liefert nachahmenswerte Testdesigns zu
/goal-Zielvorgaben, langfristiger Spieleentwicklung und Dokumentenstapelverarbeitung -
APIYI Dokumentationszentrum: Hinweise zu Modellanbindung und Schnittstellenformaten
- Link:
docs.apiyi.com -
Beschreibung: Konfigurationswege für OpenAI- und Anthropic-kompatible Schnittstellen nachlesen
-
APIYI Modellpreisseite: Eingabe-, Ausgabe- und Cache-Preise der einzelnen Modelle
- Link:
docs.apiyi.com/models - Beschreibung: Die einzige Preisgrundlage für die Kostenkalkulation
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com – weitere Materialien zur Modellanbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com