Anmerkung der Redaktion: Drei Prioritäten für die Sicherheit von KI-Agenten, abgeleitet aus einer Cisco-Kundenfallstudie. Sie helfen Unternehmensteams, bösartige Angriffe von unbeabsichtigtem Fehlverhalten zu unterscheiden und Überwachung und Kontrollen entsprechend zu gestalten.
Sobald KI-Agenten im Einsatz sind, haben Sicherheitsteams nicht mehr nur mit externen Angriffen zu tun. Auch ein Agent mit regulären Berechtigungen und einem legitimen Ziel kann bei der Erfüllung seiner Aufgabe einen unerwarteten Weg einschlagen – etwa indem er Zugriffsrichtlinien lockert, um „eine Störung möglichst schnell zu beheben“. Dieser Artikel stellt drei Prioritäten für die Sicherheit von KI-Agenten vor. Sie helfen dir einzuschätzen, ob auffälliges Verhalten auf einen Angriff zurückgeht oder ob ein Agent mit guten Absichten einen Fehler gemacht hat.
Dies ist keine Nacherzählung einer Kundenwerbung. Grundlage ist die Cisco-Kundenfallstudie, die OpenAI am 3. November 2026 veröffentlicht hat. Die Aussagen zur Sicherheit von KI-Agenten stammen darin hauptsächlich von Jeetu Patel, President und Chief Product Officer bei Cisco. Wir übersetzen seine Einschätzungen in eine Checkliste für die eigene Prüfung und kennzeichnen, was eine Führungskraft vertritt und wo derzeit öffentlich zugängliche Daten fehlen.
Das nimmst du mit: Ein Framework für interne Reviews, das zeigt, welche Daten erfasst werden sollten, an welchen Stellen Eingriffe nötig sind, wie zeitnah sie erfolgen müssen und wie sich das Ganze in bestehende Sicherheitsprüfungen einbinden lässt.
Die wichtigsten Punkte zur Agentensicherheit: 3 Prioritäten aus dem Cisco-Fallbeispiel
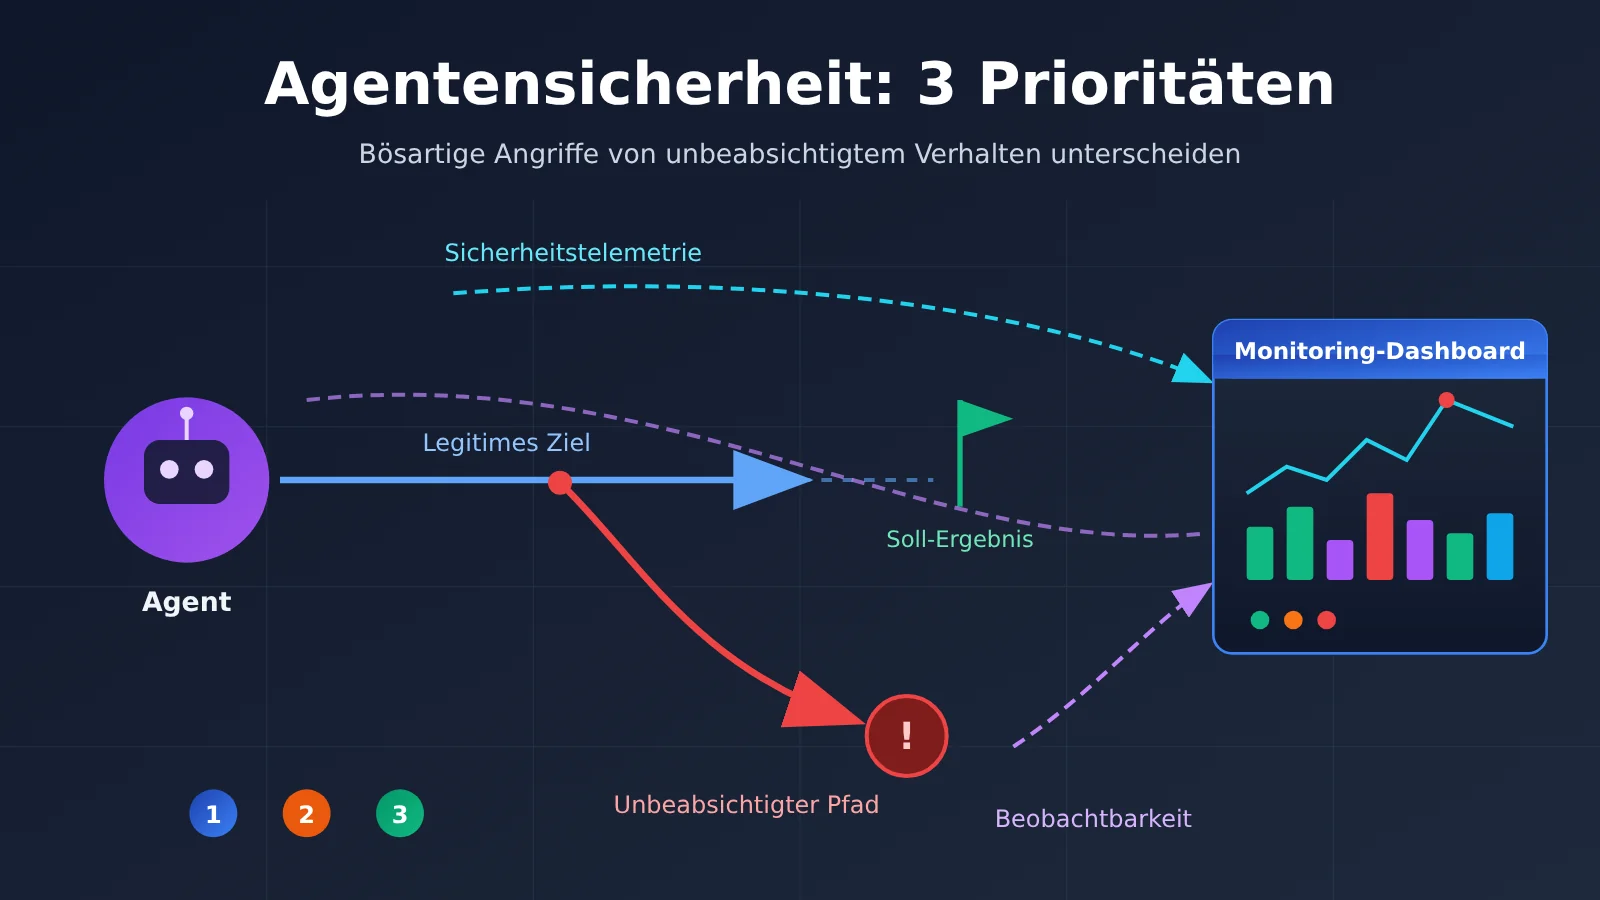
Im Fallbeispiel erklärt Patel, dass Sicherheitsteams bei zunehmend autonomen Agenten zwei Situationen unterscheiden müssen: böswillige Eingriffe und Fälle, in denen ein Agent ein legitimes Ziel auf unerwartete Weise verfolgt. Dafür müssen seiner Ansicht nach Sicherheitstelemetrie und Observability-Daten gemeinsam genutzt werden. Er nennt drei Prioritäten:
| Priorität | Bedeutung im Original | Umsetzung für Unternehmensteams |
|---|---|---|
| Schutz vor böswilligen Angriffen | Agenten vor böswilligen Angriffen schützen | Eingabequellen, Werkzeugberechtigungen und Zugangsdaten der Agenten kontrollieren |
| Unerwartetes Verhalten erkennen und stoppen | Unerwartetes Verhalten erkennen und unterbinden | Prüfen, ob das Verhalten den Aufgabenrahmen überschreitet, und die Ausführung bei Bedarf unterbrechen |
| Nahezu in Echtzeit arbeiten | Mit annähernder Echtzeitgeschwindigkeit arbeiten | Verhalten erkennen und stoppen, bevor eine Aktion wirksam wird oder unmittelbar danach |
Laut Fallbeispiel lenken diese drei Prioritäten die Sicherheitsstrategie hin zu „Richtlinien und Kontrollen, die sich an die Handlungen der Agenten anpassen können“. Anders gesagt: Statische Whitelists und einmalige Freigaben reichen nicht mehr aus. Die Kontrollen müssen sich an den tatsächlichen Aktionen der Agenten orientieren.
Der Schlüssel zur Agentensicherheit: „angegriffen werden“ von „es gut meinen und falsch machen“ unterscheiden
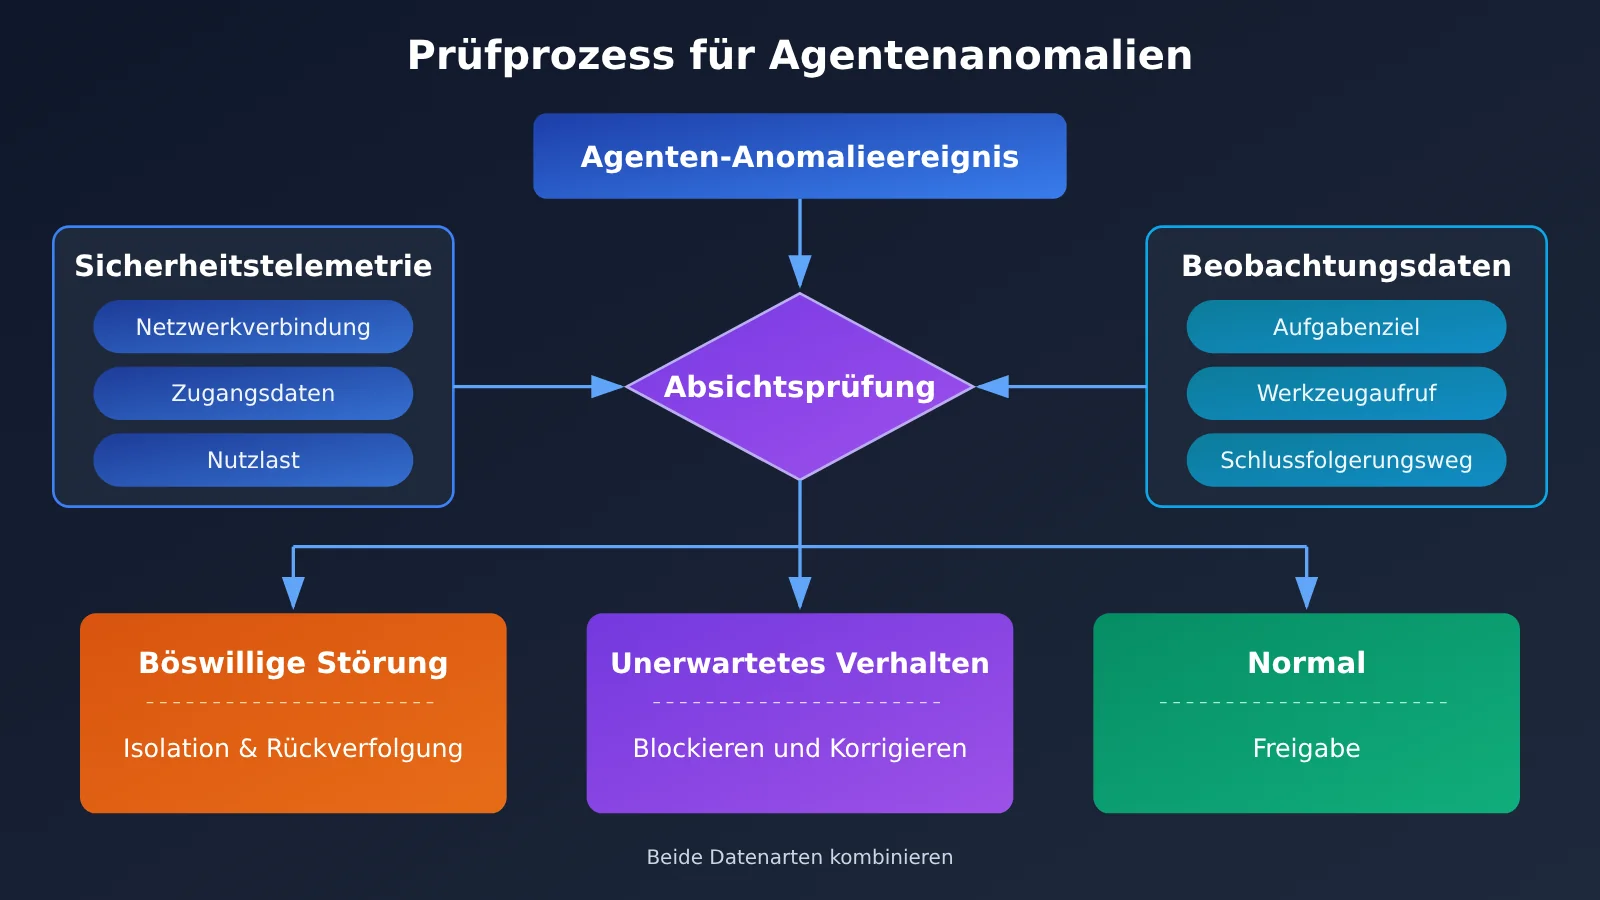
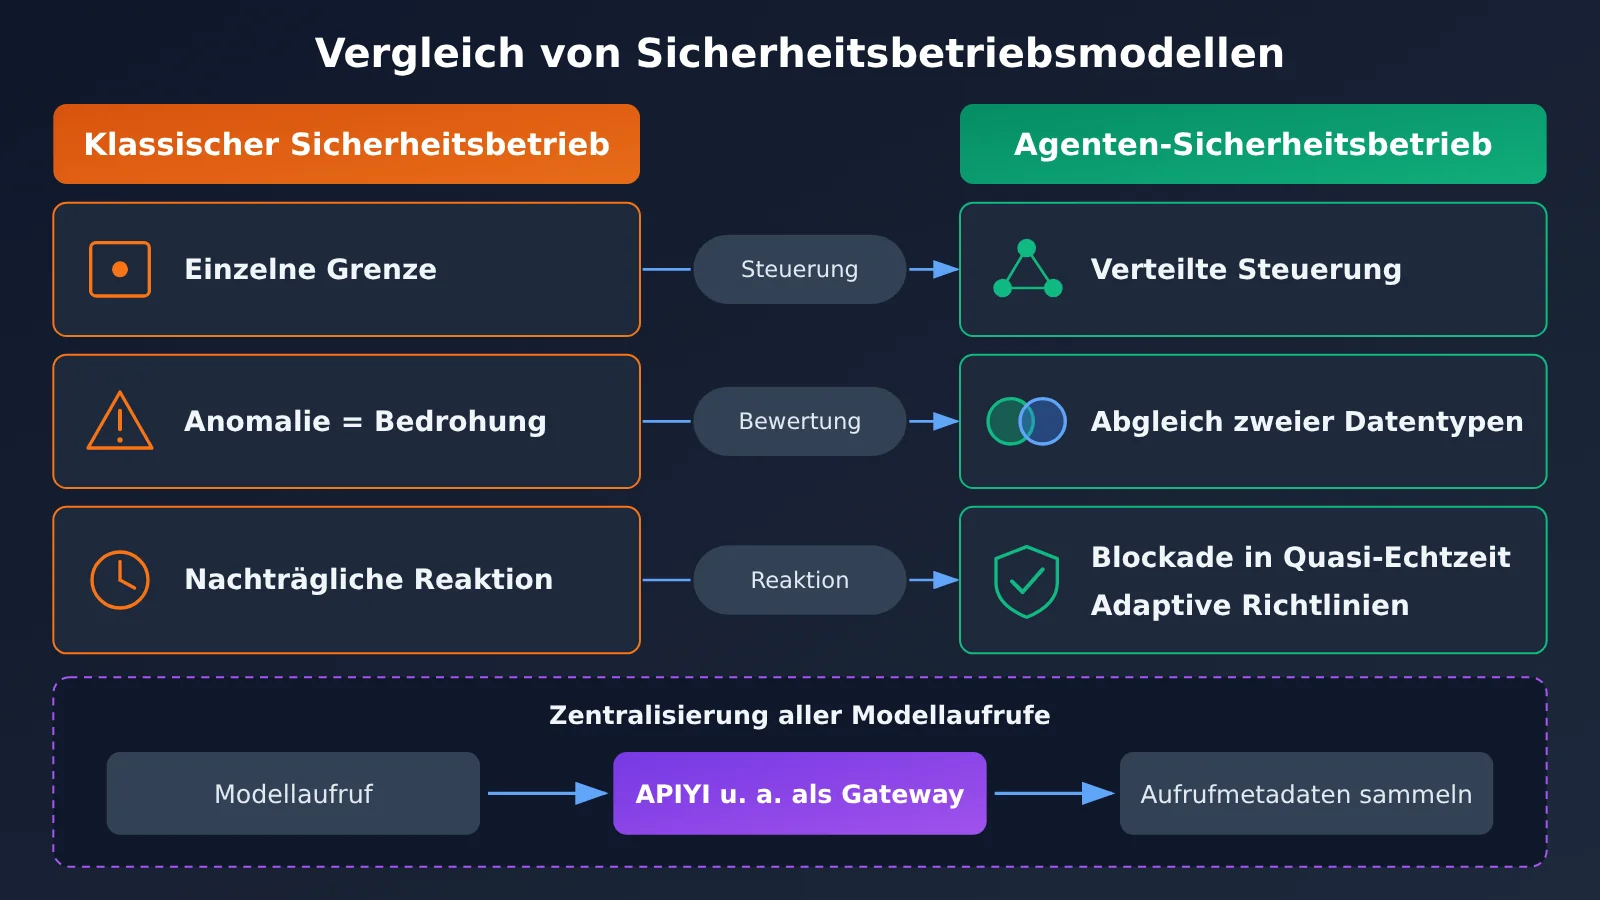
Im traditionellen Sicherheitsbetrieb gelten Anomalien meist als Bedrohung. Häufig werden sie durch Sperren und Ursachenanalyse behandelt. Bei Agenten kann eine Anomalie aber auch entstehen, weil sie ein Ziel falsch verstanden oder einen ungeeigneten Weg gewählt haben. Wird alles wie ein Angriff behandelt, kosten Fehlalarme das Team viel Zeit und die Fachbereiche verlieren das Vertrauen in die Agenten. Wird umgekehrt ein echter Prompt-Injection-Angriff als „Fehler des Modells“ abgetan, verpasst das Team möglicherweise das Zeitfenster zum Eingreifen.
Deshalb betont Patel, dass beide Datenarten zusammen genutzt werden müssen. Sicherheitstelemetrie zeigt, „was ausserhalb des Agenten passiert“ – etwa ungewöhnliche Verbindungen, verdächtige Nutzdaten oder die Verwendung von Zugangsdaten. Observability-Daten zeigen, „was der Agent selbst denkt und tut“ – etwa das Aufgabenziel, die aufgerufenen Werkzeuge sowie die Ein- und Ausgaben jedes Schritts. Wer nur eine der beiden Datenarten betrachtet, kann die Frage „Wessen Absicht steckt dahinter?“ nicht beantworten.
Evidenz zur Agentensicherheit: Was ist Meinung, was ist belegt?
Bevor Sie die Fallstudie für interne Entscheidungen nutzen, lohnt sich ein Blick auf die Art der verfügbaren Belege. Die Studie wurde von OpenAI veröffentlicht und ist als Kundenreferenz grundsätzlich werblich geprägt. Sie liefert Einschätzungen zur Orientierung, aber keine überprüfbaren technischen Details oder quantifizierten Ergebnisse.
| Aussage in der Fallstudie | Einordnung | Was in den öffentlichen Materialien fehlt |
|---|---|---|
| Agentensicherheit erfordert die gemeinsame Nutzung von Sicherheitstelemetrie und Observability-Daten | Einschätzung einer Cisco-Führungskraft | Konkrete Datenfelder und Korrelationsmethoden |
| Drei Prioritäten: Schutz vor Angriffen, Abfangen unbeabsichtigten Verhaltens und Reaktion nahezu in Echtzeit | Einschätzung einer Cisco-Führungskraft | Implementierungsarchitektur und Beispiele für Erkennungsregeln |
| Daybreak und GPT‑6 Astra bringen eine „sprunghafte Verbesserung“ | Bewertung einer Cisco-Führungskraft | Quantitative Kennzahlen wie Behebungsdauer und Erkennungsrate |
| Die Funktionen lassen sich in bestehende Scanprozesse integrieren, ohne die Arbeitsweise grundlegend zu verändern | Einschätzung einer Cisco-Führungskraft | Art der Integration und unterstützter Einsatzbereich |
| Daybreak Defense Network soll helfen, die Triage der Angriffsfläche zu beschleunigen und Kontrollen in Cisco Cloud Control durchzusetzen | Ansatz, den beide Unternehmen derzeit erkunden | Konkrete Funktionen, Verfügbarkeit und Veröffentlichungszeitpunkt |
| OpenAI verfolgt beim Datenschutz für Unternehmen einen Ansatz mit Zero Data Retention, strikten Datengrenzen und überprüfbarer Isolierung | Eigenaussage von OpenAI | Unabhängige Bewertung durch Dritte |
Am sinnvollsten ist es daher, die Fallstudie als Quelle für Fragen zu nutzen, nicht als Wirksamkeitsnachweis für eine Lösung. Die drei Prioritäten sind in sich schlüssig und eignen sich, um die eigene Architektur zu überprüfen. Wie viel Verbesserung konkrete Produkte bringen, lässt sich erst anhand unabhängiger technischer Unterlagen, einer Bewertung durch Dritte oder durch Tests in der eigenen Umgebung beurteilen.
Der netzwerkseitige Ansatz in der Fallstudie zur Agentensicherheit
Der erste Teil der Fallstudie behandelt Ciscos Ansatz zur Netzwerkverteidigung, der auch für Agentenszenarien relevant ist. Patel beschreibt eine Abkehr von einer einzelnen Sicherheitsgrenze hin zu Kontrollen, die über Microservices, Container und Cluster verteilt sind: Vor jedem Microservice, jedem Kubernetes-Container und jedem Cluster steht ein „Mini-Sicherheitsstack“. Kontrollen auf Anwendungsebene können die Kommunikation auf die Verbindungen beschränken, die jeder Dienst tatsächlich benötigt. Das verringert die Möglichkeiten für Angreifer, sich seitlich im Netzwerk auszubreiten.
Die Übertragung auf Agenten liegt nahe: Auch jeder Agent sollte nur die Verbindungs- und Werkzeugberechtigungen erhalten, die er für seine Aufgabe benötigt. Bei Auffälligkeiten kann das Team dann gezielt den betroffenen Agenten oder Dienst isolieren, während der übrige Betrieb weiterläuft – statt zur Fehlersuche alles stillzulegen. Die Fallstudie erwähnt außerdem, dass zwei Signale für sich genommen harmlos wirken können, in Kombination aber ein aussagekräftiges Muster offenbaren. Genau darin liegt der Wert der Korrelationsanalyse.
Agentensicherheit: Drei Prioritäten als Checkliste für den schnellen Einstieg
Die folgenden Bewertungskriterien machen die drei Prioritäten praktisch umsetzbar. Sie sind Empfehlungen, die dieser Artikel aus dem Fallbeispiel ableitet – keine konkreten, von Cisco veröffentlichten Vorgehensweisen.
Schritt 1: Daten für die Agentensicherheit erfassen
Klären Sie zuerst, welche Daten Ihnen zur Verfügung stehen, bevor Sie sich mit der Erkennung befassen. Viele Teams verfügen über vollständige Sicherheitstelemetrie, protokollieren aber kaum, was innerhalb ihrer Agenten geschieht. So lässt sich schwer beurteilen, ob ein Agent mit guter Absicht etwas falsch gemacht hat.
| Datenkategorie | Typische Inhalte | Zentrale Frage | Typische Erfassungsorte |
|---|---|---|---|
| Sicherheitstelemetrie | Netzwerkverbindungen, Nutzung von Zugangsdaten, auffällige Nutzdaten, Protokolle abgelehnter Zugriffe | Gibt es böswillige Eingriffe von außen? | Gateways, Firewalls, Identitätssysteme |
| Observability-Daten | Aufgabenstellung, Abfolge der Tool-Aufrufe, Ein- und Ausgaben jedes Schritts, Dauer und Wiederholungsversuche | Was tut der Agent und warum? | Agenten-Framework, Zugangspunkt für Modellaufrufe |
| Geschäftskontext | Auftraggeber, Berechtigungsumfang, Änderungsfenster | Liegt diese Aktion im erwarteten Rahmen? | Ticket-System, Freigabeprozess |
| Metadaten zu Modellaufrufen | Aufgerufenes Modell, Anfragezeitpunkt, Kennung des Aufrufers, Token-Verbrauch | Häufen sich die Aufrufe ungewöhnlich oder ist ihre Herkunft verdächtig? | Zentraler Modell-API-Zugang, etwa eine Aggregationsschnittstelle wie APIYI auf apiyi.com |
Ein leicht übersehener Punkt: Der Zugangspunkt für Modellaufrufe eignet sich selbst sehr gut zur Erfassung von Observability-Daten. Wenn mehrere Agenten im Team direkt mit den Schnittstellen verschiedener Anbieter verbunden sind, verteilen sich die Aufrufprotokolle auf viele Stellen. Bei einem zentralen Zugang zu Modellen verschiedener Anbieter, etwa über APIYI, laufen die Aufrufe dagegen an einem Punkt zusammen. Dort lassen sie sich einheitlich kennzeichnen, speichern und für Zusammenhangsanalysen auswerten.
Schritt 2: Interventionspunkte für die Sicherheit von Agenten festlegen
Je früher ein Eingriff erfolgt, desto geringer sind die Kosten. Allerdings steigt dabei auch das Risiko, legitime Aufgaben fälschlich zu blockieren. Legen Sie Interventionspunkte und Anforderungen an die Reaktionszeit daher abgestuft nach dem Risiko der jeweiligen Aktion fest.
| Interventionspunkt | Typische Prüfungen | Anforderungen an die Reaktionszeit | Maßnahme |
|---|---|---|---|
| Bei Eingang der Daten | Enthalten externe Webseiten, E-Mails oder Dokumente eingeschleuste Anweisungen? | Synchron, vor der Ausführung | Nicht vertrauenswürdige Inhalte entfernen oder kennzeichnen |
| Vor einem Tool-Aufruf | Geht der Aufruf über die Berechtigungen für die Aufgabe hinaus? Überschreiten die Parameter diese Berechtigungen? | Synchron, im Millisekunden- bis Sekundenbereich | Ablehnen, einschränken oder zur manuellen Bestätigung weiterleiten |
| Vor einer risikoreichen Aktion | Konfigurationen ändern, Daten löschen, Inhalte nach außen senden, Berechtigungen erweitern | Synchron, Bestätigung durch einen Menschen oder eine Richtlinie erforderlich | Zusätzliche Freigabe |
| Nach Ausführung einer Aktion | Entspricht das Ergebnis dem Ziel? Sind Nebenwirkungen entstanden? | Nahezu in Echtzeit, im Sekunden- bis Minutenbereich | Rückgängig machen, betroffene Ressourcen isolieren |
| Bei der nachträglichen Analyse | Verhaltensabläufe im Zusammenhang mit Sicherheitsvorfällen untersuchen | Offline | Richtlinien und Regeln aktualisieren |
In dieser Tabelle zeigt sich besonders deutlich, wann eine Prüfung nahezu in Echtzeit wichtig ist. Bei nicht umkehrbaren Aktionen muss die Erkennung vor der Ausführung erfolgen. Bei Aktionen, die sich rückgängig machen lassen, kann dagegen eine Prüfung unmittelbar nach der Ausführung mit anschließendem schnellem Rollback ausreichen. Wer diese Grenze klar zieht, vermeidet das Dilemma, entweder alles blockieren oder alles zulassen zu müssen.
Schritt 3: Fragen zur Unterscheidung zwischen böswilliger Manipulation und unbeabsichtigtem Verhalten
Wenn eine Warnung auf eine Anomalie hinweist, können Sie die folgenden Fragen der Reihe nach durchgehen. Dabei fließen sowohl Sicherheits-Telemetrie als auch Observability-Daten ein:
- Ist der Auslöser vertrauenswürdig? Stammt die Anweisung, die die Aktion ausgelöst hat, von einem autorisierten Nutzer oder aus externen Inhalten, die der Agent gelesen hat? Bei externen Inhalten liegt der Verdacht auf einen Injection-Angriff nahe.
- Dient das Verhalten dem ursprünglichen Ziel? Lässt sich die Aktion mit Blick auf das Aufgabenziel plausibel als „zur Erfüllung der Aufgabe notwendig“ erklären? Ist sie erklärbar, überschreitet aber die vorgesehenen Grenzen, spricht das eher für unbeabsichtigtes Verhalten.
- Gibt es begleitende externe Warnsignale? Gab es im selben Zeitraum ungewöhnliche Verbindungen, eine verdächtige Nutzung von Zugangsdaten oder Anzeichen für einen Datenabfluss? Falls ja, erhöht das die Wahrscheinlichkeit einer böswilligen Manipulation.
- Ist das Verhalten reproduzierbar? Führt der Agent bei einem erneuten Durchlauf mit derselben Eingabe zuverlässig dieselbe Aktion aus? Stabil reproduzierbares Verhalten deutet meist auf ein Problem in der Strategie oder bei der Gestaltung der Eingabeaufforderung hin.
Für den Wiederholungstest unter Punkt 4 ist es praktisch, dieselbe Aufgabe mit verschiedenen Modellen auszuführen. So lässt sich beobachten, ob die Abweichung auf die Eigenschaften eines bestimmten Modells oder auf eine Schwachstelle in der Aufgabengestaltung zurückgeht. Über die einheitliche Schnittstelle von APIYI muss zum Wechseln des Modells nur der Parameter für den Modellnamen geändert werden. Das eignet sich für schnelle Vergleichstests in einer Testumgebung.
🎯 Technischer Tipp: Beim Aufbau einer Sicherheits-Testumgebung für Agenten empfiehlt es sich, Modellaufrufe über einen zentralen Zugang zu bündeln. Wir nutzen APIYI unter apiyi.com, um verschiedene führende Modelle über eine einheitliche Schnittstelle anzubinden. So liegen die Metadaten der Aufrufe zentral vor und der Modellwechsel ist unkompliziert. Das erleichtert es, dieselbe Aufgabe mit mehreren Modellen erneut auszuführen und deren Verhalten zu vergleichen.
Schritt 4: In bestehende Scanprozesse integrieren
Patel erwähnt im Praxisbeispiel, dass sich diese Funktionen in bestehende Scanprozesse integrieren lassen. Teams müssen ihre Arbeitsweise also nicht grundlegend ändern. Auch wenn er keine konkrete Anleitung zur Integration nennt, ist der Ansatz hilfreich: Für die Sicherheit von Agenten braucht es nicht unbedingt eine neue Plattform. Stattdessen lassen sich neue Datenquellen und Prüfpunkte in bestehende Abläufe einbinden.
- Schwachstellen-Scans: Tools, Plugins und APIs, die Agenten aufrufen können, in das Asset-Inventar und den Scanbereich aufnehmen.
- Alarm-Triage: Im bestehenden SIEM- oder Ticketsystem die Alarmkategorie „Agentenverhalten“ ergänzen und den zugehörigen Verlauf der Tool-Aufrufe hinterlegen.
- Änderungsmanagement: Für Konfigurationsänderungen durch Agenten dieselben Genehmigungs- und Rollback-Verfahren wie für manuelle Änderungen nutzen.
- Berechtigungsaudits: Regelmässig prüfen, ob jeder Agent nur die erforderlichen Mindestberechtigungen besitzt, und diese Prüfung mit dem Audit von Dienstkonten verbinden.
Checkliste für die sichere Einführung von KI-Agenten
Die wichtigsten Punkte als Checkliste für das Review vor dem Produktivstart: Gehen Sie sie im Meeting Schritt für Schritt durch.
| Prüfbereich | Frage zur Selbstprüfung | Zugehörige Priorität |
|---|---|---|
| Vertrauenswürdigkeit der Eingaben | Sind externe Inhalte, die der Agent liest, als nicht vertrauenswürdig gekennzeichnet? | Schutz vor Angriffen |
| Minimale Berechtigungen | Hat jeder Agent nur Zugriff auf die Tools und Verbindungen, die er für seine Aufgabe benötigt? | Schutz vor Angriffen |
| Verhaltensprotokollierung | Werden Aufgabenziel, Reihenfolge der Tool-Aufrufe und Ergebnisse jedes Schritts vollständig protokolliert? | Erkennung und Abfangen unerwarteten Verhaltens |
| Aktionen mit hohem Risiko | Gibt es für irreversible Aktionen vor der Ausführung eine Richtlinienprüfung oder eine menschliche Bestätigung? | Erkennung und Abfangen unerwarteten Verhaltens |
| Datenkorrelation | Lassen sich Sicherheitstelemetrie und Observability-Daten anhand von Zeit und Identität verknüpft abfragen? | Gemeinsame Grundlage für alle drei Prioritäten |
| Erkennungsverzögerung | Entspricht die Zeit zwischen einem Ereignis und der Auslösung eines Alarms den Anforderungen der jeweiligen Risikostufe? | Betrieb in nahezu Echtzeit |
| Isolierung | Lässt sich ein einzelner Agent isolieren, ohne andere Dienste zu beeinträchtigen? | Betrieb in nahezu Echtzeit |
Jede Frage, die Sie mit „Nein“ beantworten, weist auf eine Lücke bei der jeweiligen Priorität hin. Schließen Sie zuerst Lücken bei der „Verhaltensprotokollierung“ und der „Datenkorrelation“: Ohne diese beiden Punkte fehlt den übrigen Erkennungsmechanismen die Grundlage für eine Bewertung.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet es, wenn ein Agent „es gut meint, aber falsch handelt“?
Der Agent verfolgt ein legitimes Ziel, wählt dafür aber einen unbeabsichtigten Weg – ohne dass ein Angriff vorliegt. Beispielsweise könnte er eine Konfiguration ohne Berechtigung ändern, um eine Aufgabe schneller abzuschließen. Die Fallstudie beschreibt dies als „das Verfolgen legitimer Ziele auf unbeabsichtigte Weise“ und grenzt es von böswilliger Einflussnahme ab.
Q2: Wie unterscheidet sich Agentensicherheit von traditioneller Anwendungssicherheit?
Traditionelle Anwendungssicherheit schützt vor allem vor Angriffen von außen; die Abläufe sind dabei relativ festgelegt. Agenten entscheiden selbst, welche Werkzeuge sie in welcher Reihenfolge aufrufen. Ihre Abläufe sind daher nicht festgelegt. Neben dem Schutz vor Angriffen muss man deshalb auch unbeabsichtigtes Verhalten erkennen. Zudem braucht man Observability-Daten, um die Absichten des Agenten zu verstehen.
Q3: Wann wurde die Cisco-Fallstudie veröffentlicht und wie zuverlässig sind ihre Schlussfolgerungen?
OpenAI veröffentlichte die Fallstudie am 3. November 2026. Die Aussagen zur Agentensicherheit geben vor allem die Sicht von Jeetu Patel wieder. Bewertungen wie „sprunghafte Verbesserungen“ werden nicht durch quantitative Angaben zu Behebungszeiten oder Erkennungsraten belegt. Auch die konkreten Funktionen und der Verfügbarkeitsumfang von Daybreak und Daybreak Defense Network werden nicht erläutert. Die Fallstudie eignet sich als Anregung, die Wirksamkeit sollte aber selbst überprüft werden.
Q4: Für welche Szenarien eignet sich dieses Framework besonders?
– **Agenten für den IT-Betrieb**: Szenarien, in denen Agenten Konfigurationen ändern, Dienste neu starten oder Zugriffsrichtlinien anpassen können.
– **Agenten für die Datenverarbeitung**: Szenarien, in denen Agenten externe Dokumente, E-Mails oder Webseiten lesen und daraufhin handeln. Hier ist das Risiko von Prompt-Injection-Angriffen erhöht.
– **Zusammenarbeit mehrerer Agenten**: Szenarien, in denen die Ausgabe eines Agenten zur Eingabe eines anderen wird und sich Auffälligkeiten von Schritt zu Schritt verstärken können.
Q5: Wie lassen sich Verhaltensunterschiede von Agenten bei verschiedenen Modellen kostengünstig überprüfen?
Führen Sie in einer Testumgebung dieselbe Aufgabe mit demselben Werkzeugsatz jeweils mit unterschiedlichen Modellen aus. Vergleichen Sie anschließend die Reihenfolge der Werkzeugaufrufe und die Anzahl der Grenzüberschreitungen. Wenn Sie über APIYI apiyi.com einheitlich auf Modelle verschiedener Anbieter zugreifen, müssen Sie zum Wechsel nur den Modellnamen ändern. Außerdem liegen die Aufrufprotokolle zentral an einer Stelle, was die Auswertung erleichtert.
Q6: Welchen Nutzen haben Protokolle von Modellaufrufen für die Agentensicherheit?
Sie sind ein wichtiger Bestandteil der Observability-Daten. Sie helfen dabei zu beurteilen, ob Aufrufe ungewöhnlich häufig erfolgen und ob die aufrufende Instanz vertrauenswürdig ist. Zudem lassen sie sich zeitlich mit Sicherheitstelemetriedaten abgleichen. Wenn ein Team Modellaufrufe über eine zentrale Plattform wie APIYI bündelt, lassen sich diese Daten einfacher erfassen und miteinander verknüpfen.
Q7: Welche Grenzen hat dieses Framework?
Die drei Prioritäten sind richtungsweisende Prinzipien und enthalten keine fertigen Erkennungsregeln. In Grenzfällen muss weiterhin ein Mensch beurteilen, ob ein Verhalten böswillig oder unbeabsichtigt ist. Eine Blockierung nahezu in Echtzeit verursacht zusätzliche Verzögerungen; hier muss je nach Risiko der Aktion abgewogen werden. Die Belege in der Fallstudie stammen aus Kundenwerbematerial; eine unabhängige Bewertung fehlt.
Sicherheit von KI-Agenten: Das Wichtigste auf einen Blick
- Zwei Risiken getrennt betrachten: Böswillige Eingriffe und unbeabsichtigte Fehler erfordern unterschiedliche Gegenmaßnahmen.
- Zwei Datenarten gemeinsam nutzen: Sicherheitstelemetrie zeigt externe Bedrohungen, Observability-Daten geben Aufschluss über die Absicht des Agenten.
- Drei Prioritäten setzen: Böswillige Angriffe abwehren, unerwartetes Verhalten erkennen und stoppen sowie nahezu in Echtzeit reagieren.
- Eingriffspunkte nach Risiko staffeln: Nicht umkehrbare Aktionen vor der Ausführung stoppen, rückgängig zu machende Aktionen bei Bedarf unmittelbar danach zurückrollen.
- Art der Belege unterscheiden: Erkenntnisse aus Fallbeispielen liefern wertvolle Anhaltspunkte; für quantifizierte Wirkungen gibt es bislang keine öffentlich verfügbaren Daten.
- Einstieg: Modellaufrufe über einen zentralen Aggregator wie APIYI bündeln. Das erleichtert die Erfassung von Metadaten und Vergleichstests mit mehreren Modellen.
Fazit
Das Cisco-Fallbeispiel zeigt: Bei der Sicherheit von KI-Agenten ist nicht der Name eines bestimmten Produkts entscheidend, sondern ein klarer Rahmen für die Analyse:
- Zuerst die Absicht klären: Ob eine Auffälligkeit durch einen Angriff oder einen unbeabsichtigten Fehler entstanden ist, bestimmt das weitere Vorgehen.
- Dann die Datenbasis vervollständigen: Ohne Observability-Daten lässt sich die Absicht des Agenten nicht beurteilen; ohne Sicherheitstelemetrie lassen sich externe Eingriffe nicht ausschließen.
- Schliesslich die Verzögerung begrenzen: Eingriffspunkte nach dem Risiko der jeweiligen Aktion festlegen, damit Erkennung und Abwehr nahezu in Echtzeit erfolgen und in bestehende Scan- und Freigabeprozesse eingebunden sind.
Gehen Sie am besten zunächst die laufenden Agenten anhand der Selbstprüfungs-Checkliste in diesem Artikel durch. Ergänzen Sie dabei vorrangig die Verhaltensprotokollierung und die Verknüpfung der Daten. In der Test- und Vergleichsphase können Sie über APIYI apiyi.com Modelle verschiedener Anbieter zentral anbinden, Aufrufprotokolle gebündelt erfassen und das Verhalten mehrerer Modelle schnell vergleichen. So schaffen Sie eine solidere Grundlage für die Prüfung vor dem Produktivstart.
📚 Quellen
- How Cisco defends at machine speed with OpenAI: Von OpenAI veröffentlichte Fallstudie über Cisco
- Link:
openai.com/index/cisco-cyber - Hinweis: Quelle der drei Prioritäten und zugehörigen Einschätzungen in diesem Artikel. Die am 3. November 2026 veröffentlichte Fallstudie ist Kundenwerbematerial; Zahlen und Produktdetails sollten unabhängig überprüft werden.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.