Anmerkung des Autors: Warum setzt LongCat-2.5 nicht allein auf 1M Kontext, sondern stärkt in sechs Trainingsbereichen die Fähigkeit von Agenten, ganze Projekte über lange Zeiträume abzuschließen? Dieser Artikel erklärt den Ansatz und zeigt, welche Methoden Entwickler für ihre eigenen Projekte übernehmen können.
Die meisten Entwickler, die schon mit KI-Agenten gearbeitet haben, kennen solche Situationen: Mitten in einer Aufgabe tritt ein Fehler auf, der Agent versucht wiederholt denselben fehlerhaften Befehl und liefert am Ende eine Zusammenfassung, die zwar vollständig aussieht, aber wichtige Ergebnisse auslässt. Mit LongCat-2.5, das Meituan am 2026-11-02 offiziell veröffentlicht hat, liegt der Schwerpunkt darauf, Agenten zum Abschluss ganzer Projekte über lange Zeiträume zu befähigen – statt nur das Kontextfenster von 1M zu betonen.
Dies ist kein Werbetext über Modellparameter. Meituan hat in seinem Technikblog konkrete Details zum Training mit Reinforcement Learning für langfristige Aufgaben veröffentlicht. Zudem hat ein unabhängiger Dritter das Modell am Tag der offiziellen Veröffentlichung bei langen Aufgaben getestet. Dieser Artikel unterscheidet drei Arten von Informationen: das offizielle Trainingsdesign, die offiziellen Benchmark-Ergebnisse und die praktischen Erfahrungen Dritter. Dabei geht es auch darum, was sich jeweils daraus ableiten lässt – und was nicht.
Das Wichtigste: Nach der Lektüre verstehen Sie, warum ein Kontextfenster mit einer Million Token nicht automatisch eine höhere Erfolgsquote bei Projekten bedeutet, mit welchen Methoden LongCat-2.5 seine Fähigkeiten für langfristige Aufgaben verbessert und wie Sie diese Ansätze für Ihre eigenen Agenten nutzen können.
LongCat-2.5: Die wichtigsten Fakten
LongCat-2.5 ist ein nativ multimodales großes Sprachmodell des LongCat-Teams von Meituan. Es ist auf langfristige Agentenaufgaben (Long-Horizon Agentic Tasks) ausgerichtet. Gegenüber LongCat-2.0 wurde es mit zusätzlichen Verläufen langfristiger Aufgaben trainiert. Im Fokus stehen die Entwicklung in komplexen Codebasen und die Erstellung vollständiger Projekte.
| Information | Details |
|---|---|
| Veröffentlichung | Preview am 2026-09-25, finale Version am 2026-11-02 |
| Herausgeber | LongCat-Team von Meituan |
| Modellgröße | Insgesamt 1.6T Parameter, sparse Aktivierung per MoE, rund 48B aktive Parameter pro Token |
| Kontextfenster | 1,048,576 Tokens (etwa 1M), einschließlich Ein- und Ausgabe |
| Schwerpunkte | Langfristige Agentenaufgaben, Agentic Coding, visuelle Programmierung, mehrstufige Tool-Aufrufe |
| Verfügbarkeit | Offizielle Website und API sind verfügbar; eine Veröffentlichung der Gewichte der finalen Version ist noch nicht bestätigt |
Wichtig: APIYI hatte bis zum 2026-11-03 bereits einen Artikel zu LongCat-2.5 veröffentlicht. Darin wurde jedoch darauf hingewiesen, dass das Modell zu diesem Zeitpunkt noch nicht auf der Plattform verfügbar war und später integriert werden sollte. Welche Modelle tatsächlich aufrufbar sind, zeigt die aktuelle Modellliste auf apiyi.com. Die Codebeispiele in diesem Artikel verwenden eine allgemeine, OpenAI-kompatible Schreibweise und lassen sich auf jedes bereits integrierte Modell übertragen.
Warum ein Kontextfenster mit einer Million Token für langfristige Agent-Aufgaben nicht ausreicht
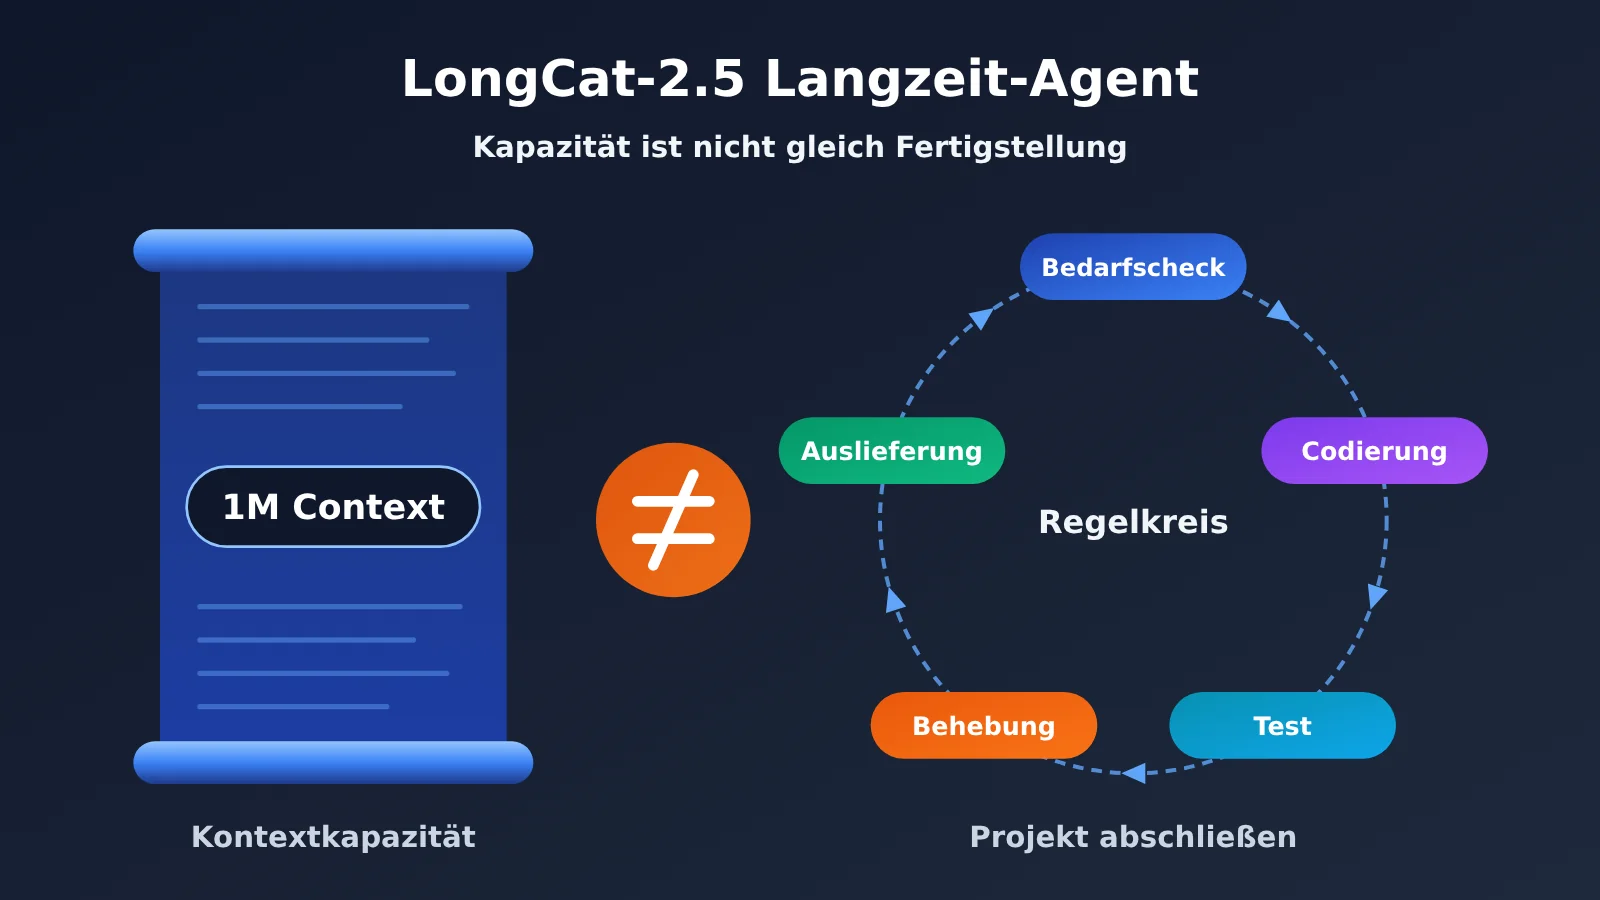
Ein langes Kontextfenster (Long Context) bezeichnet die Gesamtzahl der Token, die eine einzelne Anfrage aufnehmen kann. Ein Fenster mit 1M Token bedeutet, dass das Modell mehr Quellcode, Dokumente und frühere Nachrichten auf einmal einlesen kann. Das hilft tatsächlich beim Verständnis grosser Code-Repositories. Aus dieser Kapazität allein folgt aber nicht, dass das Modell Informationen in langen Dokumenten immer zuverlässig findet, Werkzeugaufrufe dauerhaft funktionieren oder ausgegebene Dateien garantiert korrekt sind.
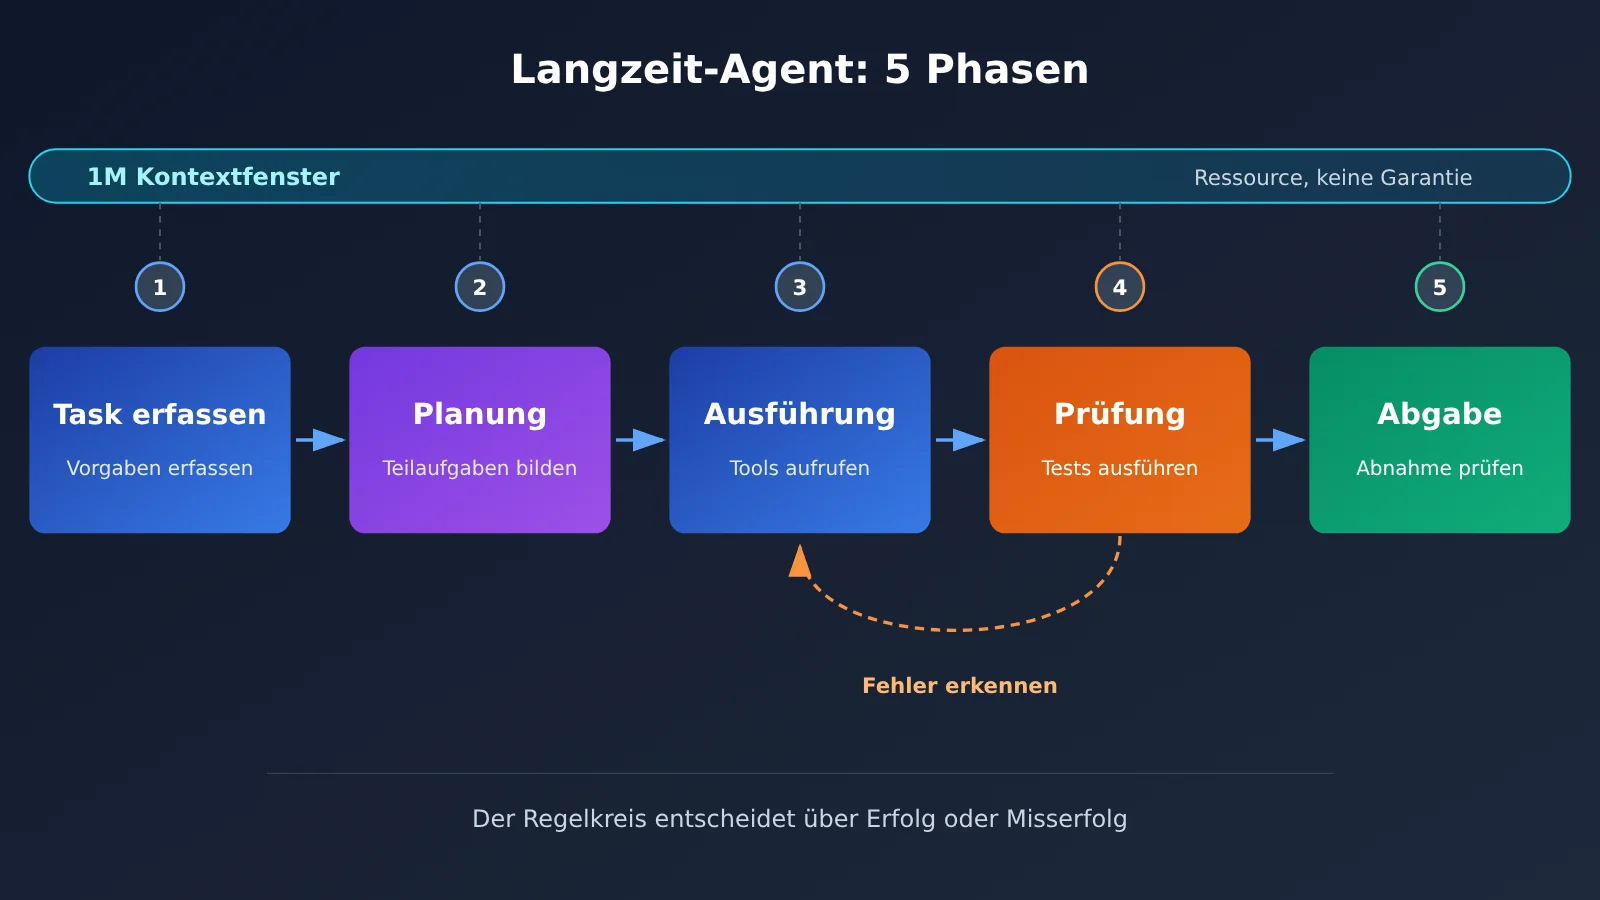
Langfristige Agenten (Long-Horizon Agents) sind eine andere Herausforderung. Sie müssen in einer externen Umgebung viele voneinander abhängige Schritte ausführen: ein Repository lesen, Code schreiben, Werkzeuge aufrufen, Tests ausführen, Fehler erkennen, beheben und erneut prüfen – und am Ende das Ergebnis liefern. Geht bei einem Schritt etwas schief, können alle folgenden Schritte auf einem fehlerhaften Zustand aufbauen.
| Vergleichskriterium | Fähigkeit für lange Kontexte | Fähigkeit für langfristige Agent-Aufgaben |
|---|---|---|
| Grundprinzip | Kapazität einer einzelnen Anfrage | Zuverlässigkeit bei der Ausführung vieler aufeinanderfolgender Schritte |
| Messgrösse | Wie viele Token hineinpassen | Ob die Aufgabe am Ende die Abnahmekriterien erfüllt |
| Zentrale Voraussetzungen | Attention-Mechanismus und Training mit langen Texten | Planung, Werkzeugaufrufe, Nutzung von Fehlerrückmeldungen und Entscheidung, wann eine Aufgabe abgeschlossen ist |
| Typische Fehler | Informationen in langen Texten werden übersehen | Das Ziel wird aus den Augen verloren, Aufrufe werden wiederholt oder Ergebnisse nicht geliefert |
| Bedeutung für den Projekterfolg | Eine von mehreren notwendigen Ressourcen | Entscheidet direkter über Erfolg oder Misserfolg |
Anders gesagt: Das Kontextfenster bestimmt, wie gross die „Werkbank“ ist. Die Fähigkeit für langfristige Aufgaben entscheidet, ob die Arbeit auch fertig wird. Selbst die grösste Werkbank hilft nicht, wenn das Modell seinen Ansatz nach fehlgeschlagenen Tests nicht anpasst oder die ursprünglichen Vorgaben vergisst. Das Projekt kann trotzdem auf halbem Weg scheitern. Genau deshalb legt LongCat-2.5 beim Training den Schwerpunkt auf langfristige Aufgaben.
LongCat-2.5: Ergebnisse bei Benchmarks für langfristige Agent-Aufgaben
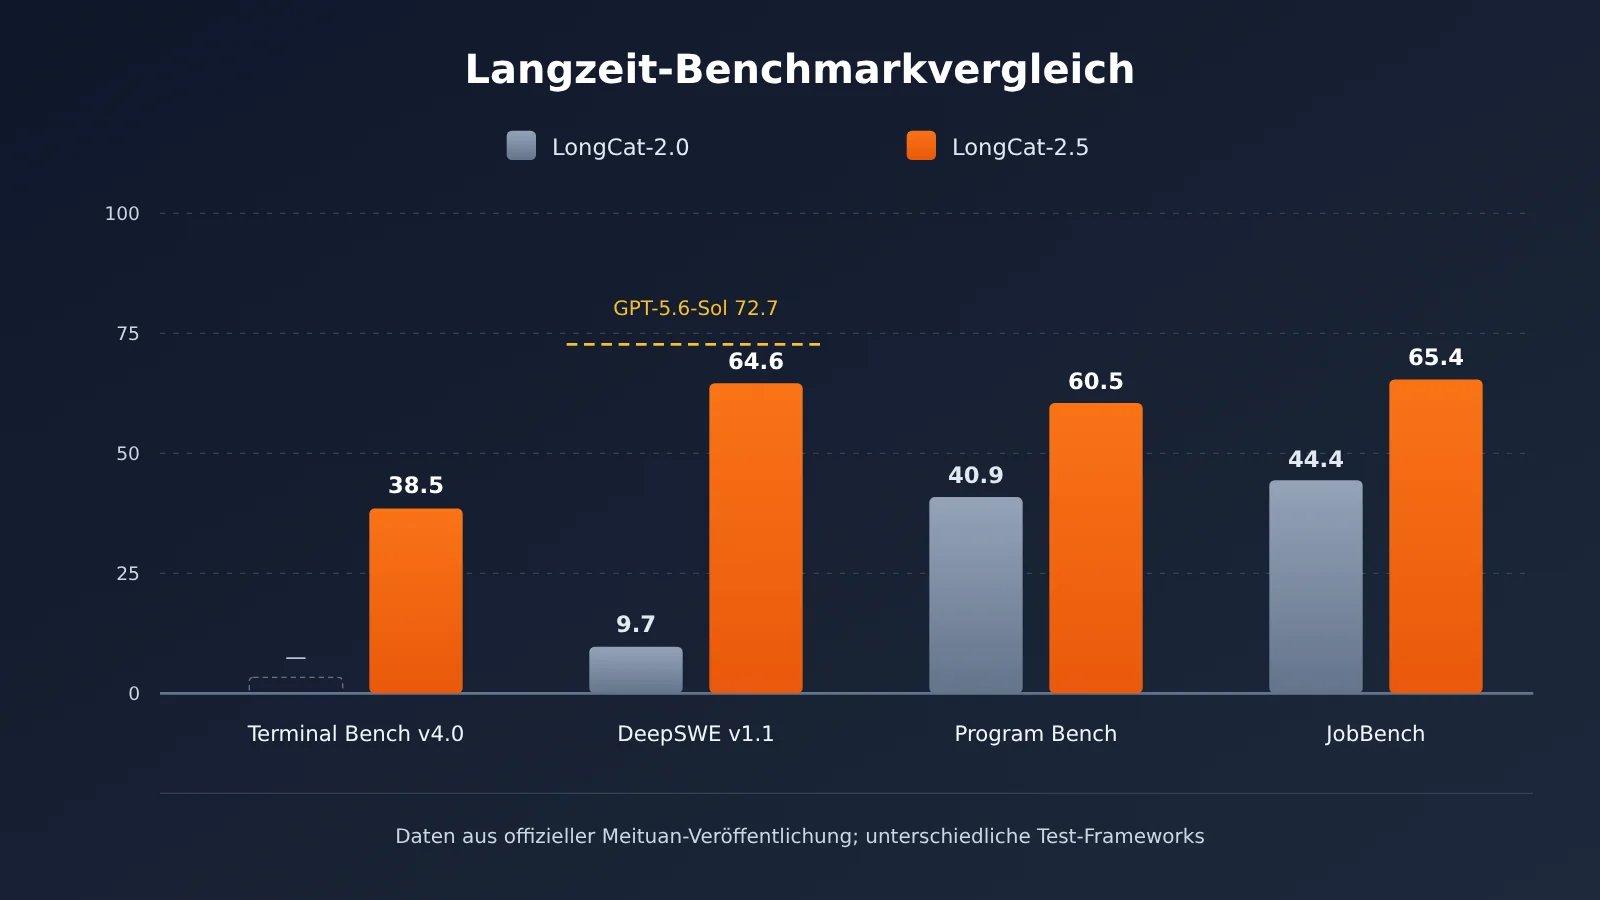
Meituan hat LongCat-2.5 und die Vorgängerversion anhand mehrerer Benchmarks für langfristige Agent-Aufgaben verglichen. Die Werte in der Tabelle stammen aus der offiziellen Veröffentlichung. Die Spalte „Zuwachs“ zeigt die Punktedifferenz, keine relative Prozentsteigerung.
| Benchmark | LongCat-2.0 | LongCat-2.5 | Zuwachs | Was wird gemessen? |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Durchführung realer Aufgaben in einer Terminalumgebung |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Anspruchsvollere, längere Terminalaufgaben |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Langfristige Software-Engineering-Aufgaben |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Wie weit die Programmentwicklung vorangeschritten ist |
| NL2Repo | 40.9 | 60.5 | +19.6 | Erstellung eines Repositorys aus natürlichsprachlichen Anforderungen |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Aufrufe mehrerer Tools |
| JobBench | 44.4 | 65.4 | +21.0 | Professionelle Arbeitsergebnisse bei beruflichen Aufgaben |
Die Fortschritte sind deutlich, bei der Interpretation gibt es aber einige Einschränkungen. DeepSWE steigt von 9.7 auf 64.6, liegt im offiziellen Vergleich aber weiterhin unter den 72.7 Punkten von GPT-5.6-Sol. Bei Terminal Bench v4.0 liegen die 38.5 Punkte knapp über den 37.3 von GPT-5.6-Sol, aber 15.4 Punkte unter den 53.9 von Claude Opus 5. Schwierige Terminalaufgaben sind also noch längst nicht gelöst.
Auch die Testbedingungen sind wichtig. Terminal Bench verwendet das Claude Code Harness, DeepSWE den mini-swe-agent und JobBench eine Bewertung nach dem Prinzip LLM-as-Judge. Die Ergebnisse sind damit jeweils an das konkrete Ausführungsframework gebunden. In der offiziellen Tabelle stammen einige Ergebnisse der Konkurrenz aus öffentlichen Berichten, andere aus eigenen Tests von Meituan. Sie bilden daher keine unabhängige Rangliste unter einheitlichen Bedingungen. Auch der interne Benchmark LongCat AppDev (47.7 → 73.7) ist nicht öffentlich reproduzierbar.
📊 Hinweis zum Vergleich: Benchmarks zeigen nur die Leistung unter einem bestimmten Framework. Entscheidend ist, die Modelle mit eigenen Aufgaben zu testen. Über APIYI apiyi.com lassen sich mehrere bereits angebundene Modelle mit denselben Aufgabenskripten vergleichen. Zusammen mit den offiziellen Ergebnissen hilft das bei der Modellauswahl.
Wie LongCat-2.5 Agents für die Umsetzung ganzer Projekte trainiert
Die im Meituan-Technologieblog vorgestellte Methode für das Training an lang laufenden Aufgaben lässt sich in sechs Bereiche gliedern. Entscheidend ist dabei, zu verstehen, welche typischen Fehler bei solchen Aufgaben die einzelnen Massnahmen jeweils adressieren.
LongCat-2.5: Reale Aufgabenumgebungen und F2P-/P2P-Verifikation
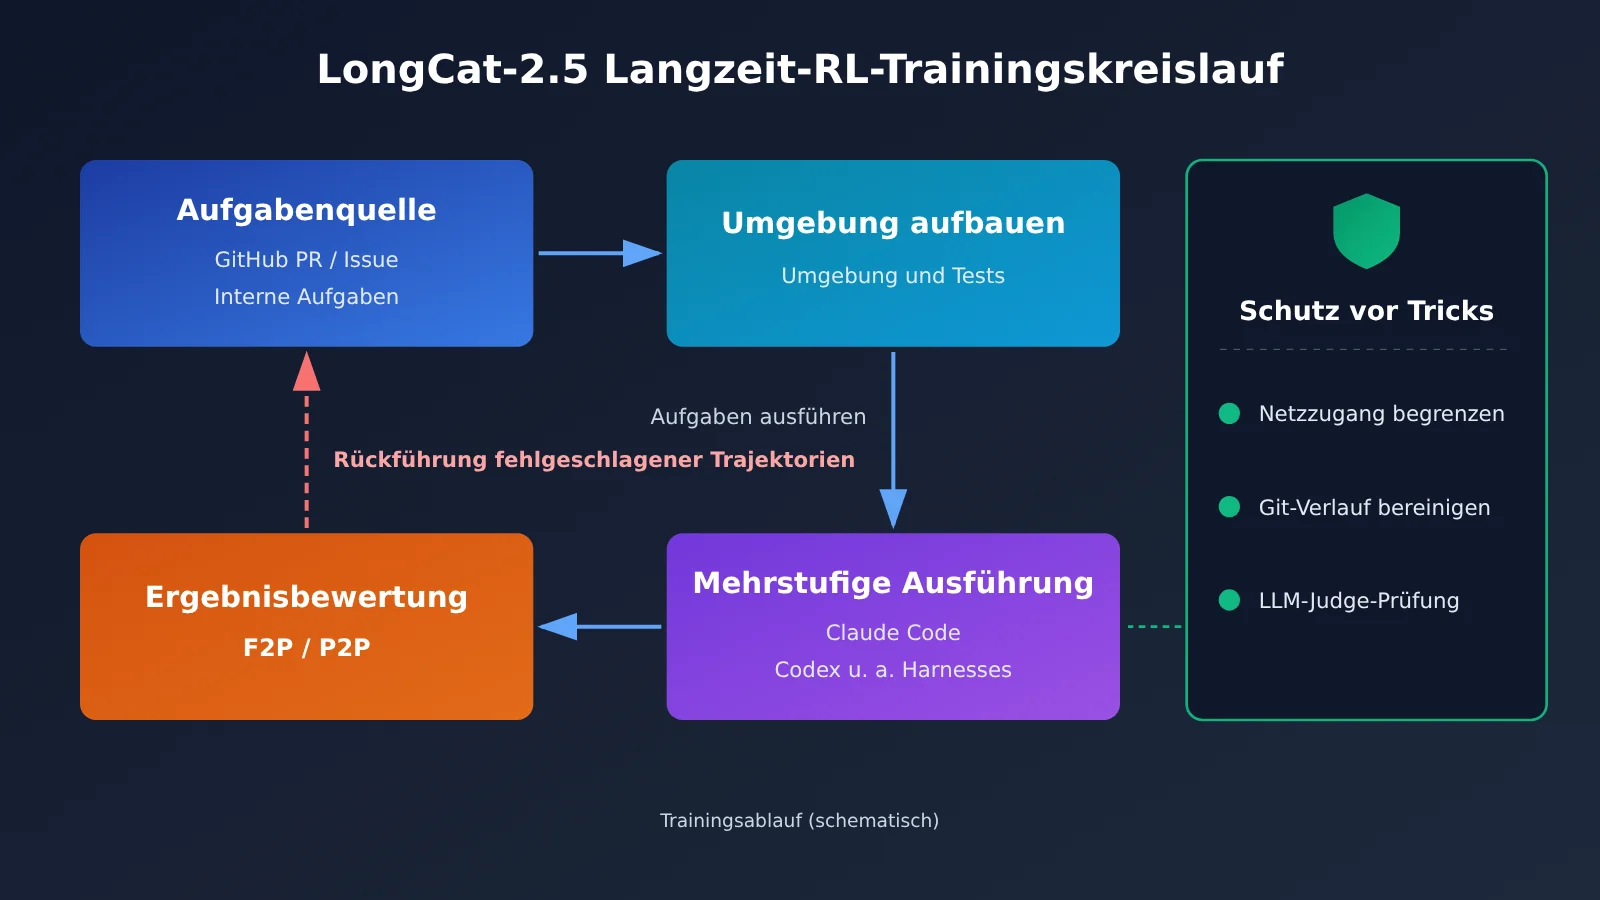
Die Trainingsdaten stammen aus Pull Requests und zugehörigen Issues öffentlicher GitHub-Repositories sowie aus realen internen Programmieraufgaben bei Meituan. Zunächst werden Aufgaben ausgewählt und automatisch von einem Agent annotiert. Anschliessend werden Codeumgebungen erstellt und ausführbare Tests generiert. Das Modell bearbeitet dann die Aufgaben; anhand der tatsächlichen Ausführungsergebnisse wird beurteilt, ob es das Problem gelöst hat. Anders als beim blossen Training mit grossen Mengen an Codetext liefert dieser Ansatz Feedback dazu, ob die Lösung tatsächlich funktioniert.
Für die Verifikation kommen zwei Testarten zum Einsatz: F2P (Fail-to-Pass) prüft, ob zuvor fehlgeschlagene Tests nach der Korrektur bestehen. P2P (Pass-to-Pass) prüft, ob zuvor bestandene Tests weiterhin erfolgreich sind. Ersteres verhindert, dass ein ungelöstes Problem übersehen wird; Letzteres, dass eine Korrektur an anderer Stelle neue Fehler verursacht. Meituan nutzt zudem Trainingsverläufe und Erfolgsquoten, um die Tests selbst auf falsch positive und falsch negative Ergebnisse zu überprüfen. Wie aussagekräftig das ist, hängt allerdings davon ab, wie vollständig die Testfälle die Anforderungen abdecken.
LongCat-2.5: Lernen aus fehlgeschlagenen Verläufen und asynchroner Partial Rollout
Die Entwickler bereiten fehlgeschlagene Verläufe realer Agenten als reproduzierbare und überprüfbare Aufgaben auf. So lassen sich Schwächen erkennen und zusätzliche Trainingsumgebungen schaffen. Das ist vergleichbar mit einem Fehlerheft: Statt nur aus erfolgreichen Beispielen zu lernen, sammelt das Modell auch Aufgaben, die es falsch gelöst hat. Wie viele solcher Verläufe verwendet wurden und wie oft Fehler der jeweiligen Kategorien korrigiert werden konnten, geht aus den öffentlichen Informationen nicht hervor.
Lang laufende Aufgaben unterscheiden sich stark in ihrer Dauer. Ein einzelner komplexer Verlauf kann eine ganze Trainingsbatch ausbremsen. Beim asynchronen Partial Rollout werden mehrere Aufgaben parallel bearbeitet. Sobald die Batch vollständig ist, werden nicht abgeschlossene Verläufe unterbrochen und gespeichert; in der nächsten Runde laufen sie weiter. Gleichzeitig werden Stichprobengruppen herausgefiltert, in denen entweder alle Versuche erfolgreich oder alle fehlgeschlagen sind und die daher keinen brauchbaren Gradienten liefern.
Dabei können Tokens desselben Verlaufs von Modellversionen aus unterschiedlichen Trainingsphasen stammen. Um die dadurch entstehende Verzerrung zu begrenzen, werden die logprob-Unterschiede beschnitten und der Gradientenbeitrag anhand der über den Verlauf akkumulierten Unterschiede angepasst. Diese Technik verbessert die Trainingseffizienz. Daraus lässt sich nicht ableiten, dass das Modell Aufgaben auf Nutzerseite im gleichen Verhältnis schneller ausführt.
LongCat-2.5: Schutz vor Reward Hacking und Training über mehrere Harnesses
Reward Hacking bedeutet, dass ein Modell Lücken im Belohnungssystem ausnutzt, um eine hohe Punktzahl zu erzielen, ohne die Aufgabe tatsächlich zu erfüllen – etwa indem es Antworten vorab einsieht oder Tests umgeht. Meituan begrenzt dafür unter anderem den Netzwerkzugriff in der Trainingsumgebung, bereinigt die Git-Historie und Datei-Caches, lässt Verläufe von einem LLM Judge prüfen und bestraft wiederholtes Nachdenken, wiederholte Tool-Aufrufe und übermässig langes Nachdenken. Das sind Massnahmen zur Risikobegrenzung, kein Beleg dafür, dass das Problem vollständig gelöst ist.
Ein Harness ist das umgebende System, das die Aufgabenausführung eines Modells organisiert. Dazu gehören Tools, Kontextverwaltung und Regeln für den Aufgabenzyklus. Bei LongCat-2.5 werden in der Kaltstartphase einige Beispiele zur Anpassung an verschiedene Frameworks eingesetzt. In der RL-Phase werden unterschiedliche Frameworks wie Claude Code und Codex sowie verschiedene Aufgabentypen gemischt. Das verringert das Risiko, dass sich das Modell nur an eine einzige Eingabeaufforderungsvorlage anpasst, garantiert aber kein vollständig einheitliches Verhalten über verschiedene Tool-Versionen hinweg.
| Trainingsmethode | Gelöstes Praxisproblem | Bekannte Grenzen |
|---|---|---|
| Reale Aufgabenumgebungen | Code schreiben, aber nicht in der Umgebung zum Laufen bringen können | Abhängig von der Qualität der Umgebungen |
| F2P- / P2P-Prüfung | Aufgabe nur scheinbar abschliessen und Regressionen einführen | Durch die Testabdeckung begrenzt |
| Lernen aus fehlgeschlagenen Verläufen | Wiederholtes Auftreten ähnlicher Fehler | Anzahl und Korrekturrate nicht veröffentlicht |
| Asynchroner Partial Rollout | Geringe Trainingseffizienz bei langen Aufgaben | Bedeutet keine schnellere Inferenz |
| Schutz vor Reward Hacking | Vorgetäuschter Erfolg durch Ausnutzen von Lücken | Keine vollständige Lösung behauptet |
| Gemischtes Training über mehrere Harnesses | Versagen beim Wechsel des Agenten-Frameworks | Keine Konsistenz über Versionen hinweg garantiert |
Praxistest eines Dritten: Warum LongCat-2.5 lange Aufgaben teilweise nur unvollständig abschließt
Neben dem offiziellen Trainingskonzept und den Benchmarks bietet ein unabhängiger Praxistest eine weitere Perspektive. TOKRACE integrierte am 2026-11-02 die finale Version von LongCat-2.5 in Claude Code und ließ das Modell mithilfe von Blender, einem Browser und weiteren Werkzeugen 15 kreative Aufgaben bearbeiten.
Ein Erfolg war ein parametrisiertes Bücherregal: Die Abmessungen beider Varianten – 0,8 Meter mit drei Fächern und 1 Meter mit vier Fächern – sowie die geforderte Plattenstärke von 18 mm stimmten. Geliefert wurden zudem sechs Ansichten. Der Prozess dauerte rund 36 Minuten und umfasste 47 Anfragen. Andere Aufgaben zeigten jedoch typische Fehler bei längeren Arbeitsabläufen:
- Struktur- und Einheitenfehler: Für ein Planetengetriebe waren 140 mm gefordert, im erzeugten Projekt wurden jedoch 140 m verwendet. Ein Video wurde ebenfalls nicht geliefert.
- Unvollständige Lieferung: Bei einem chinesischen Tempelhof wurden innerhalb der 60-minütigen Aufgabe nur drei finale Bilder geliefert; einige Ansichten und das Video fehlten.
- Probleme mit räumlichen Beziehungen: Bei einem Modell einer Zweizimmerwohnung fehlten unter anderem Öffnungen für Türen und Fenster, und ein Bett überlappte mit einer Trennwand.
- Abbruch bei längerer Ausführung: Ein Mathematik-Lernvideo wurde nach wiederholten Anfrage-Timeouts nicht fertiggestellt.
Diese Beispiele zeigen: Bei langen Aufgaben reicht es nicht zu prüfen, ob überhaupt ein Ergebnis vorliegt. Stattdessen müssen alle Anforderungen einzeln überprüft werden. Dabei ist zu beachten, dass im Test Grenzen für Anfragen, Zeit oder Ausführungsbudget galten. Nicht jede unvollständige Lieferung lässt sich daher auf mangelnde Fähigkeiten des Modells zurückführen. Zudem handelte es sich nicht um einen strengen Vergleichstest verschiedener Modelle.
Auswirkungen des LongCat-2.5-Trainingsansatzes für langfristige Aufgaben
Auswirkungen auf Agent-Entwickler
- Neue Auswahlkriterien: Bei der Bewertung von Modellen verliert die Kontextlänge an Gewicht. Aussagekräftiger sind Benchmarks für langfristige Aufgaben und die Quote vollständig abgeschlossener realer Aufgaben.
- Validierung bleibt unverzichtbar: Auch wenn ein Modell mit F2P/P2P trainiert wurde, sind in der Produktionsumgebung eigene Tests und Abnahmen nötig. Das zeigen bereits unabhängige Praxistests.
- Auch das Harness-Design ist entscheidend: Die Ergebnisse hängen stark vom Ausführungsframework ab. Wird dasselbe Modell mit einem anderen Aufgabenzyklus eingesetzt, können die Resultate deutlich abweichen.
Auswirkungen auf die Branche großer Sprachmodelle
- Der Trainingsschwerpunkt verlagert sich auf den „Prozess“: Statt nur Code in einer einzelnen Runde zu erzeugen, geht es zunehmend um vollständige Projekte und mehrstufige Entwicklungsaufgaben. Die Fähigkeit, Umgebungen für Reinforcement Learning zu schaffen, wird zu einem neuen Wettbewerbsfaktor.
- Bewertungsmethoden rücken stärker in den Fokus: In Terminal-Bench 2.1 wurden gegenüber Version 2.0 28 der 89 Aufgaben korrigiert. Das zeigt, dass bereits die Testversion selbst die Ergebnisse erheblich beeinflussen kann. Die Branche braucht transparentere Angaben zu den Bewertungsbedingungen.
LongCat-2.5 als Vorbild für die Entwicklung langlebiger Agents
Die Trainingsmethoden von LongCat-2.5 liefern eine klare Anregung für Entwickler: Wenn das Modell auf Phasenvalidierung, Wiederherstellung nach Fehlern und die Vermeidung von Tricks trainiert wird, sollten diese Mechanismen auch ausdrücklich im Agent-System verankert sein. Die folgenden Empfehlungen leiten sich aus den öffentlich beschriebenen Trainingsmethoden ab. Sie sind keine Funktionen, deren Umsetzung offiziell bestätigt wurde.
| Mechanismus | Zugehöriger Trainingsansatz | Umsetzung |
|---|---|---|
| Phasenvalidierung | F2P-Validierung | Nach jeder Teilaufgabe ein Prüfshellskript ausführen |
| Regressionsschutz | P2P-Validierung | Nach jeder Änderung die vollständige Regressionstestsuite ausführen |
| Fehlerprotokollierung | Lernen aus fehlgeschlagenen Abläufen | Fehlermeldungen in eine Fortschrittsdatei schreiben und in die nächste Runde übernehmen |
| Budgetobergrenze | Bestrafung wiederholter Aufrufe | Maximale Rundenzahl, Zeitlimit und Anzahl der Tool-Aufrufe begrenzen |
| Abnahme | Schutz vor Reward Hacking | Tatsächliche Dateien prüfen, statt nur die Zusammenfassung des Modells zu lesen |
Das folgende Minimalbeispiel zeigt eine Agent-Schleife mit Phasenvalidierung, Fortschrittsprotokollierung, Rückführung von Fehlern und einer Budgetobergrenze:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)
MODEL = "gpt-4o-mini"  # Maßgeblich ist die tatsächlich verfügbare Modell-ID in der Modellliste der Plattform
MAX_ROUNDS = 8         # Budgetobergrenze, um Endlosschleifen zu verhindern

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Hier ausgelassen: Modellausgabe analysieren und in Codedateien schreiben
        ok, log = run_check(stage["check"])          # Phasenvalidierung (ähnlich F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Regressionstest (ähnlich P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
Entscheidend an dieser Struktur ist: Für jede Phase gibt es einen ausführbaren Abnahmebefehl, Fehlerprotokolle fliessen in die Eingabeaufforderung der nächsten Runde ein, und der Fortschritt wird in eine Datei geschrieben, statt nur im Kontext zu stehen. Selbst bei einem ausreichend grossen Kontextfenster kann es das Risiko deutlich senken, bei langen Aufgaben vom Ziel abzuweichen, wenn Fortschritt und Einschränkungen als strukturierter Zustand ausserhalb des Kontexts gespeichert werden.
🚀 Tipp für den schnellen Einstieg: Für einen Agent-Prototyp können Sie zunächst über APIYI apiyi.com Testguthaben beziehen und mit demselben API-Schlüssel verschiedene Modelle in der Phasenvalidierungsschleife ausprobieren. So sehen Sie, welches Modell Ihre Aufgabe am vollständigsten erledigt.
Bei Projekten mit hohen Zuverlässigkeitsanforderungen bietet sich zusätzlich eine „Kreuzabnahme“ an: Ein zweites Modell prüft das fertige Ergebnis Punkt für Punkt anhand der Anforderungsliste. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich das ausführende und das prüfende Modell im selben Code aufrufen. Der Wechsel ist mit wenig Aufwand verbunden.
Häufig gestellte Fragen (FAQ)
F1: Bedeutet das 1M-Kontextfenster von LongCat-2.5, dass es große Projekte abschließen kann?
Nicht automatisch. Das 1M-Kontextfenster bezeichnet die Kapazität einer einzelnen Anfrage einschließlich Ein- und Ausgabe. Damit kann das Modell mehr Code und Dokumente einlesen. Für den Abschluss eines Projekts braucht es aber auch Planung, Tool-Aufrufe, Fehlerbehebung und eine Prüfung der Ergebnisse. Genau diese Fähigkeiten hat LongCat-2.5 mit Reinforcement Learning für langfristige Aufgaben gezielt trainiert.
F2: Wie schneidet LongCat-2.5 bei langfristigen Aufgaben im Vergleich zu GPT-5.6-Sol und Claude Opus 5 ab?
Laut der offiziellen Tabelle liegt LongCat-2.5 bei BrowseComp (91.9) und Terminal Bench v4.0 (38.5) knapp vor GPT-5.6-Sol. Bei DeepSWE liegt es mit 64.6 jedoch unter den 72.7 von GPT-5.6-Sol; bei Terminal Bench v4.0 liegt es zudem 15.4 Punkte hinter Claude Opus 5. Da die Test-Frameworks unterschiedlich sind, sollten die Ergebnisse nicht als einheitliche Rangliste betrachtet werden.
F3: Wann ist die finale Version von LongCat-2.5 erschienen? Sind die Modellgewichte Open Source?
Die Preview-Version wurde am 2026-09-25 auf der API-Plattform bereitgestellt, die finale Version erschien am 2026-11-02. Die offizielle Webseite und die API sind verfügbar. Bis zum 2026-11-03 war aber nicht bestätigt, dass die Gewichte der finalen Modellversion öffentlich verfügbar sind. Laut offizieller Ankündigung sollen sie später auf GitHub und Hugging Face erscheinen.
F4: Lässt sich LongCat-2.5 bereits über APIYI aufrufen?
Laut der öffentlichen Mitteilung vom 2026-11-02 war LongCat-2.5 zu diesem Zeitpunkt noch nicht auf APIYI verfügbar; eine spätere Integration war geplant. Den aktuellen Status finden Sie in der Modellliste auf APIYI apiyi.com. Bis dahin können Sie mit bereits verfügbaren Modellen ein Agent-Framework mit Zwischenprüfungen und Rückmeldung von Fehlern aufbauen. Sobald das Modell verfügbar ist, müssen Sie nur die Modell-ID austauschen.
F5: Wie lässt sich die Fähigkeit eines Modells für langfristige Agent-Aufgaben kostengünstig prüfen?
Bereiten Sie am besten 3–5 mehrstufige Aufgaben vor, die Ihrem eigenen Geschäftsalltag nahekommen und über automatische Abnahmeskripte verfügen. Erfassen Sie für jedes Modell die Quote vollständig abgeschlossener Aufgaben, die durchschnittliche Rundenzahl und die Fehlertypen. Über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com können Sie mehrere Modelle mit einem API-Schlüssel im selben Skript vergleichen. Neue Nutzer erhalten außerdem kostenloses Testguthaben für eine erste Prüfung.
F6: Welche bekannten Schwächen hat LongCat-2.5 bei langfristigen Aufgaben?
In Tests unabhängiger Dritter traten unter anderem falsche Maßeinheiten, Fehler bei räumlichen Beziehungen, nicht gelieferte Videos und durch Zeitüberschreitungen abgebrochene Anfragen auf. Auch der Anbieter behauptet nicht, Reward Hacking vollständig gelöst zu haben. Der Umfang der Fehlversuche und die Korrekturquote wurden bislang nicht veröffentlicht. Technische Maße, die Richtigkeit von Informationen und die Vollständigkeit der Ergebnisse müssen weiterhin von Menschen geprüft werden.
LongCat-2.5: Die wichtigsten Erkenntnisse zu langfristigen Agent-Aufgaben
- Kontext ≠ abgeschlossene Aufgabe: 1 Million Token beschreibt die Kapazität, nicht die Erfolgsquote eines Projekts. Langfristige Aufgaben müssen gesondert trainiert werden.
- Training in realen Umgebungen: Aus GitHub-PRs, Issues und internen Aufgaben werden ausführbare Umgebungen erstellt, die Feedback liefern.
- Tests in beide Richtungen: F2P prüft, ob das Problem gelöst wurde; P2P prüft, ob Regressionen eingeführt wurden.
- Aus Fehlern lernen: Fehlgeschlagene Abläufe realer Agenten werden zu überprüfbaren Trainingsaufgaben umgebaut.
- Ergebnisse im Kontext betrachten: Benchmarks hängen stark vom Harness ab. Unabhängige Praxistests zeigen, dass Ergebnisse weiterhin unvollständig bleiben können.
- Auch die technische Umsetzung mitdenken: Prüfungen einzelner Phasen, Fehlerprotokolle, Budgetgrenzen und eine Abnahme der Ergebnisse sind unverzichtbar. APIYI apiyi.com kann beim Vergleich und der Validierung mehrerer Modelle helfen.
Zusammenfassung
Das wichtigste Signal der Veröffentlichung von LongCat-2.5 ist nicht ein weiteres Kontextfenster mit einer Million Token. Vielmehr verschiebt sich der Trainingsschwerpunkt von der Frage „Wie viel kann das Modell lesen?“ zu „Kann es ein ganzes Projekt abschließen?“:
- Die Problemstellung ist präziser: Agenten scheitern bei langfristigen Aufgaben meist an Ausführung, Validierung oder Auslieferung – nicht an fehlendem Kontext.
- Die Trainingsmethoden setzen gezielt an: Reale Aufgabenumgebungen, F2P/P2P, Fehlerverläufe, Partial Rollout, Schutz vor dem Ausnutzen von Schlupflöchern und Training über mehrere Harnesses hinweg adressieren jeweils konkrete Fehlerarten aus der Praxis.
- Die Aussagekraft der Ergebnisse hat Grenzen: Die offiziellen Ergebnisse zeigen deutliche Fortschritte, doch zu den Spitzenmodellen besteht weiterhin Abstand. Unabhängige Praxistests zeigen ebenfalls, dass vollständige Ergebnisse noch menschliche Kontrolle brauchen.
Für Entwickler ist es am sinnvollsten, diese Ansätze im eigenen Agent-System umzusetzen und Modelle anhand ausführbarer Abnahmekriterien zu bewerten, statt nur auf Parameter und Ranglisten zu schauen. Über APIYI apiyi.com lassen sich Modelle mit einer einheitlichen Schnittstelle an realen Aufgaben vergleichen und überprüfen, bevor die Modellkombination für die Produktion festgelegt wird.
📚 Referenzen
- Meituan-Technikteam – technischer Artikel zu LongCat-2.5: Ausführliche Beschreibung der Trainingsmethoden für Agenten mit lang laufenden Aufgaben
- Link:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Hinweis: Originalquelle für Trainingsverfahren wie F2P/P2P, Partial Rollout und Schutz vor Reward Hacking
-
Offizieller LongCat-Blog: Benchmark-Daten und Evaluierungsmethoden
- Link:
longcat.ai/blog/longcat-2.5 -
Hinweis: Vollständige Ergebnistabellen sowie Harness- und Parametereinstellungen für die einzelnen Benchmarks
-
Dokumentation der LongCat-Modellparameter: Kontext- und Ausgabeparameter
- Link:
longcat.ai/platform/docs/zh/api/model-params -
Hinweis: Aufrufparameter wie Kontextlänge, max_tokens und Denkbudget
-
Terminal-Bench: Benchmark für Terminal-Agenten
- Link:
tbench.ai -
Hinweis: Informationen zur Abhängigkeit der Ergebnisse vom Agent-Harness und zu Versionsunterschieden
-
DeepSWE: Benchmark für Software-Engineering-Agenten mit lang laufenden Aufgaben
- Link:
deepswe.datacurve.ai -
Hinweis: Testdesign mit 113 eigens entwickelten Aufgaben und 91 Open-Source-Repositories
-
TOKRACE – LongCat-2.5 im Praxistest: Unabhängiger Test mit 15 kreativen Aufgaben
- Link:
tokrace.com/zh-CN/guides/longcat-2-5-release - Hinweis: Praxisbeispiele wie nur teilweise abgeschlossene lange Aufgaben und Fehler bei Einheiten
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie die APIYI-Website apiyi.com und kontaktieren Sie uns, um sich über die praktische Entwicklung von Agenten für lang laufende Aufgaben und die Auswahl verschiedener Modelle auszutauschen.