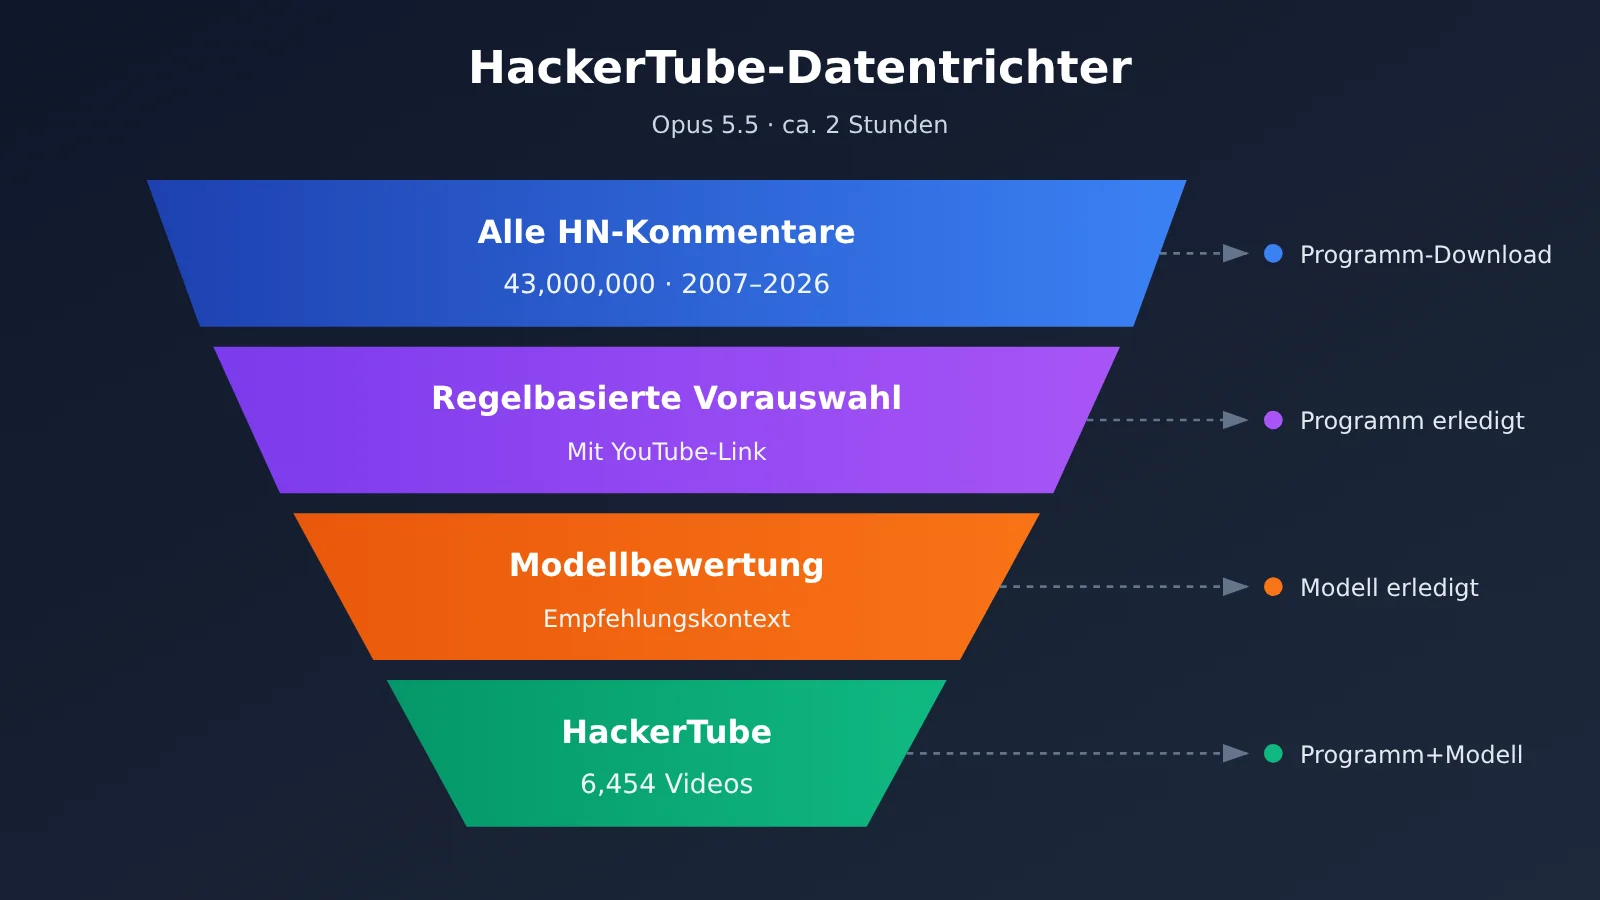
Andrej Karpathy hat an einem Wochenende in etwa zwei Stunden die Videoplattform HackerTube gebaut. Er ließ Claude rund 43 Millionen Kommentare aus 20 Jahren Hacker News durchsuchen und 6.454 YouTube-Videos herausfiltern, die immer wieder empfohlen wurden. Der Großteil der Arbeit bestand darin, mit Claude zu sprechen. Auf X schrieb Karpathy dazu am 01.11.2026: „~2 hours with Opus 5.5“.
Auf Grundlage von Karpathys ursprünglichem Beitrag, der HackerTube-Website und öffentlichen Berichten aus der Community zerlegen wir das Projekt in sechs Schritte, die Entwickler selbst nachvollziehen können. Außerdem zeigen wir die drei Stellen, an denen es am ehesten hakt.
Das nehmen Sie mit: einen Ablauf in sechs Schritten, der die Aufgaben von Mensch, Programm und Modell klar trennt, eine Kostenschätzung mit offengelegten Annahmen und den kürzesten Weg, Claude Code über APIYI unter apiyi.com anzubinden.
Was Karpathys HackerTube eigentlich macht
Kurz gesagt: Karpathy hat die Videoempfehlungen aus 20 Jahren Hacker-News-Diskussionen gesammelt und daraus eine Videoplattform zum Stöbern gemacht.
Karpathys vollständiger Beitrag auf X vom 01.11.2026 um 18:14 Uhr UTC lautet:
„Wochenendprojekt: HackerTube. Ich war von YouTubes Empfehlungen genervt und habe Claude deshalb 43 Millionen Kommentare aus 20 Jahren HN auf 6.454 Videos filtern lassen, die immer wieder empfohlen werden. Ein deutlich besseres Videoerlebnis, etwa 2 Stunden mit Opus 5.5“
Die Seite hackertube.org beschreibt sich so: „Die YouTube-Videos, die Hacker-News-Nutzer einander immer wieder empfehlen.“ Im Kern geht es also nicht um einen Empfehlungsalgorithmus, sondern darum, bestehende Community-Diskussionen semantisch zu filtern.
| Aspekt | Öffentliche Informationen | Quelle |
|---|---|---|
| Datenumfang | Rund 43 Millionen HN-Kommentare aus 20 Jahren, daraus 6.454 Videos ausgewählt | Karpathys Originalbeitrag (01.11.2026) |
| Dauer und Modell | Rund 2 Stunden mit Opus 5.5 | Karpathys Originalbeitrag (01.11.2026) |
| Arbeitsumgebung | Claude Code in der Desktop-Version | Laut Berichten aus der Community |
| Manuelle Schritte | Nur drei Dinge von Hand erledigt: YouTube-API-Schlüssel beantragt, Server eingerichtet und Domain gekauft | Laut Berichten aus der Community |
| Aufbau der Seite | Rund 150 Themen, Zeitraum 2007–2026, keine Anmeldung erforderlich | Laut Auswertungen der Community |
So funktioniert HackerTube
Berichten aus der Community zufolge sagte Karpathy: „Ich spreche nur mit Claude und lasse es alles erledigen.“ Das Herunterladen der Daten, das Schreiben der Filterskripte, die Modellaufrufe zur Bewertung und die Erstellung der Seiten übernahm also größtenteils Claude in Claude Code. Der Mensch formulierte vor allem die Anforderungen und kümmerte sich um Schritte, für die ein Konto oder eine Bezahlung nötig war.
Das ist etwas anderes, als eine KI eine Webseitenvorlage schreiben zu lassen. Die eigentliche Herausforderung liegt in den Daten: 43 Millionen Kommentare passen nicht auf einmal ins Kontextfenster, und ein Link ist noch keine Empfehlung. Das Projekt ist daher eher eine Datenpipeline mit einem schlanken Frontend.
HackerTube mit Opus 5.5 in 6 Schritten nachbauen
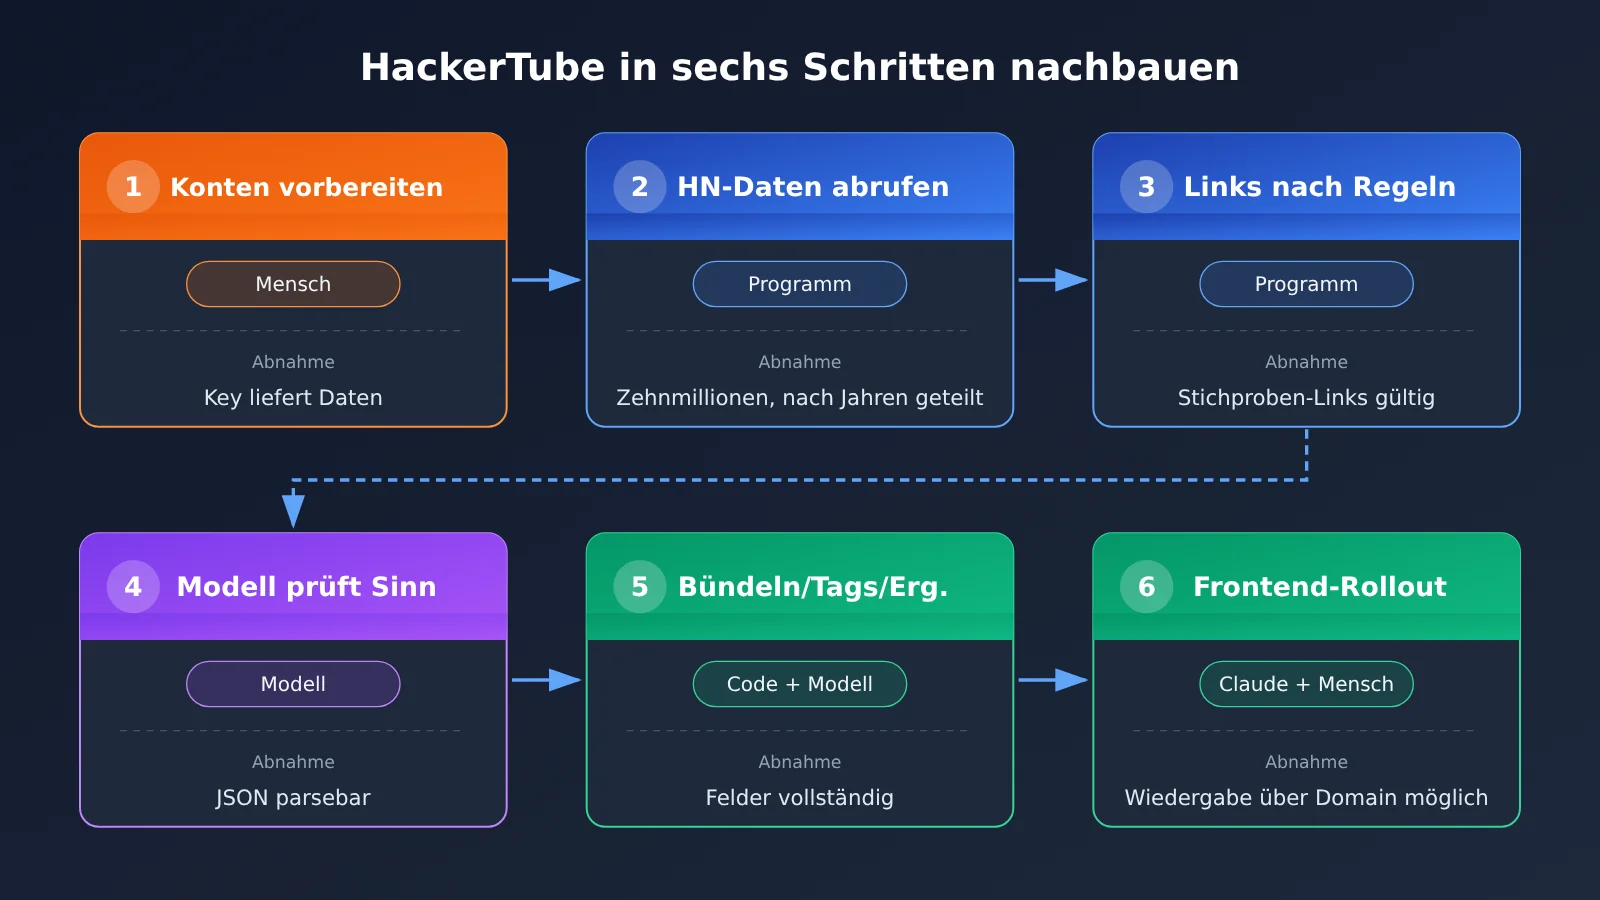
Das Wichtigste vorweg: Lassen Sie zuerst ein Programm die Datenmenge reduzieren. Das Modell übernimmt nur die Entscheidungen, für die sprachliches Verständnis nötig ist. Die folgenden sechs Schritte stehen in der Reihenfolge ihrer Ausführung. Jeder Schritt zeigt, wer ihn übernimmt und wie sich das Ergebnis prüfen lässt.
| Schritt | Was ist zu tun? | Wer übernimmt es? | Wie wird das Ergebnis geprüft? |
|---|---|---|---|
| 1 | YouTube API Key beantragen, Server vorbereiten und Domain kaufen | Mensch | Alle drei sind zugänglich, und der Key liefert Informationen zu einem Video zurück |
| 2 | Sämtliche HN-Kommentare abrufen | Programm (von Claude geschrieben) | Lokal liegen nach Jahren sortierte Dateien; die Anzahl entspricht der erwarteten Grössenordnung |
| 3 | Kommentare mit YouTube-Links per regulärem Ausdruck extrahieren | Programm | 50 Einträge stichprobenartig prüfen und bestätigen, dass jeder einen gültigen Videolink enthält |
| 4 | Das Modell in Batches prüfen lassen, ob es sich um eine Empfehlung handelt; Ergebnis als JSON ausgeben | Modell | Das JSON lässt sich direkt parsen; Stichproben werden von Hand auf Richtigkeit geprüft |
| 5 | Nach videoId aggregieren und zählen, Themen-Tags vergeben sowie Titel und Kanal ergänzen | Programm + Modell | Jedes Video hat vollständige Felder, und die Anzahl der Themen bleibt überschaubar |
| 6 | Frontend-Seite erstellen und bereitstellen | Claude schreibt den Code, ein Mensch verbindet die Domain | Die Domain lässt sich im Browser öffnen; Videos können nach Themen durchsucht und abgespielt werden |
Schritt 1–2: Ressourcen vorbereiten und HN-Daten abrufen
Schritt 1 übernimmt ein Mensch. In der Google Cloud Console ein Projekt erstellen, die YouTube Data API aktivieren und einen API-Schlüssel generieren. Als Server eignet sich ein beliebiger Cloud-Host oder ein statischer Hosting-Dienst. Die Domain wird bei einem Registrar gekauft und für später bereitgehalten. Für alle drei Dinge sind Konten oder Zahlungen nötig – genau diesen Teil hat Karpathy laut den Berichten aus der Community selbst erledigt.
Schritt 2 übernimmt ein von Claude geschriebenes Programm. Für HN-Daten gibt es zwei öffentliche Quellen: Über die offizielle Firebase API lassen sich Einträge einzeln anhand ihrer Item-ID abrufen; auf BigQuery gibt es außerdem einen öffentlichen HN-Datensatz, der sich direkt per SQL abfragen lässt. Für den vollständigen Download empfiehlt sich BigQuery, mit einem Export nach Jahren. Bei der Abnahme zählen nur zwei Punkte: Die Dateien sind nach Zeiträumen aufgeteilt und die Gesamtzahl der Einträge liegt im zweistelligen Millionenbereich.
Schritt 3–4: Regelbasierte Vorauswahl und semantische Prüfung mit Opus 5.5
Schritt 3 ist entscheidend, um Kosten zu sparen, und läuft vollständig per Programm. Reguläre Ausdrücke erkennen Linkformate wie youtube.com/watch und youtu.be/. Nur Kommentare mit Videolinks bleiben erhalten; Kommentar-ID, Zeitstempel und Titel des übergeordneten Beitrags dienen als Kontext. Die Anforderung lässt sich direkt in Claude Code beschreiben, zum Beispiel: „Schreibe ein Skript, das Kommentare mit YouTube-Links herausfiltert und als JSONL speichert.“
Erst in Schritt 4 trifft das Modell eine Entscheidung. Opus 5.5 erhält pro Durchlauf einige Tausend Kommentare und soll ausschließlich strukturierte Ergebnisse ausgeben. Die Felder umfassen videoId, Empfehlungsstatus, Thema und einen repräsentativen Kommentarauszug. In der Eingabeaufforderung muss klar stehen: „Dieses Video ist schlecht“ und „Schau dir das nicht an“ sind keine Empfehlungen. Nur Aussagen, die „sehenswert“ ausdrücken, zählen als Empfehlung. Zur Abnahme wird eine zufällige Stichprobe der Ergebnisse von Hand geprüft, um zu beurteilen, ob die Fehlerquote akzeptabel ist.
Schritte 5–6: Aggregation, Verschlagwortung und Frontend-Deployment
In Schritt 5 kommen zuerst Regeln zum Einsatz, dann das Modell. Das Programm zählt anhand der videoId, wie oft ein Video empfohlen wurde, und ergänzt anschließend Titel und Kanal über die YouTube Data API. Das Modell fasst die Themen-Tags zusammen, damit ähnliche Begriffe wie „Maschinelles Lernen“, „ML“ und „Einführung in Deep Learning“ nicht unnötig aufgespalten werden. Laut Community-Auswertung umfasst HackerTube am Ende rund 150 Themen – ein Anhaltspunkt für den passenden Detaillierungsgrad.
In Schritt 6 werden Daten und Seite getrennt. Das Ergebnis besteht aus einer JSON-Datendatei und einem statischen Frontend, das diese Datei einliest. Die Videos werden per YouTube-iframe eingebettet und nach Thema und Beliebtheit sortiert. Für ein Datenupdate muss nur die JSON-Datei neu erstellt werden; der Seitencode bleibt unverändert. Das Deployment kann auf einem statischen Hosting-Dienst oder einem eigenen Server erfolgen. Zum Schluss richtet ein Mensch die Domain auf das Ziel ein.
🚀 Schnellstart: In den Schritten 4 und 5 sind häufige Modellaufrufe nötig. Wenn du Claude Code über APIYI apiyi.com anbindest, kannst du mit demselben API-Schlüssel zwischen Opus und Sonnet wechseln. Teste den Ablauf zunächst mit einer kleinen Datenmenge und entscheide dann, welches Modell du für den vollständigen Durchlauf verwendest.
Drei Stolperfallen beim Nachbau von HackerTube
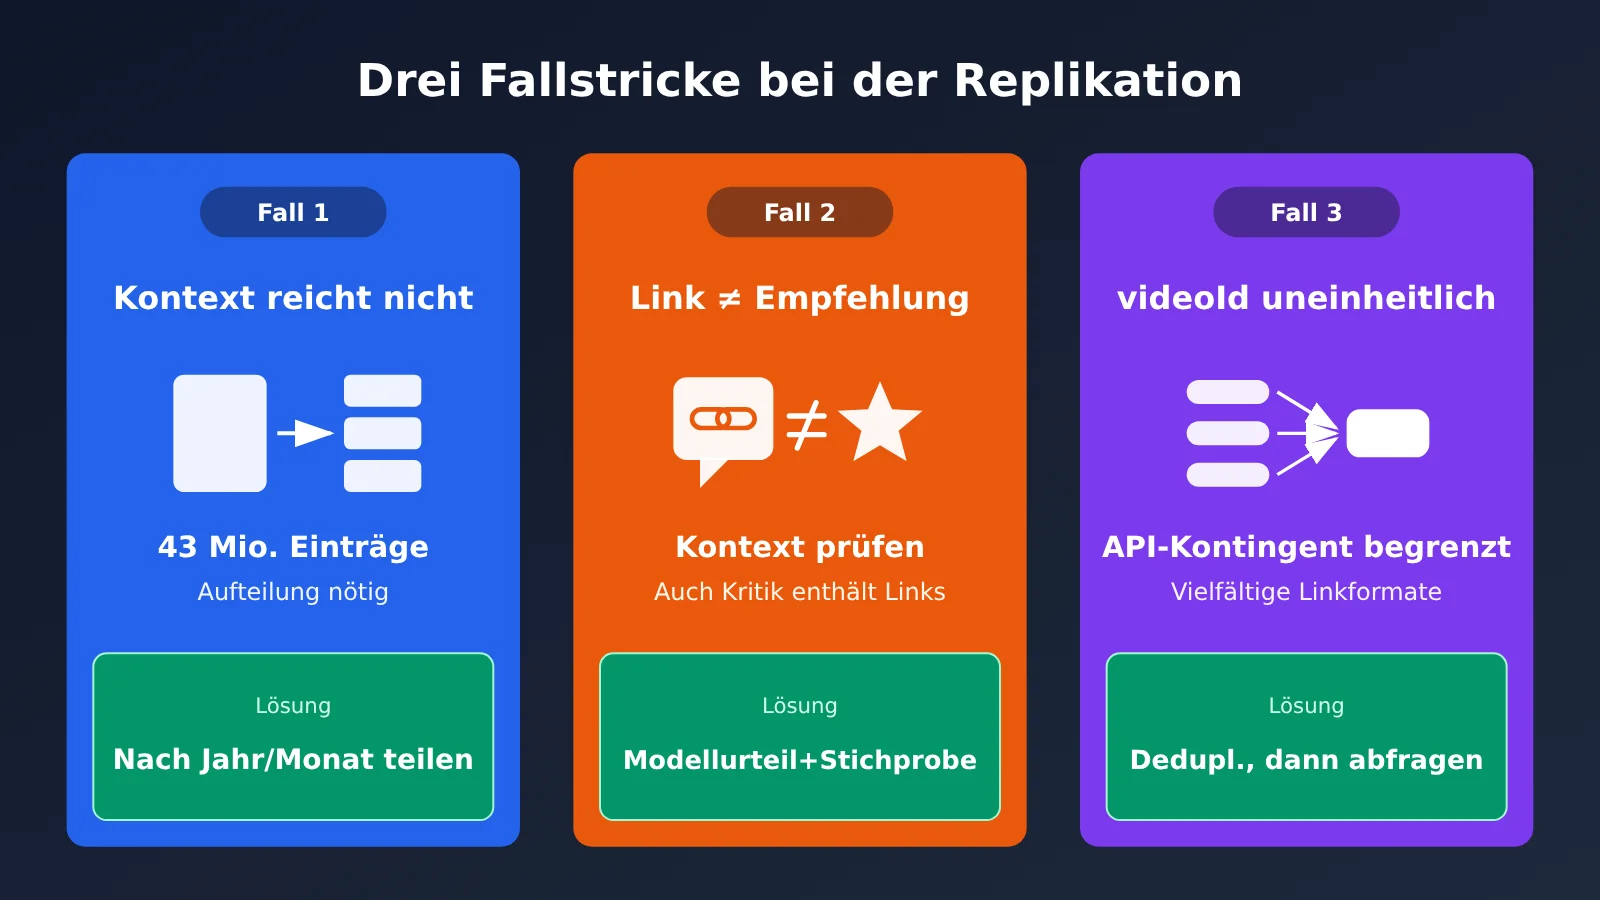
Das Wichtigste vorweg: Die Schwierigkeiten liegen fast alle bei den Daten, nicht beim Erstellen der Website. Die folgenden drei Stolperfallen stehen in der Reihenfolge, in der sie auftreten.
| Stolperfalle | Typisches Problem | Lösung |
|---|---|---|
| Kontextfenster zu klein | Das Modell soll „alle Kommentare lesen“, meldet aber einen Längenfehler oder schneidet die Ausgabe ab | Nach Jahr und Monat aufteilen, einige Tausend Einträge pro Batch verarbeiten und nur strukturiertes JSON ausgeben |
| Link ≠ Empfehlung | Links in kritischen, ironischen oder korrigierenden Kommentaren werden als Empfehlungen gewertet | Das Modell den Kommentar im Kontext beurteilen lassen und Stichproben manuell prüfen |
| Uneinheitliche IDs und begrenztes Kontingent | Unterschiedliche Links zum selben Video, gelöschte Videos, erschöpftes API-Kontingent | Zuerst videoIds vereinheitlichen und dann aggregieren; Metadaten nur für deduplizierte IDs abrufen |
Stolperfalle 1: Das Kontextfenster von Opus 5.5 reicht nicht für 43 Millionen Kommentare
Ein häufiger Anfängerfehler ist, die Aufgabe schlicht so zu formulieren: „Lies alle HN-Kommentare und finde die empfohlenen Videos.“ Egal wie groß das Kontextfenster eines Modells ist: Texte mit mehr als einer Milliarde Tokens passen nicht auf einmal hinein. Besser ist es, Claude zunächst ein Skript zum Aufteilen der Daten schreiben zu lassen. Die Kommentare werden nach Jahr oder Monat in Batches von jeweils einigen Tausend Einträgen aufgeteilt. Das Modell soll dann ausschließlich JSON zurückgeben, ohne erklärenden Text.
Außerdem braucht es einen Mechanismus, um nach einer Unterbrechung fortzufahren: Speichern Sie das Ergebnis jedes Batches separat und halten Sie fest, welche Batches bereits verarbeitet wurden. Tritt ein Fehler auf, müssen Sie nur den fehlgeschlagenen Batch erneut ausführen und nicht von vorne beginnen.
Stolperfalle 2: Ein YouTube-Link ist noch keine Empfehlung
Ein YouTube-Link in einem HN-Kommentar kann eine Empfehlung sein, aber auch ein Gegenbeispiel, Kritik oder ein Hinweis wie „Dieses Video erklärt das falsch“. Wer nur nach URLs sucht, nimmt viel Rauschen in die Ergebnisse auf. Hier muss das Modell den Kontext lesen – das ist der Schritt, für den im gesamten Ablauf tatsächlich ein Großes Sprachmodell benötigt wird.
Geben Sie in der Eingabeaufforderung positive und negative Beispiele an und lassen Sie für jede Entscheidung einen kurzen Beleg aus dem Kommentar ausgeben. So lässt sich bei manuellen Stichproben schnell nachvollziehen, warum das Modell einen Link entsprechend eingeordnet hat. Im Frontend kann dieser Auszug direkt als „Das sagt HN“ auf der Videokarte erscheinen.
Stolperfalle 3: Uneinheitliche videoIds und das YouTube-API-Kontingent
Dasselbe Video kann in verschiedenen Formen verlinkt sein: über youtube.com/watch?v=, youtu.be/, einen mobilen Link oder mit Zeitstempelparametern. Werden diese Links nicht zuerst auf die 11-stellige videoId vereinheitlicht, verteilen sich die Empfehlungen für dasselbe Video auf mehrere Einträge und die Sortierung wird verfälscht. Außerdem wurden über die vergangenen 20 Jahre viele Videos gelöscht oder auf privat gesetzt. Diese müssen separat gekennzeichnet und herausgefiltert werden.
Die YouTube Data API hat ein tägliches Kontingent. Deduplizieren Sie deshalb zuerst die IDs und rufen Sie die Metadaten anschließend gesammelt ab, statt für jeden Kommentar eine Anfrage zu stellen. Über die Batch-Schnittstelle lassen sich mehrere IDs auf einmal abfragen, was den Verbrauch deutlich senkt.
Was kostet es ungefähr, HackerTube nachzubauen? (Schätzung)
Das Wichtigste vorweg: Wer alle Daten von Opus 5.5 verarbeiten lässt, landet bei mehreren Tausend Dollar. Mit einer regelbasierten Vorauswahl lassen sich die Kosten auf einige Dutzend bis wenige Hundert Dollar senken. Alle folgenden Zahlen sind Schätzungen, keine tatsächlichen Rechnungsbeträge.
Zunächst zu den Einzelpreisen. Die folgende Tabelle stammt aus der Modellpreisliste von APIYI. Stand: 27.10.2026, 14:50 Uhr (UTC+8), in US-Dollar pro Million Tokens.
| Modell | Eingabe | Ausgabe | Cache-Lesezugriffe | Verfügbare Plattformen |
|---|---|---|---|---|
| opus-5-5 | $4 | $20 | $0.2 | APIYI apiyi.com, offizielle API |
| sonnet-5-5 | $2 | $10 | $0.1 | APIYI apiyi.com, offizielle API |
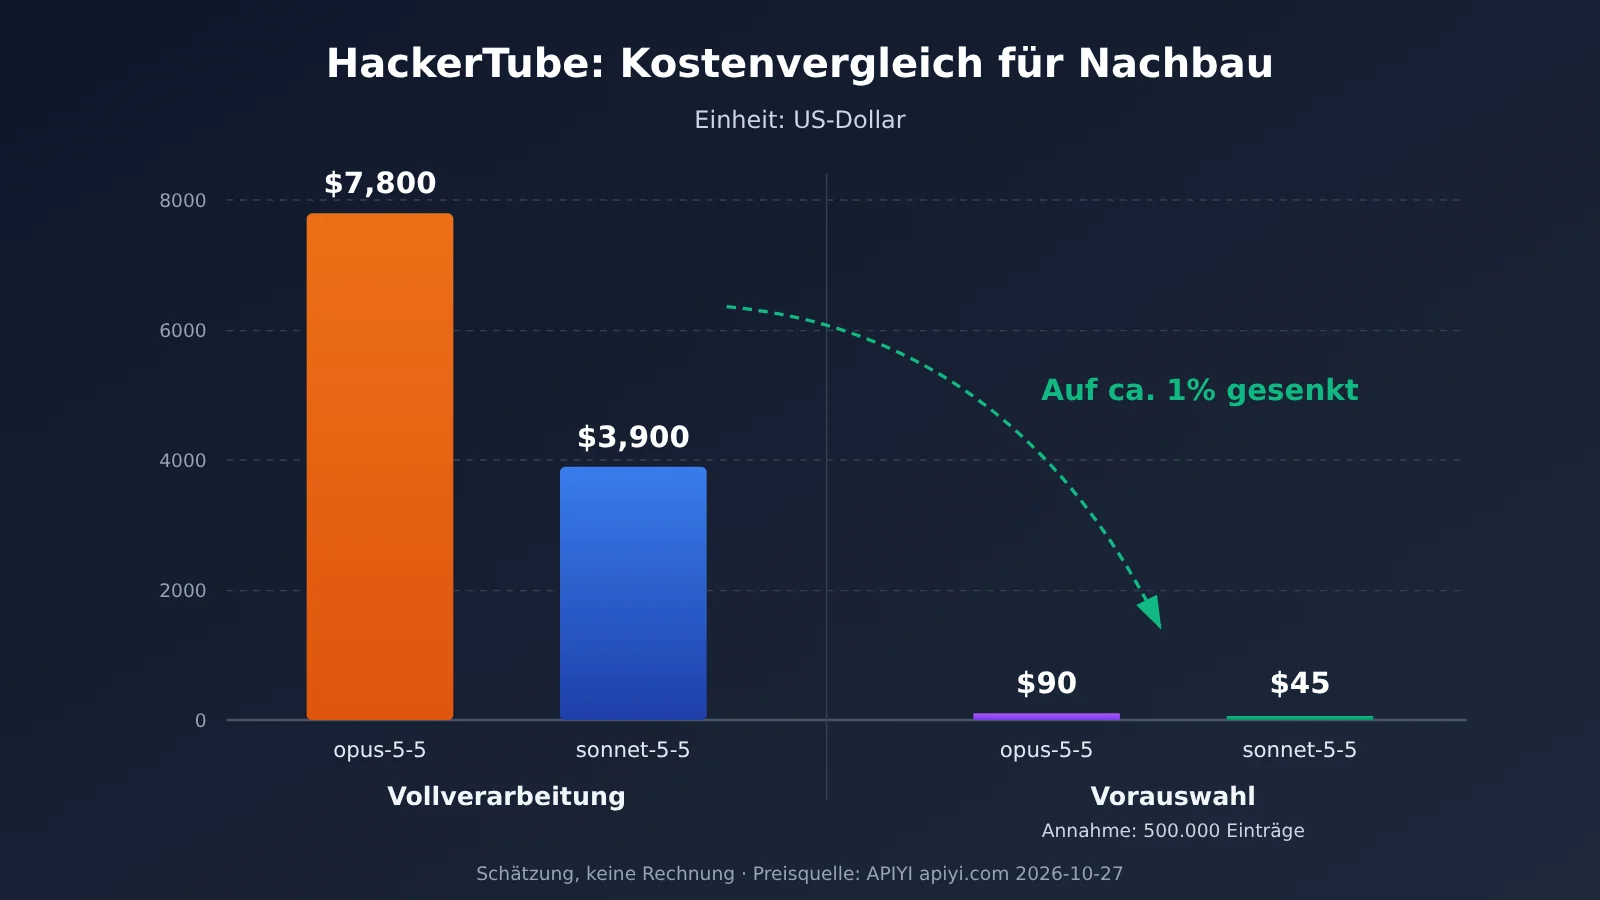
Die Schätzung basiert auf folgenden Annahmen: 43 Millionen Kommentare mit durchschnittlich 30 Tokens pro Kommentar, insgesamt rund 1,3 Milliarden Tokens. Pro Batch fallen 50.000 Eingabe-Tokens und 5.000 Ausgabe-Tokens an, bei insgesamt rund 26.000 Batches. Die „verbleibenden 500.000 Kommentare“ nach der Vorauswahl sind lediglich eine Annahme, um die Berechnung zu zeigen – keine tatsächliche HN-Statistik. Wie viele es wirklich sind, zeigt sich erst nach Schritt 3.
| Vorgehen | Eingabe-Tokens | Ausgabe-Tokens | Schätzung für opus-5-5 | Schätzung für sonnet-5-5 |
|---|---|---|---|---|
| Alle Daten direkt an das Modell übergeben | ca. 1,3 Mrd. | ca. 130 Mio. | ca. $5,200 + $2,600 ≈ $7,800 | ca. $2,600 + $1,300 ≈ $3,900 |
| Zunächst regelbasierte Vorauswahl (angenommen 500.000 verbleibende Kommentare) | ca. 15 Mio. | ca. 1,5 Mio. | ca. $60 + $30 ≈ $90 | ca. $30 + $15 ≈ $45 |
Die Tabelle zeigt: Die regelbasierte Vorauswahl in Schritt 3 entscheidet über die Grössenordnung der Projektkosten. Ausserdem wiederholen sich die System-Eingabeaufforderung und die Positiv- und Negativbeispiele bei jeder Batch-Anfrage. Dank der günstigeren Preise für Cache-Lesezugriffe lassen sich diese Kosten weiter senken. Aus der Community gibt es zudem einen Anhaltspunkt: Der X-Nutzer @thisiskp_ gibt an, mit Opus 5.5 in rund 19 Minuten und für etwa 2 Dollar eine Demo einer Show-HN-Videoseite erstellt zu haben. Das ist allerdings nur ein Einzelfall mit anderem Umfang und anderer Datenmenge und daher nicht direkt vergleichbar.
💰 Kostentipp: Lassen Sie den Ablauf vor dem vollständigen Durchlauf zunächst mit den Daten eines Monats laufen. Notieren Sie den tatsächlichen Token-Verbrauch und multiplizieren Sie ihn mit der Anzahl der Monate, um den Gesamtverbrauch abzuschätzen. APIYI apiyi.com rechnet nutzungsabhängig und ohne feste Monatsgebühr ab – das passt gut zum Ansatz, erst eine kleine Datenmenge zu testen und dann über den Umfang zu entscheiden.
Den HackerTube-Workflow mit Claude Code über APIYI ausführen
Das Wichtigste zuerst: Mit nur zwei Umgebungsvariablen kann Claude Code Opus 5.5 über APIYI aufrufen. Mit demselben Schlüssel lässt sich zwischen opus-5-5 und sonnet-5-5 wechseln.
[Platzhalter für Screenshot: APIYI-Dokumentation zur Anbindung von Claude Code]
Legen Sie gemäß der APIYI-Dokumentation zur Anbindung von Claude Code (docs.apiyi.com/scenarios/programming/claude-code) im Terminal diese beiden Variablen fest:
ANTHROPIC_BASE_URL=https://api.apiyi.comANTHROPIC_AUTH_TOKEN=<你的 APIYI Key>
Starten Sie anschließend Claude Code und wählen Sie in den Modelloptionen opus-5-5 oder sonnet-5-5 aus. In der Praxis bietet sich die Aufteilung „starkes Modell für die Planung, günstigeres Modell für die Ausführung“ an:
- Planung und Codeerstellung mit opus-5-5: Das Modell entwirft die Aufteilung in Teilmengen, schreibt Skripte zum Abrufen und Vorfiltern der Daten und erstellt das Frontend. Hier werden vergleichsweise wenige Tokens benötigt, dafür sind die Qualitätsanforderungen hoch.
- Beide Modelle bei der Bewertung größerer Datenmengen vergleichen: Lassen Sie dieselbe Stichprobe von einigen Hundert Einträgen einmal von opus-5-5 und einmal von sonnet-5-5 bewerten. Vergleichen Sie die Genauigkeit von Hand und entscheiden Sie dann, welches Modell die 26.000 Batches oder die vorgefilterten Batches bearbeiten soll.
- Für die Zusammenführung der Themen zurück zu opus-5-5 wechseln: Die Zusammenführung von rund 150 Themen erfordert einen Überblick über das Ganze. Da nur wenige Aufrufe nötig sind, ist das stärkere Modell hier die sicherere Wahl.
🎯 Technischer Tipp: Nachdem Sie in der APIYI-Konsole auf apiyi.com einen Schlüssel erstellt haben, können Sie für dieses Projekt ein separates Ausgabenlimit festlegen. So bleiben die Kosten unter Kontrolle, falls ein Batch-Skript in einer Aufrufschleife hängen bleibt. Das kostenlose Testguthaben für neue Nutzer reicht aus, um die Beispieldaten eines Monats einmal zu verarbeiten.
Für welche Daten lässt sich Karpathys HackerTube-Methode noch nutzen?
Kurz gesagt: Überall dort, wo umfangreiche Community-Diskussionen Empfehlungen für bestimmte Ressourcen enthalten, lässt sich dieselbe Pipeline einsetzen.
- Technik-Subreddits: Wiederholt empfohlene Bücher, Kurse oder Open-Source-Repositories herausfiltern. Die Pipeline bleibt fast gleich, lediglich der reguläre Ausdruck für Links muss angepasst werden.
- GitHub Issues und Discussions: Häufig zitierte Blogartikel oder Links zu Lösungen extrahieren und zu einer Leseliste für ein Projekt zusammenstellen.
- Interne Team-Chats oder Dokumentkommentare: Content-Teams können in früheren Diskussionen nach Referenzmaterial suchen, das Kollegen wiederholt geteilt haben. Voraussetzung ist, dass die Nutzung der Daten erlaubt ist.
- Podcast- und Paper-Empfehlungen: Den regulären Ausdruck für Links durch ein Muster für arXiv oder Podcast-Plattformen ersetzen, um die von der Community empfohlenen Paper oder Folgen zu finden.
Bei der Übertragung müssen nur zwei Dinge angepasst werden: die Regeln für die Vorauswahl in Schritt 3 und die positiven und negativen Beispiele in der Eingabeaufforderung von Schritt 4. Datenpipeline, gebündelte Modellaufrufe, JSON-Struktur und statisches Frontend lassen sich wiederverwenden.
Häufig gestellte Fragen (FAQ)
F1: Kann man eine Website wie HackerTube ohne YouTube-API-Schlüssel bauen?
Der grundlegende Teil lässt sich umsetzen. Die videoId wird aus Links in den Kommentaren extrahiert, die Wiedergabe erfolgt über eingebettete iframes – beides funktioniert ohne API-Schlüssel. Es fehlen allerdings Metadaten wie Titel und Kanal. Zunächst kann ein Modell anhand des Kontexts in den HN-Kommentaren Beschreibungen erzeugen; den Schlüssel kann man später ergänzen.
F2: Wie kommt man an die Kommentardaten von Hacker News?
Es gibt zwei Wege: Über die offizielle Firebase-API von HN (github.com/HackerNews/API) lassen sich Einträge anhand ihrer item ID abrufen – das eignet sich für inkrementelle Updates. Der öffentliche HN-Datensatz auf BigQuery eignet sich dagegen für einen einmaligen vollständigen Export. Wer das Projekt vollständig nachbauen möchte, sollte vorzugsweise Letzteren nutzen.
F3: Warum nicht einfach einen Empfehlungsalgorithmus entwickeln?
Karpathys ursprünglicher Beitrag entstand aus Unzufriedenheit mit den Empfehlungen von YouTube. HackerTube nutzt 20 Jahre kollektive Einschätzungen der Community, braucht keine Daten zum Nutzerverhalten und hat kein Kaltstartproblem. Es lässt sich innerhalb von zwei Stunden erstellen; ein Empfehlungsalgorithmus braucht dagegen Zeit, um Daten zu sammeln, und muss laufend optimiert werden.
F4: Wurde das Projekt in „zwei Stunden“ vollautomatisch umgesetzt?
Nicht vollständig. Berichten aus der Community zufolge beantragte Karpathy den YouTube-API-Schlüssel selbst, richtete einen Server ein und kaufte eine Domain. Den Rest erledigte er im Dialog mit Claude. Der Mensch bleibt dafür verantwortlich, Anforderungen zu formulieren, die Ergebnisse zu prüfen und Schritte zu übernehmen, für die ein Konto nötig ist. Wer das Projekt nachbaut, sollte außerdem Zeit für die Anpassung der Eingabeaufforderungen und manuelle Stichproben einplanen.
F5: Können die Kosten bei dieser Methode außer Kontrolle geraten?
Wer die Vorauswahl überspringt und alle Daten direkt an das Modell übergibt, muss mit geschätzten Kosten von mehreren Tausend US-Dollar rechnen. Die Kosten können also tatsächlich aus dem Ruder laufen. Drei Maßnahmen helfen: zunächst eine regelbasierte Vorauswahl treffen, dann eine Stichprobe von einem Monat zur Kostenschätzung verarbeiten und schließlich bei APIYI auf apiyi.com ein Nutzungslimit für den API-Schlüssel festlegen. Maßgeblich für verfügbare Modelle und Preise ist die Modellliste der Plattform.
Zusammenfassung
Karpathys HackerTube zeigt: Mit Claude Code und Opus 5.5 kann eine einzelne Person an einem Wochenende aus Millionen von Community-Diskussionen ein nutzbares Produkt machen. Entscheidend ist dabei das Design der Datenpipeline – nicht, dass „KI automatisch eine Website schreibt“.
- Ablauf: Ressourcen vorbereiten → Daten abrufen → regelbasiert vorfiltern → Modell urteilen lassen → aggregieren und mit Labels versehen → deployen. Menschen, Programme und Modelle übernehmen jeweils klar abgegrenzte Aufgaben.
- Herausforderungen: Kontext sinnvoll aufteilen, Empfehlungen im jeweiligen Zusammenhang erkennen, videoId normalisieren und API-Kontingente einhalten.
- Kosten: Der vollständige Durchlauf liegt bei mehreren Tausend US-Dollar. Mit Vorfilterung können die Kosten auf einige Dutzend bis über hundert US-Dollar sinken. Massgeblich sind die Daten aus einem eigenen Testlauf mit einer kleinen Stichprobe.
- Einstieg: Mit zwei Umgebungsvariablen kann Claude Code über APIYI opus-5-5 und sonnet-5-5 aufrufen.
Wenn Sie die Methode auf Ihre eigenen Daten anwenden möchten, beginnen Sie am besten mit einer kleinen Stichprobe aus einem Monat. Testen Sie den gesamten Ablauf über APIYI auf apiyi.com mit dem kostenlosen Guthaben, bevor Sie sich für einen grösseren Durchlauf entscheiden.
Quellen
- Karpathys ursprünglicher Beitrag (2026-11-01): Ankündigung von HackerTube
- Link:
x.com/karpathy/status/2116957135661945283 -
Beschreibung: Quelle aus erster Hand zu Datenumfang, Laufzeit und Modell
-
HackerTube-Website: Das fertige Projekt
- Link:
hackertube.org -
Beschreibung: Zeigt die Themenkategorien und die Gestaltung der Seiten
-
APIYI-Dokumentation zur Anbindung von Claude Code: Konfiguration der Umgebungsvariablen
- Link:
docs.apiyi.com/scenarios/programming/claude-code -
Beschreibung: Schritte zur Anbindung von Claude Code
-
APIYI-Preisübersicht: Preise pro Modell
- Link:
docs.apiyi.com/models -
Beschreibung: Massgebliche Übersicht zu Modellen und Preisen
-
Offizielle Dokumentation zur Hacker News API: Datenabruf
- Link:
github.com/HackerNews/API - Beschreibung: Struktur der Items und Methoden zum Abrufen