Anmerkung des Autors: Dieser Artikel stellt den Kontext von Gemini 4 Neon, die vier Thinking-Intensitätsstufen und die Preisgestaltung vor. Er erklärt, wie du bei APIYI die beiden Zugänge – nativ und kompatibel – konfigurierst und mit derselben minimalen Anfrage häufige Integrationsfehler eingrenzt.
Kurz gesagt: Gemini 4 Neon wurde am 18. November 2026 von Google veröffentlicht. APIYI hat den Dienst am 20. November in den Gruppen default/svip freigeschaltet. Die Modell-ID lautet gemini-4-neon, der Listenpreis beträgt pro Million Token: Eingabe $3, Ausgabe $15, Cache-Lesen $0.15.Wenn du die Thinking-Stufe nativ steuern möchtest, nimm vorrangig den nativen Gemini-Endpunkt; wenn du in einem bestehenden OpenAI-Client nur das Modell austauschen willst, ist der kompatible Endpunkt unkomplizierter. In beiden Fällen solltest du jedoch zuerst mit einer minimalen Anfrage einen erfolgreichen Durchlauf erzielen und dann Schritt für Schritt Streaming, Tool-Aufrufe und höhere Thinking-Stufen aktivieren.
Dies ist kein Nachrichtenartikel, der eine Pressemitteilung nacherzählt. Die folgenden Parameter, Preise, Benchmark-Ergebnisse und Fehlerbehebungswege enthalten jeweils Quellenangaben und Gültigkeitsbedingungen; die Codebeispiele sind anhand der offiziellen Dokumentation aufgebaut. In der APIYI-Ankündigung zur Freischaltung heißt es, vor dem Launch sei lediglich die Preis-API geprüft und es seien keine tatsächlichen Aufrufe durchgeführt worden. Deshalb stellt dieser Artikel weder den Betrieb über beide Endpunkte noch Tool-Aufrufe als „getestet und funktionierend“ dar.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du die Spezifikationen und die Abrechnungslogik von Neon einordnen, zwei minimale Anfragen für den nativen und den kompatiblen Zugang formulieren, die Thinking-Stufe anhand der Testergebnisse wählen und Probleme anhand der Fehlersymptome schnell eingrenzen.
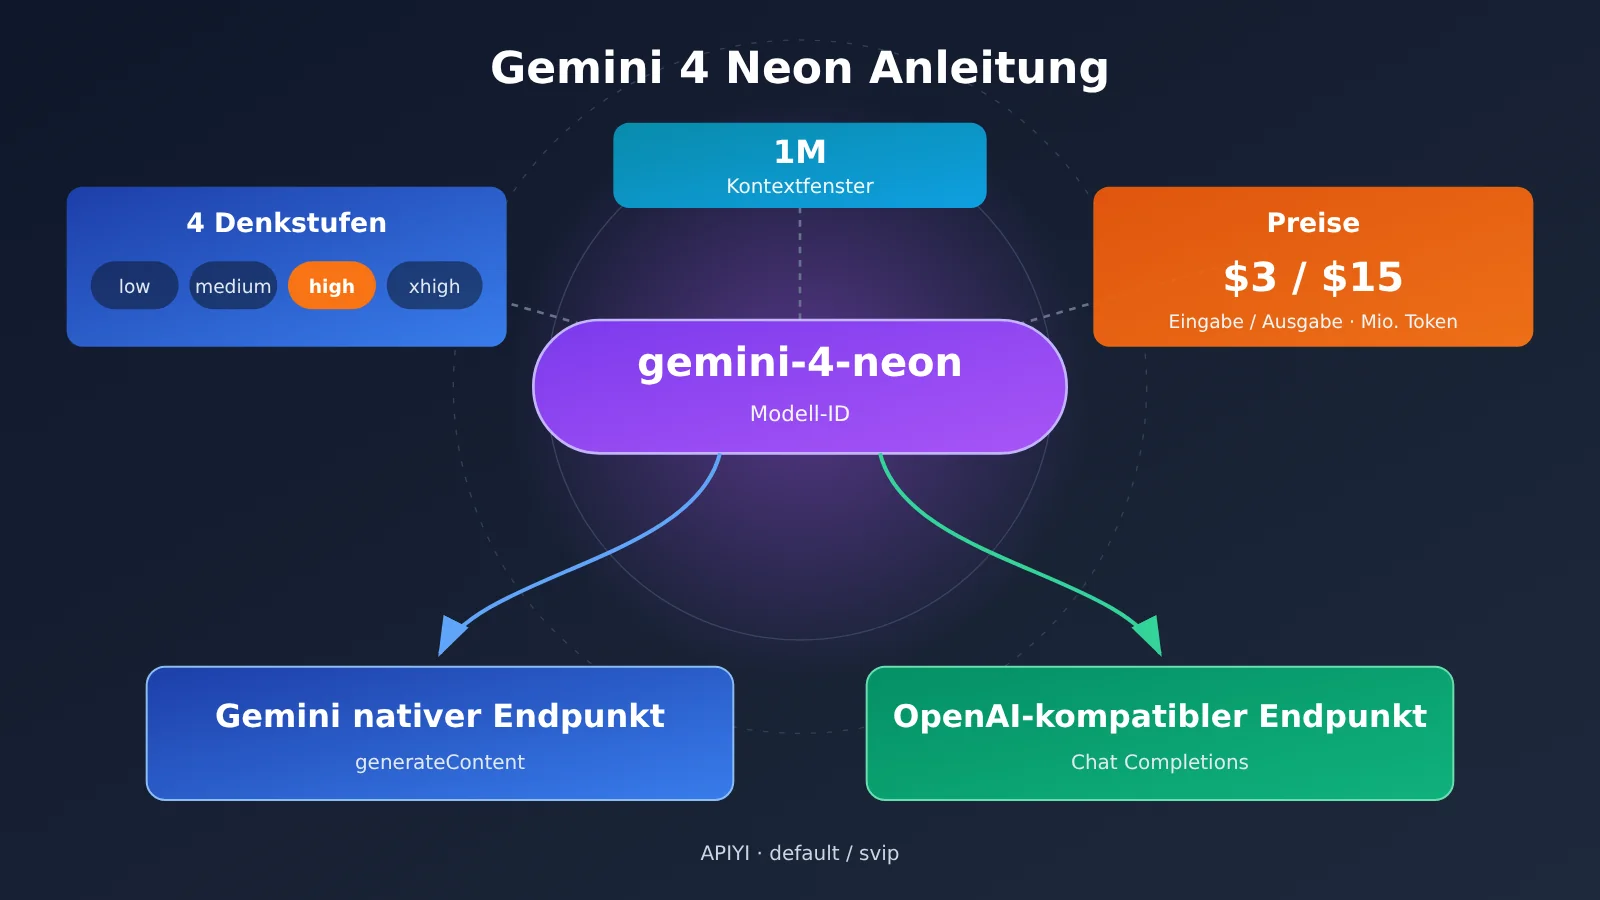
Begriffe, die Sie vor der Integration von Gemini 4 Neon kennen sollten
Die folgenden Konzepte tauchen im weiteren Verlauf immer wieder auf. Wenn wir die Bezeichnungen vorab einheitlich festlegen, kommt es bei der Fehlersuche deutlich seltener zu Verwechslungen.
- Modell-ID: der vollständige String, mit dem die Anfrage das Modell angibt – in diesem Artikel
gemini-4-neon. Groß-/Kleinschreibung und Bindestriche müssen exakt übernommen werden, kürzen Sie ihn nicht eigenmächtig ab. - Base URL: die Root-Adresse, an die der Client den Anfragepfad anhängt. Ob ein Versionspräfix wie
/v1enthalten sein muss, hängt vom verwendeten SDK ab – eine falsche Konfiguration ist die häufigste Ursache für 404-Fehler. - Nativer Gemini-Endpunkt: empfängt das
generateContent-Protokoll und eignet sich für Szenarien, in denen die nativen Denk-Parameter benötigt werden. - OpenAI-kompatibler Endpunkt: verwendet das Chat-Completions-Format, sodass bestehende OpenAI-Clients die grundlegende Nachrichtenstruktur direkt wiederverwenden können.
- Denkstufe: der Enum-Wert für die Inferenzintensität des Modells. Neon unterstützt nativ
low,medium,highundxhigh; bei APIYI ist die dynamisch gekennzeichnete Standardstufehigh. - Denk-Signatur
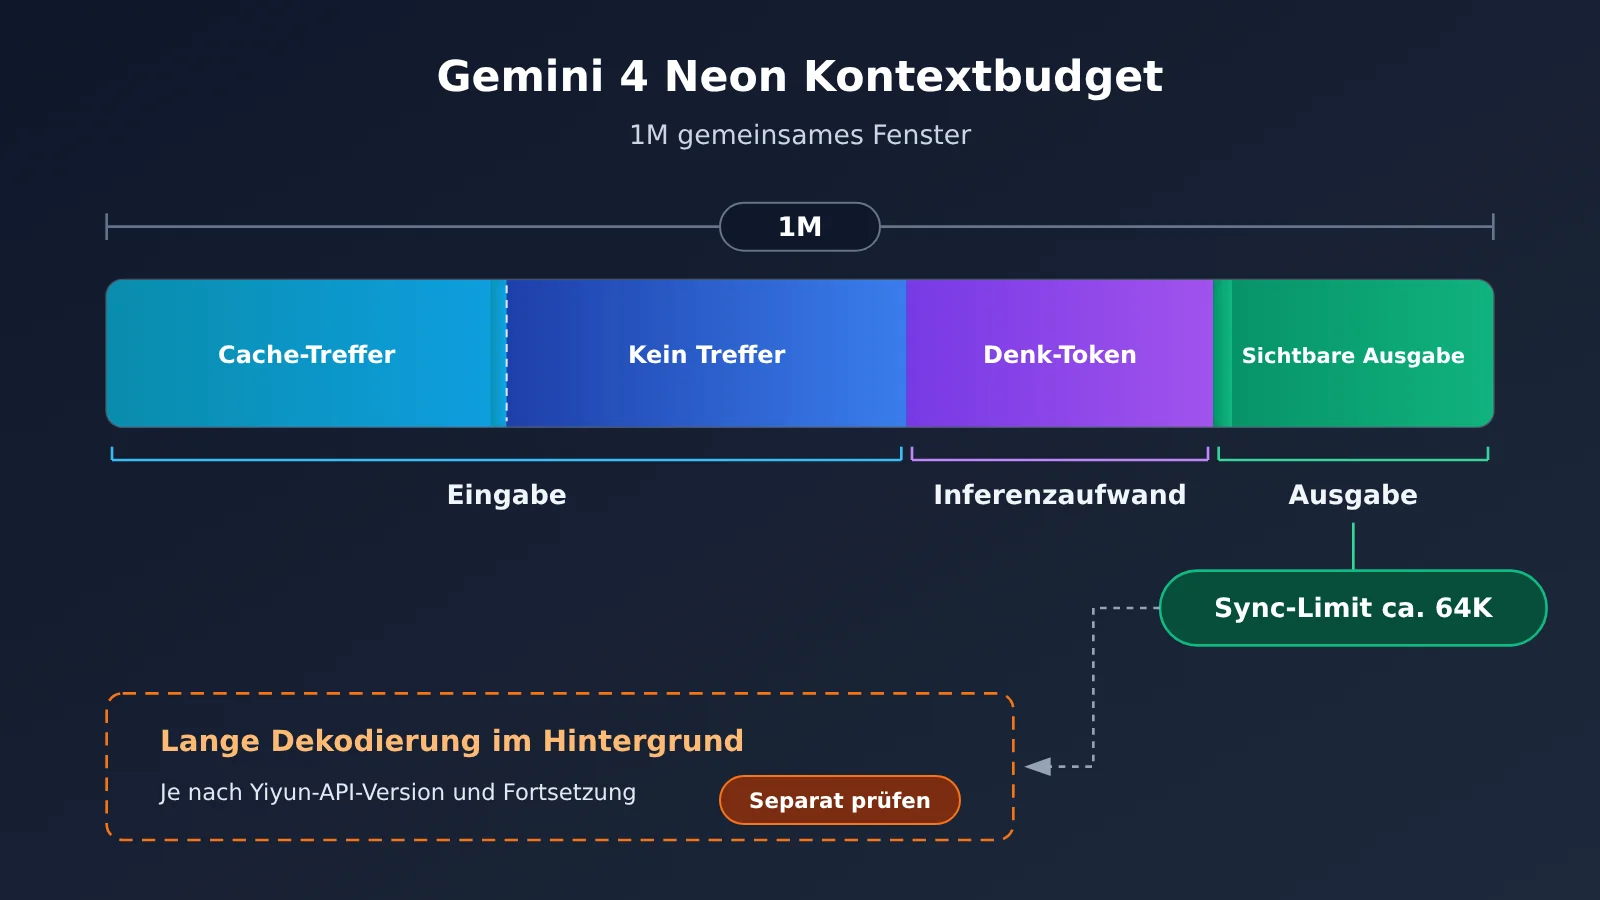
thoughtSignature: eine vom Modell zurückgegebene Kontextmarkierung. Bei mehrstufigen Tool-Aufrufen muss sie gemäß dem ursprünglichen Protokoll beibehalten und zurückgesendet werden. - Kontextfenster: das gemeinsame Gesamtbudget für Eingabe, Denken und Ausgabe. Wie viel eine einzelne synchrone Generierung tatsächlich ausgeben kann, sollten Sie separat anhand des Obergrenzenwerts prüfen.
- Cache-Lesepreis: der Abrechnungspreis, der gilt, wenn eine bereits vorhandene, den Bedingungen entsprechende Eingabe wiederverwendet wird – er liegt deutlich unter dem Standard-Eingabepreis.
Gemini 4 Neon: Kernpunkte – Parameter, Preise und Gruppen
Laut dem Launch-Update von APIYI ist Neon die mittlere Stufe der Gemini-4-Serie und liegt zwischen Carbon (für die schwierigsten Aufgaben) und Hydrogen (für alltägliche Ausführung). Google veröffentlichte es am 18. November und machte es am selben Tag allgemein verfügbar (GA); APIYI integrierte es am 20. November.
| Punkt | Inhalt | Quelle und Bedingung |
|---|---|---|
| Modell-ID | gemini-4-neon |
APIYI-Modellregister (erstellt am 2026-11-20) |
| Verfügbare Gruppen | default, svip |
APIYI-Launch-Update (2026-11-20) |
| Anbindungsendpunkte | Gemini nativ + OpenAI-kompatibel | APIYI-Launch-Update; vor dem Launch nicht real getestet |
| Kontextfenster | 1M, gemeinsam genutzt von Eingabe/Denken/Ausgabe | Google-Ankündigung und Artificial Analysis nennen beide 1M |
| Obergrenze für synchrone Generierung | ca. 64K Token | APIYI-Launch-Dokumentation |
| Denkstufen | low/medium/high/xhigh, Standard: high | APIYI-Launch-Update |
| Listenpreis (pro Million Token) | Eingabe $3, Ausgabe $15, Cache-Lesen $0.15 | APIYI-Register; laut Ankündigung in allen Punkten mit der offiziellen Website identisch, ohne Ablaufdatum |
Zusammenhang zwischen Kontextfenster und Ausgabeobergrenze bei Gemini 4 Neon
Ein 1M-Kontext wird oft fälschlich als „kann auf einmal 1M ausgeben“ interpretiert. Tatsächlich ist dieses 1M ein Fenster, das Eingabe, Denken und Ausgabe gemeinsam nutzen. Laut APIYI-Launch-Dokumentation liegt die Generierungsobergrenze bei synchronen Aufrufen bei etwa 64K Token. Das bedeutet: Lange Eingaben sind kein Problem, aber bei einer einzelnen synchronen Anfrage sollte man nicht erwarten, dass die Ausgabe diese Größenordnung überschreitet.
Die Google-Cloud-Dokumentation erwähnt eine Hintergrundfunktion für lange Dekodierung, die bis zu 1M erreichen kann. Sie hängt jedoch von einer bestimmten Cloud-API-Version und Fortsetzungsbedingungen ab und ist nicht dasselbe wie ein normaler synchroner Aufruf. Für den APIYI-kompatiblen Chat-Completions-Endpunkt gibt es derzeit keine überprüfbaren tatsächlichen Aufrufergebnisse für lange Dekodierung. Wenn Ihr Anwendungsfall sehr lange Ausgaben erfordert, sollten Sie zuerst eine segmentierte Generierung entwerfen und die Langdekodierung separat verifizieren.
Wie man die Preise für Gemini 4 Neon schätzt
Das folgende Beispiel basiert auf den Listenpreisen und stellt keine echte Rechnung dar. Angenommen, eine Anfrage hat 100K Token Eingabe und 5K Token sichtbare Ausgabe: Die Eingabekosten betragen etwa $0.30, die Ausgabe etwa $0.075, zusammen etwa $0.375. Wenn davon 80K Eingabe den Cache treffen, kostet dieser Teil bei $0.15 etwa $0.012, die restlichen 20K bei $3 etwa $0.06 – die Eingabekosten sinken deutlich.
Wie die beim Denken verbrauchten Token abgerechnet werden und unter welchen Bedingungen der Cache greift, sollte man stets anhand der tatsächlichen Abrechnung prüfen. Das APIYI-Launch-Update erwähnt außerdem, dass die befristeten Preise für Carbon/Argon zum 1. Dezember nach Ablauf wieder auf $4/$20 zurückgehen; dann liegt der Listenpreis von Neon 25 % darunter. Dies ist ein Preisvergleich aus der Plattformankündigung und kein Vergleich der Ergebnisqualität.
Gemini 4 Neon Schnellstart: Zwei minimale Anfragen – nativ und kompatibel
Empfehlung: Schicken Sie auf beiden Pfaden jeweils eine kürzeste Anfrage und prüfen Sie, ob Modell-ID, Gruppe und Routing korrekt sind, bevor Sie weitere Funktionen hinzufügen. Die folgenden Beispiele sind nach den offiziellen Dokumentationen des Google GenAI SDK und des OpenAI SDK aufgebaut; für den Key wird durchgehend ein Platzhalter verwendet.
| Vergleichspunkt | Gemini nativer Endpunkt | OpenAI-kompatibler Endpunkt |
|---|---|---|
| Empfohlenes SDK | Google GenAI SDK | OpenAI SDK |
| Schreibweise der Base URL | Plattform-Basisadresse, zusätzlich api_version="v1beta" |
Basisadresse mit /v1 |
| Anfragestruktur | contents[].parts[] |
messages[] |
| Denkstufe | generationConfig.thinkingConfig.thinkingLevel |
Parameter-Mapping über Endpunkte hinweg muss separat abgenommen werden |
| Geeignete Szenarien | Feingranulare Steuerung des Denkens, mehrstufige Tool-Aufrufe | Schneller Wechsel bestehender OpenAI-Codes |
Beispiel für den nativen Gemini 4 Neon Endpunkt
Beim nativen Endpunkt verwenden Sie die Plattform-Basisadresse; das Versionspräfix übernimmt das api_version des SDK. Schreiben Sie v1beta nicht zusätzlich in die Base URL, sonst entsteht ein doppelter Pfad.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # APIYI Plattform-Basisadresse, Version wird über api_version festgelegt
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
Die Snake-Case-Benennung des SDK entspricht letztlich den CamelCase-Feldern im REST-Anfragekörper. Wenn Sie direkt eine HTTP-Anfrage senden, sieht die Anfragestruktur ungefähr so aus – achten Sie besonders auf die beiden Ebenen:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Zwei Punkte sind zu beachten. Erstens: Die alten Stufen thinkingBudget und minimal gelten für Gemini 4 nicht und müssen bei der Code-Migration entfernt werden. Zweitens: Laut Google-Dokumentation ignoriert Gemini 4 temperature und topP; dass sich bei diesen beiden Parametern keine Wirkung zeigt, ist erwartetes Verhalten.
Gemini 4 Neon – Beispiel für den kompatiblen Endpunkt
Der kompatible Endpunkt eignet sich für Projekte, die bereits das OpenAI SDK verwenden. Im Folgenden wird nur das grundlegendste Feld messages verwendet, um zunächst zu prüfen, ob Routing und Gruppierung funktionieren.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-kompatibler Endpunkt von APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "Erkläre in drei Sätzen, was ein Kontextfenster ist"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
Neben dem eigentlichen Antworttext empfiehlt es sich, auch finish_reason zu protokollieren. Ist der Text leer, liefert dieses Feld den ersten Hinweis. Beim nativen Endpunkt entsprechen dem die Felder für Endgrund und Sicherheitsbewertung in den Kandidatenergebnissen – auch die sollten bei der Fehlersuche erhalten bleiben.
Wrapper-Code mit Diagnoseinfos anzeigen
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Hier die oben genannte kompatible Endpunktadresse eintragen
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Ruft gemini-4-neon auf und gibt Endgrund sowie Verbrauch aus – praktisch für die Fehlersuche"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("Text leer: Endgrund, Sicherheitsstatus und Ausgabebudget prüfen")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Nur bei Ratenbegrenzung und kurzfristiger Nichtverfügbarkeit erneut versuchen, andere Fehler direkt auslösen
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("Nenne drei Aufgaben, die sich für langen Kontext eignen"))
🚀 Schnellstart: Wenn Sie im APIYI-Konsolenbereich auf apiyi.com ein Token erstellen, prüfen Sie, ob die Token-Gruppe zu
defaultodersvipgehört. Neue Nutzer können mit dem kostenlosen Testkontingent zunächst die beiden oben gezeigten Minimalanfragen je einmal ausführen. Nativer und kompatibler Endpunkt teilen sich denselben Key; beim Wechsel des Endpunkts müssen nur Base-URL und Anfragestruktur angepasst werden.
Wie man die Denkstufe bei Gemini 4 Neon wählt
Je höher die Stufe, desto gründlicher die Inferenz – allerdings steigen auch Laufzeit und Kosten. Artificial Analysis (AA) hat die vier Stufen von Neon im Intelligence Index v5.0.1 einzeln getestet. Die Ergebnisse:
| Denkstufe | AA-Intelligenzindex | Ø Zeit pro Aufgabe | Anmerkung |
|---|---|---|---|
low |
44 | ca. 3,7 Minuten | Geschwindigkeit im Vordergrund |
medium |
55 | ca. 8,3 Minuten | 11 Punkte mehr als low |
high (Standard) |
60 | ca. 14,8 Minuten | 5 Punkte mehr als medium |
xhigh |
61 | ca. 21,5 Minuten | gewichtete Kosten ca. $6,44 pro Benchmark-Aufgabe |
Wie diese Daten zeigen, bringt der Sprung von medium zu high noch einen spürbaren Zugewinn, während high zu xhigh nur einen einzigen Indexpunkt mehr liefert – bei rund 6,7 Minuten zusätzlicher Zeit pro Aufgabe. Die Zahlen stammen aus der Benchmark-Pipeline von AA; die Aufgabenkosten werden nach der Gewichtung der neun Tests berechnet. Für Szenarien wie das Lesen von Dokumenten oder interaktive Frage-und-Antwort-Runden musst du Laufzeit und Rechnung selbst messen – ebenso die End-to-End-Latenz, die Erfolgsquote und die tatsächliche Abrechnung bei APIYI.
So findest du die passende Stufe: Bei latenzempfindlichen Frage-und-Antwort-Aufgaben startest du mit low oder medium. Brauchst du mehrstufige Inferenz, bleibst du bei der Standardeinstellung high. Erst wenn dein eigenes, festes Testset bestätigt, dass xhigh eine echte Verbesserung bringt, investierst du die zusätzliche Zeit und das zusätzliche Geld.
Gemini 4 Neon im Vergleich zu Modellen gleicher Positionierung
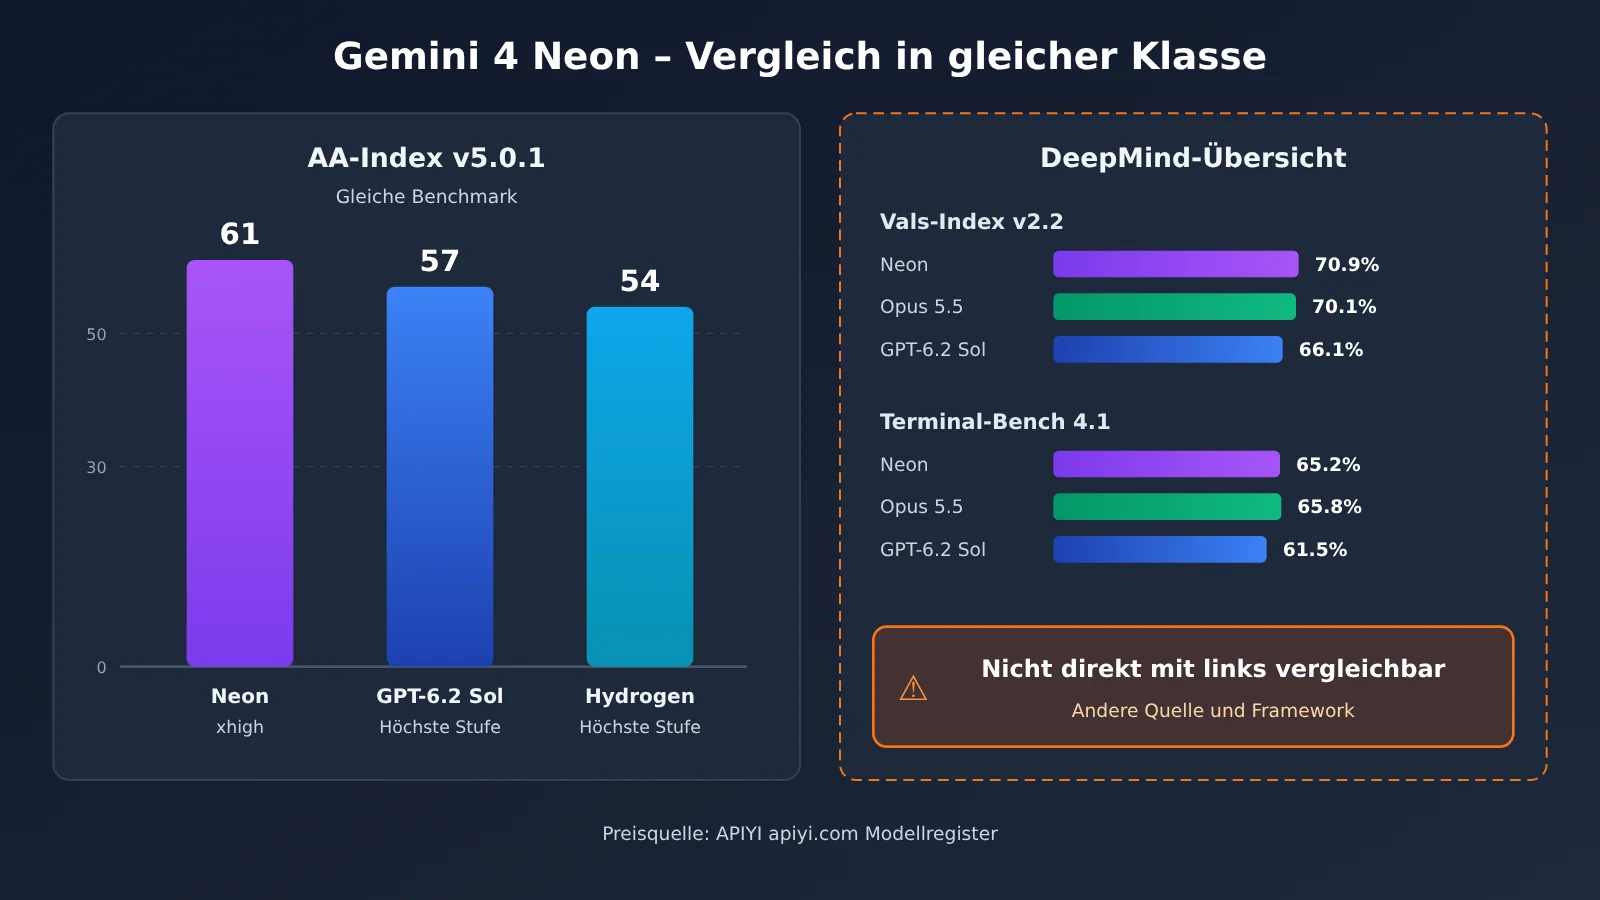
Beim Vergleich über Modelle hinweg sollten möglichst dieselbe Benchmark und vergleichbare Stufen verwendet werden. Die ersten beiden Spalten der folgenden Tabelle stammen aus derselben AA-Version, die Preise aus dem APIYI-Register.
| Modell | AA-Index v5.0.1 (höchste Stufe) | Standard-Eingabe/Ausgabe (pro Million Token) | Verfügbare Plattformen |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | $3/$15 | APIYI apiyi.com u. a. |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI u. a. |
| Gemini 4 Hydrogen | 54 | laut Modellregister | APIYI u. a. |
GPT-6.2 Sol ist im Listenpreis günstiger: Ein- und Ausgabe kosten jeweils ein Drittel weniger als bei Neon. Auf derselben AA-Benchmark liegt Neon mit xhigh jedoch 4 Punkte über der höchsten Stufe von Sol. Zu beachten ist, dass sich ein Punkteunterschied nicht direkt in einen Unterschied der fachlichen Genauigkeit umrechnen lässt; auch Latenz und tatsächlicher Token-Verbrauch müssen jeweils separat gemessen werden.
Eine weitere Referenz ist die von Google DeepMind veröffentlichte Auswertungsübersicht: Im Vals Index v2.2 erreicht Neon 70,9 %, Claude Opus 5.5 70,1 % und GPT-6.2 Sol 66,1 %; bei Terminal-Bench 4.1 liegen die angepassten Genauigkeiten in dieser Reihenfolge bei 65,2 %, 65,8 % und 61,5 %. Diese Übersicht nutzt ausdrücklich unterschiedliche Evaluierungsquellen und Laufzeit-Frameworks; bei Terminal-Bench liegt Opus 5.5 sogar leicht über Neon. Sie taugt als Richtungsreferenz, für die Auswahl sollten aber dieselben Aufgaben in Ihrer eigenen Toolchain maßgeblich sein.
💡 Auswahlempfehlung: Stellen Sie 20 bis 50 feste Testaufgaben zusammen, die Ihr reales Geschäft repräsentieren, rufen Sie damit über APIYI apiyi.com mit demselben Key nacheinander die verschiedenen Stufen von Neon und die Kandidatenmodelle auf und entscheiden Sie erst, nachdem Sie Genauigkeit, Laufzeit und Abrechnung notiert haben.
Fehlerbehebung bei häufigen Zugriffsfehlern mit Gemini 4 Neon
Wenn Probleme auftreten, greifen Sie zuerst auf die kürzeste Anfrage von oben zurück und vergleichen Sie damit – so bestätigen Sie, dass die Basisverbindung steht, und können dann die neu hinzugekommenen Funktionen gezielt prüfen.
| Symptom | Zuerst prüfen | Behebung |
|---|---|---|
| 404 / Modell nicht verfügbar | Modell-ID, Token-Gruppe, Routing, Versionspräfix | gemini-4-neon unverändert übernehmen; beim OpenAI SDK den Kompatibilitäts-Endpunkt mit /v1 verwenden, beim GenAI SDK die Basisadresse plus v1beta; doppelt angehängte Versionspräfixe vermeiden |
| 400 / Verhalten weicht nach dem Umschalten der Stufe ab | native Thinking-Parameter, Felder im Request-Body der Kompatibilitätsschicht | Am nativen Endpunkt mit thinkingLevel prüfen, ob die Stufe tatsächlich greift; thinkingBudget und minimal entfernen; Felder der beiden Protokolle nicht vermischen |
| 200, aber leerer Antworttext | Finish-Grund, Sicherheitsstatus, Ausgabe-Budget | Prüfen, ob das Ausgabe-Budget sowohl das Denken als auch die sichtbare Ausgabe abdeckt; Sicherheitsfilter-Informationen einsehen |
| Tool-Aufruf schlägt in der zweiten Runde fehl | thoughtSignature, Paarung von Tool-Aufrufen und Antworten |
Die Thought-Signatur unverändert zurücksenden und jede Tool-Antwort dem passenden Aufruf zuordnen |
| 429 / kurzzeitige 503 vom Upstream | Fehlerkörper, Token-Limits, Parallelitätsgrenzen | Bei kurzzeitigem Rate-Limiting oder Nichtverfügbarkeit exponentielles Backoff mit Jitter und begrenzter Versuchszahl einsetzen; bei Guthaben- oder Berechtigungsproblemen erst die Konfiguration korrigieren, dann erneut senden |
Gemini 4 Neon: 404 und 400 unterscheiden
Ein 404 heißt meist, dass die Anfrage gar nicht erst an dieses Modell geroutet wurde – das Problem liegt im „nicht gefunden“: falsch geschriebene ID, die Token-Gruppe enthält dieses Modell nicht, oder die URL wurde zu einem doppelten Pfad wie /v1/v1/... bzw. /v1beta/v1beta/... zusammengesetzt. Ein 400 dagegen heißt: Die Anfrage ist angekommen, aber der Request-Body verletzt das Protokoll. Am häufigsten passiert das, wenn native Felder in eine kompatible Anfrage gestopft werden oder wenn alte Parameter aus der Gemini-2.x-Ära weiterverwendet werden.
Die Parameterzuordnung über verschiedene Endpunkte hinweg muss separat abgenommen werden. Wenn Sie auf einem kompatiblen Endpunkt die Denkintensität steuern wollen und nicht das erwartete Ergebnis bekommen, prüfen Sie zuerst auf dem nativen Endpunkt, ob die Stufe tatsächlich greift, und entscheiden Sie erst dann, ob es ein Parameterproblem oder ein Mapping-Problem ist.
Gemini 4 Neon: leerer Body und fehlgeschlagene Tool-Aufrufe
Wenn HTTP 200 zurückkommt, aber kein Body, schauen Sie zuerst auf den Finish-Grund. Wurde wegen Länge abgeschnitten, hat der Denkprozess das Ausgabebudget bereits aufgebraucht, sodass kein Platz für sichtbaren Text bleibt; bei einem Sicherheitsgrund müssen Sie den Input anpassen. Die erste Situation tritt bei hohen Denkstufen eher auf.
Fehlgeschlagene Tool-Aufrufe über mehrere Runden hängen meist mit thoughtSignature zusammen. Laut Googles Thought-signatures-Dokumentation muss die vom Modell zurückgegebene Signatur in den folgenden Runden im Originalprotokoll unverändert mitgeführt werden, und zu jedem Tool-Aufruf gehört genau eine passende Tool-Antwort. Bei der Fehlersuche können Sie zuerst die Tools weglassen, mit einer kürzestmöglichen Anfrage ohne Tools einen Vergleich ziehen und die Tools dann schrittweise wieder hinzufügen.
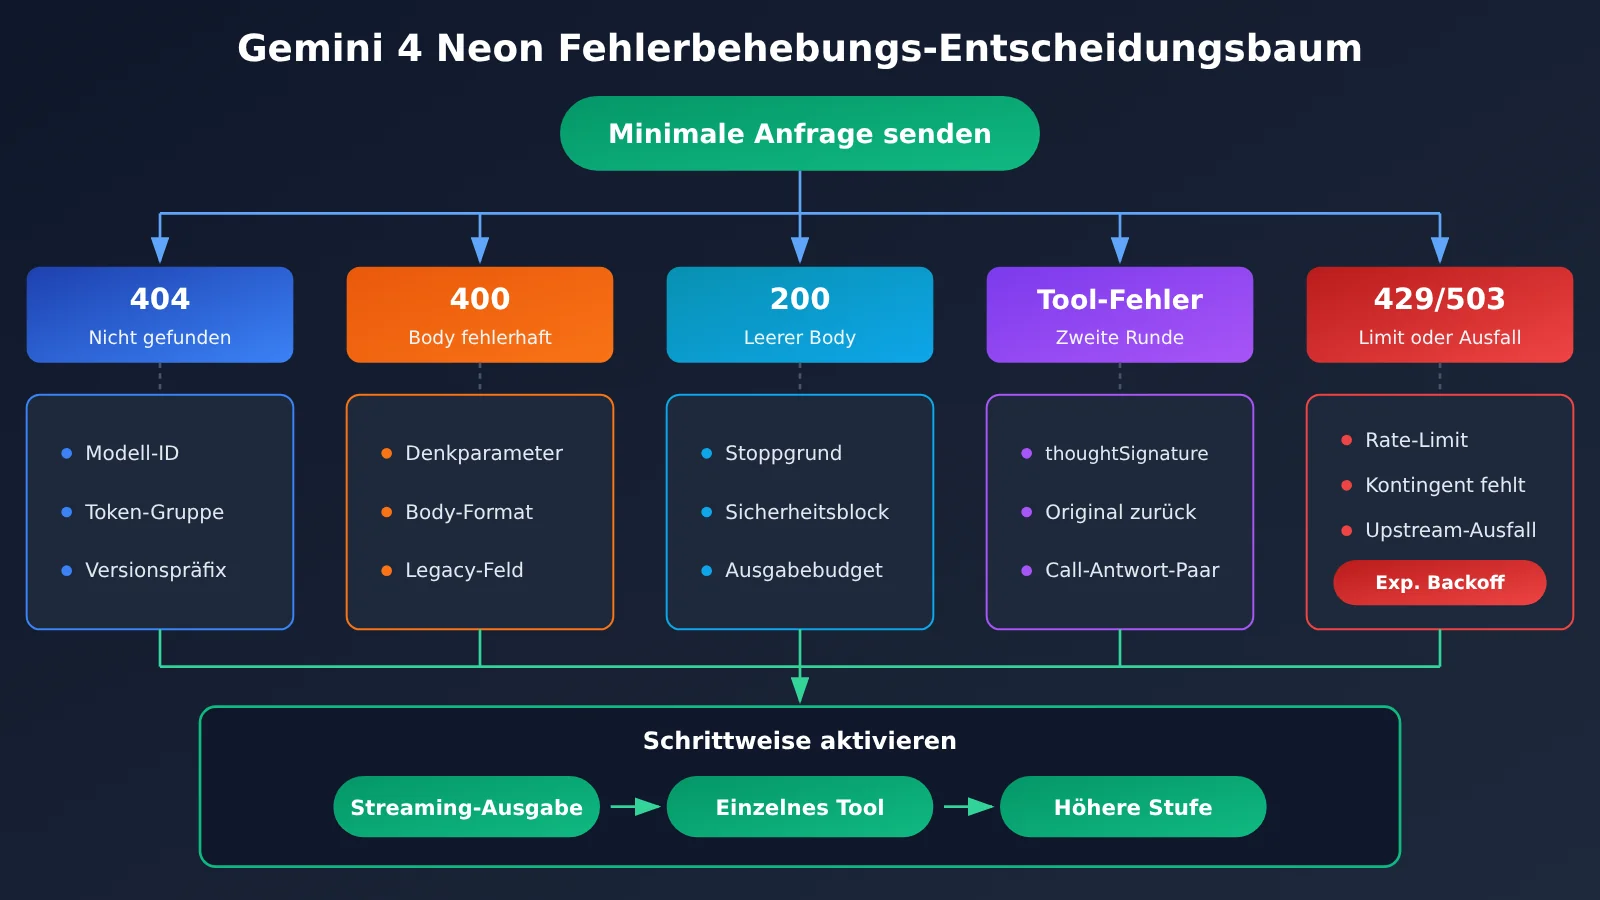
Empfohlene Validierungsreihenfolge für Gemini 4 Neon
Nachdem die minimale Anfrage erfolgreich war, empfiehlt es sich, die Funktionen in der folgenden Reihenfolge Schritt für Schritt zu aktivieren und bei jedem Schritt das Ergebnis separat zu bestätigen:
- Reine Textanfrage ohne Streaming, ohne Tools und mit der Standardstufe – ID, Gruppe und Routing auf korrekte Funktion prüfen.
- Streaming-Ausgabe aktivieren und sicherstellen, dass die Chunk-Zusammensetzung und das Auslesen des Finish-Grunds korrekt funktionieren.
- Ein einzelnes Tool hinzufügen und den vollständigen Zweirundenablauf „Aufruf → Ergebnisrückgabe → endgültige Antwort“ durchlaufen; prüfen, ob
thoughtSignatureerhalten bleibt. - Am nativen Endpunkt zwischen
low,mediumundxhighwechseln und mit einem festen Testset Effekt, Laufzeit und Abrechnung vergleichen. - Zum Schluss dann kostenrelevante Optimierungen wie lange Eingaben und Cache-Wiederverwendung hinzufügen.
Häufige Fragen (FAQ)
F1: Was ist Gemini 4 Neon?
Gemini 4 Neon ist das Mittelklasse-Modell von Gemini 4, das Google am 18. November 2026 veröffentlicht und am selben Tag GA gemacht hat. Es positioniert sich zwischen Carbon und Hydrogen. Es bietet ein gemeinsames Kontextfenster von 1M und vier Denkstufen; die Modell-ID lautet `gemini-4-neon`.
F2: Wie wählt man zwischen Gemini 4 Neon und GPT-6.2 Sol?
Auf derselben Benchmark-Basis des AA Intelligence Index v5.0.1 erreicht Neon `xhigh` 61 Punkte, während die höchste Stufe von Sol 57 Punkte erzielt. Allerdings ist der Listenpreis von Sol mit $2/$10 niedriger als die $3/$15 von Neon. Ein Punkteunterschied ist nicht gleichbedeutend mit einem Unterschied in der Geschäftsgenauigkeit – vergleichen Sie Effekt, Latenz und tatsächlichen Token-Verbrauch auf Ihrem eigenen Testset, bevor Sie sich entscheiden.
F3: Wann ist Gemini 4 Neon bei APIYI verfügbar?
APIYI hat das Modell am 20. November 2026 freigeschaltet und die beiden Gruppen `default` und `svip` geöffnet. Laut der Ankündigung zum Start gibt es für den Standardpreis kein Ablaufdatum.
F4: Für welche Szenarien eignet sich Gemini 4 Neon?
– **Analyse langer Dokumente**: Das 1M-Fenster kann eine große Menge an Material auf einmal aufnehmen, aber die Obergrenze für eine einzelne synchrone Ausgabe liegt bei etwa 64K.
– **Mehrstufiges Reasoning und Agent-Aufgaben**: Die Standardstufe `high` vereint Effekt und Laufzeit; für Tool-Aufrufe empfiehlt sich der native Endpunkt.
– **Kostenkontrollierte Batch-Verarbeitung**: Mit `low`/`medium` plus Cache-Wiederverwendung lassen sich die Kosten pro Durchlauf senken.
F5: Wie ruft man Gemini 4 Neon schnell über die API auf?
1. Bei APIYI apiyi.com registrieren und das kostenlose Testkontingent abholen.
2. Einen Token für die Gruppe `default` oder `svip` erstellen.
3. Bestehender OpenAI-Code nutzt den kompatiblen Einstiegspunkt; wer die Denkstufen steuern möchte, bindet den nativen Endpunkt über das Google GenAI SDK an.
Für beide Wege empfiehlt es sich, zuerst die minimale Anfrage aus diesem Artikel auszuführen und erst nach Bestätigung, dass die Verbindung funktioniert, weitere Funktionen hinzuzufügen.
F6: Welche bekannten Einschränkungen hat Gemini 4 Neon?
– **Ausgabegrenze**: 1M ist ein gemeinsames Fenster, die Obergrenze für synchrone Generierung liegt bei etwa 64K; lange Dekodierungen hängen von bestimmten Cloud-Schnittstellen und Fortsetzungsbedingungen ab.
– **Parameteränderungen**: `thinkingBudget` und `minimal` gelten nicht mehr, `temperature` und `topP` werden ignoriert.
– **Validierungsstatus**: Vor der Freischaltung bei APIYI wurde nur die Preis-Schnittstelle geprüft; für beide Endpunkte und den Tool-Aufruf empfiehlt es sich, vorab mit eigenen Anfragen auf APIYI apiyi.com zu testen.
Gemini 4 Neon – das Wichtigste auf einen Blick
- Modellidentität:
gemini-4-neon, die mittlere Stufe von Gemini 4, von Google am 18. November veröffentlicht. - Grenzen der Spezifikation: 1M gemeinsames Kontextfenster, Obergrenze für synchrone Generierung etwa 64K – längere Dekodierung muss separat geprüft werden.
- Listenpreise: pro Million Token $3 für Input, $15 für Output, $0.15 für Cache-Reads; maßgeblich ist die tatsächliche Abrechnung.
- Wahl der Stufe: Im AA-Test bringt der Wechsel von
highaufxhighnur 1 Punkt mehr, kostet aber rund 6,7 Minuten mehr pro Aufgabe. - Wahl des Endpunkts: Wer die Denk-Stufe steuern will, nutzt den nativen Endpunkt; wer bestehenden Code weiterverwenden will, nutzt den kompatiblen Endpunkt.
- Reihenfolge beim Debugging: Mit der kleinsten Anfrage starten, dann schrittweise Streaming, Tools und höhere Stufen aktivieren.
Fazit
Die Anbindung von Gemini 4 Neon lässt sich auf drei Kernpunkte reduzieren:
- Erst die Spezifikation prüfen: 1M ist ein gemeinsames Fenster, die synchrone Ausgabe liegt bei etwa 64K, Listenpreis $3/$15, Cache-Reads $0.15.
- Beide Endpunkte je einmal durchlaufen: Beim nativen Endpunkt die Basis-URL mit
v1beta, beim kompatiblen Endpunkt die URL mit/v1– Felder nicht vermischen. - Stufe anhand von Daten wählen: AA-Benchmarks sind nur ein Anhaltspunkt; entscheidend sind am Ende Qualität, Laufzeit und Abrechnung auf dem eigenen festen Testset.
Sobald die Anbindung geklärt ist, empfiehlt es sich, auf APIYI apiyi.com mit demselben API-Schlüssel die verschiedenen Neon-Stufen und andere Kandidatenmodelle zu vergleichen und erst danach die Standardkonfiguration für die Produktion festzulegen.
📚 Referenzen
-
APIYI Gemini 4 Neon Launch-Update: Gruppen, Endpunkte, Preise und Ausgabelimits
- Link:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Beschreibung: Veröffentlicht am 20.11.2026, enthält Informationen zu den vier Denkstufen und zur Standardstufe
- Link:
-
Google Gemini 4 Neon Ankündigung: Offizielle Veröffentlichungsinformationen
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Beschreibung: Veröffentlicht am 18.11.2026, enthält Angaben zu Kontext und Positionierung
- Link:
-
Artificial Analysis Gemini 4 Neon Modellseite: Unabhängige Bewertung der vier Stufen
- Link:
artificialanalysis.ai/models/gemini-4-neon - Beschreibung: Punktzahlen und Laufzeiten des Intelligence Index v5.0.1; die Kennzahlen werden dynamisch aktualisiert
- Link:
-
Google Gemini API Troubleshooting und Thought Signatures: Dokumentation zur Fehlerbehebung und zu Thought Signatures
- Link:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Beschreibung: Bedeutung der Fehlercodes und Regeln zur Rücksendung von Signaturen bei Multi-Turn-Tool-Aufrufen
- Link:
-
Gemini 4 Neon Model Evaluation: Zusammenfassung der DeepMind-Evaluierung
- Link:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Beschreibung: Evaluierungsergebnisse aus mehreren Quellen und Frameworks; bei Zitierung sind die Einstellungen anzugeben
- Link:
Autor: APIYI-Team
Technischer Austausch: Bei Problemen während der Integration kontaktieren Sie uns gerne über die offizielle APIYI-Website. Weitere Schnittstellenbeschreibungen finden Sie im Dokumentationszentrum unter docs.apiyi.com.