Zusammenfassung: Dieser Artikel vergleicht Qwen4-Max-Preview mit der offiziellen Version Qwen4-Max in Bezug auf Ausgabebudget, Standard-Inferenzwerte und Abrechnungsmodell und liefert eine Schritt-für-Schritt-Checkliste für die Migration, die vor dem Abschalten der Preview am 25. November ausgeführt werden kann.
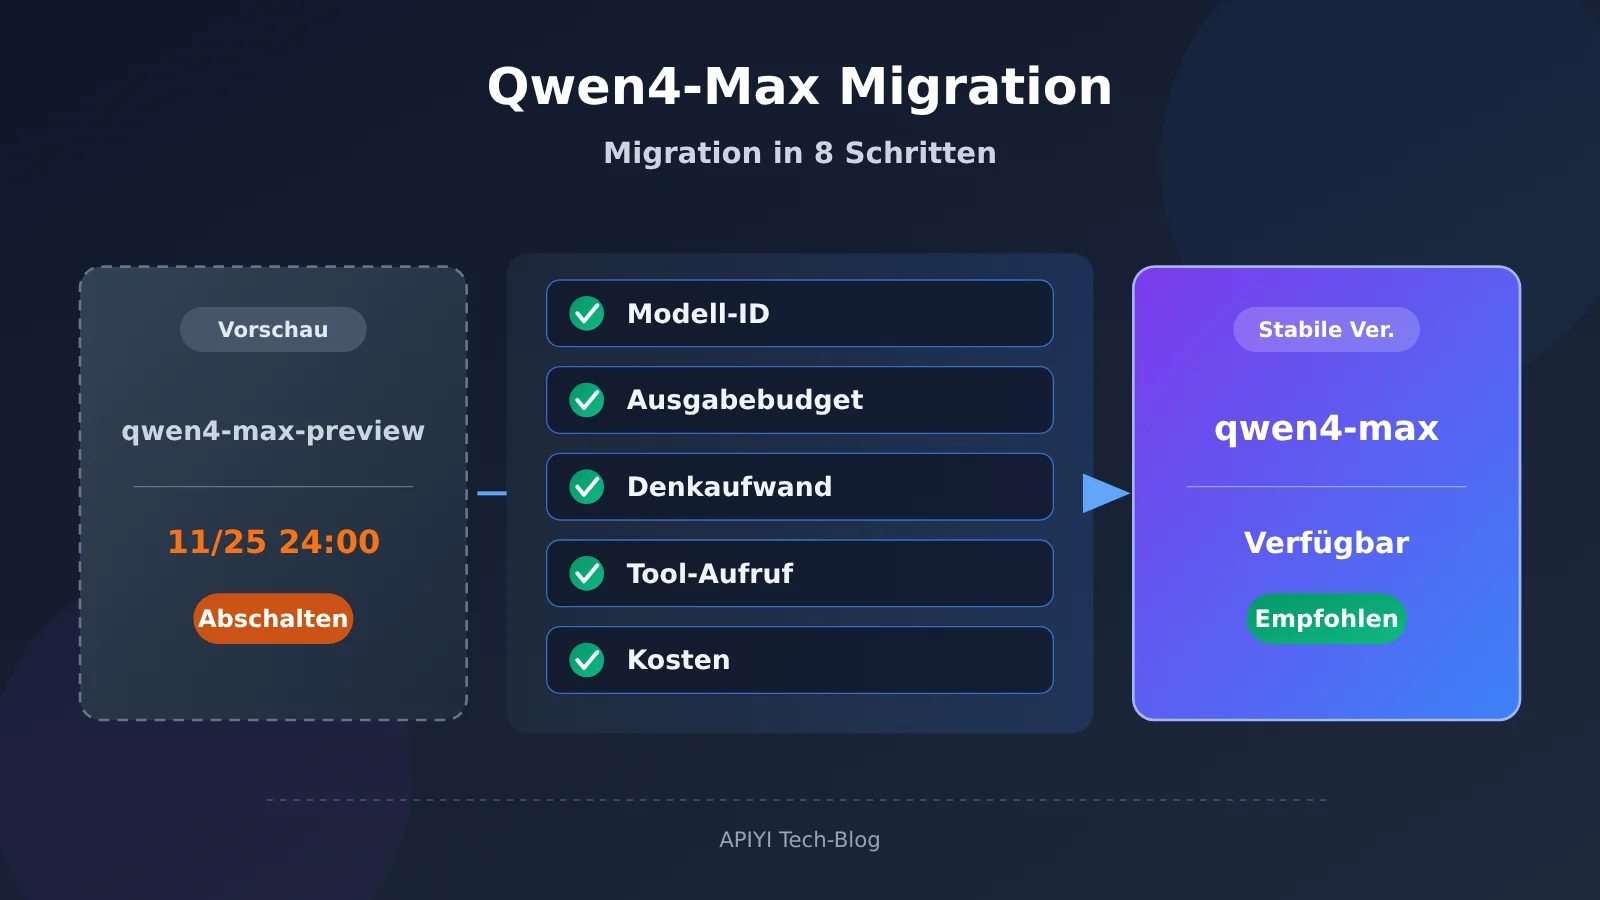
Qwen4-Max-Preview wird am 25. November 2026 um 24:00 Uhr (UTC+8) die Vorschauphase beenden und offline gehen. Die offizielle Version Qwen4-Max ist bereits am 16. November online gegangen, die Modell-ID lautet qwen4-max. Bei der Migration auf die offizielle Version müssen gleichzeitig fünf Punkte geprüft werden: angebundene Produkte, Ausgabebudget, Standard-Inferenzwerte, Tool-Verhalten und Kosten. Beide Versionen bieten ein Kontextfenster von 1 Million Token, doch in der offiziellen Version sinkt die Ausgabegrenze im Denkmodus von 393.216 auf 262.144 Token, die Standard-Reasoning-Intensität wechselt von xhigh auf high, und die Abrechnung erweitert sich von Token Plan Credits auf Pay-as-you-go. Allein das Ändern der Modell-ID garantiert noch nicht, dass Produktionsaufgaben konsistent bleiben.
Im Folgenden werden zunächst die Zeitlinie und die Spezifikationsunterschiede zwischen Preview und offizieller Version dargestellt, danach das API-Protokoll, die Regionen, Preise und das Caching der offiziellen Version vorgestellt. Anschließend folgt die Migrationscheckliste in der Reihenfolge „Baseline sichern, Konfiguration anbinden, Request-Parameter, Funktionsverifikation, Rechnungsbeobachtung, gestaffelte Umschaltung“, und zum Schluss werden die Abnahmekriterien für Aufgaben wie lange Berichte, Codegenerierung und mehrstufige Agents aufgelistet. Nach dem Lesen können Sie diesen Wechsel zu einem teamweit wiederverwendbaren Prozess für das Modellversions-Management zusammenfassen.
Zur Info: Terminologie für die Migration zu Qwen4-Max
| Begriff | Erklärung |
|---|---|
| Model ID | Kennung, mit der in einer Anfrage eine bestimmte Modellversion angegeben wird, z. B. qwen4-max. |
| Base URL | Grundlegende Schnittstellenadresse, die ein Client für den Zugriff auf ein Produkt oder einen regionalen Dienst verwendet. |
| Kontextfenster | Gesamtkapazität, die das Modell in einer Anfrage verarbeiten kann, einschließlich Eingabe, Verlauf und generiertem Inhalt. |
| Ausgabebudget | Obergrenze für die Anzahl der Token, die in einer einzelnen Anfrage generiert werden dürfen. Im Denkmodus teilen sich die Reasoning-Inhalte und die endgültige Antwort dieses Budget. |
| reasoning_effort | Anfrageparameter zur Steuerung der Reasoning-Intensität. Die Standardwerte von Preview und der offiziellen Version unterscheiden sich. |
| thinking_budget | Parameter zur Steuerung des Token-Budgets für das Denken. In der Preview kann er nicht gleichzeitig mit reasoning_effort gesetzt werden. |
| Token Plan | Abo-Dienst von Alibaba Cloud Bailian, der mit Credits abgerechnet wird und in der Preview der einzige Zugangskanal ist. |
| Function Calling | Mechanismus, bei dem das Modell anhand der Tool-Definitionen eine Aufrufanforderung zurückgibt, die Anwendung das Tool ausführt und das Ergebnis zurücksendet. |
| JSON Schema | Spezifikation zur Beschreibung von JSON-Datenstrukturen, Feldern und Einschränkungen, mit der das Ausgabeformat des Modells eingeschränkt wird. |
| TTL | Aufbewahrungsdauer des Caches; sie beeinflusst den Umfang der Cache-Wiederverwendung und die entsprechenden Kosten. |
| Regressionsprüfung | Mit vorhandenen repräsentativen Aufgaben wird geprüft, wie sich Funktionalität, Ergebnisse und Kosten nach einem Versionswechsel verändern. |
1 Wann endet Qwen4-Max-Preview und wann geht die offizielle Version live?
1.1 Zeitplan der Qwen4-Max-Versionen
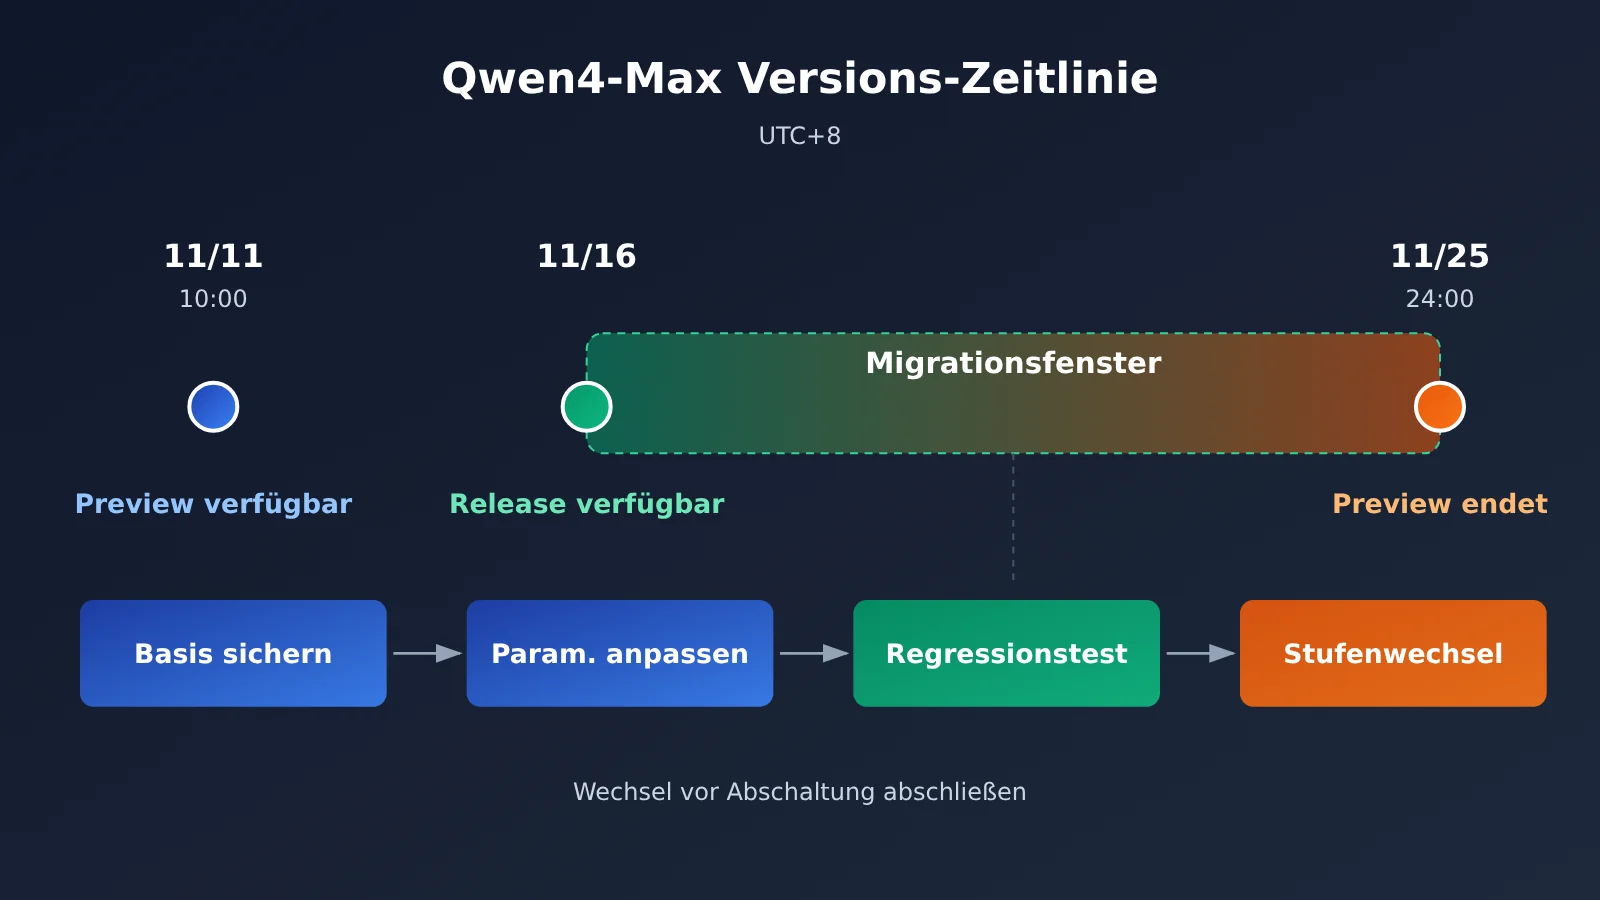
Das Funktions-Update-Protokoll des Alibaba Cloud Token Plan führt zwei unabhängige Ereignisse auf: Am 11. November ging die Preview live, am 16. November die offizielle Version. Nach der Veröffentlichung der offiziellen Version blieb der ursprünglich geplante Abschaltungstermin der Preview unverändert. In der offiziellen Preview-Dokumentation steht oben bereits der Hinweis: „Die offizielle Version Qwen4-Max ist verfügbar; die Nutzung der offiziellen Version wird empfohlen.“
| Zeit (UTC+8) | Ereignis | Bedeutung für Entwickler |
|---|---|---|
| 2026-11-11 10:00 | Qwen4-Max-Preview wird freigeschaltet | Aufruf nur über Token Plan Personal oder Team möglich |
| 2026-11-16 | Offizielle Version Qwen4-Max geht live | Unterstützt die pay-as-you-go-API und ist auch über den Token Plan nutzbar |
| 2026-11-25 24:00 | Preview endet und wird abgeschaltet | qwen4-max-preview kann nicht mehr aufgerufen werden und dient auch nicht als Fallback-Ziel |
1.2 Zwei Model-IDs und ihre jeweiligen Kanäle
Die Model-ID der Preview lautet qwen4-max-preview, der Alias qwen4.0-max-preview. Beide IDs können für Aufrufe verwendet werden; in der Abrechnung erscheinen sie einheitlich als qwen4.0-max-preview. Der Zugang zur Preview erfolgt über einen speziellen API-Schlüssel für den Token Plan plus eine spezielle Base-URL https://token-plan.cn-beijing.maas.aliyuncs.com; pay-as-you-go wird nicht unterstützt.
Die Model-ID der offiziellen Version ist qwen4-max. Für die offizielle Version gibt es zwei Nutzungswege: erstens den Token Plan in der Personal- oder Team-Edition, zweitens die pay-as-you-go-API von Bailian. Schlüssel, Base-URL und Abrechnungsmodell unterscheiden sich bei diesen beiden Wegen; bei der Migration muss zuerst entschieden werden, welcher Weg genutzt wird.
2 Spezifikationsunterschiede zwischen Qwen4-Max-Preview und der offiziellen Version
2.1 Spezifikationsvergleich Qwen4-Max
Die folgenden Daten stammen aus der offiziellen Modelldokumentation zu Preview und zur offiziellen Version.
| Technische Kennzahl | Qwen4-Max-Preview | Qwen4-Max (offizielle Version) |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| Kontextfenster | 1,000,000 | 1,000,000 |
| Maximale Eingabe (ohne Thinking-Modus / mit Thinking-Modus) | In der Dokumentation nicht separat aufgeführt | 991,808 / 983,616 |
| Maximale Ausgabe (ohne Thinking-Modus) | In der Dokumentation nicht separat aufgeführt | 131,072 |
| Maximale Summe aus Thinking + Antwort | 393,216 | 262,144 |
| Standard-Reasoning-Aufwand | xhigh | high |
| Standard-Thinking-Budget | abhängig von den Preview-API-Parametern | 131,072 |
| API-Protokolle | OpenAI Chat Completions, Responses, Anthropic Messages | die ersten drei + DashScope |
| Abrechnung | nur Token Plan Credits | Pay-as-you-go-API oder Token Plan |
2.2 Unterschiede zwischen Kontextfenster, Eingabe, Ausgabe und Thinking-Budget
Diese vier Zahlen messen unterschiedliche Dinge. Bei einer Migration sind sie am leichtesten zu verwechseln. Das Kontextfenster ist die Gesamtkapazität, die eine Anfrage verarbeiten kann; bei beiden Versionen beträgt sie 1 Million. Die maximale Eingabe bestimmt, wie viel Material in einer Anfrage maximal Platz findet. In der offiziellen Version liegt sie im Thinking-Modus bei 983,616 und damit etwas niedriger als im Modus ohne Thinking; der Rest bleibt für das Reasoning. Die maximale Ausgabe bestimmt, wie viele Token bei einem einzelnen Aufruf höchstens erzeugt werden; das Thinking-Budget wiederum bestimmt, wie viele davon für Reasoning verwendet werden dürfen.
Die größte Veränderung liegt auf der Ausgabeseite. Bei Preview teilen sich Thinking und Antwort 393,216 Token; in der offiziellen Version liegt die gemeinsame Obergrenze im Thinking-Modus bei 262,144, das Standard-Thinking-Budget bei 131,072. Nach der Standardkonfiguration bleiben in der offiziellen Version etwa 130.000 Token für die finale Antwort. Wenn ein Geschäftsprozess bei Preview auf einzelne lange Ausgaben von über 200.000 Token angewiesen ist, muss die Ausgabemethode nach dem Wechsel neu gestaltet werden.
3 API-Zugang und Kosten der offiziellen Version von Qwen4-Max
3.1 Protokolle und Funktionen
Die offizielle Version unterstützt vier Protokolle: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages und DashScope. Bei den Funktionen listet die offizielle Dokumentation Function Calling, parallele Tool-Aufrufe, Websuche, JSON Object, JSON Schema, explizites Caching, implizites Caching sowie die Zusammenfassung der Gedankenkette (Chain of Thought) und deren Verschlüsselung auf.
Im Vergleich zur Preview kommen in der Dokumentation der offiziellen Version das DashScope-Protokoll, parallele Tool-Aufrufe und die beiden Cache-Typen neu hinzu. Wenn eine Anwendung bisher nur ein einzelnes tool_call verarbeitet hat, muss jetzt geprüft werden, ob der Code auch mehrere Tool-Aufrufe aus einer Antwort korrekt verarbeitet.
3.2 Regionen und Pay-as-you-go-Preise
Die Pay-as-you-go-API der offiziellen Version deckt sechs Regionen ab. Bei der Auswahl einer Region zählen neben dem Preis auch Netzwerklatenz, Anforderungen an den Datenstandort und der geografische Umfang des Betriebs. Welche Funktionen in welcher Region verfügbar sind, steht in der offiziellen Funktionsmatrix.
| Region | Einsatzgebiet | Eingabe (Yuan/Million Token) | Ausgabe (Yuan/Million Token, inkl. Thinking-Tokens) |
|---|---|---|---|
| Nordchina 2 (Peking) | China (Festland) | 10 | 30 |
| USA (Virginia) | Global | 10 | 30 |
| Deutschland (Frankfurt) | Global | 10 | 30 |
| Japan (Tokio) | Global | 10 | 30 |
| Hongkong (China) | Global | 10 | 30 |
| Singapur | International | 10,938 | 32,813 |
Für die Region Peking ist auf der offiziellen Seite ein kostenloses Kontingent von 1 Million Token mit 90 Tagen Gültigkeit ausgewiesen. Der Startzeitpunkt ist das späteste der folgenden Ereignisse: Freischaltung von Bailian, Veröffentlichung des Modells, Genehmigung des Antrags. Die genannten Preise gelten nur für die offizielle Version. Die auf 20 % des Listenpreises reduzierte Preisgestaltung der Preview und die durch nächtliche Nutzung auf 8 % gesenkte Rate sind Vergünstigungen im Rahmen der Token Plan Credits und lassen sich nicht auf die Kostenkalkulation der offiziellen Version übertragen.
3.3 Expliziter und impliziter Cache
In der offiziellen Version wird das Caching separat abgerechnet. Explizite Caches legt der Entwickler selbst an. Sie eignen sich für langfristig unveränderte Präfixe wie System-Eingabeaufforderungen, Tool-Beschreibungen und feste Referenzmaterialien. Die TTL ist wahlweise 5 Minuten oder 1 Stunde; unterstützt werden Chat Completions, Responses und Anthropic Messages. Implizite Caches verwaltet die Plattform automatisch anhand von Bedingungen wie wiederholten Präfixen – eine zusätzliche Konfiguration ist nicht nötig.
Ein mehrstufiger Agent führt in jeder Runde dieselben Tool-Definitionen und dasselbe Hintergrundmaterial mit. Wer den Cache sinnvoll nutzt, senkt die Kosten für wiederholte Eingaben spürbar. Die TTL sollte sich am Abstand zwischen den Sitzungen orientieren: bei dicht aufeinanderfolgenden Interaktionen 5 Minuten, bei Batch-Prozessen mit längeren Pausen eher 1 Stunde.
4 Schritte zur Migration von Qwen4-Max-Preview auf die offizielle Version
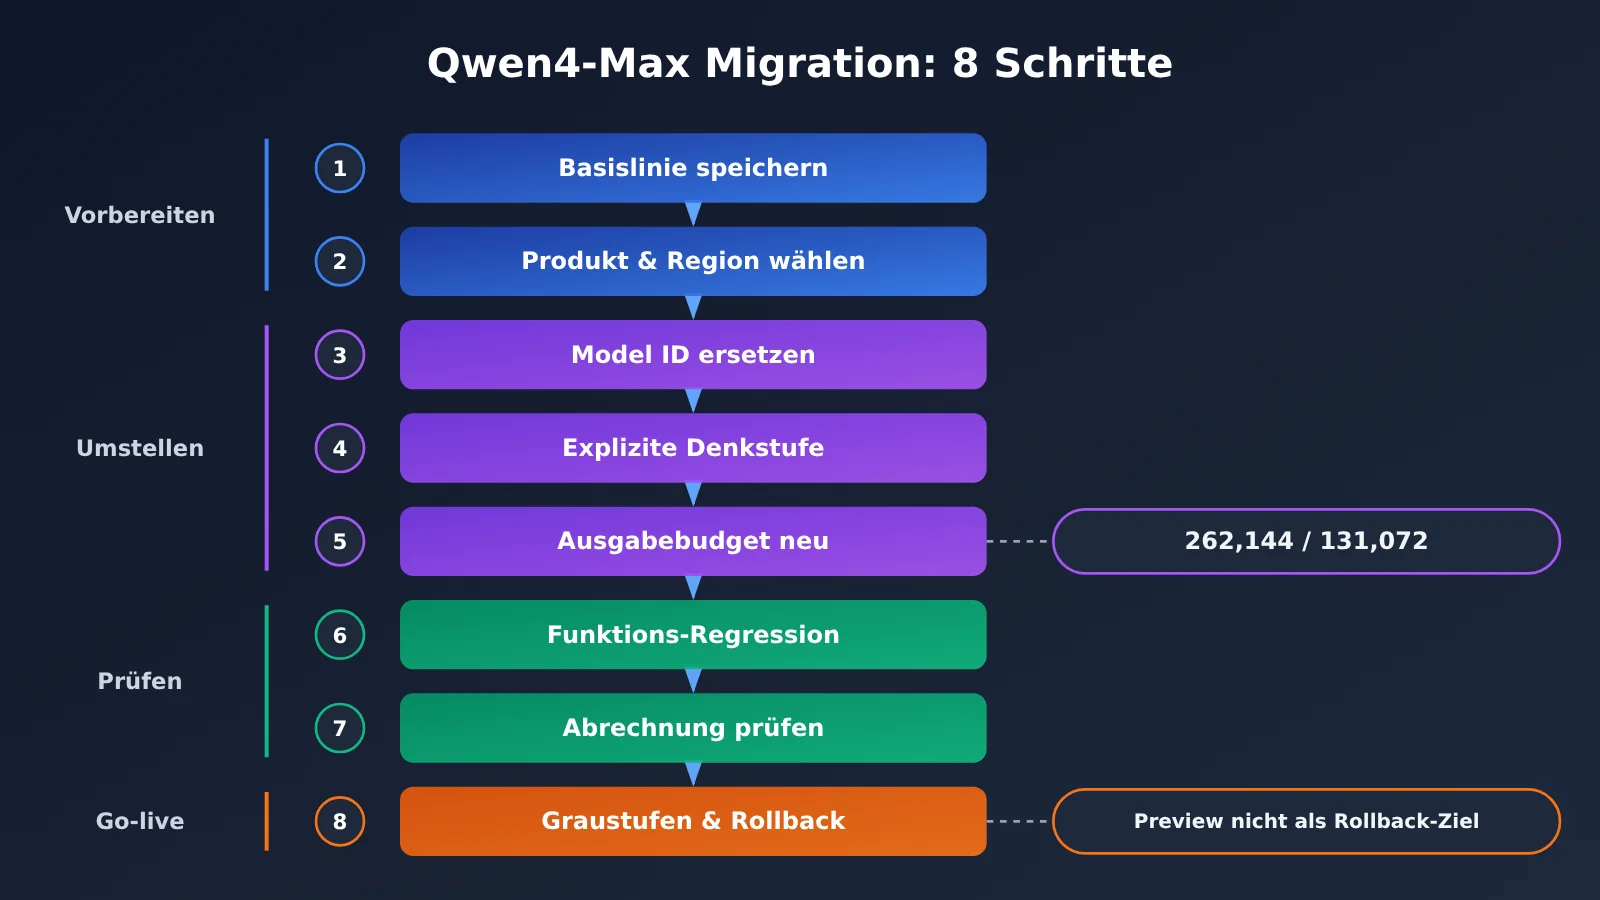
Die folgenden 8 Schritte bilden einen Prüfablauf für Entwickler, der auf Basis der offiziellen Spezifikationen zusammengestellt wurde. Offiziell gibt es weder ein automatisches Migrationstool noch die Zusage, dass alle Anfrageparameter nahtlos kompatibel sind. Daher muss jeder Schritt in der eigenen Anwendung praktisch verifiziert werden.
| Schritt | Prüfpunkt | Akzeptanzkriterium |
|---|---|---|
| 1 | Alte Konfiguration und repräsentative Aufgaben sichern | Anfrageparameter, Ausgabestichproben, Laufzeit und Nutzung von Preview sind archiviert |
| 2 | Integrationsprodukt auswählen, Region, Key und Base URL prüfen | Backend-Dienste nutzen die Pay-as-you-go-API, interaktive Tools den Token Plan |
| 3 | model durch qwen4-max ersetzen |
Smoke-Test-Anfrage läuft normal durch, Modellname in der Abrechnung ist korrekt |
| 4 | Reasoning-Aufwand explizit festlegen | Je nach Aufgabe reasoning_effort oder das entsprechende Feld angeben und sich nicht auf Standardwerte verlassen |
| 5 | Ausgabebudget neu berechnen | Gesamtbudget im Thinking-Modus ≤ 262,144, im Nicht-Thinking-Modus ≤ 131,072 |
| 6 | Tool-Aufrufe, JSON-Struktur, lange Ausgaben und Mehrrunden-Verlauf prüfen | Bestehensrate der repräsentativen Aufgaben entspricht der Preview-Baseline |
| 7 | Nutzung und Cache-Abrechnung beobachten | Kosten für Eingabe, Ausgabe und Cache entsprechen den Erwartungen |
| 8 | Mit geringem Traffic umschalten und Rollback-Konfiguration vorbereiten | Das Rollback-Ziel ist ein weiterhin gültiges Modell; Preview gehört nicht dazu |
4.1 Alte Konfigurationen und repräsentative Aufgaben sichern
Bevor Preview abgeschaltet wird, exportieren Sie alle aktuellen Konfigurationen, die qwen4-max-preview aufrufen – einschließlich max_tokens, reasoning_effort oder thinking_budget, Tool-Definitionen, response_format und System-Prompts. Wählen Sie gleichzeitig 10 bis 30 repräsentative Aufgaben aus und speichern Sie die Ausgaben, Laufzeiten und Nutzung von Preview als Vergleichsbasis. Nach dem 25. November lassen sich keine Preview-Ergebnisse mehr abrufen.
4.2 Zugangsprodukt wählen und Key sowie Base-URL prüfen
Token Plan darf ausschließlich interaktiv in Programmierwerkzeugen oder Agent-Tools wie Claude Code, Cursor, Qwen Code, Qoder usw. verwendet werden. Automatisierte Skripte, selbst betriebene Anwendungs-Backends und Batch-Aufrufe von Workflow-Plattformen fallen nicht in den erlaubten Rahmen; Verstöße können zur Aussetzung des Abonnements oder zur Sperrung des Keys führen. Wenn Preview nur in Tools wie Qoder genutzt wurde, können Sie weiterhin über Token Plan auf die offizielle Version umsteigen. Wenn Sie Ihr eigenes Backend anbinden möchten, sollten Sie stattdessen die offizielle nutzungsbasierte API verwenden und dabei den Key sowie die Base-URL aus der Konsole für die entsprechende Region nutzen.
Die persönliche Version von Token Plan enthält außerdem eine Datenlizenzklausel: Während der Nutzung werden Eingaben und generierte Inhalte zur Verbesserung des Dienstes verwendet. Teams, die vertrauliche Daten verarbeiten, sollten diesen Punkt bei der Auswahl des Zugangsprodukts in ihre Bewertung einbeziehen.
4.3 Model ID ersetzen: Schnellstart mit Qwen4-Max
Es genügt, die Modell-ID auf qwen4-max zu ändern, und schon können Sie die erste Anfrage senden. Unten finden Sie ein minimales Beispiel mit der OpenAI-kompatiblen Schnittstelle. Prüfen Sie zuerst, ob die Anfrage durchgeht, und gehen Sie dann an die Parameteranpassung:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, kann auch durch die regionsspezifische Base URL von Bailian ersetzt werden
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # Ursprünglicher Wert war qwen4-max-preview
    messages=[{"role": "user", "content": "Erkläre deine Versionsinformationen in drei Sätzen"}],
    reasoning_effort="high",             # Explizit angeben, nicht auf den Standardwert verlassen
    max_tokens=8192
)
print(resp.choices[0].message.content)
Welche Modelle unter derselben OpenAI-kompatiblen Schnittstelle verfügbar sind, richtet sich nach der Echtzeit-Modellliste der Plattform. In der Produktionsumgebung sollten Sie dies vor der Veröffentlichung noch einmal bestätigen.
4.4 Inferenzparameter explizit setzen
In der Preview-Version ist der Standardwert xhigh, in der offiziellen Version ist er high. Wenn im bisherigen Code die Inferenzintensität nicht angegeben wurde, sinkt die Reasoning-Stärke nach dem Wechsel automatisch ab – Qualität, Laufzeit und Token-Verbrauch bei komplexen Aufgaben können sich dadurch verändern. Es empfiehlt sich, die Inferenzintensität je nach Aufgabentyp explizit anzugeben: Bei komplexem Code und wissenschaftlicher Reasoning sollte man zunächst mit derselben Intensität wie in der Preview-Version eine Baseline zum Vergleich erstellen; bei einfachen Extraktions- und Formatierungsaufgaben kann man dann versuchen, sie zu reduzieren.
Die Preview-Dokumentation legt fest, dass reasoning_effort und thinking_budget nicht gleichzeitig gesetzt werden dürfen. Die Feldnamen und Werte der offiziellen Version in den vier Protokollen Chat Completions, Responses, Anthropic Messages und DashScope richten sich nach der jeweiligen Protokoll-Dokumentation. In der Preview-Version ist preserve_thinking bei mehrstufigen Dialogen standardmäßig aktiviert, und historische Denkinhalte müssen im Feld reasoning_content zurückgegeben werden. Wenn Ihre Anwendung Denkinhalte zurückschickt, müssen Sie auch in der offiziellen Version verifizieren, dass das Format der historischen Nachrichten korrekt empfangen wird.
4.5 Ausgabebudget nach den neuen Obergrenzen neu berechnen
In der Preview-Version sind max_tokens und max_completion_tokens gleichwertig; Denken und Antwort teilen sich ein Gesamtbudget von 393.216. In der offiziellen Version beträgt das Gesamtbudget im Denkmodus 262.144, das Ausgabelimit im Nicht-Denkmodus 131.072. Alle Anfragen, bei denen in der Preview-Version mehr als 262.144 eingestellt wurde, müssen heruntergesetzt werden. Bei Anfragen, deren Budget bisher knapp bemessen war, muss zusätzlich berücksichtigt werden, welchen Anteil das standardmäßige Denkbudget von 131.072 belegt.
Vollständigen Code zur Migrationskonfiguration anzeigen (Budgetprüfung + Fallback)
from openai import OpenAI

# Offizielle Obergrenzen der finalen Version (im Denkmodus Denken und Antwort zusammen)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Berechnet max_tokens je nach Modus; bei Überschreitung der offiziellen Obergrenze wird direkt ein Fehler ausgelöst, um stille Kürzung zu vermeiden."""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # APIYI OpenAI-kompatible Adresse
    "reasoning_effort": "high",
}
# Das Fallback-Ziel muss ein noch verfügbares Modell sein; qwen4-max-preview ist nach der Abschaltung nicht mehr verfügbar
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Validierung von Tool-Aufrufen, strukturierter Ausgabe und langen Ausgaben
Spielen Sie repräsentative Aufgaben einzeln durch: ob Function Calling dieselben Toolnamen und Parameterstrukturen zurückgibt, ob parallele Tool-Aufrufe vom Code korrekt verarbeitet werden, ob die JSON-Schema-Ausgabe den vorhandenen Validator besteht, ob lange Ausgaben mit finish_reason == "length" enden und ob der Kontext nach der Rücksendung mehrerer Gesprächsrunden kohärent bleibt. Vergleichen Sie jeden Punkt mit der in 4.1 gespeicherten Baseline und dokumentieren Sie die Unterschiede.
4.7 Nutzung und Cache-Abrechnung beobachten
Nach der Umstellung von Credits auf nutzungsbasierte Abrechnung müssen die Kosten getrennt nach drei Posten kalkuliert werden: Eingabe, Ausgabe (inklusive Denken) und Cache. Bei der offiziellen Version ist der Ausgabepreis dreimal so hoch wie der Eingabepreis, und Denk-Token zählen ebenfalls zur Ausgabe – die Einstellung der Inferenzintensität wirkt sich daher direkt auf die Rechnung aus. Sie können zunächst das kostenlose Kontingent der Beijing-Region für den Regressionstest nutzen und anschließend die monatlichen Kosten anhand der tatsächlichen Nutzung hochrechnen.
4.8 Schrittweise Umstellung mit kleiner Verkehrsmenge und Rollback-Konfiguration
Stellen Sie zunächst 5 bis 10 % des Traffics auf qwen4-max um und beobachten Sie Fehlerrate, Abschneiderate (Truncation-Rate) und Kosten pro Aufgabe. Erst wenn sich das als stabil erweist, schalten Sie vollständig um. Die Rollback-Konfiguration muss auf ein Modell zeigen, das noch im Betrieb ist – etwa eine andere verfügbare Version derselben Reihe oder ein bereits erprobtes Modell eines anderen Anbieters. Nach dem Abschalten von Preview darf dieses nicht mehr als Rollback-Ziel dienen.
🎯 Technischer Hinweis: Idealerweise wird das Rollback-Modell bereits vor dem Canary-Rollout mit derselben Charge repräsentativer Aufgaben validiert. Über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com lässt sich mit einem einzigen API-Schlüssel zwischen mehreren gängigen Modellen wechseln – für eine Rollback-Übung genügt es, das Feld
modelzu ändern.
5 Die häufigsten Probleme nach der Migration zu Qwen4-Max
5.1 Abgeschnittene Ausgaben
Das ist das mit Abstand häufigste Problem. Lange Berichte oder große Dateien, die mit Preview noch vollständig generiert werden konnten, werden in der offiziellen Version möglicherweise abgeschnitten – wegen der Obergrenze von 262.144 Tokens oder weil das standardmäßige Reasoning-Budget einen Teil davon belegt. Die Lösung: finish_reason prüfen, überlange Aufgaben kapitel- oder dateiweise generieren und für den Antwortteil ein klar bemessenes Budget reservieren.
5.2 Sinkender standardmäßiger Reasoning-Aufwand
Nach dem Wechsel von xhigh auf high kann sich die Leistung bei komplexen Aufgaben verändern, während einfache Aufgaben möglicherweise schneller und günstiger werden. Code, der die Reasoning-Parameter nicht explizit setzt, ändert sein Verhalten, ohne dass man es merkt. Alle Produktionsanfragen sollten den Reasoning-Aufwand explizit festlegen, und über A/B-Replays lässt sich ermitteln, welche Stufe für jede Aufgabenart passt.
5.3 Tool-Aufrufe und Protokollunterschiede
Die offizielle Version unterstützt ausdrücklich parallele Tool-Aufrufe – eine einzige Antwort kann mehrere Tool-Aufruf-Anforderungen enthalten. Code, der nur den ersten tool_call ausliest, übersieht weitere Tool-Ausführungen, wodurch der Agent-Ablauf abbricht. Beim Wechsel des Protokolls – etwa von Chat Completions zu DashScope – müssen außerdem Feldbenennung und die Art der Rückgabe von Reasoning-Inhalten erneut mit der Dokumentation abgeglichen werden.
5.4 Änderungen bei Cache und Abrechnungslogik
Der Credits-Verbrauch von Preview hängt von Abrechnungsfaktor, Cache-Treffern, Tool-Aufrufen und weiteren Faktoren ab und lässt sich nicht direkt in einen Preis pro Million Token umrechnen. Die offizielle Version rechnet in Yuan pro Million Token ab, wobei der Cache separat abgerechnet wird. Das bisherige, auf Credits basierende Budgetmodell muss neu aufgebaut werden – einschließlich der Schreibkosten für explizites Caching und der Wahl der TTL.
6 Welche Aufgaben mit der offiziellen Version von Qwen4-Max neu getestet werden müssen
| Aufgabentyp | Wichtigste Prüfpunkte | Relevante Parameter |
|---|---|---|
| Erstellung langer Berichte | Wird etwas abgeschnitten, sind die Kapitel vollständig, stimmen die Fakten untereinander überein | Ausgabebudget, finish_reason |
| Komplexe Codegenerierung | Kompilier- und Testbestehensrate, Länge einzelner Dateien, Konsistenz über Dateien hinweg | reasoning_effort, Ausgabebudget |
| Mehrstufige Agenten | Reihenfolge der Tool-Aufrufe, Umgang mit parallelen Aufrufen, Rückgabe früherer Denkschritte | tool_calls, reasoning_content |
| Retrieval in langen Dokumenten | Genauigkeit abschnittsübergreifender Verknüpfungen, ob die Eingabe 983,616 oder 991,808 überschreitet | Maximale Eingabe, Cache-Treffer |
| Strukturierte JSON-Ausgabe | Schema-Validierungsrate, fehlende Felder und Typfehler | response_format, JSON Schema |
Beim Retrieval in langen Dokumenten ist besondere Vorsicht geboten: Die maximale Eingabelänge der offiziellen Version unterscheidet sich je nach Modus, und im Denkmodus sind es etwa 8,000 Tokens weniger als im Nicht-Denkmodus. Aufgaben, deren Material bis knapp an die Obergrenze gefüllt ist, können nach einem Moduswechsel das Limit überschreiten. Bei Code-Aufgaben empfiehlt es sich, das vorhandene Unit-Test-Set direkt wiederzuverwenden und die Testbestehensrate als Abnahmekriterium heranzuziehen – das ist zuverlässiger, als die Ausgabe manuell zu lesen.
💡 Auswahlhinweis: Wenn Sie die Leistung von Qwen4-Max bei diesen Aufgaben mit anderen Flaggschiffmodellen vergleichen möchten, können Sie dieselbe Aufgabenserie über die einheitliche Schnittstelle von APIYI apiyi.com erneut abspielen. Das reduziert den Aufwand für separat angepassten Code pro Anbieter.
7 Häufige Fragen zur Migration von Qwen4-Max-Preview
F1: Werden alte Anfragen nach dem Auslaufen von Qwen4-Max-Preview automatisch an die offizielle Version weitergeleitet?
In der offiziellen Dokumentation wird nur mitgeteilt, dass Preview ausläuft und die offizielle Version verwendet werden sollte; eine automatische Weiterleitung wird nicht erwähnt. Ändern Sie daher das Feld `model` bis zum 25. November, 24:00 Uhr, manuell in `qwen4-max` und führen Sie die Prüfungen aus Abschnitt 4 dieses Artikels durch.
F2: Reicht es, nur die Modell-ID in qwen4-max zu ändern?
Nein. Die maximale Ausgabelänge, der standardmäßige Reasoning-Aufwand und das Abrechnungsmodell haben sich geändert. Sie müssen mindestens das Ausgabebudget neu berechnen, den Reasoning-Aufwand explizit festlegen und Tool-Aufrufe sowie strukturierte Ausgaben durch Regressionstests validieren.
F3: Gelten der 80-%-Rabatt und der Nachtrabatt von Preview auch für die offizielle Version?
Diese beiden Vergünstigungen gelten nur für den Credits-Verbrauch von Preview im Token Plan. Für die nutzungsbasierte API der offiziellen Version gelten in der Region Peking 10 Yuan für Eingaben und 30 Yuan pro Million Token für Ausgaben. Die Kosten müssen neu kalkuliert werden.
F4: Können Backend-Dienste weiterhin den Key des Token Plan verwenden?
Nein. Der Token Plan darf nur interaktiv in den vorgesehenen Programmier- oder Agent-Tools verwendet werden. Backends selbst entwickelter Anwendungen sollten auf die nutzungsbasierte API der offiziellen Version umsteigen oder einen Aggregationsdienst wie APIYI apiyi.com nutzen, der eine OpenAI-kompatible Schnittstelle mit nutzungsbasierter Abrechnung bietet.
F5: Wie lässt sich während der Migration schnell eine Regressionsumgebung aufbauen?
Fassen Sie repräsentative Aufgaben zu einem festen Requestsatz zusammen. Mit demselben Code können Sie das Feld `model` umschalten und so das Replay durchführen. APIYI apiyi.com bietet neuen Nutzern ein kostenloses Testkontingent, mit dem sich Fallback-Modelle und Vergleichsoptionen prüfen lassen.
8 Fazit: Modellversionsverwaltung in den Qwen4-Max-Produktionsablauf integrieren
Der Wechsel von Qwen4-Max-Preview zur offiziellen Version umfasst fünf Dimensionen, die kontinuierlich verwaltet werden müssen:
- Modell-ID: Zentral im Config Center pflegen, nicht im Code hartkodieren und Modell-Lebenszyklus-Ankündigungen abonnieren.
- Schnittstellenparameter: Reasoning-Aufwand, Denkbudget und response_format vollständig explizit festlegen.
- Ausgabelimits: Für jedes Modell vier Werte erfassen – Kontextfenster, maximale Eingabe, maximale Ausgabe und Denkbudget – und vor dem Senden der Anfrage validieren.
- Kosten: Eingaben, Ausgaben und Cache getrennt überwachen; das Budgetmodell neu aufbauen, wenn sich das Abrechnungsmodell ändert.
- Regressionstests: Ein repräsentatives Aufgaben-Set und Baseline-Ergebnisse behalten und bei jedem Versionswechsel vollständig durchspielen.
Die Preview-Version hat eine Lebensdauer von nur zwei Wochen; auch nach der offiziellen Version wird es neue Versionen und Abschaltpläne geben. Etablieren Sie einen festen Ablauf aus „Baseline speichern, Parameter explizit setzen, gestaffelt umschalten, Rollback bereithalten“, dann lässt sich der nächste Versionswechsel in wenigen Tagen abschließen. Teams, die einen Rollback-Plan für mehrere Modelle vorbereiten müssen, können über APIYI apiyi.com unter derselben Schnittstelle validieren.
Referenzen
-
Offizielle Dokumentation zu Qwen4-Max (offizielle Version): Kontext, Ein-/Ausgabegrenzen, Standard-Reasoning-Aufwand, Regionen, Preise und Caching
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Hinweis: Hauptgrundlage für die Migrationsparameter
- Link:
-
Offizielle Dokumentation zu Qwen4-Max-Preview: Preview-Spezifikationen, Integrationsweg, Abschalttermin
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Hinweis: Referenz zum Abgleich beim Sichern der alten Konfiguration
- Link:
-
Token Plan – Funktionsupdates: Veröffentlichungsprotokolle von Preview und offizieller Version
- Link:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Hinweis: Quelle der Versionszeitachse
- Link:
-
Token Plan – Berechtigungen und Nutzungsrichtlinien: Umfang der interaktiven Nutzung und verbotene Szenarien
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Hinweis: Compliance-Grundlage bei der Auswahl des Integrationsprodukts
- Link:
-
Token Plan – Personal-Abonnement und Vorteile: Tarife, Credits und Preview-Rabatte
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Hinweis: Unterscheidung zwischen Preview-Rabatten und der Abrechnung der offiziellen Version
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com.