作者注:解读 Menlo Ventures 2026 企业 AI 报告,说明 Agent 如何把模型消费从“人类提问”变成“机器持续执行任务”,以及这对 API 调用、并发和采购结构的影响。
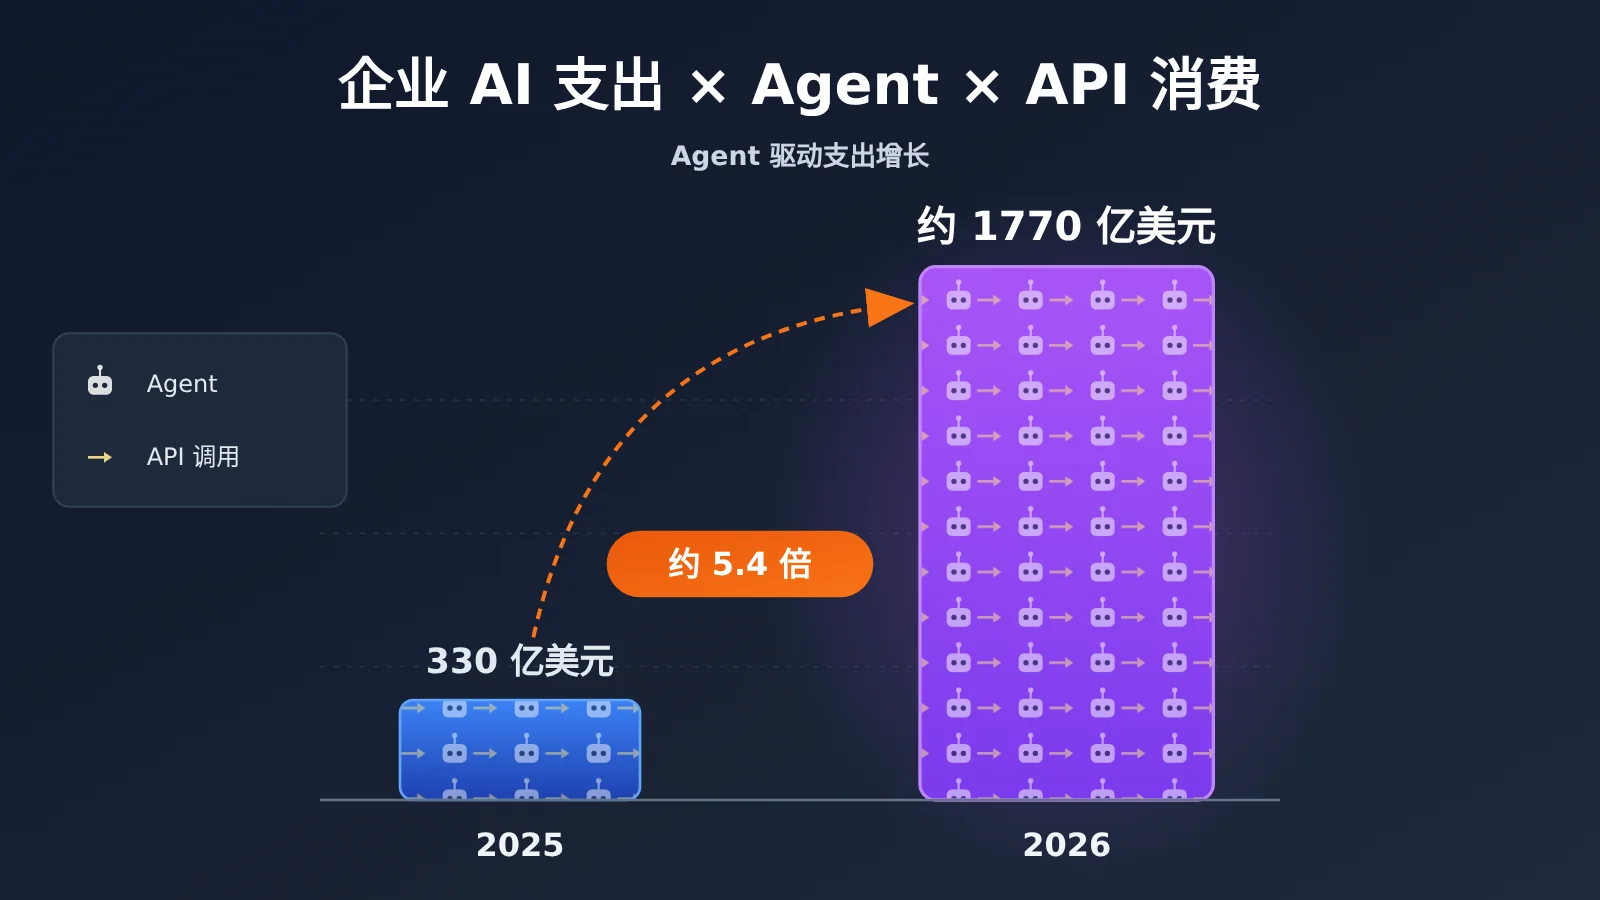
Menlo Ventures 在 2026 年 11 月 3 日发布了《The State of Enterprise AI》报告。报告估算,2026 年企业使用 AI 的支出约 1770 亿美元(报告原值为 1768 亿美元),约为 2025 年 330 亿美元的 5.4 倍。更值得注意的是,企业实际花掉的钱平均是原计划的 2.5 倍左右。
这不是又一轮“AI 市场很大”的泛泛之谈。 报告基于近 400 名美国企业决策者的调查,并引用 OpenRouter 的 Token 数据,结论指向同一个变化:支出增长的主要来源已经不是“更多人在问 AI”,而是“Agent 在替人持续干活”。
核心价值:本文梳理企业 AI 支出和 Agent 的关键数据,解释 Agent 为什么会改变 Token 消耗与 API 调用方式,并分析 API 开发者和采购者需要提前准备的事项。
2026 企业 AI 支出核心信息速览
先看数据。下表数字全部来自 Menlo Ventures 的市场估算,不是经审计的企业付款总额,也不是某一家模型厂商的收入。
| 信息项 | 详情 |
|---|---|
| 发布方 / 时间 | Menlo Ventures,2026 年 11 月 3 日 |
| 2026 企业 AI 支出 | 约 1768 亿美元(2025 年为 330 亿美元,约 5.4 倍) |
| 支出构成 | AI 基础设施约 995 亿美元,AI 应用约 773 亿美元 |
| 使用 vs 构建 | 使用 AI 支出约为构建模型支出(1025 亿美元)的 1.7 倍 |
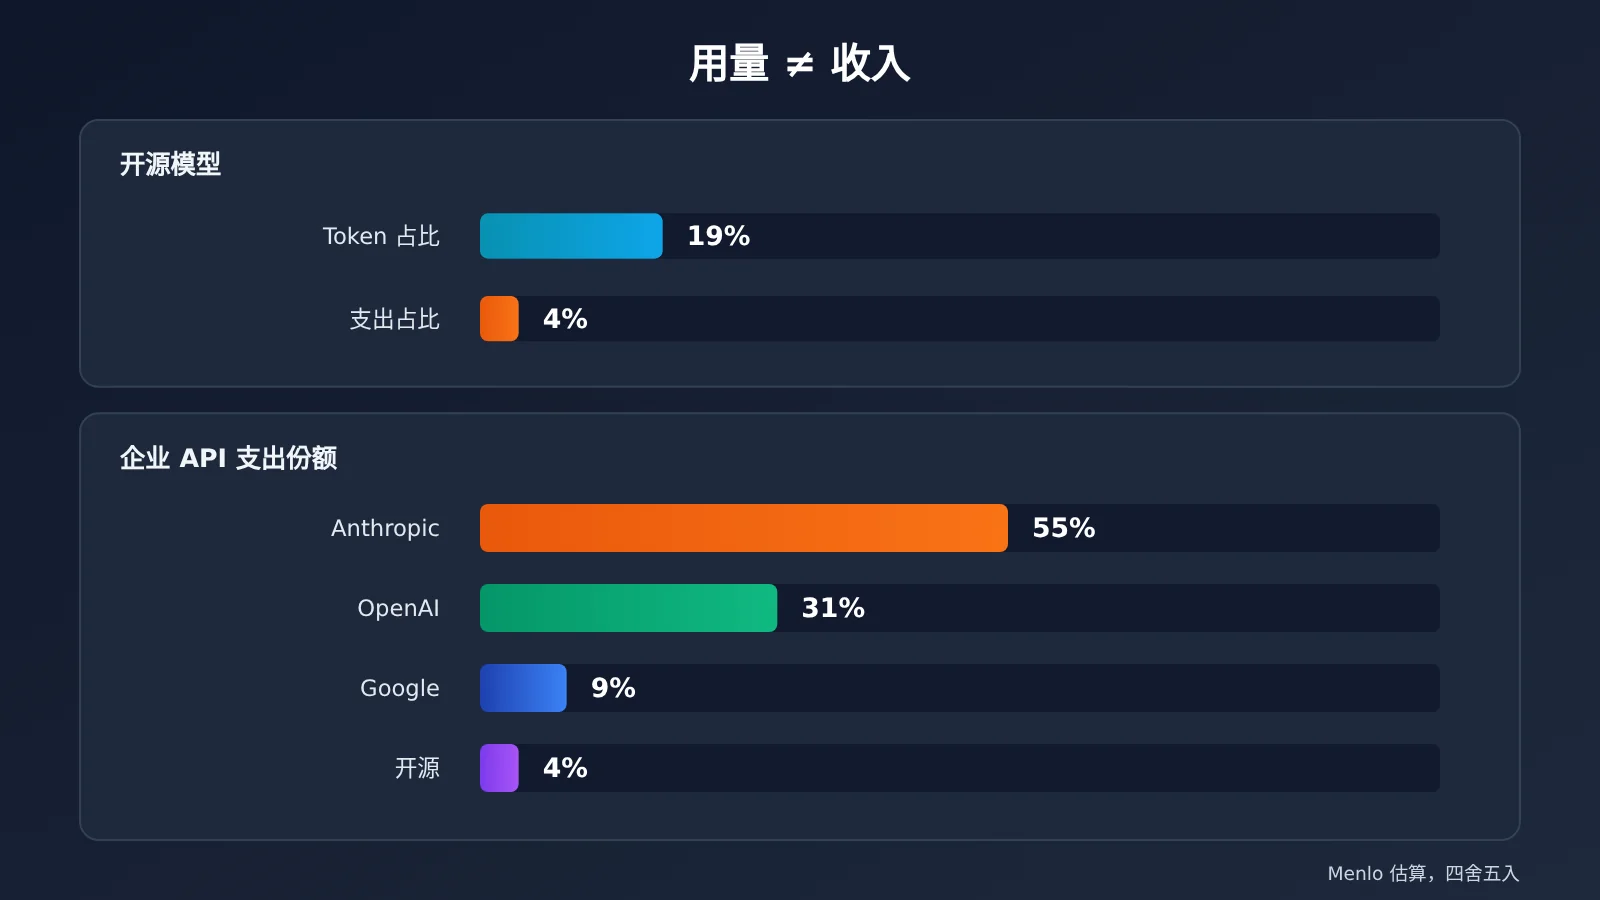
| 企业 API 支出份额 | Anthropic 55%、OpenAI 31%、Google 9%、开源模型 4% |
| Agent Token 占比 | 在 OpenRouter 上约占总 Token 消耗的 80% |
| 调研方法 | 近 400 名美国企业决策者,调查时间为 2026 年 9 月 8—26 日 |
“使用 AI 的支出超过构建模型的支出”是一个转折信号。过去讨论 AI 产业链,重点在训练和算力。现在企业为了让模型完成工作而支付的服务费用已经成为更大的一块。还要注意,这里的“使用支出”包括基础设施、应用订阅和 API 等多种形式,不能直接当作 API 市场收入。
同一时期,OpenAI 总裁 Greg Brockman 在 11 月 4 日的 WSJ 科技大会上表示,OpenAI 已有超过一半的收入来自企业业务。这个数字说的是 OpenAI 自身的收入结构,和 Menlo 统计的“OpenAI 占企业 API 支出 31%”是两个不同口径,不能混在一起比较。
企业 AI 支出为何远超预算:使用深度比用户数更关键
企业 AI 支出的预算偏差
报告里最反直觉的数据是预算偏差。企业年初普遍低估了 AI 的消耗速度:
| 指标 | 原计划(相对上年) | 实际(相对上年) |
|---|---|---|
| 平均 AI 支出 | 1.9 倍 | 4.7 倍 |
| 中位数 AI 支出 | 1.8 倍 | 2.2 倍 |
| 企业 AI 采用率 | — | 55% → 65% |
平均值比中位数高出一倍多,说明少数高强度使用 AI 的企业拉高了整体支出。采用率只上升了 10 个百分点,单个企业的平均支出却接近原来的 5 倍。所以增长的主要原因不是更多公司开始用 AI,而是已经在用的公司用得越来越深。
企业 AI 支出正在形成新预算
从资金来源看,Menlo 估算新增 AI 支出中约 55% 来自新增预算,约 22% 来自原有软件预算。也就是说,AI 不只是在替换传统 SaaS,还在创造过去没有的采购科目。对采购负责人来说,AI 已经从“IT 工具费”中分离出来,成为一笔需要单独管理的运营成本。
Agent 如何改变 API 消费:从提问到执行
聊天机器人与 Agent 的调用机制差异
预算失控的直接原因,是调用模式发生了变化。普通聊天机器人基本是“一问一答”:用户发一条消息,模型返回一次结果,Token 消耗和人的提问次数大致成正比。Agent 的工作方式是“给目标、拆任务、调工具、检查结果、再迭代”,一次任务背后可能有几十次模型调用。
| 维度 | 聊天机器人 | AI Agent |
|---|---|---|
| 触发方式 | 人主动提问 | 目标驱动,可定时或事件触发 |
| 单任务调用次数 | 通常 1 次 | 多轮规划、执行、校验 |
| 并发特征 | 跟随在线人数 | 多个子任务、多个 Agent 并行 |
| 上下文 | 对话历史 | 文档、代码库、工具返回结果 |
| 运行时长 | 人离开即停止 | 可在后台持续执行 |
| 消耗决定因素 | 用户数 × 提问频率 | 任务量 × 并行度 × 持续时间 |
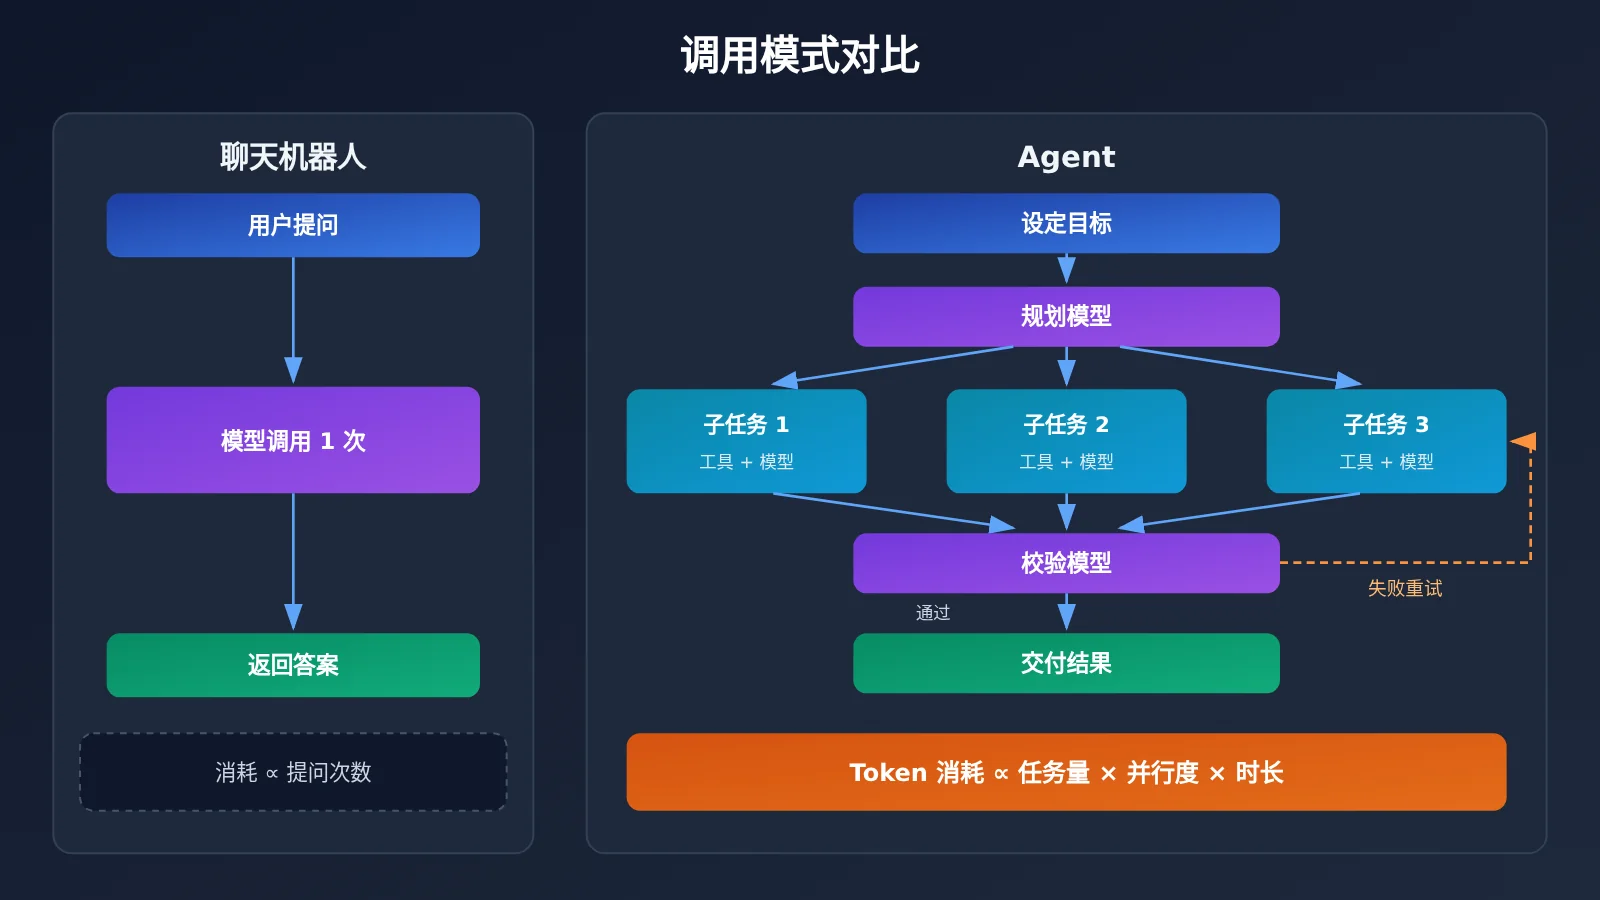
📊 图示说明:右侧的多模型 Agent 流程,在规划、执行、校验三个环节可以分别使用不同模型。如果想自己验证这种调用结构,可以通过 API易 apiyi.com 用一个 Key 切换多家模型做对比。
Token 消耗与任务执行量挂钩
Menlo 用 OpenRouter 数据观察到:Agent 已占该平台总 Token 消耗的约 80%,每周约 130.9 万亿 Token。2026 年 2 月 Agent 流量超过人工驱动流量之后,Agent 流量增长约 37 倍,同期人工驱动流量只增长约 5 倍。
OpenRouter 的用户以开发者和创业公司为主,这组数据不能代表整个行业,但方向和其他信号一致。OpenAI 2025 年企业报告显示,企业 API 每个组织的平均推理 Token 消耗同比增长约 320 倍。Axios 对 Codex 的报道也提到,超过 60% 的用户会在一天中的某个时段同时运行多个任务。这些数据说明,Token 消耗正在从“跟着人走”变成“跟着任务走”。
企业 AI 支出流向:编程和企业聊天机器人为何领先
AI 应用市场的资金分布
在约 773 亿美元的 AI 应用市场中,资金高度集中:
| 应用类别 | 2026 年估算规模 | 同比变化 |
|---|---|---|
| AI 编程应用 | 340 亿美元 | 约 7.7 倍 |
| 企业 AI 聊天机器人 | 250 亿美元 | 约 3 倍 |
| 医疗 AI 应用 | 37 亿美元 | — |
| 编程 + 聊天合计占比 | 约 76% | — |
编程领域集中度更高。Menlo 估算,Claude Code 和 Codex 合计约占编程应用市场 240 亿美元,接近七成。编程之所以最先跑通 Agent 模式,和下面三个条件直接相关。
Agent 成功落地的三个条件
- 有可执行操作的环境:Agent 需要接入 GitHub、邮件、日历、Slack、企业文档和数据库。只有推理能力、没有工具,无法完成真实工作。
- 有完整的任务上下文:除了用户的问题,还需要企业规范、业务流程、项目历史、操作约束和成功标准。
- 结果可以被验证:编译器能判断代码能否构建,测试能判断功能是否正常。这是编程 Agent 领先的关键原因。相比之下,研究、检索类任务的结果更难客观校验。
第三点也解释了 Agent 的成本风险。在结果难以验证的领域,Agent 可能消耗大量 Token 却产出错误结论。Axios 报道过斯坦福教授 Andrew Hall 用 Claude Code 更新旧论文的案例,事后人工审查发现数据收集和代码处理都有错误。
Agent 对 API 消费市场的影响分析
对 API 开发者的影响
- 成本模型要重算:按“用户数 × 单价”估算 API 预算已经不准确,应改为按“任务数 × 平均调用轮次 × 上下文长度”估算。
- 需要预算护栏:后台持续运行的 Agent 必须设置单任务 Token 上限、最大迭代次数和失败熔断,否则就会出现类似企业预算 1.9 倍变 4.7 倍的情况。
- 多模型组合成为常态:规划用强模型,批量执行用低价模型,校验用另一家模型做交叉检查,这样能明显降低单位任务成本。
对 API 服务商的影响
Agent 带来的需求变化可以归纳为五类,每一类都对应服务商需要具备的能力:
| 需求变化 | 产生原因 | 服务商需要的能力 |
|---|---|---|
| 调用频率增加 | 单任务需要多轮调用 | 低延迟、失败重试 |
| 并行调用增加 | 多个 Agent 同时处理子任务 | 并发能力、限流策略 |
| 上下文消耗增加 | 携带文档与工具返回结果 | 长上下文支持、缓存计费 |
| 持续运行增加 | 用户离开后继续执行 | 调用稳定性、用量监控 |
| 模型组合增加 | 规划、执行、检查分工 | 多模型统一接入与切换 |
💡 选择建议:如果你的 Agent 工作流需要组合多家模型,可以先在 API易 apiyi.com 上用 OpenAI 兼容接口跑通原型,按量计费,方便统计每个环节的真实成本。
冷静看待:企业 AI 支出不等于 API 收入
“Agent 越多,API 服务商收入就一定越高”这个推论并不成立,原因有三点:
- 1768 亿美元中有很大一部分是基础设施和应用订阅,不是 API 调用费。
- 价格在持续下行。开源模型的 Token 使用占比已升至 19%,支出占比却只有约 4%,说明 Token 量上涨不一定带来同等的收入增长。
- 缓存、批处理和模型路由会压低单位成本,竞争最终比拼的是稳定性和任务成功率,而不只是 Token 销量。
如何用 API 搭建多模型 Agent 工作流
极简示例
下面这段代码演示 Agent 最基本的“规划 → 执行”两次调用,模型名请替换为平台控制台中可用的模型:
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="YOUR_PLANNER_MODEL",
    messages=[{"role": "user", "content": "把“整理本周销售周报”拆成 3 个步骤"}]
).choices[0].message.content

result = client.chat.completions.create(
    model="YOUR_EXECUTOR_MODEL",
    messages=[{"role": "user", "content": f"按以下步骤执行并输出结果:\n{plan}"}]
)
print(result.choices[0].message.content, result.usage.total_tokens)
查看完整实现代码(含校验、重试和 Token 预算)
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODELS = {
    "planner": "YOUR_PLANNER_MODEL",    # 强推理模型,负责拆解任务
    "executor": "YOUR_EXECUTOR_MODEL",  # 低价模型,负责批量执行
    "checker": "YOUR_CHECKER_MODEL",    # 另一家模型,交叉校验
}
TOKEN_BUDGET = 50_000   # 单任务 Token 上限
MAX_ROUNDS = 3          # 最大迭代轮次

used_tokens = 0

def call(role: str, prompt: str, retries: int = 3) -> str:
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出单任务 Token 预算,熔断")
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=MODELS[role],
                messages=[{"role": "user", "content": prompt}],
            )
            used_tokens += resp.usage.total_tokens
            return resp.choices[0].message.content
        except Exception as e:
            time.sleep(2 ** i)  # 指数退避
            last_err = e
    raise last_err

def run_agent(goal: str) -> str:
    plan = call("planner", f"将目标拆成可执行步骤:{goal}")
    output = call("executor", f"按步骤执行:\n{plan}")
    for _ in range(MAX_ROUNDS):
        verdict = call("checker", f"检查结果是否满足目标“{goal}”,"
                                  f"合格只回复 PASS,否则指出问题:\n{output}")
        if verdict.strip().startswith("PASS"):
            break
        output = call("executor", f"根据反馈修正:\n{verdict}\n原结果:\n{output}")
    print(f"本任务共消耗 Token:{used_tokens}")
    return output

print(run_agent("整理本周销售数据并写一份 300 字摘要"))
这段代码体现了前文的几个要点:一个任务至少 3 次调用,三个角色使用不同模型,并通过 Token 预算和迭代上限避免成本失控。
🚀 快速开始:建议先在 API易 apiyi.com 领取免费测试额度,分别为三个角色试用不同模型,记录
usage数据后再决定生产环境的模型组合。
常见问题 FAQ
Q1:2026 年企业 AI 支出 1770 亿美元是什么口径?
这是 Menlo Ventures 自下而上估算的 2026 年企业使用 AI 的支出(原值 1768 亿美元),包括基础设施约 995 亿美元和应用约 773 亿美元。它是市场估算,不是审计后的付款总额,也不是 API 市场收入。
Q2:企业 AI 使用支出和模型开发支出有什么区别?
模型开发支出指构建和训练模型的投入,Menlo 估算约 1025 亿美元。使用支出指企业为完成工作而购买 AI 服务的花费。前者约为后者的六成,说明商业化重心正在转向“使用”。
Q3:为什么 Agent 会让企业 AI 支出超出预算?
Agent 的消耗由任务量、并行度和运行时长决定。一个任务包含多轮调用,多个 Agent 并行运行,还能在后台持续执行。企业沿用“按人数估算”的思路,自然会低估实际消耗。
Q4:OpenRouter 的 Agent 占比 80% 能代表整个行业吗?
不能。OpenRouter 的用户以开发者和创业公司为主,数据只能反映趋势方向。企业内部私有部署、云平台直采等场景的结构可能有明显差异,引用时需要说明样本来源。
Q5:开发者如何低成本验证多模型 Agent 方案?
建议用统一接口的聚合平台做原型:
1. 访问 API易 apiyi.com 注册并获取 API Key 和免费测试额度
2. 将上文示例的 base_url 和模型名替换为控制台中的配置
3. 分别记录规划、执行、校验三个环节的 Token 用量,再优化模型组合
Q6:Agent 目前有哪些已知限制?
主要有三点。第一,结果难以验证的任务容易出错,仍需专业人员审查。第二,多个 Agent 并行运行会增加监督压力,部分用户反映会产生精神疲劳。第三,后台运行的成本不容易预测。实践中可以先在 API易 apiyi.com 用小额度跑通流程,并配置预算上限后再扩量。
企业 AI 支出与 Agent 核心要点 Key Takeaways
- 规模:Menlo 估算 2026 年企业 AI 使用支出约 1768 亿美元,约为上年的 5.4 倍。
- 预算偏差:企业平均实际支出为上年的 4.7 倍,原计划只有 1.9 倍。
- 增长来源:主要来自已采用企业的使用深度加深,而不是采用率上升。
- 调用机制:Agent 让 Token 消耗与任务量、并行度、运行时长挂钩。
- 落地条件:需要执行环境、完整上下文和可验证的结果,编程领域因此领先。
- 理性判断:企业 AI 支出不等于 API 收入,Token 增长也不等于收入同比增长。
- 上手方式:可通过 API易 apiyi.com 用一个 Key 组合多家模型,测算真实任务成本。
总结
2026 年企业 AI 支出的核心变化有三点:
- 从人驱动到任务驱动:模型消费的主体正在从“人类提问”转向“Agent 持续执行”。
- 从工具费到独立预算:过半新增支出来自新增预算,AI 正在成为单独管理的运营成本。
- 从卖 Token 到卖可靠性:API 服务的竞争重点会转向稳定性、并发、多模型切换和用量监控。
对开发者和采购者来说,现在最值得做的是用真实任务测算“单任务成本”,而不是按人数估算预算。推荐通过 API易 apiyi.com 快速搭建多模型 Agent 原型,用实际 usage 数据为下一年的 AI 预算提供依据。
📚 参考资料
- Menlo Ventures – 2026 The State of Enterprise AI:本文主要数据来源
- 链接:
menlovc.com/perspective/2026-the-state-of-enterprise-ai -
说明:包含企业 AI 支出、API 份额、OpenRouter Agent 数据及调研方法
-
Reuters – Brockman 谈 OpenAI 企业收入:OpenAI 企业收入占比过半
- 链接:
reuters.com/legal/transactional -
说明:2026 年 11 月 5 日报道,注意与 Menlo 的 API 份额属于不同口径
-
OpenAI – The State of Enterprise AI 2025:企业使用基线数据
- 链接:
openai.com/business/guides-and-resources/the-state-of-enterprise-ai-2025-report -
说明:包含每组织推理 Token 消耗同比约 320 倍等历史数据
-
Axios – Office workers drive OpenAI’s Codex growth:Agent 多任务并行与监督问题
- 链接:
axios.com/2026/06/02/openai-codex-knowledge-workers - 说明:2026 年 6 月数据,适合了解知识工作者使用 Agent 的情况
作者:API易 技术团队
技术交流:关于 Agent 工作流与多模型调用的实践问题,欢迎在 API易 apiyi.com 首页联系我们交流