ملاحظة الكاتب: كشفت Alphabet أن واجهة API لنماذجها المطوّرة داخليًا تعالج نحو 32 مليار توكن في الدقيقة. تقارن هذه المقالة بين Gemini 4 Argon و3.8 Flash و3.5 Flash-Lite من ثلاث زوايا: الأسعار الرسمية، والتقييمات المستقلة، ومحاكاة التكاليف، لمساعدتك على حساب «التكلفة الإجمالية لكل مهمة تُنجز بالمستوى المطلوب».
في 28 أكتوبر 2026، أعلن Sundar Pichai، الرئيس التنفيذي لشركة Alphabet، خلال إعلان نتائج الربع الثالث، أن واجهة API لنماذج الشركة المطوّرة داخليًا تعالج حاليًا ما يقارب 32 مليار توكن في الدقيقة، بزيادة تزيد على أربعة أضعاف مقارنة بالعام السابق. ويعكس هذا الرقم حجم استخدام المطوّرين والشركات لواجهة Gemini API عمومًا، ولا يمثل أداء نموذج بعينه.
هذه ليست مقالة أخرى توصي باختيار أقوى نموذج دون تفكير. فمع زيادة عدد الاستدعاءات، تتضاعف أهمية التكلفة واختيار النموذج المناسب. وقد يؤدي اختيار نموذج من فئة غير مناسبة إلى زيادة الفاتورة الشهرية عدة أضعاف، أو إلى تكرار المحاولات بسبب قصور قدراته، ما يجعل التكلفة النهائية أعلى.
ما الذي ستستفيده؟ بعد قراءة المقالة، ستعرف الفروق بين نماذج Gemini الثلاثة: Argon وFlash وFlash-Lite، من حيث القدرات والسعر والسرعة وحالات الاستخدام المناسبة. كما ستجد طريقة عملية يمكنك تطبيقها مباشرة لاختبارها على مهام عملك، لتساعدك على اختيار مبدئي.
قفزة في حجم استدعاءات Gemini API: أبرز المعلومات
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 28 أكتوبر 2026 (تقرير نتائج Alphabet للربع الثالث من 2026) |
| الجهة المعلنة | الرئيس التنفيذي لشركة Alphabet، Sundar Pichai |
| البيانات الأساسية | تعالج واجهات API للنماذج المطوّرة داخليًا نحو 32 مليار رمز (Token) في الدقيقة، بزيادة تقارب 40% عن الرقم المعلن في الربع السابق وأكثر من أربعة أضعاف مقارنة بالعام السابق |
| نماذج API الرئيسية حاليًا | Gemini 4 Argon وGemini 3.8 Flash وGemini 3.5 Flash-Lite |
| نطاق التأثير | جميع المطورين والشركات الذين يبنون تطبيقات باستخدام Gemini Developer API |
ماذا يعني 32 مليار رمز في الدقيقة لمطوري Gemini API؟
تشير القفزة في الاستخدام إلى أن النماذج دخلت بيئات الإنتاج على نطاق واسع، لكن هذا لا يعني أن كل مشروع يحتاج إلى أغلى نموذج رائد. عند الاختيار، ينبغي مراعاة تعقيد المهمة، ومتطلبات جودة المخرجات، وحجم الطلبات، وسرعة الاستجابة، واستهلاك الرموز، وقدرة العمل على تحمّل الأخطاء، والحاجة إلى سياق طويل واستدعاء الأدوات، إضافة إلى تغيرات الأسعار مستقبلًا.
تجدر الإشارة إلى أن Flash في هذا المقال يعني Gemini 3.8 Flash، وأن Flash-Lite يعني Gemini 3.5 Flash-Lite؛ فلا تخلط بينهما وبين سلسلة Gemini 2.5 Flash الأقدم. كذلك، مهما بلغ حجم الاستدعاءات عالميًا، فهذا لا يعني أن حصص المطورين الأفراد غير محدودة. وسنتناول قيود الاستدعاء لاحقًا في قسم مستقل.
مكانة نماذج Gemini الثلاثة: Argon وFlash وFlash-Lite
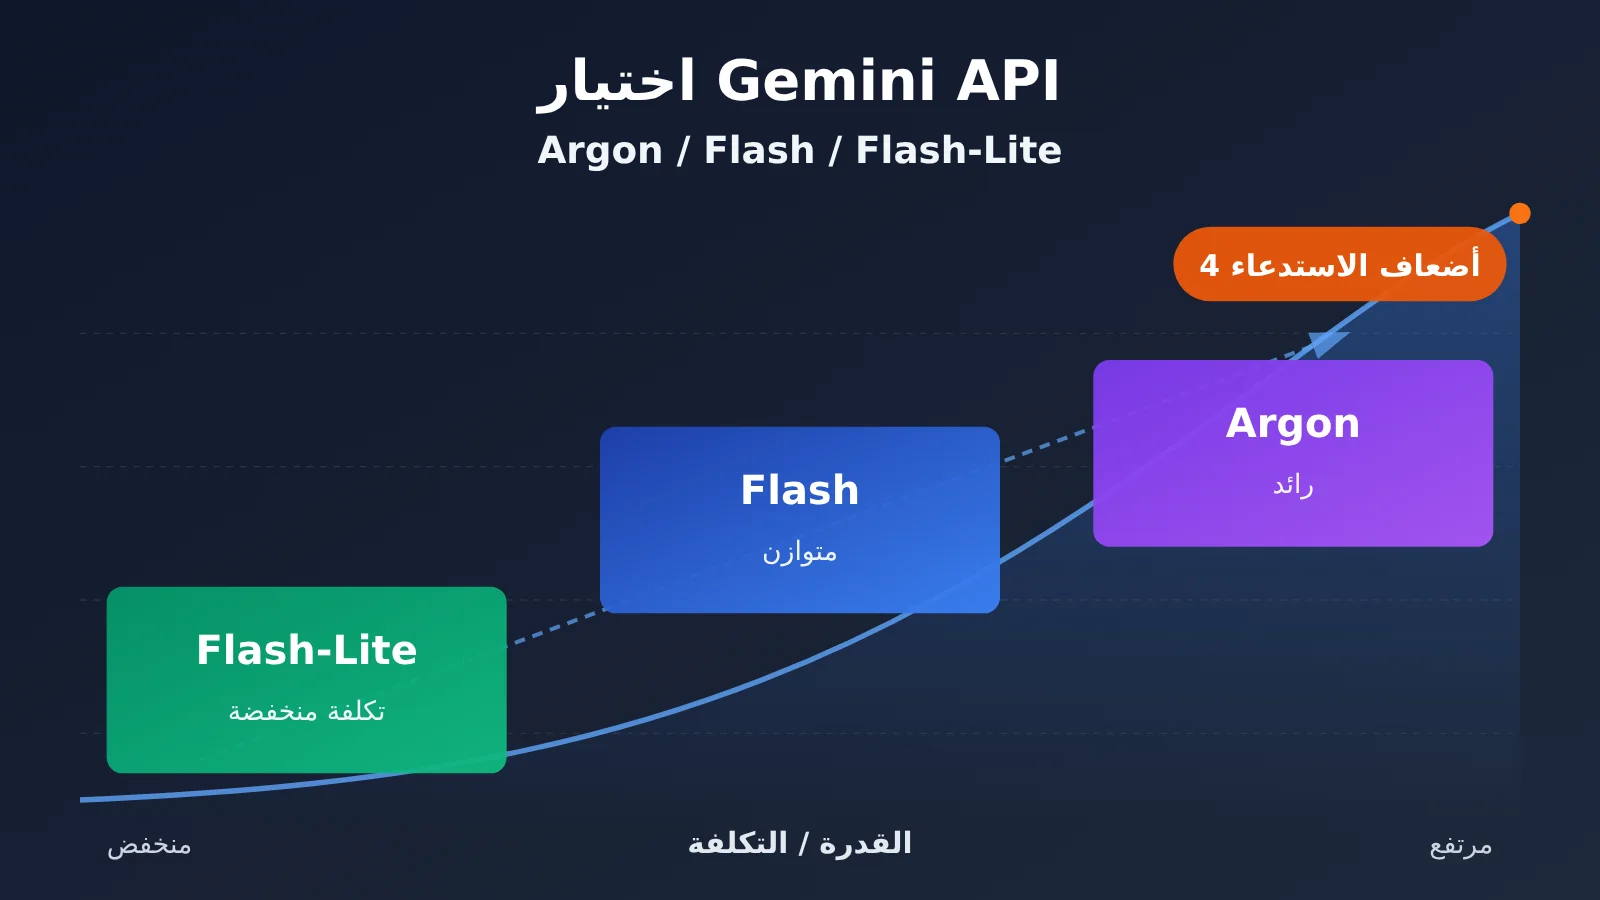
تقدم Google حاليًا ثلاث فئات من النماذج لتلبية احتياجات مختلفة من حيث التكلفة والقدرات. يستند الجدول التالي إلى صفحات مواصفات النماذج الرسمية:
| العنصر | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| معرّف API | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| التصنيف الرسمي | نموذج استدلال رائد | توازن بين الكفاءة والقدرات | زمن استجابة منخفض، وتكلفة منخفضة، وقدرة معالجة عالية |
| نافذة السياق | نحو مليون رمز (Token) | 1048576 رمز إدخال | 1048576 رمز إدخال |
| الحد الافتراضي للإخراج | 65536 رمزًا (يمكن توسيعه باستخدام آلية الإخراج الطويل) | 65536 رمزًا | 65536 رمزًا |
| مستويات التفكير | low / medium / high، والافتراضي medium | low / medium / high، والافتراضي medium | minimal / low / medium / high، والافتراضي minimal |
| قدرات الأدوات | استدعاء الدوال، والإخراج المنظّم، والاستناد إلى بحث Google، وتنفيذ الشفرة | استدعاء الدوال، والإخراج المنظّم، وتنفيذ الشفرة، والبحث في الملفات، والاستناد إلى بحث Google | الإخراج المنظّم، واستدعاء الدوال، والتخزين المؤقت |
| أنواع المدخلات | النصوص والصور والصوت والفيديو وملفات PDF | النصوص والصور والصوت والفيديو وملفات PDF | النصوص والصور والصوت والفيديو وملفات PDF |
| الفئة المجانية لواجهة API | غير متاحة | فئة مجانية محدودة | فئة مجانية محدودة |
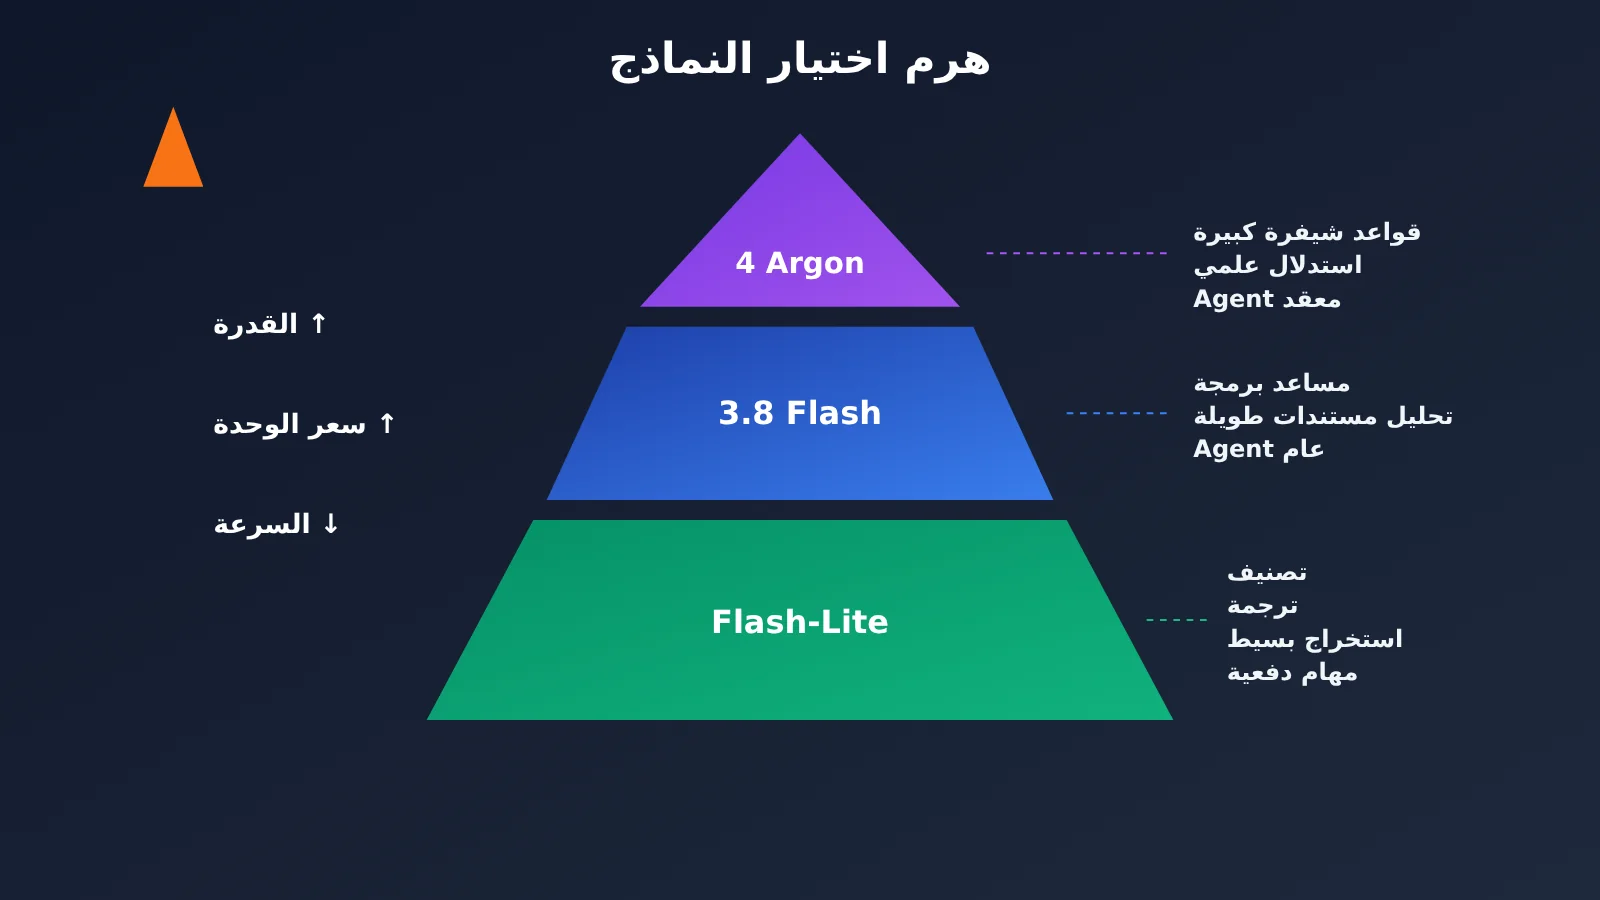
حدود قدرات نماذج Gemini الثلاثة
أُطلق Argon رسميًا في 13 أكتوبر 2026، وهو موجه بالدرجة الأولى إلى هندسة البرمجيات المعقدة، والاستدلال الرياضي والعلمي، ومهام الوكلاء المستقلة متعددة الخطوات، وتوليد المخرجات الطويلة. وتتطلب قدرته على الإخراج الطويل آلية مخصصة وإعدادات تنفيذ مناسبة؛ فلا يمكنه إرجاع مليون رمز مباشرةً في كل طلب.
يتمتع 3.8 Flash بقدرات استدلال، وليس مجرد «نسخة رخيصة لا تفكر». وهو مناسب لمساعدات البرمجة المعتادة، وتحليل المستندات الطويلة، وكتابة المحتوى، وسير عمل الوكلاء العامة. أما 3.5 Flash-Lite، الذي صدر في 21 يوليو 2026، فقد حُسّن لمهام التصنيف والترجمة والاستخراج البسيط وتحليل المستندات والمهام الفرعية البسيطة داخل الوكلاء. ويمكنه أيضًا التعامل مع بعض مهام البرمجة والاستدلال؛ ويكمن الفرق بينه وبين النماذج الأعلى فئة أساسًا في قدرته على أداء المهام المعقدة، واستقرار أدائه، والجدوى مقابل التكلفة.
أسعار Gemini API الرسمية: تدرّج تكاليف Argon وFlash وFlash-Lite
فيما يلي الأسعار الرسمية لشريحة الدفع القياسية في Gemini Developer API، بالدولار لكل مليون رمز (Token). ولا تشمل هذه الأسعار زيادات منصات الطرف الثالث أو عقود المؤسسات أو رسوم استدعاء الأدوات:
| النموذج | المدخلات | المخرجات | المدخلات المسترجعة من ذاكرة التخزين المؤقت | فترة سريان السعر |
|---|---|---|---|---|
| Gemini 4 Argon (الحالي) | $2.00 | $10.00 | $0.10 | حتى 2026-11-30 |
| Gemini 4 Argon (بعد التعديل) | $4.00 | $20.00 | $0.20 | بدءًا من 2026-12-01 |
| Gemini 3.8 Flash (الحالي) | $0.75 | $3.75 | $0.075 | حتى 2026-12-31 |
| Gemini 3.8 Flash (بعد التعديل) | $1.50 | $7.50 | $0.15 | بدءًا من 2027-01-01 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | لم يُحدَّد رسميًا موعد لمضاعفة السعر |
وفقًا للأسعار الحالية، يبلغ سعر مدخلات Argon نحو 2.67 ضعف سعر Flash، وسعر مدخلات Flash يعادل 2.5 ضعف سعر Flash-Lite، بينما يبلغ سعر مخرجات Argon أربعة أضعاف سعر Flash-Lite. السعران الحاليان لـ Argon وFlash ترويجيان، وينتهي العمل بهما في 30 نوفمبر و31 ديسمبر 2026 على التوالي، وبعد ذلك تتضاعف الأسعار. لذلك، عند إعداد ميزانية سنوية لمشروع طويل الأمد، يجب إجراء الحسابات على أساس الأسعار المعدّلة.
هناك تفصيل آخر يسهل إغفاله: تحتسب Google رموز التفكير الداخلية للنموذج ضمن تكلفة المخرجات. لذلك، لا تعتمد الفاتورة على طول الإجابة التي يراها المستخدم فقط؛ إذ يمكن أن يؤدي مستوى التفكير المرتفع إلى زيادة تكلفة المخرجات بشكل ملحوظ. وإذا لم تكن المهمة تتطلب استجابة فورية، فيمكن استخدام Batch API، حيث تنخفض أسعار المدخلات والمخرجات للنماذج الثلاثة بنسبة 50% مقارنة بالأسعار القياسية، لكن آلية التنفيذ وحدود قوائم الانتظار تختلف عن الطلبات الفورية.
مقارنة مستقلة لاختبارات الأداء وسرعة نماذج Gemini الثلاثة
تأتي البيانات التالية من منصة التقييم المستقلة Artificial Analysis، وتستخدم جميعها معيار Intelligence Index v5.0، دون خلطها بنتائج الإصدار الأقدم v4.x:
| المؤشر | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| مؤشر القدرات الشامل v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| سرعة الإخراج المرصودة | أكثر من 80 رمزًا في الثانية تقريبًا | نحو 120–140 رمزًا في الثانية | أكثر من 400 رمز في الثانية تقريبًا |
| قنوات الوصول | واجهة API الرسمية من Google، وAPIYI apiyi.com | واجهة API الرسمية من Google، وAPIYI | واجهة API الرسمية من Google، وAPIYI |
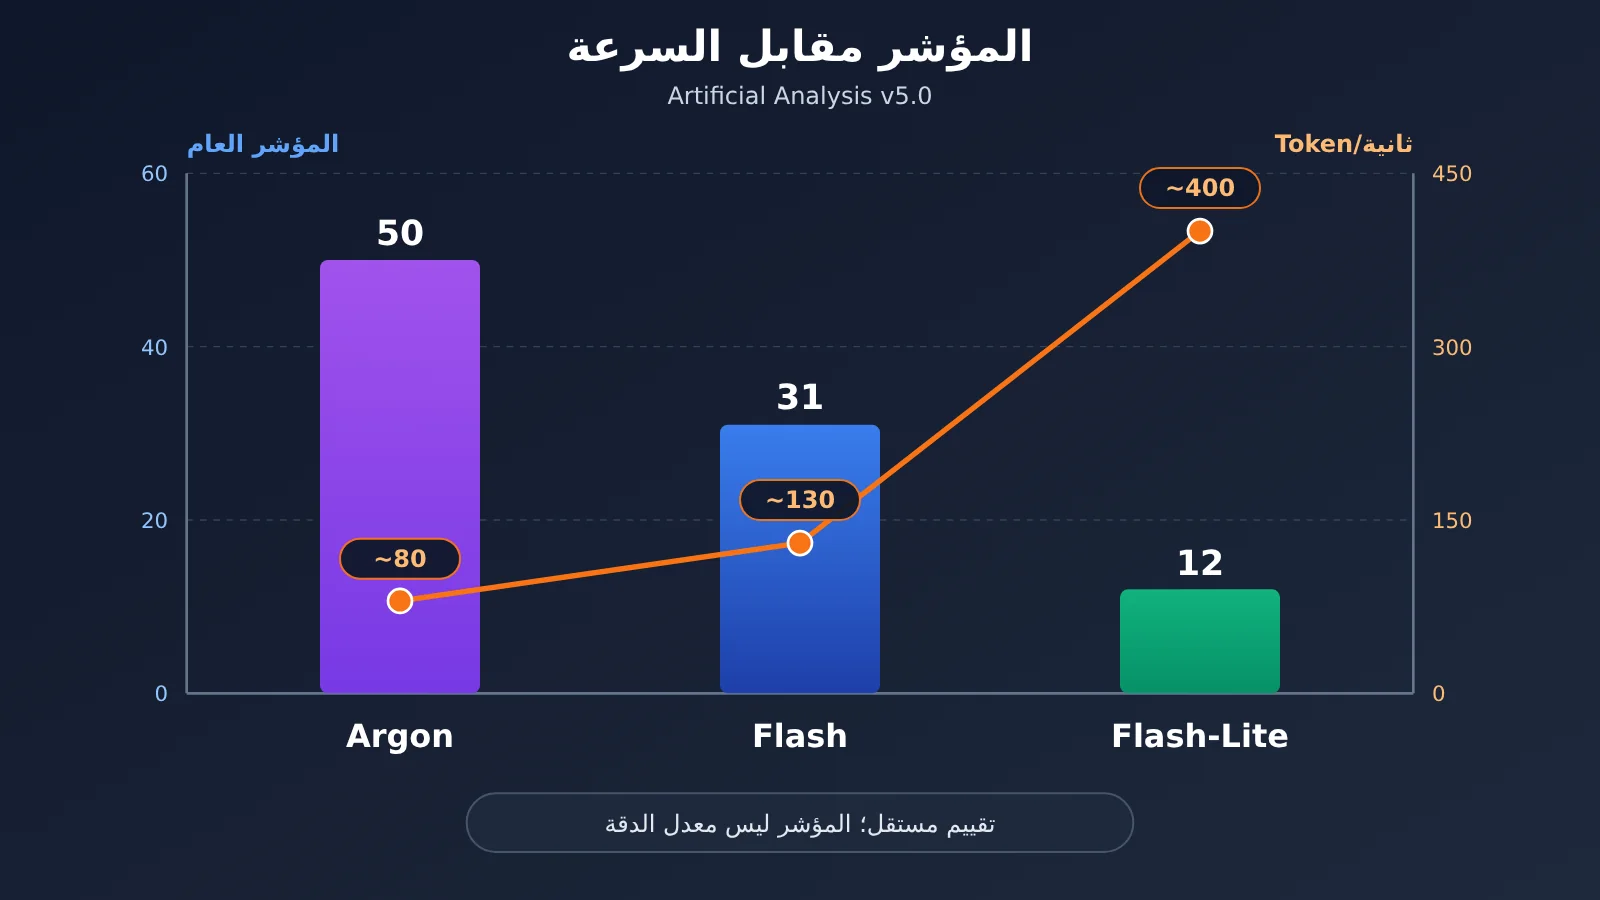
لفهم هذه البيانات بصورة صحيحة، انتبه إلى ثلاث نقاط:
- المؤشر ليس معدل الإجابات الصحيحة: الأرقام 50 و31 و12 هي درجات ضمن نظام التقييم، ولا تعني مثلًا أن النموذج «أجاب عن 50% من الأسئلة بشكل صحيح».
- الفروق واضحة في المهام المعقدة: يتصدر Argon اختبارات البرمجة والأتمتة المعقدة، يليه Flash، ثم Flash-Lite. لكن هذا لا يثبت أن Argon أفضل في كل مهمة بسيطة؛ فقد تكون النماذج الثلاثة كافية لمهام مثل التصنيف وتنظيم التنسيقات.
- لا يمكن تحويل السرعة مباشرة إلى وقت إنجاز: تتغير سرعة الإخراج بحسب حالة الخدمة، كما يتأثر الوقت الفعلي بمدة التفكير، وزمن ظهور الرمز الأول، واستدعاء الأدوات، والانتظار في الطابور، وتقلبات الشبكة.
💡 توضيح المقارنة: لا تعكس درجات الاختبارات سوى الفروق التقريبية بين قدرات النماذج، أما نتائجها في مهامك فهي المعيار النهائي. يمكنك استخدام مفتاح API واحد عبر APIYI apiyi.com للتبديل بين نماذج Gemini الثلاثة وإجراء المقارنة على عيناتك الخاصة.
محاكاة تكلفة Gemini API: ما الفرق بين فواتير Argon وFlash وFlash-Lite؟
الأرقام التالية مثال نظري وليست فواتير فعلية. نفترض أن رموز الإخراج تتضمن جميع رموز التفكير، مع استبعاد تكاليف التخزين المؤقت وأدوات البحث وإعادة المحاولة. وتستند الحسابات إلى الأسعار القياسية لشهر أكتوبر 2026:
| السيناريو | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1000 استدعاء يوميًا، بمدخلات من 5000 رمز ومخرجات من 1000 رمز لكل استدعاء (التكلفة اليومية) | $20.00 | $7.50 | $4.00 |
| A: السيناريو نفسه لمدة 30 يومًا | نحو $600 | نحو $225 | نحو $120 |
| B: تصنيف 100 ألف عنصر، بمدخلات من 1000 رمز ومخرجات من 200 رمز لكل عنصر | $400 | $150 | $80 |
| B: استخدام Batch API بدلًا من ذلك (بنصف سعر الوحدة) | نحو $200 | نحو $75 | نحو $40 |
يعكس السيناريو B الفرق في سعر الوحدة فقط عند استخدام العدد نفسه من الرموز. في الواقع، تختلف نماذج اللغة الكبيرة في عدد رموز التفكير وطول المخرجات وعدد مرات إعادة المحاولة، لذا لا يمكن افتراض أن إنفاق $80 على Flash-Lite سيحقق جودة مماثلة لإنفاق $400 على Argon. كذلك، بعد انتهاء السعر الترويجي لـ Argon وFlash، ستتضاعف الأرقام في عمودي هذين النموذجين.
تحليل التأثير: لماذا لا يكفي النظر إلى سعر التوكن عند استخدام Gemini API؟
التأثير على المطورين
يتكون «سعر» النموذج من ثلاثة مستويات على الأقل: الأول هو سعر التوكن؛ والثاني هو عدد التوكنات التي تستهلكها المهمة فعليًا، بما في ذلك الإدخال والإخراج والتفكير وتكرار السياق وإعادة المحاولة؛ أما الثالث فهو التكلفة الإجمالية لإنجاز مهمة بالمستوى المطلوب، مع احتساب معدل النجاح والمراجعة البشرية وإعادة المحاولات الفاشلة ووقت الإنجاز والخسائر التجارية الناتجة عن الأخطاء.
إذا كان Flash-Lite يفي بمتطلبات العمل في مهام التصنيف البسيطة، فإن الانتقال إلى Argon سيكون إهدارًا. وعلى العكس، إذا فشل Flash-Lite مرارًا في مهمة برمجية معقدة، بينما أنجزها Argon بمحاولات أقل، فقد يكون Argon أفضل من حيث القيمة مقابل التكلفة الإجمالية. هذا استنتاج مشروط لتوضيح مبدأ اختيار النموذج، وليس نتيجة إحصائية عن معدلات نجاح النماذج الثلاثة.
وتوضح تجارب المجتمع هذه النقطة أيضًا. فقد استخدم أحد مستخدمي Reddit نموذج Argon High في بيئة OpenCode لتنفيذ مهمة هندسة عكسية، واستهلك نحو 900 ألف توكن في تنفيذ واحد، دون أن تكتمل المهمة. هذا اختبار فردي لا يمكن اعتباره متوسطًا للقطاع، لكنه يذكرنا بأن مسارات عمل الوكلاء المعقدة قد تستهلك أعدادًا كبيرة من التوكنات دون ضمان النجاح. وأفاد مستخدم آخر بأن Argon وصل سريعًا إلى حد الاستخدام في اشتراك المستهلكين. وهذه تجربة تتعلق بمنتج اشتراك Gemini، ولا تعادل حدود الاستخدام في Developer API.
التأثير على القطاع
- أصبحت البنية متعددة النماذج والمستويات الخيار الافتراضي: تحدثت Google Cloud علنًا عن تنسيق استخدام نماذج متعددة والتوجيه الذكي (Smart Routing)، لتوزيع المهام وخفض تكاليف المؤسسات.
- تحوّل معيار التقييم من «سعر الوحدة» إلى «تكلفة إنجاز مهمة بالمستوى المطلوب»: كلما زاد حجم الاستدعاءات، ازدادت الحاجة إلى اختيار النماذج بناءً على مجموعات اختبار تعكس مهام العمل، بدلًا من الاعتماد على قوائم التصنيف.
- قِصر دورات الميزانية: مع انتهاء الأسعار الترويجية تباعًا، تحتاج الفرق إلى مراجعة مزيج النماذج والميزانية كل ثلاثة أشهر.
كيف يختار المطورون بين Argon وFlash وFlash-Lite؟
التوصيات التالية مشروطة بطبيعة المهمة؛ فلا يوجد نموذج هو الأفضل في جميع الحالات:
- تصنيف البيانات على نطاق واسع (مثل تصنيف 100 ألف خبر عن الذكاء الاصطناعي إلى إصدارات وتحديثات وأسعار وسياسات): جرّب Flash-Lite أولًا، بشرط أن يحقق المعدلات المطلوبة للدقة والالتزام بالتنسيق في اختبارات العينات. إذا لم يحققها، انتقل إلى 3.8 Flash.
- هيكلة المستندات الطويلة (مثل تحويل التقارير المالية والوثائق التقنية إلى جداول حقائق): جرّب 3.8 Flash أولًا، فهو أقوى من Lite في الفهم وأقل تكلفة من Argon. وعند الحاجة إلى اكتشاف التعارضات بين المستندات أو إجراء استدلال صعب، استدعِ Argon لهذه المهام تحديدًا.
- مشروعات البرمجة المعقدة (مثل فهم قواعد الشفرة الكبيرة وإعادة الهيكلة متعددة المراحل): جرّب Argon أولًا. فهو أقوى وفقًا لتصنيفه الرسمي ونتائج اختبارات البرمجة المستقلة، لكن لا يزال من الضروري التحقق من معدل نجاحه وتنفيذه للأدوات وتكلفته في المشروع الفعلي.
- الترجمة البسيطة بكميات كبيرة: جرّب Flash-Lite أولًا. أما المحتوى شديد التخصص، مثل المحتوى القانوني والطبي، فيحتاج إلى فحص إضافي للجودة؛ ولا ينبغي استخدامه دون مراجعة بشرية لمجرد انخفاض التكلفة.
- وكلاء المؤسسات: لا يُنصح بالاعتماد على نموذج واحد فقط. يمكن إسناد التصنيف والاستخراج وتوحيد التنسيقات إلى Flash-Lite، والتخطيط العام وسير العمل متعدد الخطوات إلى 3.8 Flash، والاستدلال الصعب وحل المشكلات المعقدة إلى Argon. هذه استراتيجية هندسية مقترحة، وليست شرطًا إلزاميًا من Google.
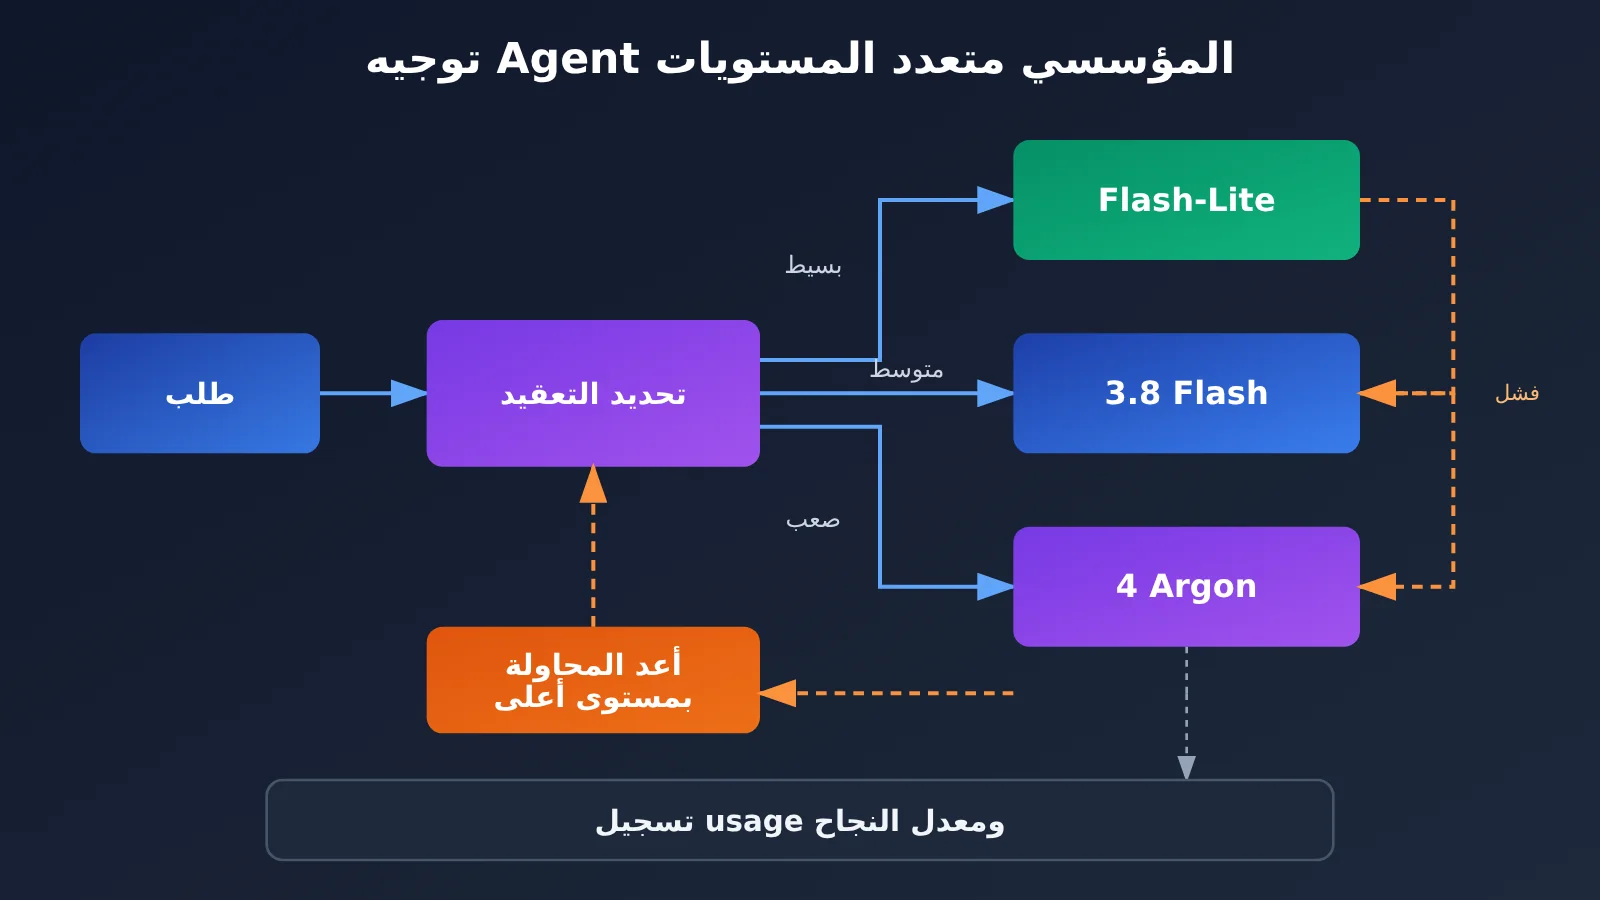
🎯 نصيحة للاختيار: يكمن نجاح التوجيه المتدرج في القدرة على التبديل بين النماذج الثلاثة بتكلفة منخفضة. توفر APIYI عبر apiyi.com واجهة متوافقة مع OpenAI، وتتيح الانتقال بين المستويات بتغيير المعامل
modelفقط، مما يناسب إجراء اختبارات مقارنة على نطاق صغير أولًا.
بداية سريعة: استدعاء نماذج Gemini الثلاثة عبر API
مثال مبسّط
يمكنك استخدام OpenAI SDK للاستدعاء، وتغيير قيمة model للتبديل بين Argon وFlash وFlash-Lite:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
عرض الشفرة الكاملة للتوجيه المتدرج وتقدير التكلفة
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 ابدأ بسرعة: ننصحك بالحصول أولاً على رصيد الاختبار المجاني للمستخدمين الجدد من APIYI على apiyi.com، ثم مقارنة مستويات النماذج الثلاثة باستخدام 100–300 عينة ممثلة قبل اختيار المستوى الافتراضي لبيئة الإنتاج. لاحظ أن أسعار المنصات الخارجية وأرصدة الاستخدام ودعم التخزين المؤقت قد تختلف عن الاتصال المباشر بـ Google؛ لذا يُرجى الرجوع إلى قواعد المنصة الفعلية.
اعتبارات نشر Gemini API قبل الإطلاق
- حدود الاستدعاء: تفرض Gemini API حدودًا للطلبات في الدقيقة (RPM)، والرموز في الدقيقة (TPM)، والطلبات في اليوم (RPD). تُحتسب هذه الحدود على مستوى المشروع، لا لكل مفتاح على حدة، ويؤدي تجاوز أي منها إلى ظهور خطأ.
- رموز التفكير: تشمل تكلفة المخرجات رموز التفكير. راجع البيانات الوصفية للاستخدام، ولا تقدّر التكلفة بناءً على طول الإجابة الظاهرة.
- التخزين المؤقت: يدعم Argon التخزين المؤقت الضمني فقط، ولا يدعم التخزين المؤقت الصريح. أما Flash وFlash-Lite فيدعمان التخزين المؤقت، وتعتمد تفاصيل التكلفة على الإعدادات.
- بيانات المستوى المجاني: قد تُستخدم بيانات المستوى المجاني لتحسين المنتجات. لا تضع بيانات المؤسسات الحساسة فيه، وراجع شروط الخدمة قبل الإطلاق.
- مقاييس الاختبار: سجّل معدل النجاح، ودقة الحقائق، ومعدل الالتزام بالبنية المطلوبة، وعدد الهلوسات، ومتوسط زمن الاستجابة وزمن الاستجابة في الحالات الأبطأ، وعدد الرموز الفعلي، وعدد مرات إعادة المحاولة، وتكلفة المهمة المستوفية للمعايير. تختلف مستويات التفكير الافتراضية، لذا وضّح الإعدادات المستخدمة فعليًا في التقرير.
الأسئلة الشائعة حول اختيار نموذج Gemini API
س1: ما نماذج Gemini 4 Argon و3.8 Flash و3.5 Flash-Lite؟
تمثل هذه النماذج المستويات الثلاثة الرئيسية في Gemini API من Google حاليًا: Argon هو نموذج الاستدلال الرائد، و3.8 Flash يوازن بين القدرات والكفاءة، أما 3.5 Flash-Lite فيتميز بزمن استجابة منخفض وتكلفة أقل وقدرة على معالجة عدد كبير من الطلبات. تدعم النماذج الثلاثة سياق إدخال يقارب مليون رمز، وتنتج مخرجات نصية.
س2: متى تنتهي الأسعار المخفضة لنموذجي Argon وFlash؟
تسري الأسعار الحالية لنموذج Argon حتى 30 نوفمبر 2026، وتتضاعف أسعار الإدخال والإخراج والتخزين المؤقت اعتبارًا من 1 ديسمبر. أما أسعار 3.8 Flash فتسري حتى 31 ديسمبر 2026، وتتضاعف اعتبارًا من 1 يناير 2027. ولم تعلن Google حتى الآن عن موعد مماثل لمضاعفة أسعار Flash-Lite.
س3: هل تعني درجة 50 من Artificial Analysis أن النموذج يجيب بشكل صحيح عن 50% من الأسئلة؟
لا. الدرجات 50 و31 و12 هي درجات مركّبة على مؤشر Intelligence Index v5.0، وليست نسبًا مئوية للإجابات الصحيحة. تصلح لمقارنة الفروق التقريبية بين النماذج، لكن لا يمكن تحويلها مباشرة إلى معدل نجاح في استخدامك الفعلي.
س4: كيف أقارن بين نماذج Gemini الثلاثة بتكلفة منخفضة؟
يُنصح باستخدام واجهة متوافقة مع OpenAI وتدعم عدة نماذج. بعد التسجيل في APIYI عبر apiyi.com والحصول على مفتاح API ورصيد مجاني، استبدل قيمة `model` في أمثلة المقال بمعرّف API لكل نموذج على التوالي، ثم سجّل استهلاك الرموز ومعدل النتائج المقبولة باستخدام مجموعة العينات نفسها.
س5: يذكر مستخدم على Reddit أن حصة Argon تنفد بعد بضع جولات. هل يحدث ذلك مع API أيضًا؟
جاءت تلك الملاحظة من منتج اشتراك Gemini الموجّه للمستهلكين، ولا تنطبق بالضرورة على حدود Developer API. تعتمد حصة API على مستوى الدفع وحالة المشروع والنموذج، وتُحسب وفق حدود RPM وTPM وRPD. وعند استدعاء النموذج عبر منصة تجميع، تنطبق أيضًا قواعد الحصص الخاصة بالمنصة. يمكنك الاطلاع على النماذج المتاحة فعليًا وطرق الفوترة في لوحة تحكم APIYI على apiyi.com.
س6: ما أبرز أوجه القصور المعروفة في كل نموذج؟
Argon هو الأعلى سعرًا والأبطأ، ولا تتوفر له باقة مجانية عادية، وقد تستهلك مهام الوكلاء المعقدة عددًا كبيرًا من الرموز. ويتأخر 3.8 Flash عن Argon بفارق واضح في أصعب اختبارات الطرفية والبرمجة. أما Flash-Lite فأداؤه أضعف في مهام البرمجة والأتمتة المعقدة، وتحتاج ترجماته في المجالات المتخصصة إلى مراجعة بشرية.
أهم النقاط لاختيار Gemini API
- خلفية الخبر: تقترب واجهات API لنماذج Google المباشرة من معالجة 32 مليار رمز (Token) في الدقيقة. وهذا يعكس نمو الاستخدام الإجمالي، وليس إنجاز نموذج واحد.
- الفئات الثلاث: يتولى Argon مهام الاستدلال المعقدة، ويشكّل 3.8 Flash الخيار المتوازن الأساسي، بينما يناسب Flash-Lite المهام الخفيفة ذات حجم الطلبات المرتفع.
- تدرّج الأسعار: تبلغ أسعار المدخلات الحالية $2 و$0.75 و$0.30 على الترتيب، وستتضاعف أسعار Argon وFlash بعد انتهاء الفترة الترويجية.
- قراءة التقييمات: تبلغ قيم مؤشر AA v5.0 للنماذج الثلاثة 50 و31 و12 على الترتيب. وهي قيم مؤشر وليست نسب دقة، وقد لا تظهر الفروق بوضوح في المهام البسيطة.
- التكاليف الخفية: تُحتسب رموز التفكير ضمن المخرجات، وتسهم تكاليف التخزين المؤقت وإعادة المحاولة والأدوات في تحديد الفاتورة النهائية.
- طريقة البدء: يمكن استخدام مفتاح واحد عبر APIYI على apiyi.com للتبديل بين الفئات الثلاث، وإجراء اختبار مقارن باستخدام 100–300 عينة.
الخلاصة
يشير الارتفاع الكبير في استخدام Gemini API إلى أن نماذج اللغة الكبيرة دخلت مرحلة الاستخدام الإنتاجي على نطاق واسع، لكن السؤال الأساسي عند اختيار النموذج لم يتغير:
- وزّع المهام حسب تعقيدها: جرّب Flash-Lite أولًا للتصنيف والترجمة، و3.8 Flash لهيكلة المستندات، وArgon للبرمجة المعقدة ومهام الوكلاء (Agents) الصعبة.
- انظر إلى تكلفة المهمة الناجحة: الهدف هو خفض التكلفة الإجمالية لكل مهمة تنجز بالمستوى المطلوب، وليس البحث عن أقل سعر لكل مليون رمز.
- تابع مواعيد انتهاء الأسعار الترويجية: تنتهي الفترة الترويجية لـ Argon في 30 نوفمبر، ولـ Flash في 31 ديسمبر. لذا احسب الميزانية وفق الأسعار بعد التعديل.
ما يحتاجه المطورون حقًا ليس النموذج الأقوى أو الأرخص دائمًا، بل مجموعة نماذج تنجز مهام العمل بثبات وبتكلفة مقبولة. يُنصح بالبدء باختبار مقارن للفئات الثلاث باستخدام الرصيد المجاني عبر APIYI على apiyi.com، ثم تحديد استراتيجية توجيه الطلبات في بيئة الإنتاج.
📚 المراجع
- كلمة الرئيس التنفيذي في تقرير أرباح Alphabet للربع الثالث من 2026: مصدر بيانات 32 مليار Token في الدقيقة
- الرابط:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
التفاصيل: خلفية الخبر والإفصاح الأصلي عن نمو استخدام API
-
التسعير الرسمي لـ Gemini API: الأسعار القياسية وأسعار التخزين المؤقت وBatch للنماذج الثلاثة
- الرابط:
ai.google.dev/gemini-api/docs/pricing -
التفاصيل: تتضمن تاريخ انتهاء السعر الترويجي وشرح احتساب تكلفة رموز التفكير
-
وثائق مواصفات نماذج Gemini: Argon و3.8 Flash و3.5 Flash-Lite
- الرابط:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
التفاصيل: نافذة السياق، والحد الأقصى للمخرجات، ومستويات التفكير، وقدرات الأدوات
-
مقارنة النماذج من Artificial Analysis: تقييم مستقل من جهة خارجية، الإصدار 5.0
- الرابط:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
التفاصيل: المؤشر الشامل، ومعايير التقييم المتخصصة، وقياسات السرعة
-
حدود استدعاء Gemini API وآلية التفكير: RPM وTPM وRPD وإعدادات التفكير
- الرابط:
ai.google.dev/gemini-api/docs/rate-limits -
التفاصيل: قواعد الحصص ورموز التفكير التي يجب قراءتها قبل الإطلاق
-
تنسيق النماذج المتعددة في Google Cloud: Smart Routing وإدارة تكاليف الوكلاء
- الرابط:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - التفاصيل: النهج الرسمي للتوجيه متعدد المستويات في المؤسسات
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لموقع APIYI، وزيارة مركز الوثائق على docs.apiyi.com للاطلاع على مزيد من موارد التكامل.