في الاستخدام الفعلي لـ APIYI، تعمل عمليات كتابة ذاكرة التخزين المؤقت واسترجاعها في سلسلتي OpenAI وClaude بشكل طبيعي، وتكون نسبة الاسترجاع مرتفعة. لكن نماذج Gemini النصية تختلف عن ذلك: فنسبة الاسترجاع فيها منخفضة جدًا، بل تكاد تكون معدومة. ويمكن التحقق من هذه الحقيقة في الفواتير وتفاصيل الاستخدام، وهي من أكثر الأمور التي تحيّر المطورين عند مطابقة الحسابات.
استنادًا إلى الوثائق الرسمية من Google (حتى 20 أكتوبر 2026)، يشرح هذا المقال خمسة أسباب لانخفاض نسبة استرجاع ذاكرة التخزين المؤقت في Gemini، ويوضح كيفية احتساب رسوم التخزين المؤقت في AI Studio (Gemini Developer API) وVertex AI.
هذا ليس تحليلًا يحمّل طرفًا آخر المسؤولية. لا تنص القواعد الرسمية لـ Google على أن «استخدام خدمة وكيل يخفض نسبة استرجاع ذاكرة التخزين المؤقت في Gemini»، كما لا يمكننا الجزم بصحة سبب معين من دون سجلات الطلبات لدى الجهة المزوّدة. لذلك سنبدأ بشرح القواعد الرسمية، ثم نعرض الحالات التي قد تجعلها «لا تنطبق»، ونختتم بخطوات عملية يمكنك تنفيذها بنفسك للتحقق من المشكلة ومطابقة الحسابات.
الفائدة الأساسية: بعد قراءة هذا المقال، ستعرف متى يسترجع Gemini البيانات من ذاكرة التخزين المؤقت ومتى لا يفعل ذلك، وستفهم نقطة التسعير المهمة وهي أن «إجمالي المدخلات يشمل الجزء المخزّن مؤقتًا»، كما ستتمكن من مطابقة الفاتورة بنفسك بالاستناد إلى حقول الاستجابة الرسمية.
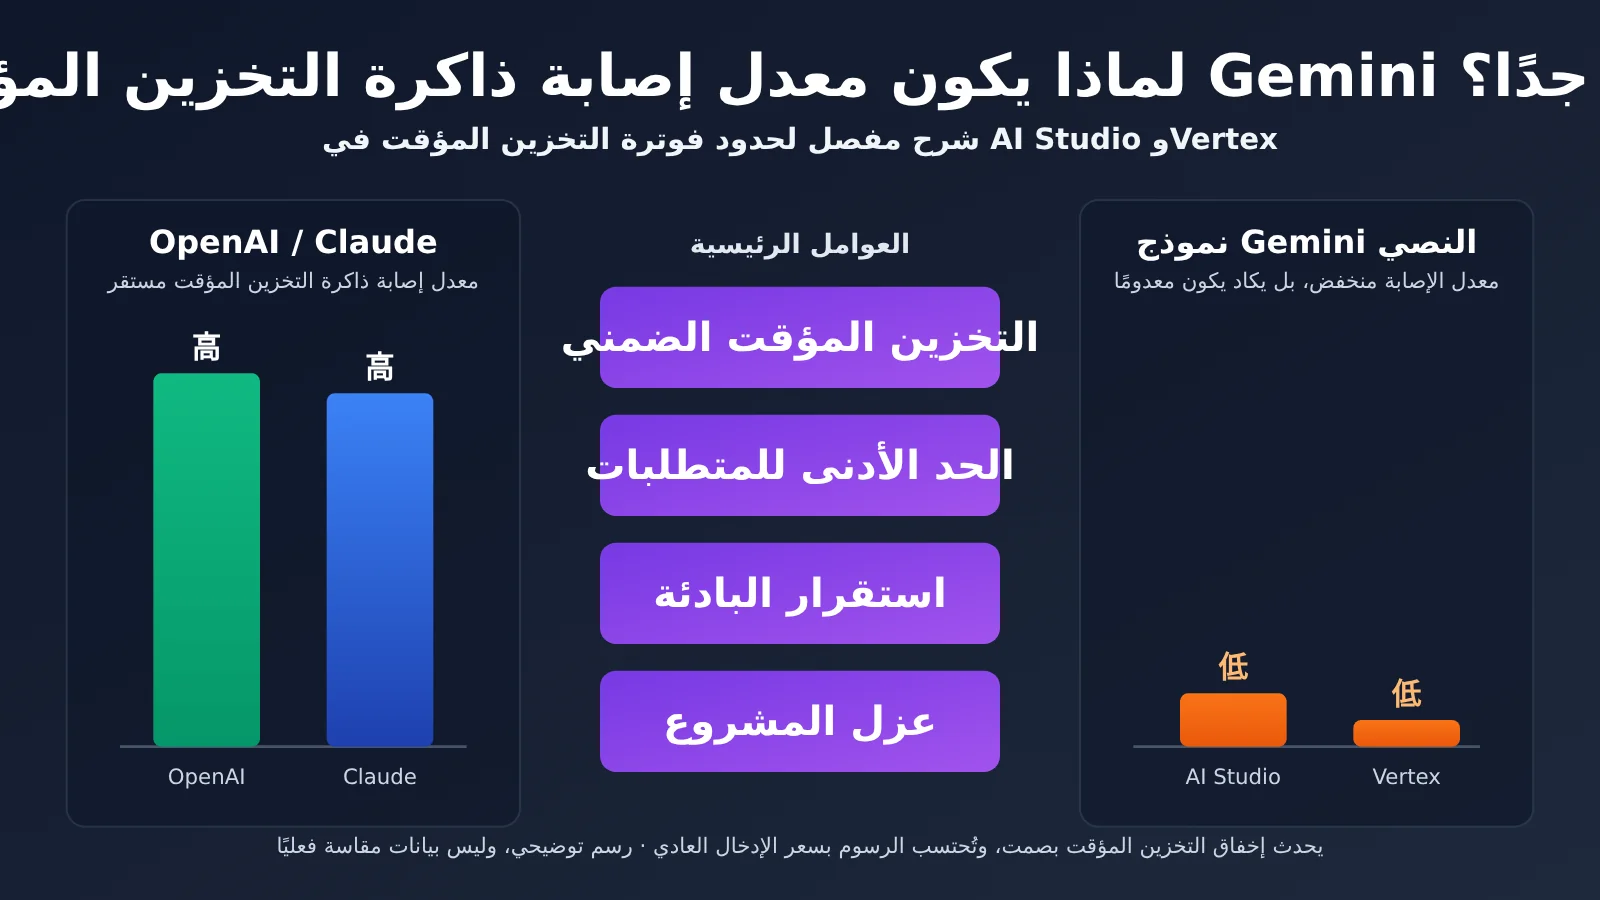
النقاط الأساسية لمعدل نجاح التخزين المؤقت في Gemini
لنبدأ بالخلاصة: لفهم التخزين المؤقت في Gemini، يجب التمييز بين آليتين مختلفتين تمامًا في طريقة التفعيل والفوترة: التخزين المؤقت الضمني والتخزين المؤقت الصريح.
| النوع | طريقة الاستخدام | كيفية الاستفادة من تخفيض التكلفة | هل توجد رسوم تخزين؟ |
|---|---|---|---|
| التخزين المؤقت الضمني Implicit caching | يُفعَّل تلقائيًا في النماذج المدعومة، ولا حاجة إلى إنشاء كائن تخزين مؤقت | بعد نجاح الطلب في استخدام التخزين المؤقت، تُحاسَب الرموز المخزنة مؤقتًا بالسعر المخفّض؛ لكن لا يوجد ضمان بأن كل طلب سيستفيد منه | لا |
| التخزين المؤقت الصريح Explicit caching | إنشاء كائن تخزين مؤقت يدويًا، ثم الإشارة إليه في الطلبات اللاحقة | تستفيد مدخلات التخزين المؤقت المشار إليه بنجاح من السعر المخفّض | نعم |
تتضمن الوثائق الرسمية عبارة مهمة بشأن التخزين المؤقت الضمني في Developer API، وهي أنه لا يضمن توفير التكاليف. أما التخزين المؤقت الصريح، فرغم أنه أكثر قابلية للتنبؤ، فإنه يتطلب جهدًا إضافيًا في التطوير، مثل إنشاء كائن التخزين المؤقت وإدارة مدة صلاحيته والإشارة إليه في الطلبات اللاحقة.
لماذا تختلف تجربة Gemini عن OpenAI وClaude؟
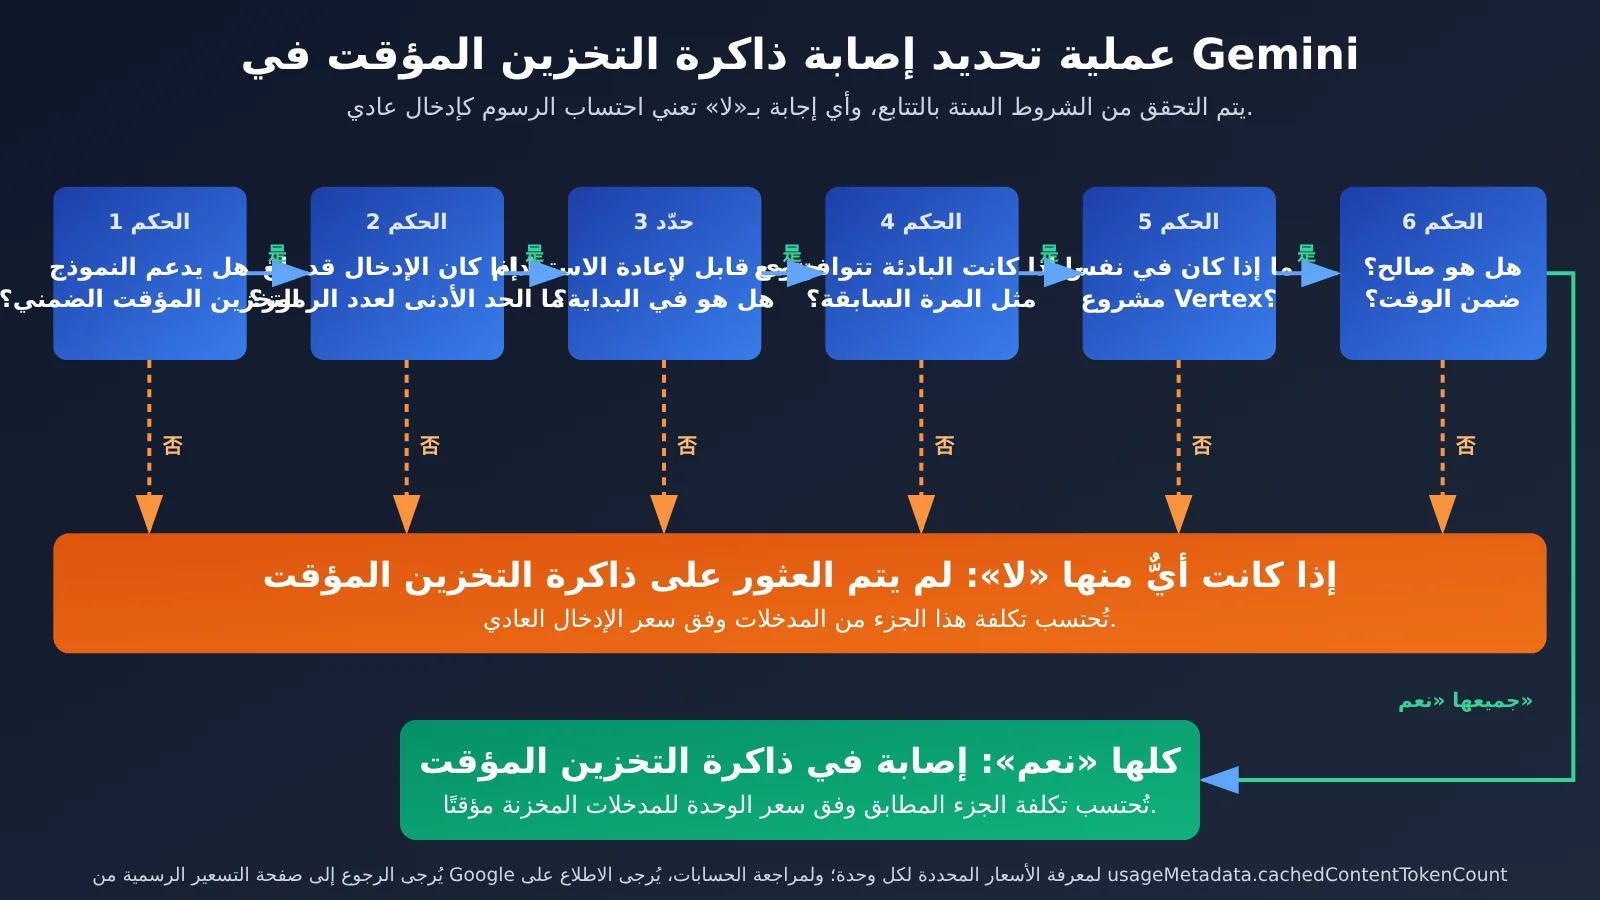
من منظور المستخدم، يظهر استخدام سلسلتي OpenAI وClaude عبر APIYI وكأنه يتيح «إرسال البادئة الطويلة نفسها» ورؤية عمليات كتابة التخزين المؤقت والاستفادة منه باستمرار. أما Gemini، فيتطلب تحقق عدة شروط معًا: أن يدعم النموذج التخزين المؤقت الضمني، وأن يبلغ الطلب الحد الأدنى من التوكنات المطلوب لذلك النموذج، وأن يكون المحتوى القابل لإعادة الاستخدام في بداية الموجه، وأن تُرسل الطلبات المتشابهة خلال فترة زمنية قصيرة، وأن تكون الطلبات في Vertex ضمن مشروع Google Cloud نفسه.
إذا لم يتحقق أي شرط من هذه الشروط، فستُحاسَب الطلبات وفق سعر الإدخال العادي، من دون ظهور خطأ أو أي تنبيه. وهذا ما يجعل انخفاض معدل النجاح في التخزين المؤقت يمر أحيانًا من دون ملاحظة: فعدم الاستفادة من التخزين المؤقت يحدث بصمت.
تحديد المقصود بـ AI Studio أولًا
نقصد بعبارة «قناة AI Studio» في هذا المقال Gemini Developer API، أي المسار الذي يستخدم مفتاح API صادرًا من AI Studio، ونقارنه بـ Vertex AI على Google Cloud. تتبع الآليتان النهج نفسه في التخزين المؤقت، لكنهما تختلفان في قيم الحد الأدنى ونطاق العزل وقواعد رسوم التخزين. وسنوضح هذه الفروق بالتفصيل أدناه.
الأسباب الخمسة لانخفاض معدل نجاح التخزين المؤقت في Gemini
ينقسم التحليل التالي إلى مستويين: أول سببين يستندان إلى قواعد مذكورة صراحةً في الوثائق الرسمية، أما الأسباب الثلاثة الأخرى فهي تفسيرات مشروطة تتعلق بظروف قد تُخلّ بهذه القواعد عند استخدام خدمات الوكيل أو في الممارسات الهندسية. ولا يمكننا تحديد السبب بمجرد معرفة أنك «استخدمت خدمة وكيل»؛ إذ نحتاج إلى بيانات المشروع upstream وسجلات الطلبات لتشخيص المشكلة.
السبب 1: عدم بلوغ الطلب الحد الأدنى من توكنات التخزين المؤقت
يشترط التخزين المؤقت الضمني حدًا أدنى من التوكنات، ولن تُخزَّن الطلبات الأقصر من ذلك مؤقتًا. كما أن الحد الأدنى يختلف بين المسارين. يوضح الجدول التالي بعض القيم الواردة في الوثائق الحالية:
| النموذج | الحد الأدنى للتخزين المؤقت الضمني في Developer API | الحد الأدنى للتخزين المؤقت الضمني في Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro (الجيل الأقدم، للمقارنة) | 2,048 | 2,048 |
هناك نقطتان يسهل الوقوع في الخطأ بشأنهما. أولًا، الحد الأدنى في النماذج الأحدث، مثل Gemini 3.8 Flash، أعلى منه في سلسلة 2.5؛ لذا فإن استخدام قيمة 2,048 من إصدار أقدم للتقدير سيؤدي إلى استنتاج خاطئ. ثانيًا، قد يكون الحد الأدنى للنموذج نفسه أعلى في Vertex. فالطلب الذي يتضمن 5,000 توكن قد يستوفي الشرط في Developer API، لكنه لا يستوفيه في Vertex.
غالبًا ما تحتوي طلبات المحادثات اليومية على بضع مئات إلى ألفي توكن فقط، أي إنها أقل من الحد المطلوب بطبيعتها. وهذا أحد الأسباب المباشرة لانخفاض معدل نجاح التخزين المؤقت في سيناريوهات الدردشة. وتجدر الإشارة إلى أن بلوغ الحد الأدنى شرط ضروري، لكنه لا يعني بالضرورة أن الطلب سيستفيد من التخزين المؤقت.
السبب 2: المحتوى القابل لإعادة الاستخدام ليس في بداية الموجه
توصي Google في كلا المسارين بوضع المحتوى الطويل والمتكرر في بداية الموجه، وإرسال الطلبات ذات البادئات المتشابهة خلال فترة زمنية قصيرة. يعتمد التخزين المؤقت على البادئة المشتركة، لا على مجرد «احتواء الطلب على المستند نفسه».
بعبارة أخرى، لا يكفي إرفاق المستند نفسه بطلبين لضمان الاستفادة من التخزين المؤقت. يجب أيضًا الانتباه إلى موضعه في الطلب، وإلى ثبات المحتوى الذي يسبقه. ومن السهل أن تؤدي كتابة كهذه إلى كسر البادئة:
# مثال مضاد: وضع المحتوى المتغير في البداية
[الوقت الحالي: 2026-10-20 10:31:07]
[معرّف الطلب: a8f3...]
{تعليمات النظام}
{المستند الطويل}
{سؤال المستخدم}
إذا اختلف حرف واحد في البداية، فلن يشترك المستند الطويل الذي يليه مع الطلب السابق في بادئة مشتركة. وهذا استنتاج مبني على التوصيات الرسمية، لكنه شائع جدًا في الممارسات الهندسية.
السبب 3: تغيير طبقة الوكيل للبادئة (احتمال مشروط)
إذا أضافت طبقة الوكيل في بداية الموجه وقتًا متغيرًا أو معرّفًا أو حقول تتبّع، أو أعادت ترتيب سياق المحادثات المتعددة أو ضغطته أو اقتطعته، فسيتغير الجزء المشترك من البادئة، ما يقلل فرص الاستفادة من التخزين المؤقت. هذا تحليل مشروط، ولا يجوز اعتباره دليلًا على أن خدمة بعينها تتصرف بهذه الطريقة.
عند استكشاف المشكلة، ميّز بين مستويين: هل البادئة التي ترسلها إلى خدمة الوكيل ثابتة؟ وهل البادئة التي ترسلها خدمة الوكيل إلى Google ثابتة؟ يمكنك التحكم في الأولى بنفسك، أما الثانية فتتطلب الاطلاع على سجلات الطلبات upstream.
السبب 4: توزيع الطلبات على مشاريع Vertex مختلفة (احتمال مشروط)
تنص Vertex صراحةً على أن التخزين المؤقت معزول بحسب مشروع Google Cloud، ولا يُشارك بين المشاريع. فإذا وُزعت الطلبات المتعددة في الجلسة نفسها على مشاريع Vertex مختلفة، فلن يتمكن المشروع B من استخدام التخزين المؤقت الذي أنشأه المشروع A.
لكن ينبغي توخي الحذر: ما إذا كان «تغيير المفتاح» يؤدي إلى فقدان التخزين المؤقت يعتمد على ما إذا كان المشروع قد تغيّر معه. لا يمكن الجزم بأن تغيير كل مفتاح يؤدي إلى فقدان التخزين المؤقت؛ بل يجب التحقق من العلاقة بين المفتاح والمشروع.
السبب 5: تمرير طلبات التوليد فقط من دون استخدام التخزين المؤقت الصريح
إذا كانت سلسلة الاستدعاء تكتفي بتمرير طلبات generateContent، من دون إنشاء كائن تخزين مؤقت أو الإشارة إليه في الطلبات اللاحقة، فستعتمد السلسلة بأكملها على التخزين المؤقت الضمني. ولا يقدم التخزين المؤقت الضمني ضمانًا بالاستفادة منه، لذلك لا يمكنه تحقيق العائد المستقر الذي يوفره التخزين المؤقت الصريح عبر «إنشاء الكائن مرة واحدة ثم الإشارة إليه مرارًا».
يوضح الجدول التالي كيف ترتبط بعض سيناريوهات استخدام خدمات الوكيل بالقواعد الرسمية:
| السلوك الفعلي | الأثر المحتمل | القاعدة الرسمية ذات الصلة |
|---|---|---|
| توزيع الجلسة نفسها على مشاريع Vertex مختلفة | تعذّر استخدام التخزين المؤقت الموجود في مشروع آخر | التخزين المؤقت معزول بحسب المشروع |
| إدراج وقت أو معرّف متغير في البداية، أو إعادة ترتيب السياق | كسر البادئة المشتركة وتقليل فرص الاستفادة من التخزين المؤقت | وضع المحتوى الطويل في البداية وتشابه البادئة |
| قِصر الطلب وعدم كفاية المحتوى الثابت القابل لإعادة الاستخدام | عدم بلوغ الحد الأدنى للتخزين المؤقت | الحد الأدنى من التوكنات |
| تمرير طلبات التوليد فقط من دون إنشاء كائن تخزين مؤقت صريح أو الإشارة إليه | الاعتماد على التخزين المؤقت الضمني فقط، من دون ضمان | يجب إنشاء كائن التخزين المؤقت الصريح والإشارة إليه |
🎯 نصيحة تقنية: عند استكشاف مشكلات التخزين المؤقت في Gemini، جرّب أولًا إرسال عدة طلبات متتالية بالبادئة الطويلة الثابتة نفسها عبر APIYI apiyi.com، ثم قارن حقل توكنات التخزين المؤقت في الردود. استخدم طلبات مضبوطة لاستبعاد مشكلات البادئة والحد الأدنى، ثم تحقّق مما إذا كانت المشكلة مرتبطة بمسار الطلب.
من دون بيانات المشروع upstream وسجلات الطلبات، لا يمكن تحديد السبب بمجرد معرفة أنك «استخدمت خدمة وكيل»، ولا يوجد سند رسمي للقول إن معدل الاستفادة من التخزين المؤقت في Vertex أعلى بالضرورة منه في Developer API.
كيفية تحديد فوترة التخزين المؤقت في AI Studio وVertex
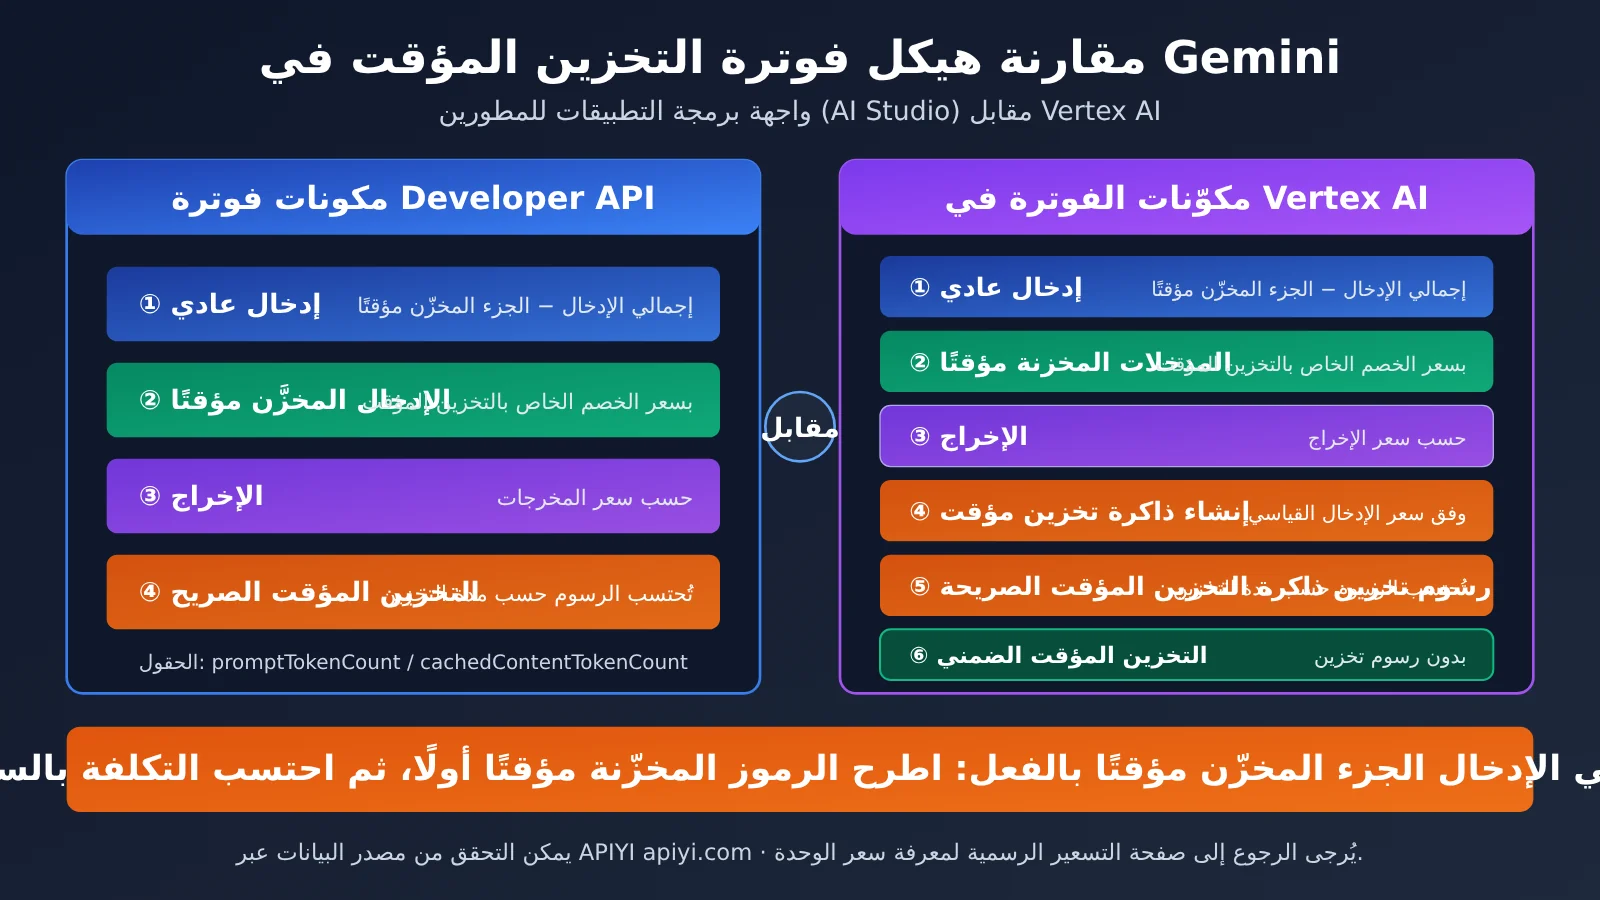
يظن كثيرون أن «الإصابة في ذاكرة التخزين المؤقت» تعني أن الاستخدام مجاني، أو أن الطلب كله يحصل على الخصم نفسه. وهذا غير صحيح. ففي كلا النظامين، يجب التمييز بين أربعة بنود: الإدخال العادي، والإدخال المخزّن مؤقتًا، والإخراج، ورسوم تخزين الذاكرة المؤقتة الصريحة.
مقارنة قواعد الفوترة في النظامين
| بند الفوترة | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| الإدخال العادي (الجزء غير المخزّن مؤقتًا) | يُحاسب بسعر الإدخال العادي | يُحاسب بسعر الإدخال العادي |
| الإدخال المخزّن مؤقتًا (الجزء المطابق) | يُحاسب بسعر الإدخال المخزّن مؤقتًا، ويُدرج هذا السعر منفصلًا في صفحة الأسعار | يُحاسب بسعر الإدخال المخزّن مؤقتًا، ويُدرج هذا السعر منفصلًا في صفحة الأسعار |
| الإخراج | يُحسب على حدة | يُحسب على حدة |
| الإدخال المستخدم لإنشاء ذاكرة مؤقتة | يُحتسب ضمن رسوم استخدام الرموز المميزة للذاكرة المؤقتة | يُحاسب بسعر الإدخال القياسي |
| رسوم تخزين الذاكرة المؤقتة الضمنية | لا توجد | لا توجد |
| رسوم تخزين الذاكرة المؤقتة الصريحة | تُحسب بحسب مدة التخزين | توجد رسوم تخزين |
توضح وثائق Developer API أن الفوترة تعتمد على رسوم استخدام الرموز المميزة للذاكرة المؤقتة، ومدة التخزين، والإدخال غير المخزّن مؤقتًا، والإخراج. أما Vertex، فيوضح أيضًا نقطتين: يُحاسب الإدخال المستخدم لإنشاء ذاكرة مؤقتة بسعر الإدخال القياسي، ولا توجد رسوم تخزين للذاكرة المؤقتة الضمنية، بينما تُفرض رسوم تخزين على الذاكرة المؤقتة الصريحة. يُرجى الرجوع إلى صفحات الأسعار الرسمية الحالية لكلتا الخدمتين لمعرفة الأسعار الدقيقة، إذ تختلف باختلاف النموذج وإصداره.
معادلة حساب تكلفة الإدخال
يمكن فهم تكلفة الإدخال في طلبات توليد النص العادية وفق الصيغة التالية:
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
تُحسب تكلفة الإخراج على حدة، وتُضاف إليها رسوم تخزين الذاكرة المؤقتة الصريحة إن وُجدت. إليك مثالًا افتراضيًا: إجمالي الإدخال في طلب ما هو 10,000 tokens، منها 8,000 tokens مطابقة لما هو مخزّن مؤقتًا. عندئذٍ تُحاسب 2,000 tokens بالسعر العادي، و8,000 tokens بسعر الإدخال المخزّن مؤقتًا.
أكثر نقطة يسهل الخطأ في حسابها: إجمالي الإدخال يشمل الجزء المخزّن مؤقتًا
عند مراجعة الحسابات، اعتمد على الاستجابة الأصلية من Google، لا على «نسبة إصابات الذاكرة المؤقتة» التي تعرضها لوحة خدمة الوكيل. في الحقل usageMetadata ضمن استجابة generateContent، يوجد حقلان أساسيان:
| الحقل | المعنى | ملاحظة عند مراجعة الحسابات |
|---|---|---|
usageMetadata.promptTokenCount |
إجمالي رموز الإدخال | يشمل الجزء المخزّن مؤقتًا |
usageMetadata.cachedContentTokenCount |
عدد رموز الجزء المخزّن مؤقتًا | عدد الرموز التي طابقت الذاكرة المؤقتة |
لذلك، لا تحسب promptTokenCount بأكمله بالسعر العادي ثم تضف إليه رسوم الإدخال المخزّن مؤقتًا؛ فذلك يؤدي إلى احتساب الجزء نفسه مرتين. الطريقة الصحيحة هي طرح الجزء المخزّن مؤقتًا من إجمالي الإدخال أولًا، ثم احتساب المتبقي بالسعر العادي. وإذا كنت تستخدم Interactions API الجديد، فإن الحقل الرسمي لإحصاءات التخزين المؤقت هو usage.total_cached_tokens.
أمران يجب الفصل بينهما
من المهم أيضًا التمييز بين أمرين: مقدار ما طابق الذاكرة المؤقتة فعليًا لدى Google، وكيف تحتسب خدمة الوكيل هذا الخصم في فاتورتك. يمكن قياس الأول باستخدام الحقول الرسمية، أما الثاني فيعتمد على قواعد الفوترة الخاصة بخدمة الوكيل، ولا يمكن لوثائق Google الرسمية أن تثبته نيابةً عنها. لذلك، عند مراجعة الفاتورة، يُنصح بمقارنة حقول التخزين المؤقت الواردة من الخدمة المصدرية مع تفاصيل الفاتورة وطريقة احتسابها.
💡 نصيحة للاختيار: ابدأ بمراجعة حقل رموز الذاكرة المؤقتة على مستوى الطلب، ثم تحقّق من إجمالي الفاتورة. وإذا أردت مقارنة OpenAI وClaude وGemini وفق معيار موحّد، يمكنك استخدام APIYI apiyi.com لاستدعاء النماذج المختلفة بالموجه نفسه، والتبديل بينها بسهولة.
اختلاف فوترة التخزين المؤقت بين Gemini وClaude وOpenAI
تختلف آلية التخزين المؤقت لدى الشركات الثلاث، كما تختلف طريقة مراجعة الحسابات. يقارن الجدول التالي بينها من حيث «طريقة التفعيل والفوترة». وقد تتغير نسب الخصم ومدد التخزين مع إصدارات النماذج؛ والبيانات أدناه تقديرية وفقًا للمعلومات المتاحة وقت كتابة هذا النص، لذا يُرجى الرجوع إلى صفحات الأسعار الرسمية لكل شركة لمعرفة الأرقام الدقيقة:
| بند المقارنة | Gemini | Claude | OpenAI |
|---|---|---|---|
| طريقة التفعيل | آلية ضمنية تلقائية، إلى جانب كائنات التخزين المؤقت الصريحة | صريحة: استخدام cache_control في الطلب لتحديد نقطة التخزين المؤقت |
تلقائية، دون الحاجة إلى تعديل الشفرة |
| رسوم الكتابة إلى الذاكرة المؤقتة | لا توجد رسوم للآلية الضمنية؛ أما الإنشاء الصريح فيُحاسب وفق الإدخال، مع رسوم تخزين إضافية | توجد؛ سعر الكتابة أعلى من سعر الإدخال العادي، ويختلف بحسب مدة الصلاحية (5 دقائق أو ساعة) | لا توجد رسوم منفصلة للكتابة |
| سعر قراءة الذاكرة المؤقتة (عند المطابقة) | أقل من سعر الإدخال العادي، ويختلف الخصم بحسب النموذج | نحو عُشر سعر الإدخال العادي | أقل من سعر الإدخال العادي، ويختلف الخصم بحسب النموذج |
| رسوم التخزين | للذاكرة المؤقتة الصريحة فقط، وتُحسب بحسب مدة التخزين | لا توجد؛ إذ تُحدد مدة الصلاحية عند الكتابة | لا توجد |
| الحد الأدنى | يختلف بحسب النموذج والقناة؛ وقد يكون أعلى في Vertex منه في Developer API | يختلف بحسب النموذج، وغالبًا يبدأ من 1,024 أو أكثر | عادةً يبدأ من 1,024 tokens |
| ضمان المطابقة | لا يوجد ضمان للآلية الضمنية؛ أما الصريحة فنتائجها أوثق | بعد تحديد نقطة التخزين المؤقت، تكون المطابقة مستقرة عادةً خلال مدة الصلاحية | مطابقة تلقائية للبادئة، دون ضمان |
| حقول الاستخدام | cachedContentTokenCount (مضمّن في promptTokenCount) |
cache_creation_input_tokens وcache_read_input_tokens، وتُعرض منفصلة عن رموز الإدخال العادية |
prompt_tokens_details.cached_tokens (مضمّن في prompt_tokens) |
ثمة ثلاث نقاط في هذا الجدول يكثر الالتباس حولها:
- رسوم الكتابة: في Claude، تكلف كتابة البيانات إلى الذاكرة المؤقتة أكثر، بينما تكون القراءة منها أرخص. لذلك، قد يكون استخدامها أغلى من عدم استخدامها إذا كثرت الكتابة وقلّت القراءة. أما OpenAI فلا يفرض رسومًا للكتابة، لذا لا تترتب تكلفة إضافية عند عدم المطابقة. وينطبق الأمر نفسه على التخزين المؤقت الضمني في Gemini؛ إذ لا توجد رسوم كتابة، بينما تنشأ تكاليف الإنشاء والتخزين في حالة التخزين المؤقت الصريح فقط.
- من يقرر التخزين المؤقت؟ يحدد الطرف صاحب الطلب نقاط التخزين المؤقت صراحةً في Claude، لذا تكون نتائج المطابقة أكثر قابلية للتوقع. أما التخزين المؤقت الضمني لدى OpenAI وGemini، فتقرره المنصة تلقائيًا، ولا يسع المطور سوى تحسين فرص المطابقة بالحفاظ على ثبات البادئة. وهذا أحد أسباب شعور المستخدمين بأن المطابقة في Claude وOpenAI أكثر استقرارًا من Gemini؛ إذ تتأثر Gemini بالحد الأدنى والبادئة وعزل القنوات في الوقت نفسه.
- طريقة احتساب إجمالي الإدخال: يشمل إجمالي الإدخال في Gemini وOpenAI الجزء المخزّن مؤقتًا، لذا يجب طرحه قبل حساب التكلفة. أما
input_tokensفي Claude فلا يشمل عمليات القراءة والكتابة من الذاكرة المؤقتة، وتُحسب البنود الثلاثة كلٌّ على حدة ثم تُجمع. استخدام معادلة إحدى الشركات لحساب تكلفة شركة أخرى يؤدي إلى خطأ في الحساب. وعند مقارنة الفواتير بين النماذج عبر APIYI apiyi.com، تحقّق أولًا من طريقة احتساب الحقول التي تعرضها كل شركة.
دليل سريع لاختبار معدل إصابة ذاكرة Gemini المؤقتة بنفسك
بعد استعراض الجانب النظري، يبقى الاختبار العملي الطريقة الأوثق للتحقق. الفكرة هي إنشاء بادئة ثابتة وطويلة تتجاوز الحد الأدنى المطلوب، ووضع السؤال المتغير في النهاية، ثم إرسال عدة طلبات متتالية ومراقبة تغيّر حقول الرموز المميزة المخزّنة مؤقتًا.
مثال مبسط
يستخدم الكود التالي تنسيقًا متوافقًا مع OpenAI، ويطبع معلومات الاستخدام الواردة في الاستجابة. اعتمد أسماء الحقول الفعلية التي تظهر في الاستجابة، إذ قد تختلف أسماء الحقول المتعلقة بالتخزين المؤقت باختلاف طريقة الاتصال:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
عرض كود الاختبار الكامل والتحقق من الفوترة
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 ابدأ بسرعة: نوصي باستخدام APIYI apiyi.com لإجراء هذه المقارنة. يكفي تغيير قيمة
modelفي السكربت نفسه لاختبار Gemini وOpenAI وClaude تباعًا، وملاحظة الفروق في أداء التخزين المؤقت بين النماذج.
متغيرات ينبغي ضبطها أثناء الاختبار
أثناء الاختبار، راجع القائمة التالية بندًا بندًا، حتى لا تخلط بين مشكلة في إعداداتك ومشكلة في مسار الاتصال:
| بند التحقق | الإجراء | الهدف |
|---|---|---|
| طول البادئة | تأكد من أنها تتجاوز الحد الأدنى الحالي للنموذج المستهدف | استبعاد مشكلة الحد الأدنى |
| ثبات البادئة | لا تضع طابعًا زمنيًا أو معرّف طلب في بدايتها | تجنب تغيير البادئة |
| موضع المحتوى المتغير | ضع سؤال المستخدم في النهاية | الحفاظ على أطول بادئة مشتركة |
| الفاصل بين الطلبات | أرسل الطلبات المتتالية خلال فترة قصيرة | الالتزام بتوصيات Google الرسمية |
| مجموعة المقارنة | اختبر موجهًا واحدًا على OpenAI أو Claude | تحديد ما إذا كان الفرق ناتجًا عن آلية النموذج أم عن مسار الاتصال |
كيفية تفسير نتائج الاختبار
إذا كانت البادئة طويلة بما يكفي، وبنيتها مستقرة، والفاصل بين الطلبات قصيرًا، ومع ذلك لم يحقق Gemini إلا عددًا ضئيلًا من الإصابات في الذاكرة المؤقتة، بينما نجح الموجه نفسه في تحقيق إصابات طبيعية على OpenAI أو Claude، فهذا يعني أن الفرق يرجع إلى آلية التخزين المؤقت في Gemini وظروف مسار الاتصال مع الخدمة الأساسية، وليس إلى طريقة كتابة الموجه. في هذه الحالة، يمكنك التفكير في استخدام التخزين المؤقت الصريح، بتثبيت المحتوى الطويل الذي تحتاج إلى إعادة استخدامه، وإنشاء عنصر ذاكرة مؤقتة يدويًا ثم الإشارة إليه في الطلبات.
أما إذا كان نشاطك يعتمد أساسًا على محادثات قصيرة، فلا داعي للسعي وراء معدل إصابة مرتفع؛ تقبّل أن فائدة التخزين المؤقت في Gemini محدودة في مثل هذه الحالات، وركّز تحسين التكاليف على اختيار النموذج والتحكم في طول المخرجات.
الأسئلة الشائعة
س1: لماذا يكون معدل إصابة ذاكرة Gemini المؤقتة أقل بوضوح من OpenAI وClaude؟
يتطلب التخزين المؤقت الضمني في Gemini استيفاء عدة شروط في آنٍ واحد: أن يدعم النموذج هذه الميزة، وأن يتجاوز النص الحد الأدنى المطلوب من الرموز، وأن تظل البادئة ثابتة، وأن تكون الطلبات متقاربة زمنيًا. كما يخضع التخزين على Vertex للعزل بين المشاريع، وتوضح Google رسميًا أن ضمان حدوث الإصابة غير متوفر. وإذا لم يتحقق أي شرط من هذه الشروط، فستُحتسب تكلفة الإدخال العادي تلقائيًا من دون تنبيه. ولمعرفة سبب المشكلة في مسار اتصال معين، يلزم الرجوع إلى سجلات الطلبات لدى الخدمة الأساسية.
س2: هل قالت Google رسميًا إن استخدام خدمة وكيل API يقلل معدل الإصابة في الذاكرة المؤقتة؟
لا. اقتصرت Google رسميًا على توضيح شروط التخزين المؤقت: وجود بادئة قابلة لإعادة الاستخدام، وتجاوز الحد الأدنى من الرموز، والالتزام بنطاق التطبيق. وإذا غيّر مسار الاتصال هذه الشروط، فقد ينخفض معدل الإصابة. ولمقارنة أداء التخزين المؤقت بين النماذج، يمكنك إجراء اختبار مضبوط باستخدام الموجه نفسه عبر APIYI apiyi.com.
س3: هل الجزء الذي يحقق إصابة في الذاكرة المؤقتة مجاني؟
لا. تُحتسب تكلفة الجزء الذي يحقق إصابة وفق سعر إدخال البيانات المخزنة مؤقتًا، وهو أقل من سعر الإدخال العادي لكنه ليس مجانيًا. وتعرض صفحات التسعير لدى الطرفين سعرَي الإدخال العادي والإدخال المخزن مؤقتًا كلًّا على حدة، كما تترتب رسوم تخزين إضافية على التخزين المؤقت الصريح.
س4: هل ينبغي إضافة رموز الإدخال المخزنة مؤقتًا مرة أخرى إلى رموز الإدخال في الفاتورة؟
لا. يمثل `promptTokenCount` إجمالي الإدخال، وهو يتضمن بالفعل الجزء المخزن مؤقتًا. اطرح `cachedContentTokenCount` من إجمالي الإدخال لتحصل على الجزء الذي يُحتسب بسعر الإدخال العادي، ثم احسب تكلفة الجزء المخزن مؤقتًا على حدة.
س5: هل حد التخزين المؤقت في AI Studio هو نفسه في Vertex؟
ليس تمامًا. وفقًا للوثائق الحالية، يبلغ الحد الأدنى لكل من Gemini 3.1 Pro Preview وGemini 3.8 Flash مقدار 4,096 في Developer API و6,144 في Vertex. أما الجيل السابق Gemini 2.5 Pro، فالحد الأدنى له 2,048 في كليهما. وقد تتغير الحدود مع تحديث إصدارات النماذج، لذا يُستحسن الرجوع إلى الأرقام الواردة في الوثائق الرسمية الحالية.
س6: هل أفقد الذاكرة المؤقتة إذا غيّرت مفتاح API؟
يعتمد ذلك على ما إذا كنت قد غيّرت المشروع. فالتخزين المؤقت في Vertex معزول حسب مشروع Google Cloud، ولا تتم مشاركته بين المشاريع؛ لذلك يؤدي الانتقال إلى مفتاح تابع لمشروع آخر إلى فقدان الذاكرة المؤقتة. أما المفاتيح المختلفة ضمن المشروع نفسه، فلا يمكن الجزم بأن تغييرها يؤدي إلى فقدانها.
س7: هل أستخدم التخزين المؤقت الضمني أم الصريح؟
إذا كنت تحتاج إلى إعادة استخدام محتوى طويل وثابت، مثل مستند مطول أو تعليمات نظام طويلة، فالتخزين المؤقت الصريح أكثر موثوقية، لكنه يتطلب جهدًا في التطوير ورسومًا للتخزين. أما إذا كانت إعادة الاستخدام عرضية، فالتخزين المؤقت الضمني لا يتطلب تكلفة إضافية، لكن فائدته غير مضمونة. يمكنك البدء بمقارنة صغيرة عبر APIYI apiyi.com، ثم تحديد ما إذا كان الاستثمار في تطوير التخزين المؤقت الصريح مناسبًا.
س8: هل يمكن الاعتماد مباشرةً على معدل الإصابة الذي تعرضه لوحة تحكم خدمة وكيل API لمطابقة الفواتير؟
لا يُنصح بذلك. اعتمد على حقول التخزين المؤقت في الاستجابة الأصلية من الخدمة الرسمية. كذلك، فإن الإصابات الفعلية لدى Google ورسوم الفوترة التي تفرضها خدمة وكيل API أمران مختلفان؛ لذا ينبغي مراجعة قواعد الفوترة الخاصة بمزوّد الخدمة.
أهم النقاط حول معدل إصابة ذاكرة التخزين المؤقت
- الملاحظة مؤكدة: تحقق سلسلة OpenAI وسلسلة Claude معدلات إصابة مستقرة، بينما يكون المعدل في Gemini منخفضًا، وقد يقترب من الصفر؛ لذا ينبغي تحليل الحالة على حدة.
- الإصابة غير مضمونة رسميًا: لا تضمن ذاكرة التخزين المؤقت الضمنية في Gemini توفير التكاليف، أما الذاكرة الصريحة فتتطلب إنشاء كائن ذاكرة تخزين مؤقت والإشارة إليه يدويًا.
- الحد الأدنى يختلف باختلاف النموذج: الحد الأدنى أعلى في النماذج الأحدث، وقد تختلف القيم بين Vertex وDeveloper API.
- المقدمة تحدد الإصابة: ضع المحتوى الطويل في البداية، وتجنب إدراج عناصر متغيرة، مثل الوقت أو المعرّفات، في مطلع الطلب حتى لا ينقطع البادئ المشترك.
- ذاكرة Vertex معزولة بحسب المشروع: لا تُشارك ذاكرة التخزين المؤقت بين المشاريع؛ لذا يؤدي توزيع الطلبات على مشاريع مختلفة إلى فقدان الإصابة.
- إجمالي الإدخال يشمل الجزء المخزّن مؤقتًا: يتضمن
promptTokenCountالرموز الموجودة في ذاكرة التخزين المؤقت؛ لذا اطرحها أولًا عند مطابقة الفواتير، ثم احسب تكلفة كل جزء على حدة. - طابق الفواتير بالاعتماد على الحقول: اعتمد على حقول ذاكرة التخزين المؤقت في الاستجابة الرسمية، وأجرِ مقارنة بين النماذج باستخدام الموجه نفسه عبر APIYI apiyi.com.
الخلاصة
ينتج انخفاض معدل إصابة ذاكرة التخزين المؤقت في Gemini عن اجتماع عدة عوامل: الإصابة غير مضمونة في التخزين الضمني، والحد الأدنى لعدد الرموز يرتفع بحسب النموذج، والبادئ يجب أن يظل ثابتًا، وذاكرة Vertex معزولة بحسب المشروع، فيما يتطلب التخزين الصريح إنشاء الذاكرة يدويًا. وعندما تتغير بعض هذه العوامل على مستوى مسار الطلب، ينخفض معدل الإصابة، لكن تحديد السبب بدقة يتطلب مراجعة المشروع upstream وسجلات الطلبات.
أما الفوترة، فتذكّر ثلاث نقاط: الإصابة بذاكرة التخزين المؤقت ليست مجانية؛ وإجمالي الإدخال يشمل الجزء المخزّن مؤقتًا، فلا تحتسبه مرتين؛ كما أن التخزين الصريح له رسوم تخزين إضافية، بخلاف التخزين الضمني. اعتمد في مطابقة الفواتير على حقول الاستجابة الرسمية، وتحقق أيضًا من آلية الفوترة لدى خدمة الوكيل بصورة مستقلة.
الخطوة التالية المقترحة: استخدم نص الاختبار الوارد في المقال لإجراء مقارنة بين Gemini وOpenAI وClaude مع تثبيت بادئ طويل، ثم قرر ما إذا كان من المناسب اعتماد التخزين الصريح. ونوصي باستخدام APIYI apiyi.com للتحقق من النتائج بسرعة؛ إذ تتيح واجهة موحدة استخدام عدة نماذج ومقارنة تكاليفها بسهولة.
المراجع
- وثائق التخزين المؤقت في Gemini API: شرح رسمي للتخزين المؤقت الضمني والصريح
- الرابط:
ai.google.dev/gemini-api/docs/caching -
ملاحظة: تتضمن الحد الأدنى لعدد الرموز والعوامل المؤثرة في الفوترة
-
صفحة أسعار Gemini API: أسعار الإدخال العادي والإدخال المخزّن مؤقتًا والإخراج والتخزين
- الرابط:
ai.google.dev/gemini-api/docs/pricing -
ملاحظة: مرجع للتحقق من الأسعار الحالية
-
نظرة عامة على التخزين المؤقت للسياق في Vertex AI: عزل المشاريع وقواعد الفوترة الخاصة بالتخزين المؤقت
- الرابط:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
ملاحظة: توضح أن ذاكرة التخزين المؤقت في Vertex لا تُشارك بين المشاريع
-
مرجع Gemini API generateContent: حقل usageMetadata في الاستجابة
- الرابط:
ai.google.dev/api/generate-content - ملاحظة: حقل رموز التخزين المؤقت المستخدم عند مراجعة الفوترة
المؤلف: فريق APIYI
للنقاشات التقنية: يسعدنا أن تشاركوا تجاربكم في استكشاف مشكلات التخزين المؤقت في Gemini ضمن التعليقات. ولمزيد من المعلومات، تفضلوا بزيارة مركز وثائق APIYI على docs.apiyi.com.