
ملخص اختبارات الكتابة مع GPT وClaude وKimi: الخلاصة أولًا
جرّب GPT-6.1 Sol أولًا للمقالات الإنجليزية؛ وجرّب Claude Opus 5.5 أولًا للمسودات الطويلة التي يهمّ فيها أسلوب الكتابة؛ وفي الشرح العلمي التبسيطي يستحق Kimi K3 الانضمام إلى القائمة. كما أن الأداء الإنجليزي العام لـ Kimi K3.1 Pro قوي جدًا، وهو قريب من GPT في ToneBench.
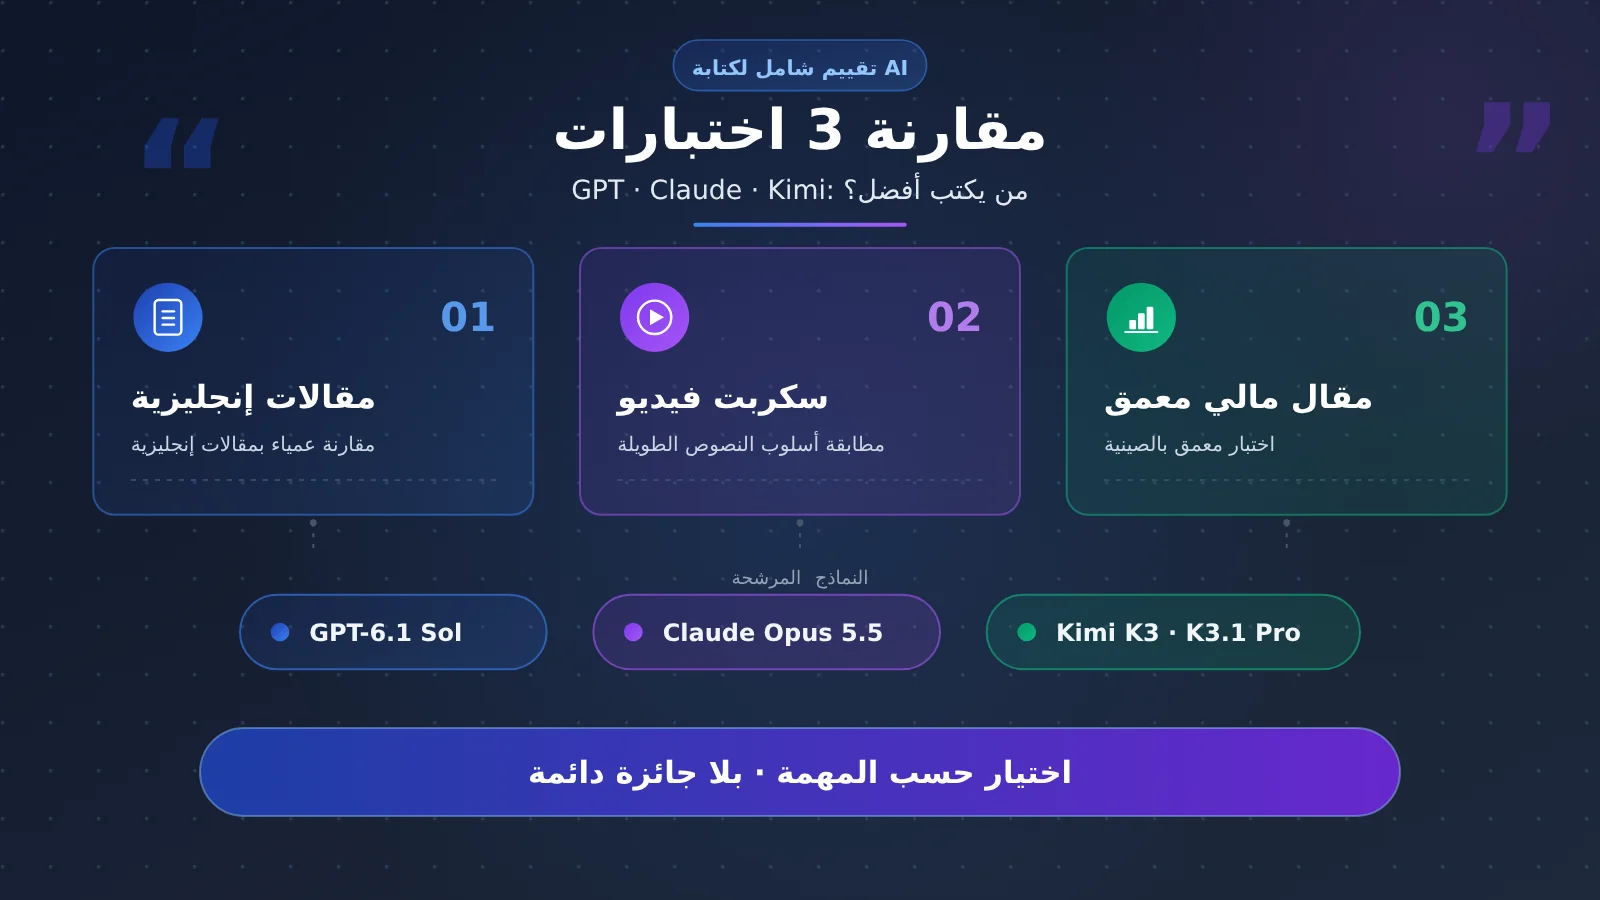
تغطي اختبارات الكتابة الثلاثة مهام ولغات وأساليب تقييم مختلفة. والاستنتاج الأكثر فائدة هو بناء قائمة مرشحين، ثم التحقق منها باستخدام نصوصك الخاصة، بدلًا من منح العائلات الثلاث للنماذج جائزة دائمة.
نصيحة للبدء: يمكنك استدعاء النماذج المرشحة عبر الواجهة الموحدة لـ APIYI على apiyi.com، ومقارنة المسودات الأولى باستخدام حزمة المواد نفسها. تخضع حصة الاختبار المجانية للمستخدمين الجدد لقواعد المنصة الحالية.
اختبار الكتابة لـ GPT وClaude وKimi: ماذا ستتناوله الأجزاء التالية؟
يفكك هذا المقال بالترتيب لوحة الكتابة بالإنجليزية، واختبار النصوص الطويلة ذات الأسلوب البصري، والاختبار الفعلي للمقالات المالية الصينية المتعمقة. ويقدم في النهاية اختيار السيناريو، وخطوات الاختبار الأعمى، وأمثلة الاستدعاء، مع التركيز على جودة المقال وتكلفة التحرير البشري.
لنحدد مصطلحين أولاً: معيار الكتابة هو اختبار يقيم المخرجات وفق مهمة محددة؛ والتقييم الأعمى هو مقارنة النصوص بعد إخفاء هوية النموذج. يمكن أن يُجري التقييم الأعمى بشر أو نموذج، وينبغي عند قراءة النتائج التمييز بين من يقوم بالتقييم.
اختبار الكتابة لـ GPT وClaude وKimi، الجزء الأول: الإنجليزية مع GPT
AI Writing Benchmark هو مشروع كتابة بالإنجليزية يديره Johannes Eva، ويعلن أنه لم يتلقَّ مدفوعات من شركات النماذج. يعتمد هذا المقال على نتائج محدَّثة في 11 نوفمبر 2026 ومُستعلام عنها في 12 نوفمبر.
يغطي المشروع 115 نموذجًا، ويسجل 131,507 مواجهة تقييم أعمى علنية. ويقيّم الكتابة عبر مقارنة نصوص مجهولة الهوية، ويُعرض ترتيب تقييم الذكاء الاصطناعي وترتيب تصويت البشر كلٌّ على حدة.
| النموذج | الدرجة الإنجليزية الإجمالية | أساس النتيجة |
|---|---|---|
| GPT-6.1 Sol | 95.3 | الأول في اللوحة الإجمالية |
| Claude Opus 5.5 | 92.9 | الثاني في اللوحة الإجمالية |
| Kimi K3.1 Pro | 91.9 | الثالث في اللوحة الإجمالية |
الدرجة الإجمالية تجمع عدة أنواع من المهام؛ أما درجة تصنيف المهمة فتعكس نوعًا واحدًا من الأسئلة فقط. حصل GPT-6.1 Sol على درجة تصنيف 98.5 في المقالات والمدونات والمحتوى التحريري، ويجب تسجيلها منفصلة عن الدرجة الإجمالية 95.3.
هذه درجات نسبية داخل المعيار. يعرّف المشروع الرقم 50 على أنه الاحتمال المقدَّر بهزيمة النموذج المتوسط الحالي للغة والفئة بنسبة واحد إلى اثنين، وينبغي للقارئ الانتباه إلى المركز التنافسي، لا اعتبار الدرجة نسبةً من المحتوى القابل للنشر.
بصراحة: إذا كانت المهمة مدونة إنجليزية أو مقالًا تحريريًا، فلـ GPT-6.1 Sol أسباب كافية لدخول الجولة الأولى من الاختبار. أما المقالات الصينية فتحتاج إلى أدلة صينية أخرى.
وثمة نتيجة أخرى جديرة بالانتباه: Kimi K3 يتصدر فئة الشرح والتبسيط العلمي بـ 94.9. الفائز هنا هو K3، بينما الثالث في اللوحة الإجمالية هو K3.1 Pro، ويجب حفظ اسم الإصدار مع النتيجة.
الاختبار الثاني للكتابة لدى GPT وClaude وKimi: أسلوب النصوص الطويلة يضع Claude في الصدارة
يطلب ToneBench من النماذج قراءة موجز إبداعي وحزمة مواد بحثية ودليل أسلوب، ثم توليد نص يوتيوب كامل. لا يرى النموذج النص النهائي للمؤلف الأصلي، ولا يستطيع الاتصال بالإنترنت أو استدعاء أدوات خارجية.
تستخدم هذه المقالة مواد محدّثة بتاريخ 10 نوفمبر 2026. المهمة هي إعداد نص فيديو طويل لصانع محتوى محدد؛ ولأن المواد المقدمة لا تذكر بوضوح جميع لغات المهام، فسّرناها هنا وفق سياق النص.
يتضمن الاختبار 87 نموذجًا و151 إعدادًا، وينفذ كل إعداد 10 مهام، وتُولّد كل مهمة 5 مرات بشكل مستقل. وقد أُنتج 7,550 مسودة، وأكمل أربعة مقيّمين من الذكاء الاصطناعي 30,200 عملية تقييم.
يركّز الاختبار بشكل خاص على مطابقة الأسلوب، أي مدى قرب النبرة والإيقاع وطريقة التعبير من صانع المحتوى المستهدف. وزن مطابقة الأسلوب 19%، بينما وزن عمق المحتوى ودقته وقيمته 15%، كما يقيّم التماسك والتحكم في الطول.
يعرض الجدول أدناه Writing Score لأفضل إعداد لكل نموذج، إلى جانب ترتيب النموذج كما ورد في المواد. الإعداد المقابل لـ Claude هو xhigh؛ ولم تذكر المواد أسماء إعدادات الاستدلال المحددة للنموذجين الآخرين، وينبغي استكمالها عند إعادة الاختبار.
| النموذج | ترتيب النموذج | Writing Score | التكلفة التقديرية لكل نص في الاختبار |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score هو مؤشر يجمع أداء الكتابة في هذا الاختبار، أما الترتيب فيعتمد على معيار Elo. لذلك، ينبغي فهم كون Kimi يزيد 0.1 نقطة ويأتي بمرتبة أدنى على أن أداءهما متقارب.
يتصدر Claude هذه المجموعة من النتائج، لكن تكلفته التقديرية في الاختبار تبلغ نحو 4.2 أضعاف تكلفة GPT. هذا تقدير تكلفة خاص بـ ToneBench، ولا يمكن تطبيقه مباشرة كسعر لمقال على منصات أخرى.
لفهم الترتيب، من الأفضل وضع المهام وعملية التقييم في المخطط نفسه. عند إعادة الاختبار عبر APIYI apiyi.com، يُنصح بالاحتفاظ بسجل الإعدادات، ثم العودة إلى القائمة الأصلية للتحقق من أساس المقارنة.
فترات الثقة للمركزين الأول والثاني في ToneBench متداخلة، كما أن حذف أي نص مرجعي واحد قد يغيّر المتصدر. وقد وجدت الدراسة أيضًا وجود بعض التفضيل للشركات لدى المقيّمين، لكن Claude بقي في الصدارة بعد استبعاد التقييمات على مستوى الوحدة.
الحكم الأساسي هو: في النصوص الطويلة التي تتطلب استيعاب المواد والحفاظ على صوت صانع المحتوى، يستحق Claude المحاولة أولًا. تصلح هذه النتيجة لتوجيه اختيار المرشحين، أما حجم الميزة فيظل بحاجة إلى التحقق باستخدام نصوصك الخاصة.
تجدر الإشارة أيضًا إلى أن نتيجة Least Slop الفردية لـ GPT-6 Sol تخص إصدارًا آخر ومؤشرًا آخر، ولا يمكن استخدامها بديلًا عن Writing Score الخاص بـ GPT-6.1 Sol.
الاختبار الثالث لكتابة النصوص على GPT وClaude وKimi: ماذا نلاحظ في المقالات الصينية المعمّقة؟
أُجري اختبار OmniTools في الفترة من 26 أكتوبر إلى 3 نوفمبر 2026، على مقالات مالية صينية معمّقة من PANews. وقد قارن الاختبار 10 نماذج و26 مقالًا.
| النموذج | درجة التقييم الأعمى للذكاء الاصطناعي | عدد المقالات المختبرة | درجة الطبيعية |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
في هذا الاختبار، حصل Claude على تقييم عام ودرجة طبيعية أعلى. بالنسبة للمقالات المالية الصينية المعمّقة، فإن Claude Opus 5.5 هو المرشح الأجدر بالتجربة أولًا.
لكن حجم العينة صغير، وعدد المقالات غير متوازن بين النماذج، كما أن Kimi لم يشارك. لذلك لا يمكن لهذه المادة إلا أن تكمّل الأدلة الخاصة باللغة الصينية عند GPT وClaude، ولا تعطي ترتيبًا صينيًا كاملًا للنماذج الثلاثة.
استخدم التقييم كلًا من Claude Opus 5.5 وDeepSeek V4 Pro، مع قاعدة تقضي بعدم تقييم النموذج لنفسه. وللجهة الناشرة خلفية تجارية في خدمات توجيه طلبات API، وينبغي مراعاة هذه المعلومة عن المصدر عند القراءة.
أما تقييم المحررين فهو سجل مختلف. فنسبة تبني التعديلات عند Claude البالغة 100% تقابل جولة واحدة فقط من أصل واحدة، وهي مناسبة للملاحظة كحالة دراسية؛ لكن معرفة التبني على المدى الطويل تحتاج إلى مزيد من المسودات.
خلاصة في جملة واحدة: هنا إشارات إيجابية إلى قدرة Claude على كتابة المقالات المالية الصينية الطويلة، ونطاق الأدلة يقتصر على هذه الحالة.
اختبار الكتابة بين GPT وClaude وKimi: اختيار المرشح حسب السيناريو
عند وضع النتائج الثلاث معًا، ينبغي أن تتشكل لديك جدول اختيار، بدلًا من جمع الدرجات. ف لغة المقال والمهمة والأسلوب المستهدف تحدد أي الأدلة تخصك.
| سيناريو الكتابة | المرشح المفضل | أساس الاختيار |
|---|---|---|
| مدونات إنجليزية ومقالات تحريرية | GPT-6.1 Sol | متقدم في فئة المقالات الإنجليزية |
| نصوص فيديو طويلة بأسلوب صانعي المحتوى | Claude Opus 5.5 | يتصدر ToneBench حاليًا |
| مقالات مالية صينية متعمقة | Claude Opus 5.5 | متقدم في اختبار عملي بعينة صينية صغيرة |
| شروح ومحتوى تبسيط علمي بالإنجليزية | Kimi K3 | متقدم في فئة الشروح والتبسيط العلمي |
| محتوى طويل مدفوع بحزمة مواد | اختبار أعمى مشترك للنماذج الثلاثة | GPT وKimi متقاربان في ToneBench |
| منصة التحقق من الاستدعاء | APIYI apiyi.com | واجهة موحدة تسهّل تبديل النماذج |
أما سيناريوهات مثل الدروس التقنية الصينية ومقدمات المنتجات، فالأدلة الثلاثة الحالية لا تغطيها تغطية كاملة. والأكثر أمانًا هو اختبار المرشحين في الوقت نفسه، لمعرفة من يستطيع شرح التقنية بوضوح وكتابة الحقائق بدقة.
اختبار الكتابة بين GPT وClaude وKimi: كيف تُجري مقارنة تحكمية بنفسك؟
يُنصح باختيار موضوع حقيقي، وإعطاء كل نموذج نفس المواد والتخطيط والحجم وصلاحيات الأدوات تمامًا. اطلب من كل نموذج أن يُولّد بشكل مستقل ثلاث مرات على الأقل، ثم أخفِ أسماء النماذج وسلّم النتائج إلى المحررين للتقييم.
يمكن البدء بالتقييم من خمسة بنود: دقة الحقائق، تنفيذ التخطيط، طبيعية التعبير، وضوح البنية، قيمة المحتوى. وتُحدَّد الأوزان حسب مهمة الفريق، مع الإشارة إلى أن هذه قواعد من إنشائكم.
ثم سجّل تكلفة التحرير اليدوي: حجم العمل اللازم لتعديل النص حتى يصبح جاهزًا للنشر. يُفضّل أن تسجّل في الوقت نفسه وقت التعديل، والفقرات المُعادة كتابتها، والأخطاء الوقائعية، وحالة الاعتماد النهائي.
اقتراح الإعداد: استخدم مفتاح API واحد في APIYI apiyi.com للتبديل بين النماذج، ما يقلل أعمال الربط المتكررة. أثناء الاختبار، احتفظ بإصدار النموذج والمعاملات واستهلاك التوكن الفعلي لتسهيل إعادة الإنتاج.
فيما يلي مثال استدعاء بسيط. ضع حزمة المواد الفعلية نفسها في brief، وبدّل اسم النموذج لتحصل على مسودة مقارنة؛ وينبغي أن توفّر بيئة التشغيل المفتاح بشكل آمن.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
هذا الكود نقطة انطلاق؛ أما الاختبار الأعمى الرسمي فينبغي أن يتضمن توليدًا متكررًا وعرضًا مجهول الأسماء وتسجيل الإعدادات. وإذا أردت التحقق من النموذج المتقدم في تصنيف الشروحات، فستحتاج إلى إضافة Kimi K3.
الأسئلة الشائعة حول اختبار الكتابة بين GPT وClaude وKimi
في اختبار الكتابة بين GPT وClaude وKimi، أي إصدار من Kimi يجب اختباره؟
في الشروح العلمية التبسيطية، أضف Kimi K3 أولًا؛ وعند مقارنة نتائج التصنيف الشامل في هذا المقال مع ToneBench، استخدم K3.1 Pro. قبل الاستدعاء عبر APIYI apiyi.com، تحقق من قائمة النماذج وأسماء النماذج المحددة لتجنب الخلط بين الإصدارات.
في اختبار الكتابة بين GPT وClaude وKimi، كيف تقارن التكلفة الفعلية؟
قارن «تكلفة المقال المؤهل الواحد»: إجمالي تكلفة الاستدعاءات مضافًا إليها جهد التحرير. عند الاختبار على APIYI apiyi.com، سجّل الاستخدام الفعلي وعدد مرات إعادة المحاولة، ثم احسب التكلفة وفق الأسعار في ذلك الوقت؛ فهذا أقرب إلى الإنتاج من النظر إلى تكلفة المسودة الأولى فقط.
ختام اختبار الكتابة بين GPT وClaude وKimi: اختر النموذج الأقل حاجة إلى التحرير
جرّب GPT أولًا للمقالات الإنجليزية، وجرّب Claude أولًا للمسودات الطويلة ذات الطابع الأسلوبي وللمقالات المالية الصينية المتعمقة، وأضف Kimi إلى الشروح العلمية التبسيطية. هذه أولويات في مهام محددة، وليست ترتيبًا دائمًا لكل عائلة النماذج.
نوصي بالتحقق من النتائج عبر APIYI apiyi.com باستخدام حزمة المواد نفسها. في النهاية، اختر النموذج الذي ينفّذ التخطيط بدقة أكبر، ويحتفظ بعدد أكبر من الفقرات الصالحة للاستخدام، ويقلل حاجة المحرر إلى جولة عمل إضافية.
مواد مرجعية لاختبار الكتابة لدى GPT وClaude وKimi
-
AI Writing Benchmark: aiwritingbenchmark.com
لوحة الصدارة الإنجليزية الشاملة ولوحات الصدارة التصنيفية، وفق معيار التحديث الصادر في 11 نوفمبر 2026. -
Towards AI ToneBench: benchmark.towardsai.com/models/
اختبار نصوص الفيديو، وترتيب النماذج، وتقديرات التكوين والتكلفة، وفق بيانات 10 نوفمبر 2026. -
اختبار OmniTools العملي لكتابة المقالات الطويلة المتعمقة: omnitools.ai/evals/longform-writing
اختبار للمسودات المالية الصينية المتعمقة من PANews، خلال الفترة من 26 أكتوبر إلى 3 نوفمبر 2026.
المؤلف: فريق المحتوى التقني في APIYI. نرحب بالتواصل عبر APIYI apiyi.com حول تكوين النماذج وطرق الاختبار الأعمى وتجارب التحرير.


