أضاء حاسوب محمول، لكن ما ظهر على شاشته لم يكن Windows ولا أي توزيعة من توزيعات Linux، بل نظامًا بنته مجموعة من وكلاء الذكاء الاصطناعي انطلاقًا من مجلد فارغ. في 9 نوفمبر 2026، كشفت Anthropic عن هذه التجربة الداخلية عند إطلاق Claude Fable 5.2: نسّق Fable 5.2 عمل أكثر من 1000 وكيل فرعي، وعملوا بلا انقطاع على مدى 8 أيام، ليبنوا نموذجًا أوليًا لنظام تشغيل يمكنه الإقلاع على حاسوب محمول حقيقي.
القيمة الأساسية: يتناول هذا المقال تجربة نظام التشغيل ليشرح جوهر إنجاز Claude Fable 5.2، وكيف ينبغي فهم عمل وكلاء الذكاء الاصطناعي الـ1000، وإلى أي مدى يبعد هذا النموذج الأولي عن منتج ناضج. وفي الختام، يناقش من منظور المطورين متطلبات البنية التحتية لواجهات API التي تفرضها مهام الوكلاء طويلة الأمد.
المعلومات الأساسية عن تجربة نظام التشغيل Claude Fable 5.2
لنبدأ بالحقائق التي أعلنتها Anthropic رسميًا. يقتصر الجدول أدناه على المعلومات المؤكدة في إعلان الشركة.
| البند | التفاصيل |
|---|---|
| تاريخ الإعلان | 9 نوفمبر 2026، بالتزامن مع إصدار Claude Fable 5.2 |
| الجهة المُصدرة | Anthropic (تجربة هندسية داخلية) |
| بداية المهمة | كلّف مهندس النظام بإنشاء نموذج أولي لنظام تشغيل، بدءًا من مجلد فارغ |
| حجم التنفيذ | أكثر من 1000 وكيل فرعي عملوا على مدار الساعة لمدة 8 أيام متواصلة |
| الأنشطة الرئيسية | كتابة الشفرة، واختبار المكوّنات، ومراجعة الشفرة، وإصلاح المشكلات |
| الوظائف النهائية | نواة، وبرامج تشغيل للأقراص ولوحة المفاتيح والشبكة، وتخزين دائم للملفات، ونظام نوافذ، وواجهة تسجيل دخول، ومُثبّت، ووظائف Claude مدمجة |
| التحقق الأساسي | أمكن تشغيل النظام (Boot) على حاسوب محمول حقيقي |
| معلومات لم تُنشر بعد | الشفرة المصدرية وآلية البناء، ووثائق البنية، وعدد أسطر الشفرة، وبنية التواصل بين الوكلاء، واستهلاك الرموز، وتكلفة التجربة، واختبارات التوافق مع عتاد متنوع، ومراجعة أمنية من جهة خارجية |
ما المكوّنات التي يتضمنها نظام التشغيل الذي أنشأه 1000 وكيل ذكاء اصطناعي؟
فيما يلي أدوار بعض المكوّنات الأساسية. النواة هي البرنامج المحوري الذي يدير العتاد وموارد النظام؛ فهي تتولى جدولة العمليات، وتخصيص الذاكرة، ومعالجة المقاطعات. أما برامج التشغيل، فتتيح لنظام التشغيل التواصل مع مكوّنات العتاد، مثل الأقراص ولوحة المفاتيح وبطاقة الشبكة. ومن دونها، لن تتمكن النواة من «رؤية» الأجهزة الطرفية.
ويعني التخزين الدائم للملفات أن البيانات تظل محفوظة بعد إعادة التشغيل. وهذا يتطلب وجود نظام ملفات فعلي، لا مجرد عرض توضيحي يعمل في الذاكرة.
أما نظام النوافذ وواجهة تسجيل الدخول والمُثبّت، فهي أجزاء يراها المستخدم. ويستحق المُثبّت الانتباه، لأنه يشير إلى أن النظام أتمّ، على الأقل، المسار الكامل المتمثل في «كتابة النظام على القرص ثم الإقلاع منه».
ولا تتضح أهمية نتيجة «إمكانية الإقلاع على حاسوب محمول» إلا عند النظر إلى هذه المكوّنات مجتمعة. فذلك يتطلب ترابط الأنظمة الفرعية فعليًا، لا أن يكتب كل منها بضعة أسطر من الشفرة تبدو صحيحة بمعزل عن غيرها.
وهنا نصل إلى السؤال الأساسي في هذا المقال: كيف تمكّن أكثر من 1000 وكيل من التعاون لإنجاز مشروع متكامل؟
اختراق Claude Fable 5.2: الذكاء الاصطناعي يبدأ بتنظيم العمل الهندسي
حقق Fable 5.2 تقدمًا ملحوظًا فعلًا في معايير البرمجة. أعلنت Anthropic أن نتيجته في FrontierCode 2.0 بلغت 49.1%، مقارنةً بـ32.4% للجيل السابق Fable 5.1؛ وفي FrontierSWE v2، بلغت النتيجة 69.9%، مقابل 56.3% للجيل السابق.
لكن هذه نتائج معايير عامة للبرمجة، وليست نتائج اختبارات تجربة نظام التشغيل نفسها. وما يجعل هذه التجربة جديرة بالاهتمام ليس جودة كتابة الشفرة بقدر ما هو تغيّر طريقة تنظيم العمل الهندسي.
الفرق بين مساعد البرمجة التقليدي بالذكاء الاصطناعي والهندسة باستخدام الوكلاء على المدى الطويل
يعتمد مساعد البرمجة التقليدي بالذكاء الاصطناعي أسلوبًا قائمًا على «سؤال وجواب»: يطرح المستخدم طلبًا، ويكتب الذكاء الاصطناعي بعض الشفرة، ثم يراجعها المستخدم ويطلب تعديلات، وتتكرر العملية. في هذا الأسلوب، يتولى الإنسان تقسيم المهام وإدارة التقدم ودمج العمل، بينما يكون الذكاء الاصطناعي منفذًا عالي الكفاءة.
أما الهندسة باستخدام الوكلاء على المدى الطويل، فتُسند مسؤوليات أكثر إلى النموذج. يوضح الجدول التالي الفرق بين الأسلوبين:
| الجانب | مساعد البرمجة التقليدي بالذكاء الاصطناعي | الهندسة باستخدام الوكلاء على المدى الطويل |
|---|---|---|
| حجم المهمة | دالة أو ملف أو ميزة واحدة | مشروع كامل يتطلب تقسيمه إلى مهام فرعية |
| مدة التشغيل | محادثة واحدة، من بضع دقائق إلى بضع ساعات | تشغيل متواصل لساعات أو أيام |
| أسلوب التنفيذ | مسار واحد، مع انتظار ملاحظات البشر | وكلاء فرعيون متعددون يعملون بالتوازي على وحدات مختلفة |
| ضمان الجودة | يعتمد أساسًا على المراجعة البشرية | اختبارات آلية ومراجعات متبادلة، مع ترتيب الإصلاحات عند اكتشاف المشكلات |
| الدمج | يتولاه الإنسان | يجمع المنسق النتائج ويتحقق من توافق الوحدات |
| دور الإنسان | توجيه العمل خطوة بخطوة | تحديد الهدف، ومراقبة العملية، والقبول النهائي |
في مشروع مثل نظام التشغيل، يكمن التحدي في العمود الأيمن. فبين النواة وبرامج التشغيل ونظام الملفات عدد كبير من الاتفاقات المتعلقة بالواجهات، وقد يؤدي تعديل وحدة واحدة إلى فشل اختبارات وحدة أخرى.
إن القدرة على مواصلة العمل ثمانية أيام، واكتشاف المشكلات وترتيب إصلاحها، ثم إحراز تقدم في الأجزاء غير المكتملة، تجسد قدرة على «إدارة المشاريع»، لا على «كتابة الشفرة» فحسب.
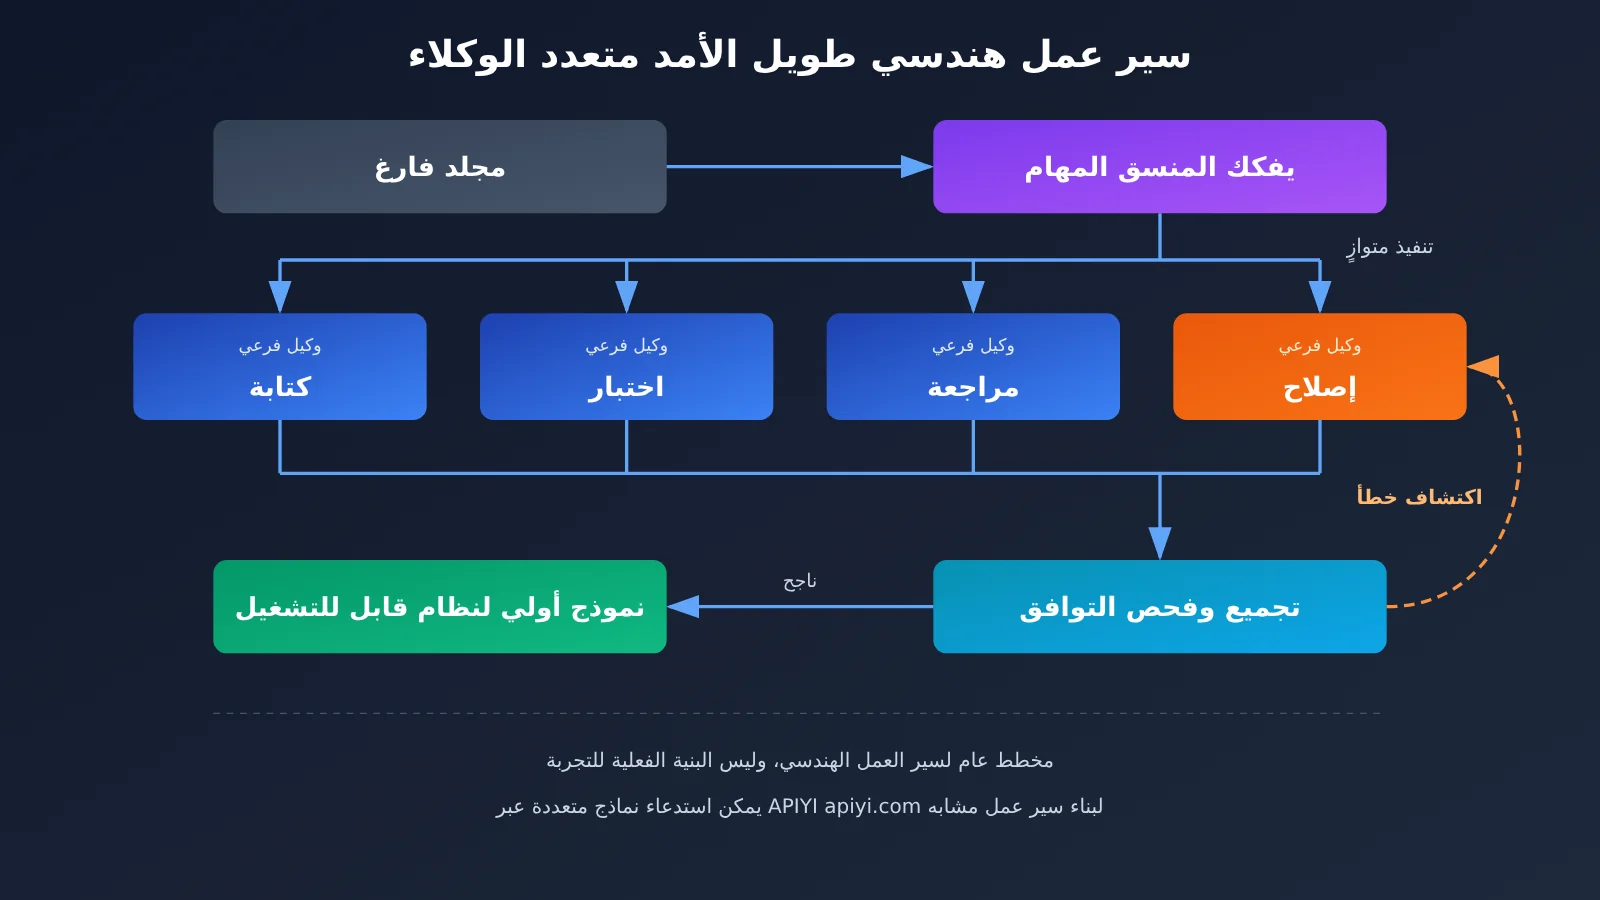
تجدر الإشارة إلى أن المخطط أعلاه تحليل لسير العمل المعتاد في المشاريع الهندسية الكبيرة. ولم تكشف Anthropic عن تفاصيل توزيع المهام في تجربة نظام التشغيل، أو إطار التشغيل (Harness)، أو بروتوكول الاتصال، أو لغة البرمجة المستخدمة.
كشفت تجربة أخرى أُجريت في الفترة نفسها حول مبرهنة فيرما الأخيرة عن تفاصيل معمارية مثل «قائد واحد + 999 مساعدًا»، لكنها تجربة مستقلة، ولا يصح إسقاط تفاصيلها مباشرةً على مشروع نظام التشغيل.
دور «المنسّق» كما يراه المختبِرون الأوائل من الشركات
عند إطلاقه، نشر Anthropic آراء عدد من شركاء الاختبار الأوائل. وهذه تجارب فعلية لمهندسين في شركات، وليست اختبارات عمياء مستقلة، لكنها تشير جميعًا إلى اتجاه واحد: بدأت النماذج تتولى أعمال التخطيط والتنسيق.
- Vercel: ذكر Joe Haddad (عضو في الفريق التقني) أن مشروعًا كان إنجازه يستغرق أسابيع باستخدام نماذج أخرى اكتمل خلال أيام باستخدام Fable 5.2، واجتاز مراجعة الفريق، مع حاجة مراجعي الشفرة إلى اقتراح تعديلات أقل.
- Shopify: رأى Tom Pritchard (مهندس أول) أن النموذج يستطيع استقبال أفكار عامة نسبيًا، وصياغة خطة بعد بضع جولات من النقاش، ثم إنجاز العمل اللاحق من تلقاء نفسه؛ وهي تجربة تشبه التعاون مع مهندس آخر من المستوى الأول.
- Datadog: شبّه Matt Lee (مهندس أول رفيع المستوى) النموذج بقائد الاستجابة للحوادث (Incident Commander): فعندما يواجه نظامًا غير مألوف، يستعين بنموذج أسرع لجمع المعلومات، ثم ينسّق المهام المختلفة، ما يخفف عبء التنسيق عن المشغّلين البشر.
- Uber: كشف Andrew Mager (مهندس أول، الأنظمة الوكيلة) عن تدقيق أمني استمر من 10 إلى 12 ساعة متواصلة. كلّف النموذج نحو 170 وكيلًا للمراجعة، وانتهى العمل بتسليم تقرير التدقيق، وطلبات سحب تتضمن الإصلاحات، ومقترح للسياسات. وشدّد على أن النموذج يواصل التنفيذ حتى إنجاز المهمة فعلًا، بدلًا من التوقف عند نتيجة مرحلية تبدو معقولة.
من حيث الشكل، تشبه حالة Uber تجربة نظام التشغيل أكثر من غيرها: ففي كلتيهما يتولى نموذج واحد توزيع العمل على عدد كبير من الوكلاء الفرعيين لإنجاز مهمة طويلة. لكن المشروعين مستقلان تمامًا.
دخل Claude Fable 5.2 بيئة الإنتاج الفعلية
لو اقتصر الأمر على تجربة نظام تشغيل، لربما اعتبره الناس عرضًا توضيحيًا مُعدًّا بعناية. لكن مجموعتين من البيانات الداخلية كشفت عنهما Anthropic في الوقت نفسه توضحان أن هذه القدرات الهندسية تُستخدم بالفعل في تطوير البرمجيات اليومي.
المجموعة الأولى تتعلق بنسبة الشيفرة المنتَجة. تقول Anthropic إن Claude كتب أكثر من 90% من تعديلات الشيفرة التي دُمجت في نهاية المطاف في مستودع الشيفرة الأساسي لديها، وذلك بتوجيه من البشر. وتشير هذه النسبة إلى حصة التعديلات المدمجة التي كتبها Claude؛ ولا تعني أن 90% من أعمال التطوير جرت من دون تدخل بشري، ولا أن كل تلك الشيفرة كتبها Fable 5.2.
أما المجموعة الثانية فتتعلق بترحيل خدمة إنتاجية. فقد نقل فريق من الوكلاء، باستخدام إصدار مبكر من Fable 5.2، خدمة إنتاجية أساسية من Python إلى Rust. وبعد الترحيل، تحسنت كفاءة الخدمة وموثوقيتها، وأصبحت سرعة بدء التشغيل أعلى بنحو 26 مرة. ويُعد نقل البرامج بين اللغات مثالًا نموذجيًا على الأعمال طويلة الأمد التي تتطلب تحققًا متكررًا؛ فضمان اتساق السلوك يتطلب عادةً اختبارات وإصلاحات أكثر من عملية الترجمة نفسها.
تختلف طبيعة هذه الحالات، ويوضح الجدول التالي الفروق بينها:
| الحالة | طبيعتها | مصدر الأدلة | ما الذي توضحه؟ | ما الذي لا توضحه؟ |
|---|---|---|---|---|
| نموذج أولي لنظام تشغيل | تجربة داخلية لدى Anthropic | إعلان رسمي وعرض توضيحي | قدرة النموذج على تنظيم مشروع هندسي طويل الأمد، واسع النطاق ومتعدد الوحدات | أنه بلغ مستوى أنظمة التشغيل التجارية أو أعادت جهة خارجية إنتاجه |
| كتب Claude 90% من الشيفرة المدمجة | بيانات إنتاج داخلية | إعلان رسمي | أن الذكاء الاصطناعي أصبح مشاركًا بعمق في إنتاج الشيفرة اليومي | أن الشيفرة لا تحتاج إلى مراجعة بشرية |
| الترحيل من Python إلى Rust | حالة إنتاج داخلية | إعلان رسمي | إمكانية استخدام هندسة الوكلاء لتحسين البنية التحتية الفعلية | أن الطريقة المستخدمة هي نفسها في تجربة نظام التشغيل |
| آراء Vercel / Shopify / Datadog / Uber | تجارب مختبِرين مبكرين | تصريحات نقلها الإعلان الرسمي | أن مهندسي الشركات لمسوا قدرات التنسيق في عملهم الفعلي | أنها بديل عن معايير قياس مستقلة |
عند النظر إلى هذه الحالات مجتمعة، نجد أنها تُظهر توسعًا في القدرة على تنفيذ الأعمال الهندسية. لكن هذا لا يعني أن كل مشروع هندسي يمكن إنجازه من دون إشراف.
ماذا يعني وجود 1000 وكيل ذكاء اصطناعي؟
«1000 وكيل» هو الرقم الأبرز في هذه التجربة، لكنه أيضًا الأكثر عرضة لسوء الفهم.
إجمالي الوكلاء لا يساوي عدد الوكلاء العاملين في الوقت نفسه
أولًا، أفصحت Anthropic عن مشاركة «أكثر من 1000 وكيل فرعي»، لكنها لم توضح ما إذا كانوا يعملون جميعًا في الوقت نفسه. وخلال فترة امتدت 8 أيام، من المرجح أن الوكلاء الفرعيين أُنشئوا على دفعات، وأنهوا مهامهم ثم توقّفوا، قبل أن يتولى وكلاء جدد العمل.
ثانيًا، لا يعني وجود 1000 وكيل أن لدينا 1000 مهندس متطابق القدرات ويعمل كل منهم باستقلال تام. فالكفاءة الفعلية تتأثر بعوامل عدة، منها مدى قابلية المهام للتوازي، وتكاليف التنسيق، والحالة المشتركة، وتعارضات الشفرة، وتغطية الاختبارات، وتكلفة الاستدعاءات.
إليك مثالًا بسيطًا: قبل أن تستقر إدارة الذاكرة في النواة، يصعب إحراز تقدم فعلي في نظام الملفات وبرامج التشغيل. ومثل هذه الاعتماديات هي ما يحدد أن المشاريع الهندسية الكبيرة لا يمكن تقسيمها إلى مهام متوازية بلا حدود.
نمطان للتنسيق في Managed Agents المتاحة للعامة
تتيح وثائق Managed Agents التي تقدمها Anthropic للمطورين إلقاء نظرة على الأنظمة متعددة الوكلاء بعد تحويلها إلى منتج. وهي تعرض نمطين للتنسيق.
نمط الوكيل الفرعي (Subagent): يستطيع الوكيل الرئيسي إنشاء وكلاء فرعيين، لكل منهم سلسلة جلسة وسجل سياق مستقلان. كما يمكن للوكيل الرئيسي إرسال مهام لاحقة إليهم. ويمكن أن تضم الجلسة الواحدة ما يصل إلى 25 سلسلة فرعية مباشرة في الوقت نفسه، ولا يدعم التفويض المباشر سوى مستوى واحد.
نمط سير العمل الديناميكي (Dynamic Workflow): صُمم للمهام الأكبر حجمًا. يكتب الوكيل الرئيسي أولًا برنامجًا لسير العمل، ثم ينشئ هذا البرنامج عدة وكلاء يعملون بالتوازي، ويجمع نتائج كل مرحلة، ويحدد الخطوة التالية استنادًا إلى نتائج المرحلة السابقة. وعادةً ما يعيد الخادم تشغيل الوكيل الذي يفشل مرة واحدة على سلسلة جديدة. وتحدد الوثائق الرسمية القيود التالية:
| المؤشر | الحد الرسمي |
|---|---|
| عدد السلاسل التي تعمل في الوقت نفسه ضمن سير عمل واحد | 64 (إعداد يحدد الحد الأقصى للمنتج؛ ولا تضمن Anthropic بلوغه دائمًا) |
| عدد الوكلاء الذين يمكن تشغيلهم طوال دورة حياة سير عمل واحد | 1000 |
| المدة الافتراضية لدورة حياة سير العمل | 24 ساعة |
| عدد مسارات العمل المفتوحة افتراضيًا في الوقت نفسه ضمن جلسة واحدة | 10 |
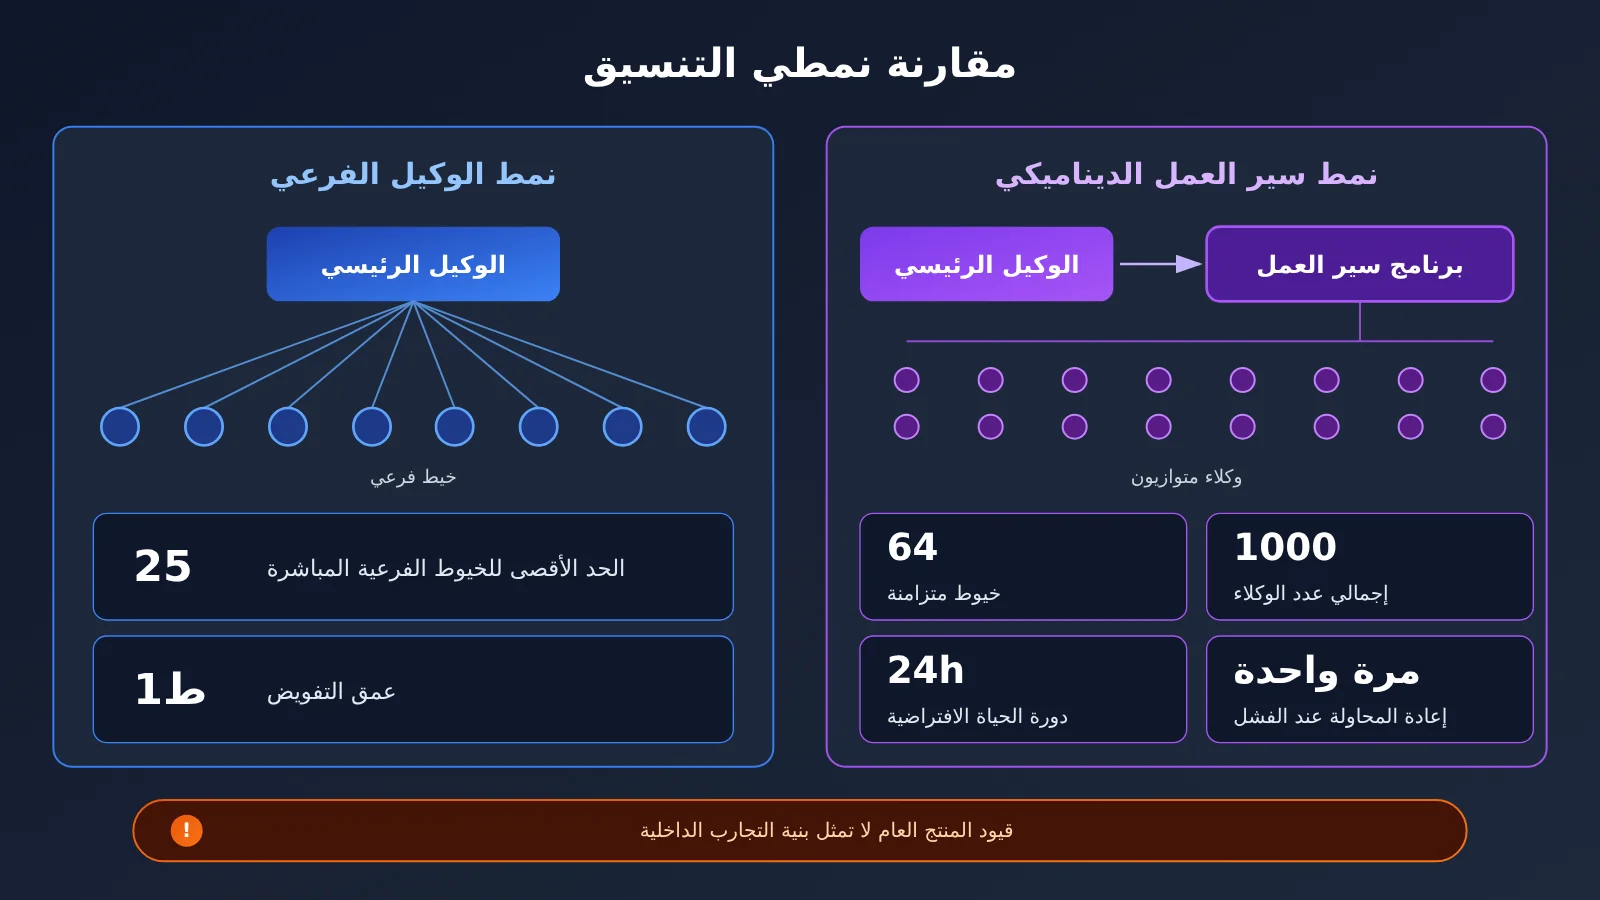
من المهم التأكيد على أن تجربة نظام التشغيل كانت تجربة هندسية داخلية لدى Anthropic، بينما Managed Agents خدمة متاحة للعامة بعد تحويلها إلى منتج. لذلك لا يمكن الجزم بأن التجربة أُنجزت باستخدام Managed Agents، ولا يصح إسقاط حد التوازي البالغ 64 سلسلة على التجربة. لكن هذه الأرقام توضح أمرًا واحدًا: لا يعتمد تنسيق الوكلاء على نطاق واسع على النموذج وحده، بل يحتاج أيضًا إلى مجدول، وإدارة لحالة المهام، وضبط التوازي، وآلية لإعادة المحاولة، ونظام لإدارة الميزانية. وما تنهض به البنية التحتية وراء رقم «1000» لا يقل أهمية عن دور النموذج.
حدود النموذج الأولي لنظام التشغيل Claude Fable 5.2
يُعدّ «الإقلاع بنجاح» إنجازًا مهمًا، لكن الطريق من هذه المرحلة إلى «الجاهزية للاستخدام في الإنتاج» لا يزال طويلًا. فأنظمة ناضجة مثل Windows وLinux وmacOS تستند إلى عقود من العمل على التوافق مع الأجهزة، وتعزيز الأمان، والصيانة المجتمعية.
| المتطلب الهندسي | نموذج أولي قابل للإقلاع (ما كُشف عنه حتى الآن) | نظام تشغيل تجاري ناضج |
|---|---|---|
| التوافق مع الأجهزة | الإقلاع على حاسوب محمول حقيقي واحد | دعم مجموعة واسعة من الشرائح والأجهزة الطرفية وتركيبات البرامج الثابتة |
| الأمان | لم يُعلن عن تدقيق أمني مستقل من جهة خارجية | استجابة مستمرة للثغرات، وعزل للصلاحيات، وآليات لتوفير التصحيحات |
| الموثوقية على المدى الطويل | لم يُعلن عن اختبارات تشغيل مطوّلة | اختُبر على نطاق واسع من المستخدمين وعلى مدى فترات طويلة |
| صيانة النظام | لم يُنشر المصدر ولا خطوات البناء | إدارة للإصدارات، ودورات نشر، ودعم طويل الأمد |
| تدقيق الشفرة البرمجية | لم يُعلن عن عدد أسطر الشفرة أو وثائق البنية | شفرة قابلة للمراجعة ووثائق بنية مكتملة |
| إمكانية إعادة الإنتاج | لم تُعِد جهة خارجية مستقلة إنتاجه بعد | خطوات بناء منشورة وقابلة للتكرار |
ليس الغرض من هذا الجدول التقليل من شأن التجربة، بل توضيح ما تثبته. فقد أثبتت أن النموذج قادر على تنظيم مشروع هندسي برمجي متعدد الوحدات على مدى فترة طويلة، وتسليم نتيجة تتكامل فيها الأنظمة الفرعية فعلًا. لكنها لم تثبت أن نظام تشغيل كتبته أداة ذكاء اصطناعي قادر على أن يحل مباشرةً محل المنتجات الحالية.
ولا يزال المهندسون البشر عنصرًا أساسيًا في هذا النوع من المشاريع. فتحديد الأهداف، والمفاضلة بين خيارات البنية، ورسم حدود الأمان، والقبول النهائي، كلها مسؤوليات تقع على عاتق البشر. وحتى Anthropic تصوغ الأمر بتحفّظ: كتب Claude 90% من الشفرة المدمجة، لكن ذلك كان «بتوجيه بشري».
والخلاصة الأكثر اتزانًا هي أن الذكاء الاصطناعي أظهر قدرته على تنظيم مشاريع هندسية برمجية معقدة، لكن هذا لا يعني أن فرق هندسة البرمجيات المتمرسة لم تعد بحاجة إلى البشر.
تأثير Claude Fable 5.2 في المطورين
من الاستدعاء المنفرد إلى سير عمل الوكلاء طويل الأمد
لن ينشئ معظم المطورين نظام تشغيل في المدى القريب. لكن أسلوب العمل الذي كشفته هذه التجربة سيجد طريقه تدريجيًا إلى المشاريع اليومية، مثل مراجعة الشيفرة البرمجية على نطاق واسع، وإعادة هيكلة المستودعات، وترحيل اللغات، والتدقيق الأمني.
في هذه الحالات، سيتحول تركيز المطورين من سؤال «هل كانت إجابة هذا الاستدعاء جيدة؟» إلى عدة جوانب أكثر ارتباطًا بالهندسة:
- إدارة المهام: كيف تُقسَّم المهام؟ وكيف تُسجَّل حالة كل مهمة فرعية؟ وهل يمكن استئناف التنفيذ من نقطة التوقف بعد الإخفاق؟
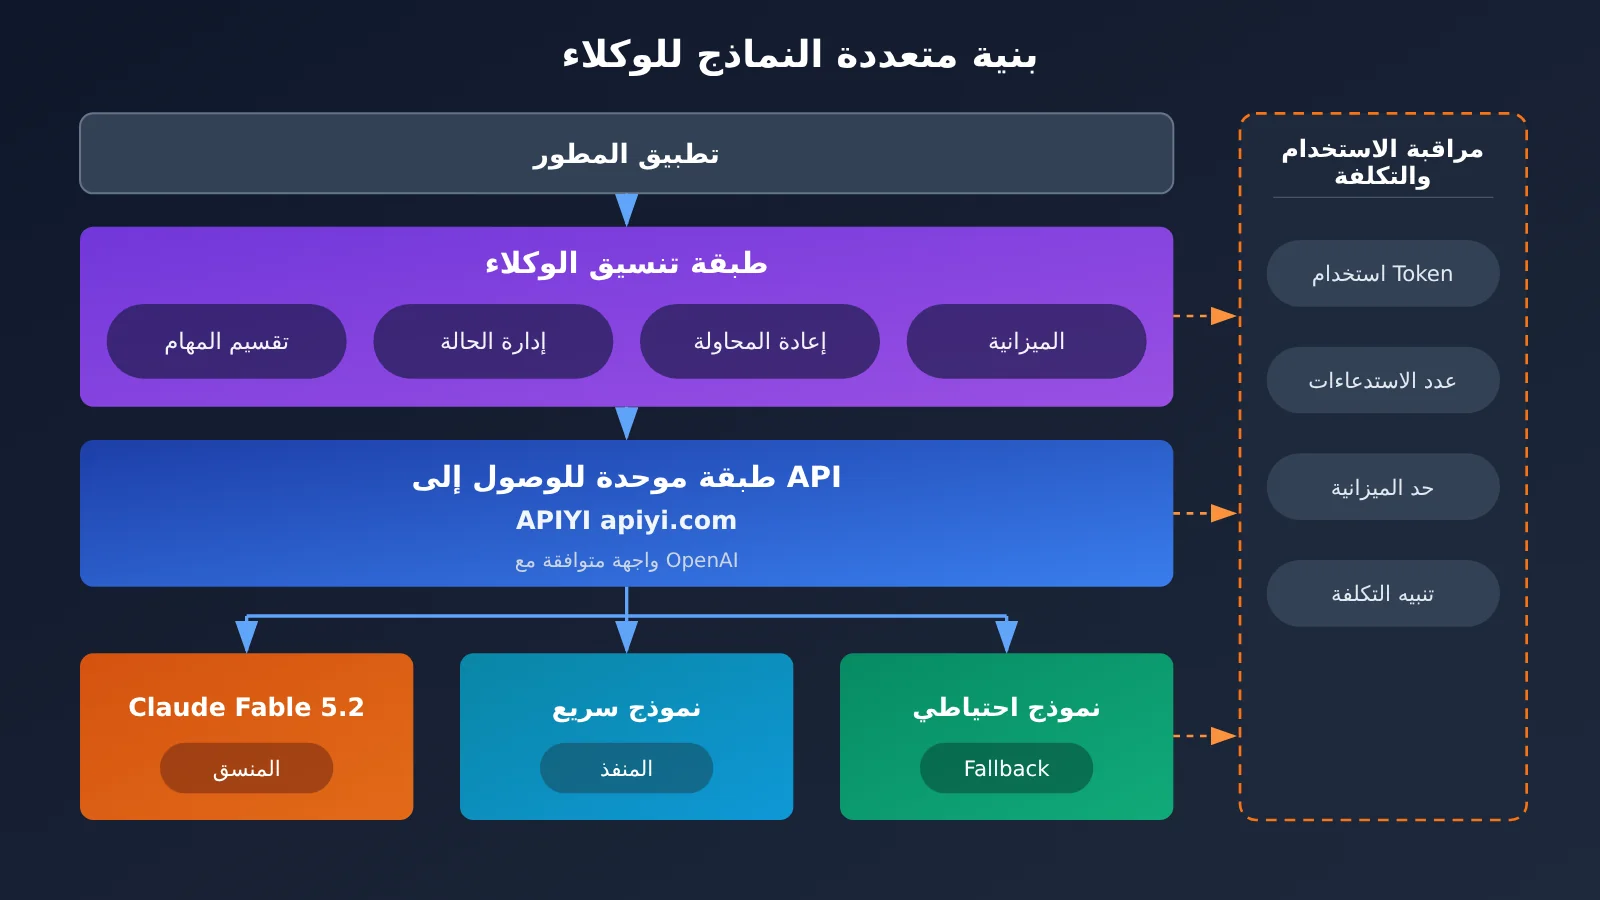
- توزيع الأدوار بين النماذج: في حالة Datadog، يستعين Fable 5.2 بـ«نموذج أسرع» لجمع المعلومات. ومن الشائع استخدام نموذج قوي للتنسيق، ونموذج أسرع أو أقل تكلفة للتنفيذ.
- موثوقية الاستدعاءات: قد يتضمن سير العمل مئات الاستدعاءات أو آلافها. وحتى لو كان معدل الإخفاق منخفضًا لكل استدعاء، فقد تتكرر الانقطاعات عند تراكم الاستدعاءات؛ لذا تلزم آليات لإعادة المحاولة والتحويل إلى مسار بديل.
- ضبط الميزانية: تبلغ الأسعار المعلنة لواجهة API الخاصة بـFable 5.2 نحو 8 دولارات لكل مليون Token للإدخال، و40 دولارًا لكل مليون Token للإخراج. أما Fast Mode فيضاعف السعر. ولم تكشف Anthropic عن التكلفة الفعلية لتجربة نظام التشغيل، لكن من الواضح أن تكاليف المهام طويلة الأمد ومتعددة الوكلاء تحتاج إلى مراقبة مستمرة.
- مراقبة المهام: لا بد من معرفة ما يفعله كل وكيل، ومقدار ما يستهلكه، وأين تعثّر.
وفي اليوم نفسه، أعلنت Vercel إتاحة Fable 5.2 عبر AI Gateway، مع ميزات تشمل التحويل عند تعطل المورّد، ونماذج احتياطية، وإحصاءات الاستخدام والتكلفة، وقواعد الميزانية وإعادة المحاولة. وهذا مؤشر على أن البنية التحتية لاستدعاء النماذج في تطبيقات الوكلاء المعقدة آخذة في التبلور.
كيفية استدعاء Claude Fable 5.2 باستخدام واجهة متوافقة مع OpenAI
معرّف النموذج الرسمي في API الخاص بـ Fable 5.2 هو claude-fable-5-2. وهو يدعم سياقًا بسعة 1M Token وإخراجًا بحد أقصى 128K Token. إليك أبسط طريقة لاستدعائه عبر واجهة متوافقة مع OpenAI (يُرجى اعتماد اسم النموذج الظاهر في قائمة النماذج بلوحة تحكم المنصة):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
عرض المثال الكامل: منسّق + منفّذون متوازون + إعادة المحاولة والتحكم في الميزانية
فيما يلي نموذج مبسّط يوضح آلية «منسّق يقسم المهام، ومنفّذون يعالجونها بالتوازي». يتضمن إعادة المحاولة عند الإخفاق وتحكمًا تقريبيًا في ميزانية Token. الغرض منه توضيح أفكار هندسية عامة فقط، وليس تنفيذًا فعليًا لتجربة أنظمة التشغيل من Anthropic.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، تتيح التبديل بين نماذج من مزوّدين مختلفين
)

PLANNER_MODEL = "claude-fable-5-2"   # المنسّق: مسؤول عن تقسيم المهام وتجميع النتائج
WORKER_MODEL = "gpt-4o-mini"         # المنفّذ: استبدله بالنموذج السريع الذي تستخدمه
TOKEN_BUDGET = 200_000               # ميزانية Token لسير العمل بأكمله
MAX_WORKERS = 8                      # الحد الأقصى للتوازي، عدّله حسب الحاجة
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 نصيحة للبدء بسرعة: عند بناء سير عمل لوكيل متعدد النماذج، غالبًا ما يكون المنسّق والمنفّذ تابعين لشركتين مختلفتين. يتيح لك APIYI apiyi.com استخدام مفتاح API واحد لاستدعاء نماذج شائعة مثل Claude وOpenAI وGemini، مع احتساب التكلفة حسب الاستخدام. ويحصل المستخدمون الجدد على رصيد مجاني للاختبار، ما يجعله خيارًا مناسبًا للتحقق أولًا من منطق التنسيق والتكلفة باستخدام مهام صغيرة.
الأسئلة الشائعة
س1: ما الذي حققته تجربة نظام التشغيل باستخدام Claude Fable 5.2؟
بحسب ما كشفته Anthropic، بدأ Fable 5.2 من مجلد فارغ، ونسّق العمل بين أكثر من 1000 وكيل فرعي عملوا على مدى 8 أيام متواصلة، لإنتاج نموذج أولي لنظام تشغيل يمكنه الإقلاع على حاسوب محمول حقيقي. ويشمل هذا النموذج نواة النظام، وبرامج تشغيل الأقراص ولوحة المفاتيح والشبكة، وتخزينًا دائمًا للملفات، ونظام نوافذ، وواجهة تسجيل دخول، ومُثبّتًا، وميزات Claude مدمجة.
س2: هل عمل وكلاء الذكاء الاصطناعي الألف جميعهم في الوقت نفسه؟
لم تكشف الشركة عن ذلك. فمشاركة أكثر من 1000 وكيل فرعي لا تعني أن 1000 وكيل عملوا جميعًا في الوقت نفسه طوال المدة، ولا تعني وجود 1000 مهندس مستقل. يبلغ الحد الأقصى المعلن للتزامن في سير العمل الواحد ضمن Managed Agents نحو 64 مسارًا متوازيًا، ويمكن إطلاق ما يصل إلى 1000 وكيل خلال دورة حياته. لكن هذه قيود المنتج، ولا يصح افتراض انطباقها على التجربة الداخلية.
س3: هل يمكن لنظام التشغيل الذي أنشأه الذكاء الاصطناعي أن يحل محل Windows أو Linux؟
لا. تصفه الشركة رسميًا بأنه «نموذج أولي يعمل». وحتى الآن، لم تُنشر شيفرته المصدرية أو وثائق بنيته، ولم تُجرَ اختبارات توافق مع أنواع متعددة من الأجهزة أو عمليات تدقيق أمنية من جهات خارجية، كما لم تُعَد التجربة بشكل مستقل. ما تثبته التجربة هو قدرة الذكاء الاصطناعي على تنظيم أعمال هندسية معقدة، لا نضج المنتج.
س4: ما أسعار Claude Fable 5.2 ومواصفاته في API؟
السعر المعلن هو 8 دولارات لكل مليون Token للإدخال، و40 دولارًا لكل مليون Token للإخراج؛ أي أقل بنسبة 20% من السعر في الوضع العادي لـ Fable 5.1. ويتضاعف السعر في Fast Mode، مع سرعة إخراج تصل إلى 2.5 مرة مقارنة بالوضع العادي. تبلغ نافذة السياق مليون Token، والحد الأقصى للإخراج 128 ألف Token، كما يوفّر Batch API خصمًا بنسبة 50% على الإدخال والإخراج. هذه هي الأسعار المعلنة، وليست الفاتورة الفعلية لتجربة نظام التشغيل.
س5: كيف يمكن للمطورين تجربة الوكلاء باستخدام Claude Fable 5.2 بسرعة؟
يمكن البدء بمهمة صغيرة للتحقق من منطق التنسيق:
1. سجّل في APIYI عبر apiyi.com واحصل على مفتاح API ورصيد مجاني للاختبار.
2. اضبط `base_url` في المثال الوارد في هذه المقالة على `https://api.apiyi.com/v1`، واستخدم اسم النموذج الظاهر في قائمة لوحة التحكم.
3. ابدأ بتشغيل أبسط دورة متكاملة: «تقسيم المهام ← التنفيذ المتوازي ← تلخيص النتائج»، ثم أضف تدريجيًا آليات إعادة المحاولة والتحكم في الميزانية.
س6: ما أكثر مواضع التعثر شيوعًا في سير العمل طويل الأمد متعدد الوكلاء؟
تتركز المشكلات الشائعة في ثلاثة جوانب: أولًا، انفلات التكاليف؛ إذ يزداد عدد الاستدعاءات مع زيادة عدد الوكلاء، لذا لا بد من وضع حد أقصى للميزانية. ثانيًا، تراكم الإخفاقات؛ فالخطأ العارض في استدعاء واحد قد يتفاقم ضمن سلسلة طويلة، ما يستدعي إعادة المحاولة واستخدام نموذج احتياطي. ثالثًا، كلفة التنسيق؛ فإذا لم تُحدَّد تبعيات المهام بوضوح، فقد يؤدي التنفيذ المتوازي إلى تعارضات في الشفرة. يتيح APIYI عبر apiyi.com ربط عدة نماذج من خلال واجهة موحدة، ما يسهّل إعداد النماذج الاحتياطية ومراجعة الاستخدام مركزيًا.
أبرز النقاط حول Claude Fable 5.2 و1000 وكيل ذكاء اصطناعي
- حقائق التجربة: أكثر من 1000 وكيل فرعي، و8 أيام من العمل، انطلاقًا من مجلد فارغ وصولًا إلى نموذج أولي لنظام تشغيل قابل للإقلاع.
- الاختراق الحقيقي: بدأت النماذج تتولى تقسيم المهام، وتنفيذها بالتوازي، والإصلاح المستمر، ودمج النتائج.
- مؤشرات الاستخدام العملي: كتب Claude أكثر من 90% من الشفرة التي دمجتها Anthropic، كما أدى الانتقال إلى Rust إلى تسريع بدء التشغيل بنحو 26 ضعفًا.
- حدود الأرقام: لا يعني وجود 1000 وكيل أنهم 1000 مهندس مستقل يعملون بالتوازي طوال الوقت.
- حدود النموذج الأولي: من دون تدقيق وإعادة إنتاج من جهة خارجية، لا يزال الطريق طويلًا قبل بلوغ مستوى نظام تشغيل تجاري ناضج.
- ما يهم المطورين: لا تقل أهمية الجدولة وإعادة المحاولة والميزانية والمراقبة عن قدرات النموذج. ويمكن الاستعانة بـ APIYI عبر apiyi.com لربط نماذج متعددة من خلال واجهة موحدة.
الخلاصة
أهم ما ينبغي تذكّره من خبر بناء نظام تشغيل بواسطة 1000 وكيل ذكاء اصطناعي خلال 8 أيام ليس الأرقام بحد ذاتها، بل ثلاث نقاط:
- تغيّر شكل القدرات: ما يعرضه Claude Fable 5.2 هو القدرة على هندسة التنظيم، لا مجرد توليد الشفرة البرمجية.
- ينبغي تقييم الأدلة على مستويات مختلفة: تجربة نظام التشغيل، وبيانات الإنتاج الداخلية، والانطباعات الأولية للشركات، أدلة من أنواع مختلفة، ويجب تقييم كل منها على حدة.
- يبقى الإنسان الحلقة الأخيرة: يمكن للنموذج الأولي أن يعمل، لكن مسؤولية القرارات المعمارية والأمان والقبول النهائي تظل على عاتق المهندسين.
بالنسبة إلى المطورين، تتمثل الخطوة التالية في الانتقال من التفكير في «استدعاء واحد» إلى «سير عمل طويل الأمد»، مع التخطيط مسبقًا لتوزيع المهام بين النماذج، واستقرار الاستدعاءات، وضبط التكاليف. نوصي باستخدام APIYI apiyi.com للوصول إلى عدة نماذج رائدة عبر مفتاح API واحد، والبدء بالتحقق من الفكرة عبر مهام وكلاء صغيرة النطاق.
📚 المراجع
- الإعلان الرسمي من Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- الرابط:
anthropic.com/claude-fable-and-mythos-5-2 -
توضيح: مصدر أولي لتجربة نظام التشغيل وبيانات الإنتاج الداخلية وانطباعات الشركات
-
وثائق مواصفات النماذج في Claude Platform: Fable 5.2 Overview
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview -
توضيح: مواصفات مثل نافذة السياق والحد الأقصى للإخراج ومعرّف النموذج
-
وثائق تنسيق الوكلاء المتعددين في Managed Agents: Subagent وDynamic Workflow
- الرابط:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
توضيح: حدود سلاسل التنفيذ المتزامنة وعدد الوكلاء ودورة حياتهم في المنتج المتاح للعامة
-
إعلان إتاحة النموذج عبر Vercel AI Gateway: Claude Fable 5.2 now available on AI Gateway
- الرابط:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
توضيح: إمكانات بوابات API التابعة لجهات خارجية، مثل التحويل عند التعطل والميزانيات وإعادة المحاولة
-
تغطية The Verge: Anthropic launches new Claude Fable and Mythos 5.2 models
- الرابط:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - توضيح: تغطية إعلامية مستقلة للإطلاق
المؤلف: الفريق التقني في APIYI
للتواصل التقني: يسعدنا التواصل معكم عبر الصفحة الرئيسية لموقع APIYI الرسمي. ولمزيد من مواد التكامل، تفضلوا بزيارة مركز التوثيق على docs.apiyi.com.