ملاحظة الكاتب: انطلاقًا من تشبيه لاي جيه، مؤسس شركة شينغتشن للذكاء الاصطناعي، «لا تفرض عليّ رسوم رموز مقابل ربط كل برغي»، نفكك مراحل سير عمل الذكاء الاصطناعي لنحدد ما يجب إسناده إلى برامج ثابتة، وما يحتاج فعلًا إلى حكم نموذج لغة كبير.
في 5 نوفمبر 2026، نشرت مجلة آيفانر في قسم «شركة التنوع» مقابلة مع لاي جيه، المؤسس والرئيس التنفيذي لشركة شينغتشن للذكاء الاصطناعي. ومن بين ما قاله عبارة تداولها كثيرًا مطورو تطبيقات الذكاء الاصطناعي: «أريد أن تتولى البرامج الثابتة ربط البراغي، وتعمل على مدار 24 ساعة يوميًا، لا أن تفرضوا عليّ رسوم رموز مقابل ربط كل برغي».
هذه ليست مجرد نكتة. كان لاي جيه يتحدث في المقابلة عن توزيع المهام في الروبوتات: يتولى النموذج المتجسد الحركات المادية، وعندما يواجه مشكلة يسأل نموذج اللغة الكبير الأساسي باستخدام اللغة الطبيعية. وعند تطبيق هذه الفكرة على سير عمل برمجي، نجد أنها تقابل سؤالًا عمليًا: ما المراحل التي لا ينبغي فيها استدعاء نموذج لغة كبير داخل تطبيق ذكاء اصطناعي؟
الفائدة الأساسية: يحوّل هذا المقال الفكرة المطروحة في المقابلة عن الروبوتات إلى تصميم لحدود الاستدعاء في سير العمل البرمجي. ويعرض 5 أنواع من المراحل التي لا تحتاج إلى استدعاء نموذج لغة كبير، ومجموعة من المعايير المتدرجة لاتخاذ القرار، ومثالًا على شيفرة للتوجيه يمكن تعديله مباشرةً. لكن تجدر الإشارة أولًا إلى أن الروبوتات والبرمجيات نوعان مختلفان من الأنظمة؛ لذا فإن تطبيق الفكرة أدناه قائم على القياس، وتحتاج نتائجه إلى التحقق بناءً على استخدامك الفعلي.
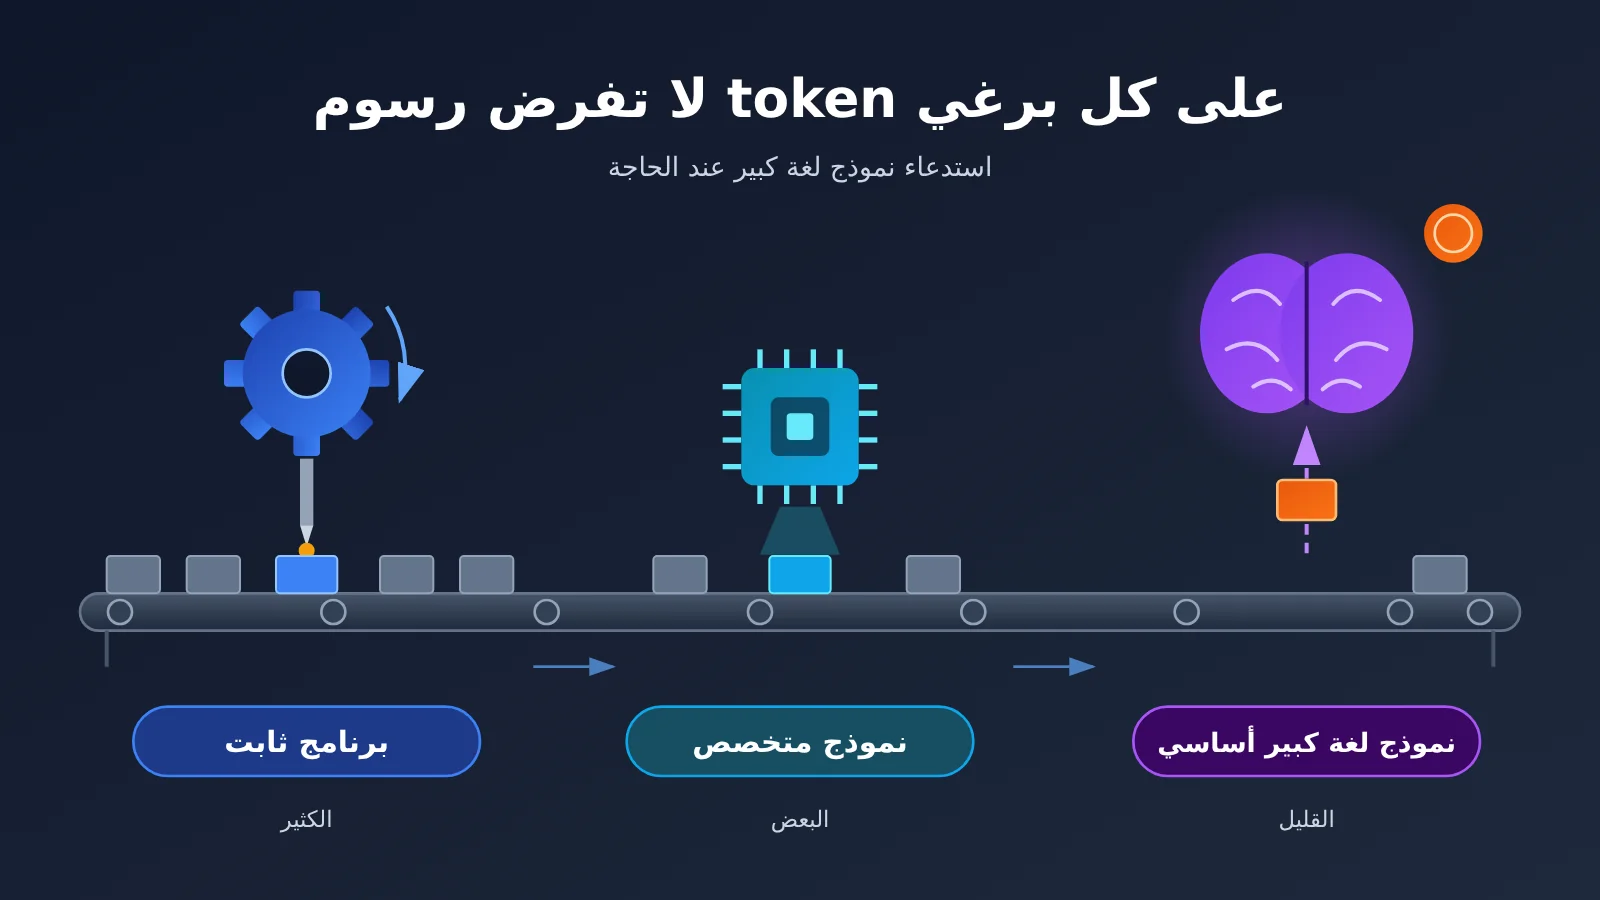
«لا تفرضوا عليّ رسوم token مع كل برغي»: أبرز النقاط
جاءت هذه العبارة في السؤال الأخير من المقابلة. فعندما سُئل لاي جيه عمّا يأمل أن تساعد الروبوتات البشر على التحرر منه، أوضح أنه لا يريد أن «تدخل الروبوتات المصانع لربط البراغي». فهو يرى أن قيمة الروبوتات تكمن في تنوع قدراتها، كما أن دفع رسوم token مقابل كل حركة في عمل متكرر لا يستحق التكلفة.
| البند | التفاصيل |
|---|---|
| المصدر | المقابلة الخامسة عشرة من سلسلة «شركة التنوع» لدى Aifaner |
| تاريخ النشر | 5 نوفمبر 2026 |
| الضيف | لاي جيه، مؤسس شركة Stardust Intelligence ورئيسها التنفيذي، وكان أول موظف في مختبر Tencent Robotics X للروبوتات |
| الفكرة الأساسية | ينبغي إسناد الحركات المتكررة إلى برامج ثابتة، بدلاً من دفع رسوم token في كل مرة |
| تقسيم المهام | يتولى نموذج الذكاء المتجسد التنفيذ المادي، وعند مواجهة مشكلة يستعين بنموذج لغة كبير أساسي عبر سؤال باللغة الطبيعية |
| الدرس المستفاد للبرمجيات | تحتاج سير عمل الذكاء الاصطناعي إلى تحديد حدود واضحة لاستدعاء البرامج الثابتة والنماذج المتخصصة ونماذج اللغة الكبيرة الأساسية |
من المهم التأكيد أن ما ورد في المقابلة يعكس وجهة نظر المؤسس، ولا تتضمن المادة قياسات فعلية للتكلفة أو بيانات تحقق من طرف ثالث. ما نستفيد منه هنا هو منطق تقسيم المهام، وليس أي استنتاج محدد.
تشبيه لاي جيه بـ«مكالمة فيديو مع الأم»: نموذج اللغة الكبير يكمّل السياق فحسب
في المقابلة تشبيه يوضّح توزيع المهام أفضل من تشبيه «ربط البراغي». يقول لاي جيه إنه إذا أراد الطبخ وهو لا يعرف كيف، يتصل بأمه عبر الفيديو. قد تقول له: «ضع قليلًا من الزيت في المقلاة الساخنة أولًا»، لكنها لا تحتاج إلى إخباره أيّ زجاجة تحتوي على الزيت. وإذا واجه سؤالًا، يمكنه الاستفسار منها. الفكرة الأساسية هي أن الأم تزوّده بالمعرفة اللازمة لاستكمال السياق، لكنه يجب أن يعرف كيف يضع الزيت بنفسه، فهي على الطرف الآخر من المكالمة ولا تستطيع فعل ذلك بدلًا منه.
في حالة الروبوت، على النموذج المتجسد أن يستشعر بنفسه المعايير الفيزيائية مثل الوزن وقوة القبضة ومدى ثبات الإمساك، ولا يسأل نموذج اللغة الكبير الأساسي إلا عن مسائل مثل: «لا أستطيع الإمساك به بإحكام، وهو غير مستقر قليلًا، فماذا أفعل؟». ويرى لاي جيه أن تدريب نموذج اللغة الكبير الأساسي على المعلومات اللمسية أيضًا «ليس مستحيلًا، لكن تكلفته غير مناسبة، كما ستظهر مشكلة في عرض النطاق الترددي للاتصال». ويضيف أن الأمر ليس مجرد تقسيم إلى طبقات، بل أقرب إلى نظام من الوكلاء يشبه مستعمرة النمل: قد لا يكون كل وكيل قويًا بمفرده، لكن اجتماعهم يجعلهم أقوياء جدًا.
| الدور في نظام الروبوت | المسؤولية في المقابلة | الدور المناظر في سير عمل برمجي |
|---|---|---|
| برنامج ثابت | تكرار ربط البراغي على مدار 24 ساعة | محركات القواعد والتعبيرات النمطية والبرامج النصية واستعلامات قواعد البيانات |
| النموذج المتجسد | التنفيذ المادي واستشعار المعايير وترجمة الحالة إلى لغة طبيعية | نماذج صغيرة متخصصة في التصنيف والاستخراج والبحث بالمتجهات |
| نموذج اللغة الكبير الأساسي | استكمال المعرفة السياقية وتقديم حلول للمسائل الصعبة | الاستدلال المعقد والتوليد المفتوح واتخاذ القرارات في الحالات الاستثنائية |
| نظام التشغيل AOS | تغليف القدرات في وحدات مهارات وتكييفها للعمل مع نموذج اللغة الكبير والوكيل | طبقة تنسيق سير العمل وطبقة استدعاء الأدوات والموجّه |
جدول المقابلة هذا هو استنتاج من المقال، وليس نقلًا حرفيًا عن المقابلة. تتعامل الروبوتات مع التحكم الآني في العالم المادي وقيود عرض النطاق الترددي للاتصال، بينما تتأثر تدفقات العمل البرمجية أكثر بتكلفة الرموز المميزة (tokens) وزمن الاستجابة والاستقرار؛ لذا لا تتطابق الاختناقات في الحالتين تمامًا.
ما المراحل التي لا ينبغي فيها استدعاء نموذج لغة كبير في تطبيقات الذكاء الاصطناعي؟ 5 معايير للحكم
عند بناء النسخة الأولى من الوكيل الذكي (Agent)، تعتاد فرق كثيرة إسناد كل الخطوات إلى نموذج لغة كبير: التحقق من التنسيق، وتحويل التواريخ، وحتى كتابة موجه للتحقق مما إذا كان الحقل فارغًا. هذه الطريقة سريعة في مرحلة النمذجة الأولية، لكن بعد الإطلاق ستدفع مقابل تنفيذ مهام حتمية في كل طلب، فضلًا عن إدخال قدر غير ضروري من العشوائية.
بالاستعانة بفكرة «ربط البراغي»، يمكننا استخدام المعايير الخمسة التالية لتحديد ما إذا كانت مرحلة ما تستحق استدعاء نموذج لغة كبير.
| معيار الحكم | يُرجّح استخدام برنامج ثابت | يُرجّح استخدام نموذج متخصص | يُرجّح استخدام نموذج لغة كبير أساسي |
|---|---|---|---|
| هل المدخلات منظّمة؟ | حقول ثابتة وتنسيق واضح | نصوص شبه منظّمة | لغة طبيعية مفتوحة |
| هل توجد إجابة واحدة صحيحة؟ | إجابة صحيحة واحدة | فئات محدودة | عدة إجابات معقولة |
| هل يمكن حصر القواعد؟ | يمكن كتابتها باستخدام if/else | قواعد كثيرة لكن أنماطها مستقرة | لا يمكن حصر القواعد |
| ما تكلفة الخطأ؟ | يجب ألا تحدث أخطاء | يمكن قبول أخطاء قليلة مع مراجعتها | يتطلب الأمر موازنة شاملة |
| ما تكرار الاستدعاء؟ | مرتفع جدًا، ويُنفّذ في كل مرة | مرتفع | منخفض، ويُفعّل عند الحاجة |
مراحل «ربط البراغي» المناسبة للبرامج الثابتة
تندرج الأنواع التالية عادةً ضمن مهام «ربط البراغي»: نتائجها حتمية ومتكررة، وقد يؤدي استخدام نموذج لغة كبير فيها إلى تقليل الاستقرار:
- التحقق من التنسيق وتنظيف البيانات: يمكن التحقق من البريد الإلكتروني وأرقام الهواتف وبنية JSON والحقول المطلوبة باستخدام التعبيرات النمطية والتحقق من المخطط (Schema).
- الاستعلام عن البيانات وإجراء الحسابات: لمعرفة حالة الطلب أو كمية المخزون أو إجمالي المبالغ، استعلم مباشرةً من قاعدة البيانات أو استدعِ واجهة العمل البرمجية، ولا تطلب من نموذج اللغة الكبير «استنتاجها».
- الإخراج بقوالب ثابتة: يمكن إنشاء رسائل الإشعارات النصية وإيصالات الاستلام القياسية وترويسات التقارير بملء المتغيرات باستخدام محرك قوالب.
- التحكم في سير العمل وإعادة المحاولة: التفرع بين المسارات، وإعادة المحاولة عند انتهاء المهلة، وتنظيم قوائم الانتظار وفق حدود المعدل، كلها من مهام طبقة التنسيق ولا تتطلب تدخل النموذج.
- الاستفادة من ذاكرة التخزين المؤقت للأسئلة المتكررة: عندما يتكرر السؤال نفسه، ابحث أولًا في ذاكرة التخزين المؤقت أو قاعدة الأسئلة الشائعة (FAQ)، وأعِد الإجابة مباشرةً إذا وجدتها.
المراحل التي تحتاج فعلًا إلى حكم نموذج لغة كبير
في المقابل، تستحق بعض المراحل استدعاء نموذج لغة كبير أساسي، وهي أشبه بـ«الأسئلة التي لا تستطيع الإجابة عنها إلا الأم على الطرف الآخر من الهاتف»: عندما تكون نية المستخدم غامضة وتحتاج إلى توضيح، أو يلزم استخلاص نتيجة من عدة مصادر، أو تظهر حالة استثنائية لا تغطيها القواعد، أو تكون هناك حاجة إلى محتوى إبداعي. والقاسم المشترك بينها هو أن الإجابة ليست واحدة، والقواعد لا يمكن حصرها، وتكرارها منخفض نسبيًا.
أما النماذج المتخصصة فتقع بين الطرفين. فمهام مثل تصنيف النوايا، واستخراج الكيانات، وتحليل المشاعر، وتحويل النصوص إلى متجهات يمكن غالبًا إنجازها بنماذج أصغر. ويمكن فهمها على أنها نسخة برمجية من «النموذج المتجسد»: تنجز ما تستطيع بنفسها، وتحوّل الحالات التي تعجز عن معالجتها إلى أسئلة واضحة ترفعها إلى المستوى الأعلى.
مثال على تصميم سير عمل AI بطبقات: اعتراض الحالات التي لا تحتاج إلى نموذج لغة كبير أولًا
لنأخذ سير عمل شائعًا، هو «المعالجة الآلية لتذاكر خدمة العملاء»، لنوضح كيف يمكن تحديد حدود استدعاء النموذج في كل خطوة. هذا مثال تصميمي، وليس بيانات مقاسة من مشروع حقيقي.
| خطوة سير العمل | الطبقة المسؤولة | طريقة المعالجة | هل تستهلك الرموز (tokens)؟ |
|---|---|---|---|
| التحقق من حقول التذكرة | برنامج ثابت | التحقق من المخطط (Schema)، وإرجاع التذكرة فورًا إذا نقصت حقول | لا |
| الاستعلام عن حالة الطلب والشحن | برنامج ثابت | استدعاء واجهة قاعدة بيانات الأعمال | لا |
| مطابقة الأسئلة الشائعة | برنامج ثابت / نموذج متخصص | إعطاء الأولوية لقواعد الكلمات المفتاحية، واللجوء إلى البحث المتجهي عند الحاجة | كمية قليلة |
| تصنيف النية | نموذج متخصص | يصنّف النموذج الصغير الطلب ضمن فئات محددة | كمية قليلة |
| معالجة الشكاوى المعقدة والحالات الاستثنائية | نموذج لغة كبير أساسي | توليد اقتراحات للمعالجة بالاستعانة بسياق الطلب | نعم |
| تعبئة قالب الرد | برنامج ثابت | يُخرج محرك القوالب النص النهائي | لا |
كما ترى، هناك خطوة واحدة فقط من أصل 6 تستلزم استدعاء نموذج لغة كبير أساسي. أما مقدار التوفير في الرموز، واحتمال انخفاض معدل النجاح، والتغير في زمن الاستجابة، فكلها تعتمد على طبيعة الطلبات الواردة ومدى تغطية القواعد، ويجب تقييمها باستخدام سجلات فعلية.
مثال مبسّط: القواعد أولًا، والنموذج عند الحاجة
توضح الشفرة التالية فكرة التوجيه متعدد الطبقات في أبسط صورها: تبدأ القواعد باعتراض الطلبات الروتينية «الشبيهة بالبراغي»، ثم يتولى نموذج صغير تصنيف البقية، ولا يُستدعى نموذج لغة كبير إلا في الحالات المعقدة. أسماء النماذج للتوضيح فقط؛ يرجى الرجوع إلى قائمة النماذج المتاحة فعليًا على المنصة.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

def handle(query: str) -> str:
    # الطبقة الأولى: برنامج ثابت؛ لا يُستدعى النموذج إذا كانت القواعد كافية
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # الطبقة الثانية: نموذج صغير لتصنيف النية
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # الطبقة الثالثة: لا يُستدعى نموذج اللغة الكبير الأساسي إلا للشكاوى المعقدة
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
عرض الشفرة الكاملة مع تسجيل الاستخدام
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # مثال: نموذج صغير للتصنيف والاستخراج
LARGE_MODEL = "claude-sonnet-4"   # مثال: نموذج لغة كبير للاستدلال المعقد

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 نصيحة للبدء السريع: للحصول على نتائج موثوقة من التوجيه متعدد الطبقات، استخدم واجهة موحدة للتبديل بين النماذج في الطبقات المختلفة وسجّل الاستهلاك. يُنصح باستخدام APIYI عبر apiyi.com لاستدعاء النموذج الصغير والنموذج الكبير بمفتاح API واحد، ومقارنة استهلاك الرموز في كل طبقة باستخدام إحصاءات المنصة. ويمكن للمستخدمين الجدد البدء برصيد الاختبار المجاني للتحقق من النموذج الأولي.
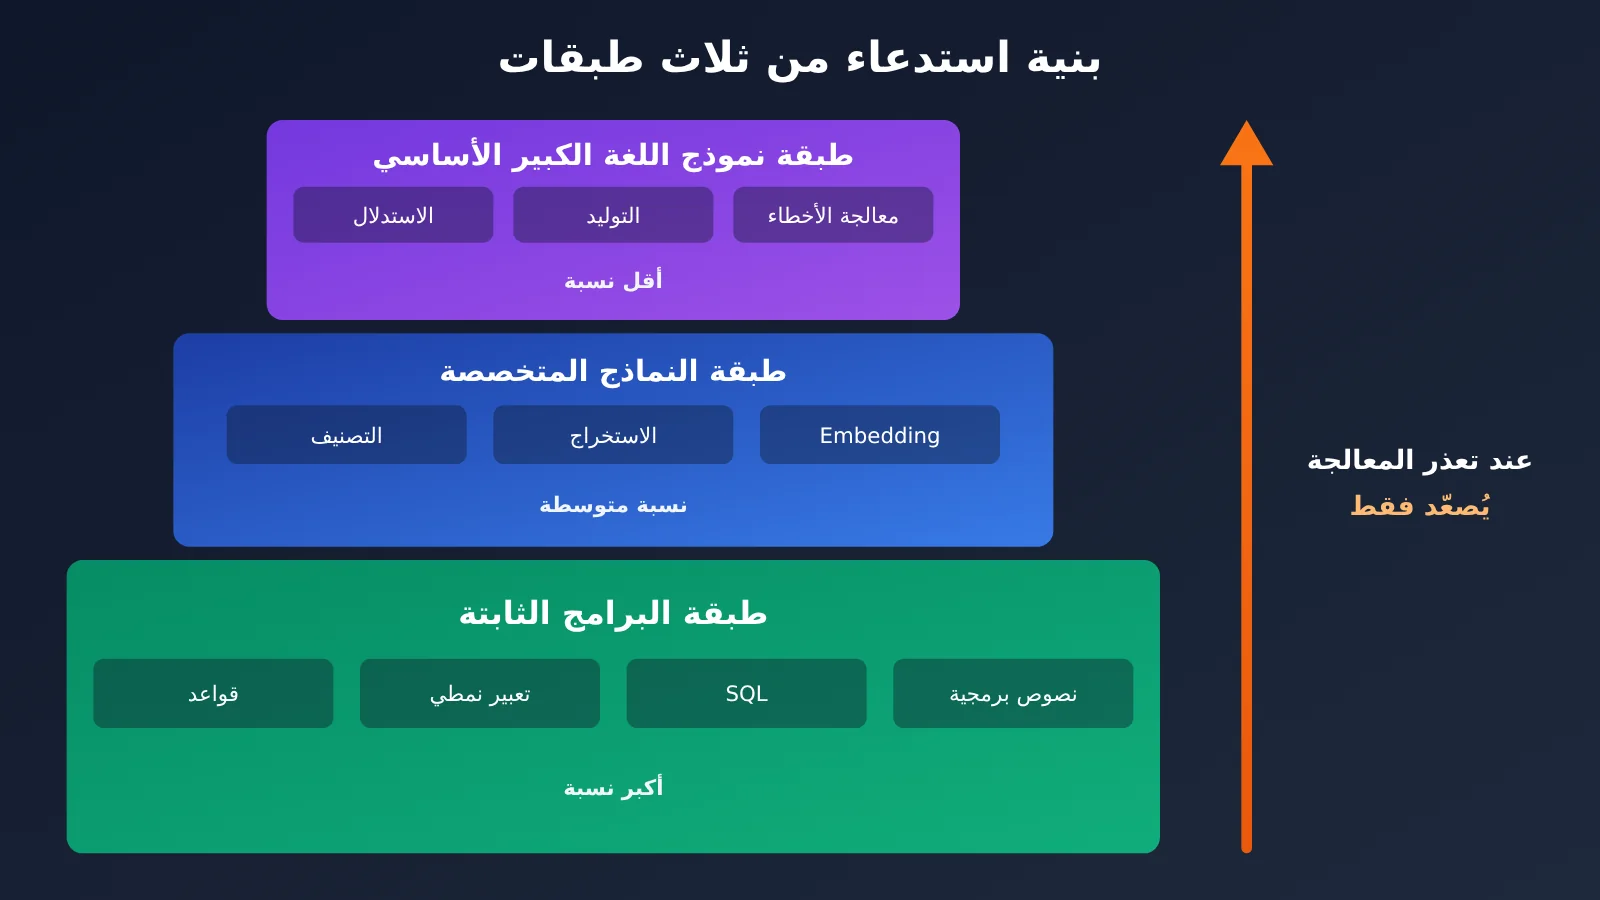
تحليل أثر مبدأ «لا تحاسبني على التوكن مقابل كل مسمار أشدّه»
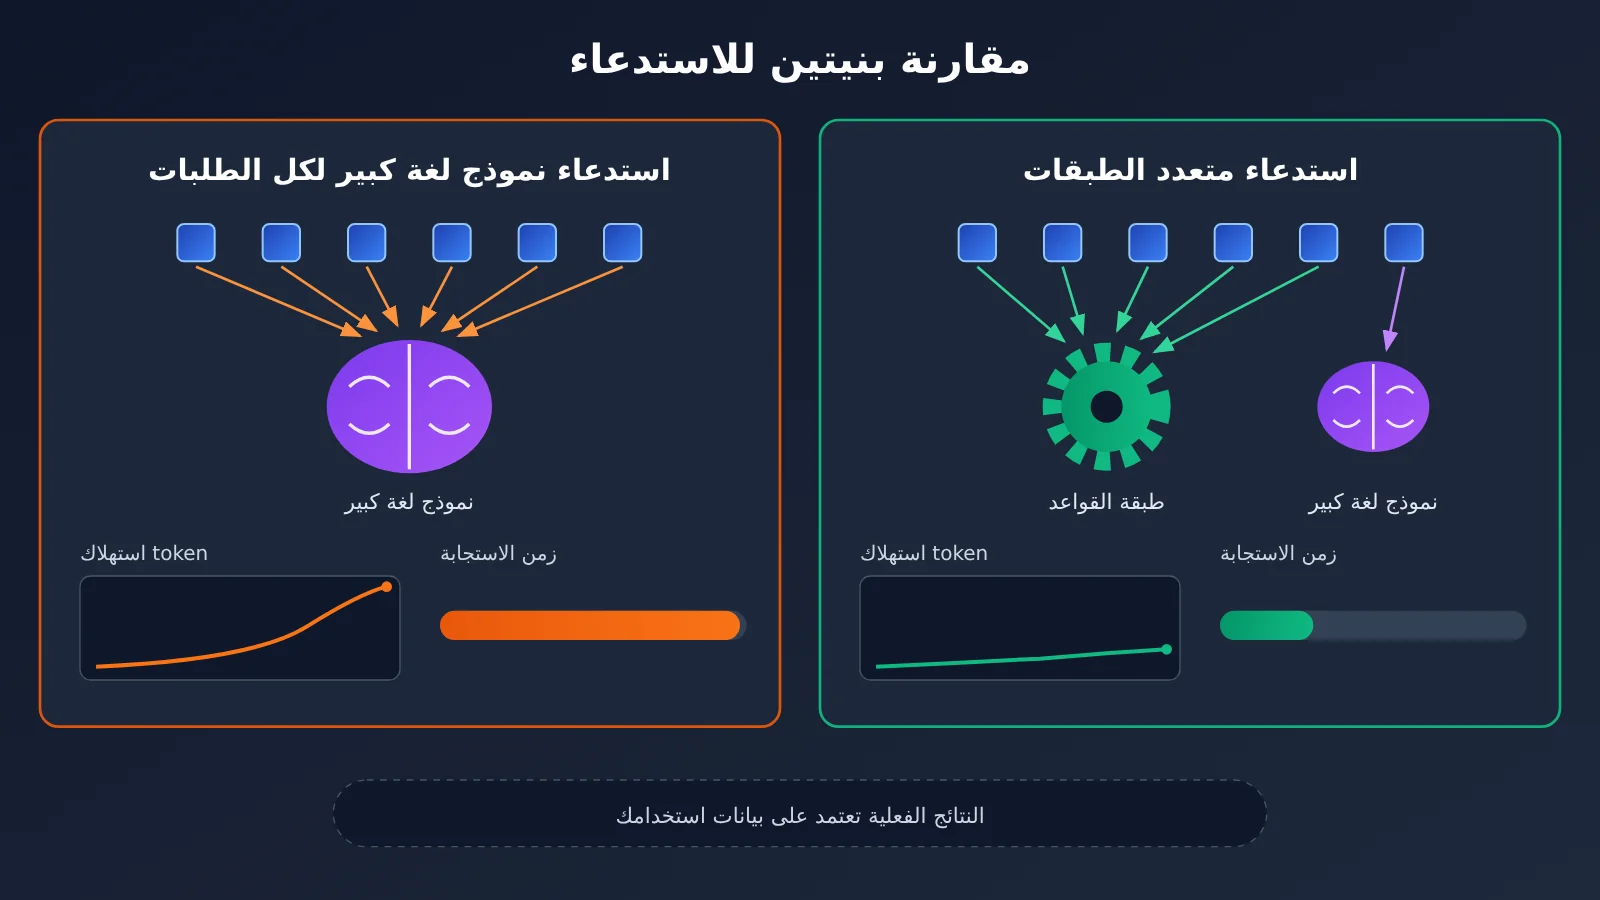
يوضح الرسم أعلاه الاختلاف في بنية التصميمين، وليس أرقامًا مستمدة من قياسات فعلية. للحصول على مقارنة دقيقة، يُنصح بتشغيل الحلّين باستخدام مجموعة الطلبات نفسها على APIYI apiyi.com، ثم استخلاص النتائج بالاستناد إلى سجلات الاستخدام.
| معيار المقارنة | استدعاء نموذج اللغة الكبير لكل مهمة | الاستدعاء متعدد الطبقات | المنصات المتاحة |
|---|---|---|---|
| سرعة التطوير | الأسرع لإنشاء نموذج أولي، إذ يكفي كتابة موجه | يتطلب إعداد قواعد وآلية لتوجيه الطلبات | APIYI apiyi.com وواجهات API الرسمية لمختلف المزودين |
| استهلاك التوكن | تُحتسب تكلفة كل مرحلة | تتركز التكلفة على المراحل المعقدة | كما سبق |
| حتمية النتائج | قد تظهر اختلافات عشوائية حتى في المهام الحتمية | نتائج طبقة القواعد قابلة للتوقع | كما سبق |
| زمن الاستجابة | تتطلب كل خطوة انتظار النموذج حتى يولّد النتيجة | تعيد طبقة القواعد النتائج بشكل شبه فوري | كما سبق |
| تكلفة الصيانة | تزداد الموجهات طولًا مع تراكمها | تحتاج القواعد إلى تحديث مع تطور متطلبات العمل | كما سبق |
التأثير على مصممي سير العمل والمطورين
- ينعكس ترتيب التصميم: بدلًا من «توصيل نموذج لغة كبير أولًا، ثم البحث عن طرق لتوفير التكلفة»، تبدأ بحصر جميع الخطوات وتحديد المهام البسيطة المتكررة، ثم تقرر أين تضع النموذج.
- يصبح دور النماذج المتخصصة أكثر أهمية: كما يترجم النموذج المتجسد الحالات الفيزيائية إلى لغة طبيعية، تكمن قيمة الطبقة الوسيطة في تنظيم المدخلات الغامضة وتحويلها إلى مسائل منظمة، بحيث يكون كل استدعاء لنموذج اللغة الكبير أكثر تركيزًا.
- تصبح قابلية الرصد ضرورة: بعد تقسيم النظام إلى طبقات، يجب تسجيل عدد الاستدعاءات واستهلاك الـtoken وزمن الاستجابة لكل طبقة؛ وإلا فلن تتمكن من تحديد ما إذا كان ينبغي نقل مهمة إلى طبقة أعلى أو أدنى.
التأثير على مسؤولي المنتجات
- تصبح التكاليف أكثر قابلية للتوقع: لا تستهلك الخطوات الحتمية رموز token، فتتركز التكاليف في الطلبات الصعبة التي يمكن تقدير حجمها.
- يجب تقبل أن «المزيد من الذكاء ليس دائمًا أفضل»: قد يبدو إسناد مهمة البحث عن طلب إلى نموذج لغة كبير أكثر ذكاءً، لكن ما يحتاجه المستخدم فعلًا هو الدقة والسرعة.
- يجب تحديد مقاييس التحقق مسبقًا: ينبغي استخدام استهلاك الـtoken، ومعدل نجاح المهام، وزمن الاستجابة من البداية إلى النهاية، أساسًا للمقارنة قبل تقسيم النظام إلى طبقات وبعده، وذلك قبل الإطلاق.
التأثير في القطاع
تعكس رؤية لاي جيه توجّهًا يرى أن ازدياد قوة نماذج اللغة الكبيرة الأساسية لا يعني بالضرورة حشر كل القدرات في نموذج واحد، بل إتاحة المجال أمام «وكلاء» ذوي قدرات مختلفة، يؤدي كل منهم دوره. وفي مجال البرمجيات، يتوافق هذا التوجّه مع تطور استدعاء الأدوات وتنسيق عمل الوكلاء. لكن المقابلة تناولت تطبيقه في مجال الروبوتات، ولا تزال البيانات المنشورة عن فوائده في سير عمل البرمجيات محدودة؛ لذا نحتاج إلى تجارب من مزيد من الفرق للتحقق من جدواه.
الأسئلة الشائعة FAQ
س1: ماذا تعني عبارة «لا تفرض عليّ رسوم token مقابل كل برغي»؟
قال ذلك لاي جيه، مؤسس شركة Stardust Intelligence، في مقابلة خاصة مع Aifaner في نوفمبر 2026. ويرى أن الأعمال المتكررة، مثل ربط البراغي بواسطة الروبوتات في المصانع، يجب أن تتولاها برامج ثابتة تعمل على مدار الساعة، بدلًا من استدعاء النموذج ودفع رسوم token عند كل حركة. وفي تطبيقات الذكاء الاصطناعي، يعني ذلك أن الخطوات الحتمية والمتكررة لا ينبغي أن تستدعي نموذج لغة كبيرًا.
س2: هل يمكن تطبيق نهج الروبوتات متعدد الطبقات مباشرة على سير عمل البرمجيات؟
لا يمكن اعتبارهما متطابقين. فالروبوتات تتعامل مع التحكم في الوقت الفعلي والإدراك اللمسي وعرض نطاق الاتصال، بينما يتأثر سير عمل البرمجيات أساسًا بتكلفة token وزمن الاستجابة والاستقرار. ما يمكن الاستفادة منه هو مبدأ تقسيم العمل: «تنفذ طبقة التنفيذ المهام بنفسها، وتصعّد المسائل الصعبة عند الحاجة». أما الفوائد الفعلية فتحتاج إلى التحقق من خلال حالات عملية.
س3: كيف أحدد ما إذا كانت إحدى الخطوات تحتاج إلى نموذج صغير أم نموذج لغة كبير؟
انظر إلى ما إذا كانت المخرجات محدودة والقواعد مستقرة. في المهام ذات الفئات المحدودة والأنماط المستقرة، مثل تصنيف النوايا واستخراج الحقول، جرّب نموذجًا صغيرًا أولًا. أما المهام التي تحتاج إلى استدلال شامل أو توليد مفتوح أو معالجة حالات استثنائية، فأسندها إلى نموذج لغة كبير. يُنصح باختبار نماذج مختلفة على مجموعة العينات نفسها عبر APIYI على apiyi.com، ثم مقارنة الدقة والاستهلاك قبل الاختيار.
س4: هل يضمن تقسيم العمل إلى طبقات خفض التكلفة؟
ليس بالضرورة. إذا كانت معظم طلبات العمل معقدة بطبيعتها ولا تستطيع طبقة القواعد معالجة إلا القليل منها، فستكون الفائدة محدودة. وإذا كانت القواعد واسعة أكثر من اللازم، فقد تعالج طلبات لا تناسبها وتقلل معدل النجاح. الأفضل هو تسجيل الوضع الحالي أولًا، ثم مقارنة استهلاك token ومعدل النجاح وزمن الاستجابة قبل التقسيم وبعده.
س5: كيف أبني نموذجًا أوليًا للاستدعاء متعدد الطبقات بسرعة؟
يمكن اتباع الخطوات التالية:
1. احصر جميع خطوات سير العمل، وحدد الخطوات المتكررة «الشبيهة بربط البراغي» ونفّذها باستخدام القواعد
2. سجّل في APIYI عبر apiyi.com واحصل على مفتاح API، ثم استخدم واجهة متوافقة مع OpenAI لربط نموذج صغير ونموذج لغة كبير
3. استعن بشفرة هذا المقال لتنفيذ التوجيه، وسجّل استهلاك token وزمن الاستجابة لكل طبقة
ميزة الواجهة الموحدة أن تبديل النموذج لا يتطلب سوى تغيير معامل `model`، ما يسهّل تكرار المقارنات.
س6: ما الأخطاء الشائعة في التصميم متعدد الطبقات؟
– **تضخم القواعد**: تتزايد القواعد حتى تصبح صيانتها أصعب من صيانة الموجه، لذا يجب مراجعتها وتنظيفها دوريًا.
– **فقدان المعلومات بين الطبقات**: لا يُمرَّر السياق إلى نموذج اللغة الكبير بعد تصنيف النموذج الصغير، فيضطر النموذج الكبير إلى إعادة فهم الطلب.
– **غياب مسار بديل**: عند فشل كل من القواعد والنموذج الصغير في اتخاذ قرار، يجب توفير مسار للتحويل إلى نموذج لغة كبير أو إلى موظف بشري.
«لا تفرض عليّ رسوم توكن مقابل كل برغي»: أهم النقاط
- مصدر الفكرة: وردت في مقابلة خاصة أجراها موقع 爱范儿 مع 来杰 من 星尘智能 في نوفمبر 2026، وهي تعبّر عن رأي المؤسس.
- منطق توزيع المهام: تنجز طبقة التنفيذ المهام بنفسها، ولا تلجأ إلى نموذج اللغة الكبير الأساسي إلا للحصول على سياق إضافي في المسائل الصعبة.
- 5 أنواع من مهام «البراغي»: التحقق من التنسيق، والاستعلام عن البيانات، وإخراج القوالب، والتحكم في سير العمل، واستخدام النتائج الموجودة في الذاكرة المؤقتة؛ لا تستدعي هذه المهام استخدام نموذج لغة كبير.
- بنية من ثلاث طبقات: برامج ثابتة في الأساس، ونماذج متخصصة في الوسط، ونموذج لغة كبير أساسي للمسائل المفتوحة والحالات الاستثنائية فقط.
- حدود القياس: لا يمكن تطبيق الاستنتاجات المتعلقة بالروبوتات مباشرة على البرمجيات؛ ويجب التحقق من الفوائد باستخدام بياناتك الخاصة.
- ثلاثة مؤشرات للتحقق: قارن استهلاك التوكنات، ومعدل نجاح المهام، وزمن الاستجابة من البداية إلى النهاية، قبل تطبيق الطبقات وبعده.
- كيف تبدأ: يمكنك استخدام الواجهة الموحدة من APIYI على apiyi.com للتبديل بين نماذج الطبقات المختلفة ومراقبة الاستهلاك.
الخلاصة
تدعونا عبارة «لا تفرض عليّ رسوم توكن مقابل كل برغي» إلى إعادة النظر في حدود استدعاء النماذج داخل سير عمل الذكاء الاصطناعي:
- حدّد مهام البراغي أولاً: أسند المهام المتكررة ذات النتائج المحددة والإجابة الواحدة إلى برامج ثابتة.
- استخدم النماذج المتخصصة بعد ذلك: دع النماذج الصغيرة تنجز المهام ذات الفئات المحدودة والأنماط المستقرة، وتنظّم المسائل.
- اترك نموذج اللغة الكبير للمرحلة الأخيرة: فالاستدلال المفتوح، والقرارات في الحالات الاستثنائية، والتوليد الإبداعي هي المهام التي تستحق دفع رسوم التوكنات.
لا تعتمد هذه الطريقة على نموذج معين أو إصدار محدد، ويمكن استخدامها على المدى الطويل بوصفها قائمة مراجعة عند تصميم الوكلاء. وعند تطبيقها، احرص على التحقق من الفروق قبل تقسيم العمل إلى طبقات وبعده باستخدام سجلات أعمالك، بدلاً من افتراض أن التكلفة ستنخفض بالضرورة.
إذا كنت تصمم سير عمل متعدد الطبقات، فيمكنك استخدام مفتاح API واحد عبر APIYI على apiyi.com للوصول إلى نماذج بأحجام مختلفة، والتبديل بينها بمرونة في كل طبقة، ومقارنة إحصاءات الاستخدام لتحديد الجهة المناسبة لربط كل «برغي» بناءً على البيانات.
📚 المراجع
- 爱范儿 – حوار مع لاي جيه من 星尘智能: المقابلة الخامسة عشرة في سلسلة «شركات متنوعة»
- الرابط:
ifanr.com/1687805 -
التوضيح: المصدر الأصلي لتشبيه «ربط البراغي ورسوم التوكنات»، وفكرة توزيع المهام بين نماذج الذكاء المتجسد والنماذج اللغوية الكبيرة الأساسية.
-
وثائق واجهة OpenAI Chat Completions: شرح معلمات الواجهات المتوافقة مع OpenAI
- الرابط:
platform.openai.com/docs/api-reference/chat - التوضيح: تساعد على فهم الحقول مثل
modelوmax_tokensوusage، لتسهيل تسجيل الاستخدام حسب الطبقة.
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لموقع APIYI، والاطلاع على مركز وثائق APIYI لمزيد من المعلومات حول ربط النماذج وإحصاءات الاستخدام.