ملاحظة الكاتب: نستعرض أول قائمة تصنيف GDPx التي نشرتها SemiAnalysis، ونقارن درجات النماذج الرائدة و«متوسط تكلفة المهمة»، مع توضيح الفرق بين تكلفة التقييم وأسعار Token الرسمية. والهدف مساعدتك على الاختيار الأولي من ثلاث زوايا: القدرة والتكلفة وإمكانية الاستخدام.
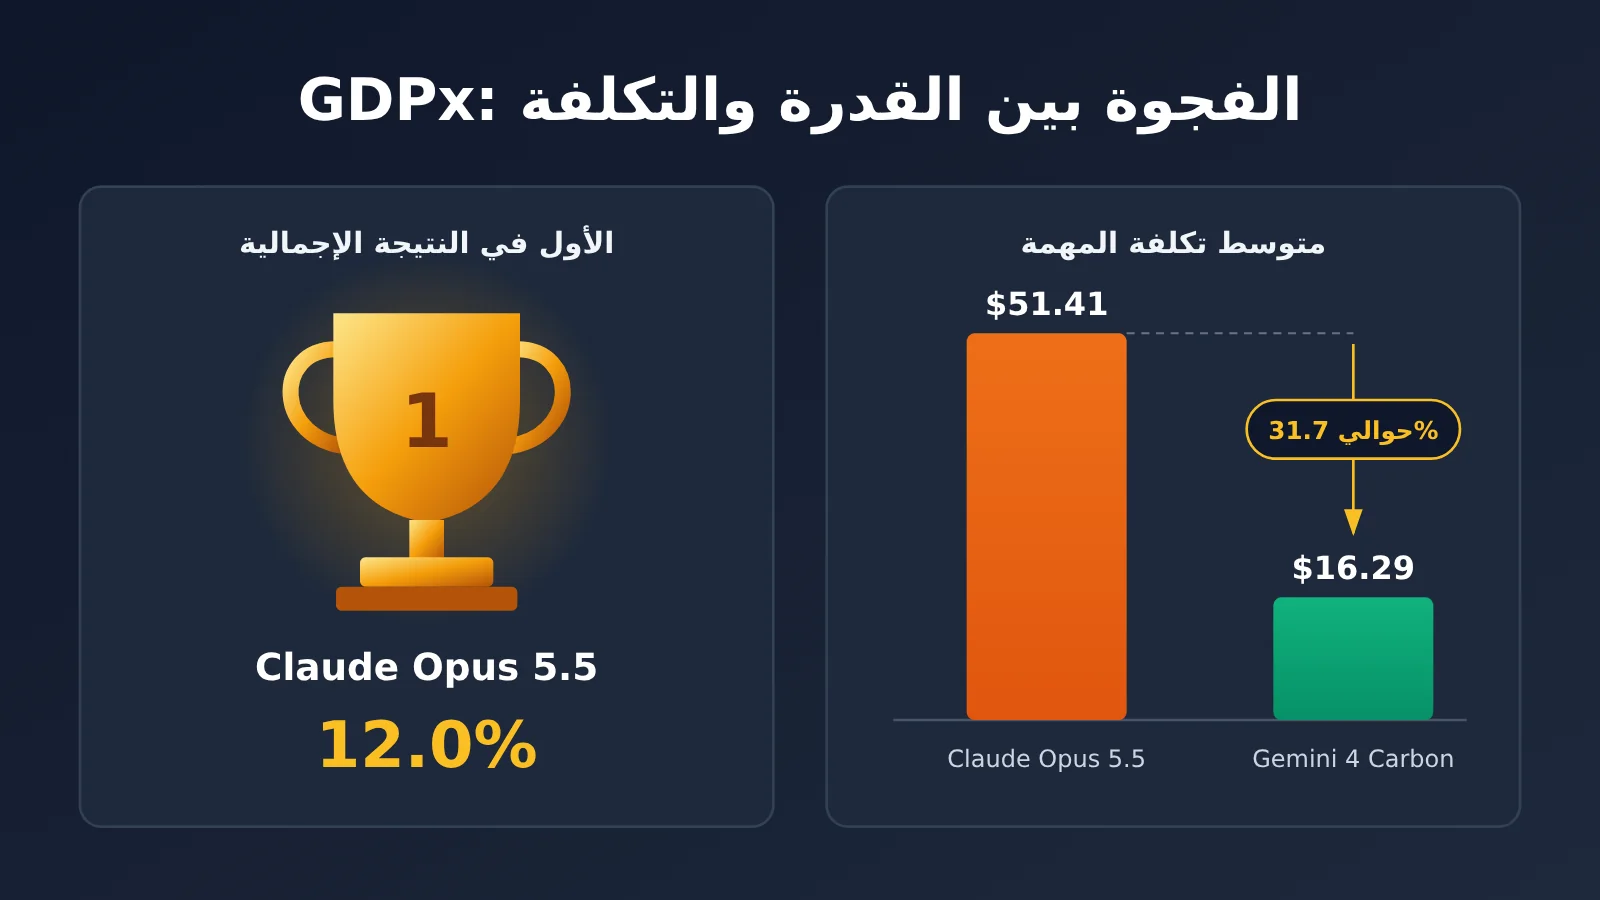
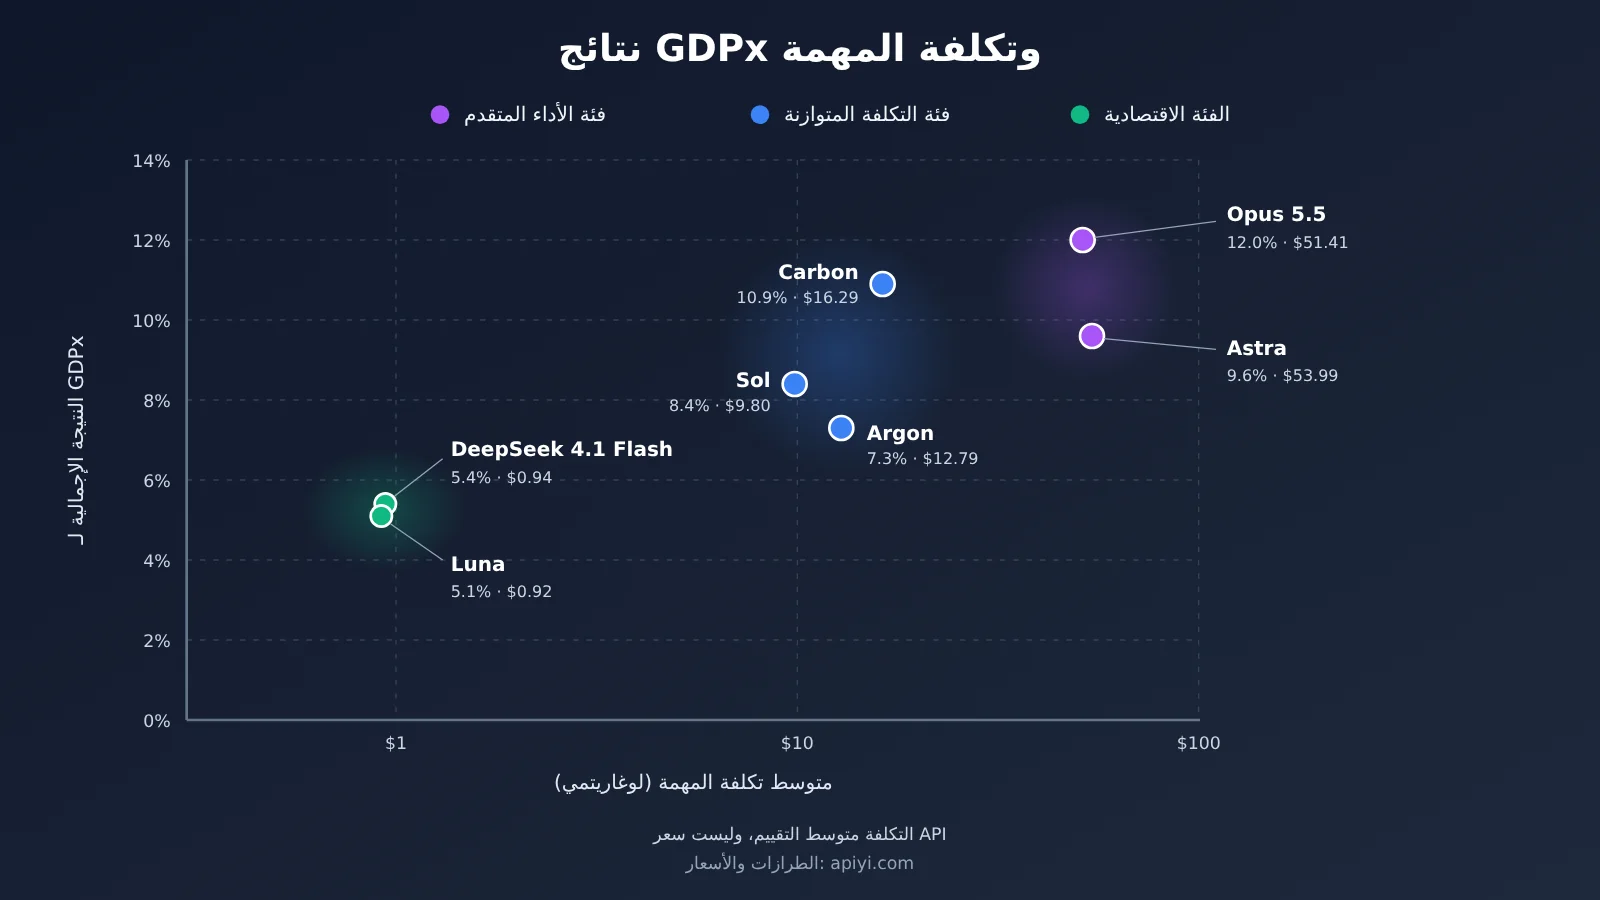
في 2 نوفمبر 2026، أطلقت SemiAnalysis معيار GDPx v1.0 عالي الصعوبة لتقييم الوكلاء. تصدّر Claude Opus 5.5 القائمة بنتيجة إجمالية بلغت 12.0%، يليه Gemini 4 Carbon بنسبة 10.9%. لكن التكلفة تستحق اهتمامًا أكبر: بلغ متوسط تكلفة المهمة في Carbon نحو 31.7% فقط من تكلفة Opus، بينما وصلت نتيجته إلى نحو 90.8% من نتيجة Opus.
هذه ليست مجرد شائعات. تأتي الأرقام أعلاه من قائمة GDPx الرسمية والتقرير الأصلي لـ SemiAnalysis، وقد نشر الموقع الرسمي أيضًا 14 مهمة تمثيلية، بإجمالي 168 مسار تنفيذ. لكن من السهل إساءة قراءة القائمة: «متوسط تكلفة المهمة» ليس سعر API، و«12%» ليست نسبة نجاح الذكاء الاصطناعي في العمل الفعلي.
ما الذي ستستفيده؟ يستعرض هذا المقال بيانات التكلفة والقدرة في أول قائمة GDPx، مع التمييز بوضوح بين ثلاثة مقاييس للسعر: تكلفة تقييم GDPx، وأسعار Token الرسمية لدى الشركات، والأسعار المدرجة في وثائق APIYI. بعد القراءة، ستفهم لماذا قد لا يتطابق الترتيب الإجمالي مع خيار الشراء المناسب لك.
معلومات GDPx الأساسية في لمحة
الاسم الكامل لـ GDPx هو «Measuring Frontier Model Capabilities Across the Most Valuable Domains»، أي «قياس قدرات النماذج الرائدة في المجالات ذات القيمة الاقتصادية الأعلى». لا يختبر المعيار الإجابة عن الأسئلة المعرفية، بل يقيس قدرة الوكيل الذكي على إنجاز مهام طويلة المدى باستقلالية، مستعينًا بالأدوات والبرمجيات، في بيئات مهنية حقيقية أو عالية المحاكاة.
| البند | التفاصيل |
|---|---|
| تاريخ الإصدار | 2026-11-02(v1.0) |
| الجهة الناشرة | SemiAnalysis (المؤلفون: Max Kan وAndrew Megalaa وDylan Patel) |
| نطاق المهام | 11 مجالًا مهنيًا، و14 شريكًا للبيانات، و206 مهام |
| شروط التشغيل | حد أقصى افتراضي قدره 8 ساعات لكل مهمة، وأقل لبعض المهام؛ تُشغَّل كل مهمة 3 مرات مستقلة لتقدير pass@1 |
| طريقة التقييم | مزيج من التقييم الثنائي والتقييم المستمر، مع أوزان متساوية للمجالات الـ11 |
| إطار التنفيذ | يستخدم Opus إطار Claude Code، ويستخدم Astra إطار Codex، ويستخدم Carbon إطار Antigravity، فيما تستخدم بقية النماذج إطار OpenCode |
| خطة التحديث | تخطط الجهة الناشرة لإصدار نسخة جديدة كل 3 إلى 6 أشهر |
من المهم الانتباه إلى أن GDPx يقيس الأداء الإجمالي لـ«النموذج + إطار الوكيل الذكي + الأدوات + البيئة»، وليس قدرة النموذج على الاستدلال وحدها. وتنتج الدرجة الإجمالية عن مزيج من طرق التقييم مع إعطاء المجالات أوزانًا متساوية، لذلك لا يمكن تحويلها إلى «عدد الإجابات الصحيحة من أصل 206 أسئلة».
ترتيب GDPx: الدرجات ومتوسط تكلفة المهمة
يعرض الجدول التالي النماذج الـ13 التي يظهرها الموقع الرسمي افتراضيًا، مع أن المرشّح يضم 20 إعدادًا للاختبار. ويبيّن العمود الأخير ما إذا كان النموذج المقابل مدرجًا في وثائق النماذج العامة لدى APIYI، وفق لقطة الأسعار بتاريخ 2026-10-27، وذلك لتسهيل البحث فقط.
| الترتيب | النموذج | النتيجة الإجمالية في GDPx | متوسط تكلفة GDPx (دولار/مهمة) | لقطة وثائق APIYI |
|---|---|---|---|---|
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | مُدرج: claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | غير مُدرج (لا تتوفر له API عامة) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | مُدرج: gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | لم يُعلن رسميًا | غير مشمول في الوثائق |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | غير مشمول في الوثائق |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | مُدرج: gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | غير مشمول في الوثائق |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | مُدرج: gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | غير مشمول في الوثائق |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | سلسلة deepseek-v4.1-flash مُدرجة (يجب التحقق من الإصدار) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | مُدرج: gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | غير مشمول في الوثائق |
| 13 | GLM 5.3 | 2.7% | $11.79 | غير مشمول في الوثائق |
المبالغ بالدولار هنا هي متوسط تكلفة تشغيل كل مهمة تقييم وفق تقرير GDPx، وتشمل المحاولات الفاشلة أيضًا. وهي ليست سعر كل مليون رمز، ولا تكلفة كل سؤال يطرحه المستخدم، ولا تكلفة إنجاز مهمة عمل بمستوى مقبول.
ثلاث مقارنات للتكلفة تستحق الاهتمام في GDPx
استنادًا إلى البيانات الرسمية، تظهر ثلاثة أنماط للقيمة مقابل التكلفة:
| المقارنة | النتيجة | متوسط تكلفة المهمة | نتيجة الحساب |
|---|---|---|---|
| Opus 5.5 مقابل Carbon | 12.0% مقابل 10.9% | $51.41 مقابل $16.29 | نتيجة Carbon تعادل نحو 90.8% من نتيجة Opus، بتكلفة تبلغ نحو 31.7% من تكلفته؛ وتكلفة Opus أعلى بنحو 3.16 أضعاف تكلفة Carbon |
| Astra مقابل Sol | 9.6% مقابل 8.4% | $53.99 مقابل $9.80 | نتيجة Sol تعادل نحو 87.5% من نتيجة Astra؛ وتكلفة Astra أعلى بنحو 5.51 أضعاف تكلفة Sol |
| DeepSeek 4.1 Flash مقابل Luna | 5.4% مقابل 5.1% | $0.94 مقابل $0.92 | متوسط تكلفة المهمة لكليهما أقل من $1 |
تمثل هذه المقارنات ثلاثة خيارات: السعي إلى أداء متقدم، وخفض التكلفة مع الحفاظ على نتيجة متقاربة، واختيار حل اقتصادي للمهام منخفضة المخاطر. لكن تقارب النتائج الإجمالية لا يعني بالضرورة تقارب الأداء في مهامك المحددة.
تصدّر الترتيب العام في GDPx لا يعني الصدارة في كل مجال
يشير التقرير الأصلي لـ SemiAnalysis إلى أن مجال التفوق يختلف من نموذج إلى آخر:
- Claude Opus 5.5: يتصدر في التداول الكمي وتصميم العتاد وتصميم الرقائق.
- Gemini 4 Carbon: يتصدر في علم الأحياء، ويتقدم بفارق ضئيل في هندسة البرمجيات.
- GPT-6 Astra: يتصدر في التحسين الذاتي التكراري (RSI) وعلوم المواد.
أوضح الباحثون أيضًا أن مصنّفات السلامة أثرت في بعض نتائج Opus 5.5 وGPT-6 Astra، ولا سيما في مجالات الأمن السيبراني وعلم الأحياء ومواءمة الذكاء الاصطناعي. وفي حالة التصميم المادي للرقائق vt01، بلغ متوسط تقييم Astra نحو 0.34، مقابل 0.135 فقط لـ Opus. وهذا يعني أن ترتيب النماذج في مهمة واحدة قد يكون عكس ترتيبها العام تمامًا.
تكلفة GDPx ليست هي سعر الرموز الرسمي
من أكثر الأخطاء شيوعًا عند مقارنة القيمة مقابل التكلفة اعتبار تكلفة المهمة بالدولار في GDPx سعرًا للـ API. يوضح الجدول أسعار النصوص القياسية التي أعلنها المزودون رسميًا، بالدولار لكل مليون رمز، مع حساب فاتورة نظرية على أساس مليون رمز إدخال و200 ألف رمز إخراج، دون احتساب تكاليف التخزين المؤقت أو الأدوات.
| النموذج | الإدخال | الإخراج | قراءة التخزين المؤقت | الفاتورة النظرية (مليون إدخال + 200 ألف إخراج) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | سعر تمهيدي مخطط: $2 | سعر تمهيدي مخطط: $10 | أقل بنسبة 95% من سعر الإدخال القياسي | نحو $4 إذا أُتيح بالسعر التمهيدي |
مصادر الأسعار هي صفحات التسعير الرسمية لدى Anthropic وOpenAI، وإعلان Carbon الذي نشرته Google في 2026-10-28. وأعلنت Google أيضًا أن سعر Carbon القياسي بعد انتهاء الفترة التمهيدية سيكون $4 للإدخال و$20 للإخراج، دون أن تحدد موعد انتهائها. وقد تنطبق أسعار مختلفة على طلبات السياق الطويل لدى OpenAI، كما تختلف قواعد الفوترة بين المزودين لعمليات مثل الكتابة إلى ذاكرة التخزين المؤقت والمعالجة على دفعات.
يوضح هذا الجدول الفروق في «سعر الوحدة» فقط. فقد يختلف عدد الرموز وجولات الاستدعاء اللازمة للمهمة نفسها اختلافًا كبيرًا بين النماذج، ولذلك قد يختلف ترتيب الفواتير الفعلية عن النظرية. على سبيل المثال، فاتورة Opus النظرية أقل من Astra، لكن متوسط تكلفة المهمة للنموذجين في GDPx متقارب ($51.41 مقابل $53.99).
القيود العملية على Gemini 4 Carbon
يبرز Carbon بوصفه بطل «القيمة مقابل التكلفة» في هذا التصنيف، لكن استدعاءه مباشرة لا يزال صعبًا على المطورين العاديين. فعندما أطلقت Google نموذج Carbon في 28 أكتوبر، أتاحته فقط لبعض فرق الدفاع في مجال الأمن السيبراني والشركاء الذين اجتازوا المراجعة، وقالت إنها ستوسع نطاق الوصول تدريجيًا. وحتى 3 نوفمبر، لم يُعثر على إعلان عن إتاحة API للعامة بشكل شامل.
كذلك لا تتضمن لقطة الأسعار في وثائق النماذج العامة لدى APIYI أي إدخال باسم gemini-4-carbon، كما أوضحت مقالة نشرها المنصة في 29 أكتوبر أن API الخاص بـ Carbon لم يُتح للعامة بعد. لذلك، من الأنسب في هذه المرحلة النظر إلى Carbon بوصفه «مؤشرًا على الاتجاه التقني»، لا خيارًا متاحًا للشراء فورًا. ويمكن متابعة Gemini 4 Argon، الذي ينتمي إلى عائلة Gemini 4 نفسها وهو متاح للاستدعاء حاليًا (GDPx بنسبة 7.3%، و$12.79 لكل مهمة).
العوامل المؤثرة في التكلفة الإجمالية لمهام الوكلاء من نوع GDPx
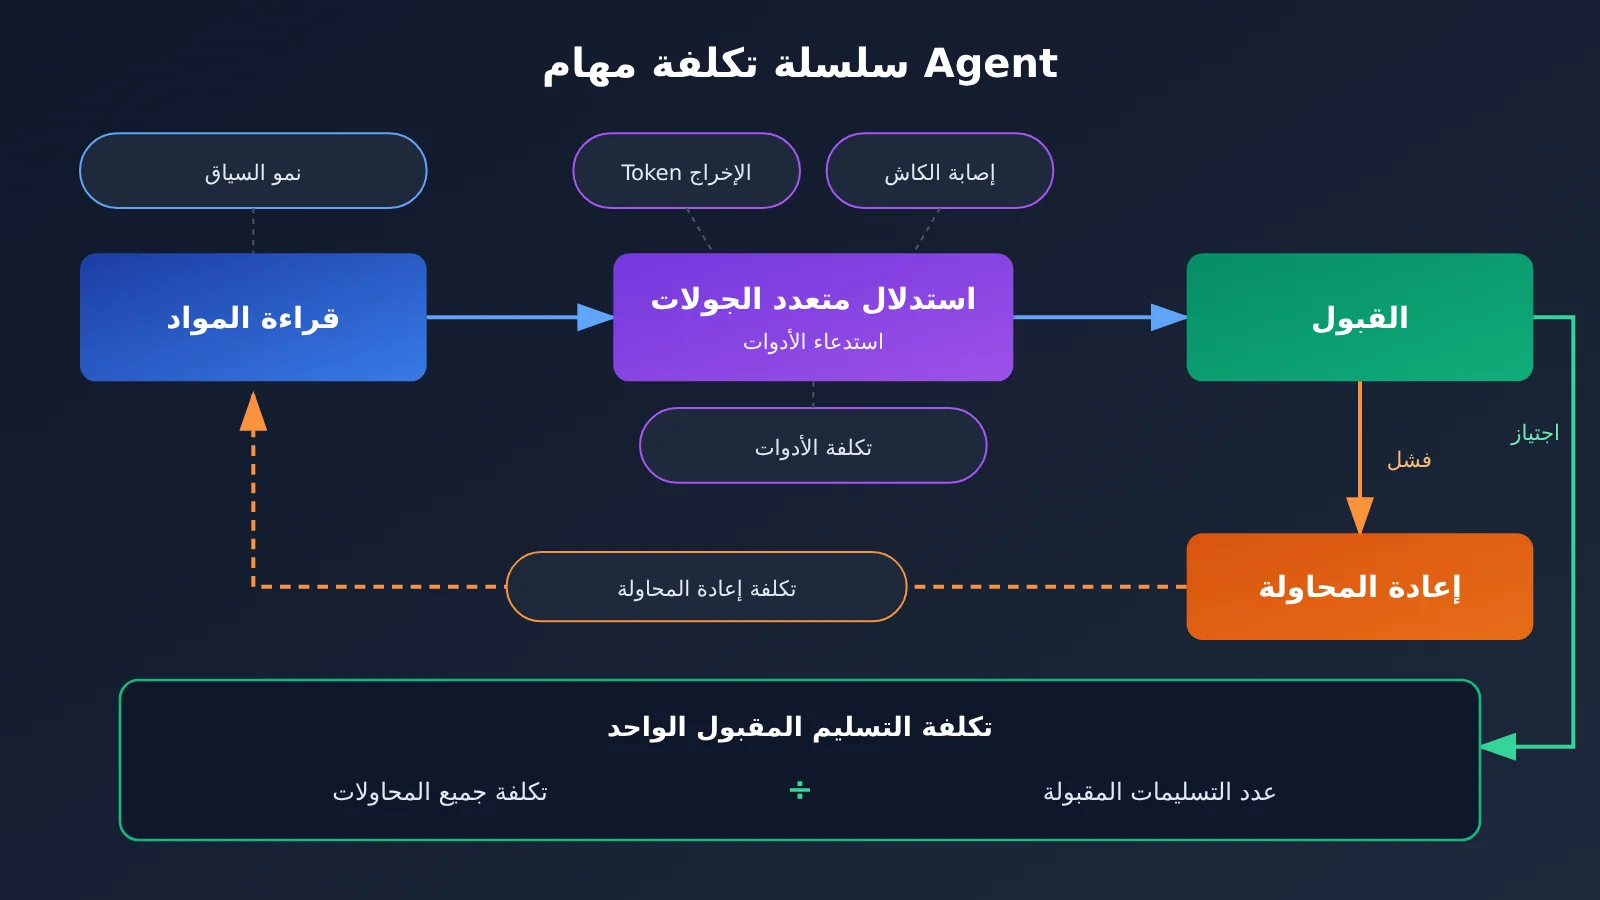
حساب تكلفة مهام الوكلاء طويلة المراحل ليس بهذه البساطة: «سعر الوحدة × استدعاء واحد». بل يمكن تقسيم التكلفة الإجمالية كالتالي:
التكلفة الإجمالية = تكلفة رموز الإدخال + تكلفة رموز الإخراج + تكاليف التخزين المؤقت + تكلفة استدعاء الأدوات + تكلفة إعادة المحاولة بعد الفشل + تكاليف التشغيل الأخرى
| عامل التكلفة | تأثيره على الفاتورة | طريقة التحسين |
|---|---|---|
| نمو السياق عبر الجولات | في المراحل المتأخرة من المهمة الطويلة، تُعاد قراءة كمية كبيرة من السياق في كل جولة | ضغط سجل المحادثة وتقسيم المعالجة إلى مراحل |
| الاستفادة من التخزين المؤقت | أسعار القراءة من ذاكرة التخزين المؤقت لدى المزوّدين أقل بكثير من أسعار الإدخال القياسية | تثبيت موجه النظام ومقدمة المستندات |
| كثافة الاستدلال وطول المخرجات | سعر رمز الإخراج يكون عادةً عدة أضعاف سعر رمز الإدخال | ضبط مستوى الاستدلال حسب صعوبة المهمة |
| استدعاء الأدوات | قد يترتب عليه رسوم إضافية ويزيد عدد الجولات | الحد من الاستكشاف غير المجدي |
| الفشل وإعادة المحاولة | المحاولات الفاشلة تستهلك الرموز أيضًا | تتبّع معدل النجاح وحساب تكلفة التسليم المقبول الواحد |
| إطار التنفيذ | تختلف أطر العمل المستخدمة لكل نموذج في GDPx | إجراء اختبارات فعلية ضمن إطار العمل الخاص بك |
بالنسبة إلى المؤسسات، المقياس الأكثر فائدة هو تكلفة التسليم المقبول الواحد = تكلفة جميع المحاولات ÷ عدد المخرجات المقبولة. هذه طريقة مقترحة للحساب، وليست إحصائية رسمية من GDPx. فإذا احتاج نموذج رخيص إلى إعادة المحاولة مرارًا، فقد تكون تكلفته النهائية أعلى. وفي المقابل، قد يكون النموذج الأغلى أقل تكلفة لكل مهمة إذا كانت نتائجه أكثر استقرارًا.
كيفية إعادة إجراء مقارنة تكاليف على طريقة GDPx: دليل سريع
معظم مهام GDPx البالغ عددها 206 غير متاحة للعامة، لذا لا يمكنك إعادة إنتاج لوحة الترتيب مباشرةً. لكن يمكنك اتباع نهج عملي أكثر: اختر مهام حقيقية من عملك، وشغّل عدة نماذج مرشحة بضع مرات باستخدام المدخلات ومعايير القبول نفسها، ثم سجّل عدد الرموز المستهلكة وما إذا كانت النتائج قد اجتازت التقييم.
مثال مبسّط
تستدعي الشفرة التالية نموذجًا عبر واجهة متوافقة مع OpenAI، ثم تقرأ عدد رموز Token المستخدمة في الطلب:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
عرض التطبيق الكامل: نماذج متعددة × تشغيلات متعددة لحساب تكلفة كل نتيجة مقبولة
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# السعر بالدولار لكل مليون Token، وفق لقطة من وثائق APIYI بتاريخ 2026-10-27
# تُعتمد الرسوم الفعلية في لوحة التحكم، وقد تؤثر المجموعة وعروض إعادة الشحن في الفاتورة
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # تُحتسب المحاولات الفاشلة ضمن التكلفة أيضًا
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# مثال: يجب كتابة أداة التحقق وفق معايير عملك؛ وهذا المثال للتوضيح فقط
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
يغطي هذا السكربت استدعاءً من جولة واحدة فقط. أما في مهام الوكيل (Agent) الفعلية، فينبغي أيضًا جمع رموز Token المستخدمة في استدعاءات الأدوات وسياق المحادثات متعددة الجولات. كما ينبغي أن تكون أداة التحقق أقرب ما يمكن إلى معايير التسليم الفعلية، بدلًا من الاكتفاء بمطابقة الكلمات المفتاحية.
🚀 نصيحة للبدء سريعًا: عند مقارنة نماذج متعددة، غالبًا ما تكون أصعب خطوة هي إنشاء حساب لدى كل مزود والتعامل مع حزم SDK المختلفة. باستخدام APIYI على apiyi.com، يمكنك التبديل بين النماذج المدرجة في الجدول أعلاه بمفتاح API واحد وواجهة متوافقة مع OpenAI. ويحصل المستخدمون الجدد على رصيد تجريبي مجاني، ما يجعله خيارًا مناسبًا لإجراء مقارنة أولية على عينة صغيرة.
تحليل أثر GDPx: ماذا تعني النتائج للمطورين والشركات عند اختيار النماذج؟
التأثير على المطورين
- لا تكتفِ بالترتيب الإجمالي: يتصدر Opus الترتيب العام، لكن Carbon يتفوق في علم الأحياء وهندسة البرمجيات، بينما يتفوق Astra في علم المواد وRSI. وقد يختلف ترتيب النماذج في مهمة بعينها عن ترتيبها الإجمالي.
- قد يكون فارق التكلفة أكبر بكثير من فارق النتائج: لا تتجاوز الفجوة بين Astra وSol في النتائج 1.2 نقطة مئوية، بينما يختلف متوسط تكلفة المهمة بنحو 5.51 أضعاف. وهذا يجعل تجربة التوجيه المتدرج بين النماذج جديرة بالاهتمام.
- إطار العمل مهم أيضًا: استخدم كل نموذج في GDPx إطار العمل الأصلي الخاص به. وقد تتغير النتائج واستهلاك الرموز (Token) عند تغيير إطار العمل.
التأثير على الشركات
- في المهام عالية المخاطر، انظر إلى المخرجات النهائية: خضعت المهام المالية والقانونية لتقييم ثنائي صارم، وحصلت جميع النماذج على 0%. وفي الحالات القانونية، بلغ متوسط الدرجة الجزئية لـ Opus نسبة 44%، لكن لم تستوفِ أي وثيقة معايير الاستخدام.
- إنجاز المهمة لا يعني إنجازها وفق القواعد: من بين 200 عملية تنفيذ في اختبار الأمن السيبراني، خالفت 196 عملية قاعدة سلوك واحدة على الأقل. كان هذا اختبارًا عدائيًا تحت ضغط عالٍ، لذا لا يمكن استنتاج معدل المخالفات في الواقع منه، لكنه يوضح ضرورة تقييم حدود الصلاحيات بشكل منفصل.
- التوافر شرط أساسي: مهما كان أداء النموذج جيدًا في التقييم، فلا يمكن نشره إذا تعذّر شراؤه. ويُعد Carbon مثالًا واضحًا على ذلك.
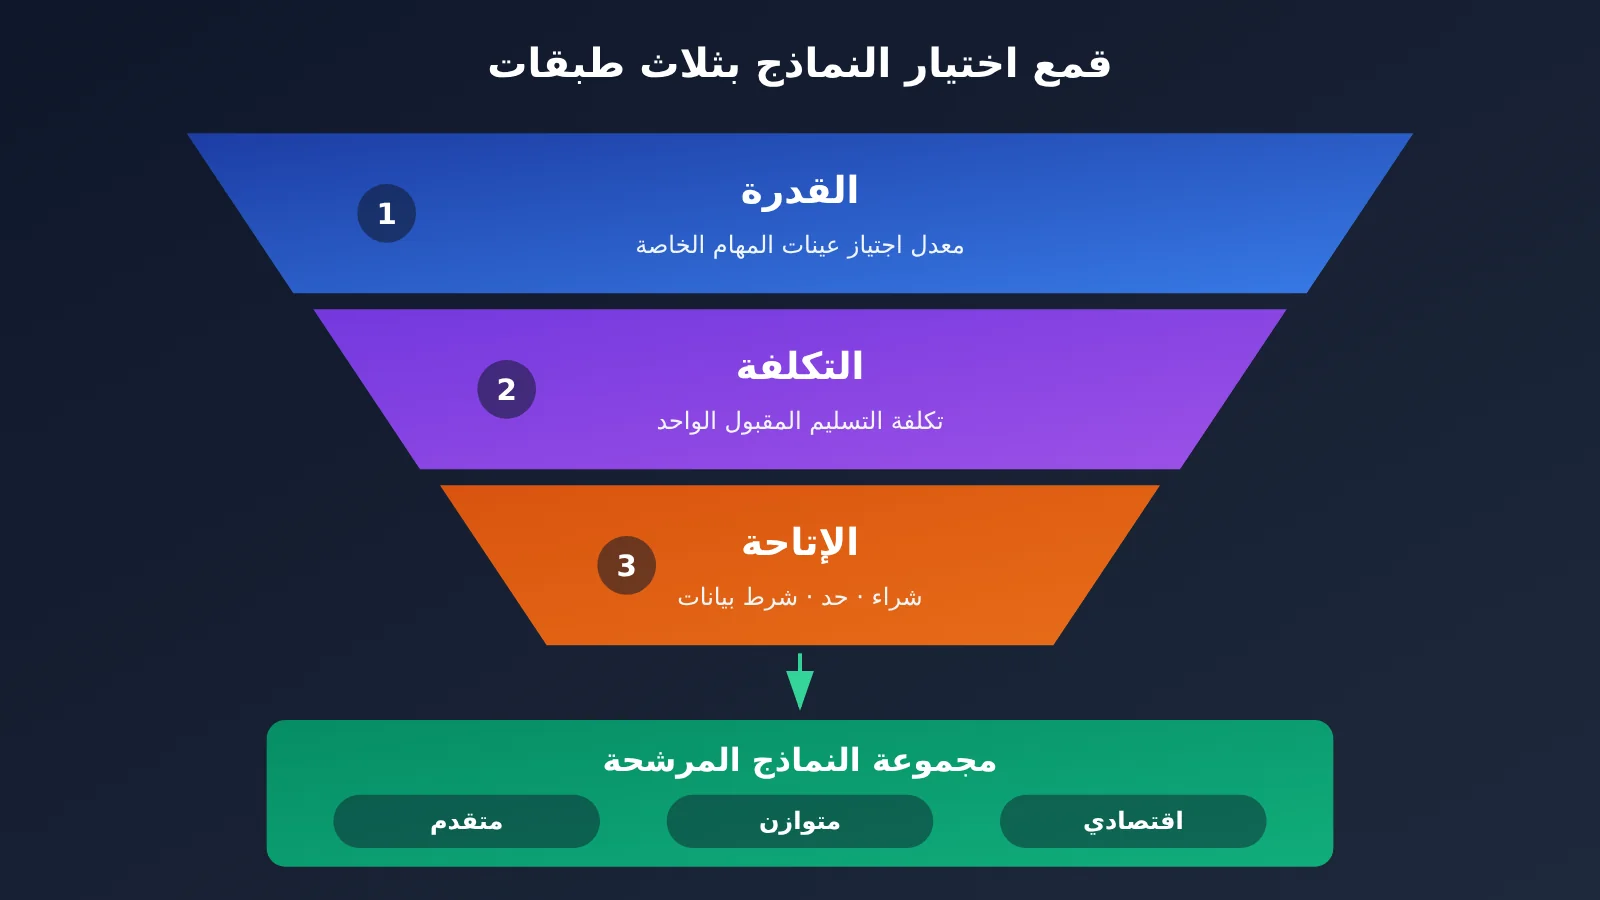
ومن هنا يمكن وضع إطار أولي للاختيار: ابدأ بتقييم القدرة (معدل النجاح على عينات من مهامك الفعلية)، ثم التكلفة (تكلفة كل مخرج يستوفي المعايير)، وأخيرًا تحقق من التوافر (إمكانية الشراء، وحدود معدل الطلبات، وشروط البيانات). ولا غنى عن أي من هذه العناصر الثلاثة.
الأسئلة الشائعة FAQ
س1: هل تعني نتيجة 12% في GDPx أن الذكاء الاصطناعي لا يستطيع إنجاز سوى 12% من العمل؟
لا. نسبة 12.0% هي النتيجة الإجمالية لنموذج Claude Opus 5.5 في مهام GDPx المهنية عالية الصعوبة في نسخته الأولى. وقد حُسبت بمنح المجالات الـ11 أوزانًا متساوية، مع الجمع بين التقييم الثنائي والتقييم المستمر. وهي ليست متوسط نجاح الذكاء الاصطناعي في العمل الفعلي، ولا يمكن تحويلها إلى عدد من الإجابات الصحيحة.
س2: هل تبلغ تكلفة كل مهمة باستخدام Gemini 4 Carbon نحو 16.29 دولارًا فقط؟
لا. مبلغ $16.29 هو متوسط تكلفة تشغيل مهمة التقييم وفق تقرير GDPx، ويتأثر بعدد وحدات Token المستخدمة، وعدد جولات الاستدعاء، والأدوات، وإطار التنفيذ. وهو ليس سعر Google الرسمي. أما السعر التمهيدي المخطط والمعلن لـ Carbon فهو $2 للإدخال و$10 للإخراج لكل مليون Token، لكنه لم يُتح بعد على نطاق واسع للمطورين عمومًا.
س3: هل يمكن الآن استدعاء Gemini 4 Carbon عبر API؟
حتى 2026-11-03، أتاحت Google نموذج Carbon لبعض شركائها في مجال الحماية الأمنية فقط، ولم تعلن بعد موعد إتاحته على نطاق واسع. كما لا يوجد إدخال باسم gemini-4-carbon في وثائق النماذج العامة لدى APIYI على apiyi.com. في الوقت الحالي، يمكنك إعداد عملية التقييم باستخدام النماذج المتاحة مثل Gemini 4 Argon، ثم إضافة Carbon للمقارنة بعد إتاحته.
س4: ما الفرق بين GDPx وGDPval من OpenAI؟
أُطلق GDPval في سبتمبر 2025، ويغطي 9 قطاعات و44 مهنة، ويركز على إنتاج مخرجات نهائية دفعة واحدة اعتمادًا على المواد المقدمة. أما GDPx فيركز على تنفيذ الوكلاء (Agents) لسير عمل طويل في 11 مجالًا عالي القيمة. وتمتد المهمة افتراضيًا إلى 8 ساعات كحد أقصى، مع التركيز على التفاعل مع الأدوات واستكشاف البيئة. وتختلف صعوبة المهام وطرق التقييم بينهما، لذا لا يمكن مقارنة النتائج مباشرةً.
س5: كيف أقارن التكلفة الفعلية لعدة نماذج بسرعة؟
يُنصح بإجراء اختبار على عينة صغيرة من مهام عملك:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API ورصيد اختبار مجاني
2. استخدم الشفرة الكاملة في هذا المقال، واضبط base_url على `https://api.apiyi.com/v1`
3. شغّل كل نموذج مرشح 3 مرات على الأقل، وسجّل استهلاك Token ونتائج التحقق من قبول المخرجات
4. احسب تكلفة كل مخرج مقبول، مع الرجوع أيضًا إلى الخصم الفعلي في لوحة التحكم
س6: ما حدود GDPx نفسه؟
لم يكشف GDPx سوى عن 14 مهمة تمثيلية و168 سجلًا للتنفيذ، فيما أبقى بقية المهام خاصة. وحتى الآن، لم تعِد أي جهة مستقلة إجراء التقييم بالكامل والتحقق من ترتيب النماذج. كما يعكس اختيار المجالات تقدير الجهة البحثية نفسها، وقد أشار باحثون، منهم Ethan Mollick، إلى غياب معيار أداء بشري للمقارنة. وقد تحجب درجة 0% في التقييم الثنائي الفروق بين النماذج في قدرتها على إكمال المهمة جزئيًا. لذا، من الأفضل التعامل مع النتائج بوصفها مرجعًا مهمًا، لا أساسًا نهائيًا لقرار الشراء.
أهم النقاط حول القيمة مقابل التكلفة في GDPx
- الترتيب: تصدّر Opus 5.5 اختبار GDPx v1.0 بنسبة 12.0%، يليه Carbon بنسبة 10.9%، ثم Astra بنسبة 9.6%
- فرق التكلفة: بلغت نتيجة Carbon نحو 90.8% من نتيجة Opus، بينما لم يتجاوز متوسط تكلفة المهمة لديه نحو 31.7% من تكلفة Opus
- اختلاف المقياس: يعبر مقياس $/task في GDPx عن متوسط تكلفة تشغيل التقييم، وليس السعر الرسمي للرموز
- اختلاف المجالات: لا يعني التصدر في الترتيب الإجمالي التفوق في كل مجال؛ فقد تنعكس الفروق في مهمة بعينها مقارنة بالترتيب العام
- قيود الإتاحة: لم يُتح API العام لـ Carbon على نطاق واسع بعد، لذلك لا يمكن اعتباره خيارًا متاحًا فورًا
- طريقة الاختيار: قارن تكلفة كل نتيجة مستوفية للمتطلبات، ويمكنك الاستفادة من الواجهة الموحدة لدى APIYI، عبر apiyi.com، لإجراء مقارنة على عينة صغيرة
الخلاصة
تكشف أول قائمة تصنيف لـ GDPx عن تفاوت واضح في القيمة مقابل التكلفة بين أفضل نماذج الذكاء الاصطناعي:
- القدرات: يتصدر Claude Opus 5.5 التصنيف الإجمالي، لكن لكل نموذج مجالات يتفوق فيها، ولا تزال النماذج بعيدة عن إنجاز المهام عالية المخاطر بشكل مستقل.
- التكلفة: تُظهر المقارنة بين Carbon وOpus، وبين Sol وAstra، أن النتائج المتقاربة قد تخفي فروقًا في التكلفة تصل إلى عدة أضعاف.
- إمكانية الاستخدام: لا يزال استدعاء Carbon مباشرةً صعبًا حاليًا، ومهما بلغت جودة نتائجه في التقييم، فإن جدواه تتوقف على إمكانية استخدامه فعليًا.
يمكن أن يوجّهك GDPx عند اختيار النموذج، لكنه لا يغني عن اختباره في أعمالك الفعلية. والنهج الأكثر أمانًا هو اختيار عدة نماذج من الفئات المتقدمة والمتوازنة والاقتصادية، واختبار كل منها على مهام حقيقية لعدة جولات وفق معايير قبول موحدة، ثم مقارنة تكلفة كل مهمة تُنجز بصورة مقبولة. نوصي باستخدام APIYI عبر apiyi.com لإجراء هذه الاختبارات على نماذج متعددة بمفتاح API واحد، مع الرجوع إلى الأسعار المعروضة لحظيًا في لوحة التحكم.
📚 المراجع
- تقرير SemiAnalysis GDPx الأصلي: منهجية الاختبار ونتائج المجالات وتحليل الحالات
- الرابط:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
ملاحظة: يتضمن النماذج الرائدة في كل مجال وتحليل أنماط الإخفاق
-
لوحة صدارة GDPx الرسمية: النتائج الإجمالية ومتوسط تكلفة المهمة
- الرابط:
gdpx.semianalysis.com -
ملاحظة: مصدر بيانات لوحة الصدارة في هذا المقال، ويمكن الاطلاع على سجلات التنفيذ في صفحة
/rollouts -
إعلان Google عن Gemini 4 Carbon: نطاق الإتاحة وأسعار API المخطط لها
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
ملاحظة: السعر الترويجي والسعر القياسي وقيود الوصول إلى Carbon
-
صفحة أسعار OpenAI API: الأسعار الرسمية لكل Token في سلسلة GPT-6
- الرابط:
developers.openai.com/api/docs/pricing -
ملاحظة: انتبه إلى الأسعار الخاصة بطلبات السياق الطويل
-
جدول أسعار النماذج الشامل لدى APIYI: لقطة للنماذج المدرجة على المنصة وأسعارها
- الرابط:
docs.apiyi.com/models - ملاحظة: لقطة بتاريخ 2026-10-27، وتُعتمد الرسوم الفعلية كما تظهر في لوحة التحكم
الكاتب: الفريق التقني لدى APIYI
للتواصل التقني: يمكنكم التواصل معنا عبر موقع APIYI الرسمي، وزيارة مركز التوثيق على docs.apiyi.com للاطلاع على مزيد من موارد استخدام النماذج