ملاحظة المؤلف: يشرح هذا المقال كيفية إرسال أول طلب إلى Gemini 4 Neon عبر APIYI باستخدام بروتوكوليْن، وما الحقول والسجلات التي ينبغي التحقق منها بعد نجاح الطلب.
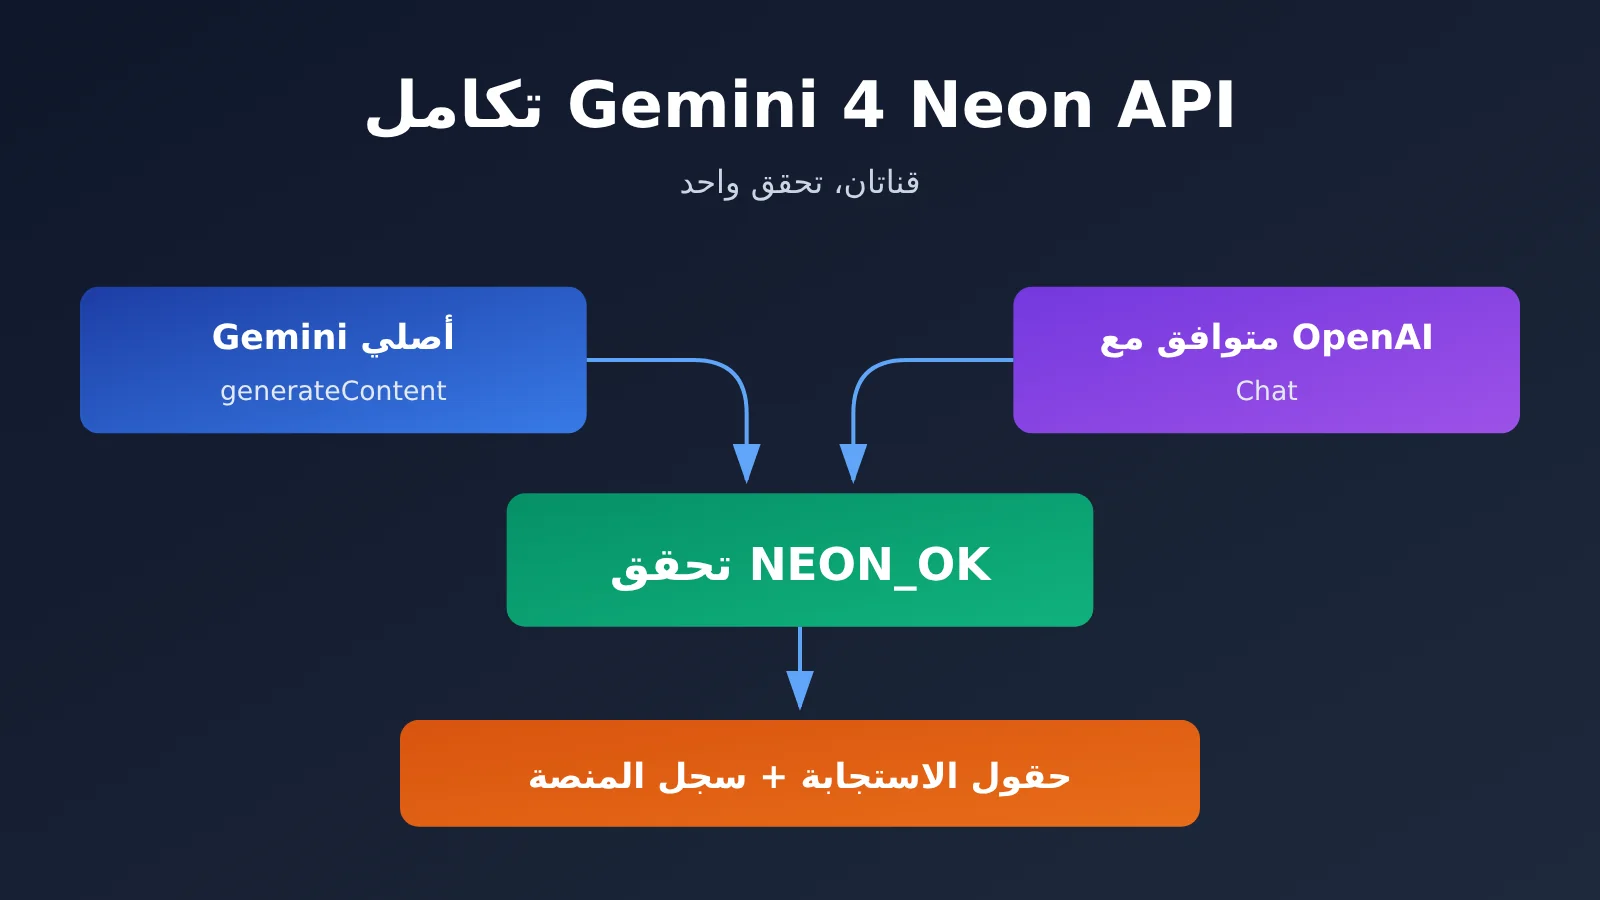
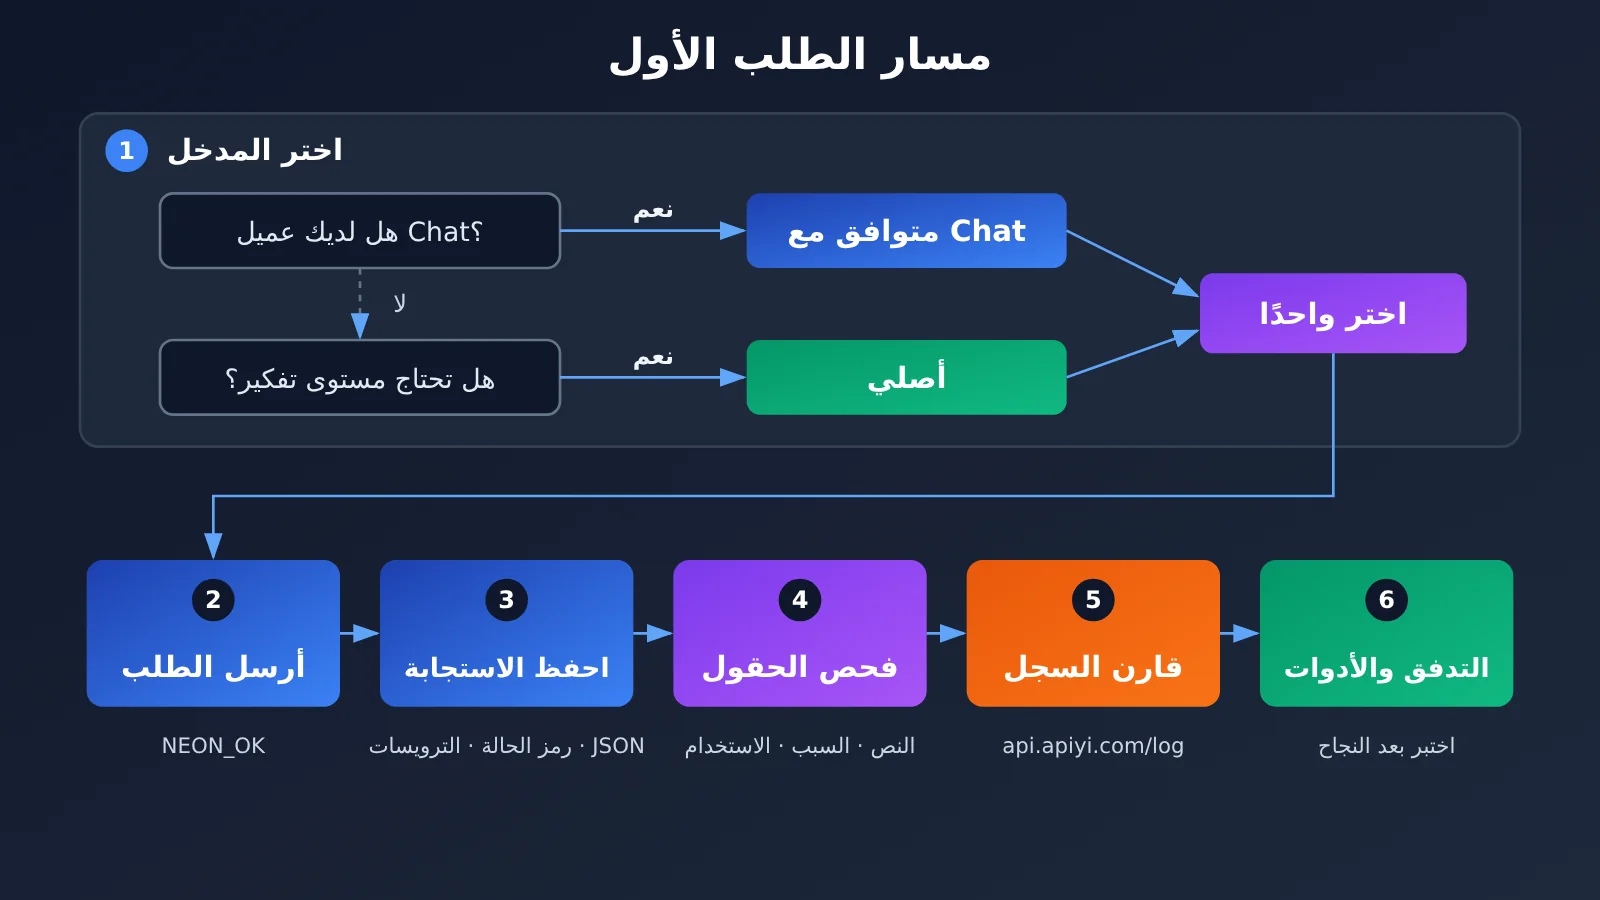
الخلاصة أولاً: إذا كان مشروعك يحتوي بالفعل على عميل OpenAI Chat، فاستخدم مدخل Chat Completions المتوافق مع OpenAI، وكل ما تحتاج إلى تغييره هو base_url واسم النموذج. أما إذا كنت بحاجة إلى ضبط مستوى التفكير في Gemini بشكل صريح، فاستخدم مدخل generateContent الأصلي في Gemini، وحدده داخل generationConfig.thinkingConfig.thinkingLevel. وأياً كان المسار الذي تختاره، ابدأ بتشغيل نص عادي باستخدام الموجه القصير نفسه، ثم نفّذ عملية القبول بناءً على حالة HTTP، وجسم الاستجابة، وسبب التوقف، والاستخدام، وسجلات المنصة. وبعد اجتياز القبول، انتقل إلى اختبار الإخراج المتدفق واستدعاء الأدوات وغيرها من القدرات.
الخلفية كما يلي. أصدرت Google نموذج Gemini 4 Neon في سجل تحديثات AI Studio بتاريخ 18 نوفمبر 2026، وأعلنت توفره العام (GA). وأكد APIYI إدراجه في المنصة عند الساعة 11:45 بتوقيت بكين في 2026-11-20، ويمكن رؤية gemini-4-neon في كتالوج الأسعار العام، والمجموعات المتاحة هي default وsvip. جميع الأمثلة في هذا المقال مكتوبة وفق وثائق APIYI ووثائق SDK، ولم يتم استدعاء أي واجهات مدفوعة، كما لا يتضمن المقال أي إحصاءات من اختبارات فعلية.
خريطة معارف وفهرس لدمج Gemini 4 Neon API
تنقسم عملية الدمج بأكملها إلى ثلاث خطوات: اختيار الواجهة، وإرسال الطلب، والتحقق من المخرجات والسجلات. ومخرجات كل خطوة هي مدخلات الخطوة التالية. ويجمع الجدول التالي بين التسلسل الذي تتبعه هذه الخطوات، وسبب هذا الترتيب، والهدف المطلوب تحقيقه في كل خطوة. ويمكنك اعتباره خريطة معارف أو فهرسًا للقراءة.
| الرقم | الخطوة | ما تقدمه الخطوة السابقة | لماذا هذا الترتيب | هدف هذه الخطوة |
|---|---|---|---|---|
| 1 | اختيار المدخل (1.1 متوافق مع Chat / 1.2 الأصلي ومستوى التفكير) | حزمة الشيفرة الحالية لديك وحاجتك إلى مستويات التفكير | يحدد المدخل عنوان URL وطريقة المصادقة وبنية الحقول، وكل الخطوات اللاحقة تعتمد عليه | تحديد بروتوكول واحد، وعدم تصحيح الأخطاء على المسارين في الوقت نفسه |
| 2 | إرسال الطلب القصير نفسه (2.1 cURL الأصلي / 2.2 Python SDK) | المدخل المحدد وتنسيق الطلب | استخدام موجه قصير ثابت يستبعد فروق قدرات النموذج، ويختبر فقط ما إذا كان المسار يعمل | الحصول على رمز الحالة الكامل ورؤوس الاستجابة وجسم الاستجابة |
| 3 | التحقق (3.1 الحقول / 3.2 الهوية والسجلات / 3.3 توثيق الفشل) | الاستجابة الخام المحفوظة من الخطوة 2 | انظر إلى الاستجابة نفسها أولاً، ثم قارنها بسجلات المنصة؛ فالأدلة تُؤخذ من الأقرب إلى الأبعد | تحديد ما إذا كان «نجاح النص» قائمًا؛ وإن لم يكن، فاترك دليلاً قابلاً للتتبع |
اقتراح للقراءة: إذا كنت تستخدم بروتوكولًا واحدًا فقط، فبعد قراءة القسم الفرعي المقابل في القسم 1، انتقل مباشرة إلى 2.1 أو 2.2، ويجب قراءة القسم 3 كاملًا.
To Know: المصطلحات الضرورية في Gemini 4 Neon API
| المصطلح | شرح موجز |
|---|---|
generateContent |
واجهة التوليد غير المتدفق الأصلية في Gemini، ويُنظّم المحتوى في جسم الطلب باستخدام contents وparts |
thinkingLevel |
حقل مستوى التفكير ضمن generationConfig.thinkingConfig في الواجهة الأصلية، ويأخذ المثال في هذا المقال القيمة high |
| thought part | جزء موسوم في الاستجابة الأصلية بأنه محتوى تفكير، ويجب استبعاده عند تجميع النص الأساسي |
finishReason / finish_reason |
حقل سبب التوقف في الواجهتين الأصلية والمتوافقة على الترتيب |
X-Shellapi-Request-Id |
معرف الطلب الذي تعيده APIYI في رؤوس الاستجابة الخام أو في رسالة الخطأ، ويُستخدم لاستكشاف الأخطاء |
1 اختيار مدخل الوصول إلى Gemini 4 Neon API
يشير المدخلان إلى النموذج نفسه، والفرق بينهما يكمن في شكل البروتوكول والمعاملات التي يمكن التحكم فيها. فيما يلي جدول مقارنة، ثم نشرح في قسمين فرعيين أسباب الاختيار.
| عنصر المقارنة | Chat المتوافق مع OpenAI | Gemini الأصلي |
|---|---|---|
| العنوان | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| مناسب لمن | المشاريع التي لديها بالفعل OpenAI SDK أو عميل Chat | المشاريع التي تحتاج إلى تحكم صريح في معاملات Gemini |
| مستوى التفكير | لا تمرر هذه المقالة المعاملات ذات الصلة | thinkingConfig.thinkingLevel |
| موضع النص الأساسي | choices[0].message.content |
text غير الخاص بالتفكير داخل candidates[0].content.parts |
| معرّف النموذج | model في الاستجابة |
modelVersion في الاستجابة (إن أُعيد) |
1.1 مدخل Gemini 4 Neon المتوافق: الاستمرار في استخدام عميل Chat الحالي
عندما يكون الكود الحالي مبنيًا على OpenAI Python SDK أو أي عميل آخر من Chat Completions، فإن أقل تعديل ممكن هو استبدال base_url بـ https://api.apiyi.com/v1، وكتابة اسم النموذج gemini-4-neon، دون تغيير بنية الرسائل. ميزة هذا الطريق أن كود طبقة الأعمال لا يحتاج تقريبًا إلى أي تعديل، وعند حدوث مشكلة يصبح تحديد ما إذا كانت في الشبكة أو المصادقة أو النموذج أسهل.
هناك عدة حدود يجب توضيحها عند استخدام هذا الطريق. أولًا، لا تمرر reasoning_effort. فطبقة التوافق الخاصة بـ Google تقوم بمقايمة، لكن هذا لا يعني أن مدخل التوافق في APIYI يقدّم التعويض نفسه. ثانيًا، لا تستخدم هذه المقالة واجهة /v1/responses. ثالثًا، الصيغة القديمة thinkingBudget ومستوى minimal خارج نطاق هذه المقالة أيضًا. إذا كنت بحاجة فعلًا إلى التحكم في مستوى التفكير، فانتقل إلى المدخل الأصلي في 1.2.
1.2 مدخل Gemini 4 Neon الأصلي: ضبط مستوى التفكير بشكل صريح
يستخدم المدخل الأصلي بنية الطلب الخاصة بـ Gemini. يتم تمرير مستوى التفكير بشكل صريح عبر generationConfig.thinkingConfig.thinkingLevel، والقيمة المستخدمة في حالة الاستخدام المخصصة في APIYI هي "high". كما تفصل الاستجابة الأصلية محتوى التفكير عن النص الأساسي في parts مختلفة، لذا يجب عند قراءة النص الأساسي التصفية بشكل فعّال، ويقدّم القسم 2.1 الصيغة المحددة.
أما من ناحية المصادقة، فتستخدم حالة الاستخدام الأصلية هذه ترويسة الطلب Authorization: Bearer، ولم تستخدم صيغة معامل key الشائعة في Gemini الرسمية. عند ترحيل كود أصلي موجود، يجب التحقق من هذه النقطة أولًا.
2 إرسال طلب قصير واحد إلى Gemini 4 Neon API
يستخدم البروتوكولان الموجه نفسه: Reply with exactly NEON_OK and nothing else. هذا الموجه يعطي إخراجًا متوقعًا قصيرًا، ويسهل الحكم على النتيجة. إذا لم يكن الناتج NEON_OK، فهذا يعني وجود مشكلة في المسار أو في مرحلة التحليل، ويمكن استبعاد تداخلات مثل «اختلاف أسلوب إجابة النموذج». يُقرأ مفتاح API دائمًا من متغير البيئة APIYI_API_KEY، ولا تكتبه في الشيفرة أو سجل الأوامر.
2.1 cURL الأصلي لـ Gemini 4 Neon واستخراج قيم JSON
يحفظ الأمر التالي رمز حالة HTTP ورؤوس الاستجابة ونص استجابة JSON كلًا على حدة، وستحتاج إلى هذه العناصر الثلاثة جميعًا في التحقق بالقسم 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
عند قراءة النص، يجب جمع كل حقول text غير thought داخل candidates[0].content.parts، ولا يكفي أخذ الجزء الأول فقط. يستخدم المثال التالي jq؛ وإن لم يكن jq مثبتًا، يمكنك استبداله بأي أداة لتحليل JSON:
# النص: دمج حقول text غير thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# سبب التوقف، والاستخدام، وإصدار النموذج (أخرج null عند غياب الحقل، ولا تضف قيمة من عندك)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# معرّف الطلب على المنصة
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 استدعاء Gemini 4 Neon عبر Python OpenAI SDK وقراءة الاستجابة
تستخدم نقطة الدخول المتوافقة with_raw_response، بحيث تحصل على الكائن بعد التحليل وتتمكن أيضًا من قراءة رؤوس الاستجابة الأصلية. ويُستخدم max_retries=0 لإيقاف إعادة المحاولة التلقائية في SDK، حتى لا تُخفي إعادة المحاولة فشلًا واحدًا، ولتجنب ظهور عدة سجلات على المنصة يصعب معها تحديد الطلب المقابل لكل سجل.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # نقطة دخول APIYI المتوافقة مع OpenAI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # تأكد قبل التسجيل من عدم احتوائه على مفاتيح أو معلومات حساسة
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
في هذا الكود نقطة واحدة تحتاج إلى انتباه خاص: عندما تكون choices فارغة، لا تكتب choices[0] مباشرة، وإلا فسيُرفع خطأ فهرسة يخفي المشكلة الحقيقية. وخطأ الاتصال لا يحمل رمز حالة HTTP ولا رؤوس استجابة، لذلك يجب معالجته بشكل منفصل عن APIStatusError.
3 التحقق من أول طلب إلى Gemini 4 Neon API
الهدف من التحقق هو تحديد ما إذا كانت عبارة «نجاح طلب نصي خالص» صحيحة. فمجرد أن تكون استجابة HTTP من فئة 2xx وأن يكون النص المتوقع هو NEON_OK لا يعني إلا أن هذا الطلب النصي قد نجح. ولا يثبت هوية النموذج، ولا ينبغي اعتباره نتيجة اختبار أداء.
3.1 حالة HTTP والنص وسبب التوقف والاستخدام
| بند الفحص | الحقل الأصلي | الحقل المتوافق | شرط النجاح |
|---|---|---|---|
| حالة HTTP | status المحفوظة |
raw.status_code |
2xx |
| النص | دمج text غير الخاص بالتفكير |
choices[0].message.content |
يساوي NEON_OK |
| سبب التوقف | candidates[0].finishReason |
choices[0].finish_reason |
تم تسجيله، ويتطابق مع حالة النص |
| الاستخدام | usageMetadata |
usage |
تم تسجيله، لأجل المقارنة مع السجلات |
إذا لم يكن أحد الحقول موجودًا في الاستجابة، فسجّله على أنه «لم يُرجع»، ولا تستنتج قيمته بناءً على الخبرة. ويجب النظر إلى سبب التوقف مع النص معًا. فإذا كان النص فارغًا ولم يكن سبب التوقف هو الانتهاء الطبيعي، فعادةً ما تكون المشكلة في عملية التوليد نفسها لا في شفرة التحليل.
3.2 ما الذي يمكن أن يوضحه كلٌّ من modelVersion الأصلي وmodel المتوافق والسجلات
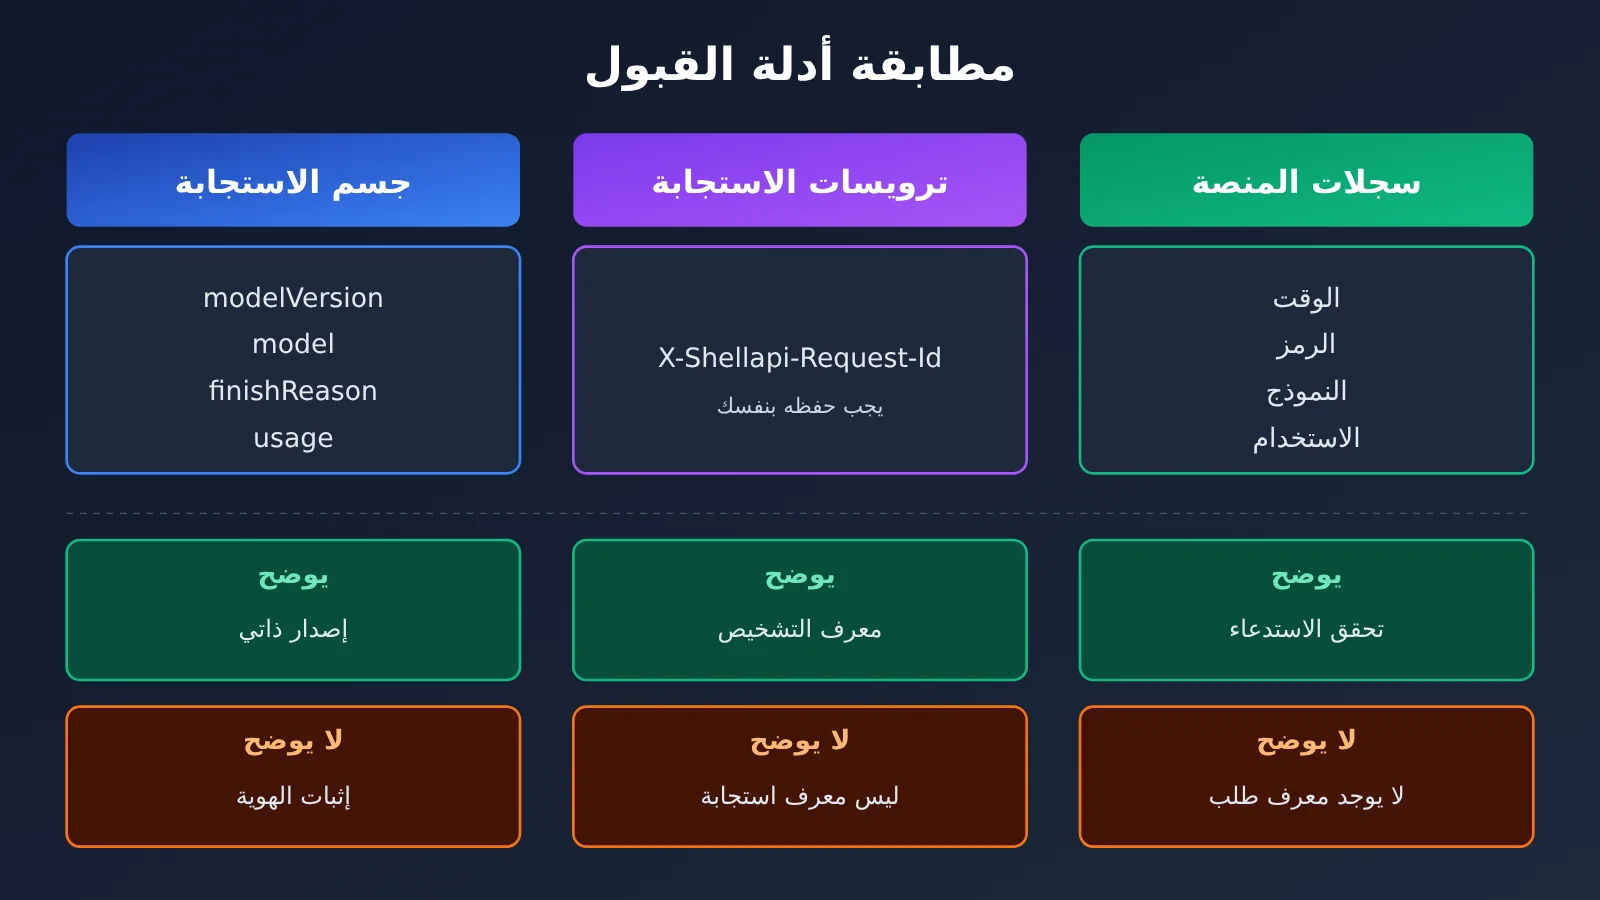
لكل من هذه المعلومات نطاقٌ مختلف لما يمكن أن تُثبته، لذا لا ينبغي أن تُستخدم بدلًا من بعضها البعض عند التسجيل:
| المعلومات | المصدر | ما يمكن أن توضحه | ما لا يمكن أن توضحه |
|---|---|---|---|
modelVersion |
جسم الاستجابة الأصلي (إذا تم إرجاعه) | إصدار النموذج الذي تُصرّح به الاستجابة نفسها | لا يصلح وحده كدليل على الهوية |
model |
جسم الاستجابة المتوافق | اسم النموذج الذي تُصرّح به الاستجابة نفسها | كما في الحالة السابقة |
| سجلات المنصة | api.apiyi.com/log |
مطابقة هذا الاستدعاء حسب الوقت والرمز والنموذج والاستخدام | وحدة التحكم لا تعرض معرّف الطلب |
X-Shellapi-Request-Id |
رأس الاستجابة الأصلي أو رسالة الخطأ | معرّف الطلب المستخدم عند استكشاف أخطاء المنصة | ليس هو responseId ولا id الخاص بـ Chat، ولا _request_id الخاص بـ SDK |
عند مطابقة السجلات، استخدم وقت إرسال الطلب والرمز المستخدم واسم النموذج gemini-4-neon وأرقام الاستخدام للمطابقة. وبما أن وحدة التحكم لا تعرض معرّف الطلب، فإن X-Shellapi-Request-Id يجب أن تحفظه بنفسك من رؤوس الاستجابة، إذ لا يمكن العثور عليه لاحقًا في وحدة التحكم.
3.3 كيف توثّق الأدلة مع Gemini 4 Neon عند غياب نص الاستجابة أو فشل الطلب
عندما يفشل الطلب أو لا تحصل على نص استجابة، لا تعِد المحاولة فورًا، بل احفظ الأدلة بالترتيب التالي:
- احفظ رمز حالة HTTP. وإذا كان الخطأ في الاتصال، فسجّل نوع الاستثناء.
- احفظ ترويسات الاستجابة الأصلية، واستخرج منها
X-Shellapi-Request-Id. - احفظ جسم الاستجابة الأصلي أو رسالة الخطأ، بعد إزالة البيانات الحساسة مثل مفتاح API.
- سجّل سبب التوقف وبيانات الاستخدام (إن وُجدت)، إضافةً إلى وقت إرسال الطلب واسم الرمز المميز المستخدم واسم النموذج.
- اذهب إلى
api.apiyi.com/logوابحث عن السجل المطابق حسب الوقت والرمز المميز، ثم قارن المواد التي جمعتها أعلاه مع وثائق استكشاف أخطاء معرّف الطلب على المنصة.
هناك نقطة أخرى يجب الانتباه إليها في الاستجابة الأصلية. إذا كان parts يحتوي على محتوى thought فقط، فسيكون النص بعد التصفية فارغًا. في هذه الحالة يجب أن تسجّل بصدق أن “النص بعد التصفية فارغ”، ولا تحوّل محتوى thought إلى نص استجابة لمجرد الحصول على مخرجات.
بعد أن ينجح التحقق من طلب نصي بسيط في جولة واحدة بالطريقة أعلاه، يمكنك بعد ذلك اختبار الإخراج المتدفق واستدعاء الأدوات وغيرها من القدرات حسب احتياجات المشروع. ومع كل قدرة تضيفها، تحقق منها منفصلةً بالطريقة نفسها: “الطلب نفسه، حفظ الاستجابة الأصلية، ومقارنة السجلات”. هذا المقال لا يتناول معايير التقييم ولا الأسعار، وللحصول على هذه المعلومات يُرجى الرجوع إلى الإعلانات الرسمية والكتالوج العام على APIYI.
مراجع
- سجل تحديثات Google AI Studio (2026-11-18):
aistudio.google.com/docs/changelog - بنية Gemini GenerateContentResponse:
aistudio.google.com/api-reference/generate-content - إعلان إطلاق Gemini 4 Neon على APIYI مع أمثلة البروتوكولين:
docs.apiyi.com/news/gemini-4-neon-launch.md - معالجة استجابات Gemini على APIYI:
docs.apiyi.com/api-capabilities/gemini/response-handling - معالجة الاستجابات المتوافقة مع OpenAI على APIYI:
docs.apiyi.com/api-capabilities/openai/response-handling - استكشاف أخطاء معرّف الطلب على APIYI:
docs.apiyi.com/faq/request-id-troubleshooting - الوصول إلى الاستجابة الأصلية في openai-python:
github.com/openai/openai-python
رحلة الألف ميل تبدأ بخطوة واحدة. — 《تاو تي تشينغ》