作者注:模型“变笨了”不一定是模型被替换。本文从 Anthropic 最新的 FlashProve 推理证明研究出发,把影响 API 调用效果的因素整理成一套从调用方到服务端的排查顺序。
“同一道题,官网能做出来,换成 API 调用就卡住了”,“这个月模型明显变笨了”,类似的抱怨几乎每个通过 API 接入大模型的开发者都遇到过。很多人的第一反应是:后台是不是把模型换了?
近期 Anthropic 发布了开源研究原型 FlashProve,尝试用密码学证明来核验“这次输出是否真的来自某套指定权重”。这让“模型有没有被掉包”第一次有了可以数学验证的方向。
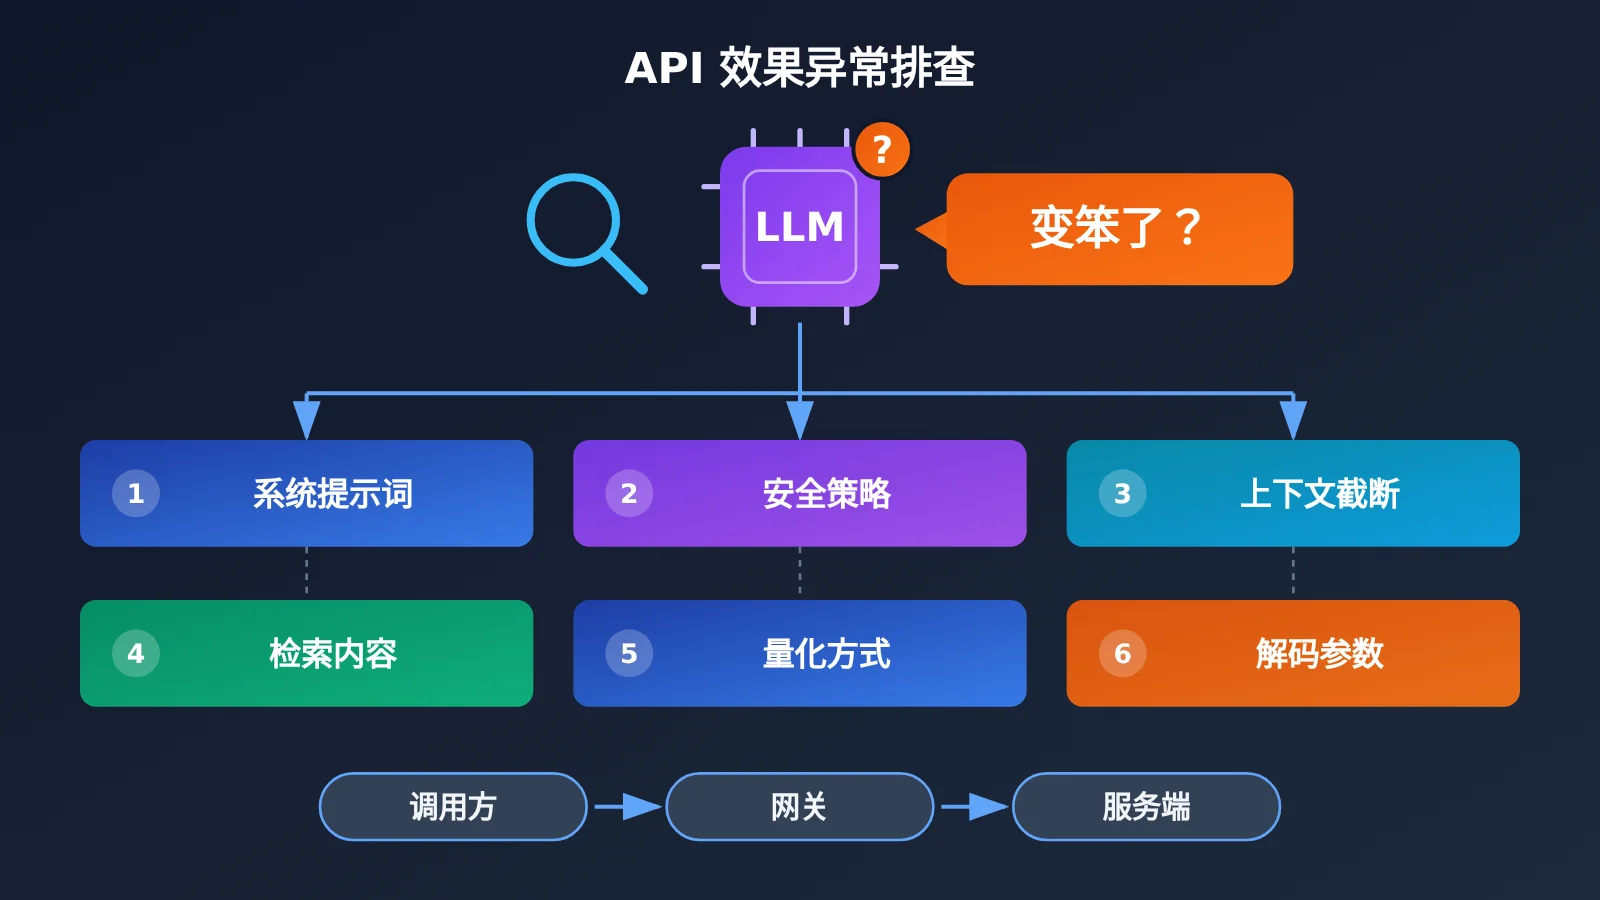
但这不是“降智”问题的终点。研究报道里明确指出:即使权重身份已经确认,系统提示词、安全策略、上下文截断、检索内容、量化方式和解码参数,依然都会影响最终效果。Kimi 团队的排查经验也显示,相当一部分跑分异常其实来自解码参数误用。
核心价值:读完本文,你会得到一份模型变笨了时的排查清单,知道哪些问题自己就能查,哪些需要服务商配合,以及为什么“问几个问题鉴别模型”并不可靠。
模型变笨了排查:核心信息速览
先把这次讨论的背景信息梳理清楚。引发讨论的是 Anthropic 关于“可证明推理”的研究,而它在社区引出的核心问题,正是模型变笨了到底该怪谁。
| 信息项 | 详情 |
|---|---|
| 发布方 | Anthropic 研究团队,同时公开代码、技术报告和 Lean 形式化证明 |
| 核心内容 | FlashProve:基于 zkSNARK 零知识简洁证明,为模型推理生成密码学证明 |
| 解决的问题 | 不公开权重、不需要用户重跑模型,也能核验输出是否来自指定权重 |
| 解决不了的问题 | 系统提示词、安全策略、上下文、解码参数等产品层面的变化 |
| 对开发者的启示 | 模型效果异常要分层排查,不能只盯着“是否被替换” |
FlashProve 如何证明“你就是你”
FlashProve 的思路分两步。首先,服务商为模型权重生成一个“承诺”,相当于一组能唯一锁定权重的密码学指纹,但不会暴露权重本身。随后,服务商针对给定的输入和输出生成一份证明,用户拿到承诺、提示词、回答和证明文件,就能在自己电脑上核验这段输出是否确实由被锁定的权重计算得出。
零知识的设计保证了验证者不会因此拿到权重、中间计算值,也看不到 MoE 模型每层调用了哪些专家。这比“让模型自报家门”可靠得多,因为回答里写的模型名字不再充当身份证明,被检查的是输出与权重之间的计算关系。
Anthropic 用公开 4-bit 权重的 Llama 4 Maverick 做了实验,这是一个约 4000 亿参数、每个 token 激活约 170 亿参数的混合专家模型。公布的关键数据如下:
| 指标 | 实验数据 | 说明 |
|---|---|---|
| 证明生成吞吐 | 单张 H100 约 110 tokens/秒 | 是证明生成速度,不是聊天输出速度 |
| 证明文件大小 | 每个 1,024-token 请求约 19 MB | 需要随响应一起传递 |
| 验证耗时 | 24 线程 CPU 约 17 秒 | 验证不需要 GPU,笔记本即可完成 |
| 权重承诺生成 | 约 39 分钟 | 只需生成一次 |
| 额外成本 | GPU 时间约为普通 vLLM 推理的 70~95 倍 | 距离大规模普及仍有距离 |
为什么确认了权重,模型变笨了仍然可能发生
FlashProve 有一个关键前提:用户必须提前知道“正品模型”的承诺是什么。如果服务方只能证明回答来自它自己选的某个模型,而用户无法确认这个模型就是自己购买的那个,证明依然解决不了身份问题。理想状态是由模型厂商或可信机构公开发布承诺,用户固定核验这个指纹。
更重要的是,权重没变不等于服务没变。一份绑定权重的证明,并不能自动回答系统提示词有没有调整、上下文有没有被截断、解码参数是否一致等问题。这正是模型变笨了这类抱怨长期存在的原因:它往往是多个环节叠加的结果。
模型变笨了的 6 类常见原因
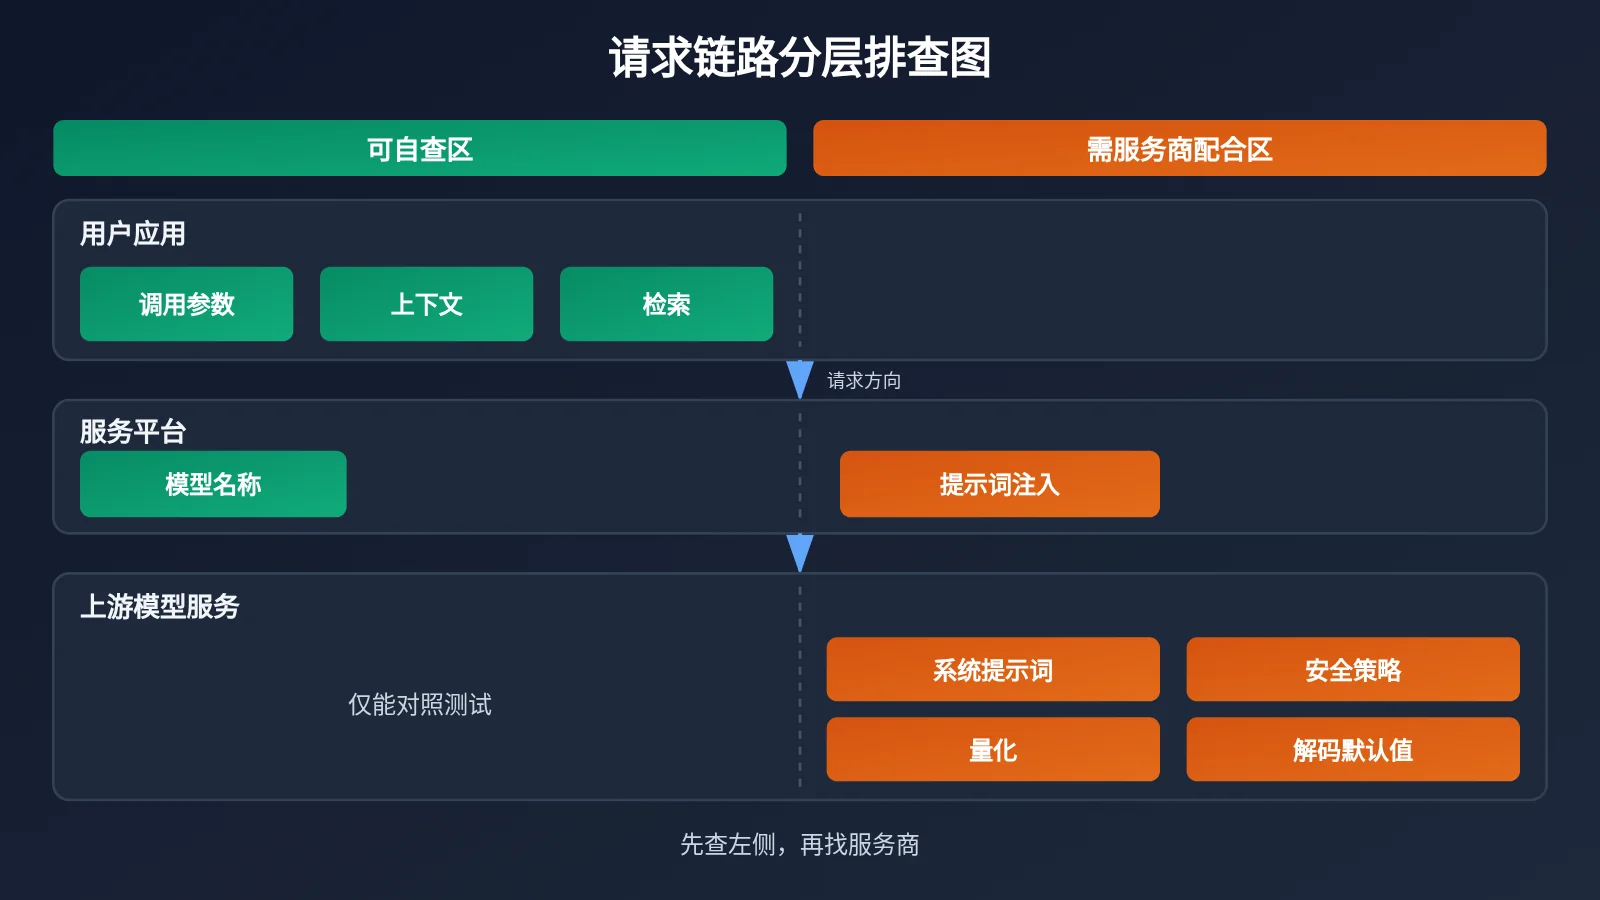
把参考研究中列出的影响因素逐一拆开,再按“问题可能出在哪一侧”归类,会发现相当一部分问题其实在调用方自己手里。
| 影响因素 | 典型表现 | 可能发生在哪一侧 | 用户能否自查 |
|---|---|---|---|
| 解码参数 | 输出发散、重复、推理模式跑分偏低 | 调用方为主,服务端也可能设默认值 | 能,核对请求参数 |
| 上下文截断 | 前文“失忆”、回答不完整、指令被忽略 | 调用方和服务端都可能 | 部分能,核对 token 用量 |
| 系统提示词 | 风格变化、拒答增多、格式不对 | 调用方或服务端注入 | 能查自己的,查不到服务端的 |
| 安全策略 | 某类问题突然被拒绝或回答变保守 | 服务端为主 | 较难,需要服务商说明 |
| 检索内容 | RAG 场景回答质量波动 | 调用方的检索链路 | 能,检查召回内容 |
| 量化方式 | 整体能力轻微下降、长推理出错率上升 | 服务端部署侧 | 不能,需要服务商配合 |
解码参数误用:模型变笨了最容易被忽视的原因
Kimi 团队在介绍 Kimi Vendor Verifier 时分享过一个很有代表性的发现:自 K2 Thinking 发布后,他们收到不少社区关于跑分异常的反馈,调查后确认其中相当一部分来自解码参数误用。团队随后在 Thinking 模式下对相关参数做了约束,并检查思考内容是否被正确传回。
这对普通开发者的启示很直接:temperature、top_p、max_tokens、推理模式开关等参数一旦和官方推荐不一致,模型表现就可能明显偏离预期。尤其是推理类模型,不同厂商对采样参数、思考预算、多轮对话中思考内容的回传方式都有各自要求,具体数值请以各模型官方文档为准,而不是沿用普通对话模型的习惯配置。
上下文没传完整:看起来像“失忆”的模型变笨了
另一类高频问题是上下文。多轮对话里如果只传了最新一句,模型自然“记不住”前文;工作流里如果历史消息超过了模型窗口,被截断的往往是最早的系统指令,结果就是模型突然不按格式输出。此外,max_tokens 设置过小会让回答在中途被截断,表现为“答一半就停了”。
这些问题都会被体感归结为模型变笨了,但只要检查请求体和响应中的结束原因,大多数时候能当场定位。
模型变笨了如何排查:3 步排查顺序
既然原因分布在调用链的不同位置,排查就应该从成本最低、最可控的环节开始。建议按下面的顺序推进:
- 先查调用方:核对 model 名称、解码参数、max_tokens、系统提示词、完整消息列表,以及 RAG 召回的内容是否正确。
- 再做对照测试:固定参数和提示词,与官方渠道或官方文档描述的表现对比,多次运行观察分布而不是单次结果。
- 最后判断服务端:如果调用方配置无误且对照差异稳定可复现,再带着请求记录和测试结果联系服务商。
极简示例:固定参数做一次可复现调用
第一步最实用的做法,是把参数全部显式写出来,避免依赖任何默认值,并打印结束原因和 token 用量:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 换成你要排查的模型名
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
如果 finish_reason 是 length,说明回答被 max_tokens 截断了,这时“答不完整”就不是模型变笨了,而是参数设置问题。usage 中的输入 token 数则可以帮你确认上下文是否真的完整传了过去。
查看完整对照测试脚本
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 切换模型只需修改 model 参数
)

# 显式写出所有参数,避免依赖默认值
PARAMS = {
    "temperature": 0.2,   # 推理模型请按官方文档推荐值设置
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """同一用例多次运行,统计命中率、截断次数和 token 用量"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # 替换为待排查模型
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
这个脚本的关键不在测试题本身,而在于三点:参数全部固定并随报告输出,同一用例多次运行看命中率,记录 finish_reason 和 prompt_tokens 来排除截断和上下文问题。只有这三项都排除后,才值得进入“服务端是否有变化”的讨论。
🚀 排查建议:API易 apiyi.com 采用 OpenAI 兼容接口,切换模型只需改 model 参数,便于用同一套测试脚本横向对比多个模型;平台提供调用日志和用量统计,可以用来回看请求消耗和 token 用量,辅助判断上下文是否完整传入。具体日志展示哪些字段,建议以平台控制台实际页面为准。
用户自查与服务商配合的分工
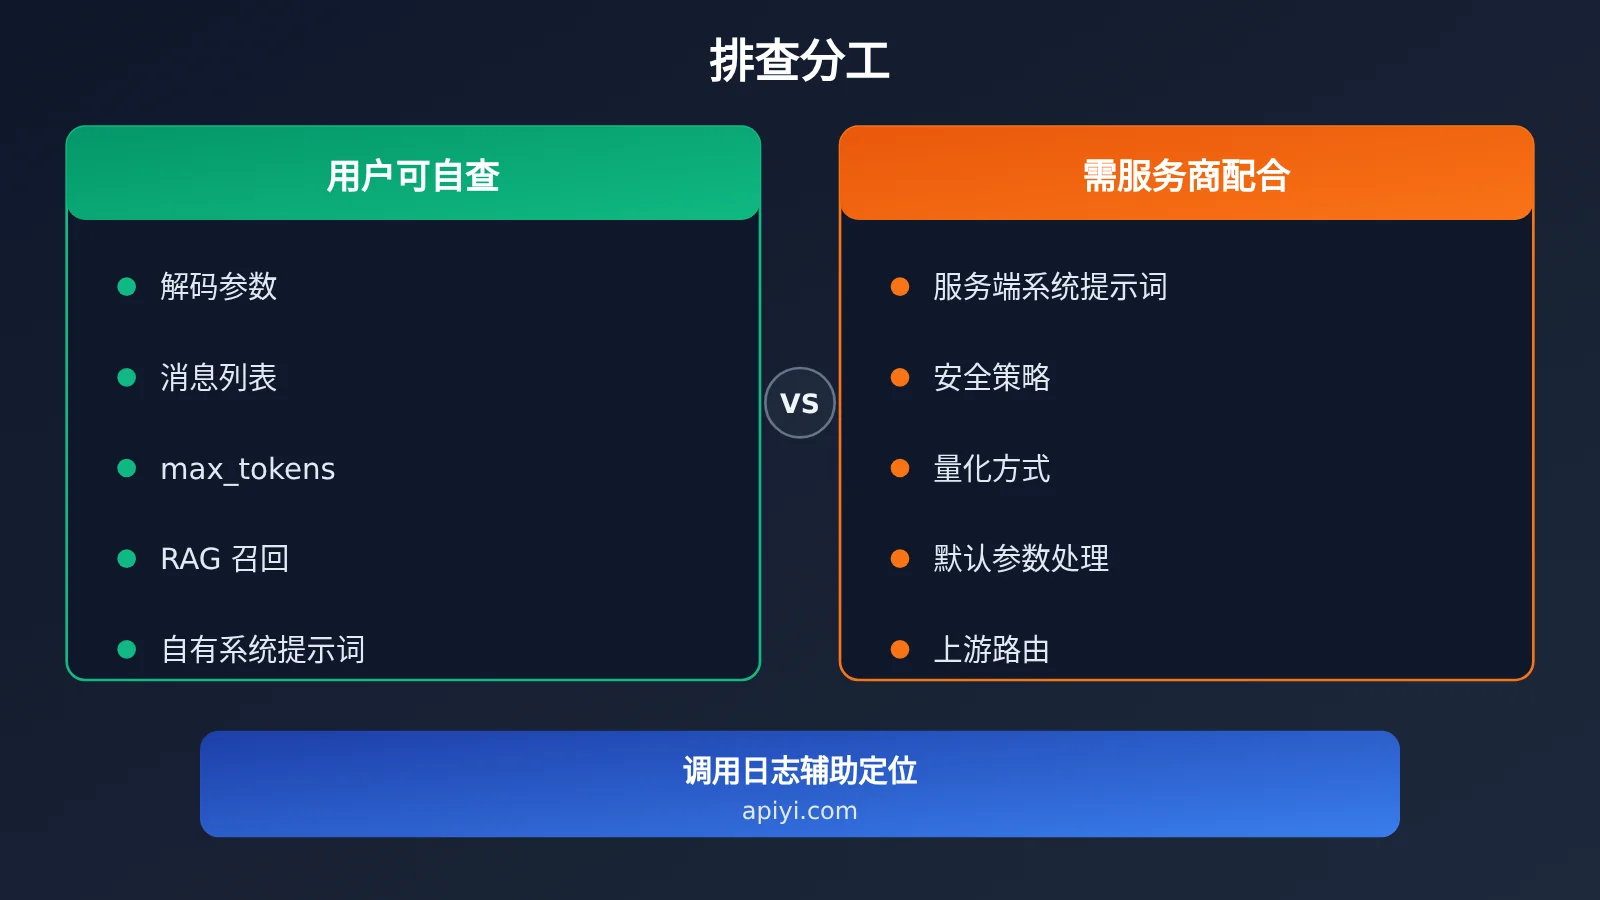
| 排查项 | 用户自查方法 | 需要服务商提供的信息 |
|---|---|---|
| 解码参数 | 打印完整请求体,对照官方文档 | 平台是否对参数做改写或补默认值 |
| 上下文完整性 | 检查消息列表与 prompt_tokens | 是否存在服务端截断或窗口限制 |
| 推理模式 | 核对思考开关和思考内容回传方式 | 上游是否支持对应参数 |
| 量化与部署 | 无法自查 | 部署精度、上游渠道说明 |
| 安全策略 | 对比同一请求在官方渠道的表现 | 是否叠加了额外审核规则 |
找服务商时,带上固定参数的请求样本、多次运行的统计结果和对照数据,沟通效率会高很多。单纯一句“模型变笨了”,对方很难定位问题。
为什么“问几个问题鉴别模型”判断模型变笨了并不可靠
社区里流行一种鉴别方法:问模型一个只有新版本才知道的知识点,答不上来就判定“被换了”。这种方法的问题在于,单次回答本身带有随机性,碰巧答错、参数不同、上下文缺失、厂商内部路由差异,最后都会表现为同一句“这不是我要的模型”。
斯坦福大学的研究项目 Model Equality Testing 提供了一个更严谨的视角:研究者测试了 2024 年四款 Llama 模型的 31 个商业 API 端点,发现其中 11 个端点的输出分布与 Meta 发布权重的参考分布存在统计差异。注意这里的方法是比较输出“分布”,而不是看一两个问题的对错。
对开发者来说,可借鉴的是统计思路:用固定参数、多个用例、多次运行去观察稳定差异。这也是上面对照脚本采用“命中率”而不是“单次结果”的原因。
模型变笨了现象的影响分析
对开发者的影响
- 排查习惯要前移:遇到效果异常先检查自己的请求体,参数误用和上下文缺失是成本最低、命中率最高的排查方向。
- 参数要显式化:生产环境中不要依赖任何默认值,推理模型尤其要按官方文档配置,并把参数纳入版本管理。
- 建立回归测试集:维护一组固定用例定期跑,模型变笨了时能拿出数据而不是体感。
- 保留调用记录:请求参数、token 用量、结束原因都是与服务商沟通时的关键证据。
对行业的影响
- 验证从体感走向证明:FlashProve 展示了“权重身份可验证”的方向,未来模型厂商、评测机构和监管方都可能用它确认实际服务的模型。
- 透明度要求会扩展:权重之外,系统提示词、解码策略、部署配置是否一致,会成为下一阶段的讨论焦点。
- 普及仍需时间:证明成本约为普通推理的数十倍,还需要更长上下文支持和可信的承诺发布机制,短期内难以覆盖日常调用。
常见问题 FAQ
Q1: 模型变笨了,最先应该检查什么?
先检查自己的请求:model 名称是否正确、temperature 等解码参数是否符合官方推荐、max_tokens 是否过小、多轮对话的历史消息是否完整传入。Kimi 团队的经验表明,相当一部分跑分异常来自解码参数误用,这一步往往最先见效。
Q2: FlashProve 能彻底解决模型变笨了的争议吗?
不能。它能核验输出是否来自指定权重,但前提是有可信的模型承诺可供对照。系统提示词、安全策略、上下文截断、量化方式、解码参数这些因素,并不在一份权重证明的自动覆盖范围内。
Q3: 如何做一次可信的对照测试?
固定全部参数和提示词,准备多个有明确答案的用例,每个用例运行多次统计命中率,同时记录 finish_reason 和 token 用量。通过 API易 apiyi.com 可以用同一套 OpenAI 兼容代码对多个模型做横向测试,新用户有免费测试额度可用于这类验证。
Q4: 推理模型在 API 中表现不如网页版,可能是什么原因?
常见原因包括思考模式未开启或思考预算设置不同、采样参数与官方推荐不一致、多轮对话中思考内容的回传方式不对,以及网页版自带的系统提示词和工具在 API 中并不存在。建议逐项对照该模型官方文档的 API 说明。
Q5: 自查无误后,怎样和服务商沟通?
准备好固定参数的请求样本、多次运行的统计结果、与官方渠道的对照数据,以及出现异常的时间段。在 API易 apiyi.com 控制台可以查看调用日志和用量统计,把对应记录一并提供,能显著缩短定位时间。
模型变笨了排查核心要点 Key Takeaways
- 模型变笨了未必是被替换:系统提示词、上下文、解码参数等都会改变效果。
- 参数误用很常见:Kimi 团队确认相当一部分跑分异常源于解码参数误用。
- 排查要分层推进:先查调用方,再做对照测试,最后判断服务端问题。
- 单题鉴别不可靠:应比较多次运行的输出分布,而不是看一两个答案。
- 权重证明有边界:FlashProve 只验证权重身份,覆盖不了产品层配置变化。
- 测试工具要统一:可借助 API易 apiyi.com 的兼容接口和日志做横向对比。
总结
模型变笨了这类问题,过去主要靠截图和体感争论。Anthropic 的 FlashProve 为“是否被掉包”提供了可验证的方向,但它同样提醒我们:权重之外,还有一整层会影响效果的配置。
- 先自查:解码参数、max_tokens、消息列表和 RAG 召回内容,是成本最低的排查起点。
- 再对照:用固定参数、多用例、多次运行的方式与官方表现对比,用数据代替感觉。
- 最后沟通:确认调用方无误后,带着请求记录和统计结果找服务商定位服务端问题。
建议把本文的对照脚本纳入日常回归测试,推荐通过 API易 apiyi.com 用同一套代码快速验证多个模型的表现,平台提供免费测试额度和统一的 OpenAI 兼容接口。
📚 参考资料
- 36氪 / APPSO – Anthropic 可证明推理研究解读:FlashProve 原理、实验数据及“降智”成因讨论
- 链接:
36kr.com/p/4056019887510401 -
说明: 本文事实数据的主要来源,包含 Kimi Vendor Verifier 与 Model Equality Testing 的相关介绍
-
Anthropic Research – Provable Inference:FlashProve 官方研究页面
- 链接:
anthropic.com/research/provable-inference - 说明: 可查阅技术报告、开源代码与形式化证明
作者: APIYI 技术团队
技术交流: 排查调用效果异常遇到问题,欢迎通过 API易 apiyi.com 网站首页联系我们,更多接入说明可访问 docs.apiyi.com 文档中心