作者注:从输入、输出、推理、缓存、重试到校验升级,用 7 个步骤把“每百万 token 多少钱”换算成“每完成一次任务多少钱”。
很多团队选模型时,第一眼看的是价格表上的输入和输出单价,然后得出“这个便宜一半”的结论。上线一个月后账单出来,却发现便宜的模型并没有省钱,有时还更贵。本文介绍一套 以“单次被接受的任务”为单位的成本估算方法,帮助你看清 token 单价之外的那部分开销。
这不是一篇劝你买贵模型的文章,便宜的模型在很多场景下确实更划算。问题在于,只有把重试、推理 token、缓存和人工校验都算进去,才能判断它到底划不划算。
核心价值:读完本文,你会得到一张可复用的任务成本工作表,知道该收集哪些数据、怎么套公式,以及哪些环节最容易被漏算。
任务完整成本 核心要点
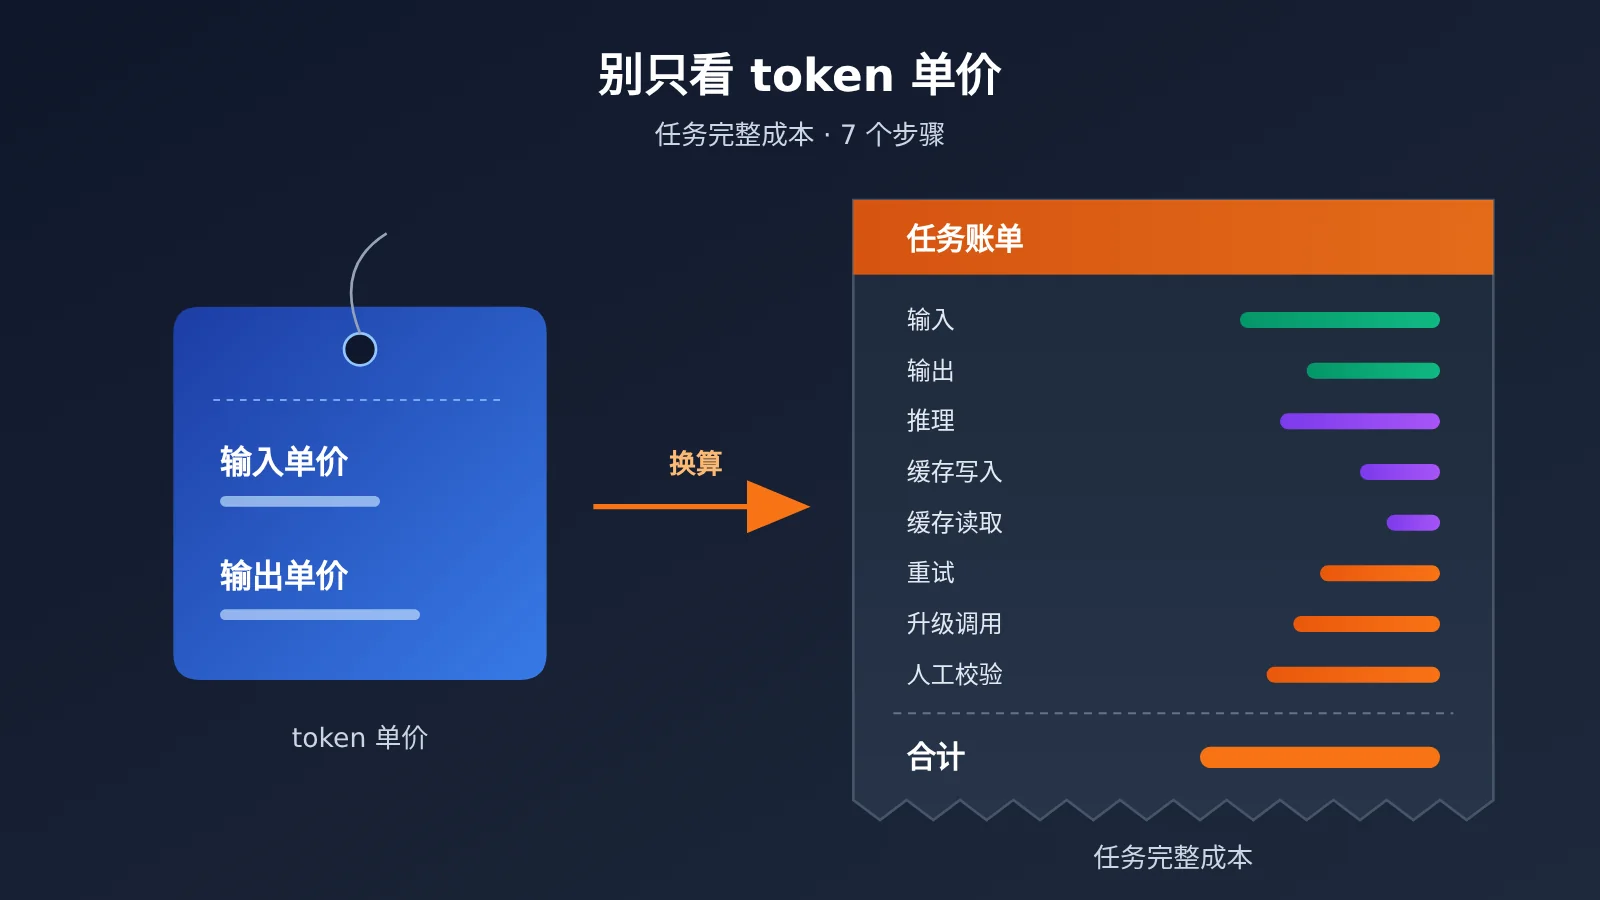
估算任务完整成本,首先要承认一个事实:价格表给的是“原材料单价”,而你真正关心的是“成品单价”。一次任务往往由多次调用、多类 token 和若干非模型开销组成,下表列出最常见的成本项。
| 成本项 | 说明 | 容易被漏算的原因 |
|---|---|---|
| 普通输入 token | 系统提示词、用户输入、检索上下文、历史对话 | 多轮对话中历史会反复计入 |
| 输出 token | 模型最终返回的可见内容 | 结构化输出常比预期更长 |
| 推理 token | 推理类模型内部思考消耗,通常按输出计费 | 用户看不到,但账单上会出现 |
| 缓存写入与读取 | 重复前缀的缓存创建与命中 | 写入和读取计价口径与普通输入不同 |
| 重试调用 | 超时、格式错误、校验失败后的重新请求 | 测试时很少出现,上线后成规模出现 |
| 升级调用 | 小模型失败后转交给更强模型 | 路由策略会叠加两次调用费用 |
| 长上下文阶梯 | 超过某个上下文阈值后单价变化 | 只在少量长输入请求上触发,容易忽略 |
| 人工校验成本 | 结果需要人检查或返工 | 不在 API 账单里,但真实存在 |
任务完整成本重点详解:为什么单价会误导
第一个误导来自推理 token。推理类模型在给出答案前会消耗一段内部思考,这部分通常按输出单价计费,而且长度会随推理强度设置变化。公开讨论中,有不少文章专门对比同一模型 high 和 xhigh 两档推理强度,结论都指向同一点:多出来的推理是否值得,要看任务通过率提升了多少,而不是只看单价是否相同。
第二个误导来自“格式正确不等于结果正确”。做文本抽取时,模型返回一段合法 JSON 很容易,但字段值是否真的来自原文、有没有张冠李戴,需要额外校验。如果一个便宜模型的抽取结果有较高比例需要人工返工,那它在 API 账单上省下的钱,很可能会在人工成本上加倍还回去。
第三个误导来自厂商的宣传口径。有模型发布时会同时宣布 token 单价下调和“任务成本下降”,但这两者并不等价。任务成本下降可能来自更少的输出长度、更少的重试,也可能依赖特定的缓存用法,你的工作负载未必能复现同样的比例。
如何估算一次任务的完整成本 快速上手
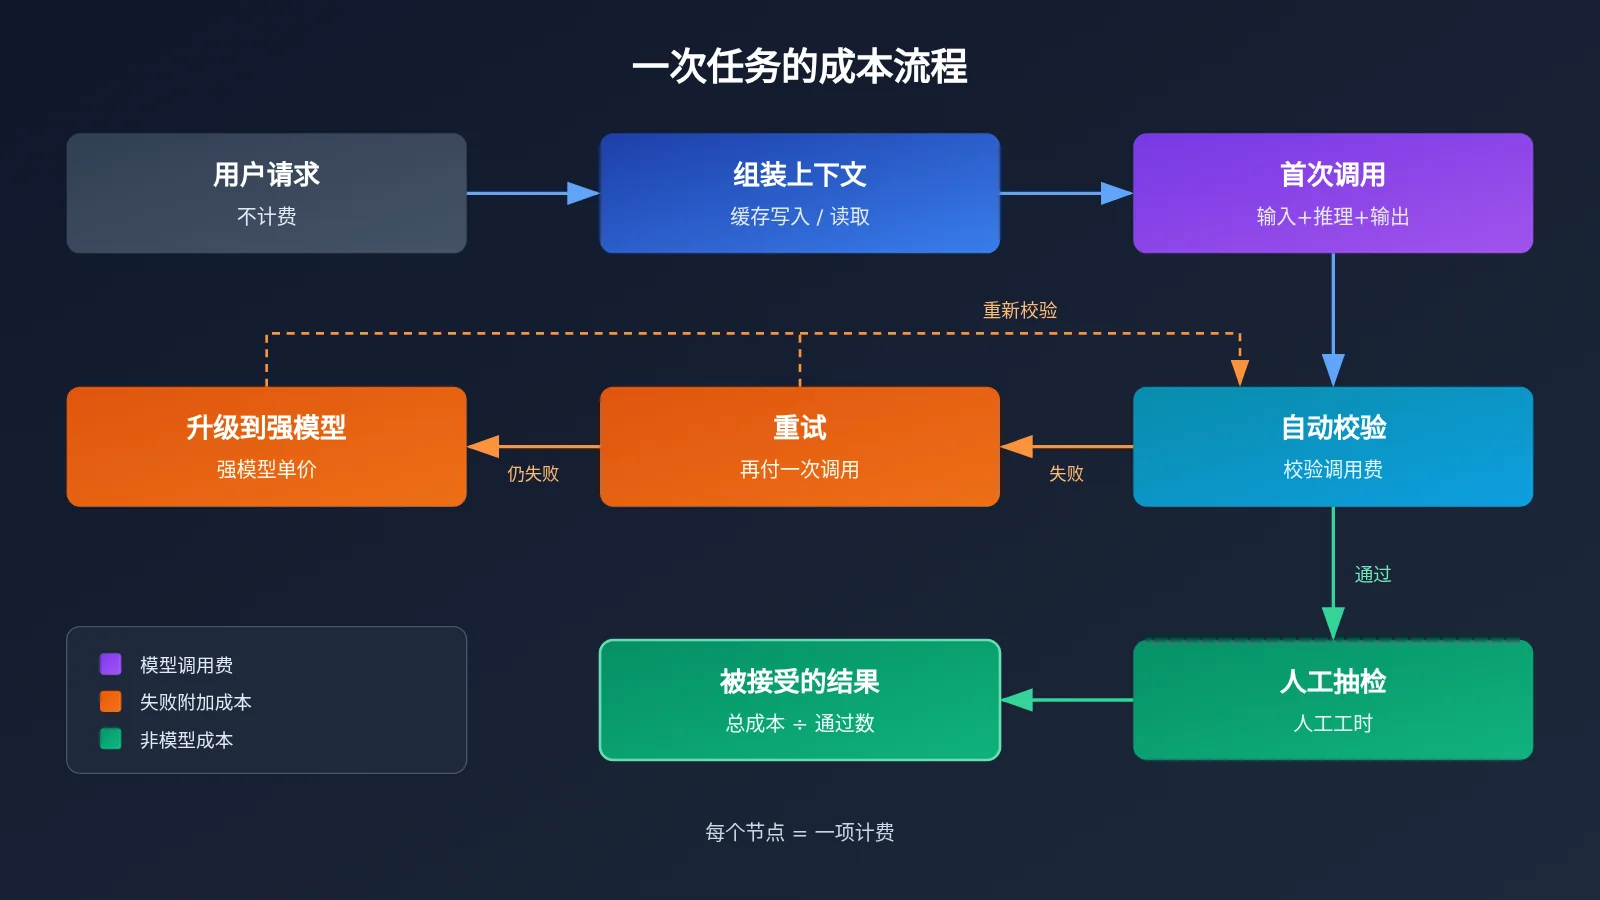
下面这套流程不需要写代码,用一张电子表格就能完成。核心思路是先算出单次调用的 token 结构,再乘上各类概率,最后除以被接受的结果数。
任务完整成本估算的 7 个步骤
- 定义“一次任务”的边界:例如“处理一张工单并输出可入库的结构化字段”,而不是“调用一次接口”。边界不同,成本口径完全不同。
- 拆分单次调用的 token 结构:分别记录系统提示词、检索上下文、用户输入、可见输出和推理 token 的平均长度,最好用 P50 和 P95 两个值。
- 标注可缓存的部分:固定的系统提示词、工具定义、少样本示例通常可以走缓存,记录缓存写入频率和预估命中率。
- 查清计费口径:输入、输出、缓存写入、缓存读取的单价,以及是否存在长上下文阶梯。所有单价以 API易 价格页 docs.apiyi.com/models 的实际数据为准。
- 用真实样本测出失败率:至少跑一批有代表性的样本,统计格式失败、校验失败、超时的比例,换算成重试率和升级率。
- 加上非模型成本:人工抽检比例、单条校验耗时,必要时折算为金额。
- 计算“每个被接受结果”的成本:总成本除以通过最终验收的结果数,这才是能拿来比较模型的指标。
任务完整成本工作表字段
把上面的步骤落到表格里,建议至少包含以下字段。字段命名可以按团队习惯调整,关键是每一项都有数据来源。
| 字段 | 含义 | 数据来源 |
|---|---|---|
in_cached |
命中缓存的输入 token 数 | 调用日志中的 usage 字段 |
in_uncached |
未命中缓存的普通输入 token 数 | 调用日志 |
cache_write |
本次写入缓存的 token 数 | 调用日志 |
out_visible |
可见输出 token 数 | 调用日志 |
out_reasoning |
推理 token 数 | 调用日志(推理模型才有) |
retry_rate |
需要重试的比例 | 样本测试统计 |
escalate_rate |
需要升级到强模型的比例 | 路由策略日志 |
accept_rate |
最终被接受的比例 | 自动校验加人工抽检 |
| 各项单价 | 输入、输出、缓存写入、缓存读取单价 | API易 价格页实际数据 |
🚀 快速上手建议:如果你要同时对比多个模型的任务成本,建议在 API易 apiyi.com 上用同一批样本分别跑一遍。平台提供本文涉及的主流模型 API 调用,兼容 OpenAI 与 Anthropic 两种接口格式,切换模型时只需改模型名,便于在同一张工作表里对比。接入方式和 base_url 请以 API易 文档 docs.apiyi.com 为准。
任务完整成本计算示例
下面用一个工单字段抽取任务做演示。为了避免使用未经核实的价格数字,示例只给出 token 量和公式,单价请填入 API易 价格页 docs.apiyi.com/models 上对应模型的实际数据。
| 环节 | token 构成(平均值) | 发生概率 | 成本公式 |
|---|---|---|---|
| 首次调用 | 缓存命中 6,000 + 普通输入 2,000 + 可见输出 800 + 推理 1,500 | 100% | 6,000×缓存读取价 + 2,000×输入价 + 2,300×输出价 |
| 缓存写入 | 6,000(缓存过期后重新写入) | 按写入频率摊销 | 6,000×缓存写入价 ÷ 每次写入覆盖的请求数 |
| 重试调用 | 与首次调用相同 | 10% | 首次调用成本 × 0.1 |
| 升级调用 | 强模型输入 8,000 + 输出与推理合计 2,000 | 5% | 强模型单价代入后 × 0.05 |
| 人工抽检 | 不消耗 token | 抽检 5% | 单条校验人工成本 × 0.05 |
把上面五行相加,得到“每条工单的期望成本”。再除以最终接受率,例如 95%,就得到“每个被接受结果的成本”。注意这里的重试按首次调用的完整成本计算,因为重试时上下文通常会原样再发一遍。
这个示例里有一个值得注意的现象:可见输出只有 800 token,但推理 token 有 1,500,按输出单价计费时,推理部分反而是输出侧的大头。如果只按可见输出估算,输出侧成本会被低估一半以上。
任务完整成本 常见误区对比
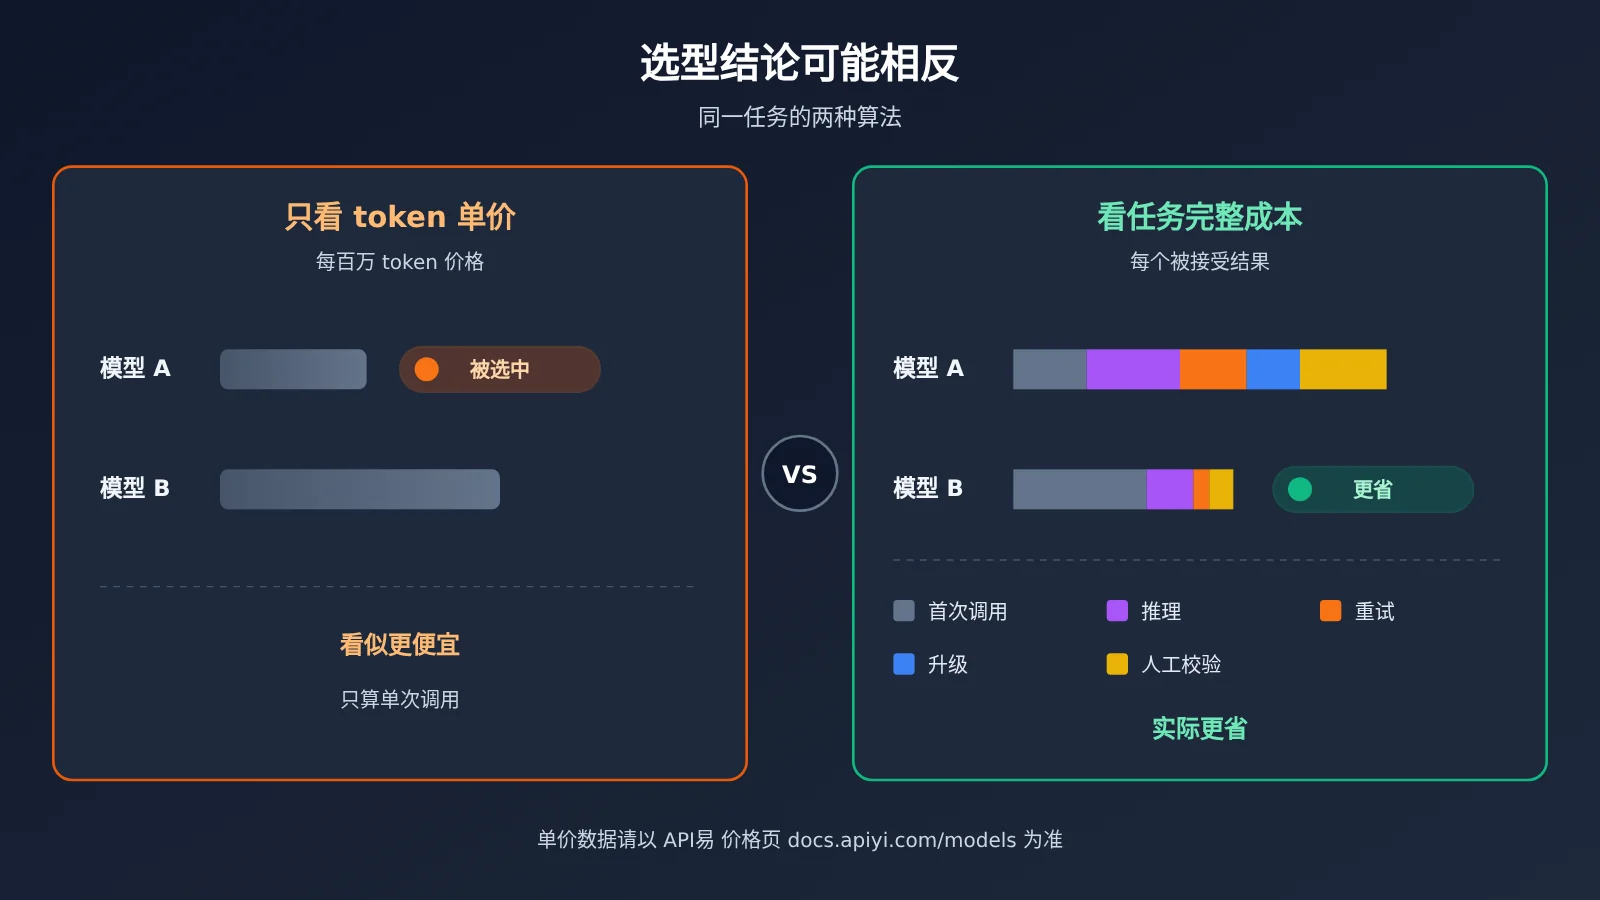
同一个需求,用“只看单价”和“看任务完整成本”两种思路,经常得出相反的选型结论。下表总结几类典型场景。
| 场景 | 只看单价的结论 | 看任务完整成本后的结论 | 关键变量 |
|---|---|---|---|
| 结构化抽取 | 选最便宜的轻量模型 | 若字段错误率高,强模型可能更省 | 接受率、人工返工 |
| 编码 Agent | 选输出单价低的模型 | 多轮工具调用使上下文膨胀,缓存策略更关键 | 缓存命中率、轮数 |
| 长文档分析 | 按平均输入长度估算 | 少量超长请求触发长上下文阶梯价 | 上下文阈值、P95 长度 |
| 推理强度选择 | 同一模型单价相同,选最高档 | 高档推理 token 更多,需看通过率是否提升 | 推理 token、通过率 |
| 批量离线任务 | 按实时调用单价算 | 批处理通道可能有不同计价口径 | 是否支持 Batch |
💡 对比说明:表中结论是方法层面的推演,具体哪个模型更划算取决于你的样本。建议在 API易 apiyi.com 上用相同样本跑多个模型,结合价格页的实际单价填表,再做决定。
任务完整成本中的长上下文与缓存细节
长上下文阶梯是最容易“小概率、大金额”的项目。公开资料提到,部分模型在输入超过某个阈值(例如有文章讨论 GPT-6 Sol 的 272K 阈值)后会适用不同的单价。如果你的请求长度分布有长尾,务必单独统计超过阈值的那部分请求,而不是用平均长度一笔带过。
缓存则是双刃剑。缓存读取通常比普通输入便宜,但部分厂商的缓存写入单价可能高于普通输入,而且缓存有过期时间。如果你的请求间隔很长、前缀经常变化,写入成本可能抵消读取带来的节省。具体的缓存写入价、读取价和计费口径,以 API易 价格页 docs.apiyi.com/models 标注为准。
降低任务完整成本 的 5 种实用手段
算清楚之后,优化方向通常也就清楚了。下面几种手段在多数场景下都有效,但要用工作表验证效果,而不是凭感觉。
| 手段 | 作用的成本项 | 注意事项 |
|---|---|---|
| 固定前缀、开启缓存 | 输入 token | 把易变内容放到提示词末尾,提高命中率 |
| 限制输出格式与长度 | 输出 token | 用结构化输出约束字段,避免冗长解释 |
| 按任务难度路由 | 升级调用、推理 token | 规则要明确,并审计“被接受的错误结果” |
| 前置自动校验 | 人工校验、返工 | 校验证据来源,而不只是校验 JSON 格式 |
| 控制推理强度 | 推理 token | 用通过率决定档位,不默认开最高档 |
关于路由,有一个常被忽视的风险:小模型“成功”返回的结果中可能藏着错误,而这些错误不会触发升级。所以评估路由策略时,除了升级率,还要抽查小模型直接通过的那部分结果,把漏网的错误折算进成本。
常见问题 FAQ
Q1:什么是任务完整成本?
任务完整成本是指完成一次业务意义上的任务、并且结果被接受所花费的全部成本。它包括所有调用的输入、输出、推理和缓存费用,以及重试、升级和人工校验的开销,比单纯的 token 单价更接近真实账单。
Q2:任务完整成本和 token 单价有什么区别?
token 单价是原材料价格,任务完整成本是成品价格。单价低的模型如果需要更多重试、更长推理或更多人工返工,任务完整成本反而可能更高;单价高的模型若一次通过率高,也可能更省。
Q3:估算任务完整成本至少需要多少样本?
没有固定数字,关键是样本要覆盖真实分布,尤其是长输入、难例和边界情况。样本太少时,重试率和接受率波动很大,建议先用小批量估算,再在上线初期用真实日志修正。
Q4:哪些场景最需要计算任务完整成本?
主要包括以下几类:
– **结构化数据抽取**:字段错误需要人工修正时,人工成本占比很高
– **编码 Agent**:多轮工具调用导致上下文快速增长
– **长文档问答**:长尾请求可能触发长上下文阶梯价
– **多模型路由**:升级调用会叠加两次费用
Q5:如何快速获取各模型的单价和计费口径?
建议直接查看 API易 价格页 docs.apiyi.com/models,上面列出了平台所支持模型的输入、输出及缓存相关单价,估算时请以该页实际数据为准。API易 兼容 OpenAI 与 Anthropic 接口格式,按文档 docs.apiyi.com 完成接入后,可以用同一批样本测试多个模型,把调用日志中的 usage 数据直接填进工作表。
Q6:订阅制产品的用量和 API 计费能放在一起比吗?
不建议直接比。订阅制产品通常按额度或使用次数限制,API 则按 token 计费,两者的计量单位和适用场景不同。如果要比较,需要先把订阅的实际可用任务量换算出来,而不能假设固定的消息数量。
Q7:任务完整成本估算有哪些局限?
它依赖样本的代表性,样本偏简单会低估成本。人工校验成本的折算也带有主观性,不同团队差异很大。另外模型单价和计费规则可能调整,工作表需要定期用最新价格和日志更新,而不是一次算完就长期沿用。
任务完整成本 核心要点 Key Takeaways
- 比较单位要换:用“每个被接受结果的成本”比较模型,而不是每百万 token 单价
- 推理 token 必须单独记:它通常按输出计费,且可能超过可见输出
- 缓存要算写入和读取:写入可能比普通输入贵,命中率决定是否划算
- 重试与升级是隐性大头:上线后的失败率往往高于测试时的观察
- 合法 JSON 不等于正确数据:校验证据来源,把人工返工算进成本
- 长上下文看长尾:用 P95 长度检查是否触发阶梯价
- 单价以价格页为准:估算时统一查 API易 价格页 docs.apiyi.com/models 的实际数据
总结
估算任务完整成本的核心要点:
- 先定义任务边界:以业务结果为单位,而不是以单次调用为单位
- 拆清所有成本项:输入、输出、推理、缓存、重试、升级、人工校验缺一不可
- 用真实样本测概率:重试率、升级率、接受率决定最终成本的倍数
“别只看 token 单价”并不是说单价不重要,而是说它只是公式里的一个变量。把工作表搭起来,用自己的样本和日志填满它,选型结论会比任何排行榜都可靠。
推荐通过 API易 apiyi.com 用同一批样本对比多个模型,结合价格页 docs.apiyi.com/models 的实际单价完成任务成本测算,平台兼容 OpenAI 与 Anthropic 接口格式,切换模型成本很低。
📚 参考资料
- Ofox.ai Blog 模型定价与任务成本系列文章:多篇文章讨论缓存计费、长上下文阈值、推理强度与任务成本的关系
- 链接:
ofox.ai/blog/page/12 -
说明: 适合了解“单价下调”与“任务成本下降”之间的区别
-
Ofox.ai Blog 模型路由与结构化抽取文章:讨论小模型到强模型的升级规则,以及“合法 JSON 不等于正确数据”
- 链接:
ofox.ai/blog/page/11 -
说明: 适合设计路由策略和校验流程时参考
-
API易 模型价格页:平台支持模型的输入、输出与缓存相关单价
- 链接:
docs.apiyi.com/models -
说明: 本文所有涉及价格与计费口径的内容均以此页实际数据为准
-
API易 文档中心:接入方式、接口格式与参数说明
- 链接:
docs.apiyi.com - 说明: 包含 OpenAI 与 Anthropic 兼容格式的接入说明
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心