作者注:GPT-6.1 Terra 价格由哪几块组成、长上下文怎么切档、缓存能省多少,本文用官方价格和 3 个算账例子讲清楚。
GPT-6.1 Terra 于 2026-10-26 发布,主打「快、省」。不少同学第一次看价格页,只记住了「输入 1 美元」,账单出来却对不上。原因是 Terra 的价格由四项计费、两个上下文档位和三种处理模式叠加而成。
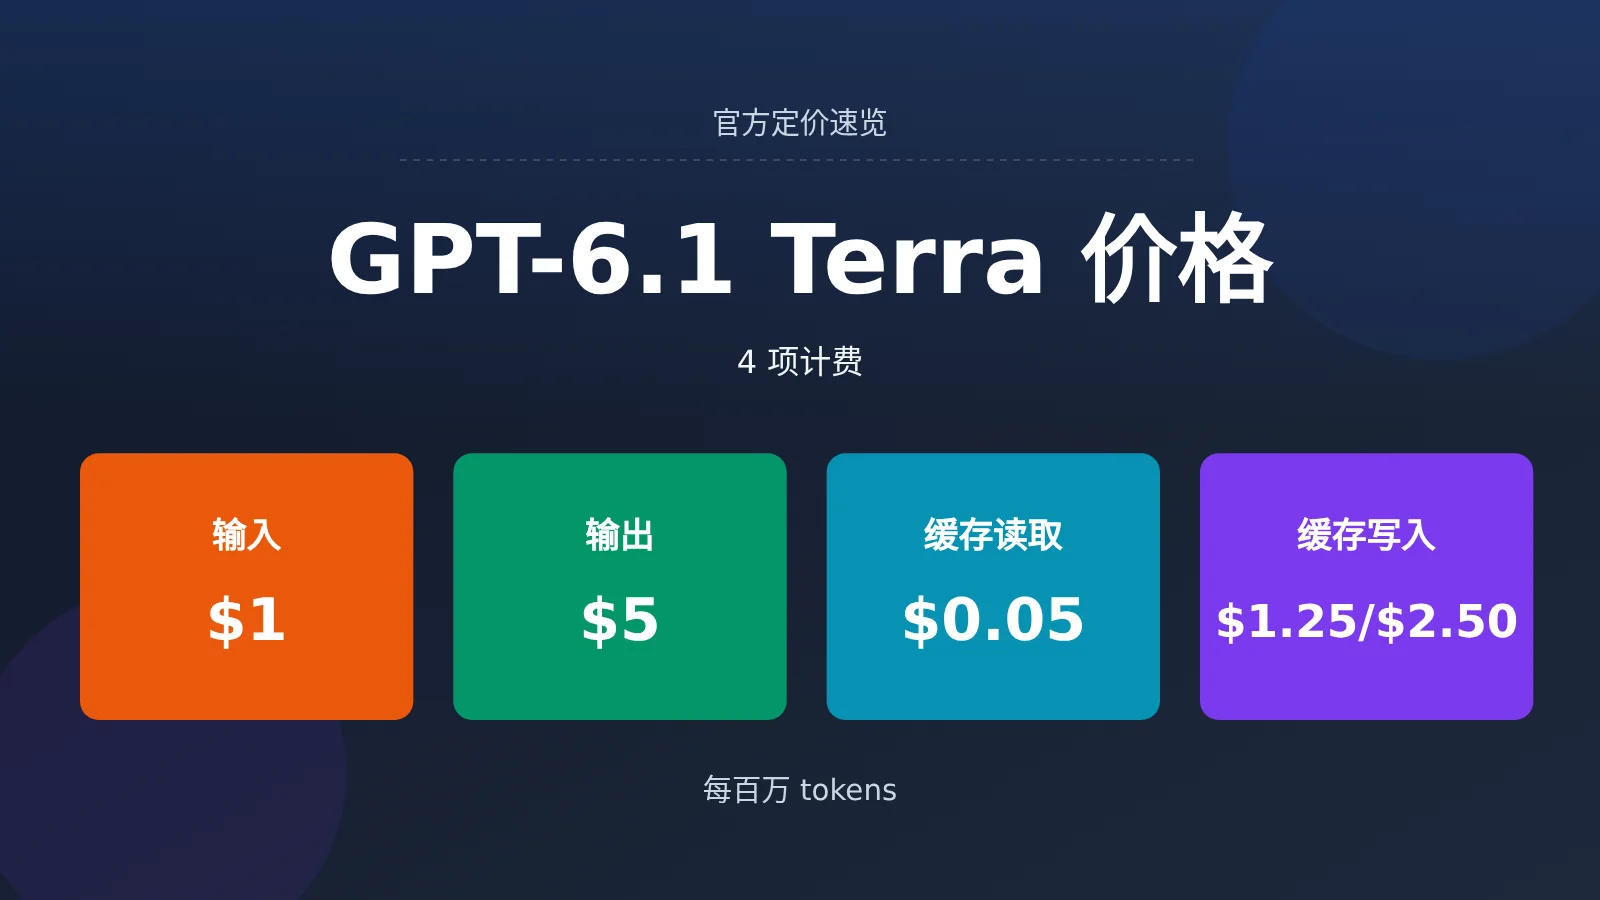
先用一段话说清 Terra 的价格结构。 每次请求按四项计费:普通输入、输出、缓存读取、缓存写入。缓存写入又分 30 分钟和 12 小时两种保留时长。单次输入超过 272K tokens 时,整条请求切到第二档。此外还有三种处理模式:Batch/Flex 打五折,Fast 按双倍计价。
口径说明:官方价格来自 OpenAI 模型页与价格页。厂商自报数据出自 2026-10-26 的发布博客。第三方数据来自 Artificial Analysis,抓取时间为 2026-10-27。
GPT-6.1 Terra 价格核心要点
先看模型本身。模型 ID 是 gpt-6.1-terra,只有一个快照。上下文窗口 1,050,000 tokens,单次最大输入 922,000,最大输出 128,000,知识截止 2026-06-01。输入支持文本和图片,输出只有文本,不支持音频和视频。
标准价适用于单次输入不超过 272K 的请求,单位均为每百万 tokens:
| 计费项 | 标准价(≤272K) | 说明 |
|---|---|---|
| 输入 | $1.00 | 未命中缓存的输入 |
| 输出 | $5.00 | 含推理产生的输出 |
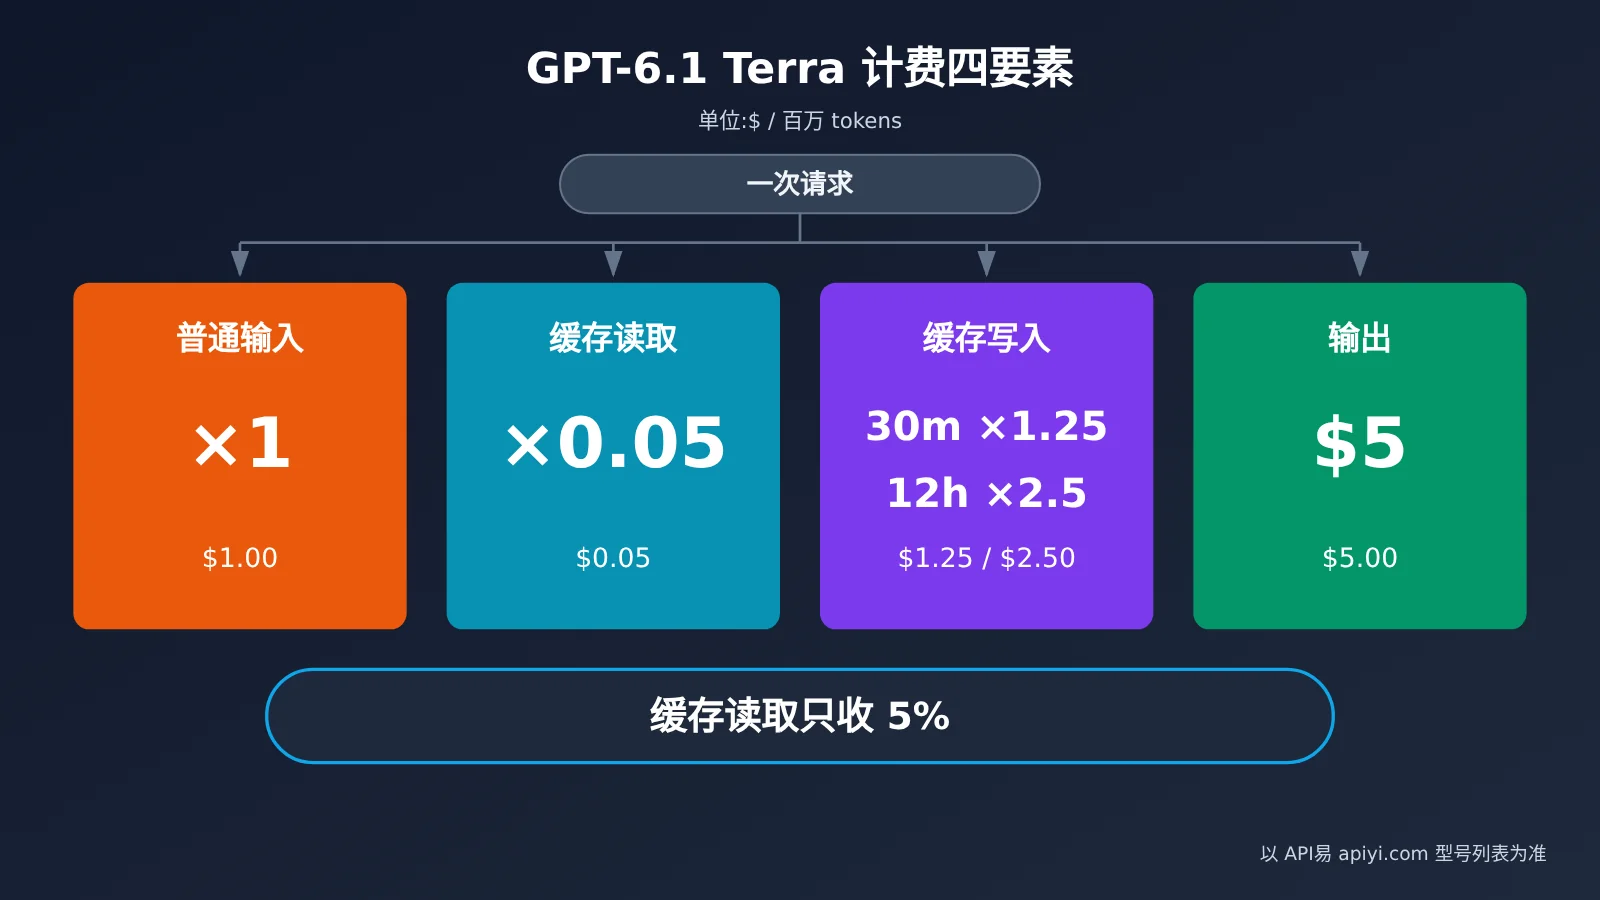
| 缓存读取 | $0.05 | 输入价的 0.05 倍 |
| 缓存写入(30 分钟) | $1.25 | 输入价的 1.25 倍 |
| 缓存写入(12 小时) | $2.50 | 输入价的 2.5 倍 |
GPT-6.1 Terra 缓存计费细节
缓存读取只收输入价的 5%。同代多数模型是 0.1 倍,这一项是 Terra 相比上一代降幅最大的地方。
缓存写入是总价,不是在输入价之外另加的费用。写入缓存的那部分 tokens 直接按 $1.25 或 $2.50 计费,不再按 $1.00 收一遍。还有几条使用规则要注意:
- 最小可缓存前缀为 1,024 tokens,低于这个长度不会进入缓存。
- 12 小时保留只能在 Responses API 中通过
prompt_cache_options.ttl设置。 ttl传入非法值时,接口返回400 invalid_request_error。
GPT-6.1 Terra 长上下文价格:272K 阶梯
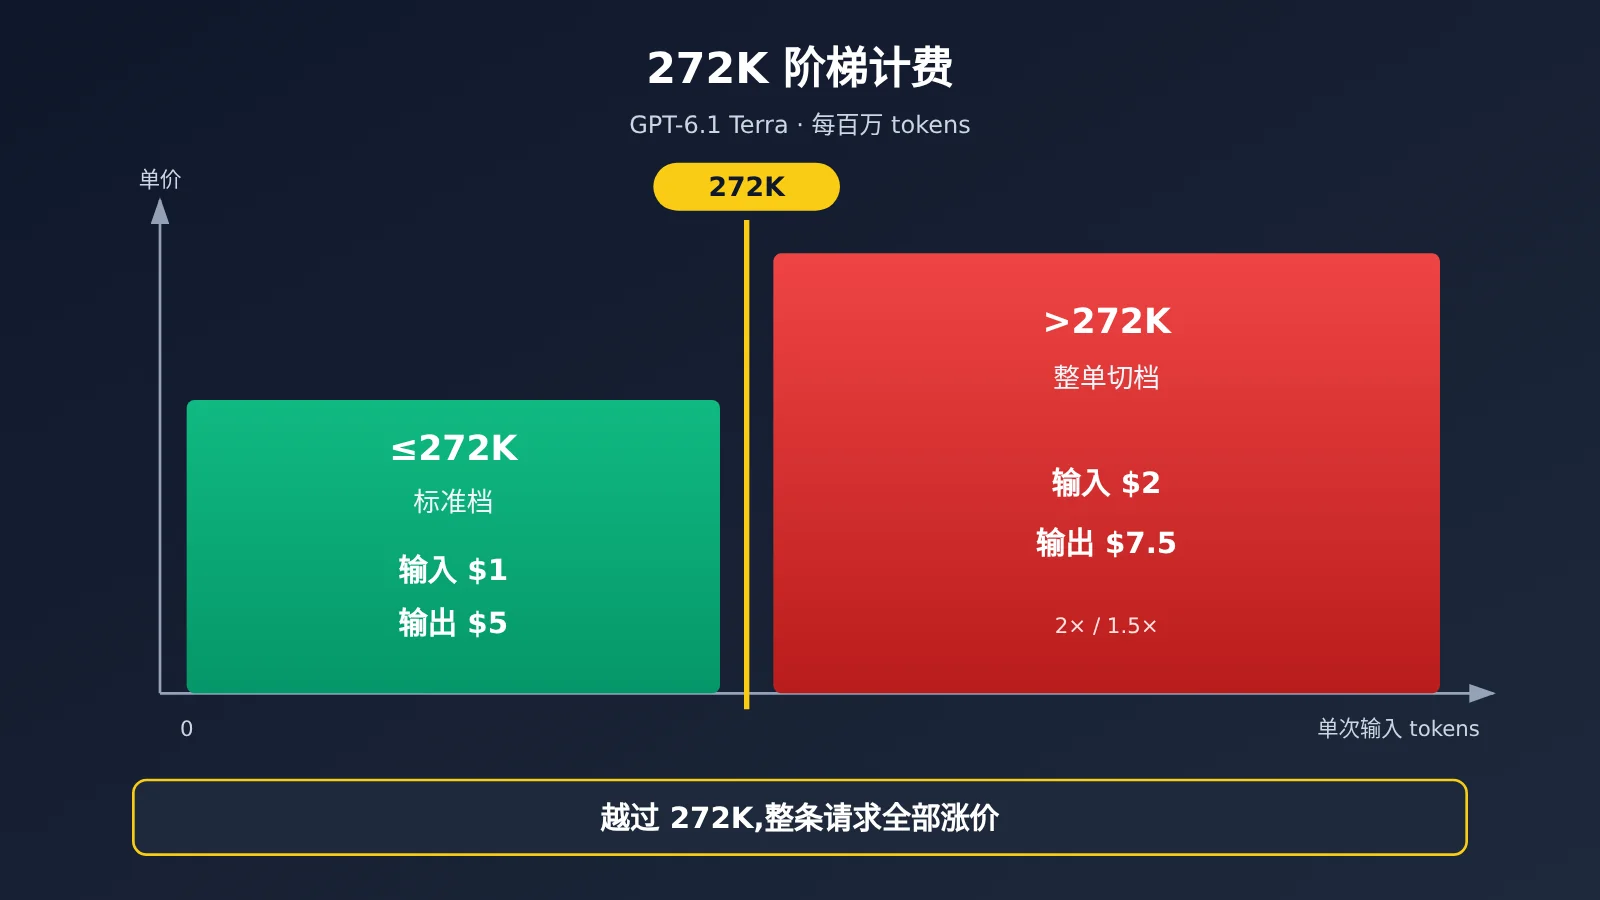
这是最容易踩坑的一条规则。单次请求的输入超过 272K tokens 后,整条请求切到第二档:输入和缓存价格翻倍,输出价格变为 1.5 倍。 切档后按新价格计算全部 tokens,不是只对超出部分加价。
| 计费项 | ≤272K | >272K(整单) | 倍数 |
|---|---|---|---|
| 输入 | $1.00 | $2.00 | 2× |
| 输出 | $5.00 | $7.50 | 1.5× |
| 缓存读取 | $0.05 | $0.10 | 2× |
| 缓存写入 30 分钟 | $1.25 | $2.50 | 2× |
| 缓存写入 12 小时 | $2.50 | $5.00 | 2× |
GPT-6.1 Terra 其他计费档
| 模式 | 价格规则 | 适用场景 |
|---|---|---|
| Batch / Flex | 标准价五折:输入 $0.50、输出 $2.50、缓存读取 $0.025、缓存写入 $0.625(30m)/ $1.25(12h) | 离线批处理、对时延不敏感的任务 |
| Fast | 标准价 2 倍:输入 $2.00、输出 $10.00 | 对时延敏感的在线场景 |
| Ultrafast | Terra 不支持,仅覆盖 gpt-6-astra 与 gpt-6.1-sol | — |
| 区域处理 / FedRAMP | 加价 10%,适用于 2026-03-05 之后发布的模型 | 数据驻留、合规场景 |
Fast 模式下的缓存价格,在我们抓取的官方页面中没有找到明确数字,这里按「官方未披露」处理。另外,Priority processing 已于 2026-07-30 更名为 Fast mode,看旧文档时注意对应关系。
GPT-6.1 Terra 价格对比:同代与上一代
| 模型 | 输入 | 输出 | 缓存读取 | 缓存写入 30m | API易 apiyi.com 型号列表(2026-10-27) |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | $12.50 | 已上架 |
| gpt-6.1-sol | $2.00 | $10.00 | $0.10 | $2.50 | 已上架 |
| gpt-6.1-terra | $1.00 | $5.00 | $0.05 | $1.25 | 已上架 |
| gpt-6-sol | $2.00 | $10.00 | $0.20 | $2.50 | 已上架 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.125 | 已上架 |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | $2.50 | 已上架 |
和 GPT-5.6 Terra 相比,Terra 的输入价降了 50%,输出价降了约 58%,缓存读取降了 75%。官方博客的说法是,其标准 API 价格比 GPT-5.6 Terra 和 GPT-6.1 Sol 都低 50%。
GPT-6.1 Terra 价格实算:三个例子
以下算式统一按每百万 tokens 的单价折算,即 tokens 数 × 单价 ÷ 1,000,000。
例一:批量发票录入
假设每次输入 2,000 tokens(含一张发票图片),输出 300 tokens,每天调用 5,000 次。
不命中缓存:
- 输入:2,000 × $1 ÷ 1M = $0.0020
- 输出:300 × $5 ÷ 1M = $0.0015
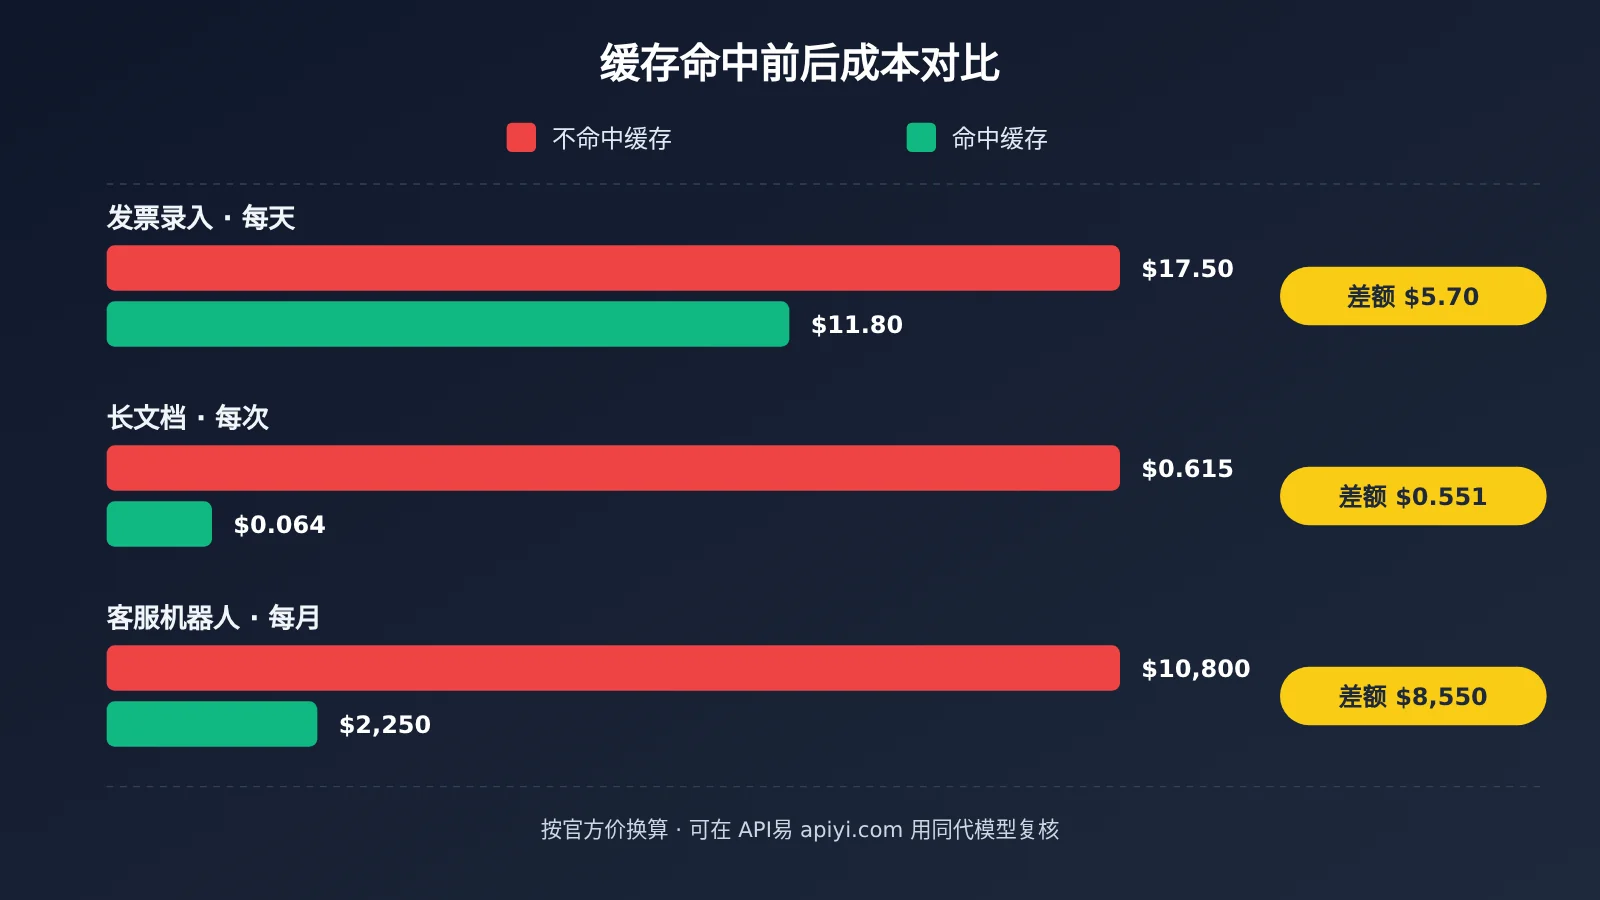
- 单次合计 $0.0035,每天 5,000 次 × $0.0035 = $17.50
命中缓存: 假设固定的系统指令和字段说明共 1,200 tokens 命中缓存(超过 1,024 的门槛),剩余 800 tokens 为图片等变化内容。
- 缓存读取:1,200 × $0.05 ÷ 1M = $0.00006
- 普通输入:800 × $1 ÷ 1M = $0.0008
- 输出:$0.0015
- 单次合计 $0.00236,每天 $11.80,比不命中缓存每天少花 $5.70
缓存过期后需要重新写入一次,30 分钟保留的写入成本为 1,200 × $1.25 ÷ 1M = $0.0015,摊到每天 5,000 次调用上可以忽略。发票录入通常不要求实时返回,改走 Batch 后,不命中缓存的单次成本为 2,000 × $0.5 ÷ 1M + 300 × $2.5 ÷ 1M = $0.00175,每天 $8.75。
例二:长文档审阅(已进入 >272K 档)
假设单次输入 300,000 tokens,输出 2,000 tokens。因为输入超过 272K,整单按第二档计价。
不命中缓存:
- 输入:300,000 × $2 ÷ 1M = $0.60
- 输出:2,000 × $7.5 ÷ 1M = $0.015
- 单次 $0.615
命中缓存: 同一份文档追问多次,假设 290,000 tokens 的文档前缀命中缓存,新问题占 10,000 tokens。
- 缓存读取:290,000 × $0.10 ÷ 1M = $0.029
- 普通输入:10,000 × $2 ÷ 1M = $0.020
- 输出:$0.015
- 单次 $0.064,比不命中缓存每次少 $0.551
首次请求要写入缓存。按 30 分钟保留计,首次成本为 290,000 × $2.5 ÷ 1M + $0.02 + $0.015 = $0.76。只要同一份文档追问一次,两次合计 $0.824,已经比两次都不缓存的 $1.23 便宜。
还有一个更直接的省钱办法:把输入压到 272K 以内。以 270,000 tokens 输入、2,000 tokens 输出计算,成本为 270,000 × $1 ÷ 1M + 2,000 × $5 ÷ 1M = $0.28,不到第二档的一半。
例三:高缓存命中的客服机器人
假设每轮输入 50,000 tokens,其中 45,000 tokens 命中缓存,输出 800 tokens,每月 20 万轮。
不命中缓存:
- 输入 50,000 × $1 ÷ 1M = $0.05,输出 800 × $5 ÷ 1M = $0.004
- 每轮 $0.054,每月 200,000 × $0.054 = $10,800
命中缓存:
- 缓存读取:45,000 × $0.05 ÷ 1M = $0.00225
- 普通输入:5,000 × $1 ÷ 1M = $0.005
- 输出:$0.004
- 每轮 $0.01125,每月 $2,250,比不命中缓存每月少 $8,550
假如缓存读取按同代多数模型的 0.1 倍计算,每轮成本为 $0.0135,每月 $2,700。Terra 的 0.05 倍规则在这个场景下每月还能再省 $450。以上计算未包含缓存写入的摊销。
GPT-6.1 Terra 单任务成本:第三方口径
以下数据来自 Artificial Analysis(抓取时间 2026-10-27)。这是第三方评测口径,不等于你的业务成本。 评测任务的 token 结构和你的真实请求不同,按官方单价结合自己的 token 分布换算会更准确。
| 模型 | Intelligence Index | 单任务成本 | 输出速度 |
|---|---|---|---|
| GPT-6.1 Terra(max) | 48 | $0.40 | 91 t/s |
| GPT-6.1 Sol | 52 | $0.72 | 69.4 t/s |
| GPT-5.6 Terra | 42 | $1.40 | 135.4 t/s |
| GPT-6 Astra | 53 | $3.26 | 67.8 t/s |
| Claude Opus 5.5(Max) | 58 | $5.98 | — |
按这份数据,Terra 的指数比 Astra 低 5 分,单任务成本约为 Astra 的 1/8、Opus 5.5 的 1/15。
官方博客还给出了一些成本对比,属于厂商自报,未经独立复现:
- 在 Agents’ Last Exam 上,medium 档得分比 GPT-5.6 Terra 高 15 个百分点,成本约为其三分之一。
- max 档的 token 效率是 Claude Opus 5.5 的 3 倍以上,单任务成本约低 9 倍。
GPT-6.1 Terra 快速上手:接入步骤
截至 2026-10-27,gpt-6.1-terra 已经可以在 API易 apiyi.com 直接调用:输入 $1、输出 $5、缓存读取 $0.05、缓存写入 $1.25(每百万 tokens,对应平台模型倍率 0.5、补全倍率 5),与官网 ≤272K 档逐项一致。同代的 gpt-6.1-sol、gpt-6-astra,以及上一代的 gpt-5.6-terra、gpt-6-sol、gpt-6-luna 也都已上架。型号与价格以平台型号列表为准,长上下文档位的最终扣费以控制台账单为准。
接入只需要四步:
- 在 API易 apiyi.com 注册账号,创建 API Key。
- 在 OpenAI 兼容 SDK 中,将
base_url设置为https://api.apiyi.com/v1,api_key填入你的 Key。 - 调用前先查询实时型号列表
api.apiyi.com/api/pricing,核对gpt-6.1-terra的单价与可用分组,再把model字段设为该 ID。 - 按任务需要设置
reasoning.effort,可选值为none / low / medium / high / xhigh / max,默认medium。 - 如需 12 小时缓存,改用 Responses API,并设置
prompt_cache_options.ttl。 - 上线前根据返回的 usage 统计核对命中缓存的 tokens 数,再套用本文的算式估算成本。
🚀 快速开始:型号与价格以平台型号列表为准。新账号自带 0.05 美元试用额度,在 API易 apiyi.com 把
model设成gpt-6.1-terra就能跑通调用链路和缓存逻辑,想横向比价再换成gpt-6.1-sol即可。
常见问题 FAQ
Q1:GPT-6.1 Terra 价格一句话怎么说?
标准档(单次输入 ≤272K)每百万 tokens:输入 $1、输出 $5、缓存读取 $0.05,缓存写入 30 分钟 $1.25、12 小时 $2.50。
Q2:超过 272K 只对超出部分加价吗?
不是。单次输入超过 272K 后,整条请求切到第二档:输入和缓存价格翻倍,输出变为 1.5 倍。
Q3:Batch 和 Fast 怎么选?
离线任务选 Batch 或 Flex,所有计费项打五折。对时延敏感的任务可以选 Fast,但要按双倍价付费。Terra 不支持 Ultrafast。
Q4:缓存写入会额外加钱吗?
缓存写入是总价,不是附加费。写入的 tokens 按 1.25 倍或 2.5 倍输入价计费,不会再按普通输入价重复收取。只要同一前缀被复用一次,通常就能回本。
Q5:在 API易 上能用 Terra 吗?
可以。2026-10-27 起 `gpt-6.1-terra` 已在 API易 apiyi.com 上架,四项计费与官网 ≤272K 档逐项一致。型号与价格以平台型号列表为准。
Q6:第三方的单任务成本能直接用来做预算吗?
不建议直接使用。那是评测任务的口径,和你的业务 token 结构不同。更稳妥的做法是在 API易 apiyi.com 用真实请求测出 token 分布,再按官方单价换算。
GPT-6.1 Terra 价格 Key Takeaways
- 四项计费:输入 $1、输出 $5、缓存读取 $0.05,缓存写入分 $1.25 和 $2.50 两档。
- 272K 是分水岭:超过后整单切档,输入翻倍,输出 1.5 倍。
- 缓存是最大的省钱点:客服场景每月从 $10,800 降到 $2,250。
- Batch/Flex 五折,Fast 双倍,Terra 不支持 Ultrafast。
- 第三方单任务成本仅供参考,做预算时按官方价自己换算更准。
- 平台接入:在 API易 apiyi.com 把
model字段设为gpt-6.1-terra就能调用,型号与价格以平台型号列表为准。
总结
Terra 的账单主要由三件事决定:输入是否超过 272K、缓存命中率有多高、是否选择了 Batch 或 Fast。把这三件事控制好,同样的业务量可以相差数倍成本。
建议先用自己的真实请求测出 token 结构,再按本文的算式逐项换算。可以直接在 API易 apiyi.com 用 gpt-6.1-terra 跑真实请求,再用同代的 gpt-6.1-sol 做横向比价。
📚 参考资料
- OpenAI GPT-6.1 Terra 模型页:规格与上下文参数
- 链接:
platform.openai.com/docs/models/gpt-6.1-terra - 说明:上下文、输入输出模态、reasoning 档位
- OpenAI 价格页:标准价、长上下文、Batch/Flex/Fast
- 链接:
platform.openai.com/docs/pricing - 说明:全部计费项的官方口径
- OpenAI Prompt Caching 指南:缓存规则
- 链接:
platform.openai.com/docs/guides/prompt-caching - 说明:最小前缀、ttl 设置、写入计费方式
- GPT-6.1 Terra 发布博客:厂商自报的成本数据
- 链接:
openai.com/index/introducing-gpt-6-1-terra - 说明:2026-10-26 发布,数据未经独立复现
作者:APIYI 技术团队
技术交流:欢迎通过 API易 apiyi.com 首页联系我们,更多资料可访问 docs.apiyi.com 文档中心