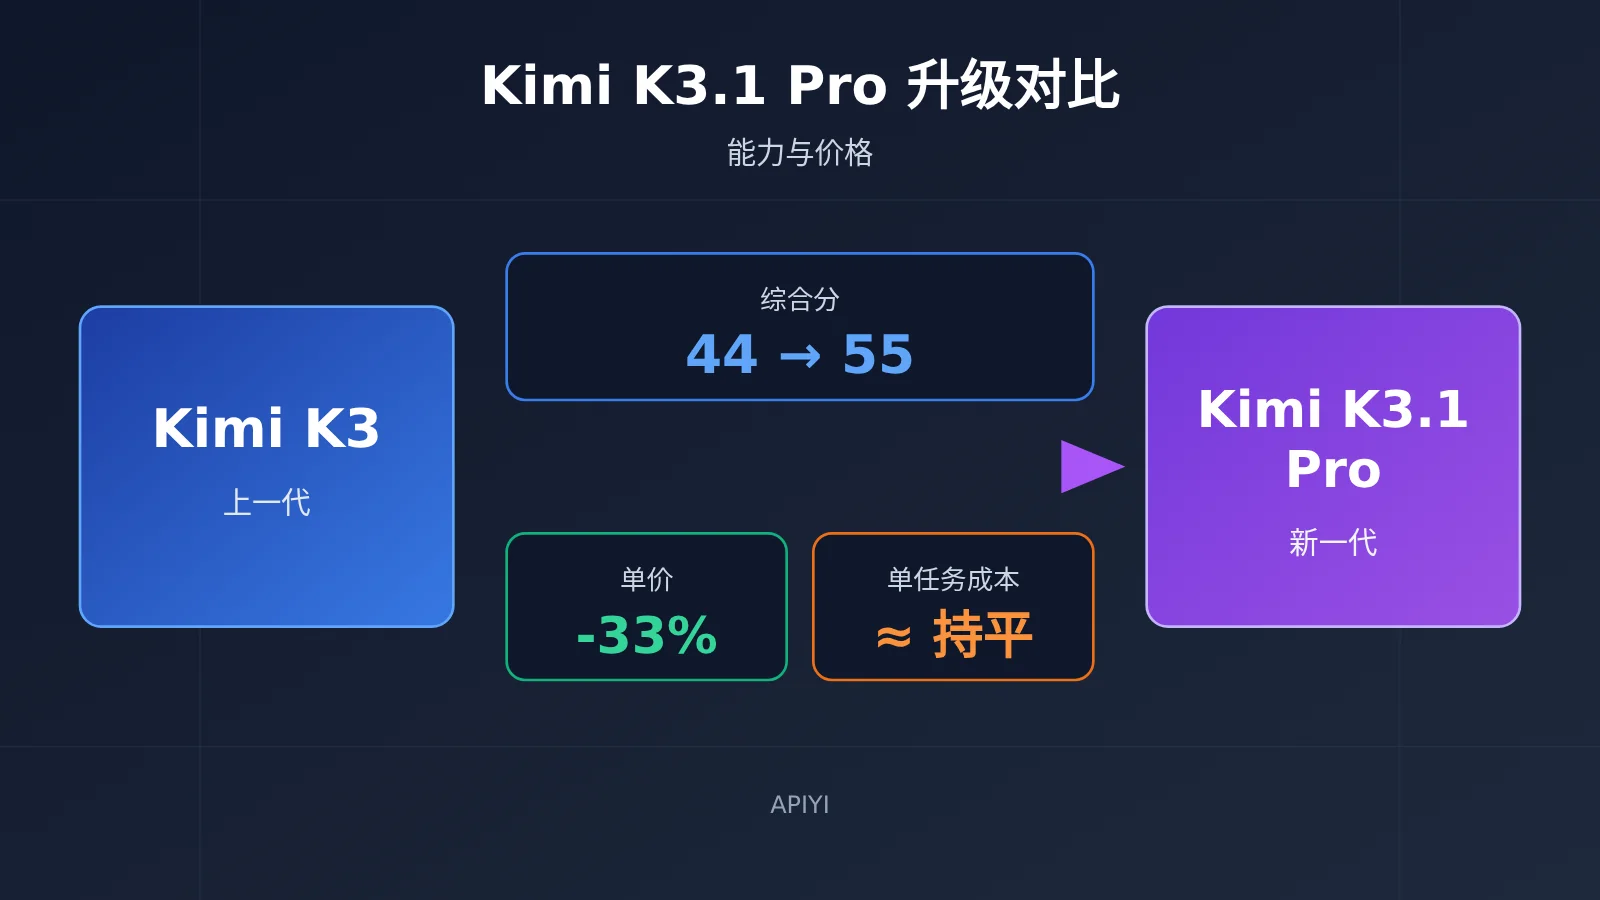
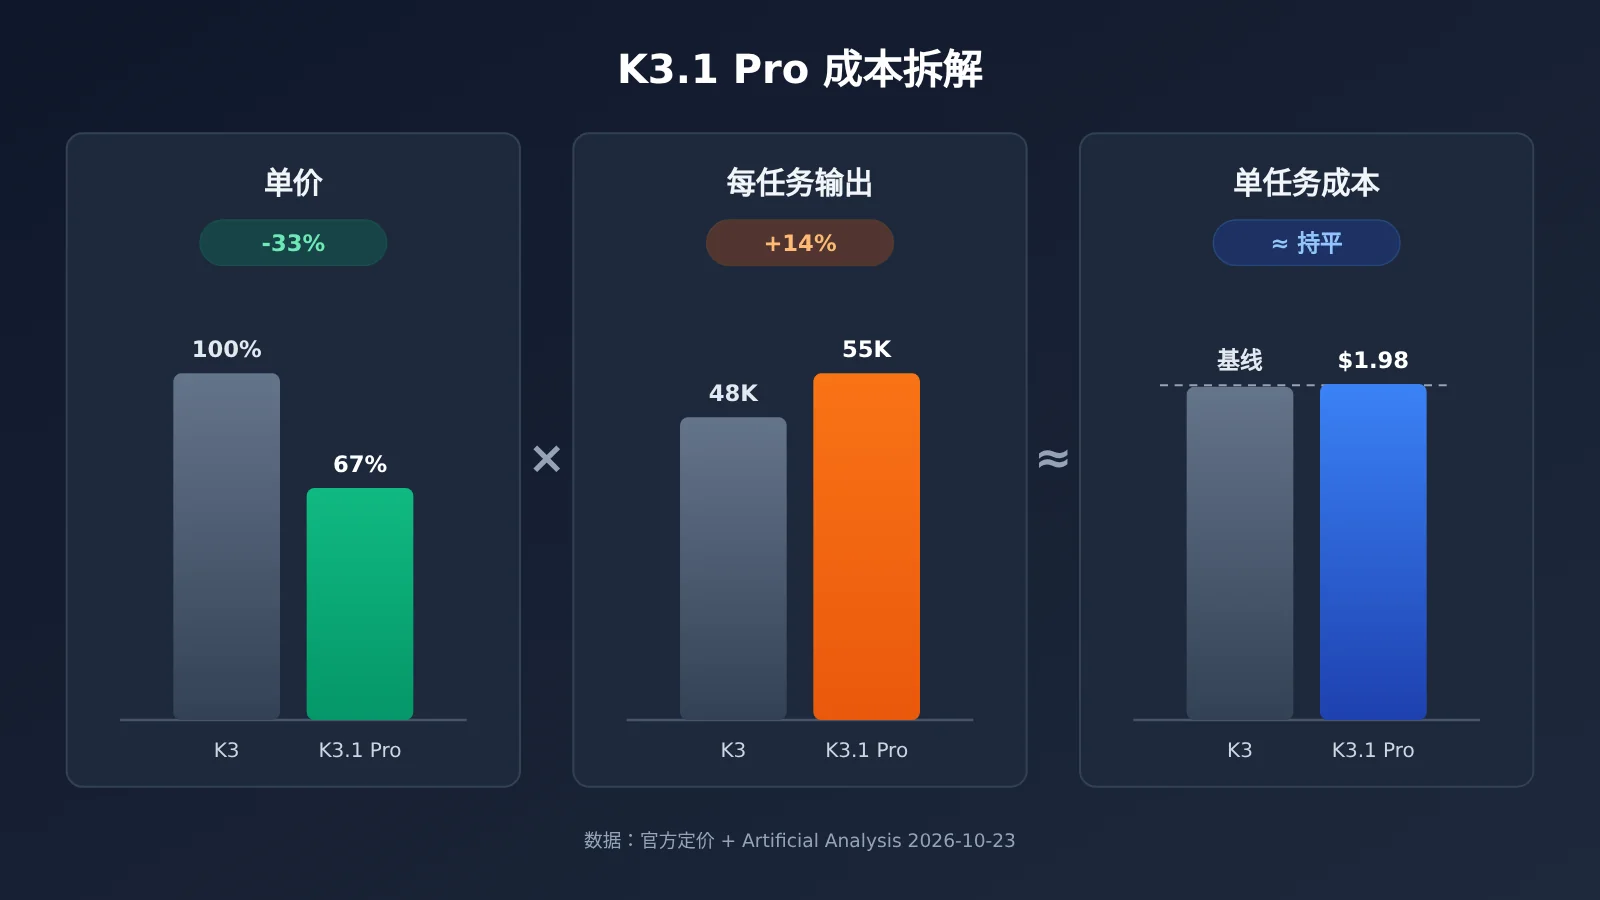
能力上,Kimi K3.1 Pro 比 K3 有明显提升:第三方 Artificial Analysis 的综合分从 44 升到 55,编程 Agent 终端榜 Terminal-Bench 4.0 从 13% 升到 67%。价格反而降了三成,输入、输出、缓存三项单价都比 K3 低 33%。不过它的输出更长,而且始终思考,所以实际跑一个任务的成本和 K3 差不多。
下面给出依据,并按「官方自报」「第三方」「未核实」三档标注每条信息的来源。这篇不是发布会复述,也不劝所有人马上换,目的是帮正在用 K3 的开发者判断自己的业务该不该迁、什么时候迁、迁的时候要注意什么。
1. Kimi K3.1 Pro 相比上一代的 5 个核心差异
K3.1 Pro 不是从头训练的新模型,而是在 K3 基础上做了大规模「后训练」。后训练指基础模型训好以后,再用更多数据和反馈调整它的做事方式。官方称它是「K3.1 系列首个模型」「最强 3T 级开放权重模型」。开放权重的意思是模型参数文件会公开,可以下载后自己部署。Artificial Analysis 记录的总参数为 2.8T,每次实际参与计算的激活参数为 104B。
| 维度 | Kimi K3 | Kimi K3.1 Pro | 来源 |
|---|---|---|---|
| 训练方式 | 基础版本 | 基于 K3 后训练,后训练算力大幅增加 | 官方自报 |
| 综合能力 | Intelligence Index 44 | 55,全榜第 4 | 第三方(AA,2026-10-23) |
| 单价 | 输入 $3 / 输出 $15 | 输入 $2 / 输出 $10,降 33% | 官方定价 |
| 每任务输出量 | 平均 48K tokens | 平均 55K tokens,多 14% | 第三方(AA) |
| 上下文 / 模态 | 1M / 文本+图像 | 1M / 文本+图像,未变 | 官方自报 |
表中的 tokens 是模型计费和计量的基本单位,可以粗略理解为「字词碎片」,一个汉字通常对应一到两个 tokens。读这张表时先抓两个变化:能力分数上去了,单价下来了。第三列「每任务输出量」决定了降价后实际能省下多少,后文第 4 节专门展开。
权重方面,官方承诺 2026-11-04 前放出完整权重。按当前时间点(2026-10-24),这一条仍属于承诺,尚未兑现,在「未核实」状态。Artificial Analysis 的判断是:权重放出后,K3.1 Pro 会是该机构榜单上得分最高的开放权重模型,开放权重模型与闭源模型最高分的差距会从 12 分缩小到 3 分。
2. Kimi K3.1 Pro 跑分对比:官方自报与第三方两套口径
先说明一点:下面两张表来自不同机构、不同测试环境,不能混在一起比较。最典型的是 Terminal-Bench 4.0,官方自报 65.7%,Artificial Analysis 独立测得 67%,这是两次测试的两个分数,不能当成同一个分数的误差。官方也没有给出 K3 的 Terminal-Bench 4.0 成绩,K3 的 13% 只来自 Artificial Analysis。
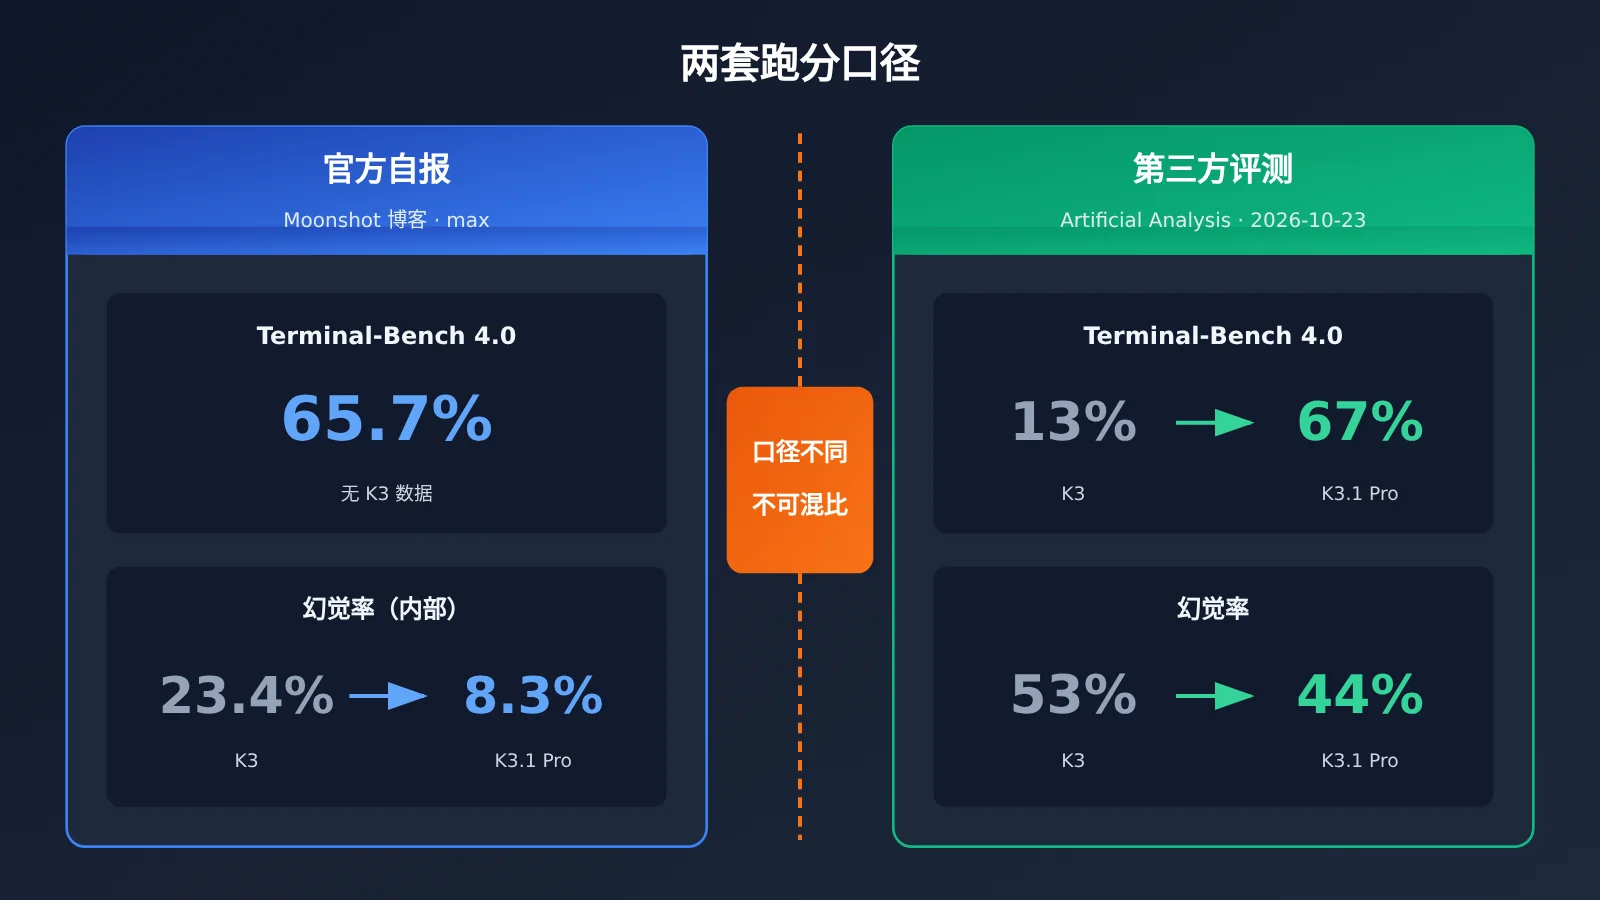
2.1 Kimi K3.1 Pro 官方自报跑分
来源:Moonshot 官方博客。测试条件:除特别注明外,均为 reasoning_effort=max(推理强度开到最大)、temperature=1.0、top_p=0.95。标注「内部」的是 Moonshot 自建测试集,外部无法复现。
| 项目 | K3.1 Pro | 对比对象 | 备注 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra 58.2%,Claude Opus 5.5 66.4% | Opus 5.5 用 Claude Code harness 跑 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | K3 55.95% | 内部,长链路编程任务 |
| BenchCAD | 92.7%(带工具) | Opus 5.5 96.2%,GPT-6 Astra 95.9% | 多视图图纸还原为 CAD 代码 |
| OfficeQA Pro v2 | 64.4 | 超过 K3 | 真实财报文档分析,官方称 SOTA |
| Financial Modeling / Research | 比 K3 高 7.2 / 11.6 分 | K3 | 内部 |
| Business Operation | 约为 K3 的 4.2 倍 | K3 | 内部模拟经营 |
| Kimi Hallu Bench Hard | claim 级幻觉率 8.3% | K3 23.4% | 内部事实性压力测试 |
| xdev-bench-hard(pass@3) | 81.0% | 未做安全清洗的对照版本 90.5% | 漏洞挖掘 |
几个术语:harness 指测试时套在模型外面的「驾驶框架」,负责调用工具、执行命令,换框架分数会变,所以 Opus 5.5 那一项要单独看。pass@3 指同一题给三次机会,答对一次就算通过。最后一行的意思是,官方为了安全,主动压低了模型挖漏洞的能力,正式版比未做限制的内部版本低了约 9.5 个百分点。
2.2 Kimi K3.1 Pro 第三方跑分(Artificial Analysis)
来源:Artificial Analysis,数据日期 2026-10-23,测试流程由该机构统一执行,K3 与 K3.1 Pro 使用同一套方法。
| 指标 | K3.1 Pro | K3 | 变化 |
|---|---|---|---|
| Intelligence Index | 55(第 4) | 44 | +11 |
| GDPval-AA(真实工作任务 Elo) | 1846(第 3) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 个百分点 |
| AutomationBench-AA(SaaS 工作流) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| 幻觉率 / 准确率 | 44% / 51% | 53% / 48% | 幻觉 -9 |
| 每任务平均输出 tokens | 55K | 48K | +14% |
在 Artificial Analysis 榜单上,K3.1 Pro 排第 4,前面是 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。Terminal-Bench 4.0 的 67% 是该机构测过的所有模型里的最高分,Sonnet 5.5 为 64%。
两套口径在幻觉上的结论方向一致,具体数值差别很大:官方内部压力测试从 23.4% 降到 8.3%,AA 从 53% 降到 44%。两边用的不是同一套题,测试难度和统计方式也不同。对外引用时请写明来源,不要合并成「幻觉率降到 8%」之类的一句话。
3. Kimi K3.1 Pro 明显变强的 5 个方向
这一节只写两套数据都指向进步、或者进步幅度足够大的方向。
- 编程 Agent 与终端任务。Agent 指能自己拆任务、调用工具、多步执行的 AI 助手。AA 测得 Terminal-Bench 4.0 从 13% 到 67%,官方内部长链路编程测试从 55.95% 到 61.2%。如果你用 K3 跑代码 Agent 时经常卡在命令执行、文件操作或多步排错上,这是提升最明显的一项。
- 真实工作任务。GDPval-AA 用 Elo 分衡量模型完成真实职业任务的水平。Elo 是一种对战排名分,下棋排名用的就是它,分差越大,胜率差距越大。K3.1 Pro 比 K3 高 312 分,排名第 3,说明在写方案、做表格、整理材料这类日常工作上提升明显。
- SaaS 工作流自动化。AutomationBench-AA 测的是模型在各类在线软件之间完成自动化流程的能力,比如读邮件、改工单、同步表格,从 58% 升到 73%。官方内部的模拟经营测试(Business Operation)达到 K3 的约 4.2 倍,同样指向长流程执行能力的提升,但这项是内部数据,仅供参考。
- 事实性与幻觉。幻觉指模型一本正经地编造不存在的事实。官方内部测试中,claim 级幻觉率(按单条事实陈述统计)从 23.4% 降到 8.3%,含至少一处事实错误的回答数量只剩 K3 的 42.4%;AA 的幻觉率从 53% 降到 44%,准确率从 48% 升到 51%。
- 金融建模与研报。官方称 OfficeQA Pro v2 得分 64.4 为 SOTA(当前最好成绩),内部 Financial Modeling 与 Financial Research 分别比 K3 高 7.2 分和 11.6 分。这几项第三方暂未独立复测,归入「官方自报」档。
科学推理类指标(Humanity’s Last Exam、CritPt、SciCode)也有提升,但只有 2-5 个百分点。如果你的业务以学术问答、科研代码为主,K3.1 Pro 的提升没有 Agent 类任务那么大,这类用户不必因为这几项着急迁移。
4. Kimi K3.1 Pro 变化不大的地方与实际成本代价
4.1 Kimi K3.1 Pro 没变的三件事
- 上下文仍是 1M:1,048,576 tokens,与 K3 相同。上下文可以理解为模型一次能「看」的内容总量。
- 模态仍是文本 + 图像:没有新增音频、视频等输入方式。
- 官方没有公布速度基准:AA 测得输出速度为 80.7 tokens/秒,在该机构的 4 档速度分级里处于第 2 档。官方称 highspeed 版本快 2-3 倍,但没有给出可复现的测试条件,这一说法暂列「未核实」。
4.2 Kimi K3.1 Pro 五档价格对比
以下为官方价格,2026-10-24 抓取,美元/百万 tokens,不含税。
| 模型 | 输入 | 输出 | 缓存命中 | 5 分钟写入 | 1 小时写入 |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
缓存命中指重复发送的相同前缀内容(比如固定的系统提示词、同一份长文档)第二次起按低价计费。5 分钟写入和 1 小时写入是把内容存进缓存时的计费,存得越久越贵。做 Agent 或长文档问答时,缓存的作用很大,提示词结构稳定的话,账单里输入部分能省下不少。
4.3 Kimi K3.1 Pro 的成本代价:降价不等于省钱
K3.1 Pro 始终思考,也就是每次回答前都会先做一段内部推理,这段推理按输出 tokens 计费。AA 测得它每任务平均输出 55K tokens,比 K3 的 48K 多 14%。
按单价算,降 33% 应该能省不少,但 AA 实测的单任务成本约为 $1.98(模型详情页写的是 $2.11),与 K3 基本持平。该机构没有公布成本拆解,所以「为什么没省下来」目前没有官方解释。一种可能是 Agent 任务的多轮调用里,输入 tokens 也随之增加,这只是推测,属于「未核实」。
另外,highspeed 版本的价格是标准版的两倍。对成本敏感的团队,切换前建议用自己的真实任务抽样跑一批,看总花费,不要只比单价。
如果想在同一套代码里对比 K3 和 K3.1 Pro 的实际花费,可以先接入 API易 apiyi.com 的 OpenAI 兼容接口跑 kimi-k3 做基线。K3.1 Pro 在平台上的型号与价格以平台型号列表为准,我们会尽快推出此模型。
5. Kimi K3.1 Pro 场景推荐:什么时候该换,什么时候不急
按任务类型给出结论,供现有 K3 用户参考。
| 任务类型 | 结论 | 理由 |
|---|---|---|
| 编程 Agent、终端自动化 | 建议尽快换 | Terminal-Bench 4.0 第三方 13%→67%,长链路编程官方 +5 分以上 |
| 文档分析与研报、金融建模 | 建议换 | GDPval Elo +312,财报与研报类官方测试全面领先 K3,幻觉明显下降 |
| SaaS 工作流、多步业务流程 | 建议换 | AutomationBench-AA 58%→73% |
| 批量小任务(分类、抽取、改写) | 不急 | 单任务成本与 K3 持平,始终思考增加输出,能力提升对简单任务意义不大 |
| 对延迟敏感的场景(实时对话、在线客服) | 先测再定 | 官方无速度数据,始终思考会拉长首字时间,highspeed 价格翻倍 |
「不急」不代表 K3 不行。K3 在简单任务上本身已经够用,延迟和花费也更好预估,没有必要为了一个更高的综合分重写整条批处理管线。等 K3.1 Pro 权重放出、第三方速度数据更完整后再评估,时间也来得及。
5.1 选择 Kimi K3.1 Pro 的典型场景
- 代码仓库级的修 bug、重构、写测试,需要模型自己跑命令、看报错、再改。
- 长篇财报、合同、研报的问答和摘要,对事实准确性要求高。
- 跨多个在线工具的自动化流程,单个任务要执行十几步以上。
5.2 暂时保留 Kimi K3 的典型场景
- 每天几十万条的标签分类、字段抽取,按条数算成本。
- 需要稳定低延迟的实时交互,已经针对 K3 调好了超时和重试参数。
选择建议:最可靠的办法是拿自己业务里的 50-100 条真实样本,在两个模型上各跑一遍,对比完成率和总花费。API易 apiyi.com 用一个 API Key 就能切换不同模型,适合做这种对照测试。K3.1 Pro 上线前,可以先用
kimi-k3跑基线,K3.1 Pro 的型号与价格以平台型号列表为准,我们会尽快推出此模型。
6. Kimi K3.1 Pro 迁移决策建议与注意事项
6.1 Kimi K2 系列的下线时间表
如果你手上还有 K2 系列的调用,优先处理这部分。官方文档显示:2026-10-31 起,K2 系列对新注册用户不可用,2026 年底前全部下线。老用户虽然暂时还能用,也建议这两个月内完成迁移,直接迁到 K3 或 K3.1 Pro,不要等到下线前才处理。
6.2 Kimi K3.1 Pro 切换模型的三条操作要点
- 新开会话,不要中途换模型。官方建议在新会话里使用 K3.1 Pro,把已有的 K3 对话历史接到 K3.1 Pro 上继续跑,可能出现上下文格式或思考内容不兼容的问题。
- 优先用原生接口。官方认为 Responses、Chat Completions、Messages 这三类原生接口最稳。
- 模型名一定要写准。在第三方工具里填写
kimi-k3.1-pro时如果拼错,请求会回落到 K2.8 Preview,并且不会思考。这个问题不会报错,只是结果变差,排查起来很费时间。上线前建议检查返回结果里的模型字段。
6.3 Kimi Code 会员档位差异
在 Kimi Code 中使用新模型,会员档位有门槛:
k3.1-pro需要 Plus 及以上会员。- 1M 上下文需要 Pro 及以上会员。
- highspeed 版本需要 Pro 及以上会员,且约消耗 2 倍配额。
Plus 会员可以用上 K3.1 Pro,但拿不到完整的 1M 上下文。如果你主要靠超长上下文读整个代码仓库,确认档位后再决定是否升级。
6.4 通过 API 接入的检查清单
base_url填https://api.apiyi.com/v1,即 API易 apiyi.com 的 OpenAI 兼容地址,现有 OpenAI SDK 代码只需改这一项和 Key。model先用kimi-k3跑通流程,再按平台型号列表填写 K3.1 Pro 的准确型号。K3.1 Pro 的型号与价格以平台型号列表为准,我们会尽快推出此模型。- 超时时间适当调长,始终思考会让单次响应变慢。
max_tokens不要设得太紧,否则思考内容可能把正文输出挤掉。
常见问题 FAQ
Q1: Kimi K3.1 Pro 是什么,和 K3 是什么关系?
K3.1 Pro 是 Moonshot 在 K3 基础上加大后训练算力得到的新版本,官方称它是 K3.1 系列首个模型。上下文和输入模态与 K3 相同,主要提升集中在编程 Agent、真实工作任务和事实准确性上。
Q2: Kimi K3.1 Pro 的 Terminal-Bench 到底是 65.7% 还是 67%?
两个都对,但来源不同。65.7% 是官方自报,67% 是 Artificial Analysis 独立测得。测试环境和 harness 不一样,不能当成同一个分数,引用时请注明来源。
Q3: Kimi K3.1 Pro 单价降了 33%,为什么不省钱?
它始终思考,每任务平均输出比 K3 多 14%。AA 实测单任务成本约 $1.98(模型页写 $2.11),与 K3 基本持平。具体原因该机构没有拆解,建议用自己的任务实测。
Q4: Kimi K3.1 Pro 的权重什么时候开放?
官方承诺 2026-11-04 前放出完整权重。截至 2026-10-24 仍是承诺,尚未兑现,自部署计划请以官方实际发布为准。
Q5: 如何通过 API 快速对比 Kimi K3.1 Pro 和 K3?
可以在 API易 apiyi.com 注册获取 Key 和免费测试额度,用 OpenAI 兼容接口先跑 `kimi-k3` 作为基线。K3.1 Pro 在平台上的型号与价格以平台型号列表为准,我们会尽快推出此模型,上线后改一下 `model` 参数就能对比。
Q6: Kimi K3.1 Pro 有哪些已知限制?
– 官方没有公开速度基准,highspeed 版本价格翻倍。
– 始终思考,不适合追求极低延迟的场景。
– 部分亮眼成绩来自内部测试集,外部无法复现。
– 漏洞挖掘能力经过安全限制,比未清洗版本低。
Q7: 我还在用 K2,应该直接迁到 K3.1 Pro 吗?
K2 系列 2026-10-31 起对新用户关闭,年底前下线,必须迁。编程 Agent 和文档类业务可以直接迁到 K3.1 Pro;批量小任务迁到 K3 更省事。在 API易 apiyi.com 上可以先用 `kimi-k3` 完成迁移,K3.1 Pro 的型号与价格以平台型号列表为准,我们会尽快推出此模型。
Kimi K3.1 Pro 核心要点 Key Takeaways
- 能力明显提升:AA 综合分 44→55,排名第 4,仅次于三款闭源模型。
- 编程 Agent 提升最大:Terminal-Bench 4.0 第三方实测 13%→67%。
- 两套数据分开看:官方自报与 AA 口径不同,引用必须注明来源。
- 降价不等于降本:单价降 33%,单任务成本与 K3 基本持平。
- 基础规格未变:1M 上下文、文本+图像,官方无速度数据。
- 迁移要写准模型名:写错会回落到 K2.8 Preview 且不思考。
- 接入方式:可先用 API易 apiyi.com 跑 K3 基线,K3.1 Pro 型号与价格以平台型号列表为准,我们会尽快推出此模型。
总结:Kimi K3.1 Pro 值不值得从 K3 迁移
Kimi K3.1 Pro 相比上一代的变化可以归纳为三点:
- 能力:编程 Agent、终端任务、真实工作任务、SaaS 自动化和事实性都有明显提升,第三方与官方数据方向一致。
- 价格:五档单价全部比 K3 低 33%,但始终思考带来更长输出,单任务成本基本没降。
- 迁移:编程 Agent 和文档研报类业务建议尽快换,批量小任务和延迟敏感场景可以先测再定;K2 用户要赶在年底前完成迁移。
API易 apiyi.com 目前已提供 kimi-k3(输入 $3 / 输出 $15)等 Kimi 型号,可以用同一个 Key 和 OpenAI 兼容接口先建立成本与效果基线。Kimi K3.1 Pro 在平台上的型号与价格以平台型号列表为准,我们会尽快推出此模型,上线后直接替换型号即可对比。
参考资料
- Moonshot 官方博客:Kimi K3.1 Pro 发布说明与官方自报跑分
- 说明:本文「官方自报」档数据来源,测试条件为
reasoning_effort=max、temperature=1.0、top_p=0.95 - Moonshot 官方文档:定价、K2 下线时间表、模型切换建议与 Kimi Code 会员说明
- 说明:价格为 2026-10-24 抓取,美元/百万 tokens,不含税
- Artificial Analysis:独立第三方模型评测
- 链接:
artificialanalysis.ai - 说明:本文「第三方」档数据来源,数据日期 2026-10-23
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心。Kimi K3.1 Pro 的型号与价格以平台型号列表为准,我们会尽快推出此模型。