摘要:从模型、编程代理和 API 渠道三层对比国内可用组合,再用真实编程任务、费用和兼容性选出适合自己的复现方案。
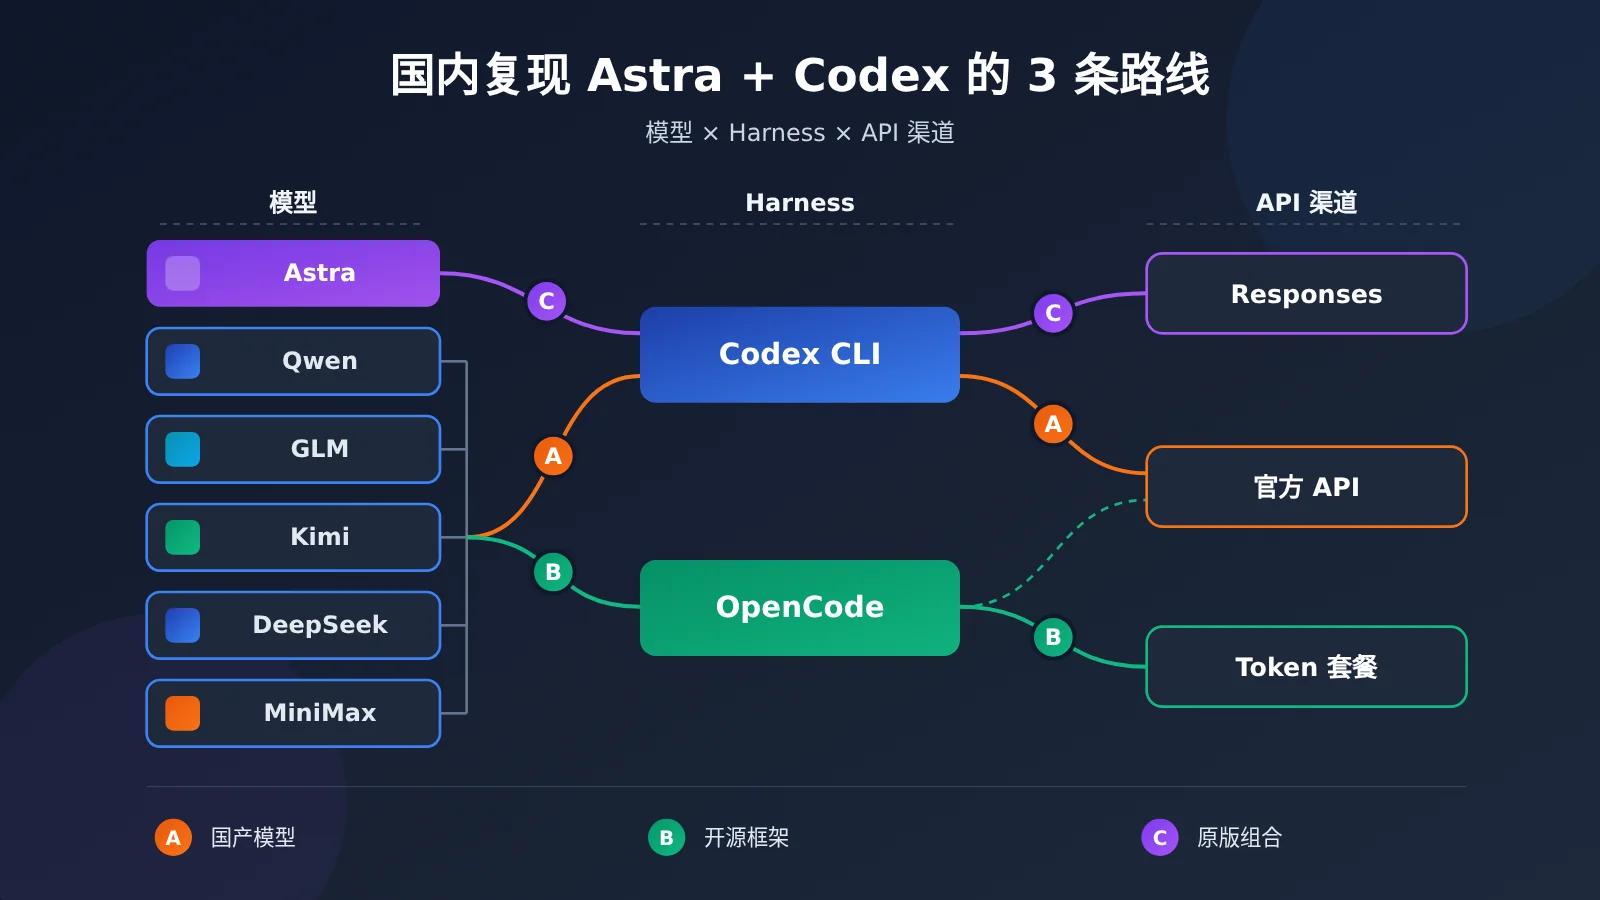
国内最大程度复现 Astra + Codex,有三条值得测试的路线。路线 A:保留原版 Codex CLI,通过阿里云百炼或腾讯云 TokenHub 的 Responses 兼容接口接入国产旗舰模型,这条路线保住了 Codex 的执行体验。路线 B:改用 OpenCode 等开放 Harness 接入多家国内模型,这条路线换来最大的模型选择自由。路线 C:在合法合规、服务实际可用的前提下,保留 GPT-6 Astra 模型,通过完整支持 Responses 协议的 API 渠道接入原版 Codex,这条路线对原始组合的还原度最高。
如果要求模型国产化,路线 A 是起点,其中 Qwen4-Max-Preview 只开放到 2026 年 11 月 25 日 24:00,适合测评而不适合做唯一的长期依赖。如果只要求在国内网络环境下使用、不要求模型国产化,路线 C 在模型智能上最接近原版。三条路线之间的最终取舍,应当由同一批真实编程任务的成功率、耗时、费用和工具兼容性来决定,而不是由榜单或 Token 单价决定。
下文先把 Astra + Codex 拆成五个能力组件,说明“复现”到底复现什么;然后分别给出路线 A 的两套官方接入配置与套餐对照、路线 B 的四款 Harness,以及值得优先测试的国产模型;接着用一张总表收拢三条路线的取舍;最后给出一套可复现的五类任务测试方法,把“单次成功任务成本”作为选型的核心指标。
To Know:术语预备知识
| 术语 | 解释 |
|---|---|
| GPT-6 Astra | OpenAI 的旗舰推理模型,定位复杂推理、软件工程和长程 Agent 任务,模型 ID 为 gpt-6-astra。 |
| Codex | OpenAI 的编程代理,能读取项目、修改代码、执行命令并验证结果。 |
| Harness | 把模型决策连接到真实工具的执行框架,负责工具循环、上下文、权限和失败恢复。 |
| Responses API | OpenAI 支持模型输出、推理和工具调用的接口协议,新版 Codex 依赖它运行。 |
| Chat Completions | OpenAI 较早的对话接口协议,旧版 Codex 使用它。 |
| Provider | 给 Agent 工具提供模型服务的供应商,在配置文件中表现为一组接入参数。 |
| Base URL | 模型服务 API 的基础访问地址,切换渠道时主要改的就是它。 |
| Token Plan | 云厂商按月套餐提供模型调用额度的计费方案。 |
| Credits / 积分 | 套餐内用于扣减调用额度的计量单位,不同厂商的单位不可直接互换。 |
| 上下文窗口 | 模型一次请求能处理的内容上限,以 Token 计。 |
| 推理档位 | 控制模型思考深度的参数,Astra 提供 low 到 max 五档。 |
| 缓存命中 | 重复发送的输入被服务端复用,按更低费率计费。 |
| MCP | 连接模型应用与外部工具、数据源的开放协议。 |
| Function Calling | 模型输出结构化调用请求、由应用执行函数并回传结果的机制。 |
| 峰谷计费 | 按时段区分价格,高峰时段消耗更多额度。 |
正文
1 Astra + Codex 到底强在哪里?
1.1 Astra 提供了什么
GPT-6 Astra 是 OpenAI 的旗舰推理模型,官方定位覆盖复杂推理、软件工程、多步骤代码修改、浏览器与计算机操作、研究分析和专业文档生产。它为 Codex 提供的是“判断力”:理解陌生代码库、设计改动方案、读懂报错并调整策略。
官方模型规格(资料核对日期 2026-11-13)如下:
- 上下文窗口:1,050,000 Token;最大输出:128,000 Token。
- 推理档位:low、medium、high、xhigh、max。
- 标准价格(美元 / 百万 Token):输入 $10,输出 $50,缓存输入 $1,30 分钟缓存写入 $12.50;输入超过 272K Token 时适用更高的长上下文费率。
- Responses API 工具:Web Search、File Search、Hosted Shell、Apply Patch、Computer Use、MCP 等。
最后一项需要单独理解:这些工具是 OpenAI 平台提供的能力,某个客户端或第三方网关能否用上,取决于它实际集成了哪些工具。
1.2 Codex 负责完成哪些任务
OpenAI 在 2026 年 8 月公布的 Codex Harness 文章中,把 Codex 的核心概括为 Agent 循环、代码库理解与文件操作、命令执行、工具调用与结果回传、多轮上下文管理、用户审批、沙盒安全边界,以及执行过程观察与失败恢复。
分工很清楚:模型负责判断与生成,Harness 负责把模型的决策落到真实的文件系统和终端上。一个很强的聊天模型,只有配上这套执行系统,才能完成“读项目 → 改代码 → 跑测试 → 修失败 → 再验证”的完整编程任务。
1.3 要复现的是模型,还是整个 Agent
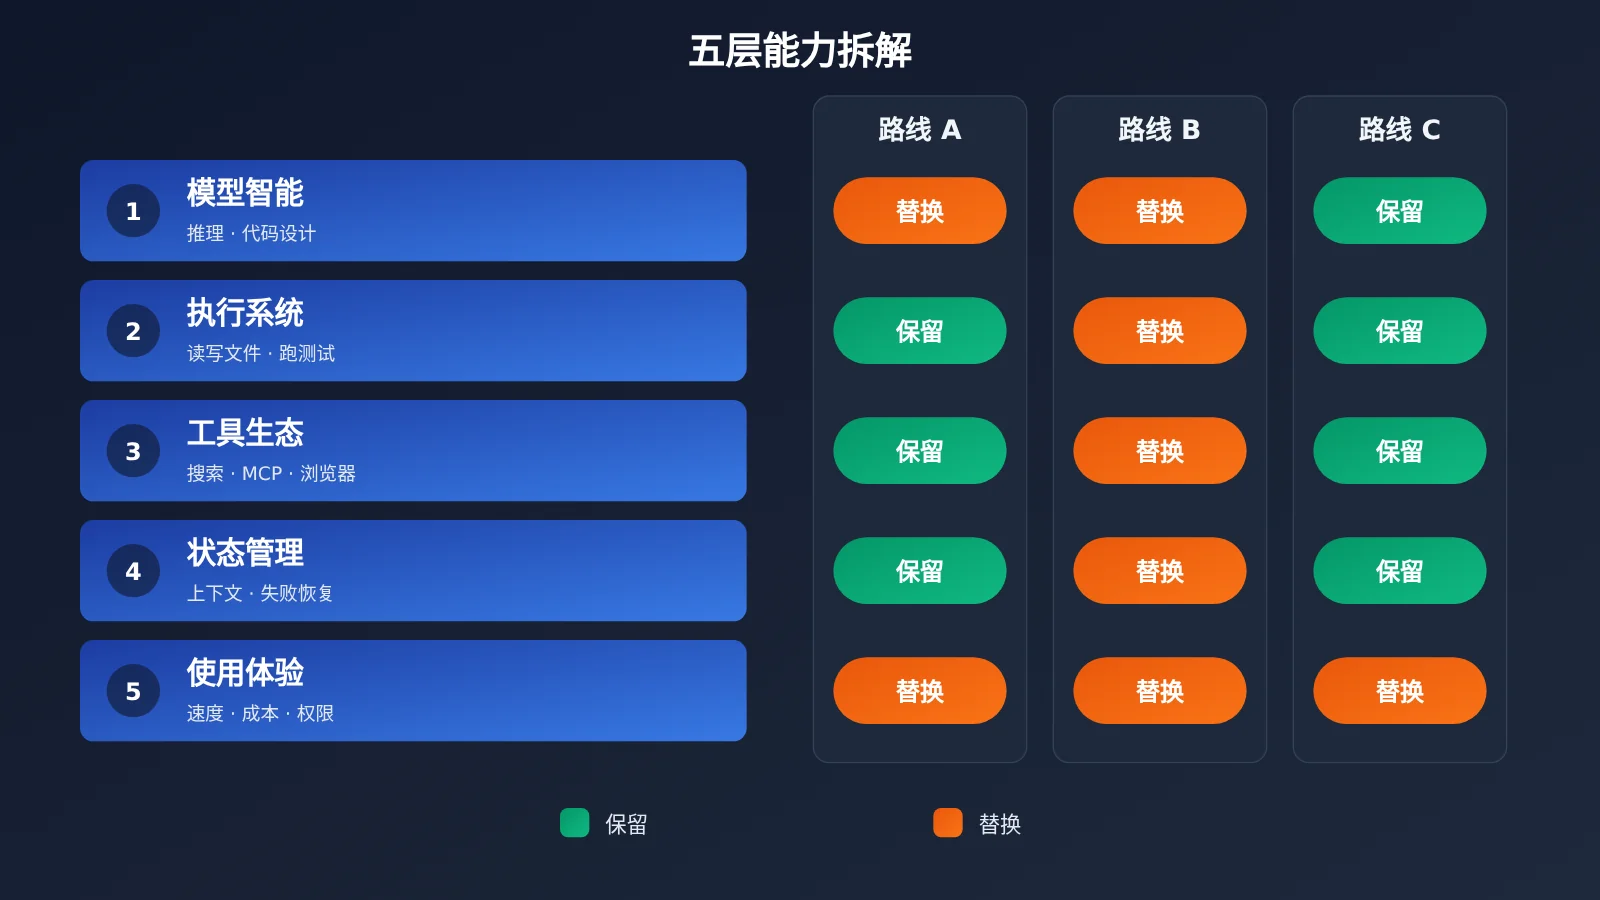
把原始体验拆开,可以得到五个组件:
- 模型智能:复杂任务理解、代码设计、推理与调试。
- 执行系统:读取项目、编辑文件、执行命令、运行测试。
- 工具生态:联网搜索、网页读取、MCP、文件处理、浏览器操作。
- 状态管理:长任务上下文、工具调用循环、失败恢复。
- 使用体验:响应速度、稳定性、成本、权限控制和操作便利性。
更换模型主要改变第 1 项,但用户最终感受到的是五项的总和。这也是三条路线的分界:路线 A 换掉第 1 项、保留第 2 和第 4 项;路线 B 同时更换第 1、2、4 项;路线 C 尽量保留第 1、2、4 项,差异集中在第 5 项和 API 渠道带来的协议细节上。
2 保留 Codex,接入国产模型(路线 A)
2.1 阿里云百炼 Token Plan + Codex
阿里云已发布 Codex 官方接入文档,Token Plan 提供 Responses 兼容接口,可以直接连接新版 Codex。在 ~/.codex/config.toml(Windows 一般为 C:\Users\<用户名>\.codex\config.toml)中写入:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
env_key 指向的环境变量里要放 Token Plan 的套餐专属 API Key。配置时有几个容易踩坑的技术细节:
- 协议版本:Codex 从 0.94.0 起要求 Responses API。阿里云旧版 Coding Plan 使用 Chat Completions,官方要求搭配 Codex 0.93.0 或更早版本;长期维护的环境应选 Token Plan。
- Key 隔离:Token Plan、Coding Plan 和按量计费使用三套不同的 API Key。
- 地域:Token Plan 目前仅支持华北 2(北京)。
- 模型元数据:新模型需要正确配置模型 ID 和元数据,才能在 Codex 的模型选择界面获得完整支持。
百炼当前最值得关注的是 2026 年 11 月 11 日上线的 Qwen4-Max-Preview(模型 ID qwen4-max-preview)。官方文档确认它是新一代旗舰多模态模型,支持代码开发、复杂智能体任务、图片与视频理解,支持深度思考(默认开启)、工具调用、联网搜索和结构化输出,兼容 OpenAI Chat Completions、Responses 和 Anthropic Messages 三种协议。上下文长度 1M Token,最大输出预算 393,216 Token,思考与最终回答共享这一预算。
它的使用条件同样明确:目前仅在 Token Plan 中提供,不支持按量付费;预览期为北京时间 2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00,结束后下线。截至本文日期,剩余可测试时间不到两周,适合抓紧做测评,生产环境应同时准备好替代模型。
2.2 腾讯云 TokenHub + Codex
腾讯云为 Codex CLI 提供了专门的官方接入教程,同一个配置文件写法如下:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id 需要替换成套餐当前支持的精确模型 ID。TokenHub 的模型库包括 GLM-5.3、Kimi K3、DeepSeek V4 系列、MiniMax M3、腾讯混元 Hy 系列以及部分轻量和自动路由模型,同一套餐还支持 Claude Code、Cline、OpenClaw 等工具。
TokenHub 的优势在于“一套 Codex 配置、多个国产模型”:改一行 model 就能让同一个 Harness 依次跑 GLM、Kimi、DeepSeek 和 MiniMax,非常适合做横向对比。模型库存、版本和额度政策会动态调整,每次测试前应以控制台列出的模型 ID 为准。
2.3 两套套餐有什么差异
两家都叫 Token Plan,但计量单位不同:百炼用 Credits,TokenHub 用 积分,两者无法直接换算。下表数据截至 2026-11-13,价格单位均为人民币 / 月:
| 对比维度 | 阿里云百炼 Token Plan(个人版) | 腾讯云 TokenHub 通用 Token Plan(个人版) |
|---|---|---|
| 档位与月费 | Lite ¥39、Essential ¥79、Standard ¥139、Pro ¥312 | Lite ¥39、Standard ¥99、Pro ¥299、Max ¥599 |
| 月度额度 | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 积分 |
| 建议并发 Agent | 1—2 / 2—3 / 3—4 / 6—8 | 文档未给出同类指标 |
| 优惠与权益 | Lite、Essential 新用户首购 ¥19.5、¥39.5(至 2026-11-30);Standard、Pro 附 AgentStudio Harness 权益 | 部分模型限时优惠抵扣费率;购买积分参考 ¥1 = 20 积分 |
| Codex 接入协议 | Responses(wire_api = "responses") |
Responses(wire_api = "responses") |
| 代表模型 | Qwen 系列,含仅限 Token Plan 的 Qwen4-Max-Preview | GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3、混元 Hy |
| 计量方式 | Credits 按模型扣减 | 2026-08-31 起积分抵扣,模型间速率不同 |
| 使用限制 | 仅华北 2(北京);交互式编程套餐不应直接用于任意商业后端自动化 | 模型库与优惠活动可能调整 |
比较这两份套餐时,月费排序意义不大,关键是“我要用的那个模型,在这个套餐里每完成一个任务扣多少额度”。百炼的价值集中在 Qwen 生态和当前独占的 Qwen4-Max-Preview;TokenHub 的价值集中在多家国产模型共用一份额度。
TokenHub 公开了各模型的积分抵扣费率。以下为 2026-11-13 查询到的部分限时优惠费率,已按 ¥1 = 20 积分换算为人民币 / 百万 Token:
| 模型 | 普通输入 | 输出 | 缓存命中输入 | 备注 |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | 优惠结束恢复刊例价 |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | 速度与成本敏感场景 |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | 优惠结束恢复刊例价 |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | 代码定向型号 |
| DeepSeek V4.1 Flash(空闲) | ¥0.40 | ¥1.60 | ¥0.008 | 峰谷计费 |
| DeepSeek V4.1 Flash(高峰) | ¥0.80 | ¥3.20 | ¥0.016 | 工作日 09:00—12:00、14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | 输入 ≤ 512K Token 的价格 |
这张表要配合两点理解。第一,包月订阅按套餐月费收费,表中金额是积分的参考价值,用来比较模型之间的消耗速率。第二,DeepSeek 峰谷计费自 2026 年 10 月 30 日起实施,高峰消耗约为低峰的两倍,夜间批量跑代码检查、测试分析这类异步任务能明显节省配额。
用 GLM-5.3 做一次演算:一个大型代码任务累计消耗普通输入 100,000 Token、缓存命中 300,000 Token、输出 30,000 Token,对应 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232 的参考积分价值。缓存命中占了输入的大头,这正是 Agent 任务的典型形态,也说明缓存费率对编程场景的总成本影响很大。
3 换一个 Harness,能否更接近 Astra + Codex?(路线 B)
3.1 OpenCode:重点是多模型自由
OpenCode 是开源 AI Coding Agent,支持大量 LLM Provider:用 /connect 添加服务商,用 /models 切换模型,支持自定义 Base URL 和本地模型,可在终端、桌面和部分开发环境中使用,具备文件检索、修改、命令执行和 Agent 工作流能力。阿里云已提供官方接入说明,选择 Alibaba Token Plan (China) 即可使用百炼套餐。
OpenCode 的官方安全说明值得认真对待:默认的本地 Agent 没有系统级安全隔离,权限审批无法替代容器或虚拟机。运行不可信代码或高权限自动化任务时,应放进 Docker 或虚拟机里执行。
3.2 Qwen Code、Kimi Code 与 DeepSeek Harness
三款原生 Harness 各自服务于对应的模型生态:
- Qwen Code:阿里云提供 CLI、桌面和 IDE 三种形态,登录百炼、选择地域、输入 API Key 即可接入,具备代码库检索、文件编辑和命令执行。主要使用千问模型、希望减少协议适配的团队优先考虑。
- Kimi Code CLI:月之暗面维护的终端编码工具,支持读改代码、调用 Shell、网页内容获取、会话恢复、计划与审批模式、编辑器集成,也能配置第三方兼容模型。Windows 通过官方 PowerShell 脚本安装,依赖 Git for Windows 的 Git Bash;旧版 Kimi CLI 已于 2026 年 9 月结束维护,新用户直接用 Kimi Code CLI。
- DeepSeek Harness:同时提供 Web UI 和 CLI 的开源 Agent 框架,支持自定义 Provider 和工具配置,可对接百炼不同计费方案。通过
npx @deepseek-ai/dsh web启动,默认地址为http://127.0.0.1:3080。选它时重点考察工具执行稳定性、权限控制和对目标模型协议的适配。
3.3 Harness 为什么会影响模型表现
同一个模型放进不同 Harness,结果差异可能很大,原因在于 Harness 决定了模型“看到什么、能做什么、错了之后怎么办”:
- 代码读取策略:一次读入多少文件、按什么顺序检索,决定模型对项目的理解是否完整。
- 工具循环设计:工具结果如何回传、失败后是否自动重试,决定长任务能否跑完。
- 上下文压缩:长会话中保留哪些历史、丢弃哪些细节,直接影响模型是否“忘记目标”。
- 补丁与测试:用整文件覆盖还是 diff 补丁、是否默认在修改后运行测试,决定改动的准确率和回归风险。
所以路线 B 测出来的成绩,是“模型 + 该 Harness”的组合成绩。拿它和路线 A 比较时,应当记住两边的执行策略本身就不同。
4 国内值得测试的模型有哪些?
4.1 Qwen4-Max-Preview
从公开规格看,1M 上下文、393,216 Token 的思考与输出共享预算、工具调用和结构化输出,使它适合测试复杂编码、长上下文分析和多轮 Agent 工作流。它同时兼容 Responses 和 Anthropic Messages,能接入 Codex,也能接入 Claude Code 类工具。
时间窗口是选它的首要约束:预览于 2026-11-25 24:00 结束并下线。推荐做法是在这段时间内用它跑完整套测试任务,把结果作为后续正式版 Qwen 模型的参照,生产环境同时配置一个长期可用的备选模型。
4.2 GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3
这四个系列都在 TokenHub 一个套餐内,按任务类型分配最省事:
- 复杂逻辑与多文件修改:GLM-5.3、Kimi K3、DeepSeek V4-Pro 作为高能力组对照。Kimi K3 输出单价在表中最高,适合放在最难的任务上检验上限。
- 代码定向任务:Kimi K2.7 Code 专门对照代码修改场景,也可以搭配 Kimi Code CLI 测原生体验。
- 高频低成本任务:GLM-5.3-Flash、DeepSeek V4-Flash 用于代码检查、批量重构等成本和速度敏感的场景。
- 长上下文稳定性与工具调用准确率:MiniMax M3 纳入候选,注意 512K 输入阈值以上价格上升。
4.3 如何判断谁最接近 Astra
上下文长度、参数量、宣传定位和 Token 单价都无法给模型排出可靠的名次,不同来源的宣传跑分也缺乏可比性。判断“谁最接近 Astra + Codex”,唯一可靠的办法是在同一个 Harness、同一批任务上,统一记录任务成功率、执行时间、Token 成本、工具兼容性和人工干预次数,具体方法见第 6 节。
5 三条复现路线,具体应该怎么选?
5.1 要原版 Codex 操作体验:选路线 A
保留 Codex Harness,接入正式支持 Responses 协议的国内服务。主力用 Qwen 选百炼,想在多个国产模型间切换选 TokenHub。优点是学习和迁移成本低,文件操作与 Agent 执行体系都是原版;取舍是模型智能与 Astra 存在差异,兼容接口的实现程度会影响工具调用体验,各模型的上下文和推理参数需要分别调。
5.2 要国产模型和多模型自由:选路线 B
OpenCode 搭配国内多模型 API,必要时补充 Qwen Code、Kimi Code 或 DeepSeek Harness。它最适合长期使用多模型、不希望绑定单一厂商的开发者,也最方便横向比较不同模型处理同一任务的表现。代价是执行策略与 Codex 不同,多 Provider 接入带来额外的配置和维护工作。
5.3 要最大程度保留 Astra 能力:选路线 C
路线 C 的组合是“原版 Codex CLI + GPT-6 Astra + 可用的 API 接入服务”。只要渠道确实提供原版 GPT-6 Astra,并完整支持 Codex 所需的 Responses API、流式事件、工具调用和上下文管理,就能同时保留模型和 Harness 两个核心组件。这条路线解决的是网络可用性,它和国产模型替代是两件事。
以 API易 为例,接入方式与路线 A 完全一致,只需换一组 Provider 配置:
model_provider = "APIYI"
model = "gpt-6-astra"            # 以 API易 控制台实际列出的模型 ID 为准
model_reasoning_effort = "high"  # 按任务难度在 low ~ max 之间调整

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
接入前建议先用一段脚本确认渠道真实支持 Responses 协议和工具调用,而不是只能返回普通文本:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # 替换为控制台中可用的模型 ID
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# 正常情况下应返回 function_call 类型的输出项,并带有结构化参数
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # 核对输入、输出、缓存与推理 Token 是否分项统计
这段探测覆盖了 Codex 最依赖的三件事:Responses 协议、Function Calling 回传、用量分项统计。脚本通过后再接入 Codex,跑一个包含“改代码 + 运行测试”的完整任务,确认流式事件和多轮工具循环正常。
即便模型相同,路线 C 的体验仍受实际模型路由、推理档位、API 延迟与输出吞吐、缓存命中、网关协议兼容性和渠道费用影响。Codex 桌面端、云端任务和 ChatGPT 账户专属功能依赖 OpenAI 自身的授权体系,通过 API Key 使用的是 Codex CLI 加模型 API 的组合,规划时应把这部分功能排除在外。
🚀 快速上手建议:想在路线 A 和路线 C 之间做对照,可以在 API易 apiyi.com 注册并领取免费测试额度,用同一个 Codex 环境分别跑国产模型和 GPT 系列模型。API易 的具体模型上架情况和协议支持,以控制台和 docs.apiyi.com 文档为准。
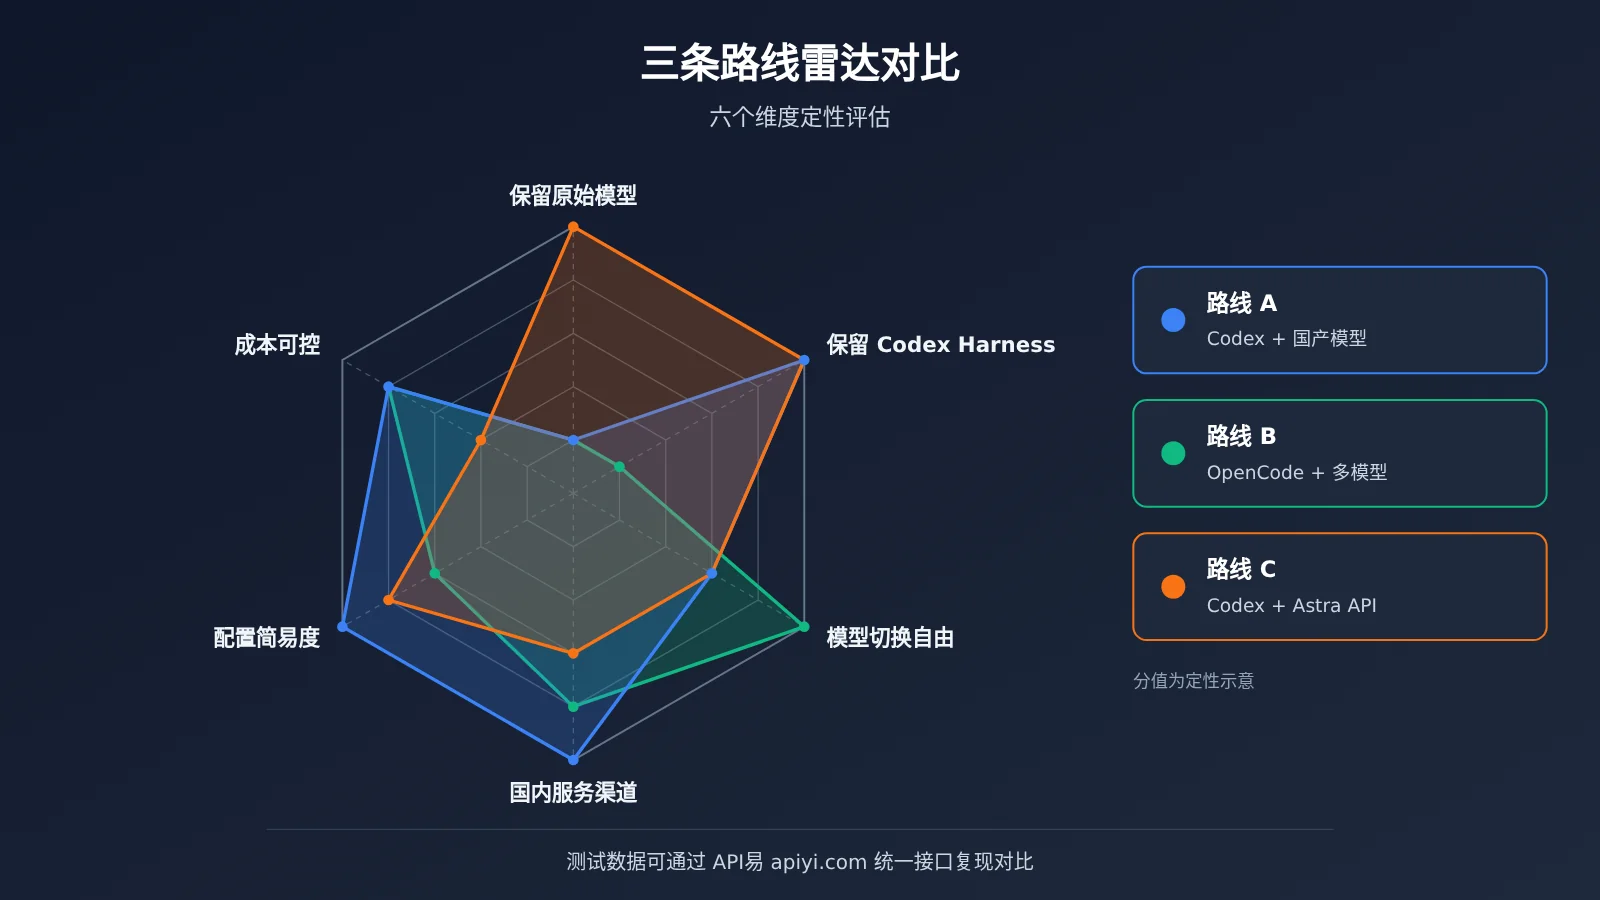
三条路线的取舍汇总如下:
| 对比维度 | 路线 A:Codex + 国产模型 | 路线 B:OpenCode 等 + 国内多模型 | 路线 C:Codex + Astra API |
|---|---|---|---|
| 保留原始模型 | 否,换为 Qwen / GLM / Kimi 等 | 否 | 是(以渠道可验证为前提) |
| 保留 Codex Harness | 是 | 否,换为开放 Harness | 是 |
| 模型切换 | 同一平台内改模型 ID | 多 Provider 自由切换 | 渠道支持的模型间切换 |
| 国内服务渠道 | 阿里云百炼、腾讯云 TokenHub | 百炼、TokenHub 及其他兼容服务 | 支持 Responses 的第三方渠道,如 API易 apiyi.com |
| 配置复杂度 | 低,官方给出现成配置 | 中,需维护多套 Provider | 低,前提是先验证协议 |
| 成本形态 | 包月套餐(Credits / 积分) | 套餐或按量,视 Provider 而定 | 按量计费,Astra 单价高于多数国产模型 |
| 适合需求 | 原版 Codex 体验 + 模型国产化 | 长期多模型工作流 | 最大限度保留原始能力 |
5.4 国内使用的网络与安全边界
模型 API 走国内可访问地址,只解决了模型调用这一段链路。Agent 在工作中还会访问 GitHub、npm 和 PyPI 等软件源、外部官方文档、第三方 MCP 服务和网页搜索,这些链路的可达性需要单独确认。联网搜索也是独立能力:云厂商的内置搜索、Harness 自带的联网工具和自建 Search API / MCP 各有访问、计费和调用限制。
安全上,编程 Agent 能修改文件、运行 Shell、读取环境变量,建议做到以下几点:
- API Key 存进环境变量或凭据管理工具,绝不写进源码和 Git 仓库。
- 复杂修改在独立 Git 分支上进行,项目保留版本控制和可恢复备份。
- 限制 Agent 访问工作目录之外的敏感文件,不可信代码放进容器或虚拟机。
- 删除、部署、付费等高风险操作保留人工审批。
6 真实任务测试比模型榜单更有价值
6.1 设置五类测试任务
用一个包含前端、后端、测试和依赖配置的真实项目,设计五类任务,分别检验模型能力和 Harness 能力:
- 项目理解:要求说明架构和关键模块关系,观察文件定位、跨文件依赖理解,以及能否给出可验证的路径引用。
- 跨文件开发:增加一个需要改动多处的新功能,观察修改准确性、功能完整性和是否引入回归。
- Bug 修复:提供带可复现失败测试的项目,观察是否找到根因、改对位置、主动运行测试且不破坏其他用例。
- 长程 Agent 工作流:完成“需求理解 → 代码修改 → 运行测试 → 发现失败 → 修复 → 复验”的连续链路,观察是否保持目标、能否根据报错调整策略。
- 联网文档查阅:阅读最新 SDK 文档后迁移一段旧 API 代码,观察能否实际联网抓取正文、是否把新 API 落实到代码,以及能否区分“工具不可用”和“检索结果为空”。
6.2 记录成功率、耗时与成本
每个“模型 + Harness”组合都跑同一套任务,至少重复三次取平均,并统一记录以下指标:
| 指标 | 计算或观察方式 |
|---|---|
| 任务成功率 | 成功完成任务数 / 总任务数 |
| 首次通过率 | 无人工修正、一次成功的比例 |
| 总任务耗时 | 从发出任务到最终验证成功 |
| 模型调用次数 | 每个任务累计的 API 请求数 |
| 工具调用次数 | 读取、编辑、Shell、搜索等调用次数 |
| Token 用量 | 输入、输出、缓存命中及推理用量分项 |
| 实际任务成本 | 完成一个成功任务的真实费用 |
| 人工干预次数 | 用户手动调整和修复的次数 |
为了让实验可复现,固定以下变量:同一份代码仓库快照、同一版本的 Harness、同一推理档位或思考设置、同一时段(对 DeepSeek 这类峰谷计费模型尤其重要)。每次任务开始前把仓库重置到快照,避免上一轮的修改影响下一轮。
6.3 以一次成功任务的成本作为核心采购指标
推荐的计算方式是:单次成功任务成本 = 全部尝试的总费用 ÷ 成功任务数。失败尝试的费用必须计入,因为它们同样消耗了额度。
单价低的模型未必便宜。一个模型如果需要更多轮推理、反复修改和重试,或者频繁需要人工介入,它完成一个任务的总消耗可能超过单价更高、一次就能做对的模型。反过来,在简单、高频的任务上,Flash 级模型的低单价和高速度往往能带来实实在在的节约。把成本算到“每个成功任务”上,两类模型才能放在同一把尺子上比较。
💰 成本评估建议:按量计费的渠道最便于做这类实验,因为每次请求的 Token 分项和费用都能逐笔核对。通过 API易 apiyi.com 用一个 Key 调用多个模型,可以把不同模型的账单放在同一个后台里统计单次成功任务成本。
7 API易 场景:让模型成为可替换组件
前面的分析指向同一个结论:稳定的 AI 编程环境,应当把 Harness 固定下来,把模型当作可替换的组件。Codex 或 OpenCode 负责执行与状态管理,API 渠道负责提供模型,模型按任务难度和预算灵活切换。
API易 apiyi.com 在这套架构里承担的是统一接入层:一个 API Key 调用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 协议,按量计费。对编程用户来说,选择任何一个 API 渠道(包括 API易)之前,都建议逐项核对以下内容:
- 是否支持当前 Codex 版本要求的 Responses API 与流式事件。
- 控制台列出的真实模型 ID,以及目标模型是否在架。
- 工具调用和 Function Calling 能否完整往返。
- 延迟和持续输出速度是否满足长任务需要。
- 缓存用量是否被正确识别和分项计费。
这些信息以服务控制台和技术文档为准,第 5.3 节的探测脚本可以直接用来验证。实际落地时,常见做法是把路线 A 的包月套餐用于日常高频任务,把按量渠道用于需要更强模型的难题和对比测试,两套 Provider 写在同一个 config.toml 里,用 --profile 或修改 model_provider 切换。
8 常见问题
Q1:国内复现 Astra + Codex,哪条路线还原度最高?
还原度最高的是路线 C:原版 Codex CLI 搭配真实可用的 GPT-6 Astra API,模型和 Harness 两个核心组件都得到保留。前提是渠道能被验证提供原版模型,并完整支持 Responses 协议与工具调用。如果要求模型国产化,路线 A 是还原 Codex 执行体验的最佳选择。
Q2:Qwen4-Max-Preview 适合长期用在 Codex 里吗?
它适合当前测评。该模型仅在百炼 Token Plan 中提供,预览期到 2026 年 11 月 25 日 24:00 结束后下线。建议趁预览期跑完测试任务,同时为生产环境准备一个长期可用的备选模型。
Q3:为什么新版 Codex 连不上阿里云旧版 Coding Plan?
Codex 从 0.94.0 起要求 Responses API,而旧版 Coding Plan 使用 Chat Completions 协议,官方要求搭配 Codex 0.93.0 或更早版本。改用 Token Plan 并设置 `wire_api = “responses”` 即可连接新版 Codex,注意 Token Plan 使用独立的 API Key。
Q4:百炼的 Credits 和 TokenHub 的积分能直接比较吗?
不能直接比较。两者是各自平台的计量单位,模型间扣减速率也不同。更可靠的做法是用同一个任务分别在两边运行,比较“完成一个成功任务消耗的套餐额度占月费的比例”。
Q5:如何快速验证一个第三方渠道能否跑 Codex?
先用第 5.3 节的 Python 脚本发一次带 function 工具的 Responses 请求,确认返回 `function_call` 输出项且用量分项统计正常,再接入 Codex 跑一个包含测试的完整任务。在 API易 apiyi.com 注册后可以领取免费测试额度完成这一步验证,具体可用模型以控制台为准。
Q6:同一个模型在 OpenCode 和 Codex 里表现不同,正常吗?
正常。Harness 决定了代码读取策略、工具循环、上下文压缩和测试习惯,这些都会改变模型的实际表现。对比时应固定 Harness 测模型,或固定模型测 Harness,避免两个变量同时变化。
Q7:通过 API Key 使用 Codex,能获得 ChatGPT 订阅里的 Codex 功能吗?
API Key 方式提供的是 Codex CLI 加模型 API 的组合。Codex 云端任务、桌面端和 ChatGPT 账户专属功能依赖 OpenAI 的账户授权,第三方 API 渠道无法提供这部分权益。
Q8:多模型切换时,怎么控制总成本?
按任务分层:难题用高能力模型,批量检查和简单重构交给 Flash 级模型,支持峰谷计费的模型把异步任务放到夜间。统一用“单次成功任务成本”评估,按量渠道如 API易 apiyi.com 便于逐笔核对每个模型的实际消耗。
9 总结:Key Takeaways
- 三条路线三种侧重:路线 A 保 Codex 体验,路线 B 保模型自由,路线 C 保原始模型。
- Astra + Codex 是五层组合:模型、执行系统、工具生态、状态管理、使用体验共同决定结果。
- 路线 A 有现成配置:百炼与 TokenHub 都提供官方 Codex 配置,核心是
wire_api = "responses"。 - Qwen4-Max-Preview 有截止日期:仅限 Token Plan,2026-11-25 24:00 结束预览并下线。
- 套餐单位不可混比:Credits、积分、Token、人民币分属不同计量体系,按任务实测才可比较。
- 用任务说话:五类真实任务、八项指标,以单次成功任务成本作为采购依据。
- 模型做成可替换组件:固定 Harness、统一接入渠道,按任务切换模型,环境才稳定可控。
最务实的起步方式,是在同一个 Codex 环境中配置两个 Provider:一个国内云套餐承担日常任务,一个按量渠道承担对照测试和高难度任务,用第 6 节的方法跑一轮,再决定长期组合。推荐通过 API易 apiyi.com 快速搭建对照组,用统一接口把国产模型和 GPT 系列放在同一套任务上验证。
📚 参考资料
- GPT-6 Astra 官方模型文档:模型规格、推理档位与定价
- 链接:
developers.openai.com/api/docs/models/gpt-6-astra -
说明:上下文窗口、最大输出、工具支持与长上下文费率
-
OpenAI Codex Harness:Codex 执行框架设计
- 链接:
developers.openai.com/blog/codex-as-a-platform -
说明:Agent 循环、工具回传、上下文管理与沙盒的官方说明
-
阿里云百炼 Codex 接入:Token Plan 配置方法
- 链接:
help.aliyun.com/zh/model-studio/codex -
说明:config.toml 字段、Responses 协议与版本要求
-
阿里云 Token Plan 个人版:套餐价格与 Credits
- 链接:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
说明:2026-11-09 调整后的档位、额度与首购优惠
-
Qwen4-Max-Preview 官方文档:模型规格与预览周期
- 链接:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
说明:1M 上下文、协议兼容与下线时间
-
腾讯云 TokenHub Codex CLI 配置:官方接入教程
- 链接:
cloud.tencent.cn/document/product/1823/130071 -
说明:Provider 配置与模型 ID 替换方法
-
腾讯云 TokenHub 套餐与积分费率:计费规则
- 链接:
cloud.tencent.cn/document/product/1823/130060 - 链接:
cloud.tencent.com/document/product/1823/133811 -
说明:套餐档位、模型积分费率与峰谷计费
-
OpenCode 官方仓库:开源 Coding Agent
- 链接:
github.com/anomalyco/opencode -
说明:Provider 配置与安全说明
-
Qwen Code、Kimi Code CLI、DeepSeek Harness:原生 Harness
- 链接:
help.aliyun.com/zh/model-studio/qwen-code - 链接:
github.com/MoonshotAI/kimi-code - 链接:
help.aliyun.com/zh/model-studio/deepseek-harness - 说明:安装、接入与能力范围
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心