作者注:系統講解 Agent 上下文自動壓縮的 3 種觸發時機、摘要保留策略與可運行代碼,幫你在長對話中控制 Token 消耗,同時不丟失關鍵任務信息。
在 Codex 這類編碼 Agent 裏連續工作幾個小時後,很多開發者會冒出同一個疑問:輸入框附近只顯示權限模式和當前模型,看不到上下文用了多少,那到底什麼時候該新開一個窗口?對話越長,每一輪請求都要帶上更多歷史,額度消耗自然更快。本文要講的是 Agent 上下文自動壓縮(Context Compaction)的觸發時機與摘要策略,幫助你理解 Codex 一類工具背後的機制,並在自己的 Agent 裏實現同樣的能力。
這不是又一篇“記得清理聊天記錄”的泛泛建議,而是基於 OpenAI 與 Anthropic 官方文檔中已公開的壓縮機制,結合工程實踐整理出的可落地方案。
核心價值:讀完本文,你將清楚 Agent 上下文自動壓縮在什麼時候觸發、摘要裏該保留什麼、該丟掉什麼,並拿到一份可以直接改造使用的 Python 實現。
Agent 上下文自動壓縮核心要點
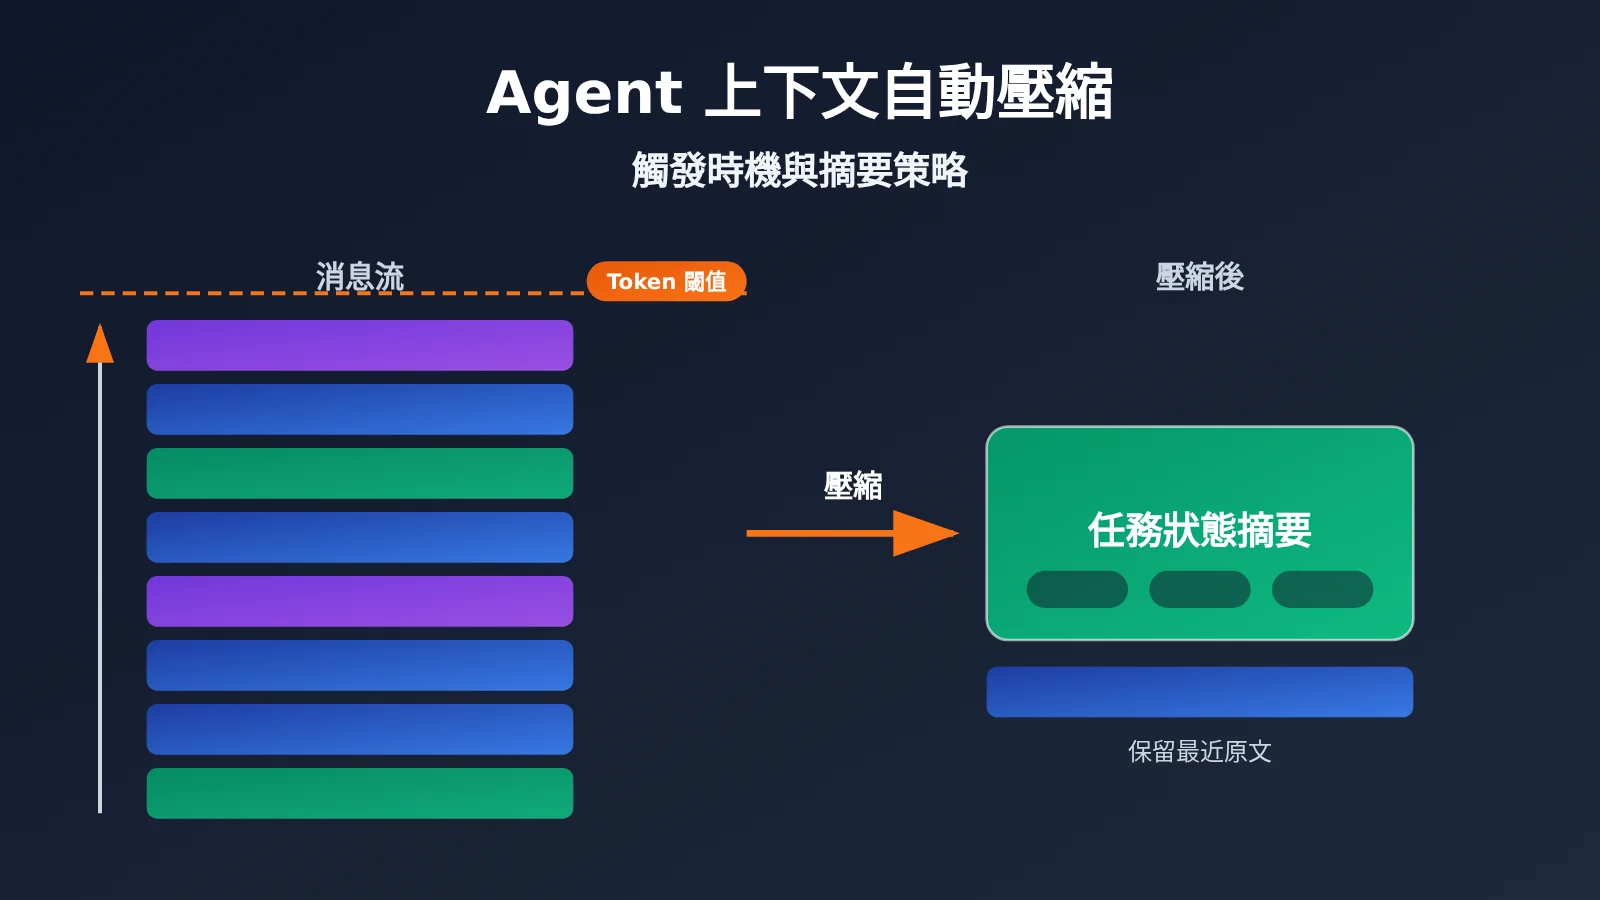
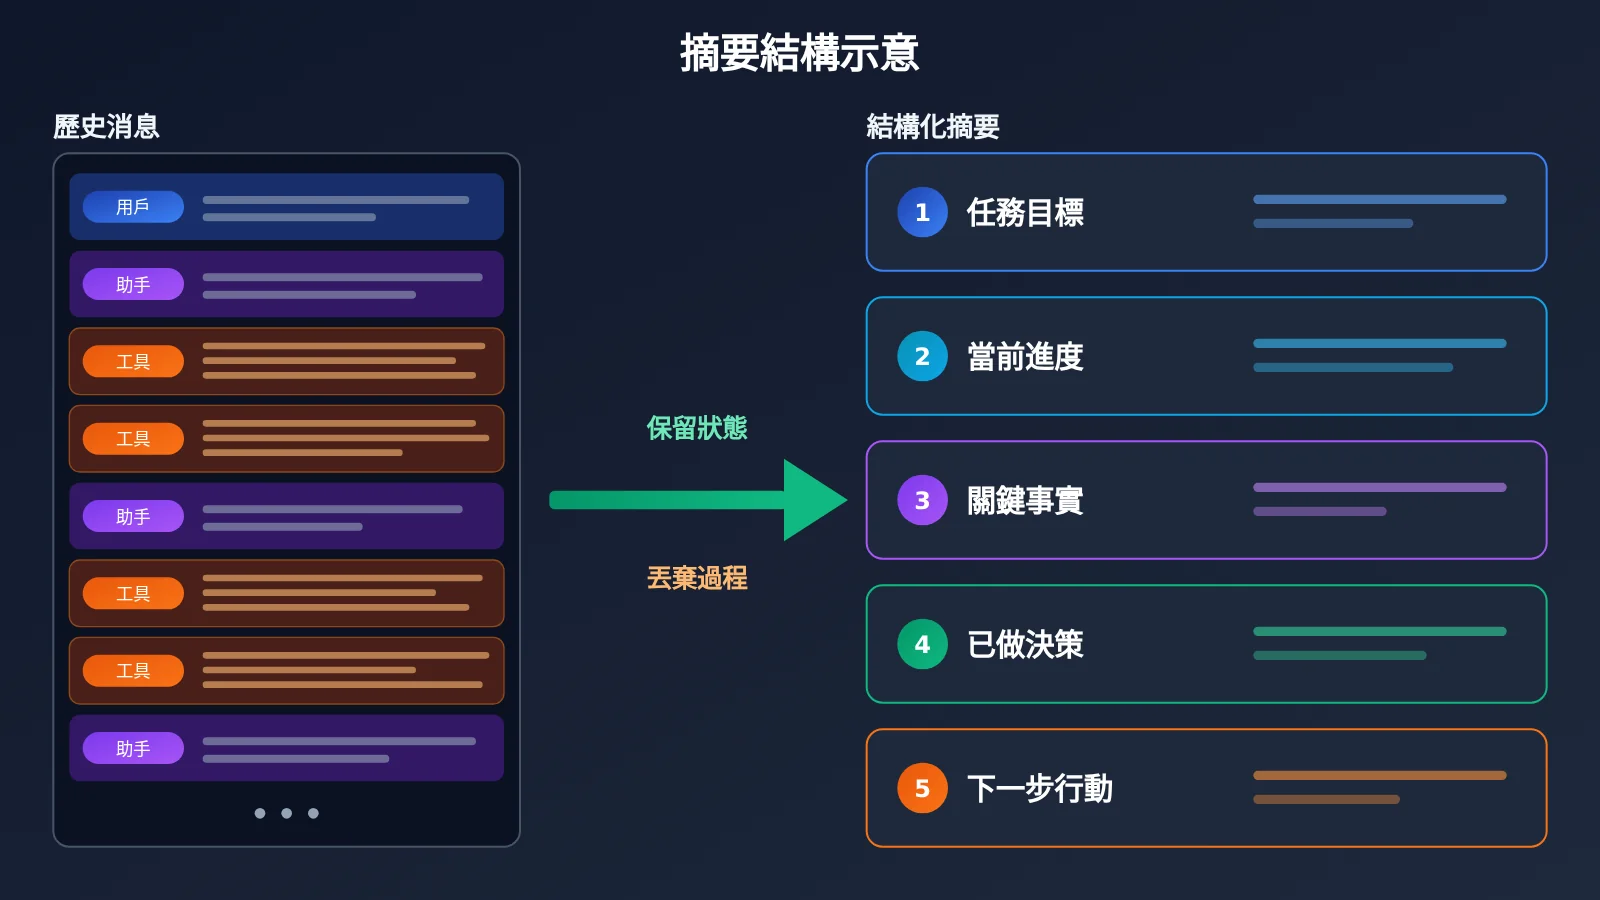
先給出結論:Agent 上下文自動壓縮通常在上下文達到指定 Token 閾值時觸發,把較早的對話和工具調用記錄壓縮成一份“還能繼續幹活”的狀態描述。它的目標不是單純縮短聊天記錄,而是保住任務進度、重要事實、已完成操作、關鍵決策和下一步行動,同時去掉冗餘的過程信息。
| 要點 | 說明 | 價值 |
|---|---|---|
| Token 閾值觸發 | 上下文達到預設 Token 數後自動壓縮 | 無需人工干預,防止撐爆窗口 |
| 主動壓縮 | 應用在特定時機(如完成一個任務階段)主動調用壓縮 | 在語義邊界壓縮,信息損失最小 |
| 框架自動管理 | 由 SDK 或 Agent Runtime 根據上下文壓力決定 | 開箱即用,適合快速搭建 |
| 摘要而非截斷 | 保留進度、事實、決策、下一步 | 壓縮後 Agent 仍能接着執行 |
| 按階段壓縮 | 不建議每輪都壓縮 | 兼顧緩存命中與信息完整度 |
爲什麼 Agent 需要上下文自動壓縮
大模型 API 本身是無狀態的。所謂“多輪對話”,本質上是每一輪都把完整的 messages 歷史重新發給模型,所以第 50 輪的請求裏包含前 49 輪的全部內容,輸入 Token 呈線性甚至更快地增長。對 Agent 來說情況更嚴重,因爲工具調用的返回結果(文件內容、終端輸出、搜索結果)往往非常長,幾輪工具調用就能佔滿大半個窗口。
這帶來兩個直接問題:一是成本,每輪輸入 Token 越多,額度消耗越快;二是質量,上下文過長時模型對早期關鍵信息的注意力會被稀釋,甚至超出窗口直接報錯。Agent 上下文自動壓縮就是在這兩個問題之間找平衡:在信息還完整、窗口還沒滿的時候,把歷史“摺疊”成一份精煉的狀態,讓後續請求輕裝上陣。
關於 Codex 不顯示上下文用量
客戶端爲什麼不再顯示上下文窗口大小,我們沒有看到官方給出的明確解釋,這裏不做猜測。可以確定的是,Codex 自帶上下文壓縮機制,長對話不會無限制地累積全部原始歷史。如果你想精確觀察每一輪的消耗,最可靠的辦法是在 API 層面看調用日誌,後文會講具體做法。
Agent 上下文自動壓縮的 3 種觸發時機
很多人默認“上下文用到 80% 就壓縮”,但這其實不是官方規則。官方 API 文檔主要以 Token 數量閾值 定義觸發條件,而不是固定的窗口百分比。另外,壓縮也不一定要等到接近上限,OpenAI 和 Anthropic 都支持主動壓縮。
官方實現的觸發規則對比
| 實現方式 | 自動觸發規則 | 官方說明 |
|---|---|---|
| OpenAI Responses API | 渲染後的 Token 數達到 compact_threshold |
閾值可自定義,服務端自動處理 |
| OpenAI Agents SDK | 上下文壓力或顯式閾值策略 | 支持自動、固定閾值和強制壓縮 |
| Anthropic Messages API | 輸入 Token 達到 trigger.value |
默認 150,000,最低 50,000 |
| Anthropic Tool Runner | 達到 context_token_threshold |
默認 100,000 |
| Anthropic 按需壓縮 | 應用程序主動發起 | 可在一個完整對話輪次結束後調用 |
從這張表能看出一個共性:自動觸發幾乎都以“輸入 Token 數”爲判斷依據,閾值可配置;同時都保留了“由應用主動決定何時壓縮”的入口。
時機一:Token 閾值觸發
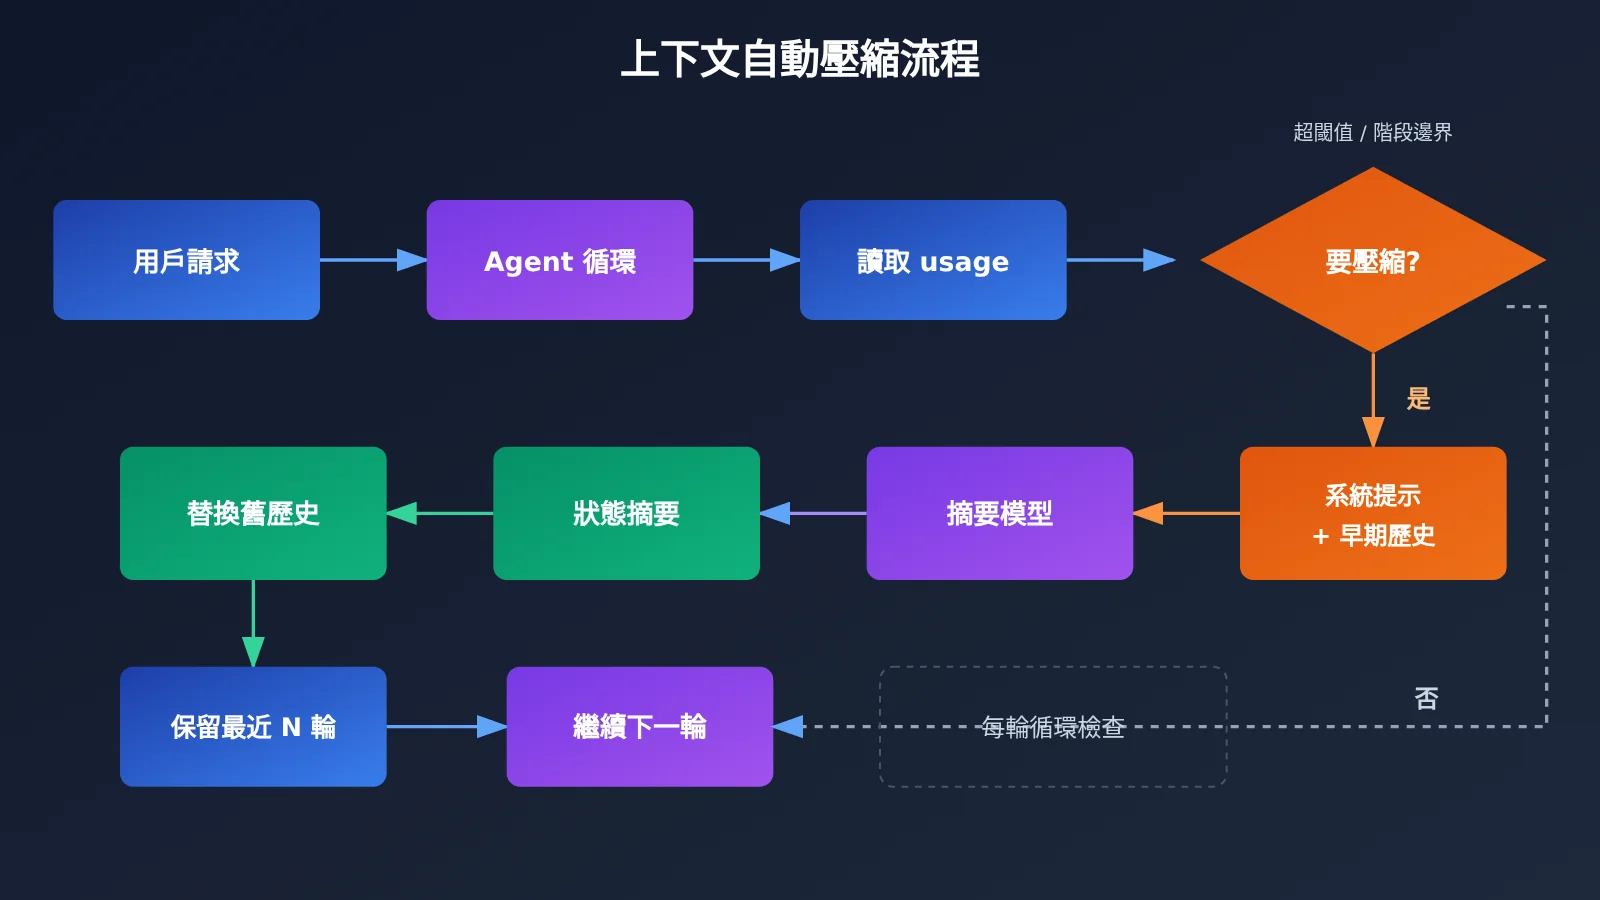
這是最基礎的保底機制。每輪調用結束後,讀取接口返回的輸入 Token 數,一旦超過你設定的閾值就執行壓縮。閾值不宜貼着窗口上限設,因爲壓縮本身需要把舊歷史再發一次給摘要模型,還要給下一輪的工具輸出留出餘量。
實踐中可以參考 Anthropic 的默認值思路:在長窗口模型上把閾值設在十萬 Token 量級,並保證閾值以上仍有足夠空間容納一次完整的工具調用返回。
時機二:任務階段邊界主動壓縮
這是信息損失最小的方式。OpenAI 官方建議在完成一個有意義的工作階段後再壓縮,而不是每輪都壓縮。比如 Agent 剛完成“定位 Bug → 修改代碼 → 跑通測試”這一整段,此時中間的試錯過程已經沒有價值,只需要記住“改了哪個文件、爲什麼改、測試已通過”。
在階段邊界壓縮,摘要更容易寫得準確,因爲任務處於一個“乾淨”的狀態,沒有半截的工具調用懸而未決。
時機三:交給框架按上下文壓力管理
如果你用的是 Agents SDK 或 Tool Runner 這類框架,可以直接開啓內置的壓縮策略,由運行時根據上下文壓力自動決定。這種方式省心,但你對摘要內容的控制力較弱,適合原型階段或通用場景。
🎯 技術建議:三種時機並不互斥。推薦的組合是“階段邊界主動壓縮爲主,Token 閾值觸發兜底”。如果想在不同模型上驗證閾值設置是否合理,可以通過 API易 apiyi.com 用同一個 Key 切換 OpenAI、Claude、Gemini 等模型對比測試。
Agent 上下文自動壓縮的摘要策略
觸發時機解決“什麼時候壓”,摘要策略解決“壓成什麼樣”。壓縮失敗最常見的表現是:壓縮後 Agent 忘了用戶最初的約束,或者重複執行已經做過的操作。根本原因是摘要只記錄了“聊了什麼”,而沒有記錄“任務狀態是什麼”。
摘要中該保留與可丟棄的內容
| 類別 | 應保留 | 可丟棄 |
|---|---|---|
| 任務目標 | 用戶原始需求、硬性約束、驗收標準 | 寒暄、重複確認 |
| 任務進度 | 已完成的步驟、當前所處階段 | 每一步的詳細推理過程 |
| 重要事實 | 文件路徑、函數名、配置值、報錯關鍵行 | 完整的文件內容、冗長日誌 |
| 關鍵決策 | 選了哪個方案以及原因 | 被否決方案的展開討論 |
| 下一步行動 | 待辦清單、未解決問題 | 已完成且無後續影響的細節 |
5 步落地摘要策略
- 固定保留系統提示詞:系統提示不參與壓縮,始終放在 messages 最前面。
- 保留最近 N 輪原文:最近幾輪對話通常與當前操作強相關,原樣保留,只壓縮更早的部分。
- 結構化摘要模板:要求摘要模型按“目標 / 進度 / 事實 / 決策 / 下一步”五個欄目輸出,避免自由發揮導致遺漏。
- 工具結果先瘦身:對超長的工具返回只保留關鍵片段,例如報錯的首尾幾行、搜索結果的標題與結論。
- 用戶原話單獨存檔:用戶給出的明確約束(如“不要改動公共接口”)建議逐字保留,不交給模型改寫。
結構化模板是其中最關鍵的一步。模型做“自由摘要”時傾向於概括對話氛圍,而結構化欄目會逼它逐項覈對,保住可執行的狀態信息。
Agent 上下文自動壓縮快速上手
下面用客戶端手動管理 messages 的方式實現一個通用版本,適用於任何 OpenAI 兼容接口。思路是:每輪調用後從 usage.prompt_tokens 讀取輸入 Token 數,超過閾值就把早期歷史交給摘要模型壓縮。
極簡示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一個編碼助手。"}]
messages.append({"role": "user", "content": "幫我檢查這個函數的邊界條件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每輪記錄輸入 Token,作爲是否壓縮的判斷依據
print("本輪輸入 Token:", resp.usage.prompt_tokens)
查看完整的 Agent 上下文自動壓縮實現代碼
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任務模型,可按需替換
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 輸入 Token 閾值,兜底觸發
KEEP_RECENT = 6                 # 保留最近 N 條消息原文

SUMMARY_PROMPT = """請把以下 Agent 對話歷史壓縮爲任務狀態摘要,嚴格按五個欄目輸出:
【任務目標】用戶原始需求與硬性約束(約束請逐字保留)
【當前進度】已完成的步驟與當前階段
【關鍵事實】文件路徑、函數名、配置值、關鍵報錯
【已做決策】採用的方案及原因
【下一步行動】待辦事項與未解決問題
不要記錄寒暄和推理過程,不要編造歷史中沒有的信息。"""


def compact(messages: list) -> list:
    """把早期歷史壓縮爲一條摘要消息,保留系統提示與最近對話。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下爲之前對話的壓縮摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 時機一:上一輪輸入 Token 超過閾值時先壓縮
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 時機二:完成一個任務階段後主動壓縮
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一個嚴謹的編碼助手。")
print(agent.chat("幫我定位登錄接口偶發 500 的原因"))
agent.finish_stage()  # 修復完成後,在階段邊界主動壓縮
🚀 快速開始:通過 API易 apiyi.com 註冊即可獲得免費測試額度,上面的代碼只需替換 API Key 就能運行。平臺爲 OpenAI 兼容接口,主模型和摘要模型可以分別選用不同廠商的模型,方便控制成本。
Agent 上下文自動壓縮的實現方案對比
| 方案 | 核心特點 | 適用場景 | 可用平臺 |
|---|---|---|---|
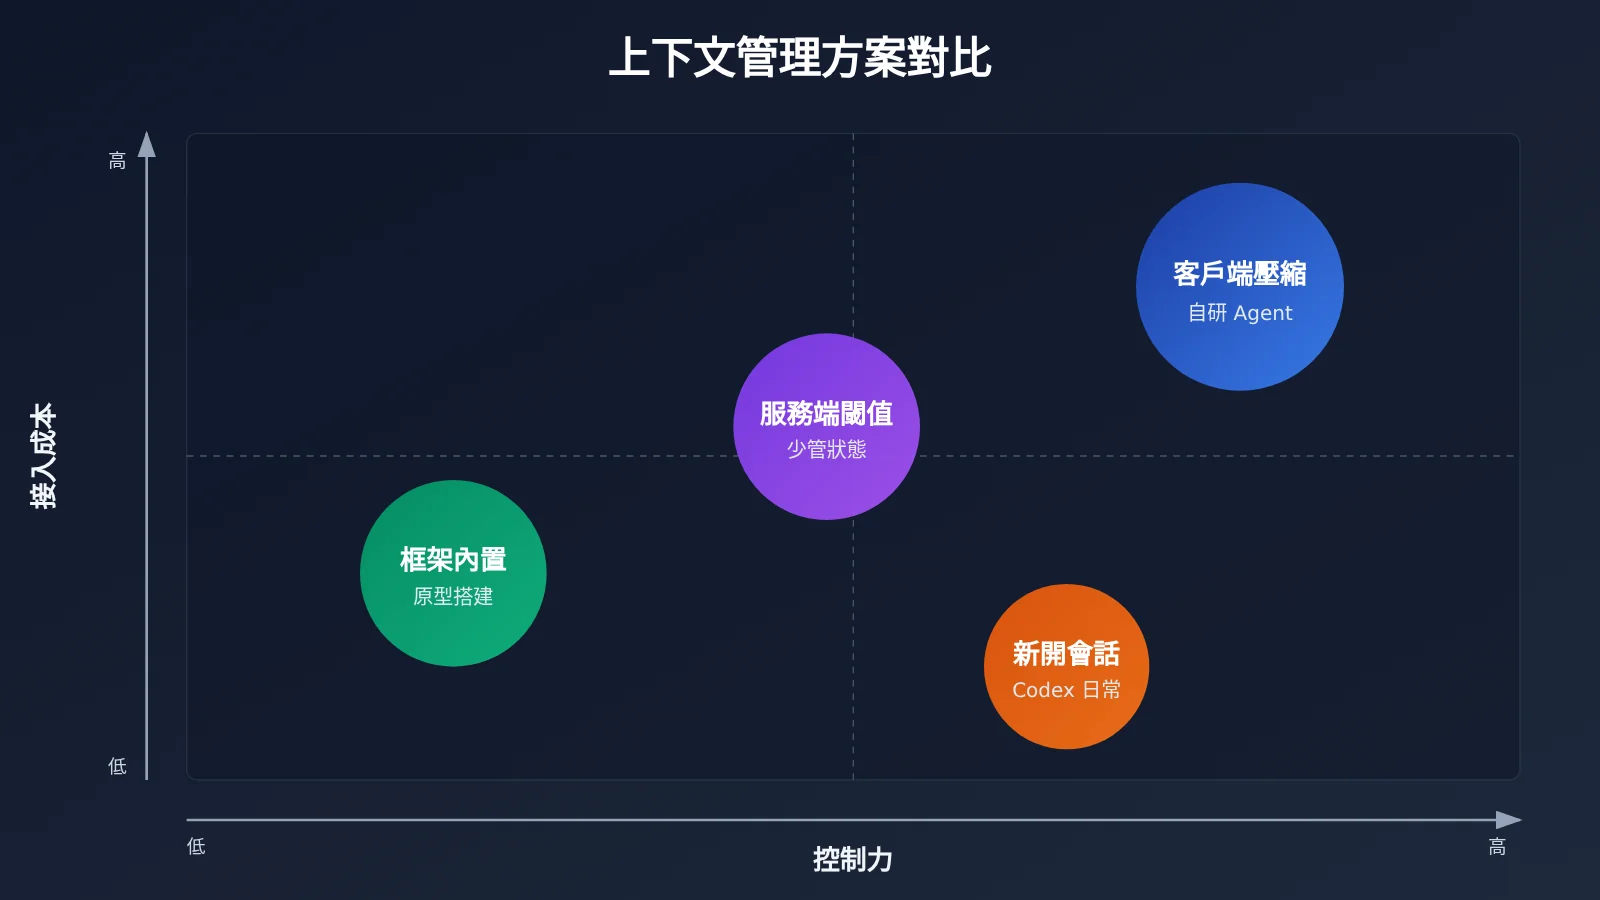
| 客戶端手動壓縮 | 自己拼接 messages,摘要邏輯完全可控 | 自研 Agent、需定製摘要模板 | API易 apiyi.com、各官方 API |
| 服務端閾值壓縮 | 如 Responses API 的 compact_threshold |
希望減少客戶端狀態管理 | 支持該接口的平臺 |
| 框架內置壓縮 | Agents SDK、Tool Runner 自動管理 | 原型搭建、通用任務 | 依賴對應 SDK |
| 直接新開會話 | 手動總結後開新窗口 | Codex 等客戶端日常使用 | 任意客戶端 |
客戶端手動壓縮在控制力上保持領先,但需要自己維護 Token 統計和摘要質量。服務端壓縮省去了歷史拼接,不過摘要細節對開發者不透明。對於自研 Agent,“客戶端結構化摘要 + 閾值兜底”通常是更穩妥的組合。
Agent 上下文自動壓縮與緩存成本的關係
壓縮看上去一定省錢,但還要考慮 Prompt Caching。按照 API易 的 OpenAI 緩存計費說明,緩存命中的輸入部分按輸入價的 1 折計費。長對話中,歷史前綴保持不變時很容易命中緩存,這時每輪新增的“全價”Token 其實並不多。
一旦執行壓縮,消息前綴被替換成新的摘要,下一輪請求的緩存會失效,需要按全價重新計算一次。這正是官方不建議“每輪都壓縮”的原因:頻繁壓縮會反覆打斷緩存,有時反而比不壓縮更貴。比較合理的節奏是讓歷史在一個階段內穩定增長、充分喫到緩存,到階段結束或接近閾值時再集中壓縮一次。
常見問題 FAQ
Q1: 什麼是 Agent 上下文自動壓縮?
它是指在上下文達到一定 Token 量或到達任務階段邊界時,把較早的對話、工具調用記錄壓縮爲一份任務狀態摘要,替換原始歷史。目的是降低每輪輸入 Token,同時保留進度、事實、決策和下一步行動,讓 Agent 能繼續執行。
Q2: 上下文壓縮和直接截斷歷史有什麼區別?
截斷只是刪掉最早的消息,實現簡單,但會丟失用戶最初的需求和約束。壓縮則用模型把歷史提煉成結構化摘要,信息保留度高得多。代價是多一次摘要調用,以及壓縮後緩存需要重新建立。
Q3: 是否有統一的“用到 80% 就壓縮”的規則?
沒有。官方文檔主要按 Token 數量閾值定義觸發條件,例如 Anthropic Messages API 默認 150,000、最低 50,000,Tool Runner 默認 100,000。閾值應結合所用模型的窗口大小和單次工具輸出的體量來設置。
Q4: 在 Codex 裏什麼時候應該新開窗口?
建議在一個完整任務階段結束後新開,例如一個功能開發完成並通過測試。新開前可以讓 Agent 按“目標 / 進度 / 事實 / 決策 / 下一步”輸出一份總結,粘貼到新會話開頭。如果你要切換到一個和當前任務無關的新話題,也應直接新開窗口,避免無關歷史持續消耗額度。
Q5: 客戶端不顯示上下文用量,怎麼觀察 Token 消耗?
可以在 API 層面查看。按照 OpenAI Codex 使用場景文檔,把 Codex 的接口配置到 API易 後,每次調用都會在 API易 apiyi.com 後臺留下詳細日誌與用量統計,能直觀看到長對話中每輪輸入 Token 的增長曲線,以此判斷何時壓縮或新開會話。
Q6: 如何快速驗證自己的壓縮策略效果?
用本文的完整代碼,分別在“不壓縮”“閾值壓縮”“階段壓縮”三種模式下跑同一個多步任務,對比總 Token 消耗和任務完成質量。通過 API易 apiyi.com 可以用一個 Key 讓主模型與摘要模型分別使用不同廠商的模型,便於找到成本與質量的平衡點。
Q7: 上下文壓縮有哪些已知的限制?
一是摘要可能遺漏細節,尤其是代碼中某個不起眼的配置值;二是每次壓縮會讓緩存失效,頻繁壓縮會推高成本;三是摘要模型偶爾會“補全”不存在的信息。應對辦法是使用結構化模板、逐字保留用戶約束,並把關鍵事實(如文件路徑)寫進外部的任務筆記文件而不只依賴摘要。
Agent 上下文自動壓縮核心要點 Key Takeaways
- 壓縮的本質:把冗長曆史轉成可繼續執行的任務狀態,而非簡單刪減記錄。
- 三種觸發時機:Token 閾值兜底、階段邊界主動壓縮、框架按上下文壓力管理。
- 沒有 80% 規則:官方以 Token 數閾值爲準,閾值需結合窗口與工具輸出體量設置。
- 結構化摘要:按目標、進度、事實、決策、下一步五欄輸出,用戶約束逐字保留。
- 別每輪都壓縮:頻繁壓縮會打斷緩存命中,按階段集中壓縮更省錢。
- 用日誌彌補盲區:客戶端不顯示用量時,可在 API易 apiyi.com 調用日誌中觀察每輪 Token 增長。
總結
Agent 上下文自動壓縮的核心要點:
- 觸發時機:以階段邊界主動壓縮爲主,Token 閾值觸發作爲兜底,框架內置策略適合快速起步。
- 摘要策略:保留系統提示與最近幾輪原文,早期歷史壓縮爲五欄結構化摘要。
- 成本平衡:壓縮會讓緩存失效,節奏應是“階段內穩定增長、階段末集中壓縮”。
如果你日常使用 Codex,可以把“階段完成就總結並新開窗口”當作手動版壓縮;如果你在自研 Agent,直接改造本文代碼即可。推薦通過 API易 apiyi.com 快速驗證效果,平臺提供免費測試額度和多模型統一接口,配合調用日誌能清楚看到壓縮前後的 Token 變化。
📚 參考資料
- OpenAI Responses API 文檔:上下文壓縮與
compact_threshold配置說明 - 鏈接:
platform.openai.com/docs/api-reference/responses -
說明: 瞭解服務端自動壓縮與狀態管理的官方說明
-
OpenAI Agents SDK 文檔:Agent 運行時的上下文管理策略
- 鏈接:
openai.github.io/openai-agents-python -
說明: 自動、固定閾值與強制壓縮等策略的配置方式
-
Anthropic 上下文壓縮文檔:Messages API 與 Tool Runner 的壓縮觸發參數
- 鏈接:
docs.anthropic.com - 說明:
trigger.value、context_token_threshold的默認值與按需壓縮用法
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,Codex 配置、多輪對話與緩存計費等更多資料可訪問 docs.apiyi.com 文檔中心