作者注:MiniMax M3.1 Flash 的權重計劃在 10 月 23 日放出。本文說明本地部署大概需要什麼級別的硬件,並從 4 個維度比較“自己部署”和“直接調 API”哪個更划算。
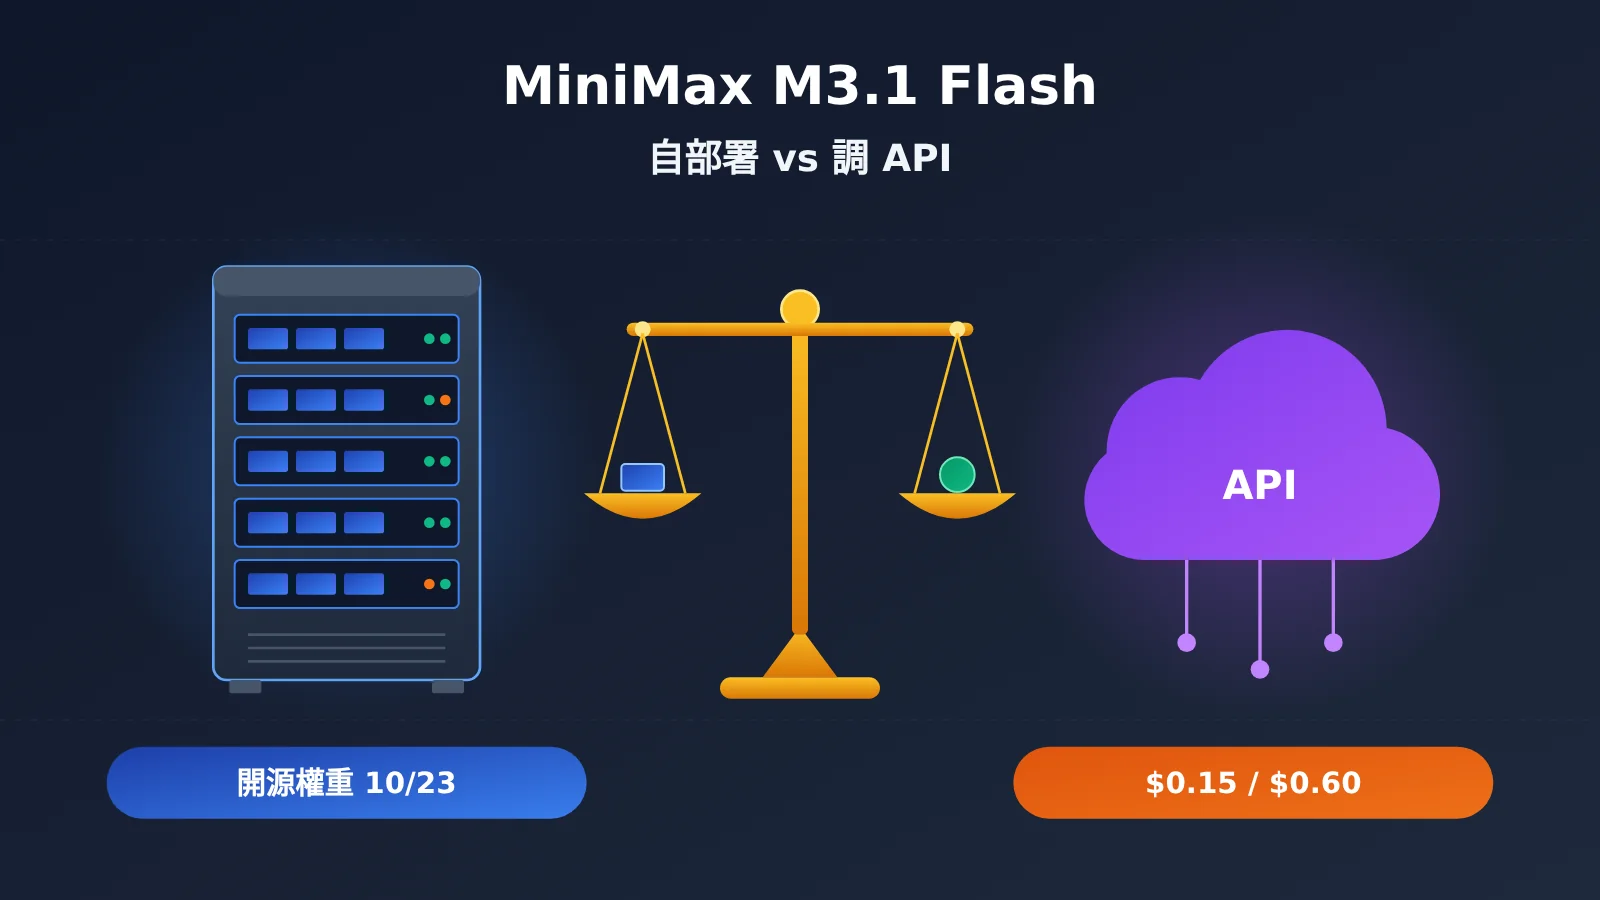
先說結論:對絕大多數個人開發者和小團隊,直接調用 每百萬 tokens 輸入 $0.15、輸出 $0.60 的 API,比自己部署省錢也省事得多。 只有三種情況值得考慮自部署:數據按規定不能出內網,調用量大到能讓一整臺多卡服務器長期滿載,或者你需要修改、微調模型本身。
這篇不是勸退開源。 開源權重對行業有價值,但“能下載”和“值得自己跑”是兩件事。M3.1 Flash 的發佈新聞本站已經單獨寫過,本文不再複述,只回答兩個問題:本地部署要什麼配置,以及自部署和調 API 哪個划算。
核心價值:讀完本文,你能判斷自己該不該等這份權重,以及等到之後要先確認哪些信息。
MiniMax M3.1 Flash 開源權重現狀:哪些已確定,哪些還沒公佈
先解釋一個詞。開源權重指模型訓練好的參數文件公開發布,你可以下載到自己的服務器上運行。它和“開源代碼”不同,也不等於隨便商用,能怎麼用要看許可證。
截至發稿(2026 年 10 月 22 日),M3.1 Flash 的權重還沒有正式放出。MiniMax 官方 X 帖寫的是“Model weights will arrive on Oct 23”,也就是計劃 10 月 23 日發佈。官方博客只說“稍後發佈”。另據上海紐約大學 RITS 的報道,10 月 20 日 MiniMax 的 Hugging Face 組織下還沒有 M3.1 Flash 的倉庫。
爲了區分信息的可靠程度,本文把事實分成三檔:官方自報(MiniMax 自己公佈)、第三方測評(如 Vals AI)、未知/未公佈。
| 信息項 | 現狀 | 信息檔位 |
|---|---|---|
| 權重發布時間 | 官方 X 帖稱 10 月 23 日;官方博客只寫“稍後” | 官方自報(計劃,尚未完成) |
| 模型規模 | MoE 架構,總參數 428B,激活約 23B,與 M3 相同 | 官方信息,經媒體報道 |
| 許可證 | M3.1 Flash 的許可證尚未公佈 | 未知/未公佈 |
| 部署硬件要求 | 官方部署指南還沒有 M3.1 Flash | 未知/未公佈 |
| 技術報告 | 尚未發佈說明 Flash 相比 M3 改了什麼 | 未知/未公佈 |
| 參考對象 M3 | 權重 6 月起已在 Hugging Face 上,採用社區許可證 | 官方信息 |
⚠️ 提醒:權重放出後,許可證條款、文件大小、推薦硬件都以 Hugging Face 上的 MiniMax 官方模型頁爲準。社區轉載的量化版本不在官方驗證範圍內,不要把它們當作官方配置。
MiniMax M3.1 Flash 本地部署要什麼配置
官方還沒公佈 M3.1 Flash 的硬件要求,所以這裏不推測顯存和 GPU 數量。能參考的是同規模的上一代 M3。兩者的總參數(428B)和激活參數(約 23B)相同,可以拿 M3 來估計大致量級。
先理解 MiniMax M3.1 Flash 的“428B 總參數、23B 激活”
MoE(混合專家)是一種模型結構:模型由很多“專家”子網絡組成,每次推理只調用其中一部分。“激活約 23B”說的是每生成一個 token 實際參與計算的參數量,所以速度可以比較快。
但有一點容易誤解:激活參數少,不代表顯存需求小。 全部 428B 參數都要裝進顯存(GPU 上的專用內存),推理時才能隨時調用任意專家。這也是 MoE 大模型本地部署門檻高的主要原因。
MiniMax 官方給出的 M3 參考部署(僅作量級參考)
幾個術語先解釋一下。MXFP8 是一種 8 位精度的存儲格式,可以縮小模型文件和顯存佔用。SGLang 是開源推理框架,能把模型跑成一個兼容 OpenAI 格式的 API 服務。TP(張量並行)是把一個模型拆到多張顯卡上協同運行的方式。
| 模型 | 官方參考配置 | 權重體積 | 狀態 |
|---|---|---|---|
| MiniMax-M3 | 8 × B200,MXFP8 精度,SGLang 的 OpenAI 兼容接口 | MXFP8 版本約 440 GB | Experimental(實驗性) |
| MiniMax-M2.7 | 4 張大顯存 NVIDIA GPU,TP 4 | 未公佈統一最低顯存 | Preview |
| MiniMax-M3.1 Flash | 官方部署指南暫未覆蓋 | 未公佈 | 未知/未公佈 |
再強調一次:上表中 M3 的數據不是 M3.1 Flash 的官方要求。 它說明的是,同規模模型的官方參考方案需要 8 張數據中心級 GPU,單是 MXFP8 權重就有約 440 GB。這個級別遠超消費級顯卡和普通工作站,個人在家用一兩張遊戲顯卡跑起完整版是不現實的。
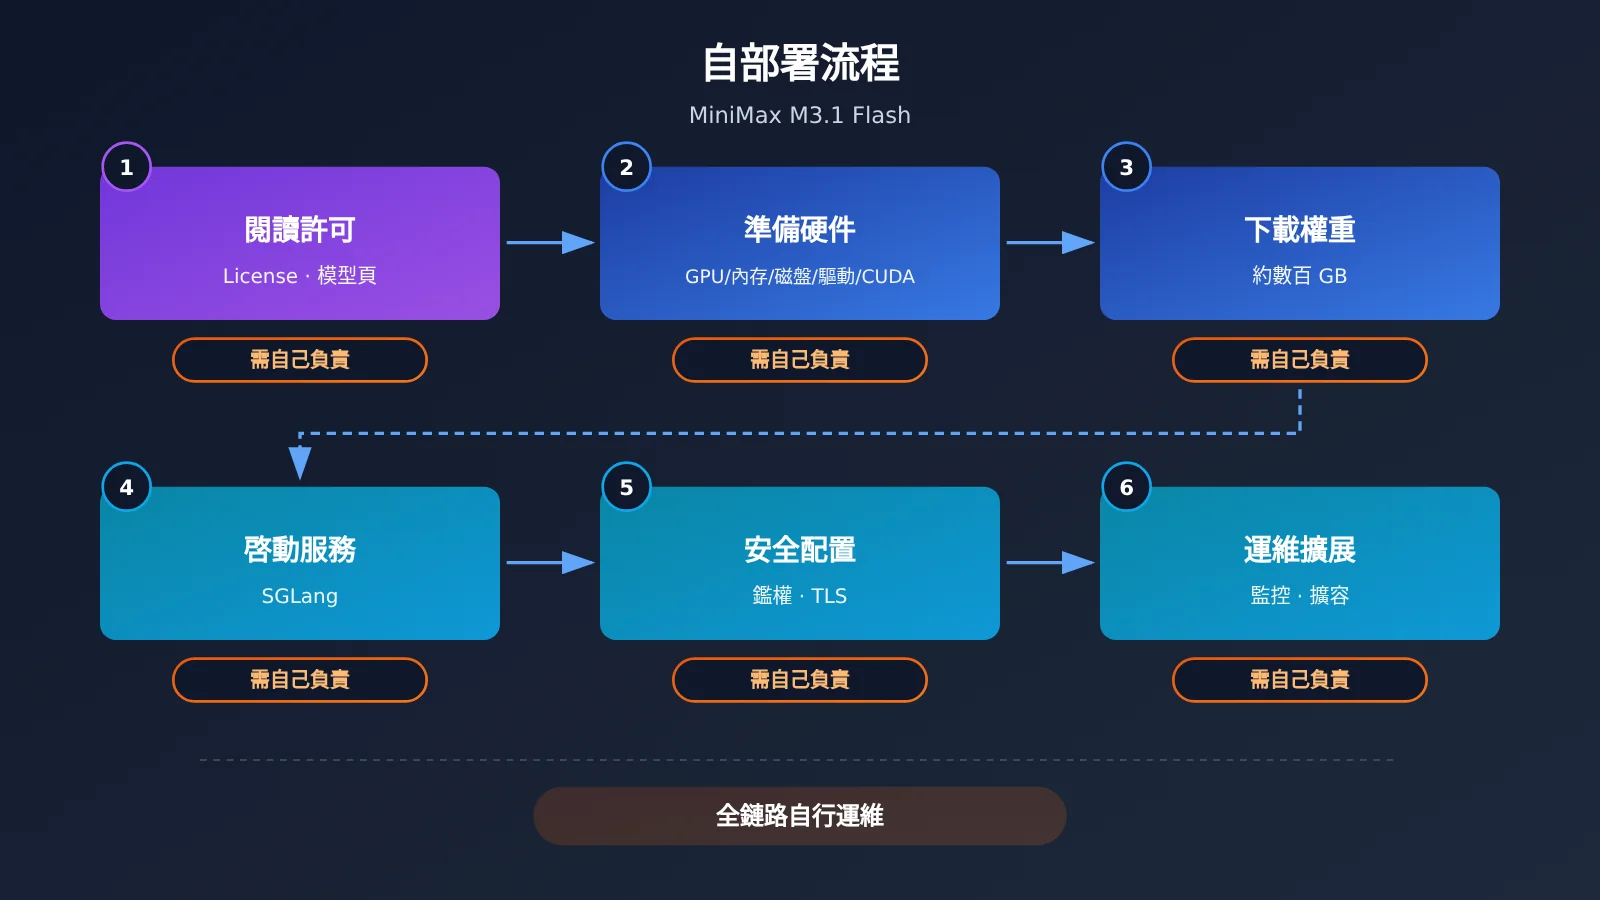
MiniMax 官方部署文檔還給了幾條部署前的建議,適用於所有開源模型:
- 先讀許可和能力範圍,確認你的用途被允許;
- 按模型頁準備硬件,包括 GPU、內存、磁盤、驅動和 CUDA 版本;
- 固定版本,模型版本和推理框架版本都鎖定,不要跟着 main/latest 分支變動;
- 國內鏡像只用模型頁列出的官方源,避免下載到被篡改的文件。
MiniMax M3.1 Flash 自己部署還是調 API 划算
這是本文的核心問題。下面用 4 個維度做判斷,對照自己的情況看即可。
| 判斷維度 | 傾向直接調 API | 傾向自己部署 |
|---|---|---|
| 數據合規要求 | 數據可以發給雲端服務商處理 | 法規或合同要求數據不能出內網 |
| 調用量 | 中小規模、波峯波谷明顯 | 長期大規模,能讓多卡服務器持續滿載 |
| 團隊運維能力 | 沒有專職的 GPU 運維人員 | 有人負責集羣、監控、值班 |
| 是否需要改模型 | 直接用通用能力就夠 | 需要微調、改結構或深度定製 |
只要前三項裏有兩項落在左列,選 API 基本不會錯。
MiniMax M3.1 Flash API 成本怎麼算
官方價格是固定價:輸入 $0.15、輸出 $0.60、緩存讀取 $0.015,單位都是每百萬 tokens,沒有長上下文加價。token 是模型計費的文本單位,官方給的換算是約 750 個英文單詞 ≈ 1000 tokens。緩存讀取指重複發送的相同前綴內容按更低價格計費。
舉個按官方單價算的例子(不是實測):每月輸入 1 億 tokens、輸出 2000 萬 tokens,費用是 100 × $0.15 + 20 × $0.60 = $27。這已經是不小的個人或小團隊用量,一個月幾十美元。
自部署的賬要換個算法。如果參考 M3 的 8 × B200 方案,這類機器不論採購還是租用,都是一筆持續的固定支出,而且沒人調用時也在花錢。要攤薄這筆成本,調用量通常需要大到讓機器長期高負載,大多數個人和小團隊達不到。
有一點需要留意:M3.1 Flash 的思考過程無法關閉,effort(思考深度)不傳時默認 max 檔。思考內容也算輸出 token。實際賬單裏輸出部分可能比你預想的多,想省錢可以把 effort 調到 low 或 medium。
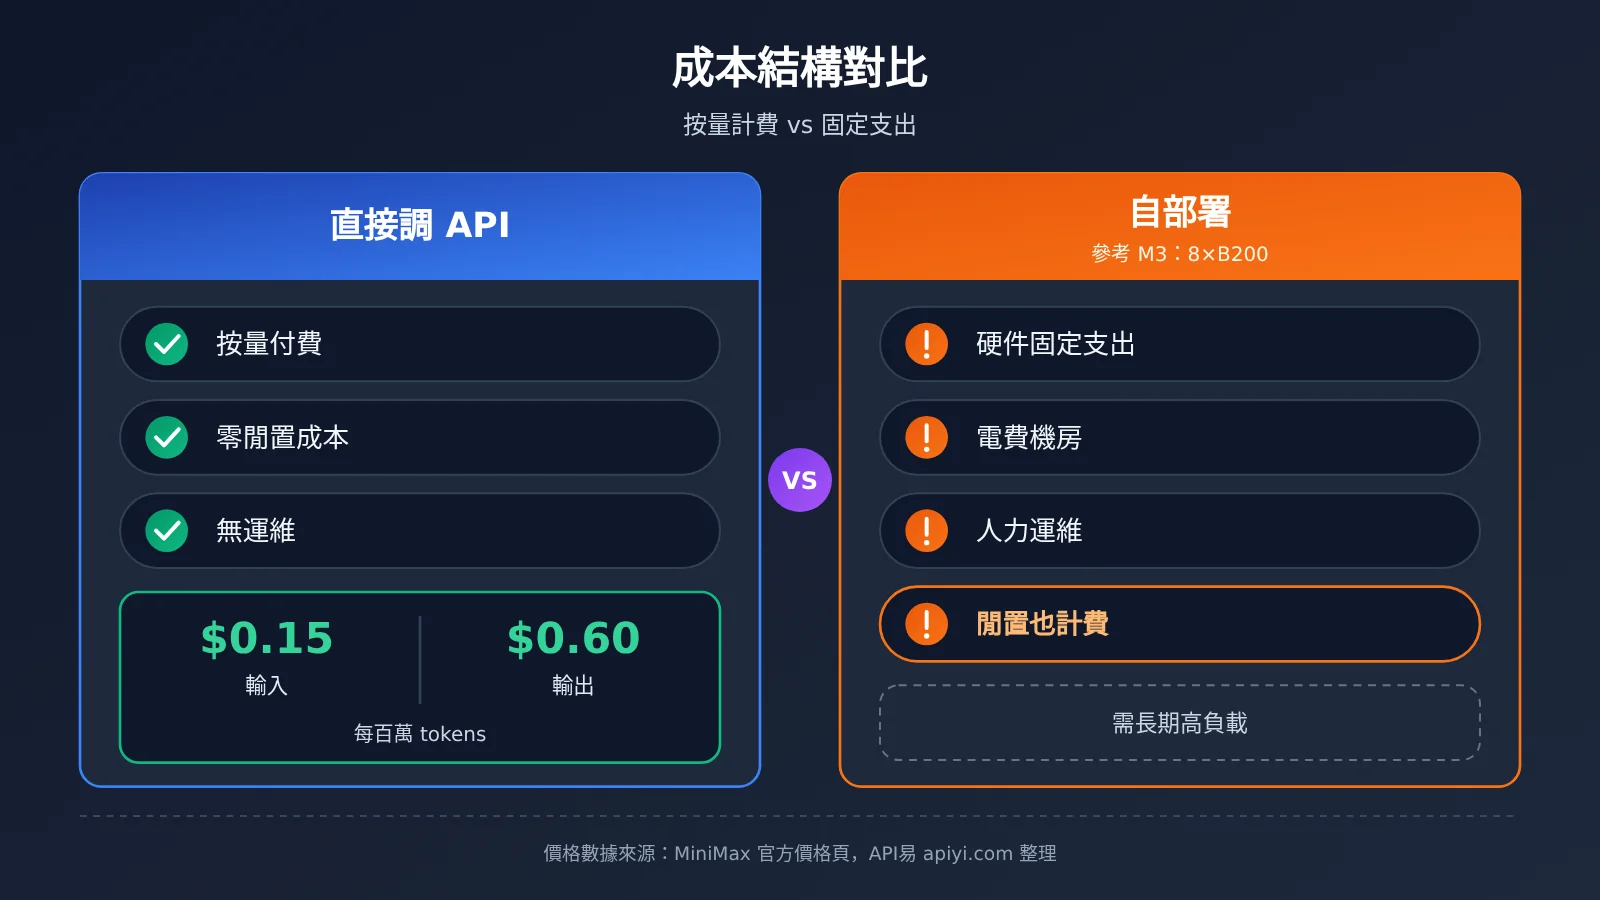
上圖的價格來自 MiniMax 官方價格頁,由 API易 apiyi.com 技術團隊整理。下表列出幾個常被拿來比較的模型的官方單價:
| 模型 | 輸入價(每百萬 tokens) | 輸出價(每百萬 tokens) | 可用平臺 |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | MiniMax 官方 API、M Plan;API易 能否調用以價格頁爲準 |
| MiniMax-M3(≤512K 輸入) | $0.30 | $1.20 | MiniMax 官方 API、API易 apiyi.com |
| claude-opus-5-5 | $4 | $20 | Anthropic 官方、API易 apiyi.com |
| claude-opus-5 | $5 | $25 | Anthropic 官方、API易 apiyi.com |
💰 成本建議:如果你現在就想試 MiniMax 系列的效果,可以先通過 API易 apiyi.com 調用已上架的 MiniMax-M3 跑通流程。M3.1 Flash 能否在 API易 調用,以價格頁爲準,我們也會盡快上架。
MiniMax M3.1 Flash 自部署後要自己負責的事
MiniMax 官方文檔寫得很清楚:開源權重不包含平臺上的緩存、內容安全等功能,服務默認只監聽本機。決定自部署之前,確認下面這些事都有人負責:
- 鑑權:給接口加訪問密鑰,防止被別人隨意調用;
- TLS 加密:對外開放時用 HTTPS 加密傳輸,防止數據被竊聽;
- 網絡隔離:限制哪些機器、哪些網段能訪問推理服務;
- 監控告警:GPU 利用率、顯存、延遲、錯誤率要有人盯;
- 容量規劃與擴容:高峯期請求排隊時,擴容方案要提前準備好;
- 故障恢復與升級:機器宕機怎麼恢復,新版本如何灰度切換;
- 內容安全:輸入輸出的內容審覈需要自己補上;
- 許可證合規:部署、再分發、商用前讀完完整 License 和使用政策。
這張清單裏任何一項缺人負責,自部署省下的 token 費都可能被運維成本抵掉。
MiniMax M3.1 Flash 能力怎麼看:官方自報 vs 第三方測評
決定要不要自部署之前,先看清模型的實際水平。下表按信息檔位整理:
| 指標 | 數據 | 信息檔位 |
|---|---|---|
| Automation-Bench v1.0.6 | 62.2,Claude Opus 5 爲 50.3 | 官方自報 |
| BankerToolBench | 76.2,與 Claude Opus 5 持平 | 官方自報 |
| Terminal Bench 4.0 | 38.1,Claude Opus 5 爲 51.8 | 官方自報 |
| SWE Refactor Bench | 23.0,Claude Opus 5 爲 31.0 | 官方自報 |
| 推理速度 | 博客稱日常 200+ TPS、P50 170+;產品頁寫約 150 tokens/秒 | 官方自報(口徑不一) |
| Vals Index | 53.78%,22 個模型中第 15,開源權重模型中第 5 | 第三方測評 |
| Vals Terminal-Bench 4.0 | 25.25%,51 個模型中第 22 | 第三方測評 |
| “成本爲 M3 的 1/3” | 按任務計算,具體算法未公開 | 未知/未公佈 |
TPS 是每秒生成的 token 數,數值越高,回答出來得越快。
和 Claude 的比較需要說清楚:MiniMax 官方表格裏的對照對象是 Claude Opus 5,不是 Opus 5.5。 Claude Opus 5.5 仍是 Anthropic 當前最強的旗艦模型,官方沒有拿它和 M3.1 Flash 逐項對比,所以不能得出“追上或超過 Opus 5.5”的結論。
即使只對比 Opus 5,M3.1 Flash 在 Terminal Bench、SWE Refactor 這類長鏈路編程和重構任務上也有明顯差距。Vals 的第三方結果同樣顯示,它在長鏈路 Agent 任務上偏弱。
什麼時候不該用 MiniMax M3.1 Flash,也不該急着自部署
以下幾種情況,建議先別動:
- 複雜規劃和大型重構:官方自報和第三方測評都顯示它在長鏈路任務上偏弱。這類任務交給 Claude Opus 5.5 這類旗艦模型更穩妥。
- 對延遲極其敏感、又不需要深度推理:思考無法關閉,即使調到 low 檔也會有思考開銷。
- 已有基於 M3
<think>標籤解析的集成:M3.1 Flash 的思考內容改爲單獨字段返回,舊解析邏輯要先改好再切換。 - 許可證還沒看清:權重放出前許可證未公佈,商用項目不要提前排期依賴自部署。
- 沒人值班:上一節的運維清單沒人負責,就別把業務壓在自建服務上。
- 想在消費級顯卡上跑完整版:參考 M3 的量級,這不現實。等官方硬件說明,也不要輕信來源不明的量化版。
在 API易 上搭配 MiniMax 與 Claude Opus 5.5
對多數開發者來說,比“自部署還是調 API”更實際的問題是:不同難度的任務怎麼分給不同模型。
API易 支持一個 Key 同時調用 Claude、GPT、Gemini 等海外模型,以及 DeepSeek、MiniMax 等國內模型。目前 API易 上可以直接用的包括 MiniMax-M3(同時支持 OpenAI 和 Anthropic 兩種接口格式,ClaudeCode 分組也可用)、MiniMax-M2.7 系列,以及 claude-opus-5-5、claude-opus-5。截至發稿,API易 價格頁還沒有 MiniMax-M3.1-Flash,能否調用以價格頁爲準。
推薦的分工如下:
- 便宜的批量活交給 MiniMax:數據清洗、批量摘要、格式轉換、簡單代碼補全等,量大、單次難度低,單價越低越划算;
- 難的規劃和重構交給 Claude Opus 5.5:跨文件重構、架構設計、複雜 Agent 任務規劃,按次付費更貴,但出錯返工的成本更高;
- 同一個 Key 切換模型:只改模型名,不用維護多套賬號和多個接口地址。
🎯 技術建議:在 API易 apiyi.com 用同一個 Key 分別跑一遍 MiniMax-M3 和 claude-opus-5-5,用你自己的真實任務對比效果和賬單,比看任何跑分都更可靠。
常見問題
Q1:MiniMax M3.1 Flash 的權重什麼時候能下載?
官方 X 帖寫的計劃日期是 10 月 23 日,官方博客只說“稍後”。截至發稿還沒有放出,請以 Hugging Face 上的 MiniMax 官方模型頁爲準。
Q2:一張消費級顯卡能跑 MiniMax M3.1 Flash 嗎?
官方沒有公佈 M3.1 Flash 的硬件要求。同規模的 M3 官方參考方案是 8 × B200,MXFP8 權重約 440 GB,完整版在單張消費級顯卡上基本不現實。
Q3:MiniMax M3.1 Flash 開源後可以商用嗎?
許可證尚未公佈。官方提醒,開源權重不代表所有模型使用同一個許可證,部署、再分發或商用前都要讀完完整 License。
Q4:現在怎麼低成本體驗 MiniMax 系列模型?
最省事的方式是直接調 API。M3.1 Flash 可以走 MiniMax 官方 API 或 M Plan 訂閱(月費以官網爲準)。如果想用一個 Key 同時管理多個模型,可以先在 API易 apiyi.com 調用已上架的 MiniMax-M3。M3.1 Flash 能否調用,以 API易 價格頁爲準。
Q5:MiniMax M3.1 Flash 能替代 Claude Opus 5.5 嗎?
不建議這樣理解。官方只和 Claude Opus 5 做了對比,並且在長鏈路編程任務上落後。更合理的做法是分工:批量任務用 MiniMax,難的規劃和重構用 Opus 5.5。在 API易 上一個 Key 就能完成這種組合。
MiniMax M3.1 Flash 開源權重核心要點 Key Takeaways
- 權重尚未放出:計劃 10 月 23 日發佈,以 Hugging Face 官方模型頁爲準
- 許可證和硬件要求未公佈:不要提前按猜測的配置採購或排期
- 量級參考 M3:8 × B200 加約 440 GB 的 MXFP8 權重,屬於數據中心級別
- API 更划算:$0.15/$0.60 的單價,對多數個人和小團隊遠比自建省事
- 自部署適用面窄:主要是強合規、超大調用量、需要改模型這三類場景
- 對比對象是 Opus 5:Opus 5.5 仍是 Anthropic 最強旗艦,官方沒有逐項對比
- 組合使用:在 API易 apiyi.com 用一個 Key 搭配 MiniMax 和 Claude Opus 5.5
總結
MiniMax M3.1 Flash 開源權重的要點:
- 現狀:權重計劃 10 月 23 日放出,許可證和部署硬件要求都還沒公佈,一切以官方模型頁爲準;
- 配置:參考同規模的 M3,官方方案是 8 張 B200 級 GPU,不是個人設備能承擔的;
- 決策:按合規、調用量、運維能力、改模型需求 4 個維度判斷,多數情況下直接調 API 更划算。
權重放出後,建議先讀許可證和官方硬件說明,再決定是否自建。業務上更實際的做法是讓不同難度的任務用不同模型。可以通過 API易 apiyi.com 用一個 Key 測試 MiniMax 系列和 claude-opus-5-5 的組合效果。
📚 參考資料
- MiniMax 官方發佈博客:M3.1 Flash 發佈說明與官方自報數據
- 鏈接:
minimax.io/blog/minimax-m31f -
說明:價格、速度和權重“稍後發佈”的官方表述
-
MiniMax 官方價格頁:各模型按量計費單價
- 鏈接:
platform.minimax.io/docs/guides/pricing -
說明:M3.1 Flash 與 M3 的價格對照
-
MiniMax 官方自部署指南:開源模型部署參考配置
- 鏈接:
platform.minimax.io/docs/guides/local-deploy -
說明:M3 的 8 × B200 參考方案與自部署注意事項
-
Vals AI 測評頁:M3.1 Flash 第三方評測結果
- 鏈接:
vals.ai/models/minimax_MiniMax-M3.1-flash -
說明:Vals Index 排名與各子項得分
-
Hugging Face – MiniMax-M3:M3 權重與社區許可證
- 鏈接:
huggingface.co/MiniMaxAI/MiniMax-M3 -
說明:M3.1 Flash 權重放出後可在同一組織下查看
-
SGLang 文檔 – MiniMax-M3:推理框架部署說明
- 鏈接:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - 說明:M3 的 MXFP8 版本體積與運行方式
作者:APIYI 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心