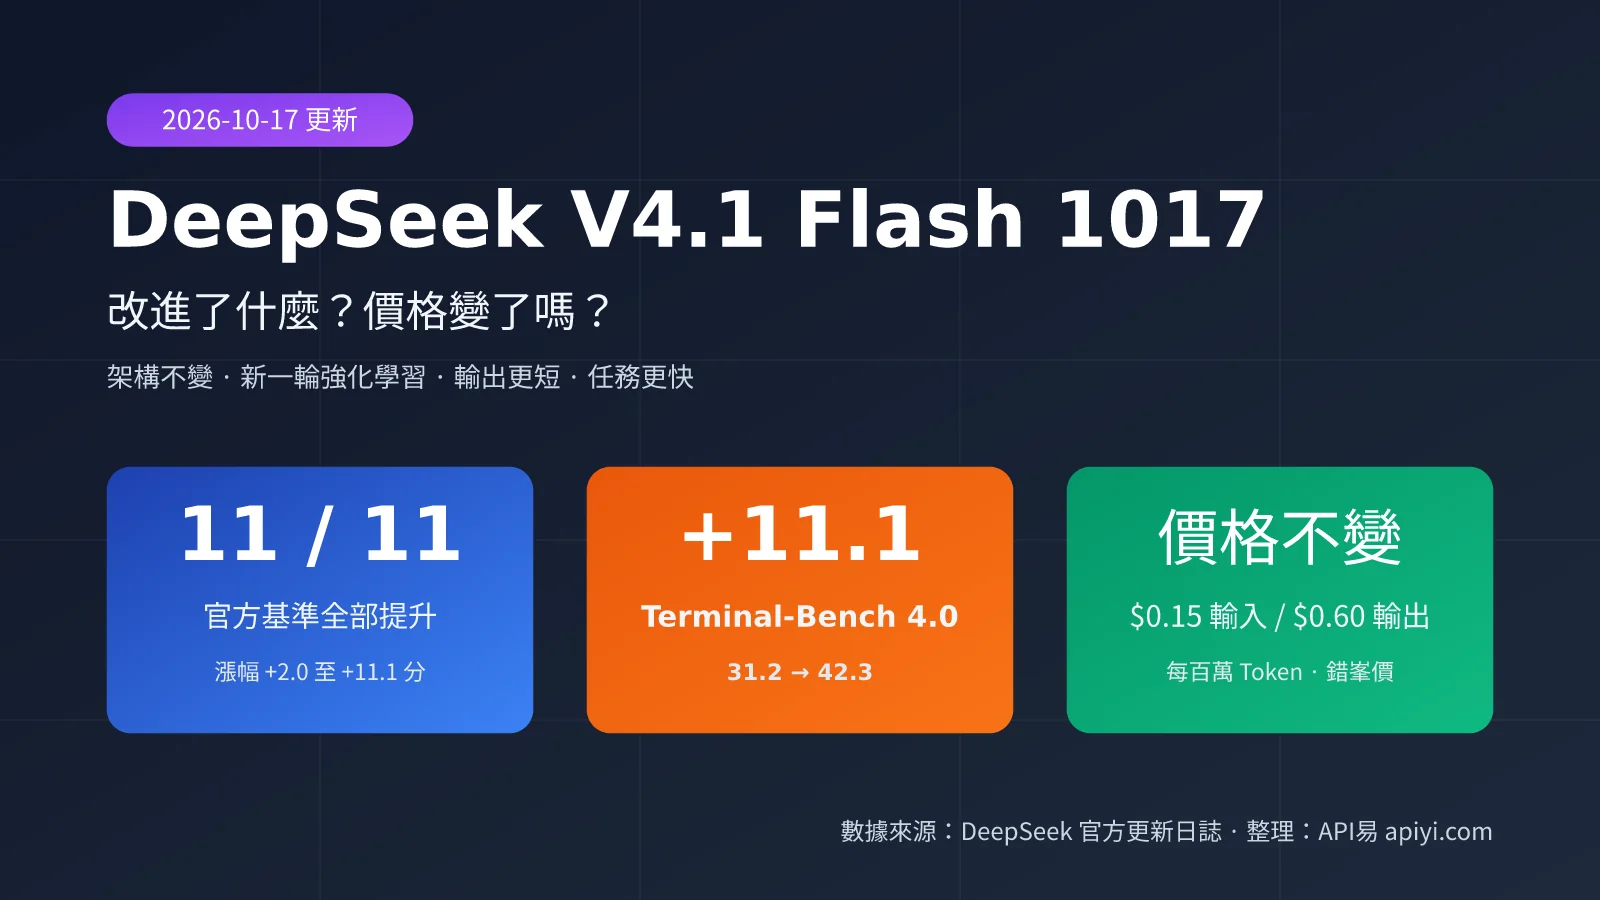
2026 年 10 月 17 日,DeepSeek 把 V4.1 Flash 悄悄升級到了 DeepSeek-V4.1-Flash-1017。官方把它定位爲一次小版本更新,但從公佈的數據看,官方列出的 11 項基準全部上漲,Terminal-Bench 4.0 一次提升了 11.1 分,這已經不算“小修小補”了。
很多開發者最關心的其實是兩個問題:DeepSeek V4.1 Flash 1017 到底改進了什麼?價格變了嗎? 本文只用 DeepSeek 官方更新日誌、定價頁和 Hugging Face 模型卡里的數據作答,第三方說法會單獨標註。
核心價值:讀完本文,你會知道 1017 版本的真實提升幅度、爲什麼“價格不變”實際意味着更便宜、以及怎樣用錯峯時段把 DeepSeek API 成本再砍一半。
DeepSeek V4.1 Flash 1017 是什麼:一次架構不變的小版本更新
DeepSeek V4.1 Flash 本身是 2026 年 9 月 10 日發佈的新架構家族裏最小的模型,原生支持圖像理解。1017 是它發佈約一個月後的第一次迭代,官方更新日誌的描述很簡潔:模型升級爲 DeepSeek-V4.1-Flash-1017,網頁端和 App 同步更新,API 調用方式和價格都不變。
從 Hugging Face 上的技術信息看,1017 沿用了同一套架構:552B 主幹參數、預填充階段每 Token 激活約 8B、解碼階段約 16B,另有 196B 的 Engram 條件記憶。英文社區的分析普遍認爲,這次變化來自新一輪強化學習後訓練,配置文件、分詞器和提示詞編碼都沒有動,所以現有代碼無需任何修改。
| 項目 | DeepSeek V4.1 Flash 1017 | 說明 |
|---|---|---|
| 發佈日期 | 2026-10-17 | 9 月 10 日首發版的第一次迭代 |
| API 模型名 | deepseek-flash |
別名自動指向最新版本 |
| 舊模型名 | deepseek-v4-flash 等 |
仍可調用,路由到 1017,按 Flash 價計費 |
| 架構 | MoE,552B 主幹,8B/16B 激活 | 與首發版相同 |
| 上下文 / 最大輸出 | 1M / 384K | 官方定價頁數據 |
| 思考模式 | 思考(默認)與非思考 | 兩種模式均可用 |
| 多模態 | 支持圖像輸入 | Pro 版暫不支持視覺 |
| 開源協議 | MIT | 權重發布在 Hugging Face 與 ModelScope |
| 併發上限 | 2,500 | Pro 版爲 500 |
值得注意的是官方特意提到的一點:1017 針對 DeepSeek Harness、騰訊 CodeBuddy 和 WorkBuddy 做了優化,並建議使用 DeepSeek Harness 0.2.1-rc.1 及以上版本。這說明本次訓練重點放在 Agent 編程場景,如果你用的是自建的 Agent 循環,實際收益可能會比官方數字小一些。
🎯 技術建議:模型別名會自動指向新版本,建議在切換生產流量前先用自己的業務樣本做一輪迴歸測試。通過 API易 apiyi.com 可以用同一個 Key 同時調用 DeepSeek 與其他主流模型,便於在同一套評測腳本里橫向對比。
DeepSeek V4.1 Flash 1017 改進了什麼:11 項基準逐項對比
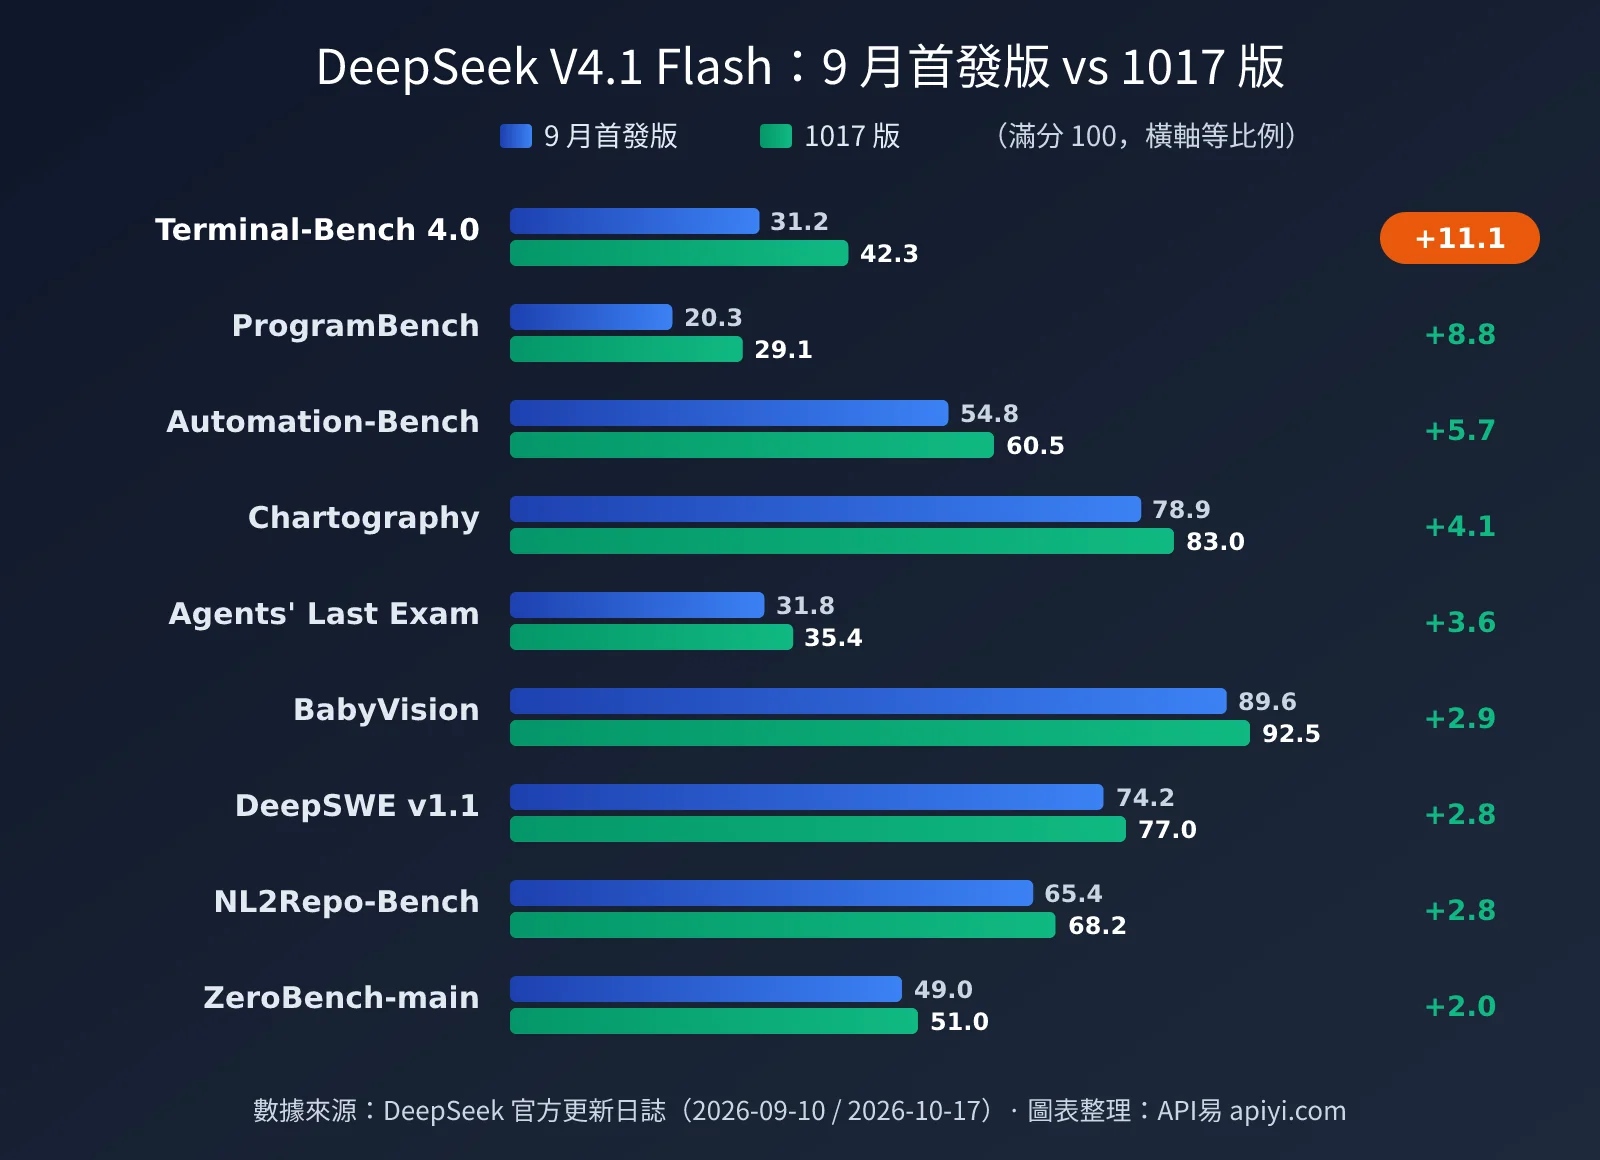
回答“改進了什麼”,最直接的方式是把官方 9 月首發版和 10 月 1017 版的成績放在一起看。下表數據均來自 DeepSeek 官方更新日誌,其中 Apex Bench 的舊分數官方日誌未列出,引用自英文社區的整理,僅供參考。
| 基準測試 | 能力維度 | 9 月首發版 | 1017 版 | 提升 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 終端 Agent 任務 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 程序生成 | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | 綜合推理(舊分爲第三方數據) | 64.6 | 72.1 | +7.5 |
| HLE(無工具) | 高難度知識推理 | 36.8 | 42.6 | +5.8 |
| Automation-Bench | 自動化工作流 | 54.8 | 60.5 | +5.7 |
| Chartography(帶工具) | 圖表理解 | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | 通用 Agent | 31.8 | 35.4 | +3.6 |
| BabyVision(帶工具) | 視覺理解 | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | 軟件工程 | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | 自然語言生成倉庫 | 65.4 | 68.2 | +2.8 |
| ZeroBench-main(帶工具) | 視覺推理 | 49.0 | 51.0 | +2.0 |
這張表能讀出三個信號。第一,提升最大的全是 Agent 與編程類任務,Terminal-Bench 4.0 和 ProgramBench 的相對漲幅都超過 35%,這與官方“針對 Harness 和 CodeBuddy 優化”的說法一致。第二,視覺類基準也有 2 到 4 分的穩定提升,說明這次後訓練沒有犧牲多模態能力。第三,部分基準的測試口徑前後不完全一致,比如 Automation-Bench 新版標註爲 v1.0.6、HLE 首發版未註明是否帶工具,解讀時不宜只看單個數字。
DeepSeek V4.1 Flash 1017 的效率改進:輸出更短、任務更快
除了分數,官方還強調了一個容易被忽略的變化:1017 完成任務的耗時更短,輸出長度更短。對於按 Token 計費的 API 來說,這一點和分數同樣重要,因爲同樣一個任務少輸出一部分 Token,賬單就直接變小。
需要說明的是,DeepSeek 沒有公佈具體縮短了多少百分比,英文社區目前也沒有可靠的前後對照測量。比較穩妥的做法是在自己的業務樣本上統計 usage.completion_tokens 的變化,用真實數據判斷成本到底降了多少。
英文社區把這次訓練方法概括爲“願望驅動編程”(Wish-Driven Programming):模型先端到端完成一個項目,再對照目標給自己打分並迭代。官方展示的案例包括 3D 故宮復原、瀏覽器賽車遊戲、用 Godot 復刻 Portal 2 等。這類長鏈路項目恰好對應 Terminal-Bench 和 ProgramBench 這樣的基準,也解釋了爲什麼 Agent 類分數漲幅最大。
DeepSeek V4.1 Flash 1017 價格變了嗎:錯峯與高峯計費詳解
先給結論:DeepSeek V4.1 Flash 1017 的 API 價格沒有變化,與 9 月首發版完全一致。但“沒變”需要結合兩個背景理解:9 月首發時已經降過一次價,而且 DeepSeek 目前採用錯峯與高峯兩檔計費,不同時段的實際單價相差一倍。
| 計費項(每百萬 Token) | Flash 錯峯價 | Flash 高峯價 | V4 Pro 錯峯價 | V4 Pro 高峯價 |
|---|---|---|---|---|
| 輸入(緩存命中) | $0.003 | $0.006 | $0.022 | $0.044 |
| 輸入(緩存未命中) | $0.15 | $0.30 | $0.66 | $1.32 |
| 輸出 | $0.60 | $1.20 | $1.98 | $3.96 |
官方定義的高峯時段是週一到週五 UTC 01:00-04:00 和 06:00-10:00,換算成北京時間就是 工作日 09:00-12:00 和 14:00-18:00,中國法定節假日不算高峯。其餘時間,包括夜間、午休時段、週末與節假日全天,都按錯峯價計費,也就是高峯價的一半。
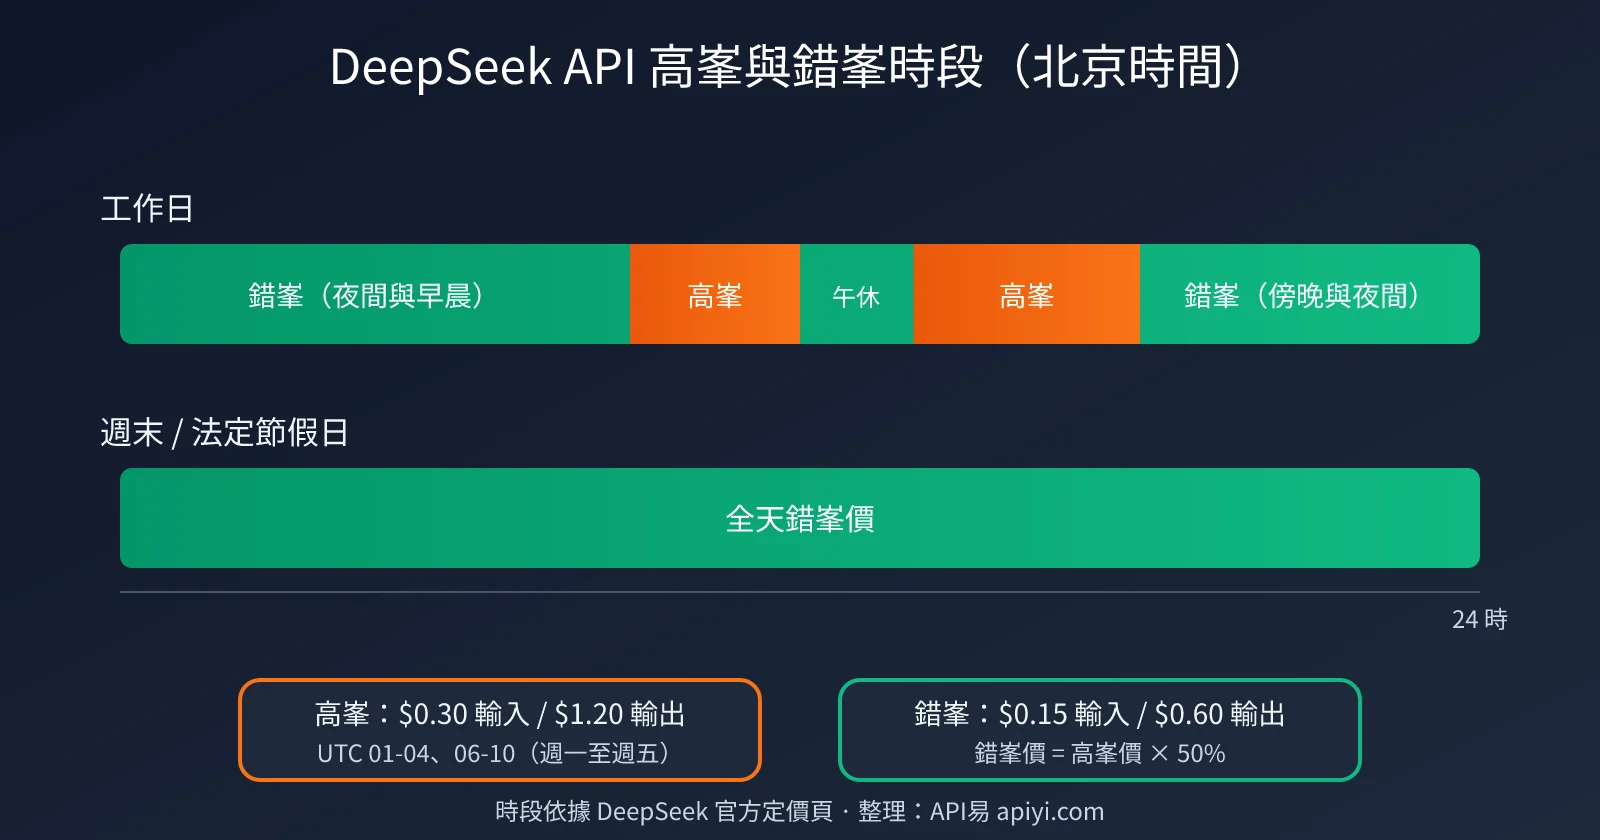
這個時段設計對國內團隊有直接影響:高峯時段幾乎完全覆蓋了國內的上班時間。如果你的任務是批量翻譯、離線數據標註、代碼倉庫掃描這類不要求實時返回的工作,把它們排到晚上 18 點以後或週末跑,單價立刻減半,這比任何提示詞優化都來得直接。
DeepSeek V4.1 Flash 價格變化時間線
如果把時間線拉長看,Flash 系列在兩個月內經歷了“降價、再加量不加價”的過程。V4 Flash 時代的價格來自英文社區的整理,僅作參考;9 月和 10 月兩版的數據來自官方。
| 版本 | 發佈時間 | 輸入(緩存未命中) | 輸入(緩存命中) | 輸出 | 變化 |
|---|---|---|---|---|---|
| V4 Flash | 2026 年 9 月前 | 約 $0.22 | 約 $0.007 | 約 $0.66 | 已下線 |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | 官方宣佈降價 |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | 價格不變,能力提升 |
表中 V4.1 系列爲錯峯價,高峯時段價格翻倍。
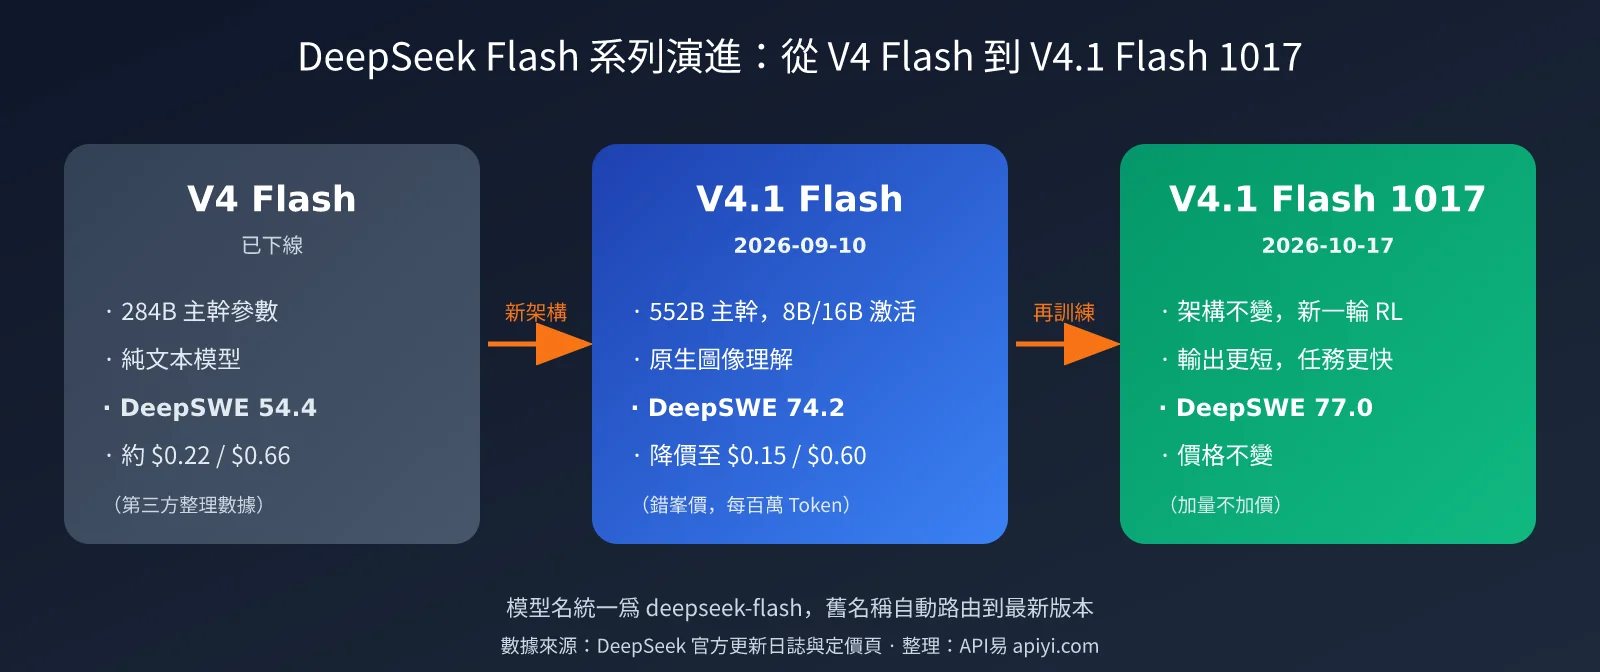
爲什麼“價格不變”實際等於降價
單價不變,但每個任務的總花費由“單價 × Token 數”決定。1017 官方確認輸出更短,意味着同一任務消耗的輸出 Token 變少;而輸出單價是輸入的 4 倍,所以縮短輸出帶來的節省比縮短輸入更明顯。
舉個示意性的例子:一個 Agent 任務在錯峯時段消耗 100 萬輸入 Token(未命中緩存)和 20 萬輸出 Token,花費約爲 $0.15 + $0.12 = $0.27。如果輸出量減少 20%(僅爲假設,實際以你的測量爲準),輸出費用就從 $0.12 降到約 $0.096。疊加緩存命中價 $0.003 的長上下文複用,真實成本還能再往下走。
💰 成本優化:對於批量調用、預算敏感的項目,可以把非實時任務排到錯峯時段,並儘量複用固定的系統提示詞以提高緩存命中率。通過 API易 apiyi.com 平臺調用,還可以統一查看各模型的用量明細,方便覈算每類任務的真實成本。
Search 與 Fetch API:1017 同時開放的新計費項
與 1017 一起發佈的還有一個變化:DeepSeek 把自家的 Search(聯網搜索)和 Fetch(網頁抓取)能力開放給外部開發者。這兩項按次單獨計費,各 $0.75 / 千次成功請求,與模型 Token 費用分開計算。
官方定價頁還給了一個過渡期:通過 DeepSeek Harness、Claude Code 或 Codex 發起的此類請求目前免費,從北京時間 2026 年 11 月 1 日 0 點開始按次計費。如果你的 Agent 工作流大量依賴聯網檢索,建議在 11 月前統計一下調用次數,提前評估這部分新增成本。
DeepSeek V4.1 Flash 1017 快速上手:API 調用示例
由於 1017 沿用 deepseek-flash 這個模型名,已有代碼不需要任何改動就會自動用上新版本。下面是一個兼容 OpenAI SDK 的最小調用示例:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 統一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 實際可用模型名以平臺模型列表爲準
    messages=[{"role": "user", "content": "用 Python 寫一個讀取 CSV 並按列求和的函數"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 記錄 Token 用量,便於對比新舊版本輸出長度
查看完整代碼:新舊版本輸出長度對比腳本
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,一個 Key 調用多個模型
)

PROMPTS = [
    "解釋 Python 中生成器和迭代器的區別,並給出示例",
    "寫一個帶重試和指數退避的 HTTP 請求函數",
    "把下面的 SQL 改寫成 pandas 代碼:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 將歷史記錄中的 completion_tokens 與本次結果對比,即可估算 1017 的輸出縮短幅度
    print(run("deepseek-flash", PROMPTS))
幾點實踐建議可以幫你更快跑通:
- 思考模式:
deepseek-flash默認開啓思考模式,簡單問答或格式轉換類任務可以切換到非思考模式,進一步節省輸出 Token,具體參數寫法以官方文檔爲準。 - 採樣參數:Hugging Face 模型卡推薦
temperature=1.0、top_p=0.95,如果你之前爲舊版本調過溫度,建議重新測一遍。 - 舊模型名:
deepseek-v4-flash仍能調用,但已路由到 1017,建議統一改成deepseek-flash,避免日後別名下線時出錯。 - 迴歸測試:輸出變短可能影響依賴固定格式或長度的下游解析,切換前用真實樣本跑一遍。
🚀 快速開始:推薦使用 API易 apiyi.com 平臺快速搭建原型,OpenAI 兼容接口開箱即用,幾分鐘即可把 DeepSeek V4.1 Flash 1017 接入現有項目,並與其他模型做 A/B 對比。
DeepSeek V4.1 Flash 1017 適合哪些場景:與 V4 Pro 的選型對比
1017 更新後,一個現實問題是:還有沒有必要用更貴的 V4 Pro?從官方定價頁看,Flash 在價格、併發和視覺能力上都佔優,Pro 則仍然是 DeepSeek 目前對外提供的更大模型。
| 對比維度 | deepseek-flash(V4.1 Flash 1017) | deepseek-v4-pro(V4 Pro 0813) | 建議 |
|---|---|---|---|
| 輸出價(錯峯) | $0.60 / 百萬 Token | $1.98 / 百萬 Token | Flash 約爲 Pro 的 30% |
| 上下文 / 最大輸出 | 1M / 384K | 1M / 384K | 持平 |
| 視覺理解 | 支持 | 不支持 | 有圖片輸入選 Flash |
| 併發上限 | 2,500 | 500 | 高併發批處理選 Flash |
| Agent 編程優化 | 針對 Harness、CodeBuddy 專項優化 | 通用 | 編程 Agent 優先試 Flash |
| 可用平臺 | DeepSeek 官方、API易 apiyi.com 等 | 同左 | 統一接口便於切換 |
結合以上信息,可以按場景給出幾條選型思路:
- 編程 Agent 與終端自動化:優先選 Flash 1017,這是本次提升最集中的方向,且價格只有 Pro 的約三分之一。
- 圖表、截圖與文檔理解:只能選 Flash,Pro 目前不支持視覺輸入。
- 大批量離線任務:Flash 的 2,500 併發上限配合錯峯價,是性價比最高的組合。
- 對單次回答質量要求極高的複雜推理:建議 Flash 與 Pro 用同一批樣本對比後再定,不要只看基準分數。
💡 選擇建議:選哪個模型主要取決於你的任務類型和質量要求。建議通過 API易 apiyi.com 平臺用同一批真實樣本同時測試 Flash 與 Pro,統一接口切換隻需改一個模型名,便於快速得出結論。
常見問題
Q1:DeepSeek V4.1 Flash 1017 需要改代碼嗎?
不需要。官方確認 API 調用方式不變,deepseek-flash 會自動指向 1017 版本,舊名稱 deepseek-v4-flash 也會路由到新版本。唯一建議做的是迴歸測試,確認輸出變短後下游解析仍然正常。通過 API易 apiyi.com 平臺可以獲取測試額度,快速驗證新版本在你業務上的表現。
Q2:DeepSeek V4.1 Flash 1017 的價格到底變了沒有?
單價沒有變:錯峯時段緩存未命中輸入 $0.15、緩存命中 $0.003、輸出 $0.60(每百萬 Token),高峯時段翻倍。但由於 1017 輸出更短,同一任務的總花費通常會下降。新增的只有 Search 與 Fetch API 按次計費,各 $0.75 / 千次成功請求。
Q3:高峯時段是北京時間幾點?
工作日北京時間 09:00-12:00 與 14:00-18:00,對應 UTC 01:00-04:00 與 06:00-10:00,中國法定節假日不計高峯。其餘時間都按錯峯價,也就是高峯價的一半。
Q4:1017 的基準提升可信嗎?
分數來自 DeepSeek 官方發佈,第三方獨立復現還在進行中。部分基準依賴特定框架,例如 Terminal-Bench 4.0 使用 Claude Code 框架、DeepSWE 使用 Mini-SWE-V2 框架,換成自建 Agent 循環後結果可能有差異。最可靠的方式仍是用自己的樣本、自己的框架實測,再決定是否切換。
Q5:可以本地部署 DeepSeek V4.1 Flash 1017 嗎?
可以。權重以 MIT 協議發佈在 Hugging Face 和 ModelScope,支持 vLLM、SGLang、Transformers 等推理框架。不過 552B 主幹參數對顯存要求很高,中小團隊通常直接調用 API 更划算。
Key Takeaways
- 改進了什麼:架構不變,新一輪強化學習,官方 11 項基準全部提升,Terminal-Bench 4.0 從 31.2 升至 42.3。
- 效率變化:任務完成更快、輸出更短,按 Token 計費時直接降低單任務成本。
- 價格變了嗎:單價不變,錯峯 $0.15 輸入 / $0.60 輸出,高峯翻倍,高峯爲北京時間工作日 9-12 點和 14-18 點。
- 新增計費:Search 與 Fetch API 各 $0.75 / 千次,11 月 1 日起對 Harness、Claude Code、Codex 調用開始收費。
- 接入方式:沿用
deepseek-flash,無需改代碼,切換前做一次迴歸測試即可。
總結
回到標題裏的兩個問題,答案可以濃縮爲三點:
- 改進了什麼:DeepSeek V4.1 Flash 1017 是同架構上的再訓練,Agent 編程能力提升最明顯,視覺理解也穩中有升,同時輸出更短、速度更快。
- 價格變了嗎:沒有變,仍是 9 月降價後的水平;輸出縮短讓實際花費更低,錯峯時段再便宜一半。
- 要做什麼:代碼不用動,但建議做一次迴歸測試,並評估 11 月起 Search/Fetch 按次計費對 Agent 工作流的影響。
對於正在用或準備用 DeepSeek 做編程 Agent、批量處理、圖表理解的團隊來說,1017 是一次“加量不加價”的更新,值得儘快切換驗證。推薦通過 API易 apiyi.com 快速驗證效果,用統一接口把 DeepSeek V4.1 Flash 1017 與其他主流模型放在同一批樣本上對比,再決定生產流量的分配。
延伸閱讀 Related Articles
如果你對 DeepSeek 系列模型感興趣,推薦繼續閱讀:
- 📘 DeepSeek V4.1 Flash 首發解讀:新架構與原生多模態 – 瞭解 9 月首發版的架構變化
- 📊 DeepSeek API 成本優化指南:緩存命中與錯峯調度 – 掌握降低 Token 成本的實用技巧
- 🚀 編程 Agent 模型選型:Flash、Pro 與主流閉源模型對比 – 探索不同場景下的最優組合
參考資料
- DeepSeek API 更新日誌: V4.1 Flash 與 1017 版本的官方發佈說明和基準數據
- 鏈接:
api-docs.deepseek.com/updates -
說明: 本文基準分數與版本信息的主要來源
-
DeepSeek 模型與價格: 官方定價、高峯時段與 Search/Fetch 計費規則
- 鏈接:
api-docs.deepseek.com/quick_start/pricing -
說明: 價格以官方頁面實時信息爲準
-
Hugging Face 模型卡: DeepSeek-V4.1-Flash 架構、參數與推薦採樣參數
- 鏈接:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
說明: 本地部署與參數配置參考
-
Regolo 對比文章: V4 Flash 與 V4.1 Flash 的價格與基準對比
- 鏈接:
regolo.ai - 說明: 文中 V4 Flash 舊價格引用自該第三方整理
作者: APIYI 技術團隊
技術交流: 歡迎在評論區討論,更多資料可訪問 API易 docs.apiyi.com 文檔中心