作者注:通過第三方 API 調用大模型時,僅憑回答質量無法確認實際運行的是哪個模型。本文解讀 Anthropic 開源的 FlashProve:它如何用 zkSNARK 把推理結果綁定到指定權重,成本有多高,能證明什麼、不能證明什麼,以及距離日常 API 調用還有多遠。
2026 年 11 月 2 日,Anthropic Frontier Red Team 聯合 EPFL、MIT 等機構的研究者發佈了 FlashProve:一個面向大語言模型的開源可證明推理原型。在 400B 參數的 Llama 4 Maverick 上,它用單張 H100 生成證明,單份證明約 19 MB,普通 CPU 十幾秒即可驗證。
這不是概念演示或 PPT 產品。Anthropic 同步發佈了技術報告、協議規範文檔、可執行的證明端與兩套驗證端代碼,以及 Lean 形式化證明,全部以 Apache 2.0 協議開源。不過它也明確表示,這只是階段性研究進展,距離完整的研究目標還有不少路要走。
核心價值:讀完本文,你將弄清楚第三方 API 調用中“模型身份”爲什麼難以確認,FlashProve 用什麼機制解決它,它的真實成本與邊界在哪裏,以及作爲 API 使用者現在能做些什麼。
第三方 API 調用爲什麼存在模型身份信任問題
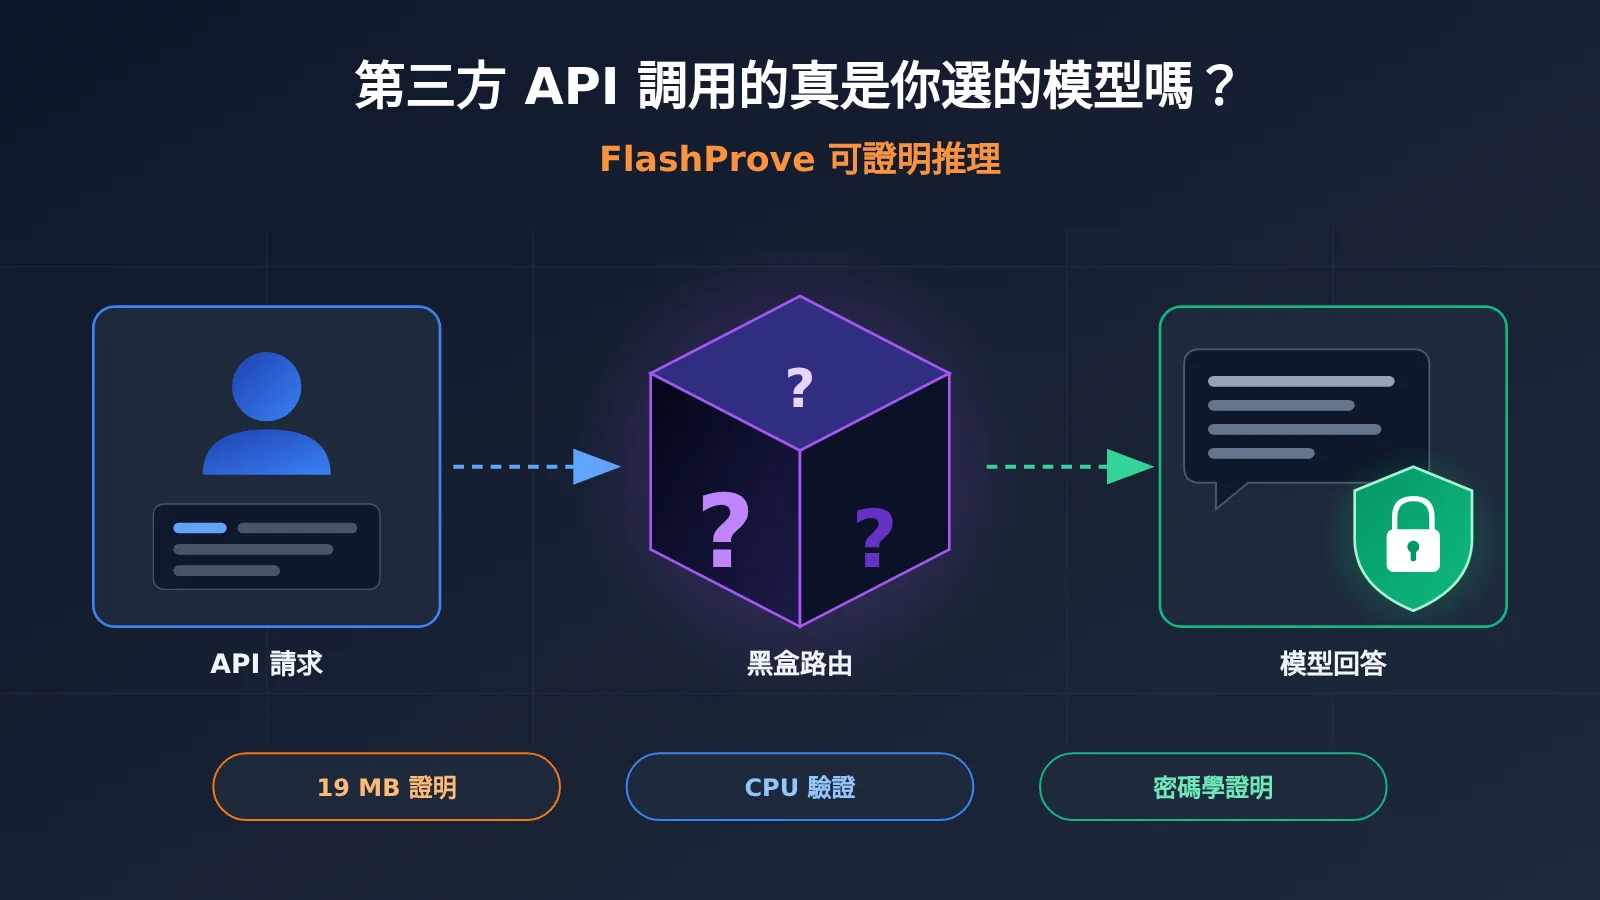
當你通過任意一個 API 發送請求時,返回的只有一段文本和一個模型名稱字段。Anthropic 在研究博客中直言,今天的用戶無法確認回答真的來自開發者聲稱的那個模型。它可能被路由服務出於成本考慮悄悄替換,也可能被攻擊者在 Token 流上做了篡改。
更關鍵的是,輸出質量高不等於模型身份真實。一個便宜的模型也可能在某些問題上答得很好,一個被降級的版本也未必能被肉眼識別出來。即使把完整聊天記錄公開,理論上也可以用更便宜的模型僞造出來,這類證據並不具備絕對的證明力。
要從根本上驗證也很難。前沿模型的權重大多不公開,就算拿到了權重,復算一遍推理所需的算力也遠超普通用戶甚至評測機構的承受範圍。Anthropic 梳理了這類信任問題的幾種典型場景:
- 第三方路由服務:客戶希望確認收到的 Token 來自自己付費選擇的模型。
- 獨立評測:評測機構需要確認發佈前後測試的就是線上實際提供服務的模型。
- 防篡改檢測:推理服務器被攻破後,攻擊者可能夾雜惡意回答,甚至把惡意軟件投遞到用戶電腦上。
- 監管與合規:監管方可能要求只能部署經過安全審批的模型,或確認硬件確實在跑推理而非偷偷訓練。
可證明推理(Provable Inference)的目標,就是讓一個算力有限、也不瞭解權重的用戶,能夠驗證某條回答確實來自所請求的模型。
FlashProve 核心信息速覽
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 11 月 2 日 |
| 發佈方 | Anthropic Frontier Red Team,聯合 EPFL、MIT、StarkWare、Succinct 等機構研究者 |
| 核心技術 | zkSNARK(零知識簡潔知識論證),基於哈希函數構造,具備後量子安全性 |
| 測試模型 | Llama 4 Maverick,400B 參數 MoE,每 Token 激活約 17B 參數,公開 4-bit 量化權重 |
| 發佈內容 | 研究博客、技術報告、Claude 撰寫的協議規範、證明端與 C++/Lean 雙驗證端代碼、Lean 證明及可視化工具 |
| 開源協議 | Apache 2.0 |
| 當前定位 | 研究原型,分享階段性進展,歡迎外部改進 |
值得一提的是,Anthropic 表示系統中的大量優化工作由 Claude 完成。爲了應對 AI 在大型複雜系統中做出“難以評估的決策”,團隊用 Lean 寫下了可審計的頂層安全聲明,作爲對沖手段。
FlashProve 如何證明推理來自指定模型
FlashProve 只有兩個角色:模型提供方作爲證明者(Prover),用戶作爲驗證者(Verifier)。整個流程分爲離線和在線兩個階段,再加上驗證端的檢查。
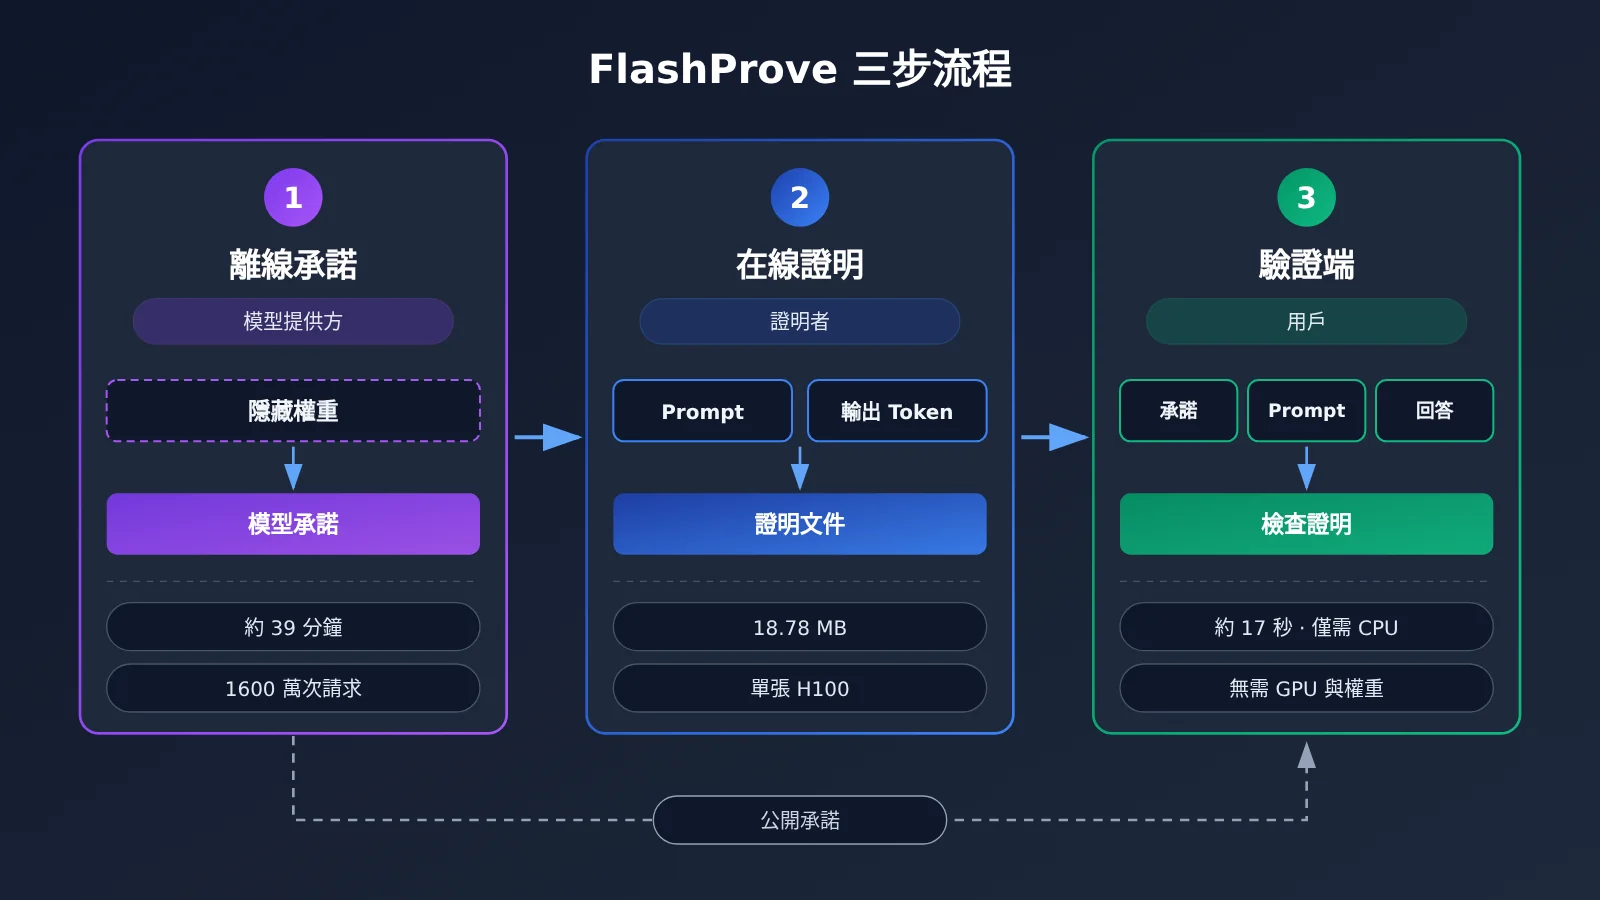
FlashProve 的三步機制
- 離線模型承諾(Model Commitment):證明者發佈一個對模型權重的承諾,可以理解爲一枚很短的“指紋”。它鎖定了一組確切的權重,但權重本身保持隱藏。在測試中這一步每個模型只需執行一次,耗時約 39 分鐘,生成的承諾大約可支撐 1600 萬次請求,之後需要重新承諾。
- 在線生成證明:收到驗證者的請求(Prompt 與對應輸出 Token)後,證明者生成一份證明文件,證明的命題是“被承諾的模型在運行時會產生這些輸出 Token”。
- 驗證端檢查:任何持有承諾、Prompt 和回答的人都能檢查證明,無需權重,也只需有限算力,就能確信被承諾的權重在這個 Prompt 上恰好產生了這些 Token。
FlashProve 的四項安全性質
前兩項性質(完整性與可靠性)其實一個知道權重、算力充足的驗證者自己復算就能做到。讓系統真正有意義的是後兩項:
- 完整性(Completeness):誠實證明者生成的證明一定能被接受。
- 可靠性(Soundness):僞造虛假命題的有效證明,難度相當於攻破被廣泛信任的密碼學假設,驗證者因此不必信任證明者。
- 零知識(Zero Knowledge):驗證者無法獲知權重、中間計算值,也無法知道每一層激活了哪些專家,但模型架構本身不隱藏。
- 簡潔性(Succinctness):被證明的是約 232 GB 量化模型的一次運行,驗證者拿到的卻只是約 19 MB 文件,在 24 核 CPU 上幾秒級即可檢查。
MoE 架構如何降低 FlashProve 證明開銷
FlashProve 的提速很大程度上利用了 MoE(混合專家模型)的結構。在 Llama 4 Maverick 中,每個 Token 只用到 400B 參數裏的約 17B,證明者的工作量也只和這約 17B 成正比,同時證明依然隱藏了具體選擇了哪些專家。
另外兩項工程設計同樣關鍵。一是事後批量證明:證明者像 Prefill 一樣一次並行讀取已完成的文本,每批只打開一次權重承諾。二是單卡適配:權重按層切段、逐段證明,放在普通內存中流式加載,一張 80 GB GPU 搭配約 290 GB 主機內存即可運行。
FlashProve 證明成本實測數據
成本是判斷可證明推理能否落地的核心指標。Anthropic 的測試環境爲:證明端是單張 H100 加 24 個 CPU 核心,驗證端只用 CPU,每個請求是一個 1024 Token 的窗口。
| 環節 | 指標 | 實測數值 |
|---|---|---|
| 離線承諾 | 耗時 / 有效期 | 約 39 分鐘 / 約 1600 萬次請求 |
| 在線證明 | 24 個請求一批的耗時 | 約 223 秒 |
| 在線證明 | 處理吞吐量 | 約 110 tokens/s |
| 證明文件 | 單份體積 | 18.78 MB |
| 驗證端下載 | 權重承諾體積 | 約 6.5 MB |
| 驗證耗時 | 24 線程 / 單線程 | 17 秒 / 21 秒(含離線階段檢查) |
| 對比 vLLM | 單 GPU 時間倍數 | 約 72 倍(66-77 倍),最高負載下約 94 倍 |
對比基線是在 8 張 H100 上用 vLLM 運行同一模型的 FP8 版本。換句話說,證明一批請求所花的 GPU 時間,大約是正常推理處理同批請求的 70-95 倍,也就是約兩個數量級的額外開銷。
110 tokens/s 不等於實時證明完整回答
這是解讀 FlashProve 時最容易被誤讀的地方。技術報告明確限定:每份證明實際檢查的只是 Prompt 後面的一個 Token,110 tokens/s 是證明端處理請求窗口的吞吐量,而不是逐 Token 驗證完整回答的速度。
| 測算口徑 | 吞吐量 | 說明 |
|---|---|---|
| 24 請求批處理,按窗口處理量計 | 約 110 tokens/s | 博客標題級數字,每份證明檢查一個 Token |
| 檢查回答中每個 Token,按已檢查 Token 計 | 39.1 tokens/s | 更接近“驗證整段回答”的場景 |
| 單請求單獨證明 | 17.6 tokens/s | 單份證明約需 58 秒,失去批處理優勢 |
因此,“FlashProve 已經可以實時證明完整回答”的說法並不準確。更嚴謹的表述是:在批處理、短上下文、事後證明的條件下,它把可證明推理的成本壓到了此前難以想象的水平。
FlashProve 與既有可證明推理方案對比
可證明推理在學術界通常被稱爲 zkML。Anthropic 在博客中回顧了相關進展,數字對比相當直觀。
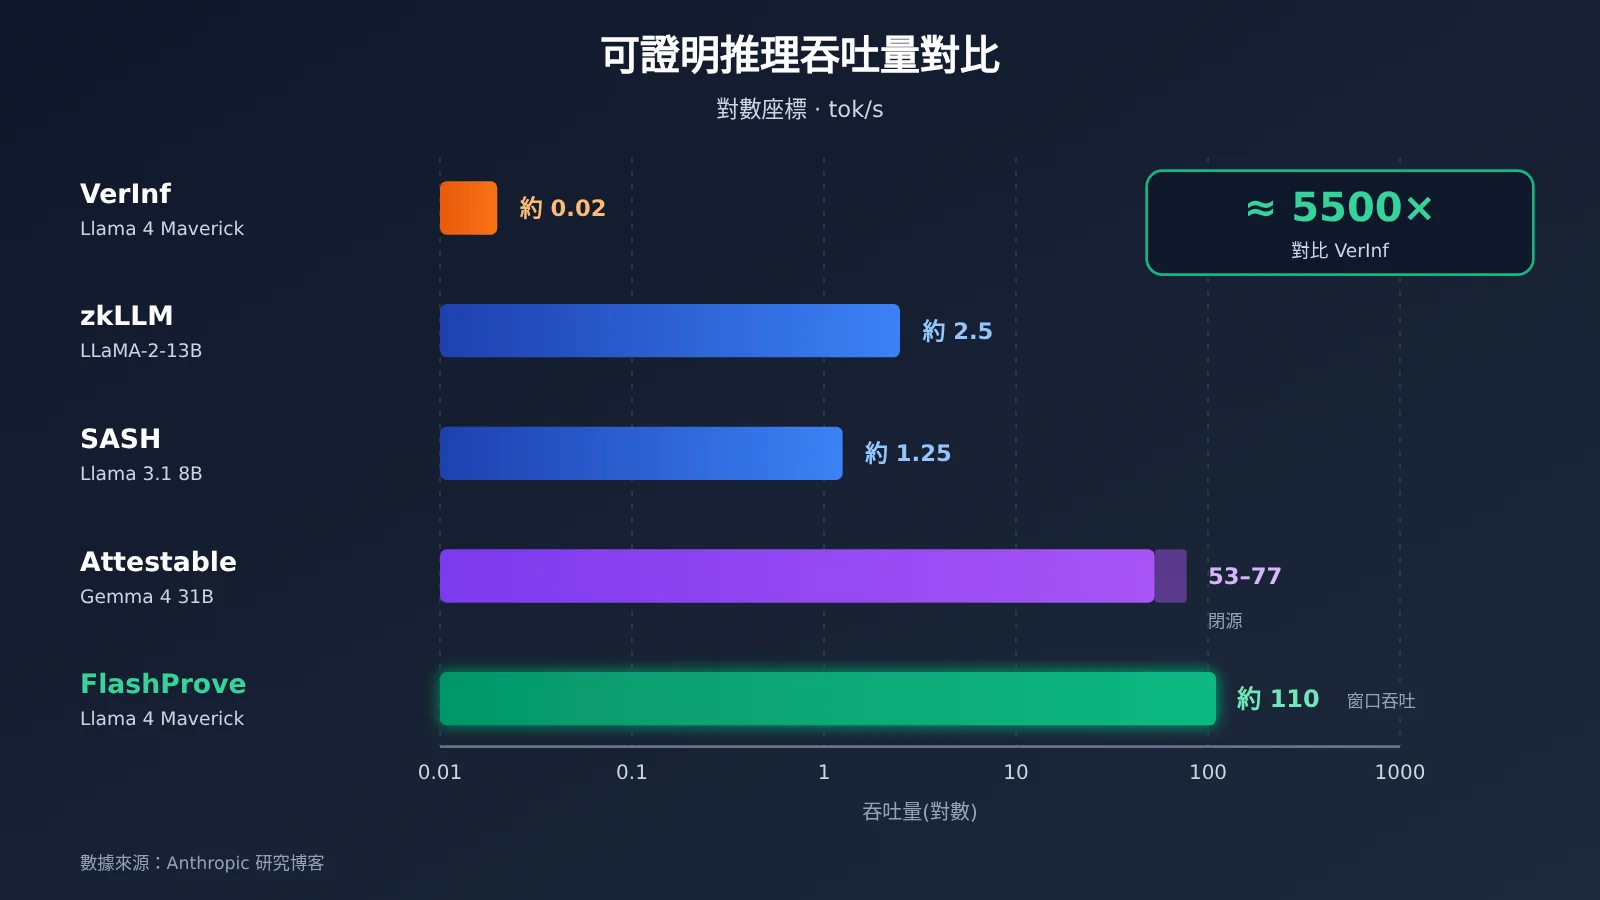
| 方案 | 證明對象 | 吞吐量 / 耗時 | 備註 |
|---|---|---|---|
| VerInf | Llama 4 Maverick(400B MoE) | 約 0.02 tok/s,1000 Token 需 14.3 小時 | 證明 93.6 GB,驗證近一天 |
| zkLLM(2024) | LLaMA-2-13B | 批處理約 2.5 tok/s | 單張 A100 |
| SASH(2026) | Llama 3.1 8B | 約 1.25 tok/s | 單張 H100 |
| Attestable | Gemma 4 31B(稠密模型) | 53-77 tok/s | 商業方案,暫未開源 |
| FlashProve | Llama 4 Maverick(400B MoE) | 約 110 tok/s | 證明約 19 MB,秒級驗證,開源 |
VerInf 對標分析:VerInf 是此前已知唯一證明過同一模型的方案,但其證明體積高達 93.6 GB,驗證需要近一天,基本無法實際使用。相比之下,FlashProve 把證明體積壓到約 19 MB,驗證縮短到十幾秒,讓普通 CPU 上的第三方審計第一次具備可行性。
Attestable 對標分析:Attestable 在稠密模型上取得了亮眼的商業化數字,但截至博客撰寫時尚未發佈對應開源庫。FlashProve 的優勢在於代碼、Lean 證明和文檔完全開放,任何人都可以復現與改進,代價是目前強依賴 MoE 架構。
FlashProve 能證明什麼,又不能證明什麼
對第三方 API 用戶來說,理解邊界和理解能力同樣重要。下表彙總了研究博客與技術報告中的關鍵限定:
| 維度 | FlashProve 能做到 | FlashProve 目前做不到 |
|---|---|---|
| 模型身份 | 證明綁定到具體的權重承諾,確認是“被承諾的那個模型” | 無法證明承諾對應的就是某個商業名稱的模型,需另行公開承諾 |
| 輸出正確性 | 證明被檢查 Token 是整數化模型的貪心解碼結果 | 不直接覆蓋浮點實現和隨機採樣(temperature 大於 0)的輸出 |
| 隱私保護 | 證明本身不泄露權重 | 不隱藏模型架構;生成耗時等側信道攻擊不在範圍內 |
| 上下文長度 | 支持最長 1024 Token 的上下文 | 遠短於聊天場景常見的數十萬到上百萬 Token |
| 防護時機 | 事後檢測出完整性問題 | 不能阻止被篡改的回答先送達用戶 |
| 模型架構 | 適用於 MoE 模型 | 稠密模型等其他架構需進一步研究 |
FlashProve 事後證明的檢測侷限
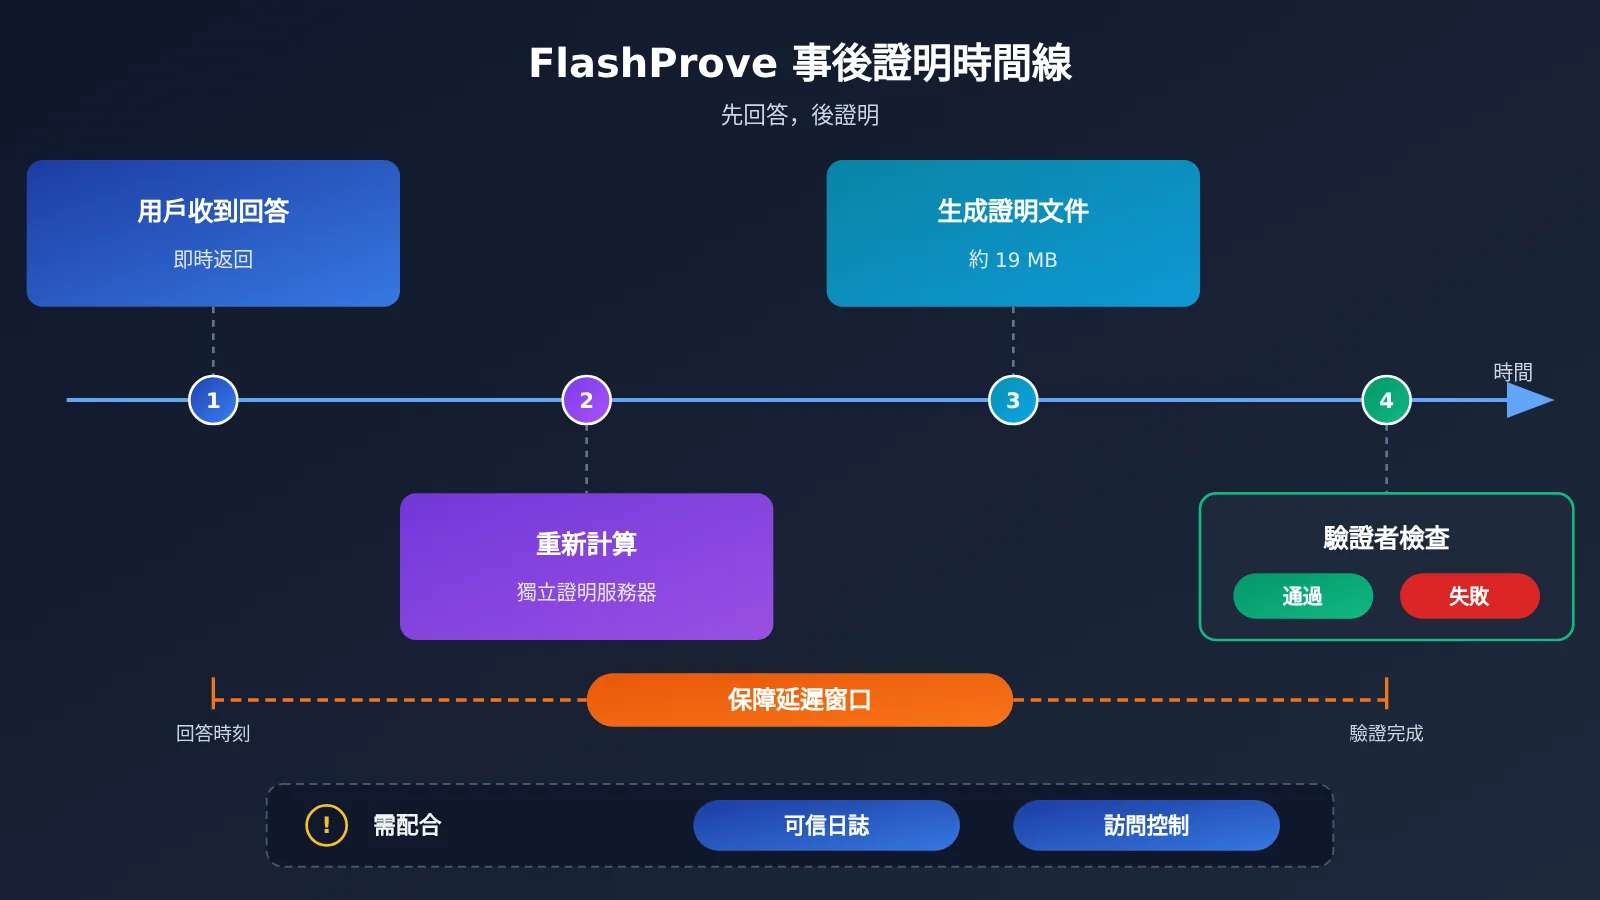
FlashProve 採用的是事後證明(Post-hoc Proving):用戶先收到響應,獨立證明服務器再重新計算並生成證明,最後由驗證者檢查。這種方式允許證明慢一些,換取不必在安全與效率之間妥協。代價是保障存在延遲,證明失敗只能揭示問題,無法讓用戶在收到回答前就得到保護。
技術報告還提醒,如果日誌系統本身被攻擊者控制,攻擊者可能一邊向用戶發送被篡改的內容,一邊讓日誌只記錄正確結果。所以 FlashProve 必須與可信日誌、訪問控制等安全措施配合使用。
FlashProve 形式化驗證的未完成部分
“用 Lean 做了形式化證明”很容易被理解爲“整個系統都被證明正確”,但事實並非如此。技術報告列出的邊界包括:
- Lean 對零知識性質的證明目前只覆蓋單請求證明,尚未覆蓋批量證明。
- GPU 證明端代碼由 AI 依據 Lean 表示生成,尚未證明與 Lean 表示等價。
- 日常使用的 C++ 快速驗證端同樣由 AI 生成,沒有形式化保證,只是在測試中與 Lean 驗證端的結論全部一致。
- 較長的協議規範文檔由 AI 生成,作者並未詳細審覈,應與作者撰寫的技術報告區分看待。
這些限制不代表研究無效,而是說明形式化驗證目前鎖定的是協議層的數學性質,可執行代碼與協議之間仍需人工或智能體審計來彌合。
影響分析:FlashProve 距離第三方 API 日常調用還有多遠
對開發者與 API 使用者的影響
- 短期內不會出現在日常調用鏈路中:約兩個數量級的 GPU 開銷、每請求約 19 MB 的證明文件、1024 Token 的上下文上限,都讓它難以直接用於高頻對話類 API。
- 適用面受限:系統假設 MoE 架構、整數化模型與貪心解碼,大多數生產調用使用隨機採樣和浮點推理,不能直接套用。
- 認知層面的價值更大:它第一次讓“驗證模型身份”從不可能變成工程問題。開發者應當意識到,返回的模型名稱字段、模型 ID 或普通請求日誌,都不等同於密碼學證明。
💡 選擇建議:在可證明推理成熟之前,選擇第三方服務時更值得關注的是計費透明度、調用日誌可追溯性和自測一致性。通過 API易 apiyi.com 這類聚合平臺調用時,可以同時請求多個模型並保留完整調用記錄,便於自行做交叉對比與審計。
對行業與監管的影響
- 評測與合規工具箱多了一個選項:監管方可以要求提供方爲一段時期的推理請求附上證明,確認硬件確實在服務指定模型,同時不獲知專有權重。但 Anthropic 也承認,這無法證明硬件沒有在旁路做訓練。
- 軟件方案與可信硬件互補:可信執行環境依賴廠商的防篡改硬件,zkSNARK 依賴計算難題的困難性,即使硬件和操作系統被攻破也無法僞造證明,兩者會在不同場景各自發揮作用。
- Anthropic 的生產驗證走的是另一條路:Anthropic 在 2026 年 10 月 19 日更新的 Frontier Safety Roadmap 中提到,其推理驗證項目已在生產推理流量上建立原型,通過簽名覆蓋內部 Token 流量並在可信服務器上覆算推理,還捕獲過一次極其罕見、非惡意的完整性異常。該項目名稱已改爲 inference verification,與 FlashProve 是相關但獨立的兩個項目,不能混爲一談。
第三方 API 調用者現在能做什麼:自建調用審計記錄
既然密碼學證明暫時還用不上,開發者能做的是先把“可追溯”做好。下面的示例在調用時固定 temperature=0,並把請求時間、請求 ID、返回的模型字段與回答哈希寫入本地日誌,方便後續做一致性複測。需要強調的是,這只是工程層面的審計記錄,不是對模型身份的密碼學證明。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句話解釋零知識證明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
查看完整審計日誌實現代碼
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一個 Key 調用多家模型
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """調用模型並記錄可追溯信息(非密碼學證明)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # 僅爲服務端返回的聲明字段
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# 固定一組探針 Prompt,定期複測並對比輸出哈希與延遲分佈
probes = ["計算 37*43 並只輸出結果", "列出三種排序算法的時間複雜度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 快速開始:可以通過 API易 apiyi.com 獲取免費測試額度,用上面的探針腳本對多個模型做定期複測。需要說明的是,這類方法只能提升可追溯性,無法替代 FlashProve 這類權重級證明。
在此基礎上,還可以搭配幾條實用做法:固定模型 ID 而非使用模糊別名;保留一組探針 Prompt 長期跟蹤輸出與延遲變化;對關鍵業務同時請求多個模型交叉校驗;關注服務商是否公開權重承諾或可驗證機制的進展。
常見問題 FAQ
Q1:什麼是 FlashProve?
FlashProve 是 Anthropic 於 2026 年 11 月開源的可證明推理研究原型。它基於 zkSNARK,讓模型提供方先對權重做承諾,再爲推理結果生成證明,用戶無需權重、只用 CPU 就能驗證回答是否來自被承諾的模型。
Q2:FlashProve 和 Anthropic 的推理驗證(inference verification)項目有什麼區別?
兩者目標相近但實現不同。推理驗證項目已在生產流量上建立原型,採用簽名內部 Token 流量並在可信服務器復算的方式;FlashProve 則是純軟件的密碼學證明方案,目前仍是研究原型,兩者不應混爲一談。
Q3:FlashProve 的 110 tokens/s 是不是意味着能實時證明完整回答?
不是。110 tokens/s 是批處理下的窗口處理吞吐量,每份證明只檢查一個 Token。檢查回答中每個 Token 時吞吐量爲 39.1 tokens/s,單請求證明則降到 17.6 tokens/s,並且整個過程是事後證明。
Q4:API易 是否已經爲每條響應提供 FlashProve 證明?
沒有。目前沒有任何材料表明 API易 apiyi.com 部署了 FlashProve 或提供權重級密碼學證明,平臺返回的模型名稱與調用日誌也不等同於密碼學證明。現階段更務實的做法,是利用平臺的統一接口和調用記錄做自主複測與交叉對比。
Q5:如何通過 API 快速做多模型一致性測試?
推薦使用支持多模型的聚合平臺:
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key 與免費測試額度
2. 將本文代碼中的 base_url 設置爲 `https://api.apiyi.com/v1`
3. 固定 `temperature=0`,用探針 Prompt 定期複測並記錄輸出哈希
這套方法便於發現異常波動,但它屬於工程審計,而非模型身份證明。
Q6:FlashProve 有哪些已知限制?
主要包括:GPU 開銷約爲正常推理的 70-95 倍;上下文上限 1024 Token;依賴 MoE 架構、整數化模型和貪心解碼;不隱藏模型架構,側信道攻擊不在範圍內;事後證明無法阻止篡改內容先送達;可執行代碼與 Lean 協議之間尚無形式化等價證明。
FlashProve 核心要點 Key Takeaways
- 信任缺口真實存在:第三方 API 調用中,回答質量高不能證明模型身份真實。
- 核心機制:離線權重承諾加在線 zkSNARK 證明,用戶用 CPU 即可驗證。
- 成本大幅下降:單 H100 窗口吞吐約 110 tokens/s,證明約 19 MB,驗證約 17 秒。
- 口徑要分清:逐 Token 檢查吞吐爲 39.1 tokens/s,單請求僅 17.6 tokens/s。
- 邊界明確:僅限 MoE、整數化貪心解碼、1024 Token 上下文和事後檢測。
- 上手方式:現階段可藉助 API易 apiyi.com 多模型統一接口做自主複測與審計。
總結
FlashProve 的核心意義可以歸納爲三點:
- 把模型身份驗證變成工程問題:此前證明同一模型需要十幾個小時和近百 GB 證明,如今壓縮到批處理百 tokens/s 級別與 19 MB 證明。
- 離生產可用仍有距離:兩個數量級的開銷、短上下文、架構與解碼方式限制,加上形式化驗證覆蓋不完整,決定了它目前仍是研究原型。
- 需要與其他安全機制配合:事後證明只能檢測、不能攔截,必須搭配可信日誌和訪問控制。
對於今天的第三方 API 使用者,最務實的態度是:既不要把模型名稱字段當作證明,也不必因此過度焦慮,先把調用記錄、探針複測和多模型交叉校驗做紮實,同時持續關注可證明推理的成熟進度。推薦通過 API易 apiyi.com 用一個 Key 對比多家模型,在自己的業務數據上建立可追溯的質量基線。
📚 參考資料
- Anthropic 研究博客 – Progress on provable inference for large language models:FlashProve 原始發佈文章
- 鏈接:
anthropic.com/research/provable-inference -
說明: 包含系統設計、實測數據、既有方案對比與侷限說明
-
FlashProve 技術報告:研究博客附帶的完整技術細節
- 鏈接:
anthropic.com/research/provable-inference(頁面內 Read the technical report 入口) -
說明: 包含吞吐量口徑、事後證明侷限、形式化驗證邊界等關鍵限定
-
Anthropic Frontier Safety Roadmap:推理驗證項目的進展說明
- 鏈接:
anthropic.com - 說明: 瞭解 inference verification 與 FlashProve 的區別
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 官網首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心