作者注:同一批中國開源模型,在門羅風投支出榜和 OpenRouter 請求榜中排名相反。本文拆解兩份榜單的統計口徑,並給出一套可以直接執行的 5 步選型方法。
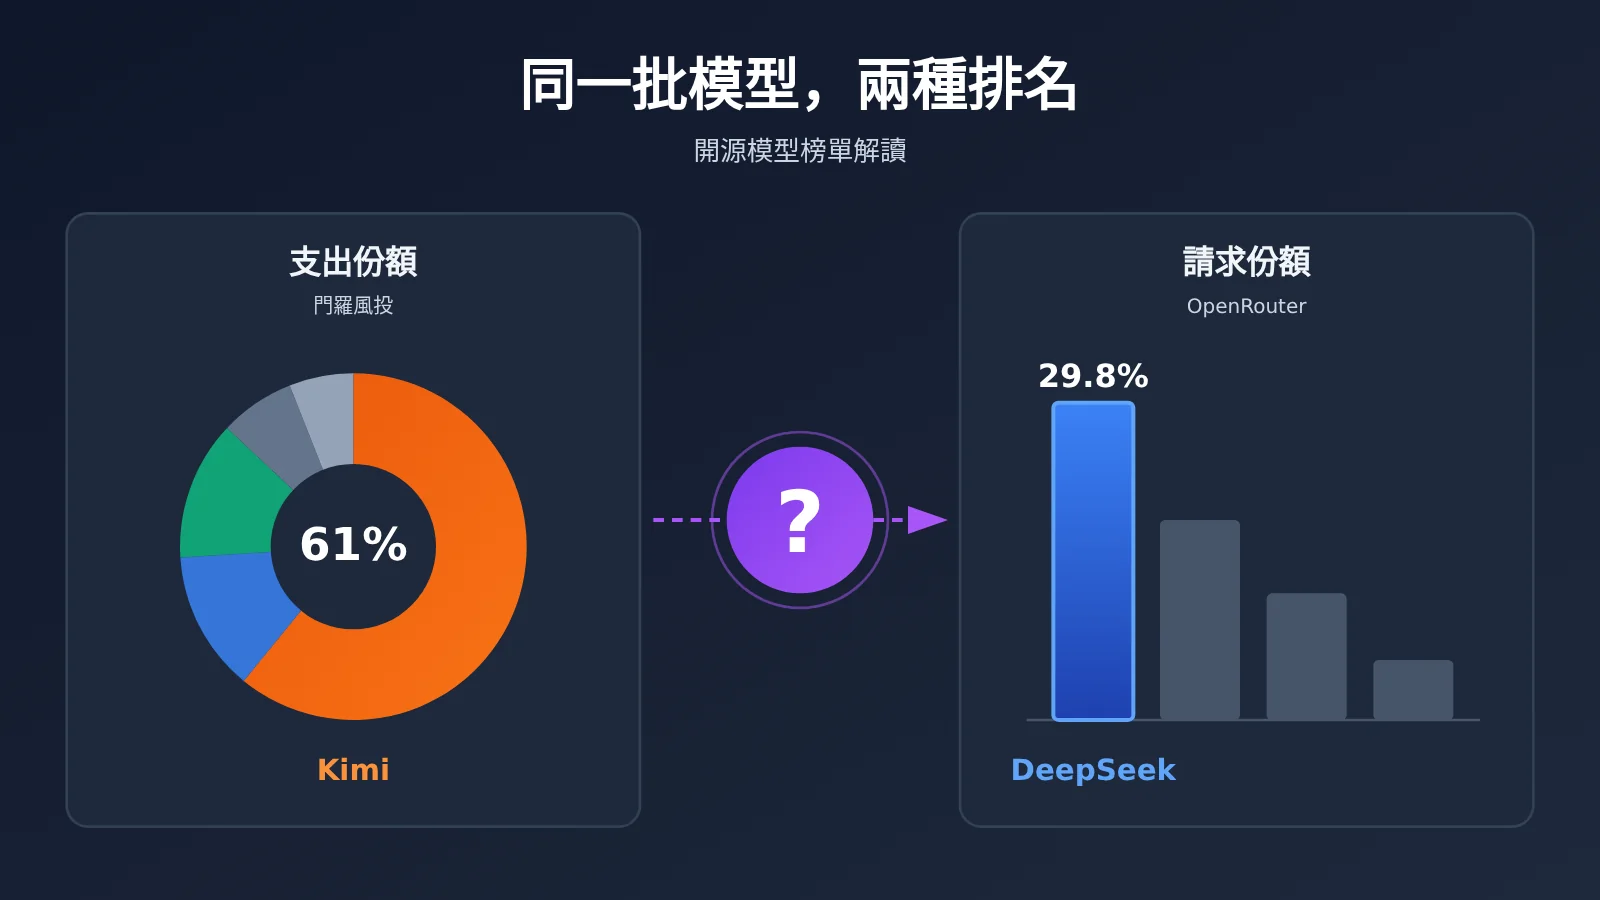
11 月初出了兩份數據。門羅風投報告顯示,Kimi 拿走美國企業開源模型支出的 61%。OpenRouter 周榜顯示,DeepSeek 拿走平臺 29.8% 的文本請求。兩邊的第一名不是同一家,排名幾乎反過來。很多技術負責人第一反應是:到底該信哪一份?
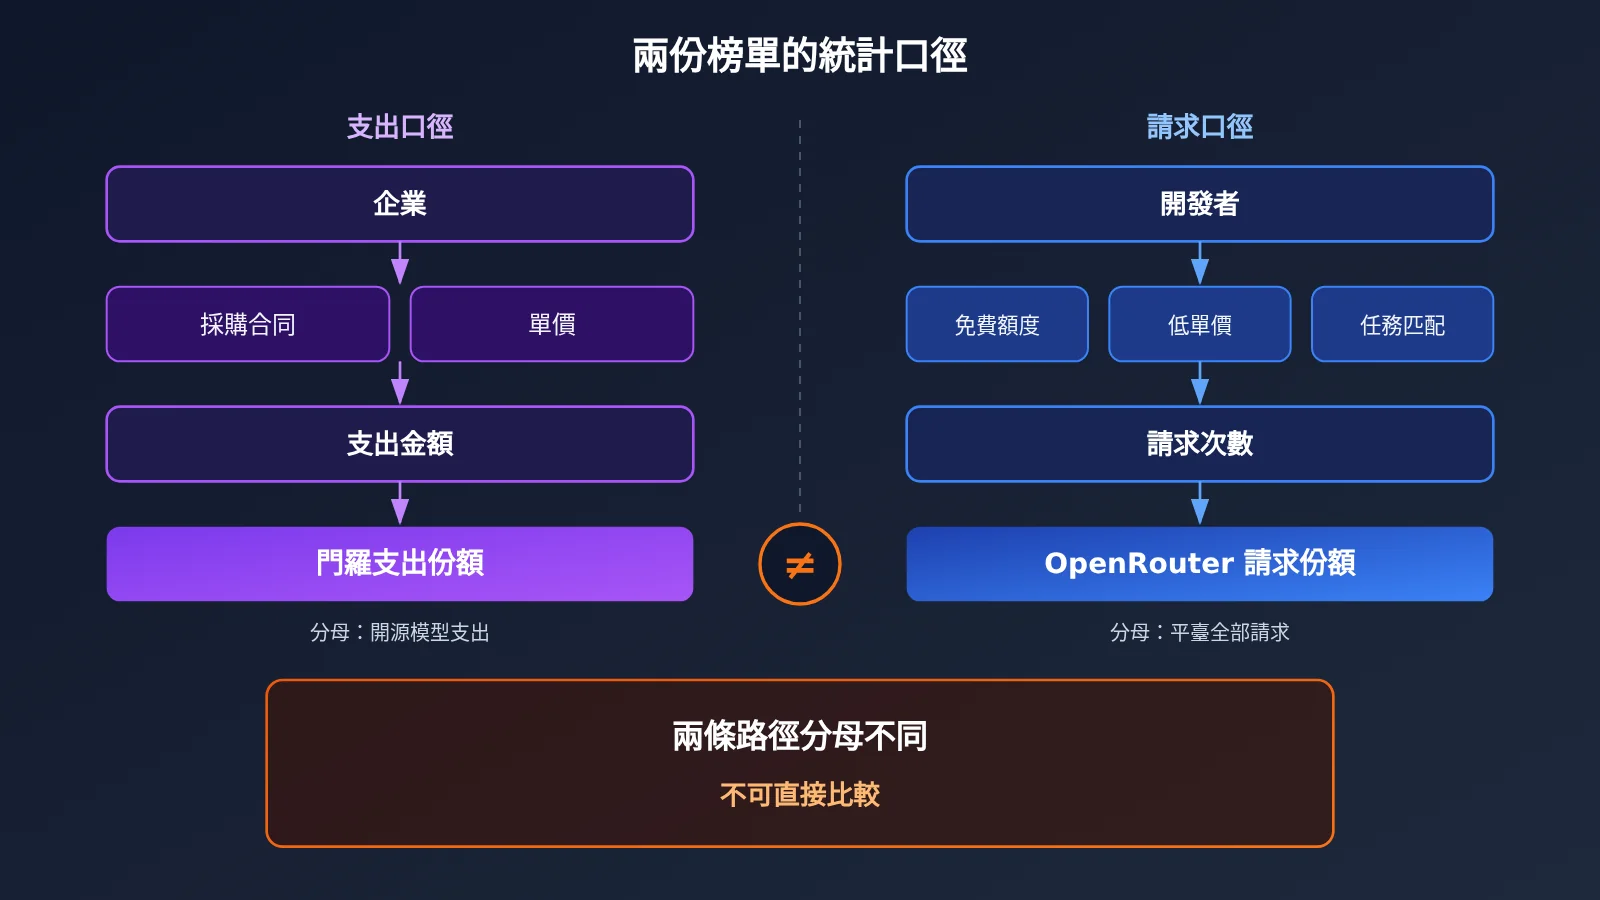
結論是兩份榜單並不矛盾,它們衡量的是兩件事。支出榜看的是“企業把錢付給了誰”,請求榜看的是“開發者在某個平臺上調用了誰”。選型時不能挑一份榜單照抄,要按自己的任務類型和成本口徑來判斷。榜單隻能縮小候選範圍,不能替你完成選型。
這不是又一篇排名複述。本文會說明每份榜單的樣本、時間窗口和適用邊界,再講清楚“單價降、用量漲”對成本結構有什麼影響,最後給出一份 5 步選型清單。
開源模型榜單核心信息速覽:Kimi 與 DeepSeek 爲什麼各拿一個第一
結論先行:門羅風投量的是企業支出,OpenRouter 量的是平臺請求,兩者的樣本、時間和統計對象都不同。
這兩份數據經常被放在一起討論,可它們的“分母”完全不同。門羅風投的數據來自對美國企業 AI 決策者的問卷調查,屬於調查估算,不是審計賬單。OpenRouter 的數據來自它自己平臺上的請求統計,只能反映這個平臺的用戶行爲,不能代表全市場。
| 榜單 | 衡量對象 | 樣本/時間 | 關鍵排名 | 適合用來判斷什麼 |
|---|---|---|---|---|
| 門羅風投 2026 企業 AI 現狀報告 | 美國企業開源模型支出份額 | 近 400 名美國企業 AI 決策者,2026 年 9 月 8-26 日調研,11 月 3 日發佈 | Kimi 61%、DeepSeek 15%、GLM 11%、Meta Llama 7%、Qwen 3% | 企業採購偏好、預算流向、哪些模型進入了正式合同 |
| OpenRouter 周榜 | 平臺文本請求份額 | OpenRouter 平臺,10 月 26 日-11 月 1 日 | DeepSeek 29.8%、OpenAI 18.8%、Z.ai 11.9%、Qwen 5.6%(第六) | 開發者活躍度、價格敏感型調用、社區熱度 |
看錶就能發現,兩份榜單連“參賽選手”都不一樣。門羅只統計開源模型,OpenRouter 則把 OpenAI、Google 這樣的閉源廠商也算進去。直接拿兩個百分比對比,本身就是口徑錯位。
門羅風投支出榜怎麼讀:Kimi 拿走 61% 開源模型支出
結論先行:門羅風投的數據說明中國開源模型已經進入美國企業預算,但它是調查估算,不是能力排名。
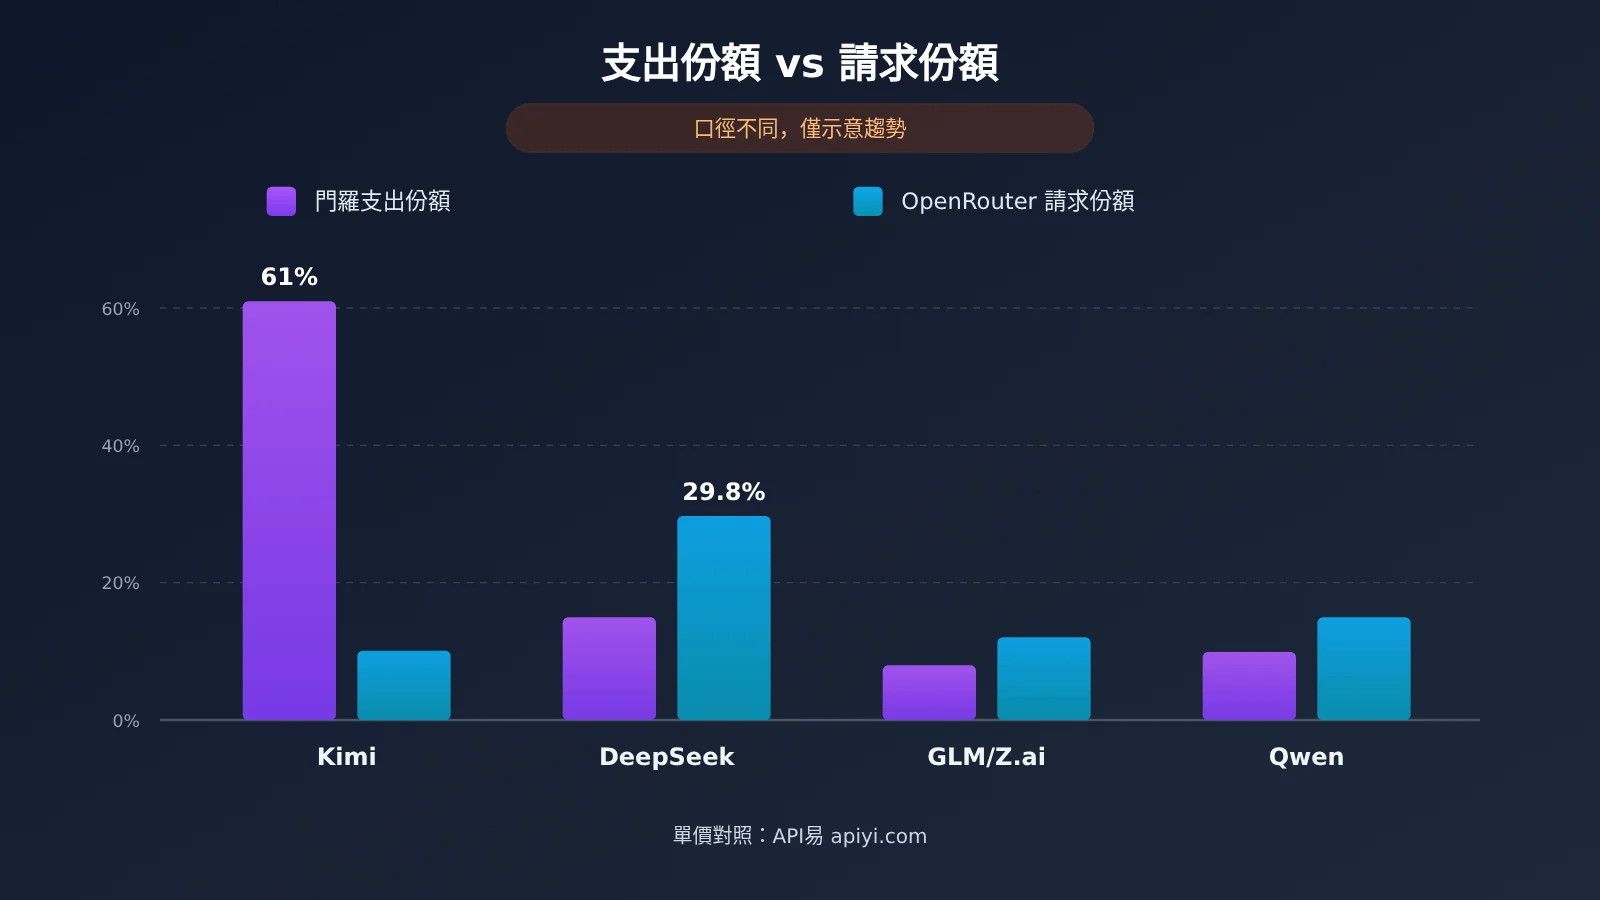
報告最受關注的數字是:中國模型佔美國企業開源模型支出的 89%。其中 Kimi 一家就佔 61%,DeepSeek 15%,GLM 11%,Qwen 3%。非中國模型裏,Meta Llama 佔 7%。
| 模型 | 美國企業開源模型支出份額 | 閱讀要點 |
|---|---|---|
| Kimi | 61% | 份額最高,可能與企業採購渠道和單價有關 |
| DeepSeek | 15% | 支出排第二,但調用側更活躍 |
| GLM | 11% | 穩定進入企業預算 |
| Meta Llama | 7% | 非中國開源模型中份額最高 |
| Qwen | 3% | 支出份額較小,調用側有一定存在感 |
把這些數字放回全局會更清楚。報告估算全球企業 AI 部署支出年化約 1768 億美元,三年增長超過 100 倍。前沿實驗室佔部署支出的 69%,開源模型在整體模型支出中只佔 4%。所以“Kimi 拿 61%”說的是開源這一小塊裏的 61%,不是整個企業 AI 市場的 61%。
另外,問卷數據依賴受訪者對自家預算的估計,近 400 個樣本也只覆蓋美國企業。合理的讀法是:這份數據說明了企業採購的方向性趨勢,具體比例屬於調查估算,有待更多數據驗證。
OpenRouter 請求榜怎麼讀:DeepSeek 拿走 29.8% 請求
結論先行:OpenRouter 周榜反映的是這個平臺上開發者的調用熱度,可以看趨勢,但不能代表全市場份額。
10 月 26 日至 11 月 1 日這一週,DeepSeek 以 29.8% 的文本請求份額排第一,環比增長 7%。OpenAI 以 18.8% 排第二,Google 的份額從 14.4% 下滑,Z.ai 以 11.9% 排第四,Qwen 以 5.6% 排第六。
| 排名信息 | 廠商 | 請求份額 | 變化 |
|---|---|---|---|
| 第 1 | DeepSeek | 29.8% | 環比 +7% |
| 第 2 | OpenAI | 18.8% | — |
| 下滑 | 從 14.4% 下降 | 份額回落 | |
| 第 4 | Z.ai | 11.9% | — |
| 第 6 | Qwen | 5.6% | — |
還有兩條趨勢值得注意。中國模型的 token 調用量已經連續 27 周超過美國模型,單模型周調用量前五里,中國模型佔了四席。同期 DeepSeek 把模型升級到 DeepSeek V4.1-Flash-1017,API 調用方式和價格都沒有變化,這對已經接入的開發者來說遷移成本很低。
穩定性方面也要留意。11 月 3 日,DeepSeek 的網頁端和 API 出現過約 1 小時的部分中斷。調用量大不代表永遠可用,這正是後面要講的“留備用模型”的理由。新版本上線後,具體模型 ID 和計費以 API易 apiyi.com 控制檯的模型列表爲準。
爲什麼開源模型支出榜和請求榜排名相反
結論先行:排名相反主要由單價、採購方式、免費額度、任務匹配和平臺口徑五個因素造成,不說明哪一份榜單“錯了”。
支出份額大致等於“調用量 × 單價”,再疊加合同和採購因素。請求份額只數調用次數,不管每次花多少錢。如果一個模型單價更高、企業願意籤採購合同,它在支出榜上就會靠前。如果一個模型單價低、開發者用得多,它在請求榜上就會靠前。
| 影響因素 | 對支出份額的作用 | 對請求份額的作用 |
|---|---|---|
| 單價 | 單價高,同樣用量花費更多,支出份額被放大 | 單價低吸引更多試用,請求量上升 |
| 企業採購 | 合同、私有化部署、服務協議計入支出 | 不一定經過 OpenRouter,平臺上看不到 |
| 免費額度 | 免費調用不產生支出 | 免費調用會計入請求量 |
| 任務匹配 | 長文檔、Agent 等高 token 任務推高花費 | 短對話、批量小任務推高次數 |
| 平臺口徑 | 只覆蓋受訪的美國企業 | 只覆蓋 OpenRouter 用戶 |
按這個框架看,Kimi 可能在企業採購渠道和單價上更有優勢,所以支出份額高。DeepSeek 單價更低、開發者社區活躍,所以請求量大。這是基於口徑的合理推測,兩份報告本身沒有給出逐項拆分。
還有一個經常被忽略的細節:同一個模型的不同版本、不同接入渠道、不同緩存命中率,都會讓支出和調用數字出現偏差。一個團隊如果大量命中緩存,請求次數照樣計入,但實際支出會低很多。
開源模型價格與用量:單價降約 7 成、用量漲 22.5 倍意味着什麼
結論先行:單價下降不等於總成本下降,按“完成一個任務的成本”比較,比按每百萬 token 單價比較更可靠。
門羅報告裏有一組關鍵數字:平均 token 價格從 0.45 美元/百萬 token 降到 0.13 美元/百萬 token,降幅約 7 成,同期用量增長了 22.5 倍。按這兩個數字粗略推算,總花費不降反升,大約是原來的 6.5 倍。這只是基於報告平均值的示意計算,各團隊的實際情況會有差異。
開源模型的情況更典型。開源模型佔企業 token 用量的 19%,卻只佔模型支出的 4%。也就是說,大量 token 跑在便宜的開源模型上,但錢主要還是付給了前沿閉源模型。
對開發者來說,單價下降會刺激更多調用,Agent 和批量任務尤其明顯。真實成本還要考慮下面幾個變量:
- 緩存命中:重複的系統提示詞和長上下文能否命中緩存,直接決定實際單價。
- 上下文長度:長文檔任務的輸入 token 往往遠多於輸出。
- 重試次數:輸出不穩定、格式出錯導致的重試,會讓成本成倍增加。
- 工具調用輪次:Agent 任務一次可能來回十幾輪,單價低但輪次多。
比較價格時,建議先在 API易 apiyi.com 控制檯查看候選模型的列表價格和計費方式,確認輸入、輸出、緩存分別怎麼算。然後用自己的任務跑一小批樣本,把“完成一個任務花了多少錢”算出來,這個數字比列表單價更有參考價值。
開源模型選型方法:用榜單縮小範圍,用任務做決定
結論先行:榜單負責給出候選名單,最終決策要靠任務匹配、成本、穩定性和小樣本驗證。
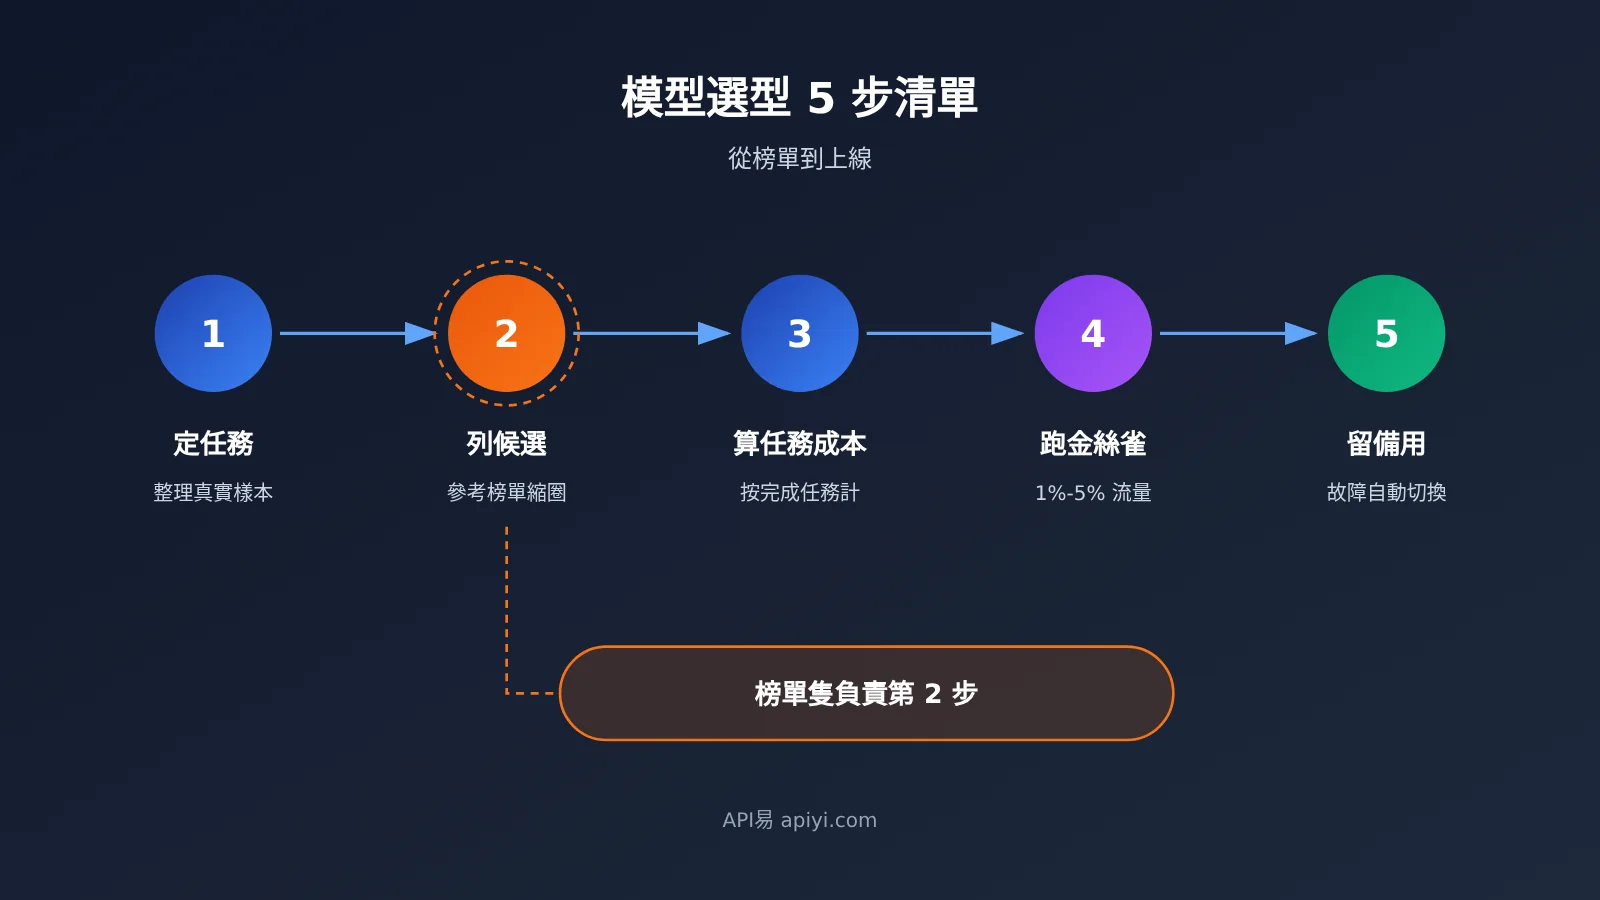
選型可以按“任務 → 成本 → 穩定性 → 驗證 → 備用”的順序推進。下表列出了每個維度要問的問題和驗證方法。
| 維度 | 要問的問題 | 怎麼驗證 | 對成本的影響 |
|---|---|---|---|
| 任務匹配 | 主要是編程、長文檔、多模態,還是 Agent 工具調用? | 準備 30-100 條真實任務樣本,人工評估輸出 | 匹配度低會增加重試和人工修改 |
| 單價與緩存 | 輸入、輸出、緩存命中分別多少錢? | 查控制檯模型列表與計費說明,統計緩存命中率 | 決定每百萬 token 的實際單價 |
| 上下文 | 最長輸入多長?超長後效果是否下降? | 用最長的真實文檔測試截斷和召回 | 長上下文直接推高輸入 token |
| 限流 | 併發和每分鐘請求上限夠不夠? | 按峯值流量做壓測 | 被限流時需要排隊或切換,影響時延 |
| 地區可用性 | 部署地區能否穩定訪問? | 在生產所在地區實際調用 | 不可用就要另找渠道 |
| 穩定性 | 近期有沒有中斷?恢復要多久? | 查故障歷史,觀察錯誤率日誌 | 中斷會造成重試成本和業務損失 |
多模型對比是這一步最耗時的地方。如果每個候選模型都要單獨註冊、單獨對接 SDK,光是接入就要花好幾天。通過 API易 apiyi.com,一個 API Key 就能調用 OpenAI、Claude、Gemini 以及 DeepSeek、Kimi 等多家模型。接口兼容 OpenAI 格式,把 base_url 設爲 https://api.apiyi.com/v1,在請求裏改 model 參數就能切換模型,同一批樣本可以很快跑完橫向對比。
穩定性這一項不能只看廠商公告。DeepSeek 11 月 3 日的中斷提醒我們,任何單一模型都可能臨時不可用。在 API易 apiyi.com 控制檯可以按模型查看用量和調用日誌,錯誤率、時延、token 消耗都有記錄,適合在金絲雀階段觀察候選模型的真實表現。平臺採用多節點部署和智能路由,並提供自動降級。業務側再配置一個備用模型,主模型出錯時切到備用模型,就能把單點故障的影響控制在較小範圍。
金絲雀發佈建議從 1%-5% 的真實流量開始,持續觀察幾天的錯誤率、時延和單任務成本。數據穩定後再逐步放量,不要看完榜單就一次性全量切換。
開源模型榜單常見問題 FAQ
結論先行:下面 5 個問題覆蓋了讀開源模型榜單時最常見的誤區。
Q1:Kimi 支出份額 61%,是不是說明 Kimi 模型更好?
不是。支出份額反映的是錢流向了誰,會受單價、企業採購合同和渠道影響,和模型能力沒有直接對應關係。而且門羅數據是調查估算,口徑只覆蓋美國企業的開源模型支出。“支出第一”不等於“能力第一”,能力要用你自己的任務來評估。
Q2:OpenRouter 請求排名能代表企業採購嗎?
不能。OpenRouter 統計的是自己平臺上的請求份額,用戶以開發者和中小團隊爲主。企業的直籤合同、私有化部署和其他渠道都不在統計範圍內。它適合觀察開發者熱度和價格敏感型調用的趨勢,不適合推斷企業預算分佈。
Q3:單價低的模型,總成本一定低嗎?
不一定。如果單價低的模型需要更多重試、更長的提示詞或更多工具調用輪次,總 token 消耗可能反而更高。建議按“完成一個任務”來算成本:在 API易 apiyi.com 控制檯查看每次調用的 token 用量和費用日誌,對比不同模型完成同一批任務的總花費。
Q4:開源模型能完全替代閉源模型嗎?
要看具體任務。門羅數據顯示開源模型承擔了企業 19% 的 token,但只佔 4% 的支出,說明很多團隊把批量、常規任務交給開源模型,複雜任務仍留給前沿閉源模型。比較穩妥的做法是混合使用:通過 API易 apiyi.com 用同一個 Key 同時接入開源和閉源模型,再按任務難度分流。
Q5:開源模型榜單多久看一次比較合適?
周榜可以每月瀏覽一次,看趨勢而不是追單週波動。年度或季度調查報告發布時細讀一次,關注口徑和樣本有沒有變化。真正影響你決策的,是自家業務指標的持續監控,比如錯誤率、單任務成本和用戶反饋,這些建議按周覆盤。
開源模型榜單解讀總結:5 步選型清單
結論先行:兩份榜單量的是兩件事,讀榜單的正確姿勢是先問口徑、再看樣本、最後用自己的任務驗證。
核心要點回顧:
- 支出 ≠ 調用:門羅量企業支出,OpenRouter 量平臺請求,分母不同,不能直接比較。
- 調查 ≠ 審計:門羅數據是近 400 名美國企業決策者的調查估算,OpenRouter 只代表自己的平臺。
- 便宜 ≠ 省錢:單價降約 7 成、用量漲 22.5 倍,總花費反而上升,要按任務成本來算。
- 熱門 ≠ 穩定:調用量第一的模型同樣會中斷,備用方案必須提前準備。
- 榜單隻能縮小候選範圍,不能替你完成選型。
下面這份清單可以直接用於下一次模型選型:
- 定任務:寫清楚主要任務類型(編程、長文檔、多模態、Agent),整理 30-100 條真實樣本和評估標準。
- 列候選:參考支出榜和請求榜各取 2-3 個模型,再加 1 個閉源模型作爲基準,候選控制在 3-5 個。
- 算任務成本:用同一批樣本跑所有候選,記錄 token 用量、緩存命中、重試次數,算出單任務成本和質量得分。
- 跑金絲雀:選出的模型先承接 1%-5% 的真實流量,觀察幾天的錯誤率、時延和成本,達標後再放量。
- 留備用:至少配置一個不同廠商的備用模型,寫好切換規則,並定期演練。
如果想把第 3 步到第 5 步放在同一個入口完成,可以通過 API易 apiyi.com 用一個 Key 接入候選模型,在控制檯對照價格、用量與日誌,再結合平臺的自動降級能力設置備用切換。新用戶有免費測試額度,適合先跑小樣本驗證。
本文數據來源
- 門羅風投 2026 企業 AI 現狀報告:2026 年 11 月 3 日發佈
- 鏈接:
menlovc.com -
說明: 企業 AI 支出、開源模型支出份額與 token 價格變化,屬於調查估算
-
OpenRouter 模型排行榜:2026 年 10 月 26 日-11 月 1 日周榜
- 鏈接:
openrouter.ai/rankings - 說明: 平臺文本請求份額與 token 調用趨勢,僅代表該平臺
作者: APIYI 技術團隊
技術交流: 模型選型中遇到價格、限流或切換方面的問題,歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心