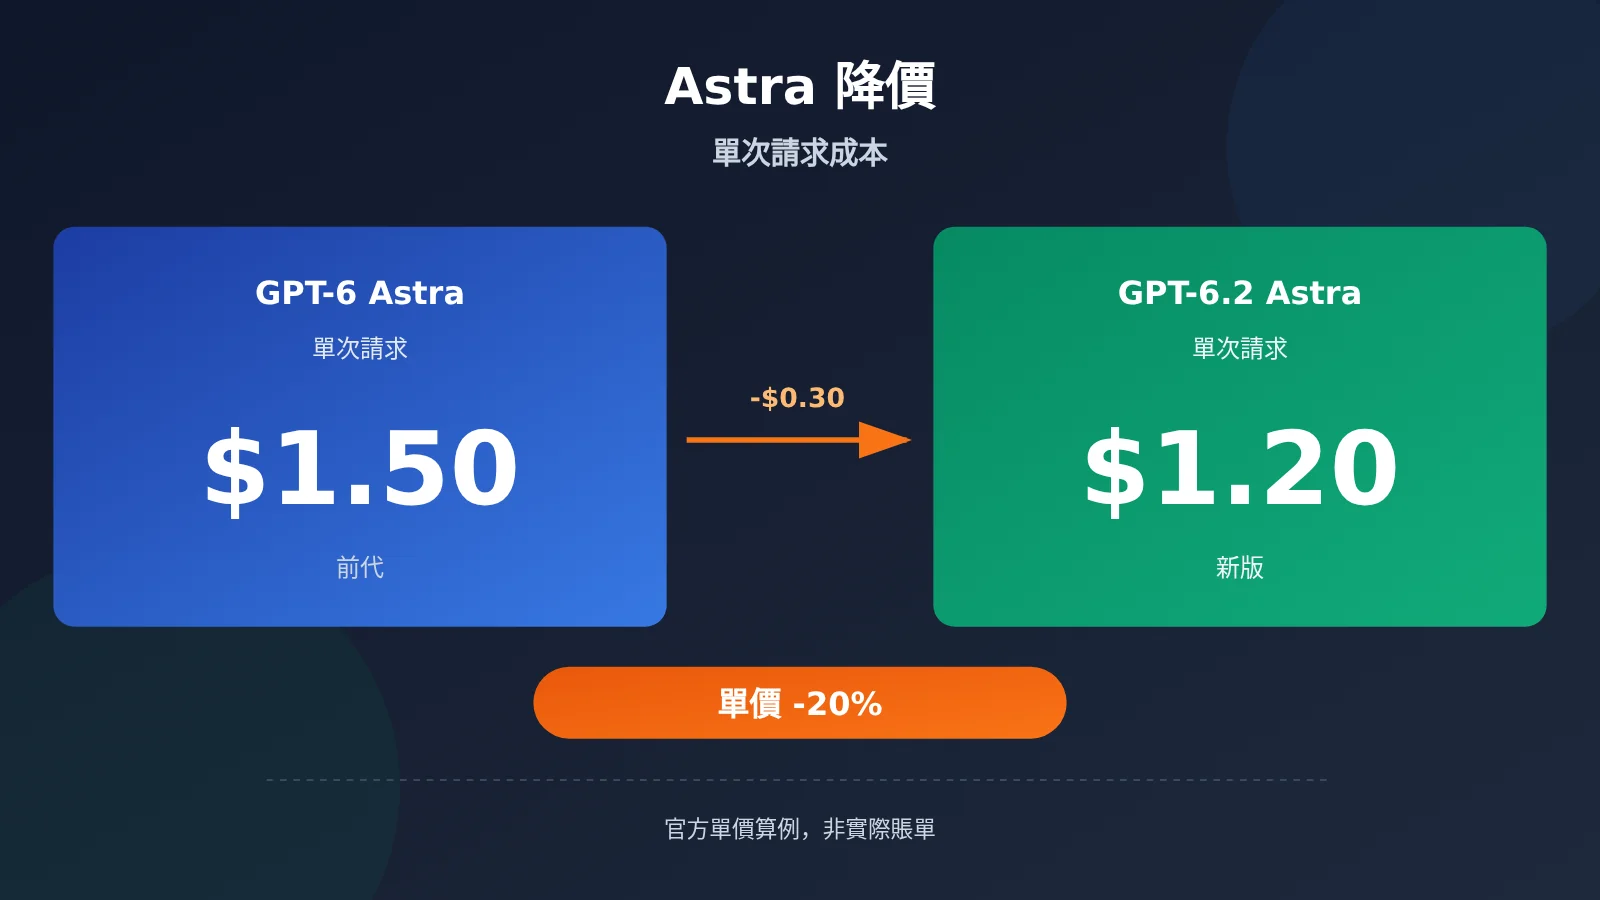
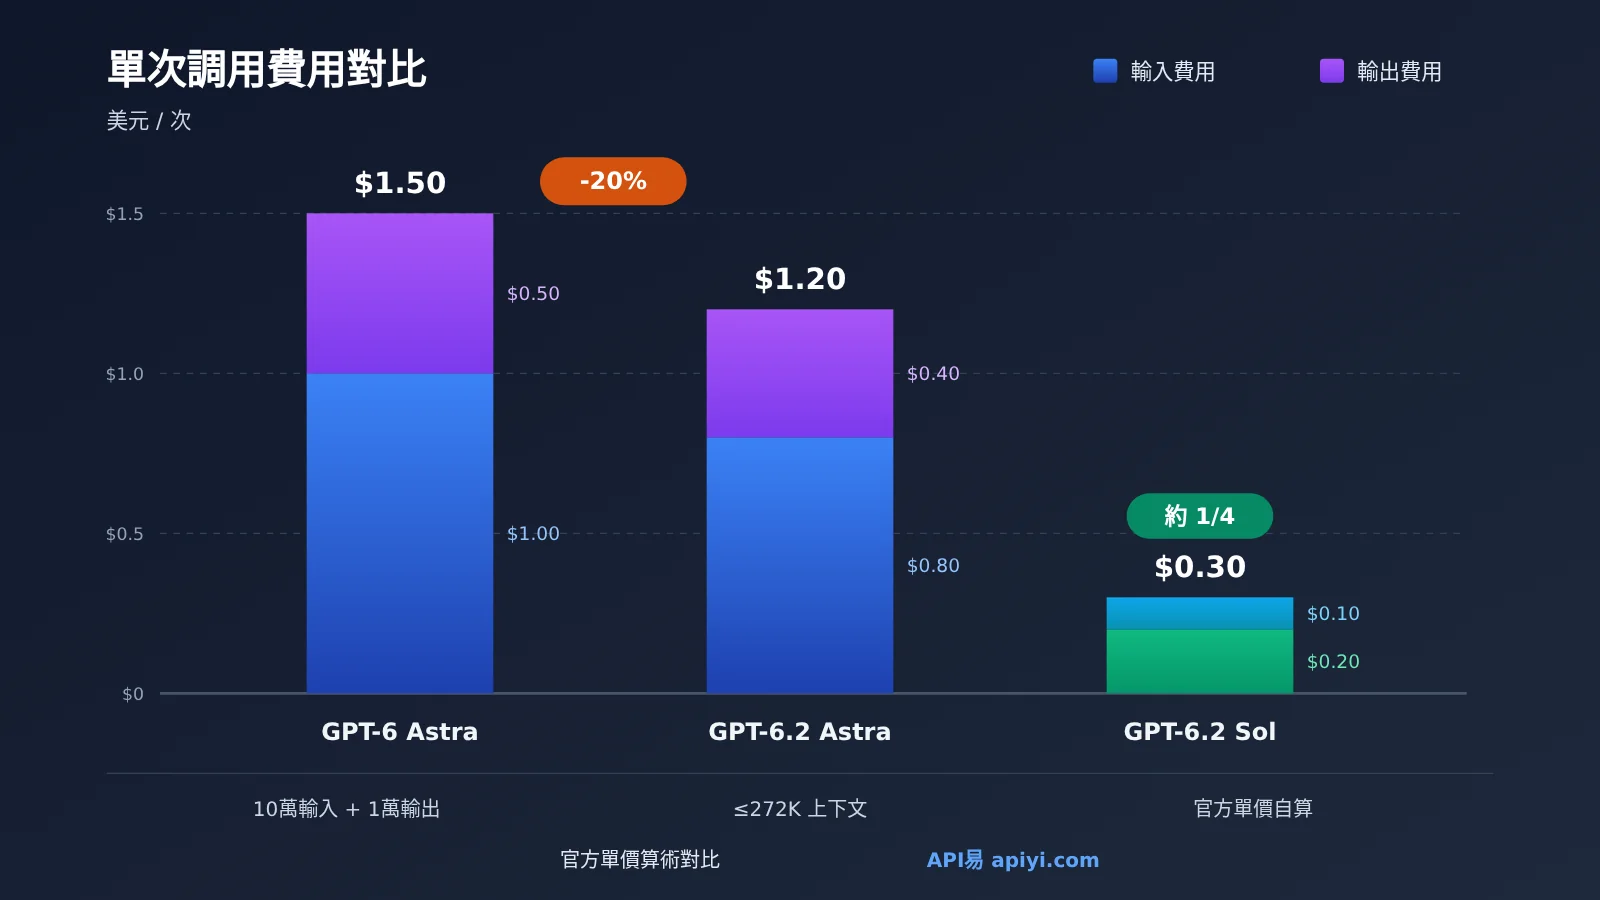
以一次“非緩存 10 萬輸入 + 1 萬輸出、輸入不超過 272K”的標準請求爲例:按官方標準單價計算,GPT-6 Astra 約需 $1.50,GPT-6.2 Astra 約需 $1.20,每次少花 $0.30,正好是 20%。同樣的 token 量換成 GPT-6.2 Sol 只需約 $0.30。需要注意,這是“單價下降 20%”。緩存、長上下文階梯、推理輸出量、工具調用等因素都會影響最終費用,實際賬單不一定按 20% 同比例下降。
您讀完此文能瞭解到什麼?
- OpenAI 於 2026 年 11 月 17 日發佈的 GPT-6.2 Astra 與 Sol,官方標準價格各是多少。
- 一次 API 請求的費用怎麼算:每一步乘法、換算單位和前提假設。
- 緩存讀取、超過 272K 的長上下文、輸出 token 變化,會讓實際成本偏離“降價 20%”多少。
- 開發者和預算負責人應該怎樣重新估算自己的調用成本。
索引:本文先用一張概念表和一份影響速覽交代背景;第一部分“客觀事實”整理官方發佈信息、價格表和官方評測,並給出三組基於官方單價的自算示例;第二部分“分析判斷”說明單價下降和賬單下降之間的差距,給出不同角色的應對建議,並附一段可直接運行的成本估算代碼。
GPT-6.2 Astra 降價相關概念 To Know
| 概念 | 簡要解釋 |
|---|---|
| Token | 模型計費和處理文本的基本單位,API 按“每百萬 token”定價 |
| 非緩存輸入 | 本文指既未按緩存讀取計費、也未按緩存寫入計費的普通輸入部分 |
| 緩存讀取 | 請求中命中提示詞緩存的部分,單價遠低於非緩存輸入 |
| 緩存寫入 | 寫入 token 使用獨立的總費率;同一 token 不再疊加普通輸入費 |
| 長上下文階梯 | 輸入超過 272K token 時,整次請求的輸入和緩存費率變爲 2 倍,輸出費率變爲 1.5 倍 |
| 推理檔位 | 模型在回答前投入的推理強度,檔位越高,通常消耗的 token 越多 |
| GDPval v2 / ALE / FrontierCode 2.0 | OpenAI 在發佈中引用的三項評測,評測對象和口徑各不相同,結果不能互相換算 |
GPT-6.2 Astra 降價 20% 影響速覽
| 人羣 | 主要影響 |
|---|---|
| API 開發者 | 在常規長度請求下,Astra 的輸入和輸出單價都下降 20%,同樣的調用量費用隨之下降;超長上下文請求需要單獨計算 |
| 預算負責人 | 可以按 20% 重新評估 Astra 的單價預算,但真實降幅要結合緩存命中率、上下文長度和輸出量,用賬單數據覈對 |
| 選型中的團隊 | Sol 的標準單價約爲 Astra 的 1/4,對成本敏感的任務多了一個值得評估的選項 |
| ChatGPT 普通用戶 | 本輪主要面向 ChatGPT Work、Codex 和 API 逐步開放,普通 Chat 不在本輪上線範圍內 |
一、GPT-6.2 Astra 降價 20% 的客觀事實
以下內容來自 OpenAI 官方發佈頁、模型文檔和定價頁,覈實日期爲 2026 年 11 月 18 日。所有評測數據都是官方報告,不是本團隊的實測結果。
1.1 GPT-6.2 Astra 與 Sol 發佈基本信息
OpenAI 於 2026 年 11 月 17 日發佈 GPT-6.2 Astra 與 GPT-6.2 Sol。兩款模型的輸入支持文字和圖片,輸出爲文字,不能原生生成視頻。
上線範圍方面,官方說明新模型將逐步開放給 ChatGPT Work、Codex 和 API 用戶,普通 Chat 不在本輪上線範圍內。具體開放節奏以 OpenAI 幫助文檔爲準。
1.2 GPT-6.2 Astra 官方 API 標準價格
下表爲 OpenAI 官方 Standard 檔、輸入不超過 272K token 時的價格,單位是美元/每百萬 token,不是 API易報價。輸出量按 usage 中的計費輸出總量計算,包含推理 token,不等於可見正文長度。
| 模型 | 非緩存輸入 | 緩存讀取 | 輸出 | 數據來源 |
|---|---|---|---|---|
| GPT-6 Astra(前代) | $10 | $1.00 | $50 | OpenAI 模型頁 |
| GPT-6.2 Astra | $8 | $0.4 | $40 | OpenAI 模型頁 / 定價頁 |
| GPT-6.2 Sol | $2 | $0.1 | $10 | OpenAI 模型頁 / 定價頁 |
官方還有兩條計費規則需要注意:
- 緩存寫入按獨立總費率計費:Standard 短上下文的 Astra 寫入費爲 30 分鐘 $10/百萬 token、12 小時 $20/百萬 token,不是在普通輸入 $8 上再加這筆費用。同一輸入 token 應歸入普通輸入、緩存讀取或對應壽命的緩存寫入之一,不能重複計費。
- 輸入超過 272K token 時,整次請求的輸入費率和緩存費率按 2 倍計算,輸出費率按 1.5 倍計算。
對比前代,Astra 的非緩存輸入從 $10 降到 $8,輸出從 $50 降到 $40,兩項都下降 20%。這就是“降價 20%”的準確含義:標準單價下降 20%。
1.3 GPT-6.2 Astra 官方評測數據(非本團隊實測)
OpenAI 在發佈中給出了幾項評測結果。不同評測的口徑不同,不能混在一起解讀:
- GDPval v2:GPT-6.2 Astra 比 GPT-6 Astra 高 6.2 個百分點,輸出 token 少 22%;GPT-6.2 Sol 比 GPT-6.1 Sol 高 5.3 個百分點。
- ALE:GPT-6.2 Astra 提升 5.2 分。這是另一項評測,不能和 GDPval 的百分點相加或對比。
- FrontierCode 2.0:在 max 推理檔位下,Sol 的得分比 Astra 低 0.5 分,任務成本約爲 Astra 的 1/5。這隻適用於該測試和該檔位,不能當作通用的成本結論。
1.4 GPT-6.2 Astra 單次請求費用自算示例
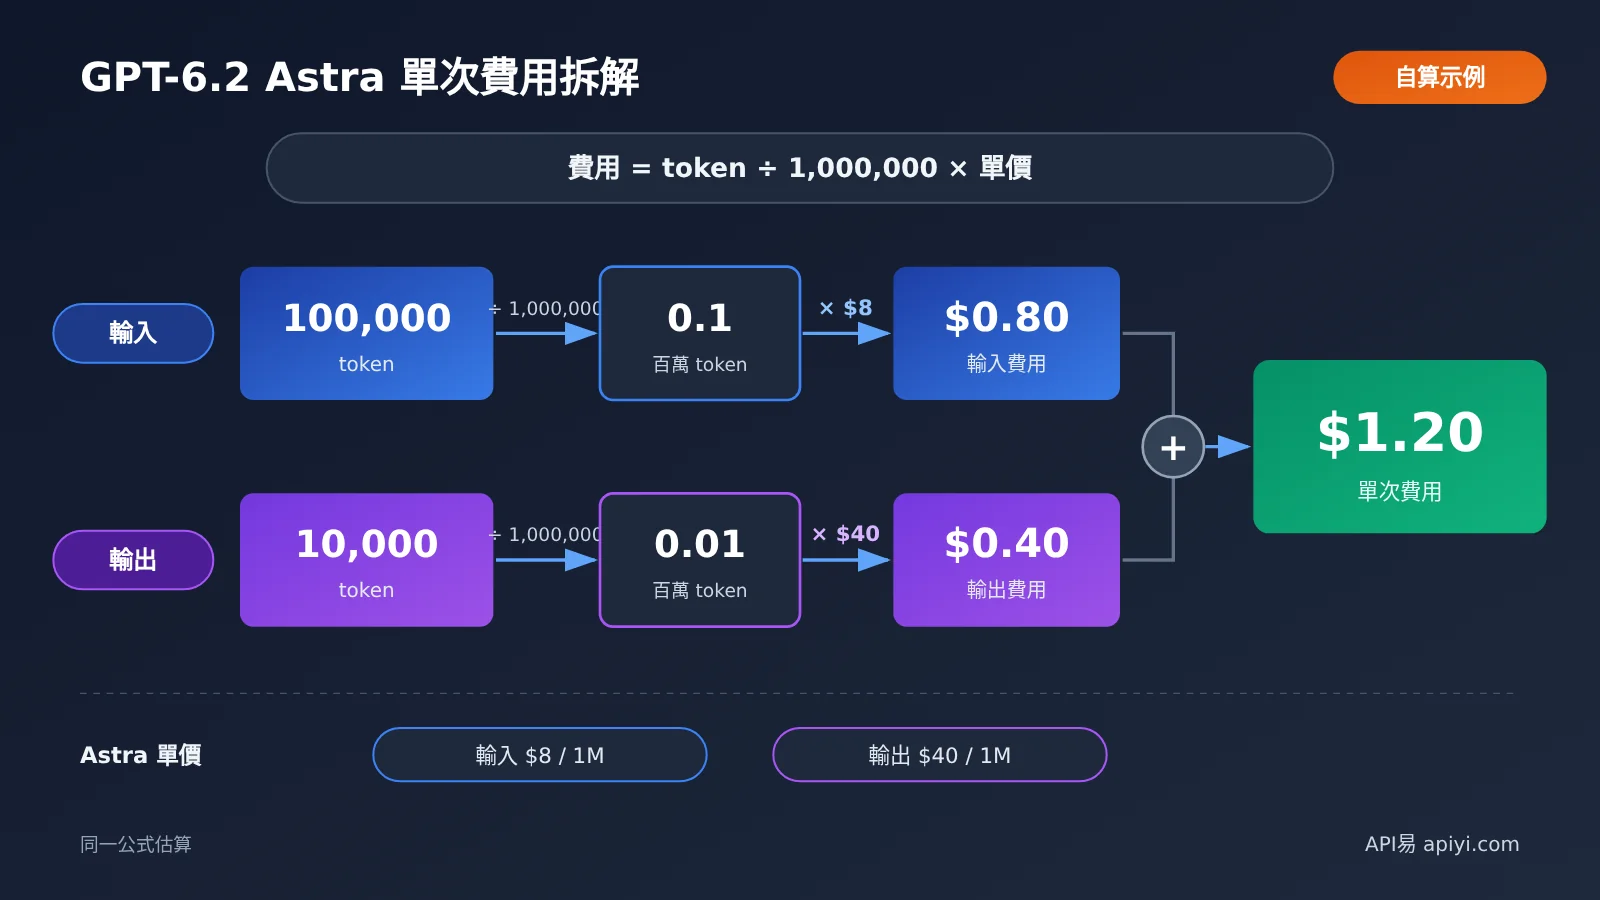
以下三組算例是我們按官網標準單價做的算術,不是 API 實測,也不代表任何賬戶的實際賬單。計算公式爲:
費用 = token 數 ÷ 1,000,000 × 每百萬 token 單價
算例一:標準請求,新舊 Astra 與 Sol 對比
前提假設:非緩存輸入 100,000 token,輸出 10,000 token,輸入不超過 272K,沒有緩存讀寫,沒有工具調用,按標準價計費。
| 項目 | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| 輸入費用 | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| 輸出費用 | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| 單次合計 | $1.50 | $1.20 | $0.30 |
| 相對 GPT-6 Astra | 基準 | 少 $0.30(-20%) | 少 $1.20(-80%) |
表中“0.1”指 100,000 ÷ 1,000,000,“0.01”指 10,000 ÷ 1,000,000。如果每月發出 10,000 次同樣的請求,按這組假設,GPT-6 Astra 約 $15,000,GPT-6.2 Astra 約 $12,000。這個結果只是線性外推,不構成任何費用承諾。
算例二:命中緩存的 GPT-6.2 Astra 請求
前提假設:總輸入 100,000 token,其中 80,000 token 命中緩存讀取,20,000 token 爲不寫入緩存的普通輸入,輸出 10,000 token;本次緩存寫入量設爲零,歷史緩存建立成本不計入本次算例。
- 非緩存輸入:0.02 × $8 = $0.16
- 緩存讀取:0.08 × $0.4 = $0.032
- 輸出:0.01 × $40 = $0.40
- 合計:約 $0.592
前代 GPT-6 Astra 的緩存讀取價爲 $1.00/百萬 token,新版爲 $0.40,降幅爲 60%。按同一組 token 數,前代費用爲 $0.20 + $0.08 + $0.50 = $0.78;新版 $0.592,少 $0.188,約下降 24.1%。兩者都未計緩存寫入、工具和其他費用,不能視爲完整賬單。
算例三:超過 272K 的 GPT-6.2 Astra 長上下文請求
前提假設:普通輸入 300,000 token(超過 272K),輸出 10,000 token,緩存讀取與寫入量均爲零。
- 輸入:0.3 × ($8 × 2) = $4.80
- 輸出:0.01 × ($40 × 1.5) = $0.60
- 合計:$5.40
請注意,階梯是按整次請求計算的。輸入一旦超過 272K,這次請求的全部輸入都按 2 倍費率計費,並不是只對超出部分加價。
緩存壽命配置使用 Responses API 的 prompt_cache_options.ttl:默認 "30m",可選擇 "12h",單個顯式斷點可用 prompt_cache_breakpoint.ttl 覆蓋。它表示最低緩存壽命,不是數據刪除時限,不應與舊模型的 prompt_cache_retention 參數混用。
輸入超過 272K 時,Standard 檔 Astra 的普通輸入、緩存讀、30 分鐘寫入、12 小時寫入、輸出分別爲 $16、$0.80、$20、$40、$60/百萬 token;倍率作用於整次請求,不只超出部分。
1.5 GPT-6.2 Astra 官方來源
-
OpenAI 發佈公告: openai.com/index/introducing-gpt-6-2-astra-sol/
- GPT-6 Astra 模型文檔:官方舊模型價格
- GPT-6.2 Astra 模型文檔:官方新模型價格與費率條件
- GPT-6.2 Sol 模型文檔: developers.openai.com/api/docs/models/gpt-6.2-sol
- OpenAI API 定價頁: developers.openai.com/api/docs/pricing
- ChatGPT Work 與 Codex 幫助文檔: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
二、GPT-6.2 Astra 降價 20% 的分析判斷
以下爲編輯基於上述事實做的解讀,屬於分析和判斷,不是官方結論。
2.1 單價降 20%,爲什麼賬單不一定降 20%
算例一之所以能得出嚴格的 20%,是因爲它只包含非緩存輸入和標準輸出兩項,而這兩項都恰好降了 20%。真實業務的賬單通常由多種費用構成,任何一項的比例變化都會讓整體降幅偏離 20%。
| 成本因素 | 對實際賬單的可能影響 | 判斷依據 |
|---|---|---|
| 緩存讀取與寫入 | 緩存讀取單價下降 60%,不同於非緩存輸入的 20%;須按各自 token 數覈算,不能預設整體降幅;緩存寫入使用獨立總費率,不疊加普通輸入費 | 官方價格表 |
| 長上下文階梯 | 超過 272K 時整次請求的費率上浮,長文檔場景的單次費用可能明顯高於算例一 | 官方計費規則 |
| 輸出 / 推理 token 數量 | 官方在 GDPval v2 中報告輸出 token 少 22%,如果你的任務也有類似變化,節省可能超過 20%;如果推理檔位更高,也可能更貴 | 官方評測(特定任務) |
| 工具調用與速度檔位 | GPT-6.2 Astra 的 Fast 爲同上下文 Standard 費率的 2 倍,Batch 爲 50%;工具費用按所用工具另覈算 | 官方模型頁與定價頁 |
| 調用渠道 | 通過 API易 apiyi.com 等第三方平臺調用時,以平臺公佈的實際計費爲準,不能直接套用官方價 | 渠道差異 |
一個容易被忽視的地方是“輸出少 22%”。這個數字來自 GDPval v2 這一項評測,如果直接把它套到所有業務上,得出“實際省 30% 以上”的結論,就把官方在特定評測中的結果當成了通用規律。更穩妥的做法是用自己的真實請求做小樣本測試,記錄 usage 字段中的 token 數,再做判斷。
2.2 GPT-6.2 Astra 與 Sol 的選型判斷
從標準單價看,Sol 的每一項價格都約爲 Astra 的 1/4。在算例一中,Sol 的單次費用只有 Astra 的四分之一。FrontierCode 2.0 的結果顯示,Sol 在 max 推理檔位下與 Astra 的分差很小,但官方並沒有說明這一結論能推廣到其他任務。
因此我們的判斷是:對成本敏感、任務難度中等的場景,Sol 值得優先評估;對質量要求高或任務複雜的場景,Astra 降價後的門檻也降低了。最終選擇哪一個,應該用自己的任務集做 A/B 對比來決定。
💡 選型建議:如果需要在同一套代碼裏對比多個模型的 token 消耗和輸出質量,可以考慮通過 API易 apiyi.com 這類 OpenAI 兼容的聚合接口切換模型。GPT-6.2 系列在平臺上是否已上線、價格多少,請以平臺模型列表和計費頁爲準。
2.3 GPT-6.2 Astra 成本估算代碼
下面的腳本只做本地算術,不調用接口。將輸入拆成互不重疊的普通輸入、緩存讀取、30 分鐘寫入與 12 小時寫入四類;總輸入量用於判斷 272K 階梯。寫入費率是總費率,不再給寫入 token 疊加普通輸入費。
# OpenAI Standard 費率,美元/百萬 token;不含工具、稅及其他檔位費用
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 數不得爲負")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# 同樣10萬輸入全部按30分鐘寫入計費:不是1.2再加1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
對 Responses 的 usage,應先識別緩存讀取量與寫入量,再用總輸入減去二者得到普通輸入。混合 30 分鐘與 12 小時壽命時,還需按實際計費明細分配寫入量;不能把所有寫入都套用一種費率。若渠道缺少寫入明細或計費口徑不同,就用該渠道賬單核對,不應默認寫入量爲零。計費輸出包含推理 token 時,不要再次疊加推理量。本文沒有實際調用 API;第三方平臺是否支持這些配置及如何收費,以其文檔爲準。
2.4 GPT-6.2 Astra 降價後的應對建議
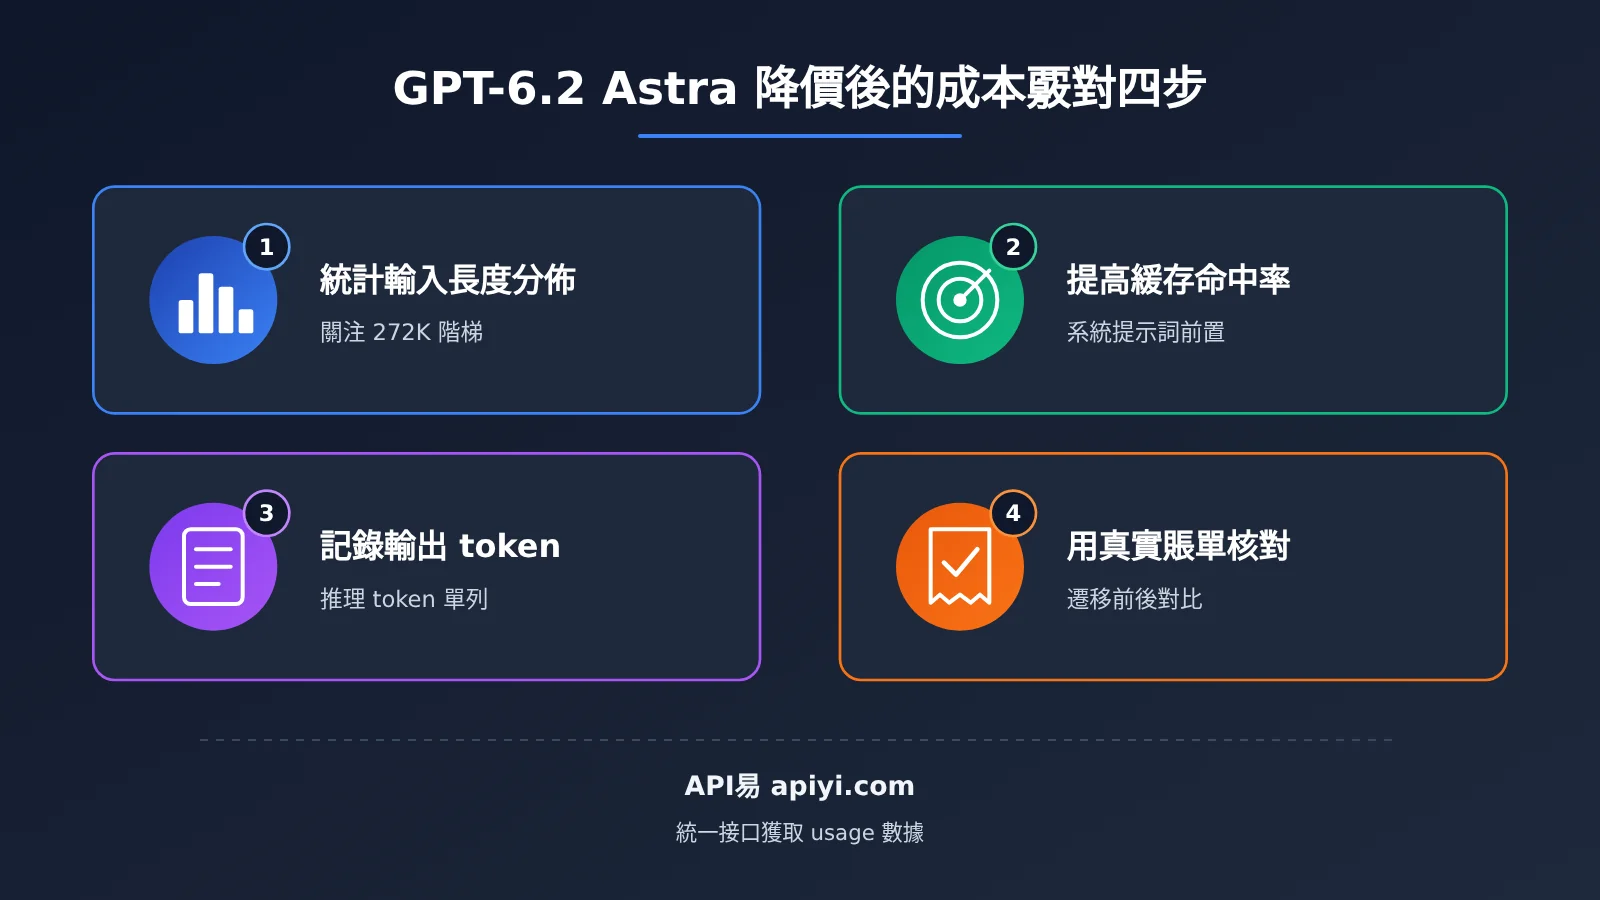
對開發者:先統計現有請求的輸入長度分佈,看有多少請求接近或超過 272K。如果長上下文請求佔比高,可以通過檢索切片、摘要壓縮等方式把輸入控制在階梯以內,這樣節省的費用可能比 20% 的降價還多。同時,把固定的系統提示詞放在請求前部,以提高緩存命中率。
對預算負責人:可以把“Astra 標準單價下降 20%”作爲同等非緩存輸入與輸出量下的預算基準參考,而不是實際降幅上限或確定的節省額。建議用遷移前後各一段時間的真實賬單做對比,並把緩存、長上下文和輸出 token 的變化分別列出來。通過 API易 apiyi.com 等平臺調用的團隊,還要以平臺賬單的計費口徑爲準。
仍需關注的後續變化:官方價格更新、渠道開放進度,以及第三方獨立評測能否復現官方數據。官方已列明緩存寫入與速度檔位費率,估算時應覈對所選檔位,不應把它們當作尚未公佈。新 Astra 在 Standard 短上下文下,30 分鐘保留期的緩存寫入爲 $10/百萬 token,12 小時爲 $20/百萬 token;本文三組主算例均假設本次緩存寫入量爲零,不代表默認 API 請求必然沒有寫入。
如果想先跑通計費覈對流程,可以在 API易 apiyi.com 用同一套代碼對比不同模型的 usage 數據。等 GPT-6.2 系列在你使用的渠道上線後,就能直接把真實 token 數代入上面的估算函數。
降價 20% 是一個清楚的信號,但賬單上的數字取決於每一次請求裏輸入多長、緩存命中多少、輸出多少。把每一筆乘法都算清楚,比記住一個百分比更有用。
“Beware of little expenses; a small leak will sink a great ship.”
——本傑明·富蘭克林《窮理查年鑑》
(留意小開銷,一個小漏洞足以讓大船沉沒。)