作者注:從 OpenAI 企業收入過半的新動態出發,結合 Harness 調查與“每個成功任務成本”指標,拆解企業 AI 採購的 5 個步驟與成本治理方法。
2026 年 11 月 4 日,OpenAI 總裁 Greg Brockman 在 WSJ 科技大會上表示,OpenAI 超過一半的收入已經來自企業業務。他同時說明,消費者業務收入仍在增長,只是企業業務增長更快。與此同時,多份行業調查顯示,企業 AI 賬單正在以超出預期的速度膨脹。
這不是又一篇 ChatGPT 套餐比價文章。Reuters、TechCrunch 已報道 Brockman 的表態,Harness 的 FinOps 調查也給出了企業 AI 賬單失控的樣本數據。對企業來說,真正難的已經不是“買哪個模型”,而是如何同時管理多家供應商、持續增長的調用費用,以及每個任務的真實成本。
核心價值:讀完本文,你將理解 ChatGPT 企業採購的幾種計費方式,並拿到一套從任務定義到效果評估的 5 步 AI 採購與成本治理框架。
ChatGPT 企業採購核心信息速覽
先把這次動態的關鍵事實放在一起。需要提醒的是,“OpenAI 企業收入過半”說的是 OpenAI 自身的收入結構,和行業報告中的企業 API 市場份額不是同一個統計口徑,不能混爲一談。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 11 月 4 日(美國當地時間),WSJ Technology Conference |
| 發佈方 | Greg Brockman,OpenAI 聯合創始人、總裁 |
| 核心內容 | 企業業務收入佔比超過一半,此前約爲企業 30%、消費者 70% |
| 增長驅動 | 第三季度企業業務規模翻倍,Codex、ChatGPT Work、GPT-5.6 Sol 被列爲關鍵因素 |
| 行業背景 | Menlo Ventures 估算企業 AI 支出平均爲上一年的 4.7 倍,而企業原先預計約 1.9 倍 |
| 影響範圍 | 企業採購、預算管理、多模型接入與 API 成本治理 |
ChatGPT 企業採購的三種主流形態
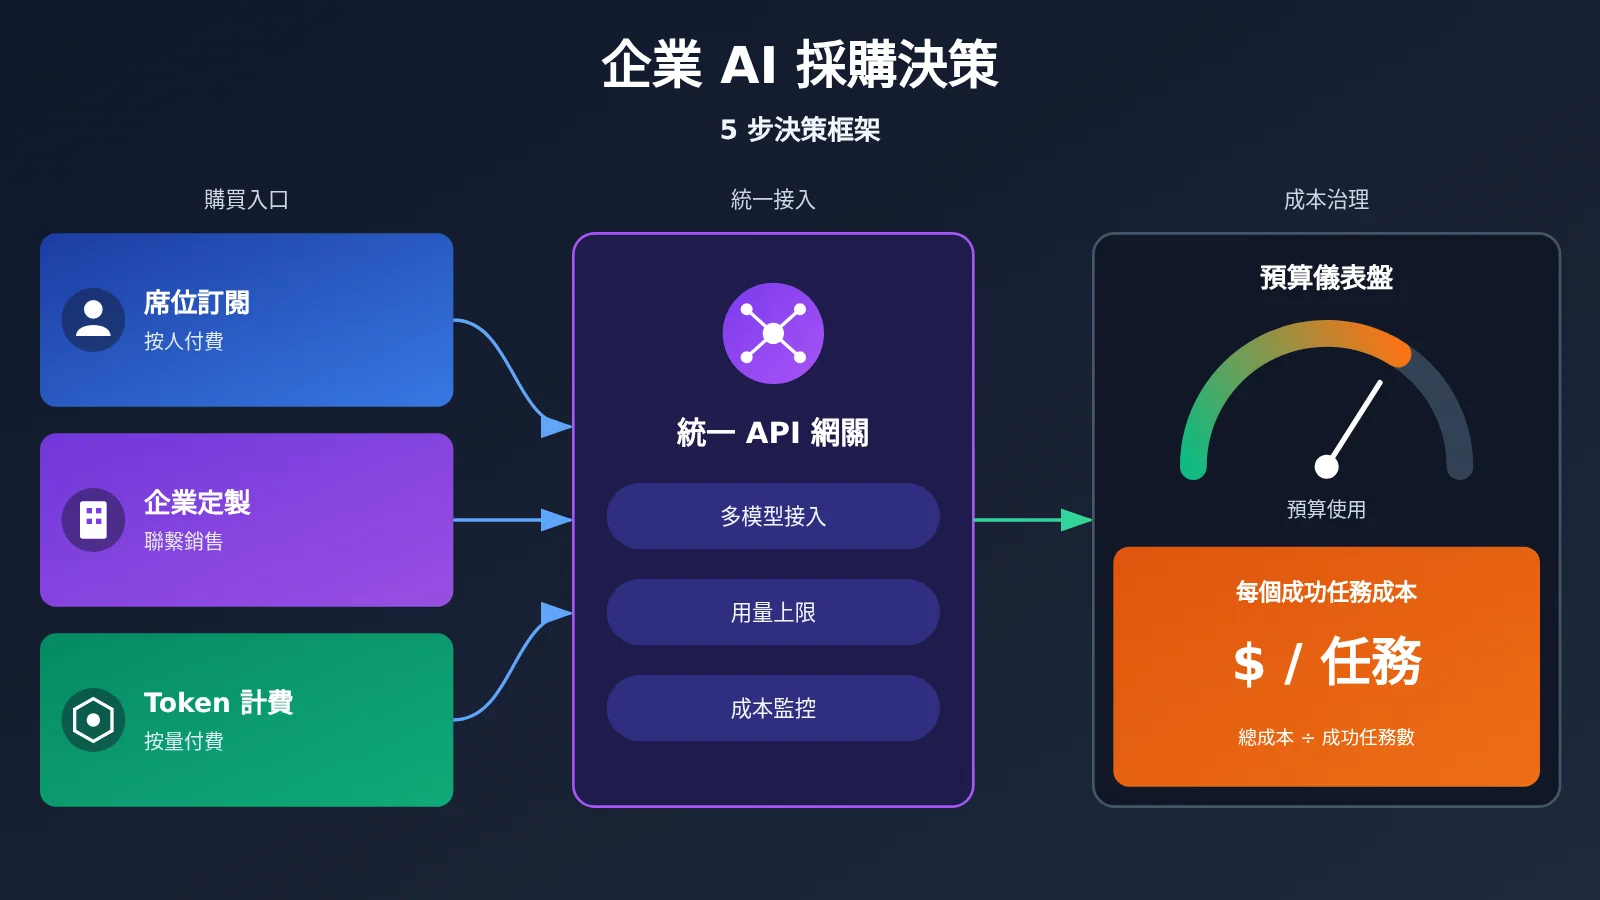
從公開價格看,ChatGPT 企業採購大致有三條路徑。ChatGPT Business 面向 2—200 人團隊,Standard 席位年付折算約每人每月 20 美元、月付 25 美元,Premium 席位提供約 5 倍於 Standard 的使用額度。ChatGPT Enterprise 則需要聯繫銷售定製報價,包含 SCIM、EKM、RBAC、數據駐留、SLA 和定製法律條款,並可採用 Credit-based 或 Token-based 計費。
第三條路徑是直接按 Token 採購 API。API 與 ChatGPT 訂閱是兩套獨立的計費體系,按實際輸入、輸出和緩存 Token 計費,不同模式和上下文長度還會影響最終成本。值得注意的是,2026 年 10 月 OpenAI 爲符合條件的 Business 工作區提供了促銷 API credits,但這些額度與 ChatGPT 使用額度分開計算,這也說明席位和 API 在財務上要分別管理。
企業 AI 採購爲什麼總是超預算
如果只看單價,AI 似乎並不貴;但企業真正收到的賬單往往和預期相差很遠。Harness 在《State of AI in FinOps 2026》中調查了 700 名工程負責人和從業者,調查時間爲 2026 年 5—6 月,覆蓋美國、英國、法國、德國和印度,受訪企業均在 1000 人以上。
調查顯示,67% 的受訪組織每月 AI 支出超過 25 萬美元,20% 已經超過 100 萬美元。80% 表示過去六個月 AI 總支出增加,78% 預計還會繼續增長。更值得關注的是賬單管理層面暴露的問題:
| Harness 調查結果 | 比例 | 反映的採購問題 |
|---|---|---|
| 遭遇過意外 AI 賬單 | 72% | 預算與實際調用脫節 |
| 沒有明確 AI 成本負責人 | 52% | 成本歸屬不清 |
| 認爲 AI 預算制定主要靠猜測 | 56% | 缺少歷史用量數據 |
| 經常擔心下一筆 Token 賬單 | 47% | 用量缺乏上限控制 |
| 至少需要一天定位成本異常 | 79% | 監控與告警滯後 |
| 需要一週才能定位成本異常 | 32% | 多平臺賬單難以合併 |
另一組對比更能說明問題:73% 的企業已經制定 AI 成本政策,但只有 13% 具備基本的成本可見性。換句話說,制度寫在紙上,執行和監控能力卻沒有跟上。需要說明的是,Harness 本身是 FinOps 工具廠商,樣本限定在千人以上企業和五個國家,結論更適合作爲大中型企業的參考,而不是全行業的統計結論。
Agent 讓 Token 消耗與人數脫鉤
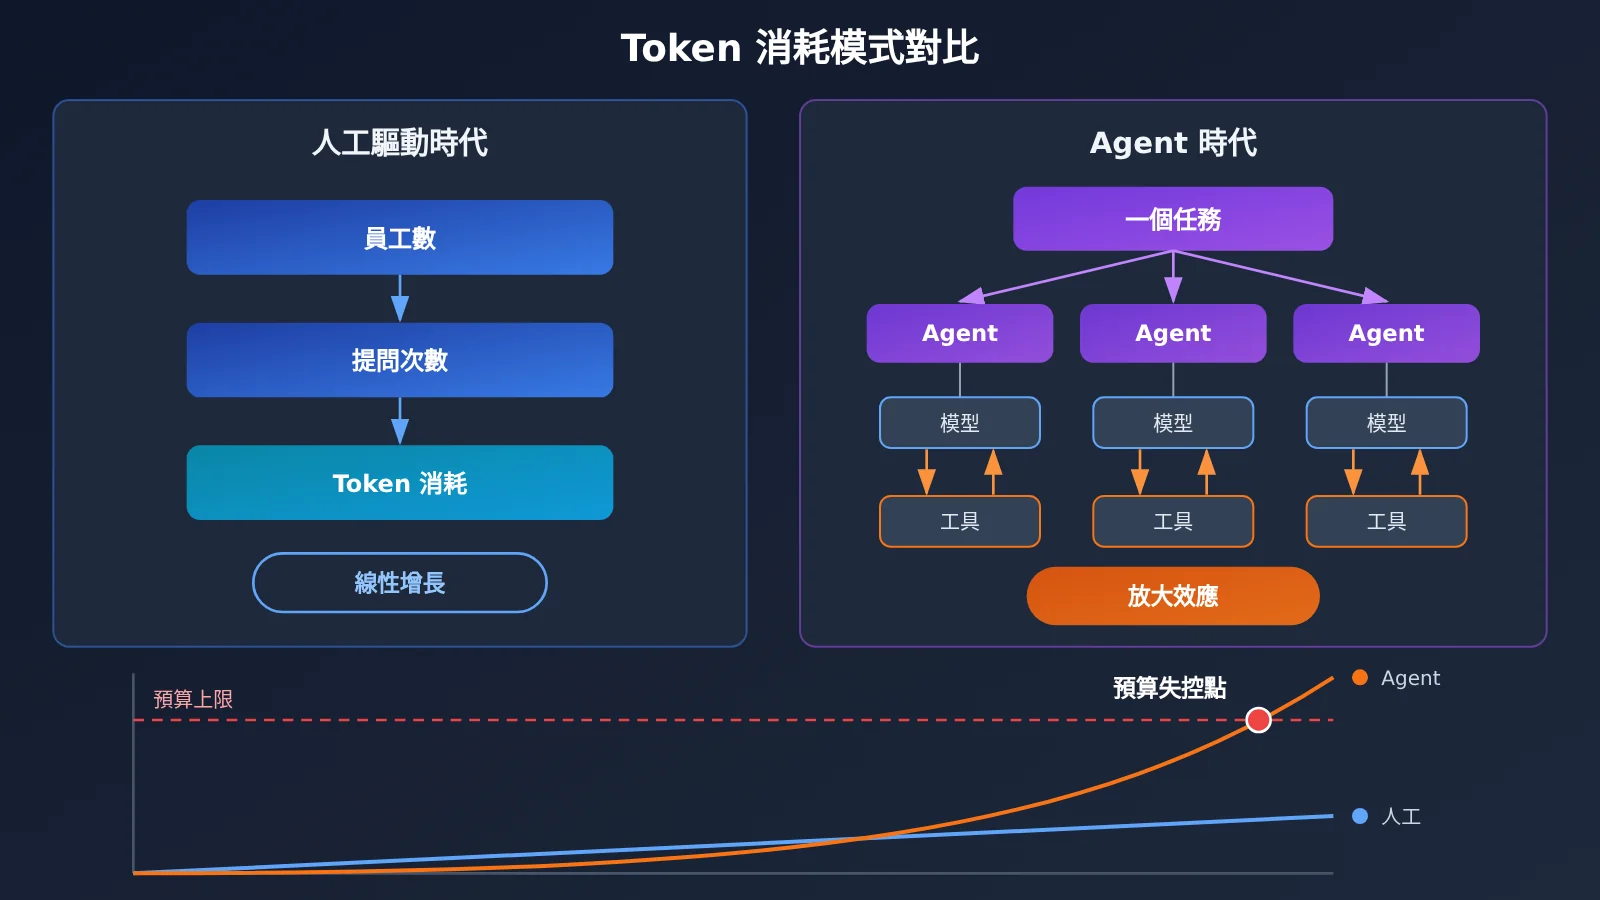
傳統 SaaS 採購按人頭計算,預算相對可控。但 Agent 改變了這一邏輯:Menlo Ventures 基於 OpenRouter 數據的分析顯示,Agent 已佔該平臺 Token 消耗量約 80%,自 2026 年 2 月超過人工驅動流量後增長約 37 倍。Menlo 也指出,Agent 的並行運行和後臺持續執行,是企業支出超過預算的重要原因之一。
這組數據同樣有侷限:OpenRouter 用戶結構偏向開發者和創業公司,不能代表整個行業。但趨勢本身很清晰,Token 消耗越來越取決於任務數量、並行度和執行時長,而不只是員工人數。Axios 報道中,超過 60% 的 Codex 用戶在一天中的某個時段會同時運行多個任務,這正是賬單難以預測的根源。
ChatGPT 企業採購爲何走向多模型
很多企業最初只採購一家供應商,但很快就會發現單一模型難以覆蓋所有任務。Harness 調查中,企業生產環境使用 OpenAI 的比例爲 69%,Azure OpenAI 爲 58%,Google Vertex AI 爲 53%,AWS Bedrock 爲 41%,Anthropic 爲 37%。這些比例可以重疊,說明的是“多數企業同時使用多個平臺”,而不是市場份額,更不能相加計算。
2026 年 7 月發佈在 arXiv 的預印本《The Multi-Lab Enterprise》給出了類似線索:全球 2000 強企業中,81% 使用三個或更多模型系列,79% 曾經超過 AI 預算,即便 FinOps 成熟的企業平均超支也達到 30.9%。不過這是一篇尚未經過同行評審的預印本,只能作爲研究線索參考,不宜單獨作爲決策依據。
多模型採購帶來的麻煩很具體。各平臺的計費單位、賬單格式、用量統計口徑都不一致,財務部門很難按部門或項目歸集成本,技術團隊也難以在同一套指標下比較模型效果。這正是統一 API 接入層存在的價值:把多家模型收斂到同一個接口和同一份用量報表中。
ChatGPT 企業採購方式對比
| 採購方式 | 計費邏輯 | 適合場景 | 治理重點 |
|---|---|---|---|
| ChatGPT Business 席位 | 按人每月計費,Standard/Premium 可混配 | 2—200 人團隊的日常辦公與知識工作 | 席位利用率、閒置席位回收 |
| ChatGPT Enterprise 合同 | 定製報價,可選 Credit 或 Token 計費 | 對合規、數據駐留、SLA 有要求的大型組織 | 合同條款、額度消耗節奏 |
| 模型 API 按 Token | 按輸入/輸出/緩存 Token 計費 | 自研應用、Agent 工作流、批量任務 | 單任務成本、異常調用、重試率 |
| 雲平臺模型服務 | 併入雲賬單 | 已深度使用某雲廠商的企業 | 跨雲成本歸屬 |
| 合作伙伴集成 | 項目制或服務費 | 需要流程改造與系統整合 | 交付成果與業務指標掛鉤 |
Cost per Successful Task:Token 單價不等於真實成本
企業比價時最常見的誤區,是隻看每百萬 Token 的價格。設想兩個模型:模型 A 單次調用便宜,但完成任務需要多次重試,輸出質量不穩定,需要大量人工檢查;模型 B 單價更高,但一次成功率更高,人工複覈時間更短。最終攤到每個交付成果上,模型 A 反而可能更貴。
因此更有意義的採購指標是 Cost per Successful Task(每個成功任務的實際成本)。它把模型費用、工具費用、失敗重試和人力複覈都算進來,再除以真正成功交付的任務數量。最便宜的模型並不天然是最優選擇,關鍵是在你的任務上誰的綜合成本更低。
| 成本構成 | 含義 | 常被忽略的原因 |
|---|---|---|
| 模型調用成本 | 輸入、輸出、緩存 Token 費用 | 只看單價不看用量 |
| 工具調用成本 | 檢索、代碼執行、外部 API 等費用 | 分散在其他賬單中 |
| 失敗重試成本 | 超時、格式錯誤、質量不合格後的重跑 | 日誌未區分首次與重試 |
| 人工複覈成本 | 員工檢查、修改、返工的時間 | 不計入 IT 預算 |
| 任務耗時 | 從發起到交付的總時長 | 只統計模型延遲 |
| 任務成功率 | 一次即可交付的任務比例 | 缺少業務側驗收標準 |
這一點在 Agent 場景中尤其明顯。Axios 報道過斯坦福商學院教授 Andrew Hall 用 Claude Code 更新舊論文的案例,Agent 能完成數據蒐集、分析和畫圖,但後續人工審查發現了數據和代碼錯誤。人工監督成本是真實存在的,忽略它就會嚴重低估 AI 的總成本。
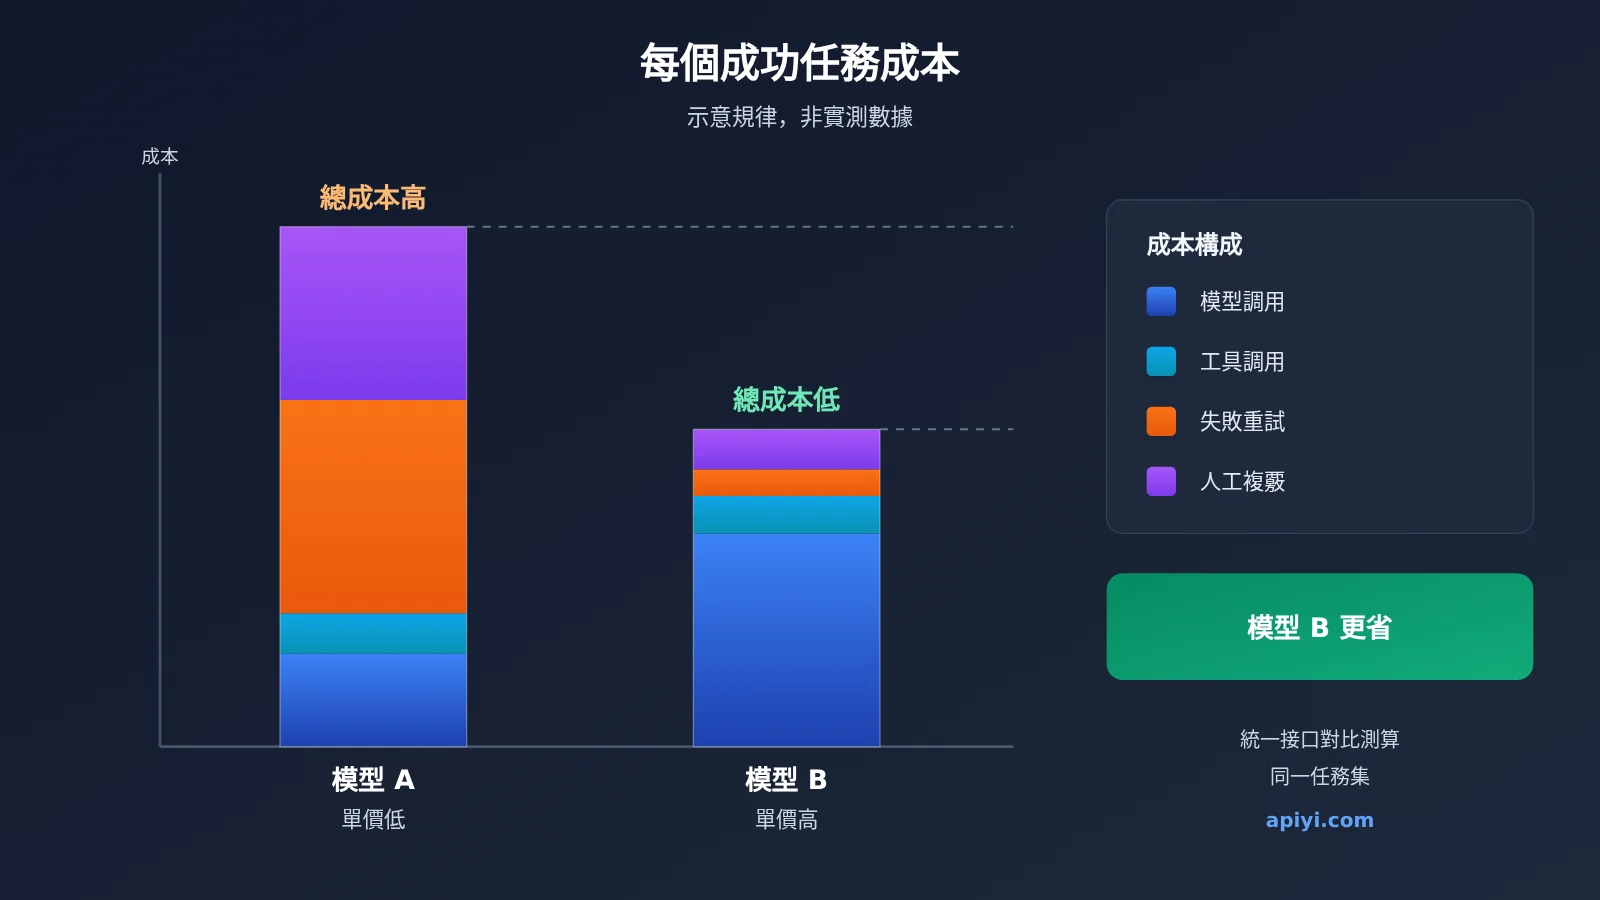
上圖展示的是一種常見規律,而不是某兩個具體模型的實測結論。實際評估時,建議用同一批真實業務樣本分別跑不同模型,再按上表口徑計算。通過 API易 apiyi.com 這類統一接口平臺,可以用同一套代碼切換模型,減少對比測試的工程量。
如何測算 ChatGPT 企業採購的單任務成本
下面的示例展示如何記錄每次調用的 Token 用量,這是計算 Cost per Successful Task 的數據基礎:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="your-model-id",  # 模型 ID 以平臺模型列表爲準
    messages=[{"role": "user", "content": "總結這份合同的關鍵風險條款"}]
)
print(resp.choices[0].message.content)
print("輸入 Token:", resp.usage.prompt_tokens, "輸出 Token:", resp.usage.completion_tokens)
查看完整實現:按部門歸集成本並計算單任務成本
import openai
from collections import defaultdict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 統一接口,切換模型只改 model 參數
)

# 單價按你實際採購的模型填寫,單位:美元 / 百萬 Token
PRICE = {
    "model-a-id": {"input": 0.0, "output": 0.0},
    "model-b-id": {"input": 0.0, "output": 0.0},
}
REVIEW_COST_PER_MIN = 0.0  # 人工複覈每分鐘成本,按企業人力成本測算

ledger = defaultdict(lambda: {"cost": 0.0, "tasks": 0, "success": 0})

def run_task(dept: str, model: str, prompt: str, validator, max_retry: int = 2):
    """執行一個任務,記錄模型費用與重試,返回是否成功"""
    key = (dept, model)
    ledger[key]["tasks"] += 1
    for _ in range(max_retry + 1):
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        u = resp.usage
        p = PRICE[model]
        ledger[key]["cost"] += (u.prompt_tokens * p["input"]
                                + u.completion_tokens * p["output"]) / 1_000_000
        if validator(resp.choices[0].message.content):
            ledger[key]["success"] += 1
            return True
    return False

def add_review(dept: str, model: str, minutes: float):
    """把人工複覈時間折算進成本"""
    ledger[(dept, model)]["cost"] += minutes * REVIEW_COST_PER_MIN

def report():
    for (dept, model), d in ledger.items():
        cpst = d["cost"] / d["success"] if d["success"] else float("inf")
        rate = d["success"] / d["tasks"] if d["tasks"] else 0
        print(f"{dept} | {model} | 成功率 {rate:.0%} | 每個成功任務成本 ${cpst:.4f}")
🚀 快速上手建議:在正式簽訂年度合同前,建議先用真實業務樣本做兩到四周的小規模測算。通過 API易 apiyi.com 註冊即可獲得免費測試額度,一個 API Key 調用 OpenAI、Claude、Gemini 等主流模型,便於在同一份用量報表裏比較不同模型的單任務成本。
ChatGPT 企業採購的 5 步決策框架
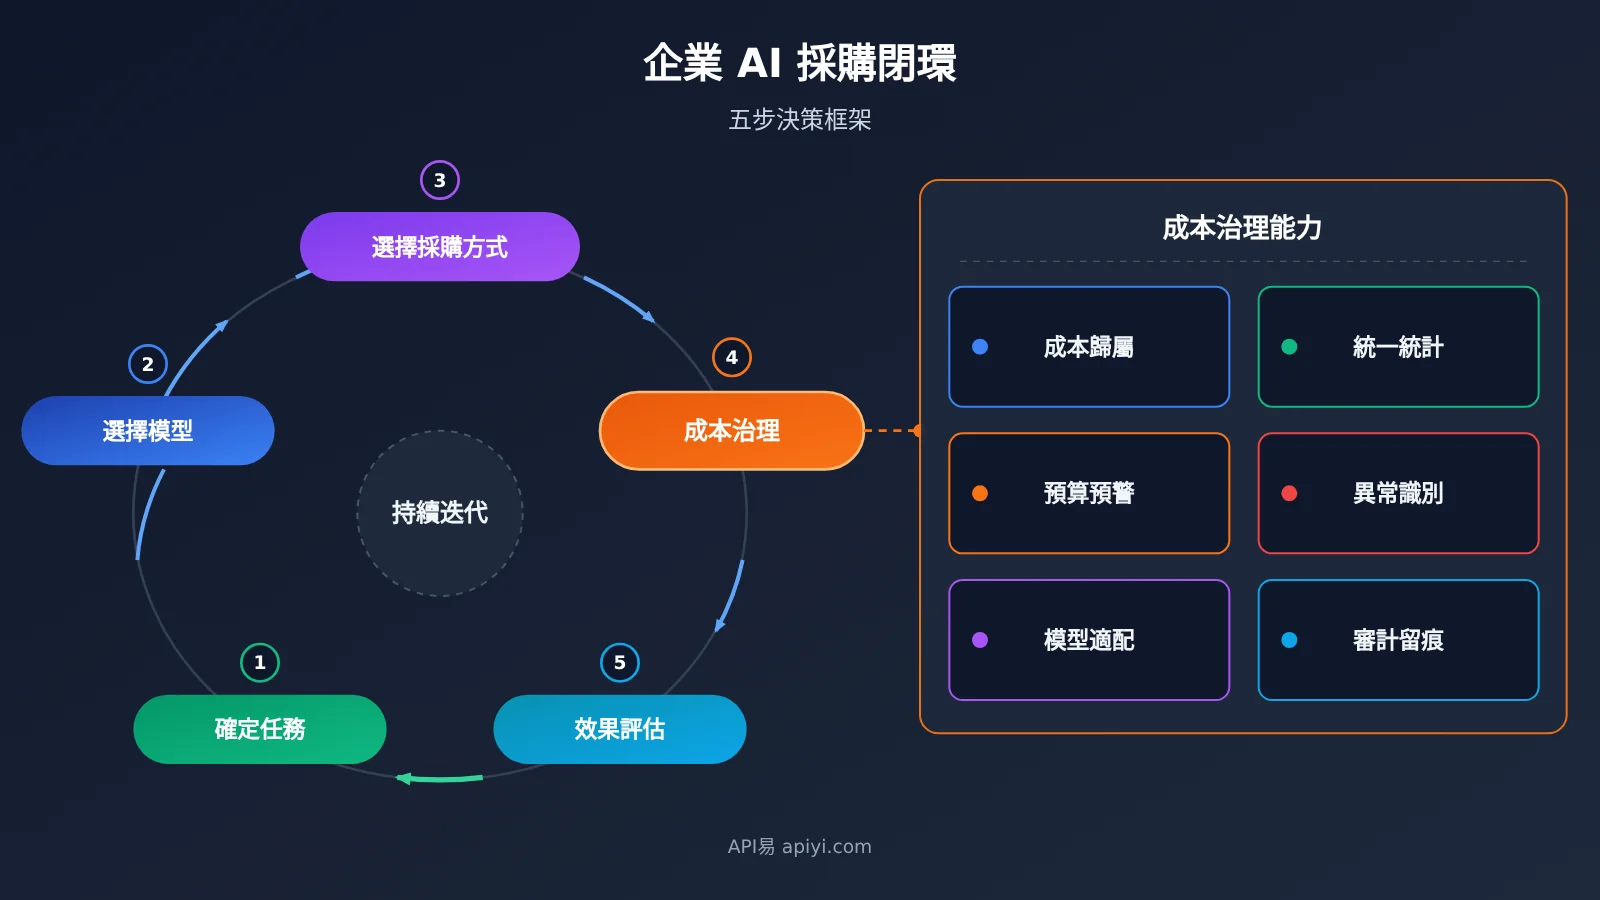
把前面的討論落地,企業 AI 採購可以按五個步驟推進。每一步都對應一個明確的產出物,避免“先買了再說”導致的預算失控。
| 步驟 | 關鍵問題 | 產出物 | 可藉助的工具 |
|---|---|---|---|
| 1. 確定任務 | 哪些工作交給 AI,哪些必須由人處理 | 任務清單與驗收標準 | 業務訪談、流程梳理 |
| 2. 選擇模型 | 準確性、推理能力、延遲、安全要求 | 每類任務的候選模型 | 統一接口平臺如 API易 apiyi.com 做橫向測試 |
| 3. 選擇採購方式 | 按席位、按 API 用量還是企業定製合同 | 採購組合方案 | 供應商報價、合同條款 |
| 4. 成本治理 | 實際調用、預算、異常、成功率 | 預算預警與異常告警規則 | 用量統計、調用日誌 |
| 5. 效果評估 | 是否真正改善業務結果 | 業務指標覆盤報告 | 試點數據、財務覈算 |
步驟詳解:從任務到效果評估
第一步和第五步最容易被跳過,卻決定了整個採購是否有意義。Credit Saison 的案例可以參考其節奏:先用 315 人做一個多月的 ChatGPT Enterprise 試點,再根據結果決定全員推廣。該公司報告的試點 ROI 爲 954%,每位參與者每月節省約 14 小時,但這是 OpenAI 發佈的客戶案例和企業自報數據,並非獨立審計結論,更不是行業平均水平。
第三步通常不是單選題。比較常見的組合是:知識工作者使用 Business 或 Enterprise 席位,研發團隊和自動化流程走 API 按量計費。第四步則需要覆蓋 Harness 調查中歸納出的幾項能力:
- 成本歸屬:按部門、團隊、項目拆分 AI 支出,解決“沒有成本負責人”的問題
- 統一統計:把不同供應商的賬單合併到同一口徑
- 預算預警:設置用量閾值,在超支前而不是月底發現問題
- 異常識別:及時發現異常 Token 消耗和 Agent 無限循環
- 模型適配:簡單任務用輕量模型,複雜任務再調用高階模型
- 審計留痕:保留調用日誌、任務結果和審計記錄
ChatGPT 企業採購對企業與行業的影響分析
對企業技術負責人的影響
- 預算模型需要重建:Agent 讓 Token 消耗與人數脫鉤,按人頭編預算會系統性低估支出
- 評估指標需要升級:從比較 Token 單價,轉向比較每個成功任務的成本
- 架構需要預留切換能力:多模型已是常態,業務代碼不應深度綁定單一供應商 SDK
對 AI 採購與財務團隊的影響
- 採購形式更復雜:席位、Credits、Token、雲平臺、合作伙伴服務可能同時存在
- 需要指定成本負責人:Harness 調查中超過一半組織缺少明確負責人
- 合同談判有了新籌碼:清晰的用量數據是談批量折扣和 Token 計費方案的基礎
對行業的影響
OpenAI 企業收入過半,說明大模型廠商的主戰場正在向企業側傾斜,企業級的安全、數據駐留和 SLA 會成爲競爭重點。與此同時,Menlo 估算的企業 API 支出份額顯示多家供應商並存,這意味着模型接入、路由、用量統計和預算控制等“中間層”能力會越來越重要。不過這屬於趨勢判斷,並不代表任何單一服務商已經因此獲得增長。
常見問題 FAQ
Q1: ChatGPT 企業採購和個人買 Plus 有什麼區別?
企業採購不是批量購買個人賬號。ChatGPT Business 和 Enterprise 提供集中賬單、SSO、權限管理、使用分析、默認不使用企業數據訓練等能力,Enterprise 還包括數據駐留、SLA 和定製法律條款,本質是帶組織治理能力的企業產品。
Q2: 買了 ChatGPT Enterprise 還需要單獨採購 API 嗎?
通常需要分別考慮。ChatGPT 席位面向員工交互使用,API 面向自研應用和自動化流程,兩者計費體系獨立。如果研發團隊要做 Agent 或批量任務,建議先通過 API易 apiyi.com 用免費額度測算真實 Token 消耗,再決定 API 預算規模。
Q3: OpenAI 企業收入過半是否意味着它佔據了企業 API 市場一半份額?
不是。Brockman 說的是 OpenAI 自身收入結構,Menlo Ventures 估算的則是整個企業 API 市場的供應商支出份額,二者統計口徑不同。此外,Brockman 並未披露精確百分比,企業收入也不能直接等同於 API 收入。
Q4: 企業如何快速搭建多模型的成本對比測試?
建議準備一批真實業務樣本,用同一套代碼在不同模型上運行,記錄 Token、重試次數、人工複覈時間和成功率。使用 API易 apiyi.com 的 OpenAI 兼容接口,只需替換 base_url 和 model 參數即可切換模型,用量也能在同一處統計。
Q5: 最便宜的模型是不是最划算?
不一定。低單價模型如果成功率低、需要多次重試或大量人工返工,每個成功任務的綜合成本可能更高。應以 Cost per Successful Task 爲準,並針對不同任務分別選型。
Q6: 本文引用的調查數據有哪些侷限?
Harness 調查樣本爲五國、千人以上企業的 700 名受訪者,且發佈方爲 FinOps 廠商;《The Multi-Lab Enterprise》是未經同行評審的預印本;Menlo 的支出與份額數據是市場估算;Credit Saison 的 ROI 是企業自報案例數據。這些數據適合用於識別趨勢,不宜直接當作行業基準。
ChatGPT 企業採購核心要點 Key Takeaways
- 收入結構轉向:OpenAI 企業收入已超過一半,消費者業務仍在增長
- 賬單失控普遍:Harness 調查中 72% 企業遭遇過意外 AI 賬單
- 多模型是常態:多數企業同時使用多個平臺,使用比例不能相加爲份額
- 單價不等於成本:用每個成功任務成本替代每百萬 Token 價格做決策
- Agent 放大消耗:並行與後臺執行讓 Token 用量與員工人數脫鉤
- 五步閉環採購:任務、模型、採購方式、成本治理、效果評估缺一不可
- 先測後籤:可藉助 API易 apiyi.com 統一接口用真實樣本測算成本
總結
ChatGPT 企業採購的核心要點:
- 採購方式是組合題:Business 席位、Enterprise 定製合同和 API 按 Token 計費各有適用場景,多數企業需要混合使用
- 成本治理比選型更難:成本歸屬、統一統計、預算預警和異常識別,決定了 AI 支出是否可控
- 以任務成本爲核心指標:把重試、工具調用和人工複覈計入成本,才能做出真正划算的採購決策
對於正在制定 AI 預算的技術負責人和採購人員,比較穩妥的做法是先小規模試點、拿到真實用量數據,再簽訂長期合同。推薦通過 API易 apiyi.com 快速驗證不同模型在你業務上的單任務成本,平臺提供免費測試額度和多模型統一接口。
📚 參考資料
- Reuters:OpenAI 企業收入過半報道:Brockman 在 WSJ 科技大會的表態
- 鏈接:
reuters.com/legal/transactional/openai-ready-ipo-2027-now-counts-majority-sales-enterprises-brockman-says-2026-11-05 -
說明: 企業收入佔比、第三季度增長與 IPO 相關表態
-
Harness:State of AI in FinOps 2026:企業 AI 成本管理調查
- 鏈接:
harness.io/state-of-ai-in-finops-2026 -
說明: 意外賬單、成本可見性與多平臺使用數據
-
OpenAI Business Pricing:ChatGPT Business 與 Enterprise 官方價格頁
- 鏈接:
openai.com/business/pricing -
說明: 席位類型、企業功能與計費方式
-
Menlo Ventures:2026 The State of Enterprise AI:企業 AI 市場研究報告
- 鏈接:
menlovc.com/perspective/2026-the-state-of-enterprise-ai -
說明: 企業 AI 支出估算、API 份額與 Agent 消耗趨勢
-
The Multi-Lab Enterprise:多模型企業治理研究預印本
- 鏈接:
arxiv.org/abs/2609.31622 - 說明: 多模型使用與預算超支的研究線索,尚未經過同行評審
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心