2026 年 10 月 27 日,Google DeepMind 發佈了新一代世界模型 Genie 4。這次變化最大的地方,是生成出來的世界會自己發出聲音,裏面的人會開口說話,你還能一邊看一邊打字改場景。官方 X 首發帖到 10 月 28 日上午約有 170 萬瀏覽、1.53 萬贊。不過它現在還進不去,官方只開放給了一小批受信任測試者。
核心價值:用 3 分鐘弄清 Genie 4 新在哪、現在能不能用,以及你下一步可以做什麼。
Genie 4 一變:世界自己會說話了
一句話結論:Genie 4 生成的不再是一個只能看的啞場景,而是一個會出聲、會回應、能隨手改的現場。
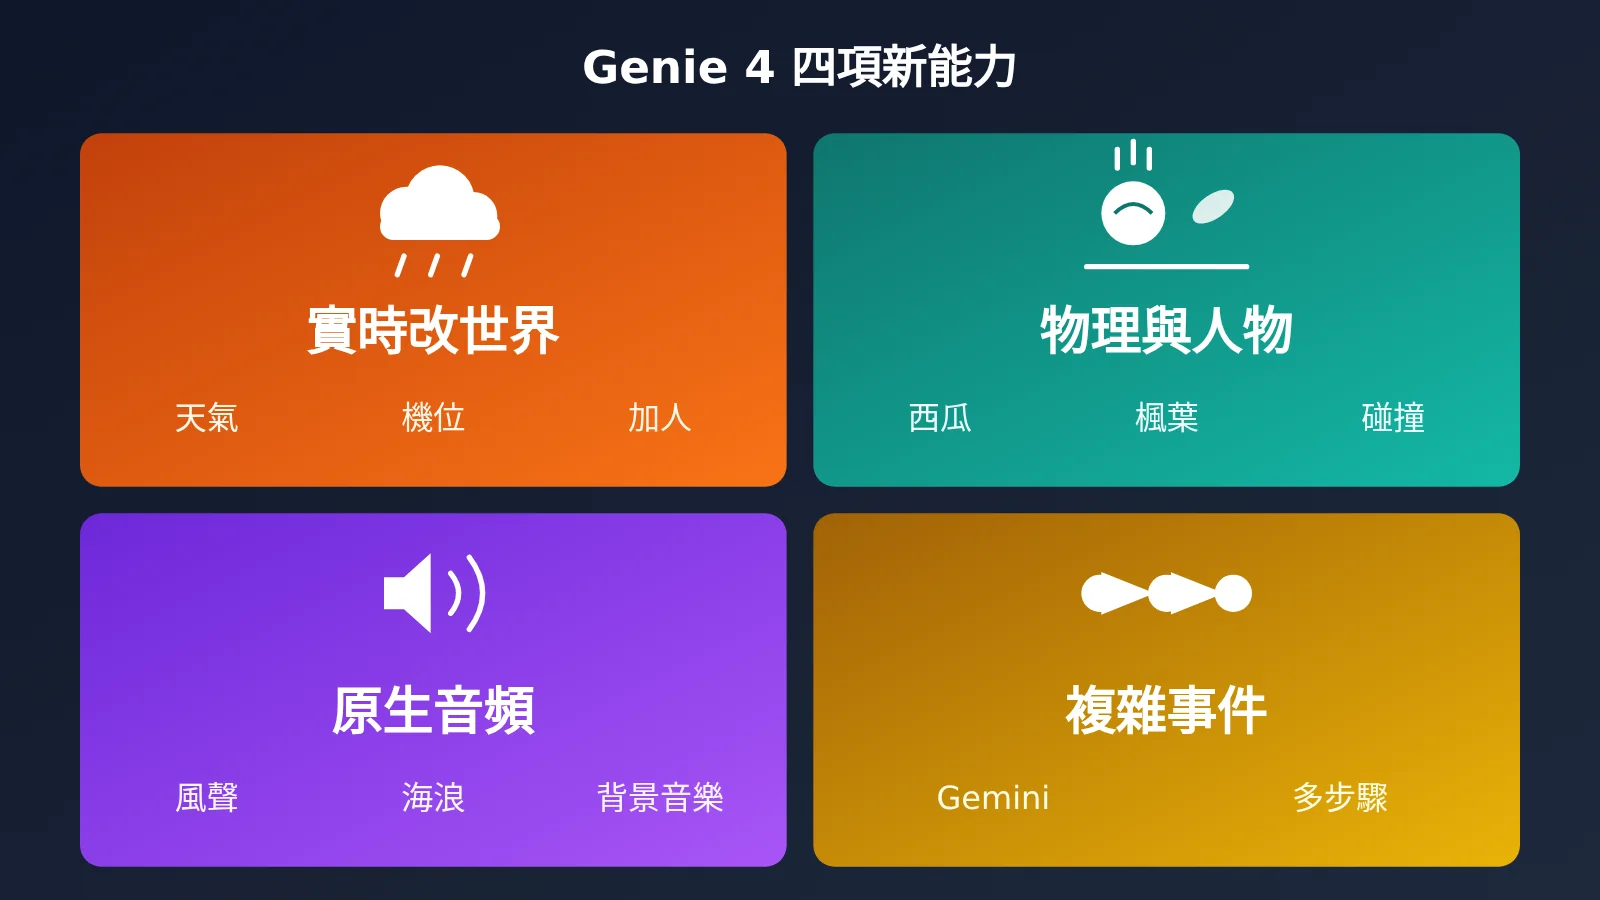
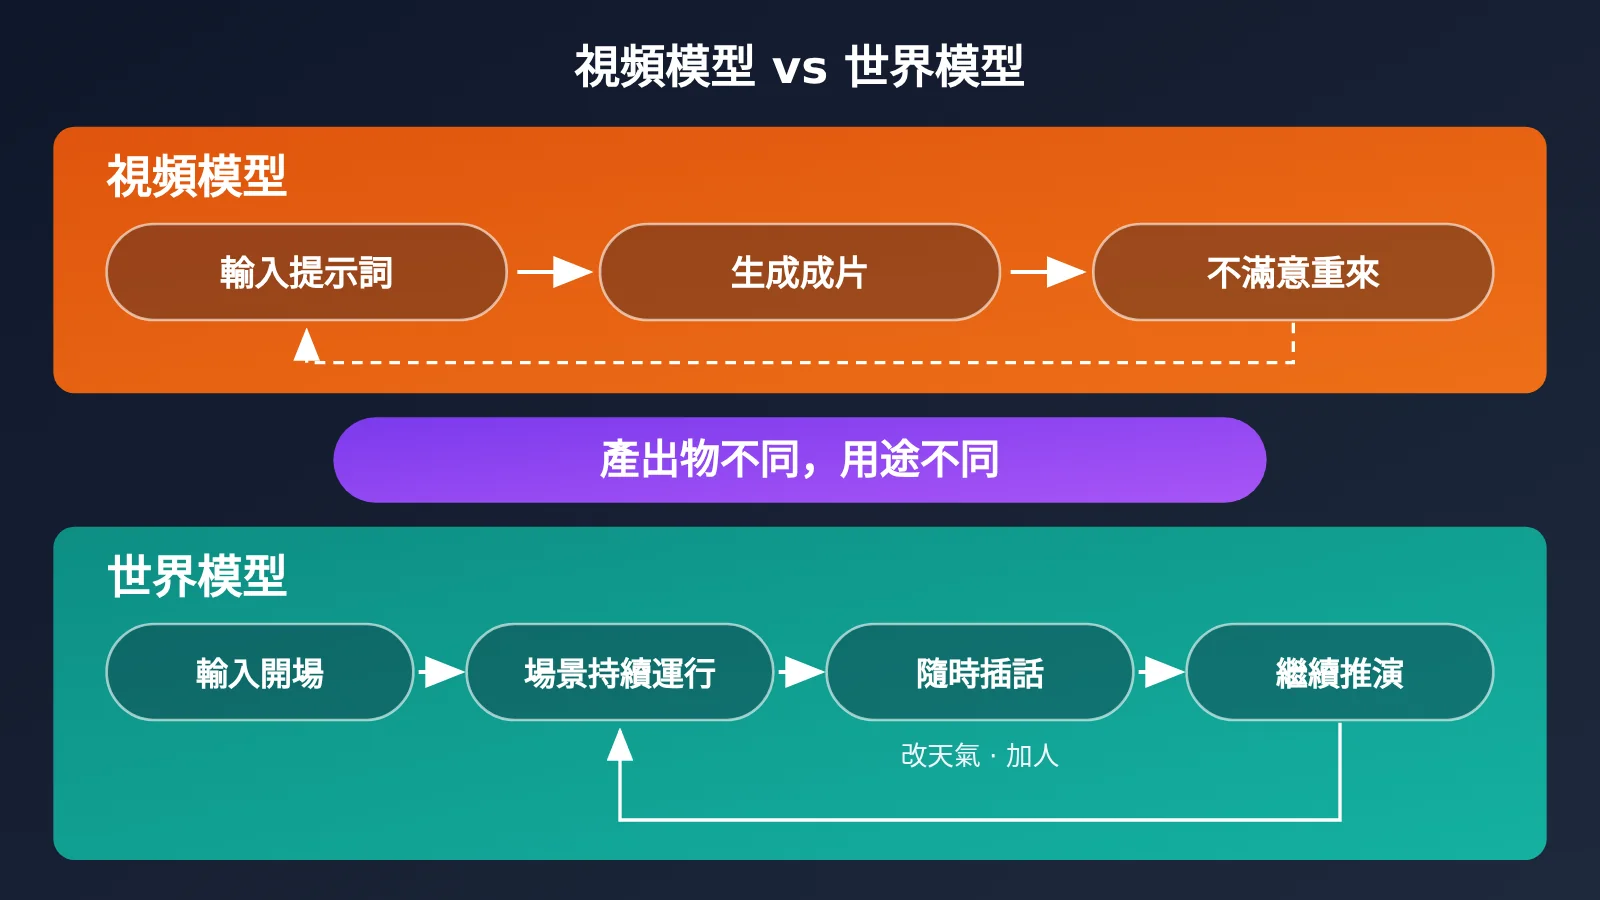
先解釋一下“世界模型”。視頻模型像給你一個門牌號,你拿到的是一段拍好的成片。世界模型更像一場現場演出,演員一直在臺上,你喊一句“下雨”,臺上就開始下雨,接下來的劇情也跟着變。官方博客把 Genie 4 的進步歸成四項能力,下面逐條說明。
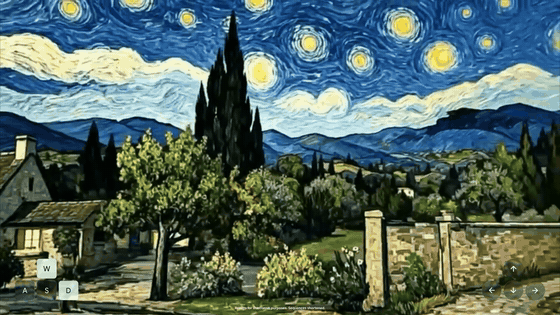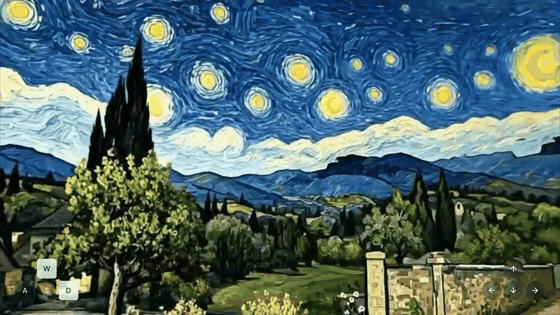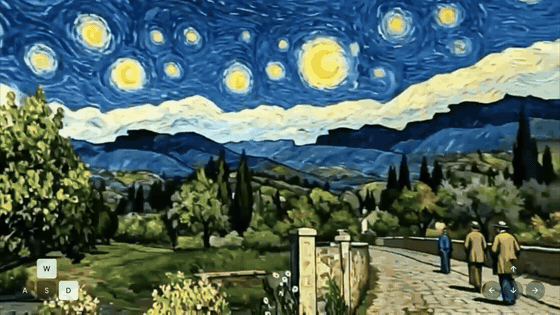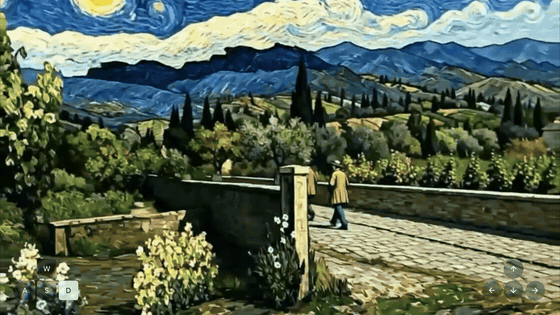
圖注:官方發佈片裏,人物走進梵高《星夜》畫出來的世界。來源:Google DeepMind 官方發佈帖(2026-10-27),官方演示片段。
Genie 4 能力一:實時改變世界
官方博客說,你可以用自然語言實時修改正在運行的模擬,比如改天氣、移動機位、加入新的人或物體。官方演示裏,畫面正在播放時輸入一句指令,天氣就會變化,鏡頭就會挪動,場景裏也會多出一個人。
比較關鍵的細節是,官方稱 Gemini 會結合周圍場景,把你的提示詞改寫成更貼合當前畫面的指令。在你兩次輸入之間,Gemini 也會持續觀察並引導場景,讓世界不會因爲停止輸入就“卡住”。
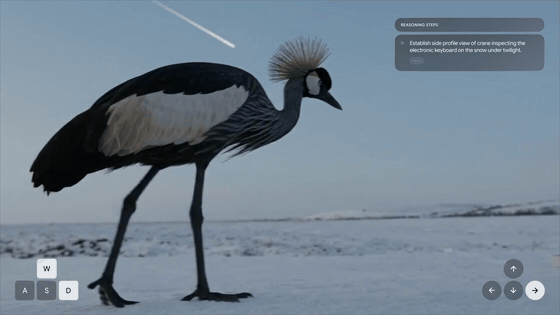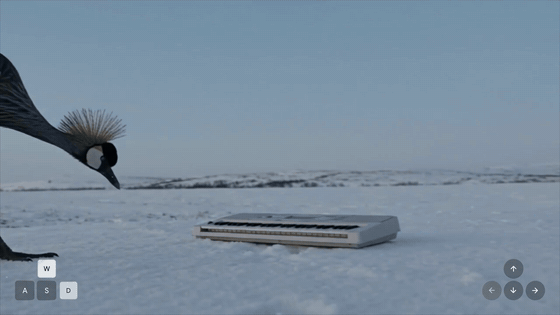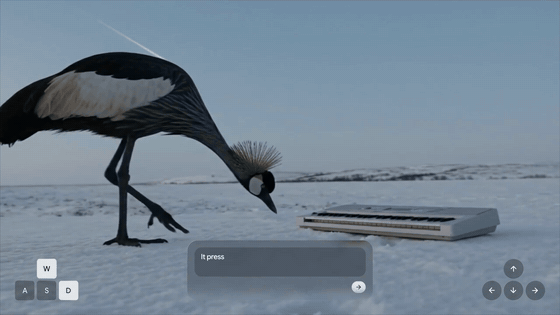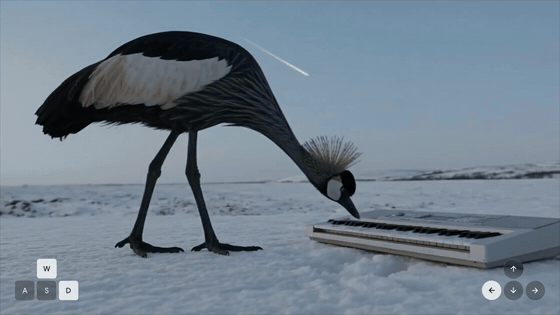
圖注:畫面還在跑的時候輸入提示詞,雪地裏就多出一架鋼琴,鶴走過去落在琴鍵上。來源:同上。
Genie 4 能力二:物理和人物更真實
官方博客說,Genie 4 能模擬空氣動力學、碰撞這類真實物理。演示裏有西瓜落地、楓葉飄落和互相碰撞的片段,需要注意這些都是 Google 自己放出來的演示。
官方認爲最大的提升在“人”這一塊:角色動作更自然,能對環境做出反應,也能被你實時操控。上一代 Genie 3 的人物相對僵硬,這次官方把它列爲主要改進方向。
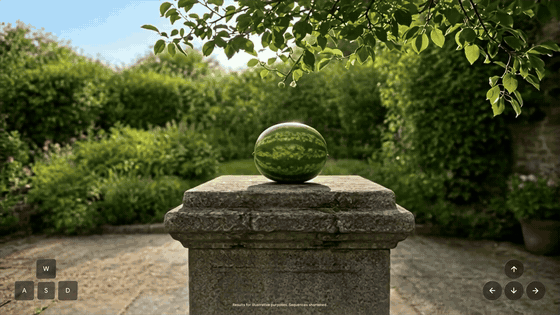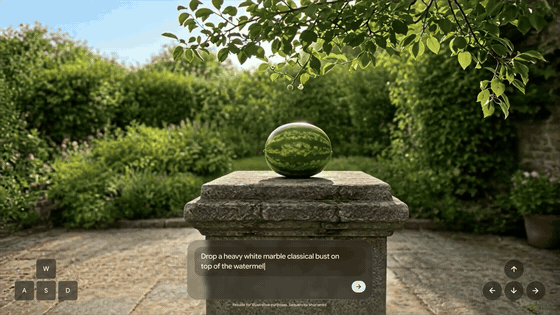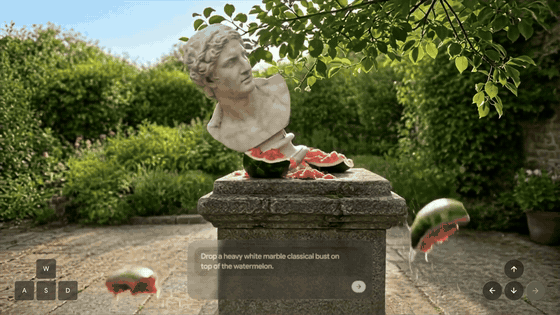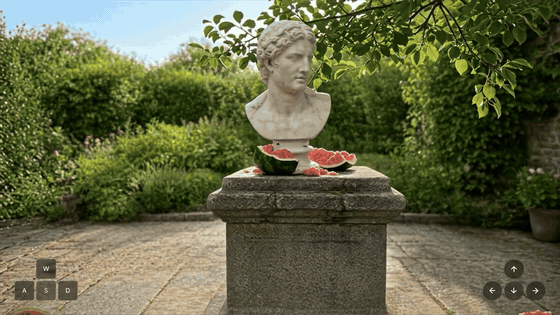
圖注:只寫一句“把大理石頭像砸到西瓜上”,場景裏就真的生成出頭像,西瓜被砸碎、果肉飛濺。來源:同上。
Genie 4 能力三:原生生成聲音
官方原話是,Genie 4 是他們“第一款原生生成音頻的實時世界模型”。每個世界都會帶上自己的環境音,從樹林裏的風聲到海浪聲,也可以有背景音樂。這些聲音和畫面同步生成,不是事後另外配上去的。
更進一步的是對話。官方博客說,角色會對你的輸入或世界裏發生的事情做出反應,並實時開口交談。早期體驗者 @venturetwins 在 X 上稱這是“一大步”,特別提到“還帶原生音頻”。這只是個人觀感,不代表效果已經得到驗證。
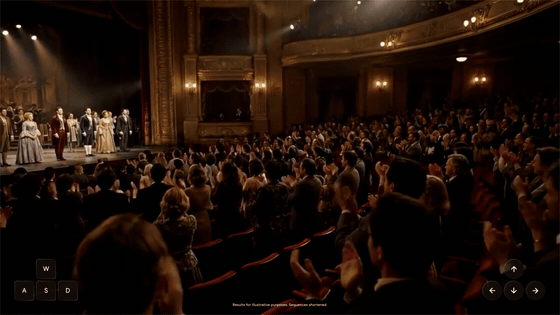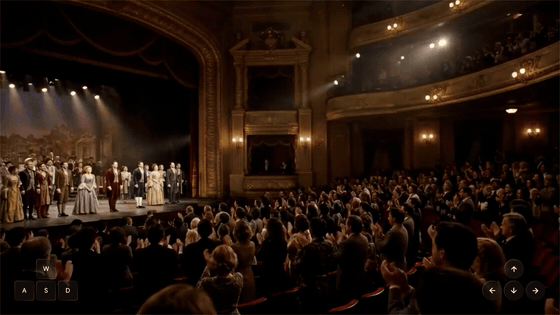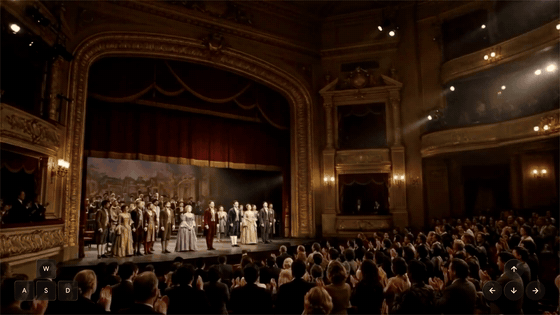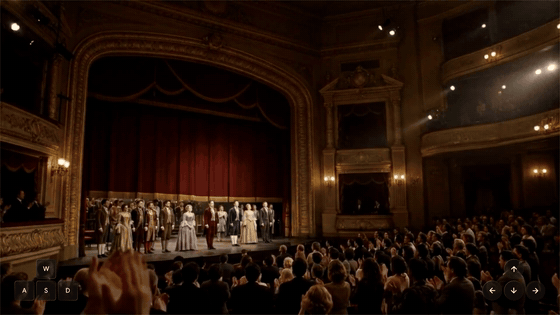
圖注:歌劇院世界裏鏡頭自己往上搖,看清穹頂。原片帶環境音和角色對話,GIF 保留不了聲音。來源:同上。
Genie 4 能力四:用 Gemini 模擬複雜事件
官方博客說,Genie 4 與 Gemini 結合後可以模擬多步驟事件。這樣一來,AI 系統在進入真實世界之前,可以先在模擬環境裏檢驗應對方式。這項能力主要面向機器人等研究場景,普通用戶短期內接觸不到。
Genie 4 二變:背後其實是三撥模型在配合
一句話結論:Genie 4 負責把像素畫出來,幾款 Gemini 模型分別負責外觀、調度和拆解任務。
官方博客寫明,Gemini Omni 負責把模擬錨定在真實世界的外觀和行爲上,也就是讓畫面裏的東西看起來像真的。想了解 Omni 此前的背景,可以看《Gemini Omni 視頻模型情報彙總:8 大信號鎖定 I/O 2026 發佈》。
被官方點名的第二個模型是 Gemini 3.8 Flash,官方稱它是“在循環中的引導代理”。它不負責畫畫,更像片場的導演兼場記:持續觀察畫面,把目標拆成一步步動作,再回看生成的畫面,判斷每一步有沒有完成。如果世界發生變化,或者用戶中途插話,它會當場調整計劃。
第三個是 Gemini 4 Argon,出現在 Gemini Robotics 相關實驗裏。官方舉的例子是:Argon 把“下跳棋”這個任務拆成步驟,以文字字幕的形式實時交給 Genie 4,Genie 4 渲染出 Apptronik 的 Apollo 人形機器人下棋的畫面。
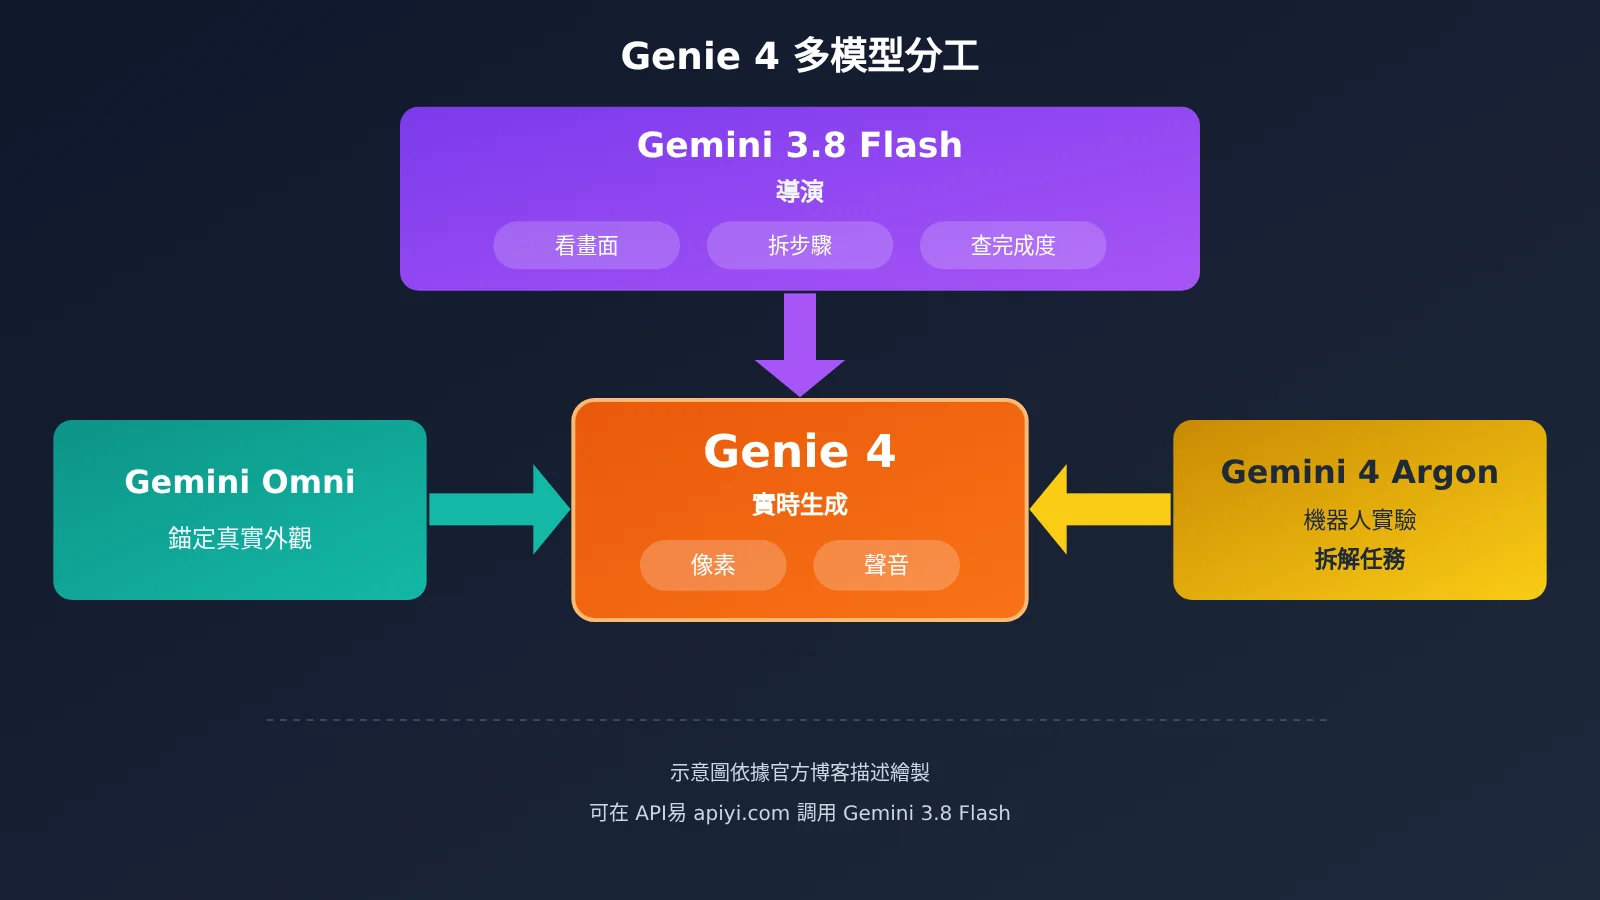
TechCrunch 引述的簡報內容中,Google 研究總監 Tejas Kulkarni 提到未來會出現“混合世界模型”:由 Gemini 寫代碼和文本,Genie 實時接收這些內容並模擬現實。官方博客也提出了同樣的方向,即 Gemini 負責結構和敘事時間線,Genie 負責像素級的物理表現。
Genie 4 三變:它和 Veo 這類視頻模型不是一回事
一句話結論:視頻模型交付的是一段成片,世界模型交付的是一個持續運行、可以隨時介入的現場。
兩者解決的問題不同,不存在誰替代誰。Veo 這類視頻模型適合產出可直接剪進作品的固定片段。Genie 4 更適合構思、預演和交互原型,官方並沒有把它定位成成片工具,也沒有說它能取代遊戲引擎。
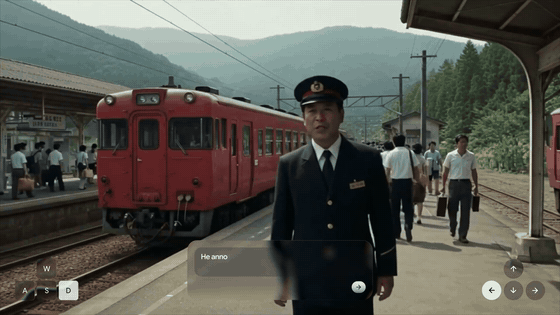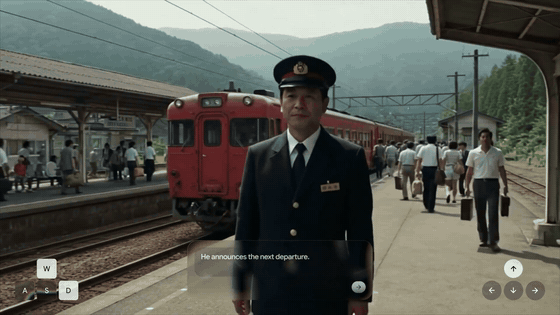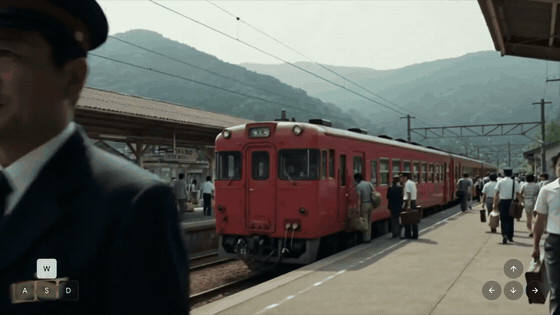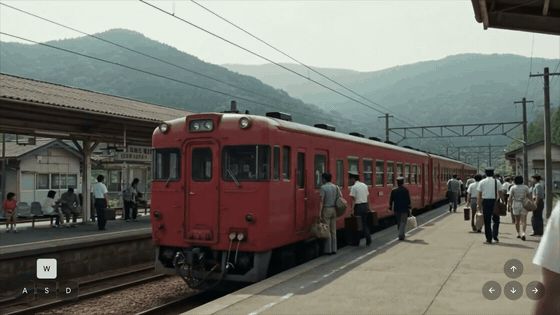
圖注:1980 年代日本鄉間車站,第一人稱視角一路走過站臺,人羣自己在動。這正是視頻模型給不了的部分。來源:同上。
[](https://help.apiyi.com/veo-3-1-preview-deprecated-migration-guide.html)
| 對比項 | 視頻模型(如 Veo) | 世界模型(Genie 4) |
|---|---|---|
| 產出物 | 一段固定的視頻片段 | 一個持續運行、可交互的場景 |
| 能不能中途改 | 生成過程中不能改 | 可以隨時用文字或操作改 |
| 想改結果要不要重生成 | 需要重新生成 | 不需要,場景會接着往下演 |
| 適合做什麼 | 成片素材、廣告、短視頻 | 預演、分鏡構思、交互原型、仿真研究 |
Genie 4 什麼時候能用上
一句話結論:目前只有受信任測試者能用,普通用戶只能先加入 waitlist 排隊。
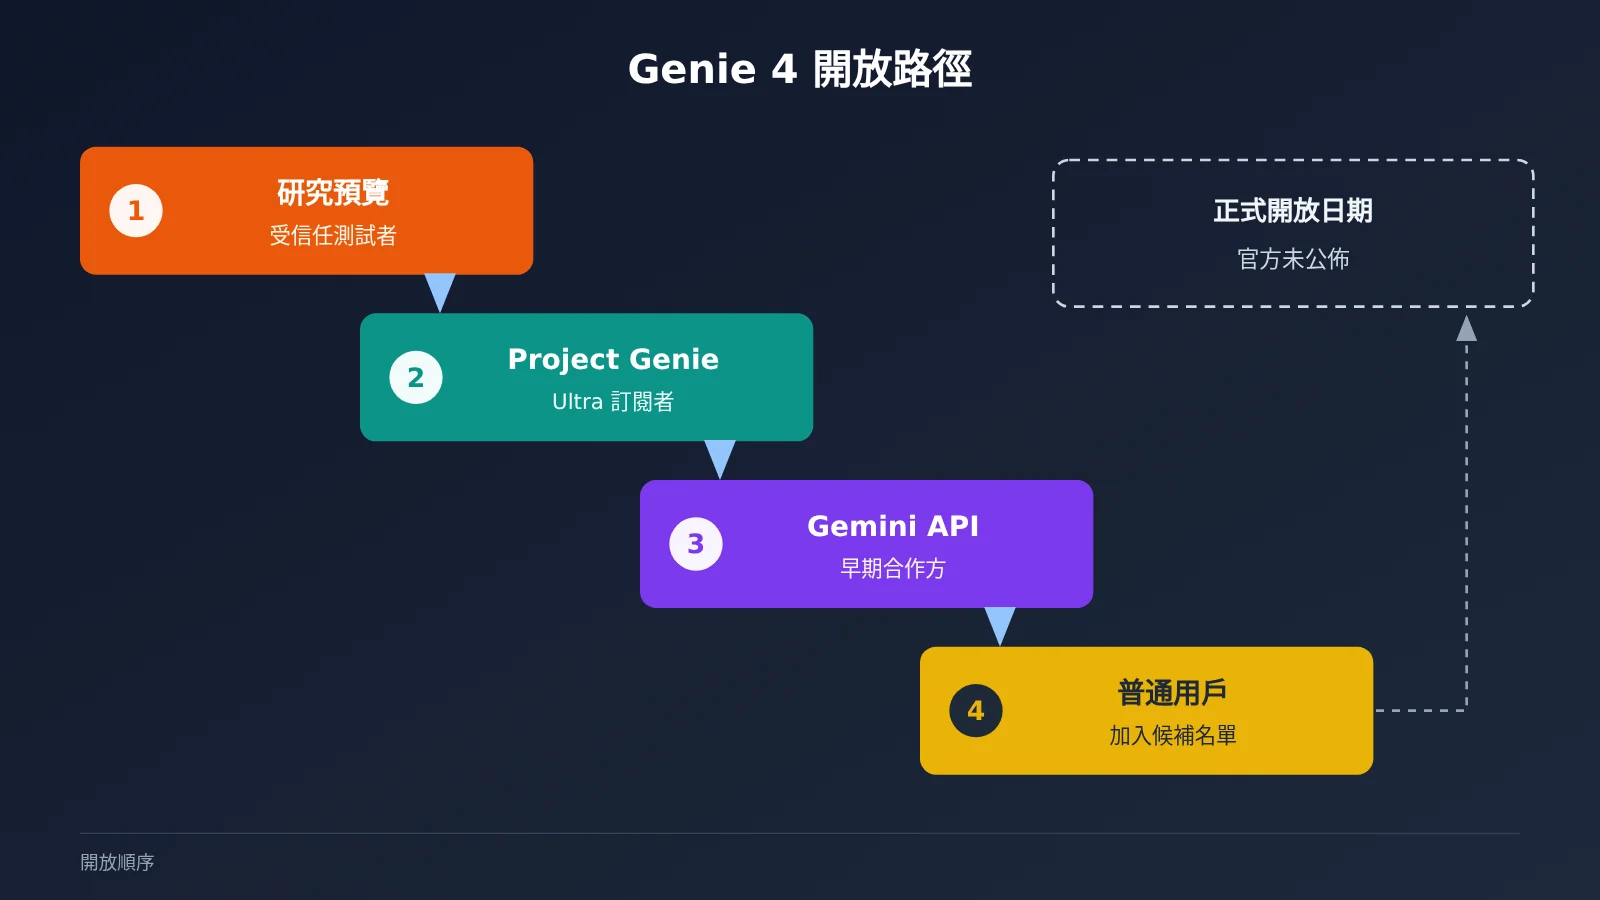
官方博客原話是:Genie 4 已作爲研究預覽開放給受信任測試者,收集反饋後,會先在 Google AI Ultra 訂閱的 Project Genie 中開放,同時開放給 Gemini API 與 Google AI Studio 的 early access partners。
這裏有兩個概念需要說明。Project Genie 是 Google Labs 的實驗網頁應用,相當於世界模型的“體驗展廳”,今年 1 月起掛在 Google AI Ultra 訂閱裏。early access partners 指提前拿到入場券的合作方,通常是企業或開發團隊,並不是公開註冊就能拿到的資格。
如果想排隊,官方頁面頂部有一個 Join the Genie 4 waitlist 入口,鏈接指向一張 Google 表單:forms.gle/WQnSNEM3omF7Uruu7,按表單要求填寫即可。還要提醒一點:截至 10 月 28 日,Gemini 訂閱頁上 Project Genie 那一行寫的仍然是 Genie 3,Genie 4 還沒有出現在訂閱權益裏。正式開放日期官方沒有公佈。
Genie 4 現在還做不到的六件事
一句話結論:官方自己承認 Genie 4 仍是早期研究,短時間內表現較好,時間一長就容易出問題。
- 畫面會漂移(官方博客):短時段內能保持連貫,但跑得久了、改詞改多了,或者在場景裏四處走動後,細節和物體的持續性會發生偏移,長期一致性仍在研究中。
- 複雜物理交互(官方博客):仍被列爲研究中的方向。
- 實時音頻的準確性(官方博客):聲音能生成出來,但準確度還在改進。
- 清晰可讀的文字(官方博客):畫面裏的招牌、文字可能渲染不清楚。
- 空間精度(官方博客):位置和距離關係還不夠精確。
- 單次能跑多久:官方博客沒有寫。TechCrunch 根據簡報報道稱,Genie 4 最長可維持約兩分鐘的一致場景,是上一代的兩倍。官方對照數據是 Project Genie 裏 Genie 3 的單次生成上限爲 60 秒,兩者能對得上,但“兩分鐘”目前仍是媒體口徑。
此外,分辨率、幀率、價格、調用額度、參數規模、API 上線時間,官方都沒有公佈。
社區裏也有不同聲音。X 用戶 @dummerspast39 認爲 Genie 4“不算新模型”,本質是 Omni 實時版加上 3.8 Flash 當助手。這只是單個用戶的判斷,沒有給出證據,官方也沒有回應。官方博客的說法是 Genie 4 “整合並建立在 Gemini 家族能力之上”。
國內讀者現在能做什麼
一句話結論:世界模型還要排隊,但“做一段今天就能用的視頻”現在就能做。
如果只是好奇,可以先加入 waitlist,同時關注官方博客和 SynthID 相關說明。SynthID 是 Google 的隱形水印技術,人眼看不出來,但可以被檢測到。官方說 Genie 4 生成的視頻和音頻都會嵌入 SynthID,以後看到疑似 Genie 生成的內容,可以用這個思路去核實。
如果想馬上動手,可以從 Genie 4 體系裏能拿到的部分入手。官方點名擔任“導演”的 gemini-3.8-flash,目前在 API易 apiyi.com 上可以調用。你可以讓它把一段場景描述拆成鏡頭、動作和臺詞,先把分鏡想清楚。視頻方向,平臺上已經有 Seedance 2.5 這類可用型號,可以把分鏡直接做成片段。具體型號與價格以平臺型號列表爲準,可在 apiyi.com 查看。
這樣做還有一個好處:一個 Key 就能調用多個模型,不需要爲每個模型單獨註冊。接口兼容 OpenAI 格式,把 base_url 設爲 https://api.apiyi.com/v1 即可接入現有代碼。等 Genie 4 真正開放時,你手裏已經有了一套“導演模型加視頻模型”的工作流經驗。
Genie 4 常見問題 FAQ
Q1:Genie 4 是什麼?
Google DeepMind 在 2026 年 10 月 27 日發佈的世界模型。它能實時生成可交互的環境,並且原生帶聲音和角色對話。
Q2:Genie 4 和 Genie 3 差在哪?
官方博客列出的新增內容包括原生音頻、角色對話、更真實的人物動作,以及由 Gemini 實時引導。時長方面只有 TechCrunch 的“兩分鐘”口徑,對照 Genie 3 在 Project Genie 裏的 60 秒上限。
Q3:現在能用 Genie 4 嗎?
普通用戶暫時不能用。官方只處在研究預覽階段,只開放給受信任測試者,後續會面向 AI Ultra 的 Project Genie 用戶和 API 早期合作方開放,具體日期沒有公佈。
Q4:Genie 4 有公開 API 和價格嗎?
沒有。官方沒有公開 API、模型名和計費方式,它目前也不是可以購買的產品。想先體驗周邊能力,可以在 API易 apiyi.com 調用 Gemini 3.8 Flash 等已上線型號。
Q5:Genie 4 能替代視頻生成工具嗎?
不能這樣理解。兩者產出物不同,視頻模型交付成片,Genie 4 適合預演和原型。需要成片素材時,仍然要用視頻模型,可通過 API易 apiyi.com 一個 Key 調用多個視頻型號。
Q6:官方演示的效果可信嗎?
演示是 Google 自己放出的,早期體驗者的評價也只是個人觀感。官方承認畫面會漂移、文字和空間精度仍有不足,最好等更多公開測試結果再下結論。
總結
Genie 4 最大的變化,是世界模型第一次同時具備了聲音、對話和實時可控的能力,背後由 Gemini Omni、Gemini 3.8 Flash 等模型分工配合。不過它目前仍是研究預覽,開放日期、價格和時長都沒有官方數字,“兩分鐘”也只是媒體口徑。
一句話帶走:Genie 4 值得關注,但現在還用不上;想做內容,可以先用現有模型把分鏡和視頻做出來。 需要的話,可以在 API易 apiyi.com 用一個 Key 試試 Gemini 3.8 Flash 和視頻型號。
參考資料
- Google DeepMind 官方博客:Genie 4: A new generation of world simulation
- 鏈接:
deepmind.google/blog/genie-4-a-new-generation-of-world-simulation - Google 官方博客:Introducing Genie 4
- 鏈接:
blog.google/innovation-and-ai/models-and-research/google-deepmind/introducing-genie-4 - TechCrunch 報道:Google’s Genie 4 world model adds audio, more realistic worlds, and real-time steering
- 鏈接:
techcrunch.com
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心