摘要:本文依據公開的第三方測試報告,分析 Qwen4-Max-Preview 完成抓娃娃機、Python 服務修復和 1,600 條工單檢索等任務的表現,並說明它在耗時和科研判斷上的邊界。
結論先行:Qwen4-Max-Preview 編程能力的核心判斷
公開測試報告顯示,Qwen4-Max-Preview 能夠推進多步驟開發,補充測試,並交付可複驗的項目。最有力的證據來自一次代碼修復任務:模型先復現缺陷,再新增測試、發送真實 HTTP 請求並校驗數據完整性,最終 57 項測試全部通過。它的短板同樣明確:複雜任務耗時較長,抓娃娃機任務用了約 75 分鐘;在科研任務中,模型對計算結果的解釋超出了證據範圍。因此,複雜交付物和科學結論都需要開發者審覈。
下文先從抓娃娃機任務切入,再梳理一份覆蓋 12 項任務的報告,重點分析代碼修復與工單檢索兩組可覈驗證據。隨後用非負矩陣分解案例說明模型的推理邊界,再結合同一抓娃娃機挑戰的跨工具對照討論效率問題,最後給出適合交給它的任務類型。本文爲公開報告的測評分析,我們沒有重新運行作者的項目,所有數字均標註來源和測試條件。
To Know:理解 Qwen4-Max-Preview 測評的 9 個術語
| 術語 | 解釋 |
|---|---|
| Agent | 模型自行規劃步驟、調用工具並逐步推進任務的工作方式。 |
| 狀態機 | 用一組狀態和狀態之間的轉換規則來控制程序行爲,例如抓娃娃機的“移動—下抓—上提—結算”。 |
| 迴歸測試 | 修改代碼後重新驗證已有功能,確認舊行爲沒有被改壞。 |
| HTTP 請求 | 客戶端向服務端發送的請求,用來檢驗接口在真實運行時返回什麼結果。 |
| 哈希校驗 | 計算文件內容的摘要值,前後對比即可判斷原始數據或測試文件是否被改動。 |
| Token 吞吐 | 單位時間內處理或生成的 Token 數量,數值受工具、網絡和運行環境影響。 |
| 上下文檢索 | 在一次請求攜帶的大量資料中定位並關聯目標信息。 |
| 非負矩陣分解 | 把一個非負數據矩陣近似拆成兩個非負因子矩陣相乘的算法。 |
| 局部最優解 | 在鄰近範圍內無法繼續改進的解;判斷一個解是否爲局部最優,需要額外的數學條件或分析。 |
1 75 分鐘完成抓娃娃機:Qwen4-Max-Preview 的一項複雜編程任務
1.1 抓娃娃機任務考察什麼
2026 年 11 月 12 日,人人都是產品經理刊發了一篇基於 Qoder 的 Qwen4-Max-Preview 實測報告,其中最複雜的一項是抓娃娃機交互系統。這項任務把多種編程難點集中在一個項目裏:機械交互與力反饋、繩索懸垂擺動、娃娃之間的碰撞、控制流程的狀態機,以及最終的計分邏輯。
這類任務很難靠一次性生成完成。物理效果、狀態切換和計分規則彼此依賴,模型需要反覆編寫、運行、觀察和修正,因此它考察的是 Agent 式的多步驟推進能力。
1.2 作者記錄的耗時、速度和消耗
| 指標 | 作者記錄 | 測試條件與說明 |
|---|---|---|
| 總耗時 | 約 75 分鐘 | Qoder 環境,單次任務 |
| 輸出速度 | 約 33 Tokens/s | 該次任務中觀測到的速度 |
| Credits 消耗 | 約 65 | 作者估算,Token Plan 計量 |
| 交付質量 | 較紮實 | 作者主觀評價,認爲整體可與 Kimi K3.1 打平 |
這組數字只屬於該次任務。Credits 是 Token Plan 的訂閱計量單位,實際消耗受輸入、緩存命中、輸出、思考 Token 和工具調用共同影響,65 Credits 只能說明這次任務的花費量級。33 Tokens/s 同樣是特定環境下的觀測值。
同一份報告還記錄了另外幾項任務。在只使用 NumPy 和 PIL 的水墨畫任務中,模型生成了超過 1,000 行代碼,繪製約 4,019 個筆觸,並用像素明度統計和 ASCII 輪廓掃描自檢,發現燕子與窗洞黑塊重疊後主動調整了座標。作者認爲它的代碼組織和自檢能力較強,審美表現仍有提升空間。
2 Qwen4-Max-Preview 的十二項真實任務覆蓋了什麼
2.1 一份更全面的測試報告
11 月 16 日,人人都是產品經理刊發了一份 Z Finance 測試報告,作者稱完成了 12 項任務,並對關鍵結果做了抽查和複驗。下表按報告覆蓋的任務整理:
| 類別 | 測試任務 | 主要考察能力 |
|---|---|---|
| 視覺生成 | 鵜鶘騎自行車 SVG | 視覺理解、代碼生成 |
| 財務分析 | 三份財報聯合分析 | 長文檔理解、財務口徑 |
| 圖表識別 | Apple 產品收入柱狀圖 | 圖表讀取、數值估計 |
| 辦公協作 | 會議紀要三輪修改 | 上下文保持、修改一致性 |
| 數據處理 | 44 行銷售數據清洗 | 去重、單位轉換、公式 |
| 演示文稿 | 平頭哥上市 PPT | 實時檢索、文件生成 |
| 長文本檢索 | 1,600 條客服工單 | 跨記錄關聯、條件篩選 |
| 代碼維護 | Python 工單服務修復 | 缺陷定位、測試與迴歸 |
| 科研復現 | 非負矩陣分解算法 | 算法實現、數值驗證 |
| 網頁開發 | 招股書資料展示頁面 | HTML、離線交付、交互 |
| 仿真系統 | 雨水花園模擬 | 交互設計、數值計算 |
| 遊戲開發 | 四季主題 3D 小遊戲 | 3D 場景、狀態管理、交互 |
2.2 五個值得關注的案例
這 12 項任務中,以下五項最能說明模型交付“可用成果”的能力:
- 財報分析:輸入 Apple、Costco 的 FY2026 年報和 Anthropic 第二版招股書,約 8 分鐘完成。抽查的 6 個關鍵數字全部正確,模型區分了經營虧損與淨虧損,指出了可轉債公允價值變動對淨虧損的影響,對未披露的未來指引沒有自行編造。
- Excel 清洗:44 行銷售明細中混入了重複記錄、僅有空格差異的重複數據、元與萬元兩種單位、三種日期格式和 5 筆缺失訂單。清洗後剩 35 行,四個區域合計 215,700 元,5 個彙總單元格均使用真實公式,修改明細後彙總值能自動更新。
- PPT 生成:模型通過實時檢索識別出分拆公告信息,生成可編輯的 PPT,並區分了估值預測與發行定價;第二輪調整受衆後,原有 20 個關鍵數字、日期和名稱都保持不變。作者也指出存在產品線遺漏。
- 工單檢索與 Python 修復:這兩項證據最具體,分別在第 4 節和第 3 節展開。
這些任務的共同點是交付物可以被檢查:公式能不能聯動,數字和原文是否一致,測試能否通過。這類證據比“生成了一段看起來正確的代碼”更有說服力。
3 57 項測試通過:Qwen4-Max-Preview 最有說服力的工程證據
3.1 修復過程完整還原
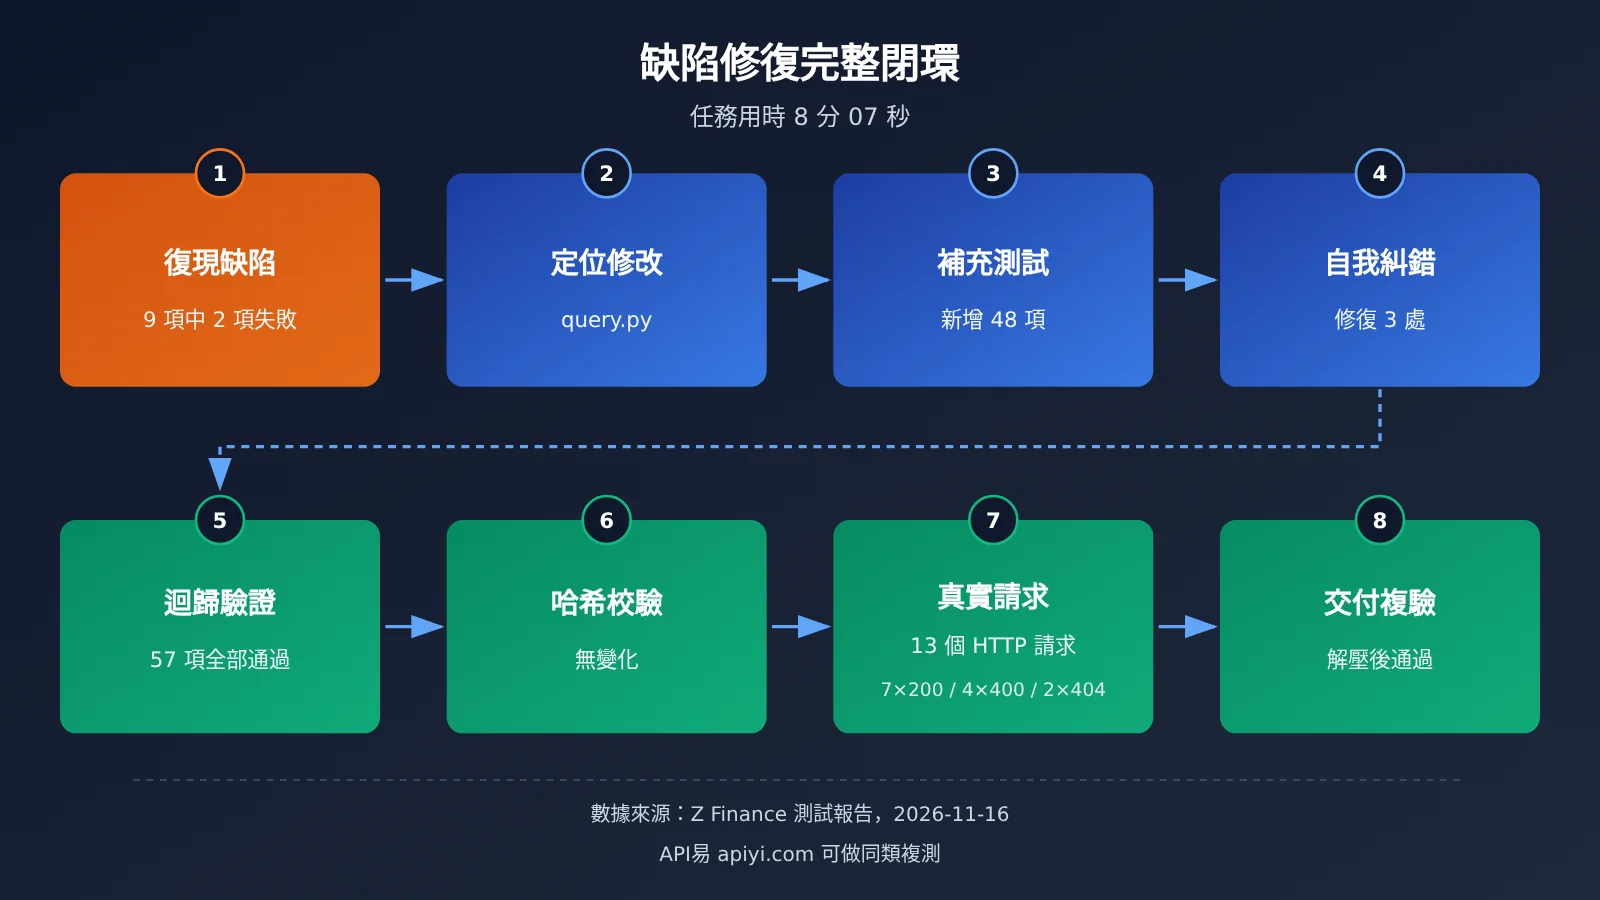
被測對象是一個用 Python 標準庫編寫的工單查詢服務,缺陷涉及組合篩選、排序、分頁和參數校驗。任務要求修復缺陷,同時保留接口、原始數據和原有測試。報告記錄該次任務用時 8 分 07 秒,過程如下:
| 步驟 | 模型的動作 | 工程意義 |
|---|---|---|
| 復現缺陷 | 先運行原有 9 項測試,復現其中 2 項失敗 | 先確認問題存在,再動手修改 |
| 定位修改 | 主要修改集中在 query.py | 改動範圍收斂,降低副作用 |
| 補充測試 | 新增 48 項測試 | 覆蓋原測試未覆蓋的邊界情況 |
| 自我糾錯 | 修復自編測試中的 3 處問題 | 發現測試本身寫錯並及時糾正 |
| 迴歸驗證 | 最終 57 項測試全部通過 | 9 項原有測試加 48 項新增測試 |
| 完整性檢查 | 對原始數據和原有測試做哈希校驗,哈希無變化 | 證明沒有靠篡改數據或測試來“通過” |
| 真實請求 | 啓動本地服務發送 13 個 HTTP 請求,得到 7 個 200、4 個 400、2 個 404 | 驗證接口運行時的正常響應與錯誤處理 |
| 交付複驗 | 解壓最終交付包後再次運行,測試通過 | 確認交付物本身可以獨立運行 |
3.2 爲什麼這比生成代碼更能說明問題
AI 編程中常見的失敗方式有兩種:一是改動測試或數據讓測試“變綠”,二是代碼在測試裏通過,在真實運行時出錯。該次任務的哈希校驗針對第一種風險,真實 HTTP 請求和交付包複驗針對第二種風險。4 個 400 和 2 個 404 響應說明模型也驗證了錯誤路徑,參數校驗和不存在資源的處理都經過實際檢驗。
這一流程與成熟工程師修 Bug 的習慣一致:復現、修復、補測、迴歸、交付。它證明 Qwen4-Max-Preview 在一個規則明確、規模可控的服務中具備完整的維護閉環。這仍是一次任務的記錄,無法換算成通用的代碼修復成功率。
4 百萬上下文的實際價值:在 1,600 條工單中找到相隔 741 行的線索
4.1 測試設計與結果
官方公佈的 Qwen4-Max-Preview 上下文窗口爲 1,000,000 Tokens。窗口大小隻是容量上限,決定實用價值的是模型能否在大量材料中建立正確關聯。Z Finance 報告中的工單測試回答了這個問題。
測試數據爲 1,600 條客服工單,體量約 50 萬字節,關鍵線索分佈在相隔 741 行的兩條記錄中,共提出 5 個問題。報告記錄 5 個問題全部答對,具體表現包括:
- 把兩條分散的工單關聯起來,找到 1,386 元退款金額及經手人。
- 依據審批日期,判斷補償券新政策是否適用於該案例。
- 統計出 62 條符合指定條件的工單,與腳本統計結果一致。
- 找出兩組重複訂單號,並區分哪組屬於正常流轉、哪組屬於客戶信息衝突。
4.2 字節和 Token 是兩種單位
約 50 萬字節是文件大小,Token 數量取決於分詞方式和中英文比例,兩者需要分開計算。這項測試證明的是“中等規模資料中的跨記錄關聯與條件篩選”,它的規模遠小於 100 萬 Token 的窗口上限,因此不能當作極限容量的壓力測試。
第 3 項結果的價值在於可覈對:62 條與腳本統計一致,說明模型的計數可以用確定性程序複覈。實際使用時也建議採用同樣的做法,用腳本覈對模型給出的統計結果,再把模型用於關聯和解釋這類腳本難以完成的部分。
5 不能忽視的短板:Qwen4-Max-Preview 在科研推理中的過度結論
5.1 計算做對了,解釋超出了證據
科研復現任務要求依據指定論文實現非負矩陣分解的乘法更新算法。輸入矩陣爲 48×36,使用三組不同初值,每組迭代 500 次。報告記錄模型用時 10 分 06 秒,交付了代碼、數值結果、圖表和日誌;三組結果各提供 52 個檢查點,A 組關鍵檢查點與公開參考結果吻合,另有 63 項自查記錄。
問題出在結論環節。模型僅憑目標函數持續下降,就把結果解釋爲收斂到局部最優解。作者指出這屬於過度推斷。
5.2 三個需要分開判斷的概念
這個案例涉及三個層次的判斷,後者都需要比前者更強的證據:
- 目標函數下降:乘法更新規則的設計特性,日誌和圖表可以直接觀察到。
- 數值迭代收斂:需要檢查迭代量的變化是否趨於穩定,並設定明確的停止標準。
- 收斂到局部最優解:需要驗證最優性條件,例如 KKT 條件,單看函數值下降無法得出。
這說明模型的執行能力和論證嚴謹性需要分別評估。數值計算可以靠檢查點驗證,科學結論則需要具備相關背景的人審覈。在研究、論文復現或技術報告場景中,模型輸出的“結論段”應作爲草稿處理。
6 Qwen4-Max-Preview 與其他編程工具的同任務對照
6.1 抓娃娃機挑戰的對照數據
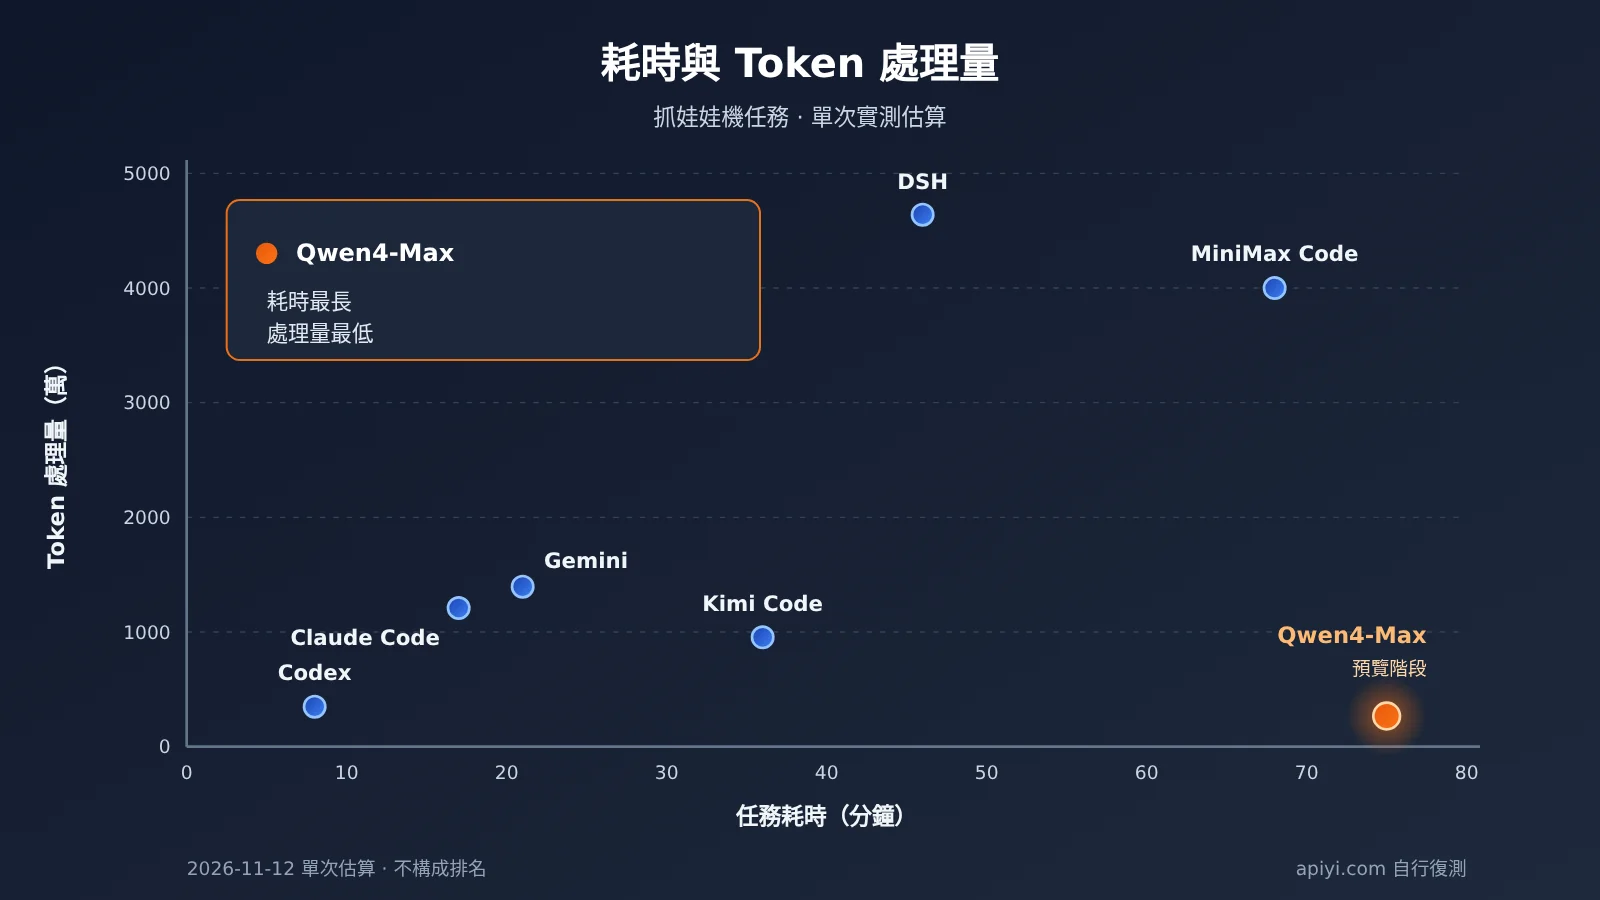
11 月 12 日的報告還給出了同一抓娃娃機挑戰在不同工具中的記錄。原表中的 Qwen 一行標註爲 Qwen4-Max,測試時間爲 11 月 12 日,早於正式版 11 月 16 日上線,對應的是預覽階段的模型。
| 工具/模型 | 耗時 | Token 總處理量(估算) | 輸出 Token | 複測入口 |
|---|---|---|---|---|
| Codex | 8 分鐘 | 350 萬 | 2.8 萬 | 對應官方工具 |
| Claude Code | 17 分鐘 | 1,215 萬 | 13 萬 | 官方工具;Claude 模型可經 API易 apiyi.com 調用 |
| Gemini | 21 分鐘 | 1,394 萬 | 8.1 萬 | 官方工具;Gemini 模型可經 API易 調用 |
| Kimi Code | 36 分鐘 | 950 萬 | 5.9 萬 | 對應官方工具 |
| DSH | 46 分鐘 | 4,644 萬 | 28.1 萬 | 對應官方工具 |
| MiniMax Code | 68 分鐘 | 4,000 萬 | 19.8 萬 | 對應官方工具 |
| Qwen4-Max(預覽階段) | 75 分鐘 | 269 萬 | 5.5 萬 | Token Plan(Qoder) |
6.2 如何讀這組數據
數據呈現出一個明顯的反差:Qwen4-Max-Preview 在該任務中的 Token 總處理量最低,約 269 萬,耗時卻最長,約 75 分鐘。結合約 33 Tokens/s 的觀測速度可以看出,該次任務的瓶頸在生成速度,消耗的 Token 規模本身並不大。
這組數據不適合做排名,原因有三點:Token 總量是作者估算的;各工具的上下文緩存佔比、調用策略和執行方式不同;表中各模型的具體版本也沒有統一說明。Token 處理量低可能來自更少的重複讀取,也可能來自工具層的緩存策略差異,現有材料無法區分。它能支持的判斷是:在這個工具環境裏,Qwen4-Max-Preview 適合對等待時間不敏感、更在意交付完整性的任務。
7 哪些開發者值得嘗試 Qwen4-Max-Preview
7.1 適合與謹慎使用的場景
綜合兩份報告,Qwen4-Max-Preview 在以下任務中表現較穩定:
- 規則明確的代碼維護:有現成測試、問題邊界清楚的修復和補測任務。
- 長文檔檢索與關聯:工單、日誌、合同、財報中的跨記錄查找,配合腳本複覈統計結果。
- 辦公自動化:數據清洗、帶公式的 Excel、可編輯 PPT 和多輪修改。
- 交互原型開發:單文件網頁、模擬系統和小遊戲原型,例如報告中約 46KB、無外部依賴的離線展示頁。
需要謹慎的是三類任務:對響應時間敏感的交互開發(單次任務可能持續一小時以上)、需要嚴格數學或科學論證的結論輸出,以及高可靠性要求的生產變更。報告作者的總結也包括“範圍較寬的任務中部分信息會遺漏”和“仍需要人工覈驗最終交付物”。
使用前還要注意官方限制:Preview 只能通過阿里雲 Token Plan 在 Claude Code、Cursor、Qoder 等工具中交互式使用,不支持按量付費,預覽期至 2026 年 11 月 25 日 24:00(北京時間)結束後下線。正式版 Qwen4-Max 已於 11 月 16 日上線,官方建議遷移到正式版。兩者參數不同:正式版思考模式最大輸出爲 262,144 Tokens,Preview 爲 393,216 Tokens,遷移時需要重新設置輸出預算。
7.2 用自己的任務做一次同類複測
二手報告最多隻能說明“這個模型做得到”。決定它是否適合你的團隊,最直接的方法是拿自己的真實代碼和測試做一次對照。下面的示例通過 OpenAI 兼容接口發送一項代碼修復任務,並記錄耗時和 Token 用量。模型名稱請以平臺模型列表中的實際名稱爲準。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,OpenAI 兼容
)

resp = client.chat.completions.create(
    model="qwen4-max",  # 以 API易 模型列表中的實際名稱爲準
    messages=[{"role": "user", "content": "閱讀以下代碼與失敗的測試,給出最小修復補丁:..."}]
)
print(resp.choices[0].message.content)
查看多模型對照複測腳本
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一個 Key 調用多家模型
)

# 替換爲平臺模型列表中的實際名稱
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你將收到一個 Python 服務的源碼和測試結果。
要求:1) 先說明覆現到的失敗原因;2) 只修改必要文件;
3) 補充覆蓋邊界條件的測試;4) 不得修改原始數據和已有測試。
--- 源碼與測試輸出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # 思考模型的思考 Token 也佔用輸出預算,需預留空間
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # 將補丁應用到隔離目錄,運行測試並對原始數據做哈希校驗後再評分
腳本只負責收集方案和用量,評分環節要照搬報告中的做法:在隔離目錄裏應用補丁,運行原有測試和新增測試,用哈希值確認數據和舊測試沒有被改動。這樣得出的結論纔對你的代碼庫有效。
🚀 快速開始:如果要在同一組任務上對比多個模型,可以通過 API易 apiyi.com 獲取免費測試額度。平臺提供 OpenAI 兼容接口,一個 API Key 即可切換 OpenAI、Claude、Gemini 等主流模型,便於把複測腳本跑在同一套評測流程裏。
8 Qwen4-Max-Preview 測評常見問題
Q1:75 分鐘完成抓娃娃機,說明它速度慢嗎?
在該次 Qoder 任務中,它的耗時是對照表裏最長的,觀測輸出速度約 33 Tokens/s。這只是單一環境下的記錄,工具調度和網絡條件都會影響結果。如果你的場景對等待時間敏感,建議用自己的任務實測。
Q2:57 項測試通過能代表它的代碼修復成功率嗎?
它代表一次完整、可覈驗的修復過程,無法換算成成功率。想評估在自己項目中的表現,可以通過 API易 apiyi.com 用同一組缺陷樣本對比多個模型,按測試通過情況和哈希校驗結果打分。
Q3:工單測試是否驗證了 100 萬 Token 上下文?
沒有。該測試約 50 萬字節,Token 數量取決於分詞方式,規模遠小於窗口上限。它驗證的是跨記錄關聯和條件篩選能力。
Q4:Preview 結束後應該怎麼辦?
官方已上線正式版 Qwen4-Max,並建議使用正式版。正式版支持按量付費 API,思考模式最大輸出爲 262,144 Tokens,遷移時需要調整輸出預算。第三方平臺的上架情況和價格變化較快,可以在 API易 apiyi.com 的模型列表中確認當前可用的模型名稱後再接入。
Q5:能把 Token Plan 的 Key 放進自己的應用後端嗎?
不能。官方規定 Token Plan 僅限在允許的編程工具和智能體工具中交互式使用,自動化腳本批量調用和自建應用後端都不在允許範圍內,違規可能導致訂閱暫停或 Key 被封禁。自建應用應選擇符合使用範圍的 API 產品。
9 Qwen4-Max-Preview 測評 Key Takeaways
- 交付閉環:代碼修復任務覆蓋復現、修復、補測、哈希校驗、真實請求和交付複驗,57 項測試通過。
- 長文本關聯:1,600 條工單中跨 741 行關聯線索,5 問全對,62 條統計與腳本一致。
- 辦公交付:Excel 公式可聯動,PPT 多輪修改後 20 個關鍵事實保持不變。
- 速度短板:抓娃娃機任務約 75 分鐘,Token 處理量低、耗時長。
- 推理邊界:科研復現的計算與參考結果吻合,結論存在過度推斷,需要人工審覈。
- 證據性質:以上均爲單一作者的任務實測,不構成標準化排名。
- 上手方式:用自己的代碼與測試做對照複測,可藉助 API易 apiyi.com 在一個接口內切換多個模型。
10 總結:開發者應該把 Qwen4-Max-Preview 用在哪裏
公開報告給出的畫像比較清晰。Qwen4-Max-Preview 擅長有明確規則和可檢驗結果的工作:帶測試的代碼維護、長資料中的跨記錄檢索、帶公式的數據處理和可編輯辦公文件,以及交互原型開發。它在這些任務中能自己補測試、自己查錯,並交付可以複驗的成果。
它的限制同樣具體:複雜任務耗時較長,適合放在後臺運行;科學結論容易超出證據範圍,需要專業審覈;Preview 只能通過 Token Plan 在指定工具中交互使用,並將於 11 月 25 日下線,長期使用應轉向正式版。
最務實的做法是把它當作一名能獨立完成維護閉環的工程助手,由開發者負責結論把關和最終合併。上線前,建議用自己的真實任務做一次多模型對照,通過 API易 apiyi.com 統一接口即可在同一流程裏完成測試與比較。
📚 參考資料
-
人人都是產品經理:Qwen4-Max 預覽版來了!實測,談談感受:Qoder 抓娃娃機實測與跨工具對照,2026-11-12
- 鏈接:
woshipm.com/ai/6492544.html - 說明: 75 分鐘耗時、33 Tokens/s、65 Credits 及對照表來源
- 鏈接:
-
人人都是產品經理:實測 Qwen4-Max-Preview(Z Finance 測試報告):12 項任務綜合測試,2026-11-16
- 鏈接:
woshipm.com/evaluating/6494229.html - 說明: 代碼修復、工單檢索、科研復現、辦公任務數據來源
- 鏈接:
-
阿里雲 Model Studio:Qwen4-Max-Preview 文檔:官方規格與使用說明
- 鏈接:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 說明: 上下文窗口、最大輸出、預覽時間與接入方式
- 鏈接:
-
阿里雲 Model Studio:Qwen4-Max 文檔:正式版參數與計費
- 鏈接:
help.aliyun.com/zh/model-studio/qwen4-max - 說明: 正式版輸出預算與按量付費信息
- 鏈接:
-
阿里雲:Token Plan 權限與使用規範:使用範圍限制
- 鏈接:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 說明: 交互式使用要求與禁止場景
- 鏈接:
作者:API易 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心