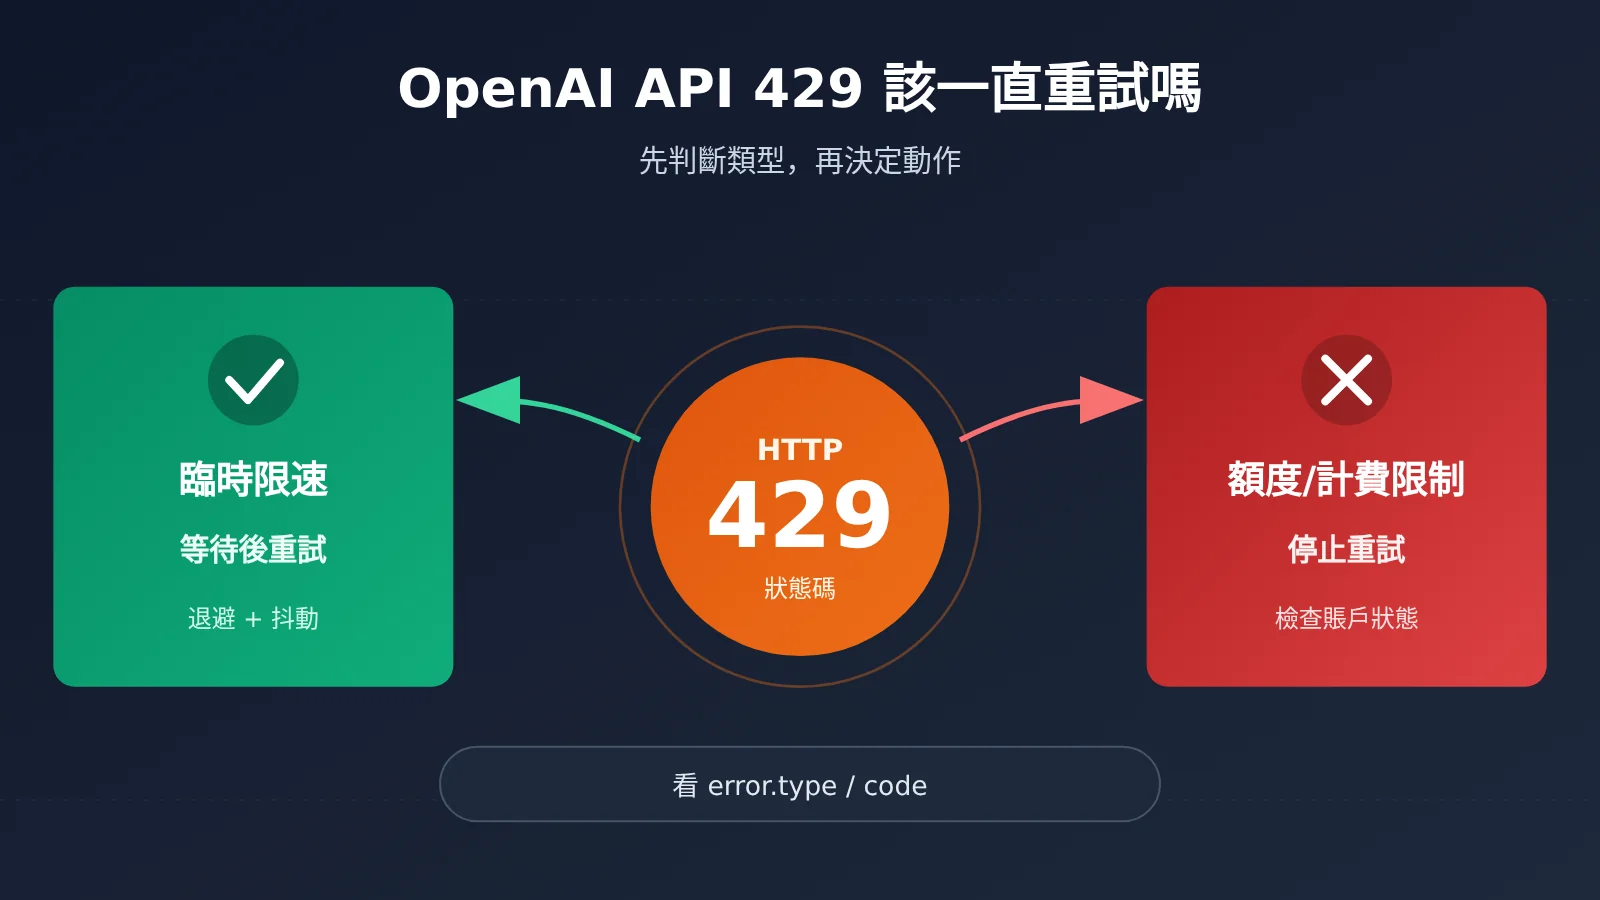
不該一直重試。 OpenAI API 返回 429,並不等於“稍等一下就好”。只有臨時性的速率限制適合等待後重試。額度用盡、計費異常或組織層面的使用限制,再怎麼重試也不會恢復,反而會把隊列堵死。
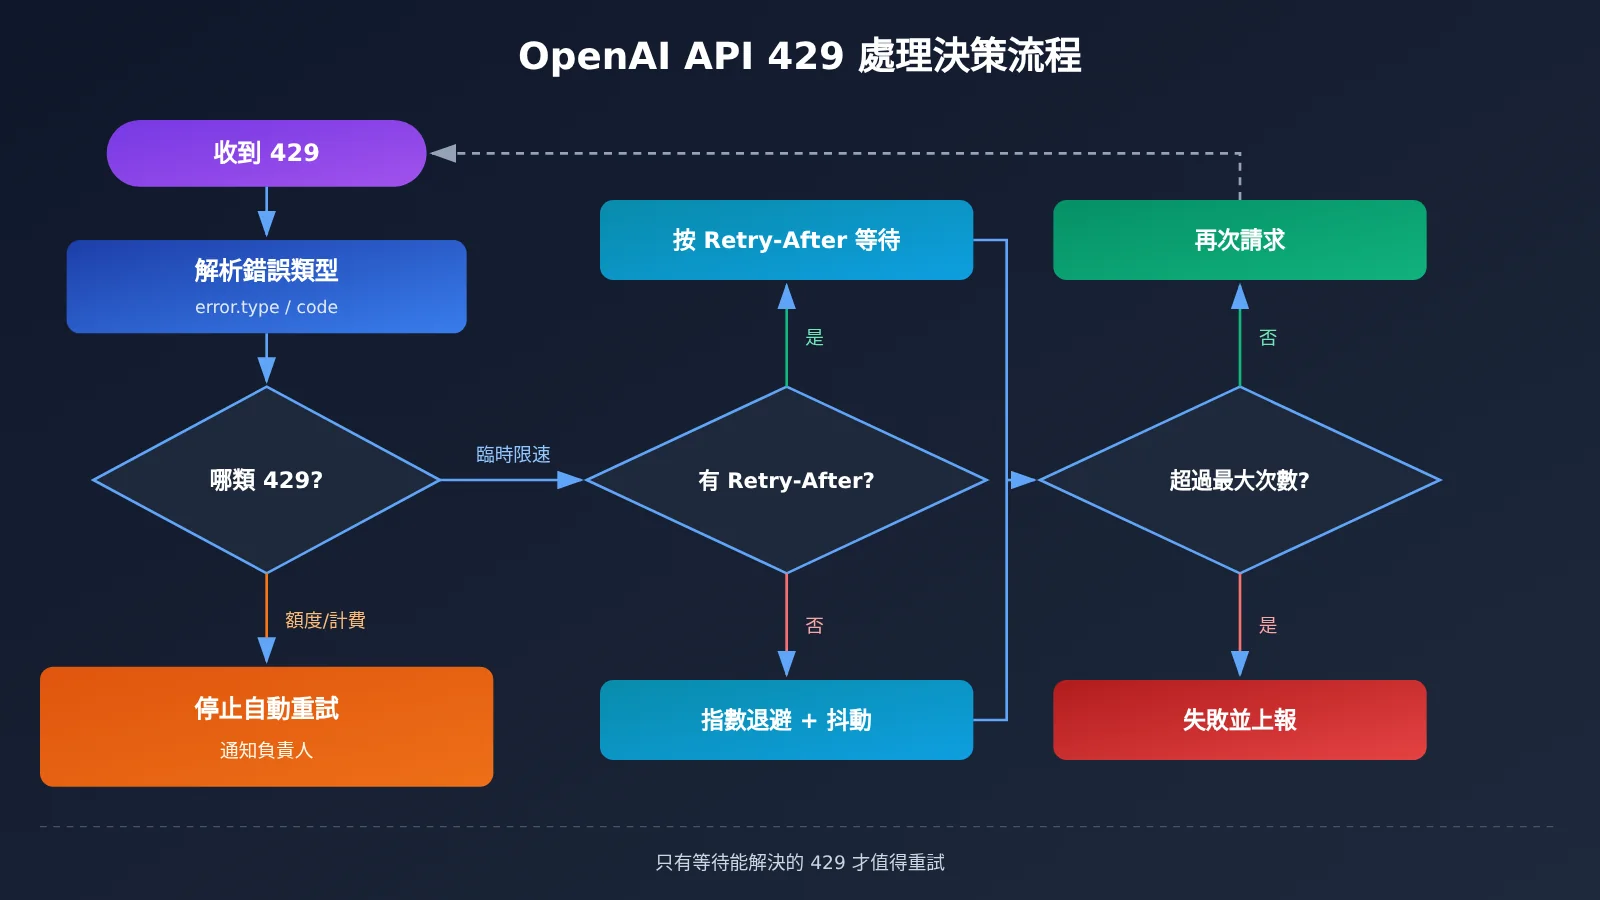
正確做法是先看錯誤信息、error.type 和可用的 error.code,判斷屬於哪一類 429。如果是臨時限速,有有效的 Retry-After 就照它等待,沒有就用帶隨機抖動的指數退避,並設置次數上限。
您讀完此文能瞭解到什麼?
- OpenAI API 的 429 至少分爲哪幾類,各自應該怎麼處理。
Retry-After、指數退避、隨機抖動三者是什麼關係,什麼時候用哪個。- 官方 SDK 自動重試、任務隊列和人工“重試”按鈕疊加後,爲什麼會放大 429。
- 請求數瓶頸和 token 瓶頸的不同解法,以及流式請求中途出錯時的注意事項。
索引: 正文前先用一張概念表和一張影響速覽,幫你統一術語,並找到與自己相關的部分。“客觀事實”部分整理 OpenAI 官方文檔對 429 的描述,包括錯誤分類、重試規則和 SDK 行爲。“分析判斷”部分討論工程落地,包括按瓶頸類型調整策略、設計隊列狀態、排查重試疊加,以及遷移到其他網關時要注意的語義差異。
To Know:理解 OpenAI API 429 需要的概念
| 概念 | 簡要解釋 |
|---|---|
| HTTP 429 | “Too Many Requests”狀態碼。OpenAI API 用它表示速率限制,也用它表示額度或使用量限制 |
| 速率限制(Rate Limit) | 在一段時間內可以發起的請求量上限。OpenAI 會分別統計請求數和 token 量 |
| RPM / TPM | 每分鐘請求數、每分鐘 token 數。兩者任一觸頂都可能觸發 429 |
error.type / error.code |
錯誤響應體中的結構化字段,用來區分 429 的具體原因,比只看狀態碼更可靠 |
| Retry-After | 響應頭字段,表示服務端建議多久之後再試。值有效時應優先遵循 |
| 指數退避(Exponential Backoff) | 每次失敗後,等待時間按倍數遞增,例如 1 秒、2 秒、4 秒,並設置上限 |
| 隨機抖動(Jitter) | 在退避時間上加入隨機量,避免大量客戶端在同一時刻集中重試 |
| 流式輸出(Streaming) | 模型邊生成邊返回內容。一旦開始輸出,中途出錯就不能簡單地整體重放 |
| 重試疊加 | SDK、業務隊列、用戶手動操作各自重試,實際請求量被成倍放大的現象 |
影響速覽:OpenAI API 429 對不同角色意味着什麼
| 角色 | 主要影響 | 需要關注的點 |
|---|---|---|
| 後端開發者 | 重試邏輯寫錯,會把短暫限速放大成持續故障 | 區分 429 類型,統一由一層負責重試 |
| 批處理與數據任務負責人 | 大批量任務容易同時撞上請求數和 token 兩條限制 | 提交節奏、上下文體積、隊列狀態設計 |
| 產品與前端 | 用戶反覆點“重試”,會繼續製造新的 429 | 告訴用戶下次嘗試時間,或說明是賬戶原因 |
| 運維與賬戶管理者 | 額度、計費類 429 無法靠代碼自愈 | 及時發現並處理賬戶狀態,而不是放任自動重試 |
客觀事實:OpenAI 官方文檔如何描述 429
本部分依據 OpenAI 公開維護的錯誤碼指南、速率限制指南和幫助中心的 429 排查文章,覈查日期爲 2026-11-17。這些是持續更新的維護文檔,本文無法覈實相關內容最早發佈於何時,因此不把它當作當日新聞,只把它作爲當前有效的規則說明。
OpenAI API 429 的不同來源
官方文檔的核心立場是:同樣是 429,含義可能不同,要結合錯誤信息、error.type 和可用的 error.code 判斷。 臨時速率限制與額度、計費、組織使用限制,處理方式不一樣。
前者是“當前窗口內請求太快或太多”,過一段時間窗口刷新就能恢復。後者涉及賬戶本身的狀態,例如額度用完、付款問題、組織層面的使用上限。這類問題不會隨時間自動消失。
| 429 類型 | 典型信號 | 等待能否解決 | 推薦動作 |
|---|---|---|---|
| 請求數限速 | 錯誤信息指向請求數上限,常見 code 爲 rate_limit_exceeded |
通常可以 | 遵循 Retry-After,或使用帶抖動的指數退避 |
| token 量限速 | 錯誤信息指向 token 上限 | 通常可以,但容易反覆觸發 | 退避的同時減少單次請求的 token 量 |
| 額度/計費/組織限制 | 錯誤信息指向額度或賬單,常見 code 爲 insufficient_quota |
不能 | 停止自動重試,通知負責人處理賬戶 |
需要強調的是,error.code 的具體取值應以實際返回內容和官方文檔爲準。上表的 code 只是常見示例,代碼中不要只靠硬編碼字符串做判斷,同時保留錯誤信息原文用於日誌排查。
請求數與 token 量可能分別受限
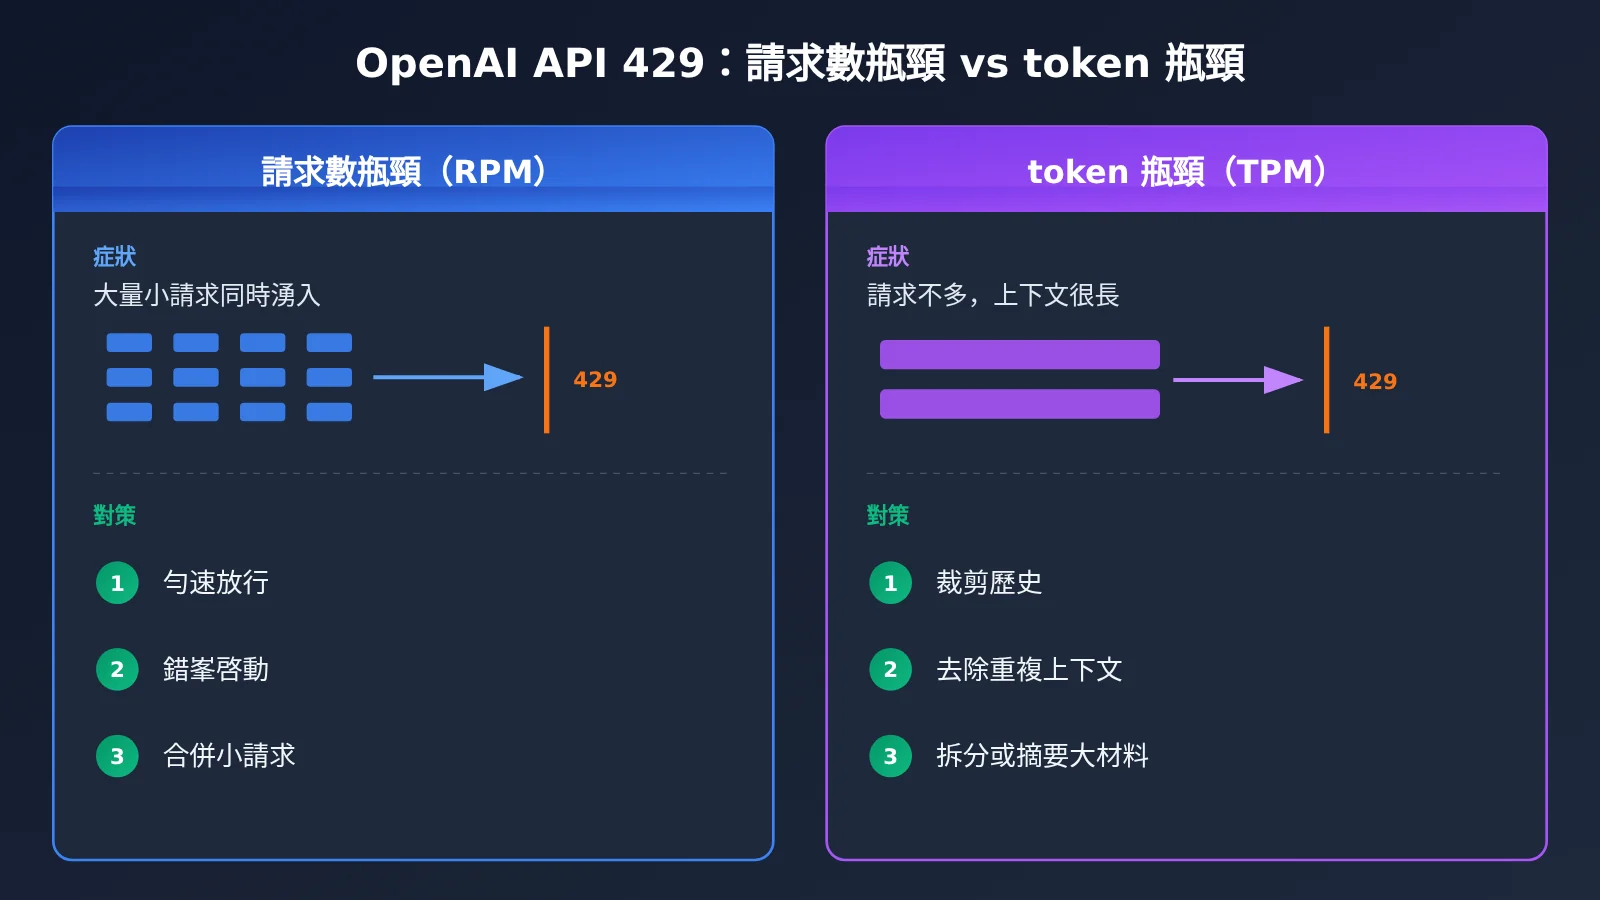
速率限制指南說明,限制會從多個維度計量,其中最常遇到的是請求數和 token 量,兩者獨立生效。也就是說,請求數還遠沒到上限時,也可能因爲每個請求都帶着很長的上下文而先撞上 token 限制。反過來,大量很小的請求也可能先耗盡請求數。
OpenAI 在響應頭中提供了與速率限制相關的信息,例如剩餘請求數、剩餘 token 數和各自的重置時間。這些頭字段有助於在真正觸發 429 之前判斷自己離哪條上限更近。
官方推薦的 OpenAI API 429 重試方式
對於適合重試的臨時限速,官方的推薦可以歸納爲兩條:
- 存在有效的 Retry-After 時,遵循它。 這是服務端給出的最直接信號,比客戶端自己猜更準確。
- 沒有 Retry-After 時,使用帶隨機抖動的指數退避。 等待時間隨失敗次數遞增,再疊加隨機量,避免所有客戶端在同一時刻一起重試。
這兩條規則的前提是“這次 429 屬於等待能解決的類型”。如果是額度或計費問題,再精確的退避算法也只是在空轉。
官方 SDK 的自動重試行爲
OpenAI 官方 SDK 會對符合條件的限速錯誤自動重試,具體行爲受客戶端配置影響。以 Python SDK 爲例,可以通過 max_retries 參數調整,或者設爲 0 關閉自動重試。
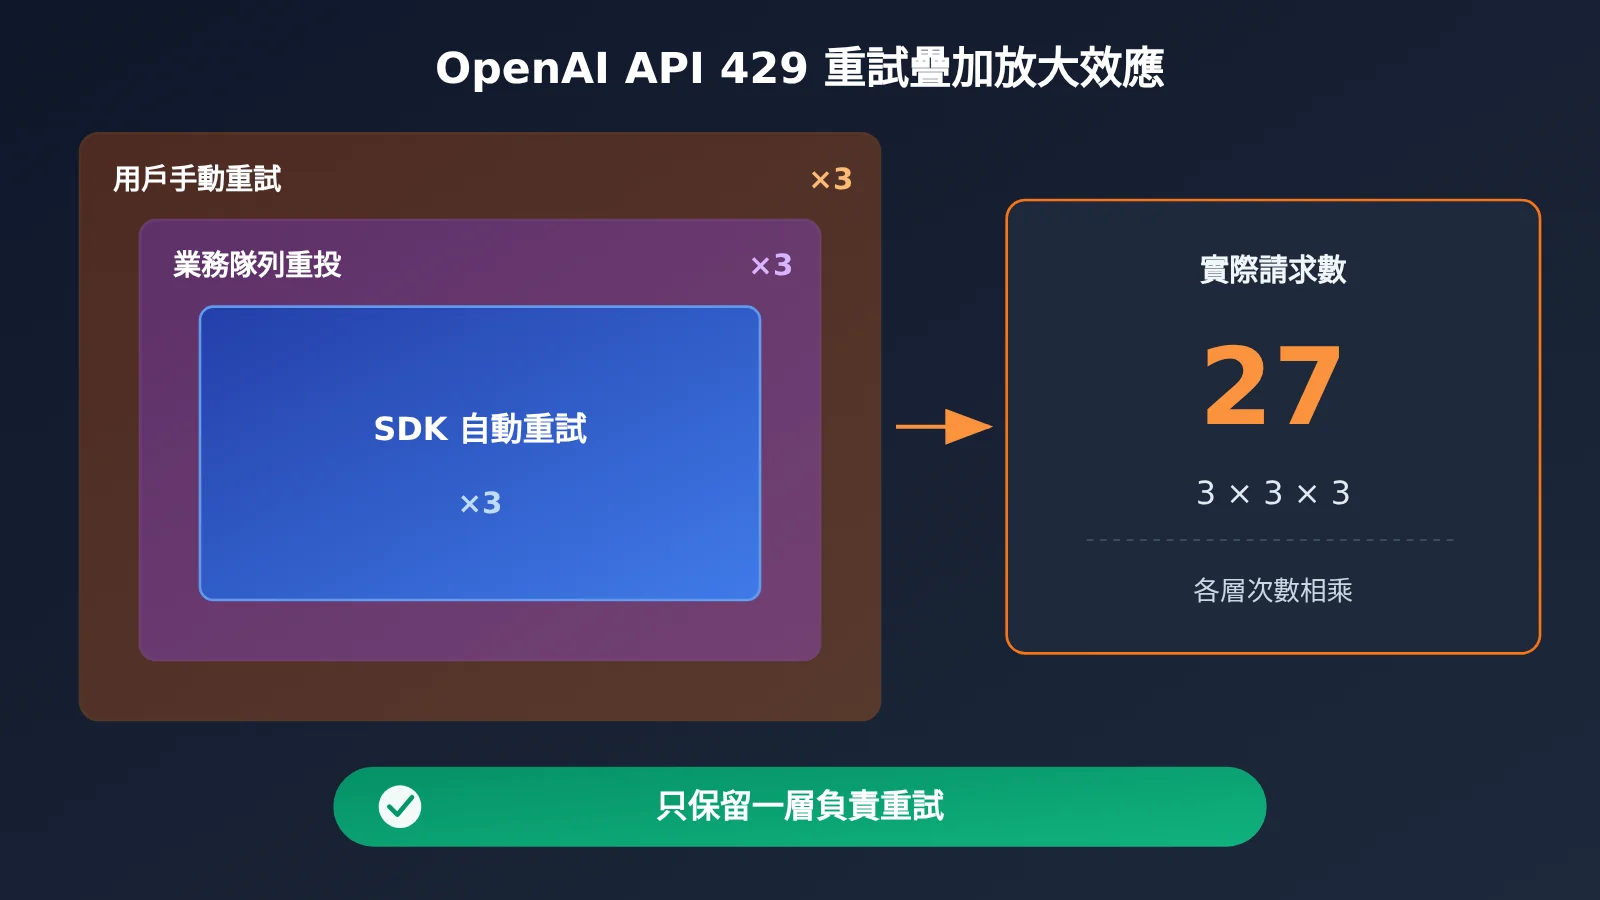
這意味着即使你的業務代碼裏一行重試邏輯都沒寫,請求也可能已經被重試過幾次。若業務層再包一層重試,實際請求次數就是兩者相乘。
流式請求中途出錯不能一律重放
官方文檔還提到一個容易被忽略的邊界:流式輸出一旦已經開始,之後發生的錯誤不能一律通過重放整個請求來處理。 用戶可能已經看到了部分內容,下游系統也可能已經消費了部分數據。直接重放會導致內容重複、前後不一致,還會重複消耗 token。
分析判斷:OpenAI API 429 在工程中該怎麼落地
以下內容是基於上述事實的工程判斷,不是 OpenAI 官方的原話。
一段可直接改造的 OpenAI API 429 退避示例
下面的示例體現了幾條原則:關閉 SDK 自動重試,由業務層統一負責;額度類錯誤直接拋出;優先遵循 Retry-After;沒有時使用帶完全抖動的指數退避;限制最大嘗試次數。
import random
import time
from openai import OpenAI, RateLimitError

# 關閉 SDK 自動重試,避免與下面的自定義重試疊加
client = OpenAI(max_retries=0)

# 等待無法解決的 429 類型(以實際返回和官方文檔爲準)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """解析 Retry-After 秒數;無效則返回 None。HTTP 日期格式可按需補充解析。"""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # 額度/計費類問題,交給賬戶處理流程
            if attempt == max_attempts - 1:
                raise  # 超過上限,交給隊列或告警
            wait = parse_retry_after(e.response)
            if wait is None:
                # 完全抖動:在 [0, 指數上限] 內隨機取值
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
示例中的 max_attempts、base、cap 都只是起點,不是推薦值。不同賬戶的限額等級不同,任務形態也不同,不存在一個適合所有賬號的統一併發數或重試次數,應根據自己的監控數據調整。
按瓶頸類型調整:請求數瓶頸和 token 瓶頸解法不同
退避只能解決“這一次怎麼等”,解決不了“爲什麼總是撞線”。要減少 429,得先弄清撞的是哪條線。
請求數瓶頸的關鍵是拉開提交節奏。在隊列入口做勻速放行,比如令牌桶或固定間隔發放,不要讓大量任務在同一秒湧出。批量任務啓動時也要錯峯,不要整點一起觸發。
token 瓶頸的關鍵是減小單次請求的體積。常見的浪費包括:每輪對話都完整帶上很長的系統提示和歷史記錄;同一份大文檔在多個請求裏反覆傳入;把整份材料塞給模型,而實際只需要其中一段。先做裁剪、摘要或檢索再提交,往往比調大重試次數有效得多。
隊列狀態要區分“等待重試”和“賬戶阻塞”
很多系統只有“排隊中”和“失敗”兩種狀態。遇到 429 時,這會造成兩種誤判:臨時限速被當成失敗而丟棄任務,額度問題被當成排隊而無限等待。
更合理的做法是把兩種 429 拆成兩個狀態,並給出不同的展示:
| 隊列狀態 | 觸發條件 | 應展示的信息 | 後續處理 |
|---|---|---|---|
| 等待重試 | 臨時速率限制 | 預計下次嘗試時間、已嘗試次數 | 到時自動重試,達到上限轉失敗 |
| 賬戶阻塞 | 額度、計費、組織使用限制 | 阻塞原因(如額度不足) | 暫停同賬戶的後續任務,通知負責人 |
| 失敗 | 超出重試上限或其他不可恢復錯誤 | 錯誤類型與原始信息 | 人工介入或業務降級 |
“賬戶阻塞”還有一個連帶效果。同一賬戶下的其他任務大概率也會遇到同樣的 429,此時應整體暫停,而不是讓每個任務各自撞一次。
排查重試疊加:SDK、隊列、人工按鈕
如果你發現 429 越重試越多,第一件事是檢查是否有多層重試同時生效。典型鏈路是:SDK 自動重試數次,業務隊列在任務失敗後再重新投遞數次,前端用戶看到報錯又手動點了“重試”。三層相乘後,一個原始請求可能變成十幾次實際請求,而且這些請求往往集中在限速窗口內,正好加劇限速。
排查時建議逐層確認:
- SDK 層:確認
max_retries的實際取值,不要依賴記憶中的默認值。 - 隊列層:確認任務失敗後是否會自動重新投遞,以及重投是否有退避。
- 交互層:確認“重試”按鈕在等待期間是否禁用,並顯示下次嘗試時間。
- 日誌層:爲每個原始任務分配唯一 ID,統計它實際發出了多少次請求。
原則很簡單:同一條鏈路上只保留一層負責重試,其他層只負責傳遞狀態。
流式場景要單獨設計 OpenAI API 429 的恢復策略
流式請求在建立連接、尚未輸出任何內容時遇到 429,可以按普通請求處理。一旦已經開始輸出,就應該把“是否重放”交給業務決定。例如,向用戶明確提示生成中斷,由用戶選擇重新生成;或者丟棄已輸出的部分並整體替換。不要在後臺靜默重放,導致界面上出現兩段重複內容。
遷移到其他平臺時,不要照搬 OpenAI 的 429 語義
本文所述的錯誤分類、error.code 取值、Retry-After 行爲和響應頭,都是 OpenAI 官方 API 的語義。如果你通過第三方網關、中轉或聚合平臺(例如 API易)調用模型,對方的錯誤碼、限流維度和重試建議需要以該平臺自己的文檔爲準,另行覈實,不能直接照搬 OpenAI 的行爲。比較穩妥的做法是在接入層做一層錯誤歸一化,把不同來源的 429 映射到本文所說的“等待重試 / 賬戶阻塞 / 失敗”三類狀態,再交給統一的重試模塊處理。
值得持續關注的變化
OpenAI 的錯誤碼文檔和速率限制文檔都在持續維護。限額等級、計量維度、響應頭字段都有可能調整。建議在代碼中保留錯誤原文日誌,定期對照官方文檔複覈判斷邏輯。另外,不要把“所有 429 都能靠等待解決”寫進任何默認配置。這條假設一旦在額度耗盡時生效,代價就是一整晚空轉的任務隊列。
429 本質上是服務端在說“慢一點”,有時還在說“這條路暫時走不通”。分清是哪一種,再決定是等、是改,還是停,比任何精巧的重試算法都重要。正如《論語·子路》所言:
“無慾速,無見小利。欲速則不達,見小利則大事不成。”