
摘要:從模型、編程代理和 API 渠道三層對比國內可用組合,再用真實編程任務、費用和兼容性選出適合自己的復現方案。
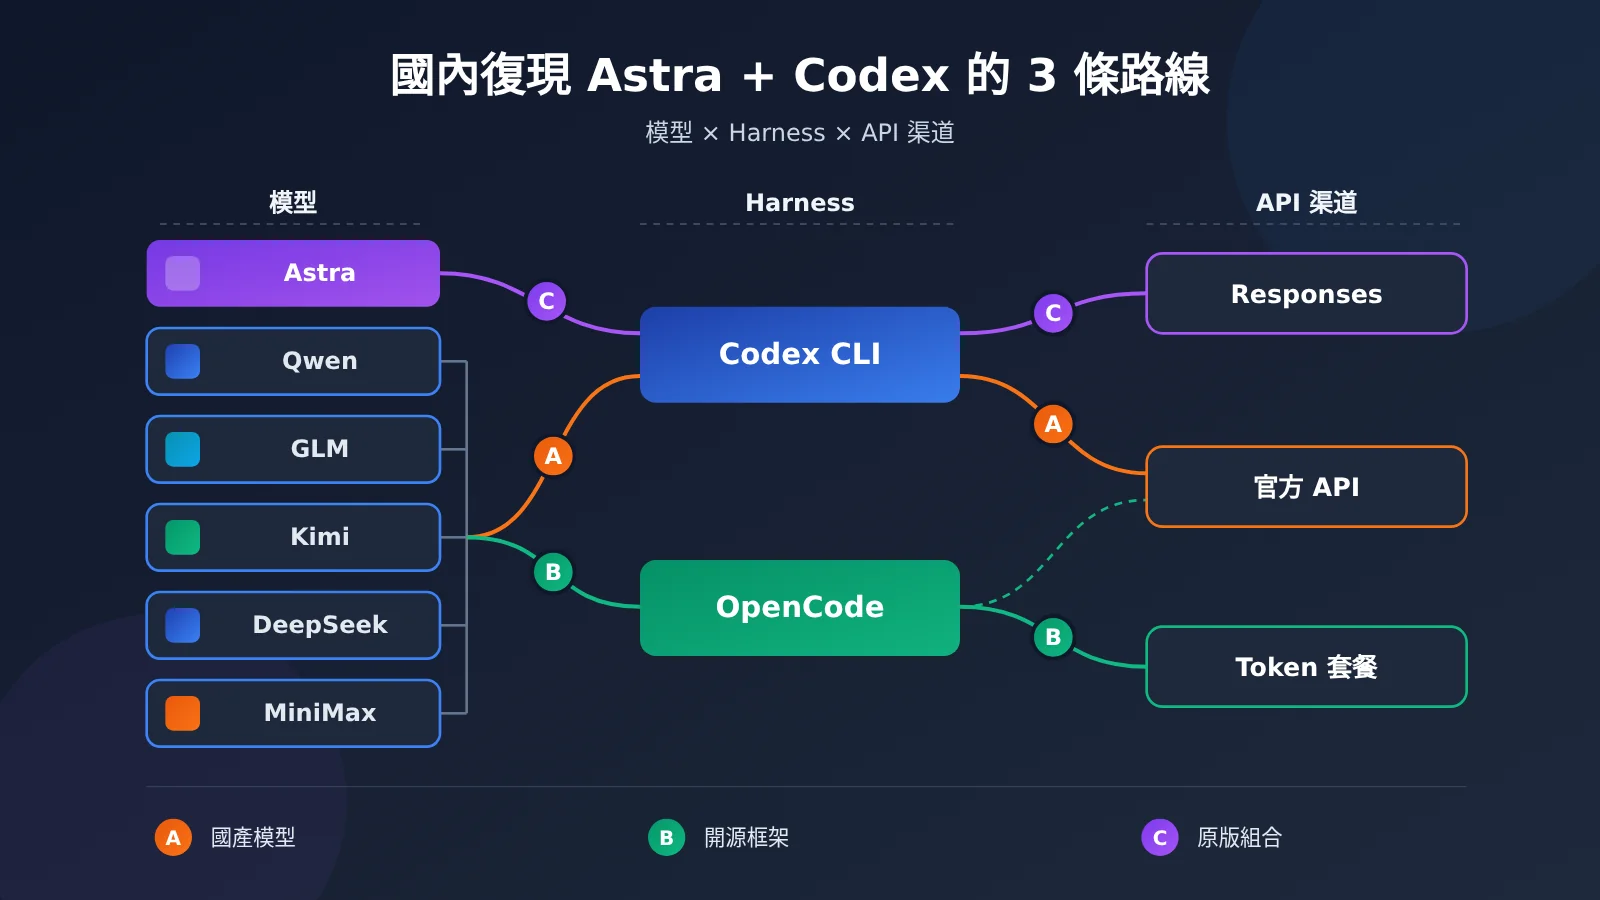
國內最大程度復現 Astra + Codex,有三條值得測試的路線。路線 A:保留原版 Codex CLI,通過阿里雲百鍊或騰訊雲 TokenHub 的 Responses 兼容接口接入國產旗艦模型,這條路線保住了 Codex 的執行體驗。路線 B:改用 OpenCode 等開放 Harness 接入多家國內模型,這條路線換來最大的模型選擇自由。路線 C:在合法合規、服務實際可用的前提下,保留 GPT-6 Astra 模型,通過完整支持 Responses 協議的 API 渠道接入原版 Codex,這條路線對原始組合的還原度最高。
如果要求模型國產化,路線 A 是起點,其中 Qwen4-Max-Preview 只開放到 2026 年 11 月 25 日 24:00,適合測評而不適合做唯一的長期依賴。如果只要求在國內網絡環境下使用、不要求模型國產化,路線 C 在模型智能上最接近原版。三條路線之間的最終取捨,應當由同一批真實編程任務的成功率、耗時、費用和工具兼容性來決定,而不是由榜單或 Token 單價決定。
下文先把 Astra + Codex 拆成五個能力組件,說明“復現”到底復現什麼;然後分別給出路線 A 的兩套官方接入配置與套餐對照、路線 B 的四款 Harness,以及值得優先測試的國產模型;接着用一張總表收攏三條路線的取捨;最後給出一套可復現的五類任務測試方法,把“單次成功任務成本”作爲選型的核心指標。
To Know:術語預備知識
| 術語 | 解釋 |
|---|---|
| GPT-6 Astra | OpenAI 的旗艦推理模型,定位複雜推理、軟件工程和長程 Agent 任務,模型 ID 爲 gpt-6-astra。 |
| Codex | OpenAI 的編程代理,能讀取項目、修改代碼、執行命令並驗證結果。 |
| Harness | 把模型決策連接到真實工具的執行框架,負責工具循環、上下文、權限和失敗恢復。 |
| Responses API | OpenAI 支持模型輸出、推理和工具調用的接口協議,新版 Codex 依賴它運行。 |
| Chat Completions | OpenAI 較早的對話接口協議,舊版 Codex 使用它。 |
| Provider | 給 Agent 工具提供模型服務的供應商,在配置文件中表現爲一組接入參數。 |
| Base URL | 模型服務 API 的基礎訪問地址,切換渠道時主要改的就是它。 |
| Token Plan | 雲廠商按月套餐提供模型調用額度的計費方案。 |
| Credits / 積分 | 套餐內用於扣減調用額度的計量單位,不同廠商的單位不可直接互換。 |
| 上下文窗口 | 模型一次請求能處理的內容上限,以 Token 計。 |
| 推理檔位 | 控制模型思考深度的參數,Astra 提供 low 到 max 五檔。 |
| 緩存命中 | 重複發送的輸入被服務端複用,按更低費率計費。 |
| MCP | 連接模型應用與外部工具、數據源的開放協議。 |
| Function Calling | 模型輸出結構化調用請求、由應用執行函數並回傳結果的機制。 |
| 峯谷計費 | 按時段區分價格,高峯時段消耗更多額度。 |
正文
1 Astra + Codex 到底強在哪裏?
1.1 Astra 提供了什麼
GPT-6 Astra 是 OpenAI 的旗艦推理模型,官方定位覆蓋複雜推理、軟件工程、多步驟代碼修改、瀏覽器與計算機操作、研究分析和專業文檔生產。它爲 Codex 提供的是“判斷力”:理解陌生代碼庫、設計改動方案、讀懂報錯並調整策略。
官方模型規格(資料覈對日期 2026-11-13)如下:
- 上下文窗口:1,050,000 Token;最大輸出:128,000 Token。
- 推理檔位:low、medium、high、xhigh、max。
- 標準價格(美元 / 百萬 Token):輸入 $10,輸出 $50,緩存輸入 $1,30 分鐘緩存寫入 $12.50;輸入超過 272K Token 時適用更高的長上下文費率。
- Responses API 工具:Web Search、File Search、Hosted Shell、Apply Patch、Computer Use、MCP 等。
最後一項需要單獨理解:這些工具是 OpenAI 平臺提供的能力,某個客戶端或第三方網關能否用上,取決於它實際集成了哪些工具。
1.2 Codex 負責完成哪些任務
OpenAI 在 2026 年 8 月公佈的 Codex Harness 文章中,把 Codex 的核心概括爲 Agent 循環、代碼庫理解與文件操作、命令執行、工具調用與結果回傳、多輪上下文管理、用戶審批、沙盒安全邊界,以及執行過程觀察與失敗恢復。
分工很清楚:模型負責判斷與生成,Harness 負責把模型的決策落到真實的文件系統和終端上。一個很強的聊天模型,只有配上這套執行系統,才能完成“讀項目 → 改代碼 → 跑測試 → 修失敗 → 再驗證”的完整編程任務。
1.3 要復現的是模型,還是整個 Agent
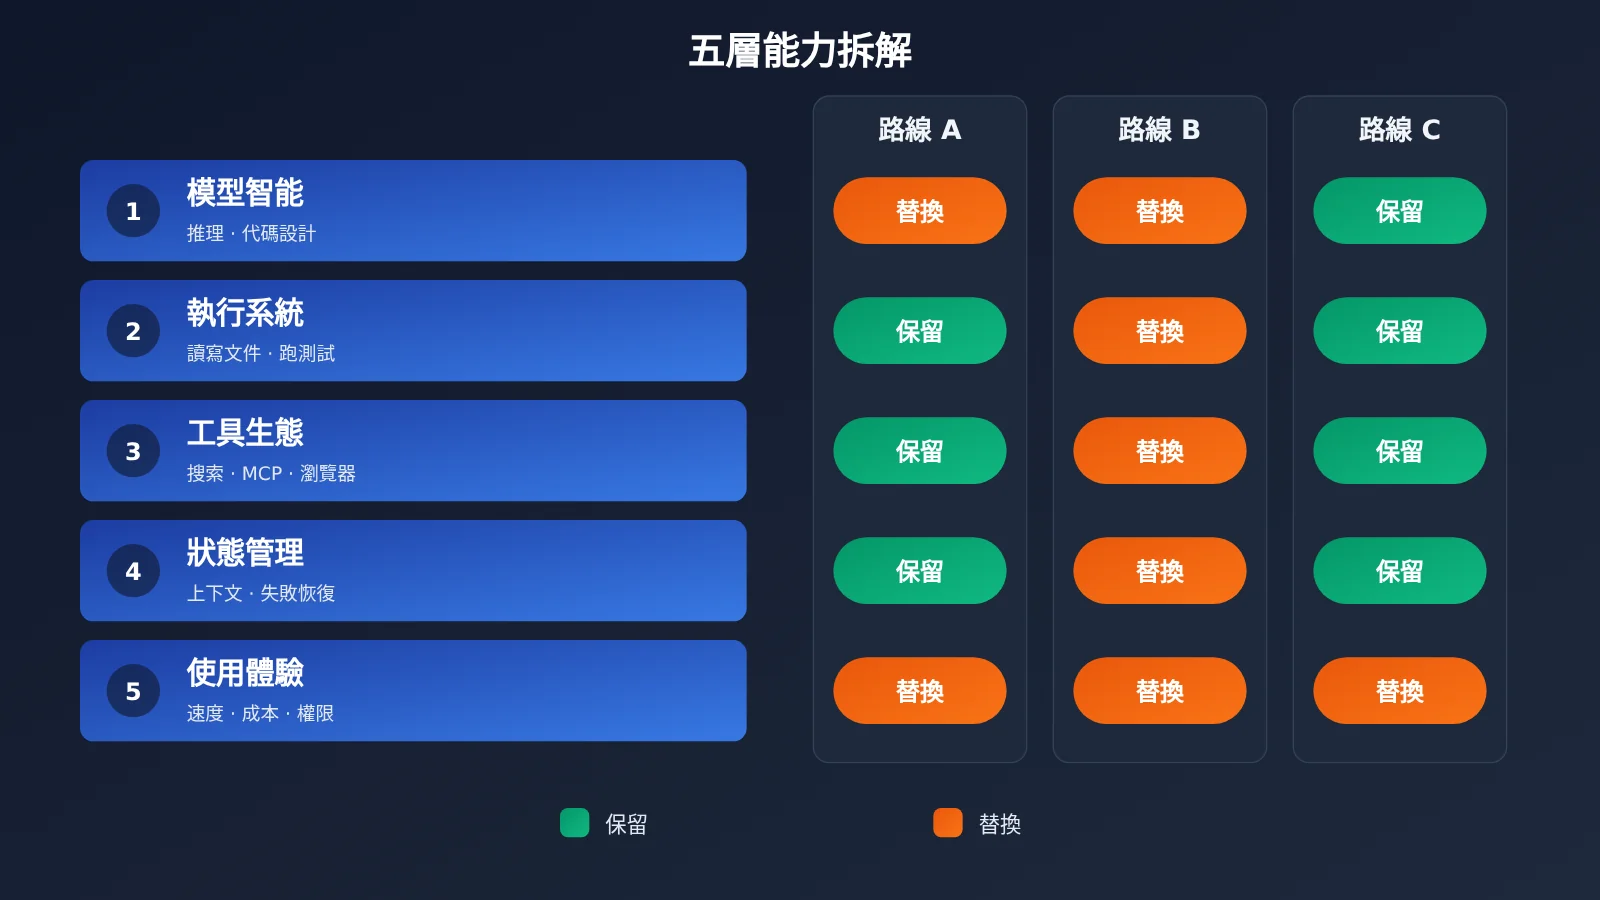
把原始體驗拆開,可以得到五個組件:
- 模型智能:複雜任務理解、代碼設計、推理與調試。
- 執行系統:讀取項目、編輯文件、執行命令、運行測試。
- 工具生態:聯網搜索、網頁讀取、MCP、文件處理、瀏覽器操作。
- 狀態管理:長任務上下文、工具調用循環、失敗恢復。
- 使用體驗:響應速度、穩定性、成本、權限控制和操作便利性。
更換模型主要改變第 1 項,但用戶最終感受到的是五項的總和。這也是三條路線的分界:路線 A 換掉第 1 項、保留第 2 和第 4 項;路線 B 同時更換第 1、2、4 項;路線 C 儘量保留第 1、2、4 項,差異集中在第 5 項和 API 渠道帶來的協議細節上。
2 保留 Codex,接入國產模型(路線 A)
2.1 阿里雲百鍊 Token Plan + Codex
阿里雲已發佈 Codex 官方接入文檔,Token Plan 提供 Responses 兼容接口,可以直接連接新版 Codex。在 ~/.codex/config.toml(Windows 一般爲 C:\Users\<用戶名>\.codex\config.toml)中寫入:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
env_key 指向的環境變量裏要放 Token Plan 的套餐專屬 API Key。配置時有幾個容易踩坑的技術細節:
- 協議版本:Codex 從 0.94.0 起要求 Responses API。阿里雲舊版 Coding Plan 使用 Chat Completions,官方要求搭配 Codex 0.93.0 或更早版本;長期維護的環境應選 Token Plan。
- Key 隔離:Token Plan、Coding Plan 和按量計費使用三套不同的 API Key。
- 地域:Token Plan 目前僅支持華北 2(北京)。
- 模型元數據:新模型需要正確配置模型 ID 和元數據,才能在 Codex 的模型選擇界面獲得完整支持。
百鍊當前最值得關注的是 2026 年 11 月 11 日上線的 Qwen4-Max-Preview(模型 ID qwen4-max-preview)。官方文檔確認它是新一代旗艦多模態模型,支持代碼開發、複雜智能體任務、圖片與視頻理解,支持深度思考(默認開啓)、工具調用、聯網搜索和結構化輸出,兼容 OpenAI Chat Completions、Responses 和 Anthropic Messages 三種協議。上下文長度 1M Token,最大輸出預算 393,216 Token,思考與最終回答共享這一預算。
它的使用條件同樣明確:目前僅在 Token Plan 中提供,不支持按量付費;預覽期爲北京時間 2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00,結束後下線。截至本文日期,剩餘可測試時間不到兩週,適合抓緊做測評,生產環境應同時準備好替代模型。
2.2 騰訊雲 TokenHub + Codex
騰訊云爲 Codex CLI 提供了專門的官方接入教程,同一個配置文件寫法如下:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id 需要替換成套餐當前支持的精確模型 ID。TokenHub 的模型庫包括 GLM-5.3、Kimi K3、DeepSeek V4 系列、MiniMax M3、騰訊混元 Hy 系列以及部分輕量和自動路由模型,同一套餐還支持 Claude Code、Cline、OpenClaw 等工具。
TokenHub 的優勢在於“一套 Codex 配置、多個國產模型”:改一行 model 就能讓同一個 Harness 依次跑 GLM、Kimi、DeepSeek 和 MiniMax,非常適合做橫向對比。模型庫存、版本和額度政策會動態調整,每次測試前應以控制檯列出的模型 ID 爲準。
2.3 兩套套餐有什麼差異
兩家都叫 Token Plan,但計量單位不同:百鍊用 Credits,TokenHub 用 積分,兩者無法直接換算。下表數據截至 2026-11-13,價格單位均爲人民幣 / 月:
| 對比維度 | 阿里雲百鍊 Token Plan(個人版) | 騰訊雲 TokenHub 通用 Token Plan(個人版) |
|---|---|---|
| 檔位與月費 | Lite ¥39、Essential ¥79、Standard ¥139、Pro ¥312 | Lite ¥39、Standard ¥99、Pro ¥299、Max ¥599 |
| 月度額度 | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 積分 |
| 建議併發 Agent | 1—2 / 2—3 / 3—4 / 6—8 | 文檔未給出同類指標 |
| 優惠與權益 | Lite、Essential 新用戶首購 ¥19.5、¥39.5(至 2026-11-30);Standard、Pro 附 AgentStudio Harness 權益 | 部分模型限時優惠抵扣費率;購買積分參考 ¥1 = 20 積分 |
| Codex 接入協議 | Responses(wire_api = "responses") |
Responses(wire_api = "responses") |
| 代表模型 | Qwen 系列,含僅限 Token Plan 的 Qwen4-Max-Preview | GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3、混元 Hy |
| 計量方式 | Credits 按模型扣減 | 2026-08-31 起積分抵扣,模型間速率不同 |
| 使用限制 | 僅華北 2(北京);交互式編程套餐不應直接用於任意商業後端自動化 | 模型庫與優惠活動可能調整 |
比較這兩份套餐時,月費排序意義不大,關鍵是“我要用的那個模型,在這個套餐裏每完成一個任務扣多少額度”。百鍊的價值集中在 Qwen 生態和當前獨佔的 Qwen4-Max-Preview;TokenHub 的價值集中在多家國產模型共用一份額度。
TokenHub 公開了各模型的積分抵扣費率。以下爲 2026-11-13 查詢到的部分限時優惠費率,已按 ¥1 = 20 積分換算爲人民幣 / 百萬 Token:
| 模型 | 普通輸入 | 輸出 | 緩存命中輸入 | 備註 |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | 優惠結束恢復刊例價 |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | 速度與成本敏感場景 |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | 優惠結束恢復刊例價 |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | 代碼定向型號 |
| DeepSeek V4.1 Flash(空閒) | ¥0.40 | ¥1.60 | ¥0.008 | 峯谷計費 |
| DeepSeek V4.1 Flash(高峯) | ¥0.80 | ¥3.20 | ¥0.016 | 工作日 09:00—12:00、14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | 輸入 ≤ 512K Token 的價格 |
這張表要配合兩點理解。第一,包月訂閱按套餐月費收費,表中金額是積分的參考價值,用來比較模型之間的消耗速率。第二,DeepSeek 峯谷計費自 2026 年 10 月 30 日起實施,高峯消耗約爲低峯的兩倍,夜間批量跑代碼檢查、測試分析這類異步任務能明顯節省配額。
用 GLM-5.3 做一次演算:一個大型代碼任務累計消耗普通輸入 100,000 Token、緩存命中 300,000 Token、輸出 30,000 Token,對應 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232 的參考積分價值。緩存命中佔了輸入的大頭,這正是 Agent 任務的典型形態,也說明緩存費率對編程場景的總成本影響很大。
3 換一個 Harness,能否更接近 Astra + Codex?(路線 B)
3.1 OpenCode:重點是多模型自由
OpenCode 是開源 AI Coding Agent,支持大量 LLM Provider:用 /connect 添加服務商,用 /models 切換模型,支持自定義 Base URL 和本地模型,可在終端、桌面和部分開發環境中使用,具備文件檢索、修改、命令執行和 Agent 工作流能力。阿里雲已提供官方接入說明,選擇 Alibaba Token Plan (China) 即可使用百鍊套餐。
OpenCode 的官方安全說明值得認真對待:默認的本地 Agent 沒有系統級安全隔離,權限審批無法替代容器或虛擬機。運行不可信代碼或高權限自動化任務時,應放進 Docker 或虛擬機裏執行。
3.2 Qwen Code、Kimi Code 與 DeepSeek Harness
三款原生 Harness 各自服務於對應的模型生態:
- Qwen Code:阿里雲提供 CLI、桌面和 IDE 三種形態,登錄百鍊、選擇地域、輸入 API Key 即可接入,具備代碼庫檢索、文件編輯和命令執行。主要使用千問模型、希望減少協議適配的團隊優先考慮。
- Kimi Code CLI:月之暗面維護的終端編碼工具,支持讀改代碼、調用 Shell、網頁內容獲取、會話恢復、計劃與審批模式、編輯器集成,也能配置第三方兼容模型。Windows 通過官方 PowerShell 腳本安裝,依賴 Git for Windows 的 Git Bash;舊版 Kimi CLI 已於 2026 年 9 月結束維護,新用戶直接用 Kimi Code CLI。
- DeepSeek Harness:同時提供 Web UI 和 CLI 的開源 Agent 框架,支持自定義 Provider 和工具配置,可對接百鍊不同計費方案。通過
npx @deepseek-ai/dsh web啓動,默認地址爲http://127.0.0.1:3080。選它時重點考察工具執行穩定性、權限控制和對目標模型協議的適配。
3.3 Harness 爲什麼會影響模型表現
同一個模型放進不同 Harness,結果差異可能很大,原因在於 Harness 決定了模型“看到什麼、能做什麼、錯了之後怎麼辦”:
- 代碼讀取策略:一次讀入多少文件、按什麼順序檢索,決定模型對項目的理解是否完整。
- 工具循環設計:工具結果如何回傳、失敗後是否自動重試,決定長任務能否跑完。
- 上下文壓縮:長會話中保留哪些歷史、丟棄哪些細節,直接影響模型是否“忘記目標”。
- 補丁與測試:用整文件覆蓋還是 diff 補丁、是否默認在修改後運行測試,決定改動的準確率和迴歸風險。
所以路線 B 測出來的成績,是“模型 + 該 Harness”的組合成績。拿它和路線 A 比較時,應當記住兩邊的執行策略本身就不同。
4 國內值得測試的模型有哪些?
4.1 Qwen4-Max-Preview
從公開規格看,1M 上下文、393,216 Token 的思考與輸出共享預算、工具調用和結構化輸出,使它適合測試複雜編碼、長上下文分析和多輪 Agent 工作流。它同時兼容 Responses 和 Anthropic Messages,能接入 Codex,也能接入 Claude Code 類工具。
時間窗口是選它的首要約束:預覽於 2026-11-25 24:00 結束並下線。推薦做法是在這段時間內用它跑完整套測試任務,把結果作爲後續正式版 Qwen 模型的參照,生產環境同時配置一個長期可用的備選模型。
4.2 GLM-5.3、Kimi K3、DeepSeek V4、MiniMax M3
這四個系列都在 TokenHub 一個套餐內,按任務類型分配最省事:
- 複雜邏輯與多文件修改:GLM-5.3、Kimi K3、DeepSeek V4-Pro 作爲高能力組對照。Kimi K3 輸出單價在表中最高,適合放在最難的任務上檢驗上限。
- 代碼定向任務:Kimi K2.7 Code 專門對照代碼修改場景,也可以搭配 Kimi Code CLI 測原生體驗。
- 高頻低成本任務:GLM-5.3-Flash、DeepSeek V4-Flash 用於代碼檢查、批量重構等成本和速度敏感的場景。
- 長上下文穩定性與工具調用準確率:MiniMax M3 納入候選,注意 512K 輸入閾值以上價格上升。
4.3 如何判斷誰最接近 Astra
上下文長度、參數量、宣傳定位和 Token 單價都無法給模型排出可靠的名次,不同來源的宣傳跑分也缺乏可比性。判斷“誰最接近 Astra + Codex”,唯一可靠的辦法是在同一個 Harness、同一批任務上,統一記錄任務成功率、執行時間、Token 成本、工具兼容性和人工干預次數,具體方法見第 6 節。
5 三條復現路線,具體應該怎麼選?
5.1 要原版 Codex 操作體驗:選路線 A
保留 Codex Harness,接入正式支持 Responses 協議的國內服務。主力用 Qwen 選百鍊,想在多個國產模型間切換選 TokenHub。優點是學習和遷移成本低,文件操作與 Agent 執行體系都是原版;取捨是模型智能與 Astra 存在差異,兼容接口的實現程度會影響工具調用體驗,各模型的上下文和推理參數需要分別調。
5.2 要國產模型和多模型自由:選路線 B
OpenCode 搭配國內多模型 API,必要時補充 Qwen Code、Kimi Code 或 DeepSeek Harness。它最適合長期使用多模型、不希望綁定單一廠商的開發者,也最方便橫向比較不同模型處理同一任務的表現。代價是執行策略與 Codex 不同,多 Provider 接入帶來額外的配置和維護工作。
5.3 要最大程度保留 Astra 能力:選路線 C
路線 C 的組合是“原版 Codex CLI + GPT-6 Astra + 可用的 API 接入服務”。只要渠道確實提供原版 GPT-6 Astra,並完整支持 Codex 所需的 Responses API、流式事件、工具調用和上下文管理,就能同時保留模型和 Harness 兩個核心組件。這條路線解決的是網絡可用性,它和國產模型替代是兩件事。
以 API易 爲例,接入方式與路線 A 完全一致,只需換一組 Provider 配置:
model_provider = "APIYI"
model = "gpt-6-astra"            # 以 API易 控制檯實際列出的模型 ID 爲準
model_reasoning_effort = "high"  # 按任務難度在 low ~ max 之間調整

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
接入前建議先用一段腳本確認渠道真實支持 Responses 協議和工具調用,而不是隻能返回普通文本:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # 替換爲控制檯中可用的模型 ID
    reasoning={"effort": "medium"},
    input="讀取 src/app.py 並告訴我入口函數名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "讀取項目中的文件內容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# 正常情況下應返回 function_call 類型的輸出項,並帶有結構化參數
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # 覈對輸入、輸出、緩存與推理 Token 是否分項統計
這段探測覆蓋了 Codex 最依賴的三件事:Responses 協議、Function Calling 回傳、用量分項統計。腳本通過後再接入 Codex,跑一個包含“改代碼 + 運行測試”的完整任務,確認流式事件和多輪工具循環正常。
即便模型相同,路線 C 的體驗仍受實際模型路由、推理檔位、API 延遲與輸出吞吐、緩存命中、網關協議兼容性和渠道費用影響。Codex 桌面端、雲端任務和 ChatGPT 賬戶專屬功能依賴 OpenAI 自身的授權體系,通過 API Key 使用的是 Codex CLI 加模型 API 的組合,規劃時應把這部分功能排除在外。
🚀 快速上手建議:想在路線 A 和路線 C 之間做對照,可以在 API易 apiyi.com 註冊並領取免費測試額度,用同一個 Codex 環境分別跑國產模型和 GPT 系列模型。API易 的具體模型上架情況和協議支持,以控制檯和 docs.apiyi.com 文檔爲準。
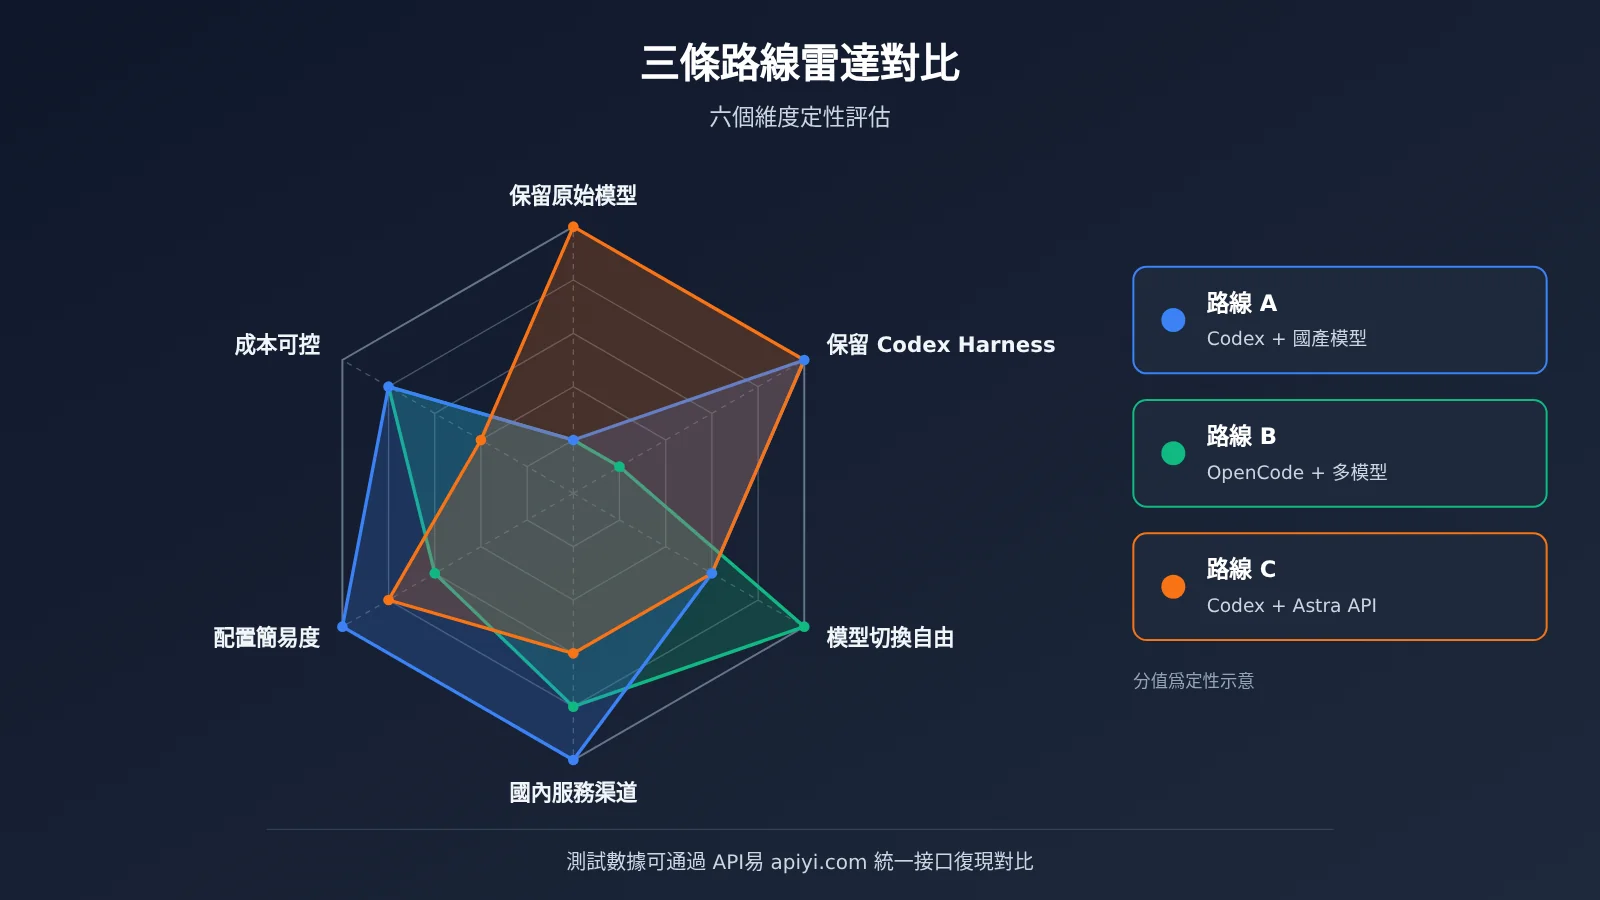
三條路線的取捨彙總如下:
| 對比維度 | 路線 A:Codex + 國產模型 | 路線 B:OpenCode 等 + 國內多模型 | 路線 C:Codex + Astra API |
|---|---|---|---|
| 保留原始模型 | 否,換爲 Qwen / GLM / Kimi 等 | 否 | 是(以渠道可驗證爲前提) |
| 保留 Codex Harness | 是 | 否,換爲開放 Harness | 是 |
| 模型切換 | 同一平臺內改模型 ID | 多 Provider 自由切換 | 渠道支持的模型間切換 |
| 國內服務渠道 | 阿里雲百鍊、騰訊雲 TokenHub | 百鍊、TokenHub 及其他兼容服務 | 支持 Responses 的第三方渠道,如 API易 apiyi.com |
| 配置複雜度 | 低,官方給出現成配置 | 中,需維護多套 Provider | 低,前提是先驗證協議 |
| 成本形態 | 包月套餐(Credits / 積分) | 套餐或按量,視 Provider 而定 | 按量計費,Astra 單價高於多數國產模型 |
| 適合需求 | 原版 Codex 體驗 + 模型國產化 | 長期多模型工作流 | 最大限度保留原始能力 |
5.4 國內使用的網絡與安全邊界
模型 API 走國內可訪問地址,只解決了模型調用這一段鏈路。Agent 在工作中還會訪問 GitHub、npm 和 PyPI 等軟件源、外部官方文檔、第三方 MCP 服務和網頁搜索,這些鏈路的可達性需要單獨確認。聯網搜索也是獨立能力:雲廠商的內置搜索、Harness 自帶的聯網工具和自建 Search API / MCP 各有訪問、計費和調用限制。
安全上,編程 Agent 能修改文件、運行 Shell、讀取環境變量,建議做到以下幾點:
- API Key 存進環境變量或憑據管理工具,絕不寫進源碼和 Git 倉庫。
- 複雜修改在獨立 Git 分支上進行,項目保留版本控制和可恢復備份。
- 限制 Agent 訪問工作目錄之外的敏感文件,不可信代碼放進容器或虛擬機。
- 刪除、部署、付費等高風險操作保留人工審批。
6 真實任務測試比模型榜單更有價值
6.1 設置五類測試任務
用一個包含前端、後端、測試和依賴配置的真實項目,設計五類任務,分別檢驗模型能力和 Harness 能力:
- 項目理解:要求說明架構和關鍵模塊關係,觀察文件定位、跨文件依賴理解,以及能否給出可驗證的路徑引用。
- 跨文件開發:增加一個需要改動多處的新功能,觀察修改準確性、功能完整性和是否引入迴歸。
- Bug 修復:提供帶可復現失敗測試的項目,觀察是否找到根因、改對位置、主動運行測試且不破壞其他用例。
- 長程 Agent 工作流:完成“需求理解 → 代碼修改 → 運行測試 → 發現失敗 → 修復 → 複驗”的連續鏈路,觀察是否保持目標、能否根據報錯調整策略。
- 聯網文檔查閱:閱讀最新 SDK 文檔後遷移一段舊 API 代碼,觀察能否實際聯網抓取正文、是否把新 API 落實到代碼,以及能否區分“工具不可用”和“檢索結果爲空”。
6.2 記錄成功率、耗時與成本
每個“模型 + Harness”組合都跑同一套任務,至少重複三次取平均,並統一記錄以下指標:
| 指標 | 計算或觀察方式 |
|---|---|
| 任務成功率 | 成功完成任務數 / 總任務數 |
| 首次通過率 | 無人工修正、一次成功的比例 |
| 總任務耗時 | 從發出任務到最終驗證成功 |
| 模型調用次數 | 每個任務累計的 API 請求數 |
| 工具調用次數 | 讀取、編輯、Shell、搜索等調用次數 |
| Token 用量 | 輸入、輸出、緩存命中及推理用量分項 |
| 實際任務成本 | 完成一個成功任務的真實費用 |
| 人工干預次數 | 用戶手動調整和修復的次數 |
爲了讓實驗可復現,固定以下變量:同一份代碼倉庫快照、同一版本的 Harness、同一推理檔位或思考設置、同一時段(對 DeepSeek 這類峯谷計費模型尤其重要)。每次任務開始前把倉庫重置到快照,避免上一輪的修改影響下一輪。
6.3 以一次成功任務的成本作爲核心採購指標
推薦的計算方式是:單次成功任務成本 = 全部嘗試的總費用 ÷ 成功任務數。失敗嘗試的費用必須計入,因爲它們同樣消耗了額度。
單價低的模型未必便宜。一個模型如果需要更多輪推理、反覆修改和重試,或者頻繁需要人工介入,它完成一個任務的總消耗可能超過單價更高、一次就能做對的模型。反過來,在簡單、高頻的任務上,Flash 級模型的低單價和高速度往往能帶來實實在在的節約。把成本算到“每個成功任務”上,兩類模型才能放在同一把尺子上比較。
💰 成本評估建議:按量計費的渠道最便於做這類實驗,因爲每次請求的 Token 分項和費用都能逐筆覈對。通過 API易 apiyi.com 用一個 Key 調用多個模型,可以把不同模型的賬單放在同一個後臺裏統計單次成功任務成本。
7 API易 場景:讓模型成爲可替換組件
前面的分析指向同一個結論:穩定的 AI 編程環境,應當把 Harness 固定下來,把模型當作可替換的組件。Codex 或 OpenCode 負責執行與狀態管理,API 渠道負責提供模型,模型按任務難度和預算靈活切換。
API易 apiyi.com 在這套架構裏承擔的是統一接入層:一個 API Key 調用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 協議,按量計費。對編程用戶來說,選擇任何一個 API 渠道(包括 API易)之前,都建議逐項覈對以下內容:
- 是否支持當前 Codex 版本要求的 Responses API 與流式事件。
- 控制檯列出的真實模型 ID,以及目標模型是否在架。
- 工具調用和 Function Calling 能否完整往返。
- 延遲和持續輸出速度是否滿足長任務需要。
- 緩存用量是否被正確識別和分項計費。
這些信息以服務控制檯和技術文檔爲準,第 5.3 節的探測腳本可以直接用來驗證。實際落地時,常見做法是把路線 A 的包月套餐用於日常高頻任務,把按量渠道用於需要更強模型的難題和對比測試,兩套 Provider 寫在同一個 config.toml 裏,用 --profile 或修改 model_provider 切換。
8 常見問題
Q1:國內復現 Astra + Codex,哪條路線還原度最高?
還原度最高的是路線 C:原版 Codex CLI 搭配真實可用的 GPT-6 Astra API,模型和 Harness 兩個核心組件都得到保留。前提是渠道能被驗證提供原版模型,並完整支持 Responses 協議與工具調用。如果要求模型國產化,路線 A 是還原 Codex 執行體驗的最佳選擇。
Q2:Qwen4-Max-Preview 適合長期用在 Codex 裏嗎?
它適合當前測評。該模型僅在百鍊 Token Plan 中提供,預覽期到 2026 年 11 月 25 日 24:00 結束後下線。建議趁預覽期跑完測試任務,同時爲生產環境準備一個長期可用的備選模型。
Q3:爲什麼新版 Codex 連不上阿里雲舊版 Coding Plan?
Codex 從 0.94.0 起要求 Responses API,而舊版 Coding Plan 使用 Chat Completions 協議,官方要求搭配 Codex 0.93.0 或更早版本。改用 Token Plan 並設置 `wire_api = “responses”` 即可連接新版 Codex,注意 Token Plan 使用獨立的 API Key。
Q4:百鍊的 Credits 和 TokenHub 的積分能直接比較嗎?
不能直接比較。兩者是各自平臺的計量單位,模型間扣減速率也不同。更可靠的做法是用同一個任務分別在兩邊運行,比較“完成一個成功任務消耗的套餐額度佔月費的比例”。
Q5:如何快速驗證一個第三方渠道能否跑 Codex?
先用第 5.3 節的 Python 腳本發一次帶 function 工具的 Responses 請求,確認返回 `function_call` 輸出項且用量分項統計正常,再接入 Codex 跑一個包含測試的完整任務。在 API易 apiyi.com 註冊後可以領取免費測試額度完成這一步驗證,具體可用模型以控制檯爲準。
Q6:同一個模型在 OpenCode 和 Codex 裏表現不同,正常嗎?
正常。Harness 決定了代碼讀取策略、工具循環、上下文壓縮和測試習慣,這些都會改變模型的實際表現。對比時應固定 Harness 測模型,或固定模型測 Harness,避免兩個變量同時變化。
Q7:通過 API Key 使用 Codex,能獲得 ChatGPT 訂閱裏的 Codex 功能嗎?
API Key 方式提供的是 Codex CLI 加模型 API 的組合。Codex 雲端任務、桌面端和 ChatGPT 賬戶專屬功能依賴 OpenAI 的賬戶授權,第三方 API 渠道無法提供這部分權益。
Q8:多模型切換時,怎麼控制總成本?
按任務分層:難題用高能力模型,批量檢查和簡單重構交給 Flash 級模型,支持峯谷計費的模型把異步任務放到夜間。統一用“單次成功任務成本”評估,按量渠道如 API易 apiyi.com 便於逐筆覈對每個模型的實際消耗。
9 總結:Key Takeaways
- 三條路線三種側重:路線 A 保 Codex 體驗,路線 B 保模型自由,路線 C 保原始模型。
- Astra + Codex 是五層組合:模型、執行系統、工具生態、狀態管理、使用體驗共同決定結果。
- 路線 A 有現成配置:百鍊與 TokenHub 都提供官方 Codex 配置,核心是
wire_api = "responses"。 - Qwen4-Max-Preview 有截止日期:僅限 Token Plan,2026-11-25 24:00 結束預覽並下線。
- 套餐單位不可混比:Credits、積分、Token、人民幣分屬不同計量體系,按任務實測纔可比較。
- 用任務說話:五類真實任務、八項指標,以單次成功任務成本作爲採購依據。
- 模型做成可替換組件:固定 Harness、統一接入渠道,按任務切換模型,環境才穩定可控。
最務實的起步方式,是在同一個 Codex 環境中配置兩個 Provider:一個國內雲套餐承擔日常任務,一個按量渠道承擔對照測試和高難度任務,用第 6 節的方法跑一輪,再決定長期組合。推薦通過 API易 apiyi.com 快速搭建對照組,用統一接口把國產模型和 GPT 系列放在同一套任務上驗證。
📚 參考資料
- GPT-6 Astra 官方模型文檔:模型規格、推理檔位與定價
- 鏈接:
developers.openai.com/api/docs/models/gpt-6-astra -
說明:上下文窗口、最大輸出、工具支持與長上下文費率
-
OpenAI Codex Harness:Codex 執行框架設計
- 鏈接:
developers.openai.com/blog/codex-as-a-platform -
說明:Agent 循環、工具回傳、上下文管理與沙盒的官方說明
-
阿里雲百鍊 Codex 接入:Token Plan 配置方法
- 鏈接:
help.aliyun.com/zh/model-studio/codex -
說明:config.toml 字段、Responses 協議與版本要求
-
阿里雲 Token Plan 個人版:套餐價格與 Credits
- 鏈接:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
說明:2026-11-09 調整後的檔位、額度與首購優惠
-
Qwen4-Max-Preview 官方文檔:模型規格與預覽週期
- 鏈接:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
說明:1M 上下文、協議兼容與下線時間
-
騰訊雲 TokenHub Codex CLI 配置:官方接入教程
- 鏈接:
cloud.tencent.cn/document/product/1823/130071 -
說明:Provider 配置與模型 ID 替換方法
-
騰訊雲 TokenHub 套餐與積分費率:計費規則
- 鏈接:
cloud.tencent.cn/document/product/1823/130060 - 鏈接:
cloud.tencent.com/document/product/1823/133811 -
說明:套餐檔位、模型積分費率與峯谷計費
-
OpenCode 官方倉庫:開源 Coding Agent
- 鏈接:
github.com/anomalyco/opencode -
說明:Provider 配置與安全說明
-
Qwen Code、Kimi Code CLI、DeepSeek Harness:原生 Harness
- 鏈接:
help.aliyun.com/zh/model-studio/qwen-code - 鏈接:
github.com/MoonshotAI/kimi-code - 鏈接:
help.aliyun.com/zh/model-studio/deepseek-harness - 說明:安裝、接入與能力範圍
作者:APIYI 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心


