Примечание автора: разбираем, как 12-часовой Prompt Cache от OpenAI влияет на затраты на GPT-6 API, и с помощью формулы окупаемости и 5 критериев показываем, в каких сценариях кеш экономит деньги, а где выгода ограничена.
OpenAI добавил в Prompt Cache возможность хранить кеш 12 часов — для команд, которые вызывают GPT-6 API, это повод заново пересчитать расходы. Раньше кеш жил обычно всего несколько минут простоя, и многие редкие запросы просто не успевали получить скидку; теперь окно кеша стало длиннее, и целая группа запросов, которые «возвращаются через несколько часов», тоже может в него попасть.
Это не маркетинговый лозунг «включил кеш — и сразу экономишь половину». Экономия зависит от того, насколько стабилен префикс, как долго между запросами, насколько велик префикс в одном запросе и есть ли дополнительные расходы на запись в кеш. В этой статье мы разберём простую формулу окупаемости и поможем понять, стоит ли вашему бизнесу включать 12-часовой кеш.
Главное: за 5 минут разобраться, что изменилось в механике 12-часового Prompt Cache, и научиться по 5 критериям определять, когда кеш GPT-6 API действительно экономит деньги.
OpenAI Prompt Cache на 12 часов: главное в двух словах
Сначала — таблица с ключевыми деталями обновления. Официальные цены и параметры меняются, поэтому все, что касается тарификации, сверяйтесь с документацией и страницей цен OpenAI.
| Пункт | Детали |
|---|---|
| Что нового | В Prompt Cache появилась опция хранения кэша на 12 часов |
| Кто выпустил | OpenAI |
| Какие модели | GPT-6 API и другие модели с поддержкой Prompt Caching (актуальный список — в официальной документации) |
| Логика тарификации | Входные токены, попавшие в кэш, считаются по цене ниже обычных входных токенов; точный размер скидки — на официальной странице цен |
| Суть изменения | Кэш живет не «минуты простоя», а до 12 часов |
| Где это важно | Длинные системные промпты, определения инструментов для агентов, фиксированные знания в RAG, многораундовые диалоги |
Как работает Prompt Cache
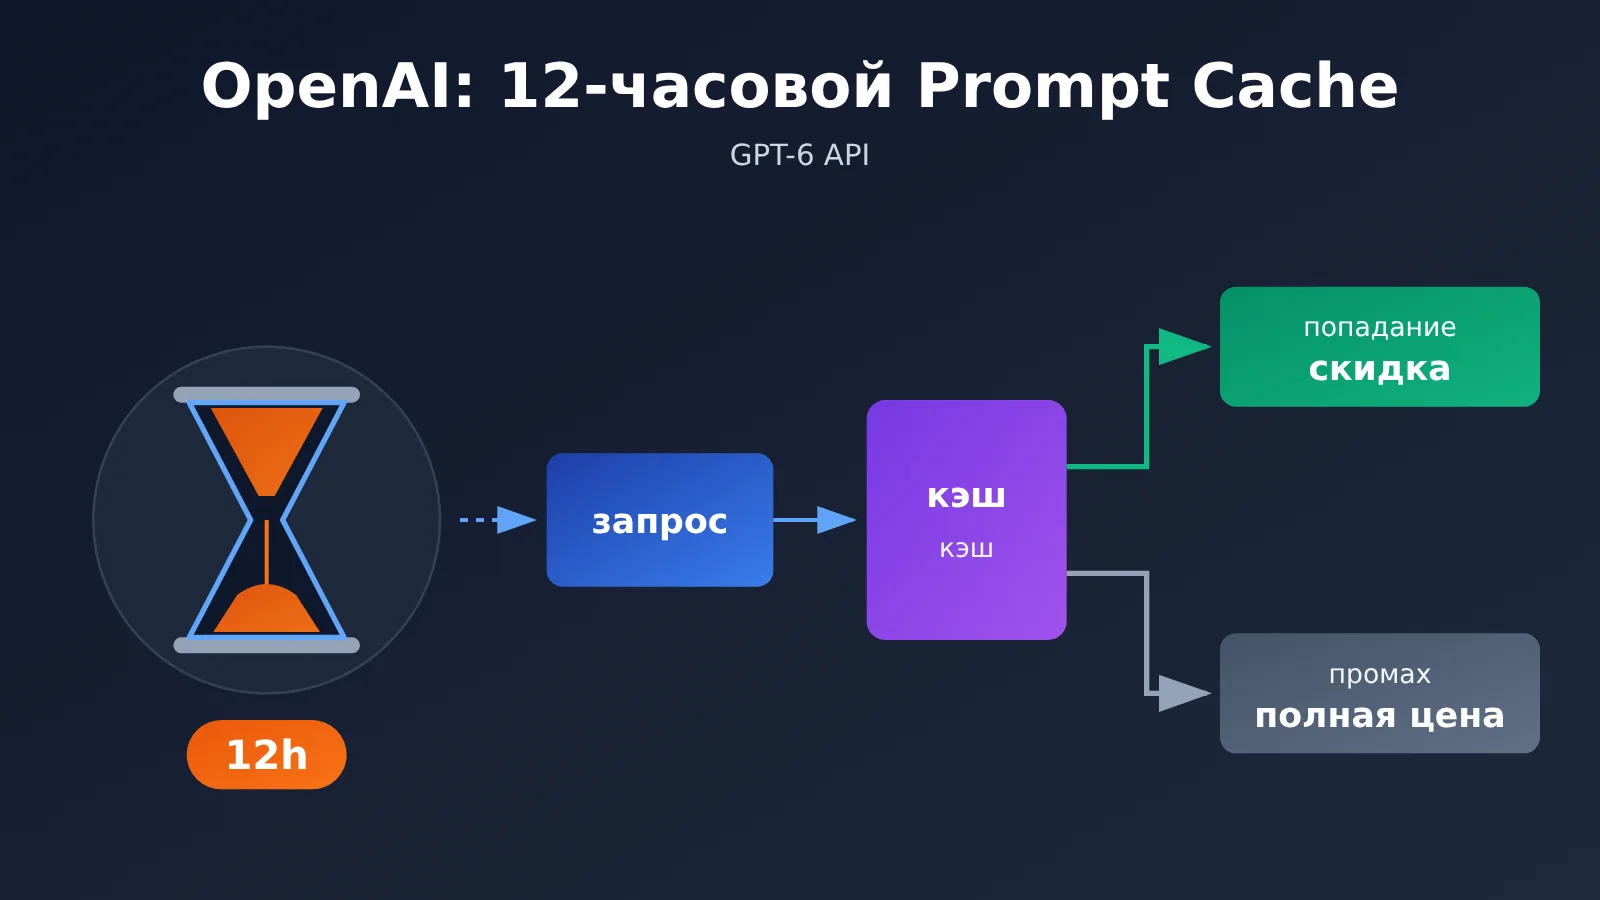
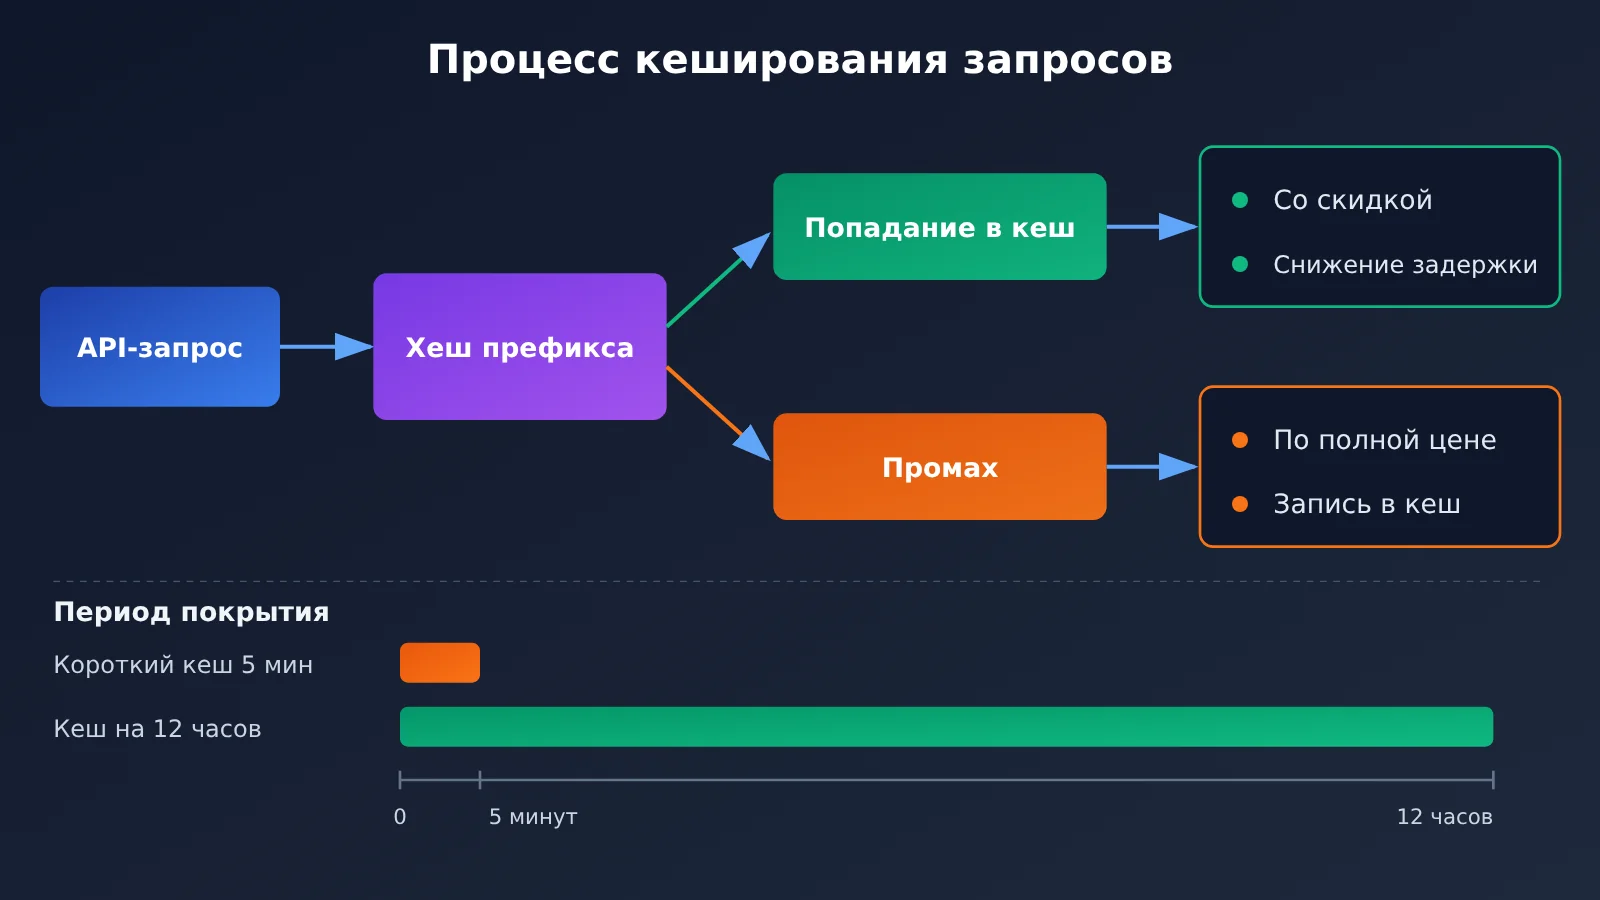
Prompt Caching в OpenAI построен на механизме «сопоставления префикса». Если начало запроса (системный промпт, определения инструментов, фиксированные документы и т. д.) полностью совпадает с каким-то недавним запросом и длина этого фрагмента достигает официального минимального порога, такие токены распознаются как попадание в кэш: они тарифицируются со скидкой, а задержка до первого токена заметно снижается.
Важный момент: кэш учитывает только ту часть, которая совпадает начиная с самого первого токена. Достаточно вставить в середину префикса метку времени или ID пользователя — и все, что идет после, уже не попадет в кэш. Поэтому структура промпта важнее, чем сам факт «включена ли у нас эта штука»: статичный контент — в начало, динамичный — в конец.
Чем 12-часовой кэш отличается от короткого
Прежний короткий кэш очищался после нескольких минут простоя, поэтому стабильно попадали в него только частые, идущие подряд запросы. Хранение на 12 часов расширяет «окно попадания» с минут до половины суток — и это напрямую меняет экономику низкочастотных сценариев.
| Параметр | Обычный короткий кэш | Кэш на 12 часов |
|---|---|---|
| Время жизни | Истекает после нескольких минут простоя | До ~12 часов |
| Подходящая частота запросов | Частые, идущие подряд запросы | Средние и низкие, с паузами |
| Типичные сценарии | Живая поддержка клиентов, пакетные серийные вызовы | Пользователь возвращается в диалог через несколько часов, задачи по расписанию в течение дня |
| Стабильность попаданий | Сильно зависит от колебаний трафика | Лучше переносит провалы трафика |
| Дополнительные расходы | Обычно без платы за запись | Есть ли надбавка — смотрите официальные пояснения |
GPT-6 API: когда кэширование реально экономит деньги — формула окупаемости
Многие статьи ограничиваются фразой «кэш экономит деньги», но не объясняют, сколько именно и при каких условиях. Ниже — универсальная формула, которая переводит вопрос в цифры: подставьте свои бизнес-параметры и получите ответ.
Вывод формулы окупаемости Prompt Cache
Зададим переменные:
L— число токенов в кэшируемом префиксеP— обычная цена входных токеновd— отношение цены за попадание в кэш к обычной цене (0 < d < 1)w— доля дополнительной платы за первую запись в кэш (при отсутствии доплаты w = 0)N— сколько раз один и тот же префикс вызывается за время жизни кэша
Без кэша суммарная стоимость префикса равна N × L × P. С кэшем первый вызов оплачивается по цене записи, а последующие — по цене попадания, итого L × P × (1 + w) + (N − 1) × L × P × d.
Вычтем одно из другого и получим очень простое условие окупаемости: N > 1 + w / (1 − d). Из формулы следуют две вещи. Если запись в кэш бесплатна (w = 0), достаточно повторно использовать один и тот же префикс хотя бы один раз в пределах срока жизни кэша — и вы уже в плюсе. Если за запись берут доплату, число повторных вызовов должно превысить некий порог, и чем больше скидка (чем меньше d), тем быстрее наступает окупаемость.
Расчёт окупаемости для разных сценариев
Ниже — примерный расчёт на «условных параметрах»: он нужен только для иллюстрации того, как работает формула, и не отражает реальные цены OpenAI. Предположим, что цена попадания в кэш составляет некоторую долю от обычной цены, и посмотрим, сколько вызовов требуется для окупаемости — с доплатой за запись и без неё.
| Условный сценарий | Доплата за запись w | Скидка при попадании d | Вызовов для окупаемости N | Вывод |
|---|---|---|---|---|
| Без доплаты за запись | 0 | любая | N > 1 | Один повторный вызов уже экономит |
| Небольшая доплата за запись | низкая | скидка большая | около 2 раз | Выгодно почти в любом сценарии |
| Повышенная доплата за запись | высокая | скидка небольшая | больше 3 раз | Выгодно только при частом переиспользовании |
Расчёт показывает: настоящая ценность 12-часового кэша не в «самой скидке», а в том, что он позволяет увеличить N. Запрос, который приходит раз в несколько часов, при коротком кэше имеет N, близкое к 1, — тут об экономии говорить не приходится. Растянув срок жизни кэша до 12 часов, вы получаете несколько переиспользований одного и того же префикса за день, и только тогда экономия становится заметной.
🚀 Быстрый старт: если хотите проверить формулу окупаемости на реальном трафике, рекомендую через APIYI apiyi.com сравнить попадания в кэш у разных моделей, используя один и тот же API-ключ. Платформа предоставляет OpenAI-совместимый интерфейс, а новые пользователи получают бесплатный тестовый лимит.
Как проверить попадание в Prompt Cache в GPT-6 API
Самый надёжный способ понять, экономит ли кэш деньги, — заглянуть в поле usage в ответе. Интерфейс, совместимый с OpenAI, возвращает в usage.prompt_tokens_details.cached_tokens количество токенов, попавших в кэш в рамках этого запроса, — по нему и можно посчитать реальную долю попаданий.
Минимальный пример
Код ниже дважды отправляет запросы с одинаковым префиксом — посмотрите, будет ли cached_tokens во второй раз больше 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI, совместимый с OpenAI
)

SYSTEM_PROMPT = "Ты опытный технический консультант…… (здесь размещается фиксированный длинный промпт, превышающий минимальный порог кэширования)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # ориентируйтесь на фактическое название в списке моделей платформы
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Вопрос {i+1}: как оптимизировать стоимость запросов к API?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Запрос {i+1}, токенов попало в кэш: {cached}")
Посмотреть полный код реализации (со статистикой попаданий и ключом маршрутизации кэша)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """Статический контент ставим в начало, динамический — в конец, чтобы префикс оставался стабильным"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key помогает направлять запросы с одинаковым префиксом в один и тот же кэш
        # чтобы включить 12-часовое хранение, добавьте соответствующий параметр согласно официальной документации OpenAI
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["Как спроектировать промпт, дружественный к кэшированию?", "Где размещать определения инструментов?", "Как считать долю попаданий?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Общая доля попаданий в кэш: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Запрос {idx}: prompt={p}, cached={c}")
Совет: сначала погоняйте на небольшом трафике день-другой, соберите общую долю попаданий и распределение интервалов между запросами — и только потом решайте, включать ли 12-часовое кэширование в проде на полную. Тестовый лимит можно получить через APIYI apiyi.com, и такой проверки будет достаточно — отдельно заводить несколько официальных аккаунтов не нужно.
5 критериев, когда 12-часовой кэш промптов окупается
Если переложить формулу окупаемости на реальные задачи, получаются пять критериев. Чем больше пунктов совпало, тем заметнее выгода от включения 12-часового кэша.
- Префикс достаточно длинный: кэшируемая фиксированная часть должна достигать официального минимального порога, и чем она длиннее, тем больше суммарная скидка. Короткий промпт на несколько сотен токенов даже при попадании в кэш сэкономит немного.
- Префикс достаточно стабильный: системный промпт, определения инструментов и порядок Schema не меняются в течение дня. Если часто переписывать промпт, кэш будет постоянно сбрасываться.
- Интервал между запросами не превышает 12 часов: если один и тот же префикс вызывается раз в несколько десятков минут или раз в несколько часов, это как раз зона максимального прироста выгоды от 12-часового кэша по сравнению с коротким.
- Число повторных использований выше порога окупаемости: проверьте по
N > 1 + w / (1 − d), что число повторных использований в течение дня стабильно превышает порог. - Высокая доля затрат на входные токены: если основная часть счёта приходится на выходные токены, кэш оптимизирует только входную сторону, и общее снижение будет размытым.
Насколько 12-часовой кэш подходит разным сценариям
| Сценарий | Характер интервалов между запросами | Эффект короткого кэша | Прирост от 12-часового кэша |
|---|---|---|---|
| Чат-бот поддержки в реальном времени | Высокая частота, непрерывно | Уже неплохо | Умеренный, в основном закрывает провалы трафика |
| Корпоративная база знаний на RAG | Средняя частота, фиксированный префикс документов | Заметно колеблется | Ощутимый, фиксированные знания многократно переиспользуются в течение дня |
| Сессии coding-агента | Пользователь периодически возвращается к сессии | Часто перестаёт работать | Очень высокий, длинный контекст переиспользуется через часы |
| Пакетная обработка по расписанию в течение дня | Пачка раз в несколько часов | Практически бесполезен | Очень высокий, один шаблон используется несколько раз в день |
| Разовый анализ длинного документа | Вызов только один раз | Бесполезен | Почти нулевой, при N = 1 окупаемости нет |
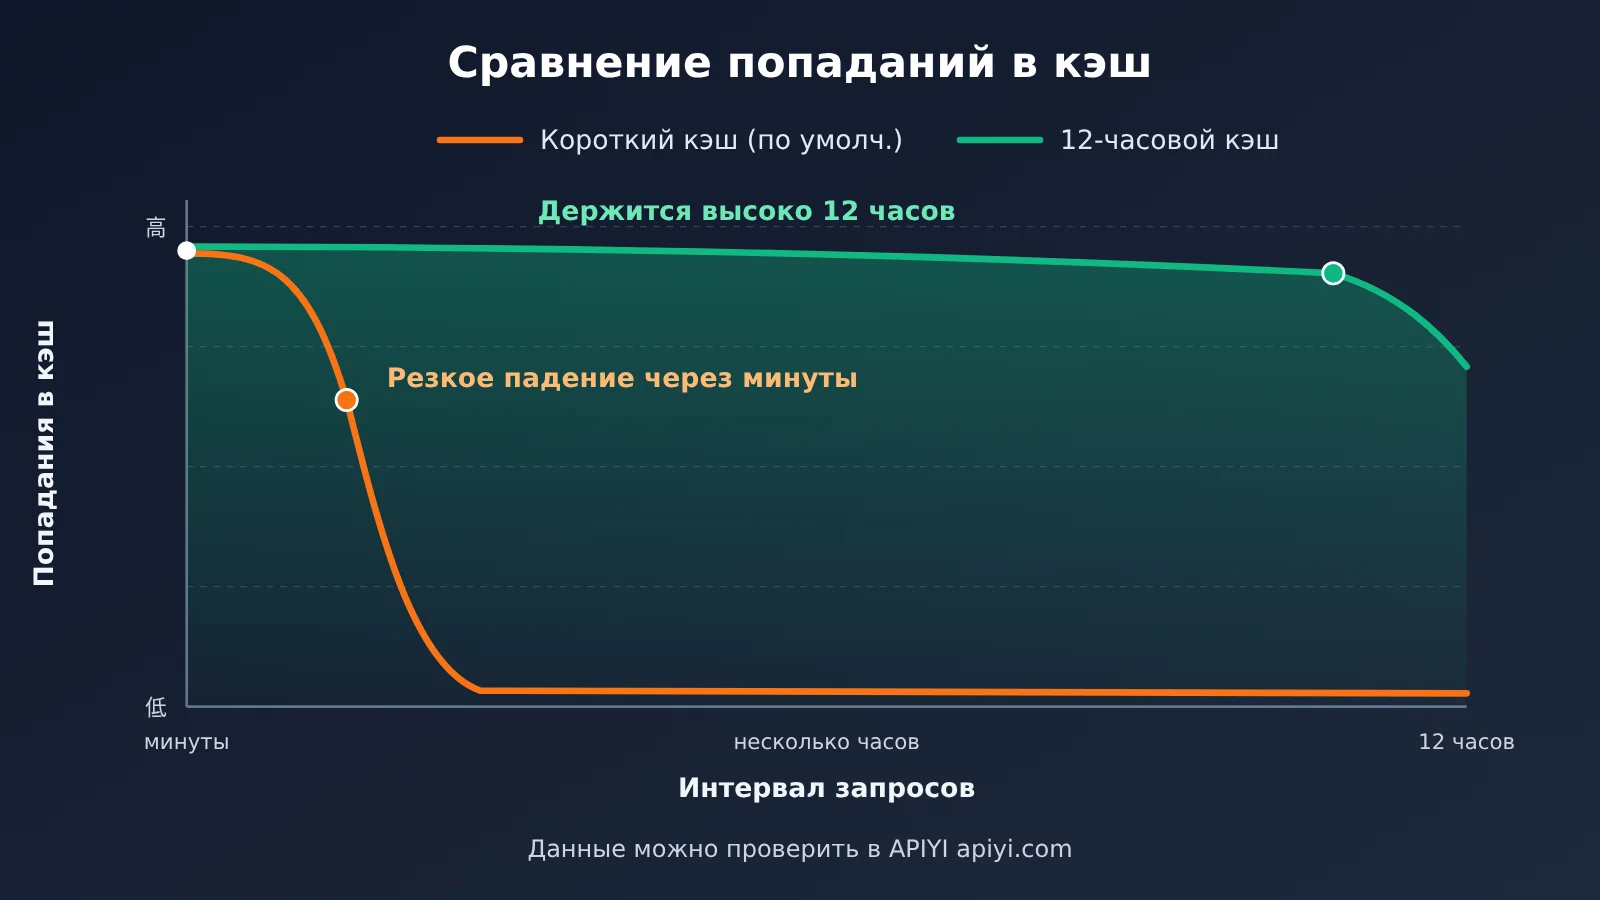
Пояснение к сравнению: на графике показана разница в динамике доли попаданий в кэш для двух стратегий при разных интервалах между запросами. Реальная доля попаданий зависит от стабильности вашего префикса и распределения трафика, поэтому лучше сравнить стратегии на собственных логах реальных запросов.
Анализ влияния 12-часового кэша промптов OpenAI
Влияние на разработчиков
- Промпт-инжиниринг превращается в «кэш-инжиниринг»: системные промпты, определения инструментов и фиксированные знания нужно собрать в стабильные префиксные блоки и явно управлять версиями, чтобы небольшие правки не сбрасывали весь кэш.
- Оценка стоимости смещается с «цены за единицу» к «эффективной цене»: у команд с высоким и низким процентом попаданий в кэш фактическая стоимость на тысячу запросов к одному и тому же GPT-6 API может заметно различаться. Мониторинг cached_tokens стоит сделать регулярной метрикой.
- Агенты с длинным контекстом становятся практичнее: у ассистентов для программирования и исследовательских агентов контекст часто очень длинный. Раньше, если пользователь отходил на время и возвращался, всё приходилось пересчитывать по полной цене. Теперь повторное использование в течение нескольких часов заметно улучшает экономику длинных сессий.
- Задержка тоже улучшается: запросы с попаданием в кэш получают первый токен быстрее — дополнительный плюс для продуктов, чувствительных к интерактивности.
Влияние на отрасль
- Кэширование становится измерением конкуренции в ценообразовании моделей: крупные провайдеры предлагают собственные схемы кэширования промптов, а срок хранения, размер скидки и наличие платы за запись становятся важными критериями выбора для разработчиков.
- Растёт ценность сравнения нескольких моделей на агрегаторах: правила кэширования у разных провайдеров сильно отличаются. Сравнивать реальные счета через единый интерфейс полезнее, чем смотреть только на официальные прайс-листы.
- Архитектуру RAG, возможно, придётся пересмотреть: когда длинный префикс документа можно дешево переиспользовать полдня, в некоторых сценариях с небольшими и средними базами знаний можно перейти от «поиска и нарезки» к «поместить весь документ в контекст + кэш».
Сравнение вариантов кэширования для разных моделей
| Направление модели | Особенности кэширования (по официальной документации провайдеров) | Сценарии применения | Доступные платформы |
|---|---|---|---|
| GPT-6 API | Автоматическое префиксное кэширование, новый вариант хранения 12 часов | Длинные системные промпты, сессии агентов | APIYI apiyi.com, официальный OpenAI |
| Семейство Claude | Нужно явно отмечать точки кэширования, поддерживаются разные сроки хранения | Сценарии с точным контролем мест кэширования | APIYI, официальный Anthropic |
| Семейство Gemini | Поддерживает неявное и явное кэширование контекста | Сверхдлинные документы, мультимодальный контекст | APIYI, официальный Google |
💡 Рекомендация по выбору: правила кэширования у разных моделей сильно различаются. Лучше взять один и тот же бизнес-промпт, прогнать его на нескольких моделях и замерить реальный процент попаданий и счета, а потом принимать решение с учётом качества.
Частые вопросы (FAQ)
Вопрос 1: Что такое 12-часовой Prompt Cache от OpenAI?
Это опция продлённого хранения в механизме Prompt Caching от OpenAI. Запросы с одинаковым префиксом могут попадать в кэш на срок до ~12 часов, а входные токены из кэшированной части тарифицируются со скидкой — кроме того, снижается задержка до первого токена.
Вопрос 2: Чем 12-часовой кэш отличается от обычного короткого?
Обычный короткий кэш «сгорает» после нескольких минут простоя — он подходит только для частых последовательных запросов. 12-часовой кэш покрывает и средне-/низкочастотные, прерывистые обращения. Для сценариев вроде чат-поддержки в реальном времени разницы почти нет, а вот для сессий агентов или плановой пакетной обработки, где между вызовами проходят часы, прирост от 12-часового кэша вполне ощутим.
Вопрос 3: Включение 12-часового кэша гарантированно экономит деньги?
Нет. Если за запись в кэш нет доплаты, достаточно один раз переиспользовать тот же префикс в течение срока действия — и вы уже в плюсе. Если доплата есть, нужно переиспользовать префикс больше `1 + w / (1 − d)` раз, чтобы окупиться. В случаях с разовым вызовом, часто меняющимся или очень коротким префиксом выгода крайне невелика.
Вопрос 4: Как повысить долю попаданий в кэш при работе с GPT-6 API?
Главный принцип — «статичное впереди, динамичное позади»:
— Системный промпт, определения инструментов и фиксированные документы ставьте в самое начало сообщения и сохраняйте их порядок неизменным
— Динамический контент — метки времени, ID пользователя, результаты поиска — размещайте в конце
— Для однотипных запросов используйте постоянный ключ маршрутизации кэша, чтобы повысить шанс попасть в один и тот же кэш
— Обновления промптов выпускайте централизованно, избегайте мелких правок по несколько раз в день
Вопрос 5: Как быстро протестировать эффект 12-часового кэша через API?
Рекомендую тестировать через агрегатор API с поддержкой нескольких моделей:
1. Зарегистрируйтесь на платформе APIYI — apiyi.com
2. Получите API-ключ и бесплатную тестовую квоту
3. Используйте пример кода из этой статьи (замените base_url на `https://api.apiyi.com/v1`) и читайте статистику попаданий из `cached_tokens`
APIYI использует интерфейс, совместимый с OpenAI: с одним ключом можно сравнить поведение кэша у GPT, Claude и Gemini.
Вопрос 6: Какие известные ограничения есть у Prompt Cache?
Кэш работает только для непрерывных префиксов, достигших минимального порога длины, и оптимизирует исключительно затраты на входной стороне — выходные токены скидки не получают. Кэш — механизм «best effort»: при высокой параллельной нагрузке или изменении маршрутизации трафика возможны промахи, так что не стоит рассчитывать на 100%-ную долю попаданий. Точную тарификацию и список поддерживаемых моделей для 12-часового хранения уточняйте в официальной документации OpenAI.
Ключевые моменты 12-часового Prompt Cache
- Суть механизма: работает по точному совпадению префикса — на входные токены, попавшие в кэш, действует скидка
- Главное изменение: время хранения выросло с минут до ~12 часов, так что кэш теперь покрывает и низкочастотные запросы
- Формула окупаемости: экономия начинается, когда число повторных использований N > 1 + w / (1 − d)
- Где выгода максимальна: длинные сессии агентов, RAG по базе знаний, пакетная обработка по расписанию в течение дня
- Где выгода ограничена: разовые вызовы, короткие префиксы, промпты, которые часто переписывают
- Что важно на практике: статичный контент — в начало промпта, а долю попаданий постоянно отслеживать через
cached_tokens - Как проверить: сначала небольшой тест на реальном трафике через APIYI apiyi.com, и только потом включать на полную
Итог
Как 12-часовой Prompt Cache от OpenAI влияет на стоимость GPT-6 API — главное:
- Экономия зависит от числа повторных использований. 12-часовое окно позволяет даже средне- и низкочастотным запросам многократно переиспользовать один и тот же префикс. Именно рост N, а не сам факт кэша, даёт реальную прибавку.
- Порог окупаемости задаёт стоимость записи. Если доплаты за запись нет — вы почти всегда в плюсе. Если есть — считайте по формуле окупаемости.
- Структура промпта важнее переключателя. Статичный контент в начале, управление версиями, мониторинг доли попаданий — только так скидка за кэш действительно доходит до счёта.
Совет: начинайте с самых выгодных сценариев — длинных системных промптов и сессий агентов. Прогоните реальный трафик за день, посмотрите на долю попаданий и уже потом решайте, насколько широко внедрять. Быстро сравнить эффект кэша на нескольких моделях удобно через APIYI apiyi.com: платформа даёт бесплатный тестовый лимит и единый OpenAI-совместимый интерфейс.
📚 Справочные материалы
- Официальное руководство OpenAI по Prompt Caching: механизм кэширования, минимальный порог и описание поля
usage - Ссылка:
platform.openai.com/docs/guides/prompt-caching -
Пояснение: авторитетный источник по правилам попадания в кэш и актуальным параметрам срока хранения
-
Страница цен OpenAI API: стоимость обычного ввода, ввода из кэша и вывода для разных моделей
- Ссылка:
openai.com/api/pricing -
Пояснение: при подстановке в формулу окупаемости ориентируйтесь на актуальные цены на этой странице
-
OpenAI API Reference: описание параметров интерфейсов Chat Completions и Responses
- Ссылка:
platform.openai.com/docs/api-reference - Пояснение: конкретное использование параметров кэширования, таких как
prompt_cache_key
Автор: Техническая команда APIYI
По техническим вопросам: свяжитесь с нами через главную страницу сайта APIYI — расскажем больше о подключении моделей и оптимизации затрат