Примечание автора: по результатам тестирования уже опубликованной в открытом доступе Kimi K3 оцениваем требования к оборудованию для локального развёртывания K3.1 Pro, ежемесячные расходы, стоимость миллиона токенов и точку безубыточности. Это поможет понять, когда выгоднее арендовать сервер, купить его или просто пользоваться API.
Сразу к выводам: Kimi K3.1 Pro скоро появится в открытом доступе, но локальное развёртывание — не вариант для частного пользователя. По заявлению разработчиков, полные веса модели выпустят до 4 ноября. Это модель с открытыми весами масштаба 3T. По состоянию на 26 октября 2026 года веса K3.1 Pro ещё не опубликованы. Все приведённые в статье цифры по оборудованию и видеопамяти рассчитаны на основе замеров уже открытой Kimi K3; после публикации весов их нужно будет перепроверить.
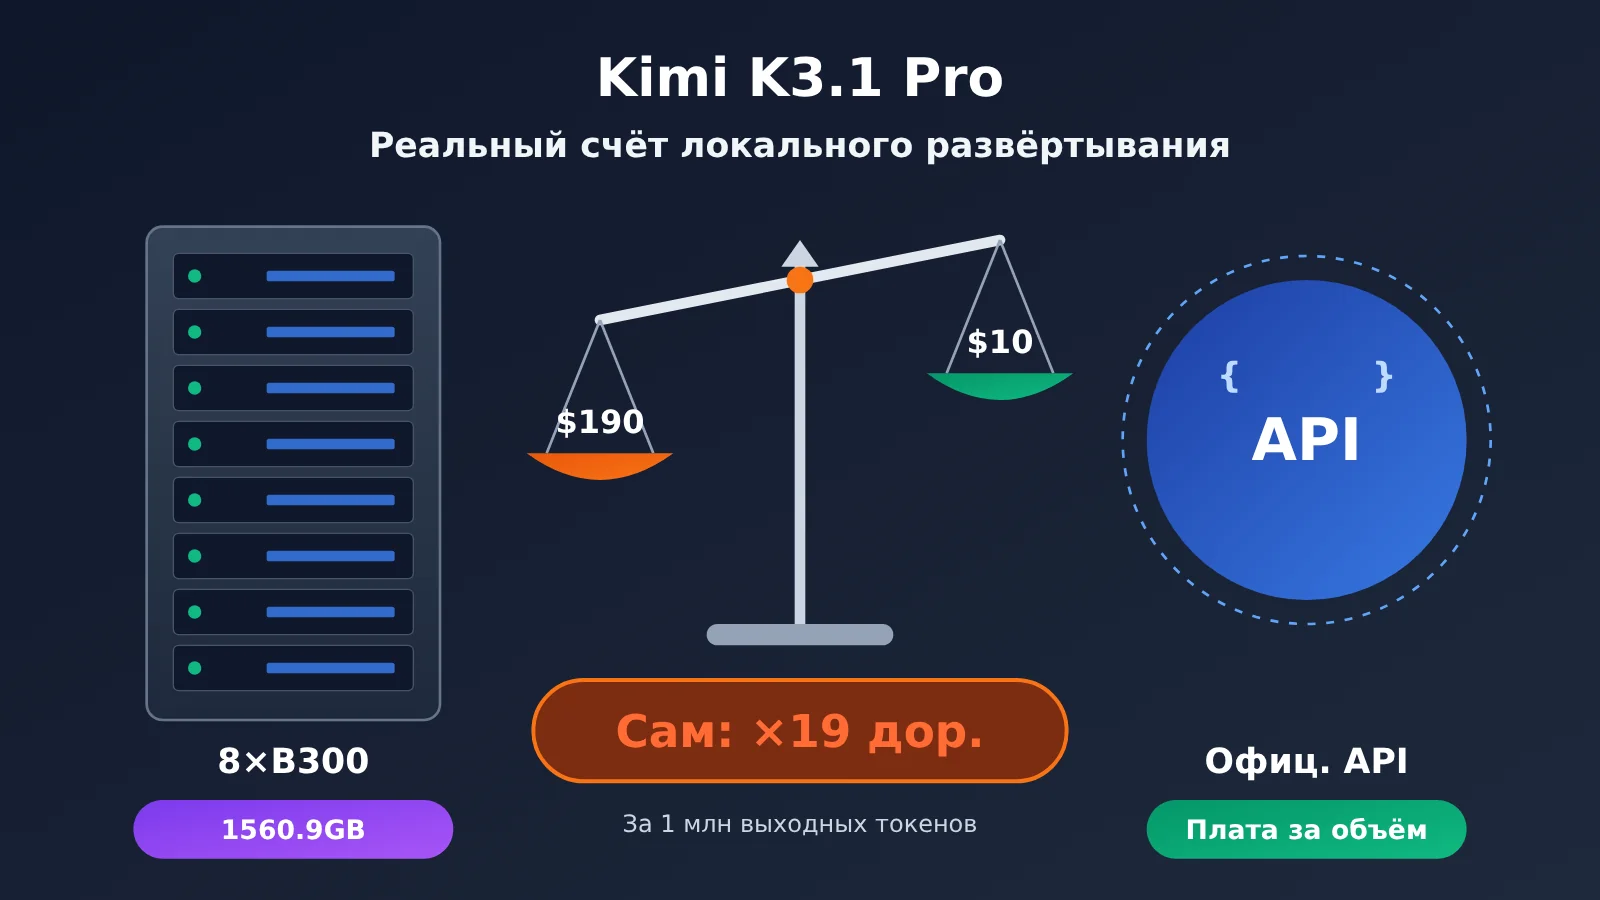
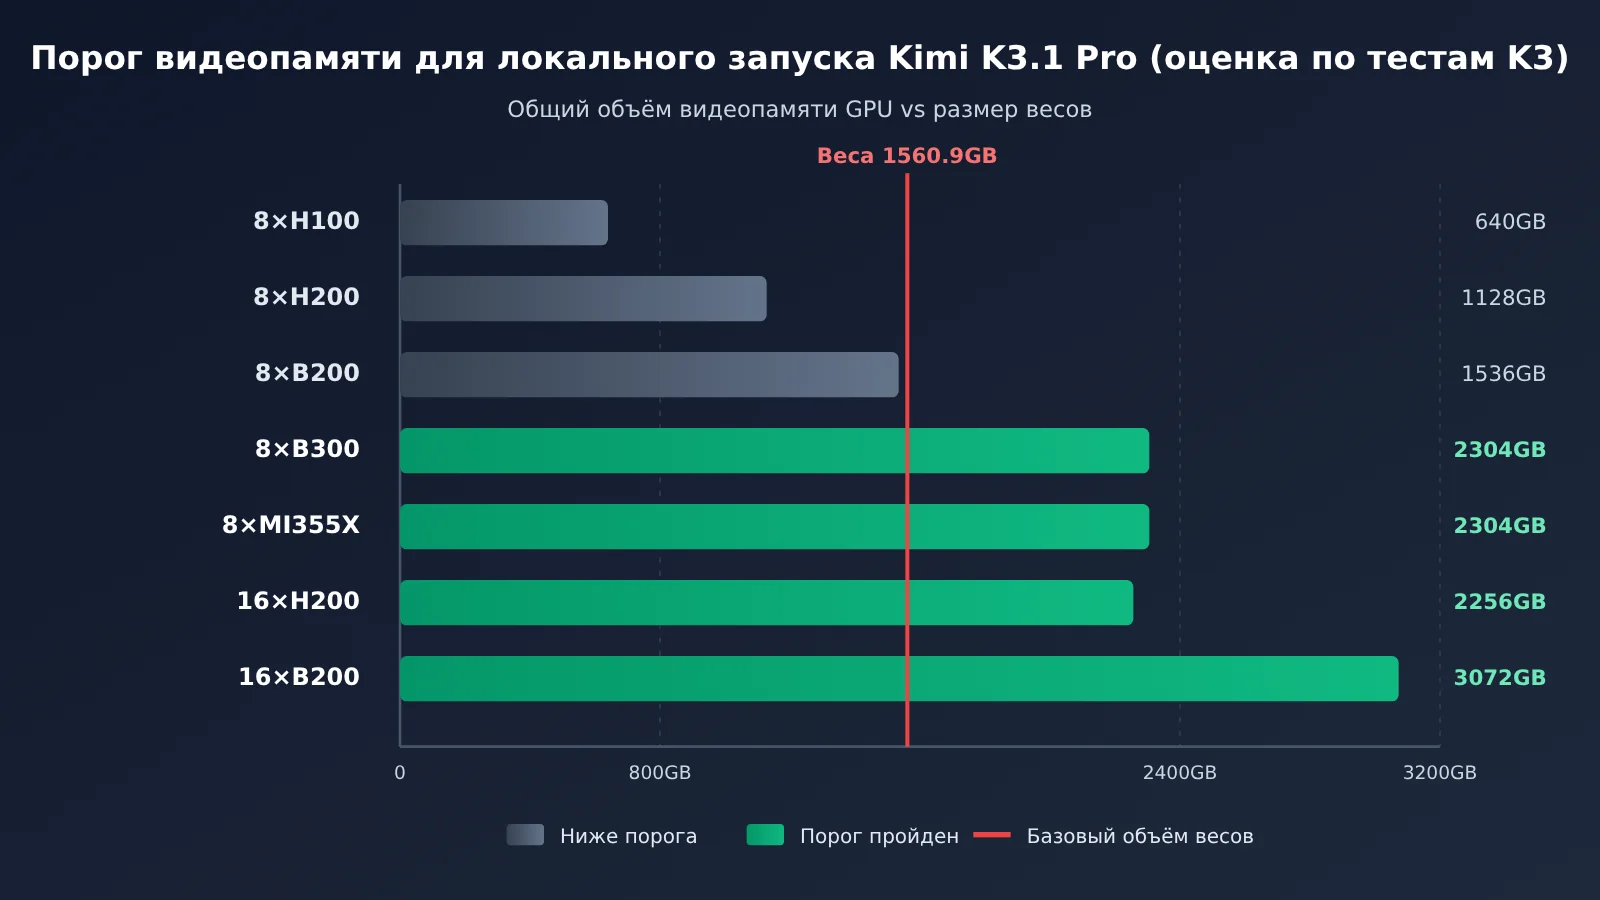
Согласно замерам K3, одни только веса занимают 1560,9 ГБ: 8 ускорителей B300 хватает впритык, а 8 H200 не хватает примерно 400 ГБ. Если использовать сервер с 8 B300 только для себя, миллион выходных токенов обойдётся примерно в $190,00 — в 19 раз дороже, чем через официальный API ($10,00).
Эта статья не отговаривает от локального развёртывания — она поможет решить, стоит ли создавать собственную инфраструктуру. Для каждой цифры указано, получена ли она из официального источника, стороннего тестирования или расчётов автора. Подставьте свои объёмы нагрузки и оцените расходы.
Главное: прочитав статью, вы сможете рассчитать реальные затраты на самостоятельный запуск Kimi K3.1 Pro и по контрольному списку решить, что вам подходит: арендовать сервер, купить его или просто обращаться к API.
Ключевые выводы о локальном развёртывании Kimi K3.1 Pro
| Ключевой аспект | Вывод | Уровень достоверности |
|---|---|---|
| Статус весов | Пока не опубликованы; по официальной информации, их планируют выпустить до 4 ноября | Официальные источники |
| Объём весов | Веса K3 занимают 1560,9 ГБ; архитектура K3.1 Pro унаследована от K3 | Сторонние замеры (K3) |
| Минимальная конфигурация для одного сервера | 8×B300 / 8×GB300 / 8×MI355X | Рекомендации фреймворков для инференса и результаты тестов |
| Себестоимость при самостоятельном использовании | Около $190,00 за миллион выходных токенов | Счета по результатам сторонних тестов |
| Условие для сравнения с API | Стабильная длительная генерация со скоростью выше 1 500 токенов/с | Оценка в этой статье |
Как понимать уровни достоверности данных о локальном развёртывании Kimi K3.1 Pro
В этой статье мы разделяем данные на три уровня — при чтении учитывайте это. Официальные источники — это сведения из блога Moonshot на kimi.ai, документации platform.kimi.ai и карточек моделей на Hugging Face. Сторонние замеры — опубликованные результаты тестов пользователей AWS, GPUStack, OpenZeka, Modal и других платформ. Для них мы указываем источник и дату. Оценка в этой статье — расчёты на основе открытых цен и показателей производительности; мы приводим формулы и допущения. Эти данные не являются официальными.
Основание для расчётов тоже взято из официальных источников: Kimi K3.1 Pro — версия Kimi K3, дополнительно обученная после предобучения (post-trained version of Kimi K3). Архитектура осталась прежней, но для последующего обучения с подкреплением использовалось больше вычислительных ресурсов. Поэтому количество параметров K3, форматы квантования и объём весов можно считать разумным ориентиром для минимальных требований к развёртыванию K3.1 Pro.
Аппаратные требования для локального развёртывания Kimi K3.1 Pro: почему минимум — 8 B300
【Официальные данные】В карточке модели K3 указано: всего 2,8T параметров, из них 104B активных; 93 слоя; 896 маршрутизируемых экспертов, из которых для каждого токена выбираются 16, а ещё 2 эксперта — общие; контекстное окно — 1 048 576 токенов. Для весов используется MXFP4, для активаций — MXFP8. Квантование учитывалось при обучении уже на этапе SFT.
【Сторонние тесты】Один из пользователей подсчитал файлы в репозитории на Hugging Face: 96 сегментов safetensors в сумме занимают 1 560 936 091 448 байт — около 1560,9 GB. Фактический размер больше теоретической оценки «2,8T × 0,5 byte = 1400GB», потому что в config некоторые компоненты — слои внимания, общие эксперты, lm_head, визуальная башня и другие — внесены в белый список и сохраняют более высокую точность. В рецепте vLLM указан минимальный объём видеопамяти — 1680GB, а также сказано, что потребуется как минимум 8×GB300. Для реальной производственной нагрузки нужно несколько узлов.
| Конфигурация | Общий объём видеопамяти | Запустится? | Примечание |
|---|---|---|---|
| 8×H100 80GB | 640GB | Нет | Для весов нужно в 2,4 раза больше видеопамяти |
| 32×H100 | 2.56TB | С трудом | Для SGLang есть рецепт, но Hopper не поддерживает MXFP4 напрямую — потребуется обратное квантование во время выполнения |
| 8×H200 141GB | 1.13TB | Нет | Не хватает около 400GB — особенно обидный вариант |
| 16×H200 (два узла) | 2.26TB | Да | Также потребуется обратное квантование |
| 8×B200 180GB | 1.44TB | Нет | Не хватает около 120GB |
| 16×B200 / GB200 | 2.88TB | Да | Эталонная конфигурация Blackwell |
| 8×B300 / GB300 | 2.30TB | Да | Официальный вариант по умолчанию: модель как раз помещается в один узел |
| 8×MI355X | 2.30TB | Да | Проверено AMD в день запуска |
| Одна карта / RTX 4090 / Mac с 512GB | — | Нет | Для RTX 4090 понадобится 75 карт, чтобы вместить одни только веса |
KV-кэш, напротив, не становится узким местом. В K3 всего 24 слоя Gated MLA, которым требуется около 27 KiB на токен; остальные 69 слоёв KDA хранят лишь фиксированное состояние для каждой последовательности. По расчётам сторонних специалистов, KV-кэш для одного пользователя с контекстом в 1M токенов занимает около 29,5GB, а для контекста в 8K — около 0,7GB. Главная проблема — сами веса объёмом 1,56TB.
Если вы всё же собираетесь развернуть модель, учтите обязательные требования со стороны фреймворков (по рецептам vLLM и руководству SGLang для K3):
- Образ vLLM:
vllm/vllm-openai:kimi-k3. Доступна только версия для CUDA 13; нужны драйверы r580+ и vLLM ≥ 0.27.0. - Параллелизм: для TP / TEP требуется минимум 8 карт, для DEP — минимум 16. Распределённый KV-кэш на всём перечисленном оборудовании помечен как неподдерживаемый.
- Планирование узлов для SGLang: для B300 нужен один узел с 8 картами, для B200 и H200 — два узла по 8 карт.
- По заявлениям Moonshot за август 2026 года, переданным третьими сторонами, для производственной среды рекомендуется суперузел с более чем 64 ускорителями.
Реальные расходы на локальное развёртывание Kimi K3.1 Pro: четыре варианта и месячная стоимость
Ниже приведена оценка месячных затрат при круглосуточной работе одной системы с 8×B300. Для пересчёта используется единый курс: 1 доллар = 7,25 юаня. Цены взяты из трёх источников: почасовые тарифы ComputeUnion, собранные 24–25 октября 2026 года; счета пользователей Modal; материалы отраслевого исследования рынка аренды вычислительных мощностей, опубликованные Sina Finance 20 мая 2026 года.
⚠️ Цены на аренду и покупку готовых систем в Китае (например, около 80 000 юаней в месяц за H200, 160 000–190 000 юаней в месяц за B300 при аренде на пять лет и 6,8–7 млн юаней за B300 при покупке на спотовом рынке) основаны на отраслевом исследовании, а не на публичных прайс-листах производителей, и служат только для ориентировочной оценки. Обычно речь идёт о системах с восемью GPU, минимальный срок аренды — один год.
| Вариант | Расчёт | Стоимость в месяц | Примечания |
|---|---|---|---|
| Почасовая аренда за рубежом (24/7) | Система B300: 342–464 юаня в час × 730 часов | Около 249 800–338 700 юаней (34 500–46 700 долларов) | Сторонние расценки + оценка в этой статье |
| Modal, по реальным счетам (24/7) | 56,79 доллара в час × 730 часов | 41 457,00 доллара, около 300 600 юаней | Счёт по итогам реального использования |
| Аренда системы в Китае на пять лет | По данным отраслевого исследования | 160 000–190 000 юаней | Не публичная цена, минимальный срок аренды — 1 год |
| Покупка + электричество | 6,8–7 млн юаней с линейной амортизацией за 3 года, плюс около 8 800 юаней за электричество | Около 198 000–203 000 юаней | Без учёта расходов на специалистов по эксплуатации, запасные части, размещение оборудования и пропускную способность сети |
| Работа по 4 часа в день с выключением на остальное время | Почасовая аренда за рубежом | Около 26 000–30 000 юаней | Каждый запуск требует холодного старта продолжительностью около 27 минут |
Расходы на электричество рассчитаны по следующим допущениям: нагрузка — 13,2 кВт, PUE — 1,3, тариф — 0,7 юаня за кВт·ч. Это около 12 юаней в час. Покупка системы выглядит самым дешёвым вариантом, но в таблице не учтены затраты на инженеров по эксплуатации — а для небольшой команды это как раз одна из самых значительных скрытых статей расходов.
Режим «работать 4 часа в день, а потом выключать» кажется экономным, но на практике его сложно реализовать. По замерам Modal холодный старт занимает около 27 минут: нужно загрузить веса модели объёмом 1,56 ТБ, выполнить JIT-компиляцию и захватить 51 граф CUDA. При запуске коротких задач ожидание может оказаться дольше самого вывода.
Себестоимость Kimi K3.1 Pro: от пропускной способности зависит, во сколько раз вы переплачиваете по сравнению с API
Аренда на месяц — лишь часть расходов. Чтобы понять, насколько она оправдана, нужно смотреть на себестоимость миллиона токенов. В этой статье используется формула: стоимость миллиона выходных токенов = стоимость машины за час ÷ количество выходных токенов за час (в миллионах). Для расчётов везде берётся значение $56.79 в час — по замерам Modal.
【Замеры сторонних компаний】Несколько результатов тестов пропускной способности на системах с 8×B300:
- Одна машина Modal (TP8, нативный MXFP4): стабильная скорость — 92 токена/с, TTFT — 0,92–1,02 секунды
- OpenZeka (DGX B300, TP8, vLLM): при параллельной обработке 1 запроса — 105,7 токена/с, при 64 запросах — 32,45 токена/с на пользователя; расчётная нагрузка — 150 пользователей в чат-режиме или 50 пользователей Agent
- Официальный пример AWS (29 июля 2026 года, p6-b300.48xlarge): при 8 параллельных запросах — 516 токенов/с, общая пропускная способность при высокой нагрузке — 4 634 токена/с
- GPUStack (30 июля 2026 года): входной контекст 64K, 10 параллельных запросов; обработка запроса от начала до конца в vLLM занимает 100,5 секунды; агрегированная пропускная способность prefill — около 19–23 тыс. токенов/с
| Стабильная скорость генерации | Выходных токенов в час | Стоимость миллиона выходных токенов | Сравнение с официальным API за $10.00 |
|---|---|---|---|
| 92 токена/с (один запрос, полная нагрузка) | 0.33M | $171.50 (по расчётам автора — $190.00) | примерно в 17–19 раз дороже |
| 500 токенов/с | 1.80M | $31.50 | примерно в 3 раза дороже |
| 1,000 токенов/с | 3.60M | $15.80 | примерно в 1,6 раза дороже |
| 1,500 токенов/с | 5.40M | $10.50 | примерно одинаковая стоимость |
| 3,000 токенов/с | 10.80M | $5.30 | примерно вдвое дешевле |
| 4,634 токена/с (пиковое значение по замерам AWS) | 16.68M | $3.40 | примерно втрое дешевле |
Если системой пользуется один человек или небольшая группа, результат на практике будет примерно соответствовать первой строке. При низкой параллельной нагрузке большая часть времени машина простаивает, и миллион выходных токенов обходится примерно в $190.00 — отсюда и взялось «в 19 раз дороже» в заголовке. Самостоятельное развёртывание сравняется с API по себестоимости, только если бизнес сможет долго поддерживать пропускную способность выше 1 500 токенов/с.
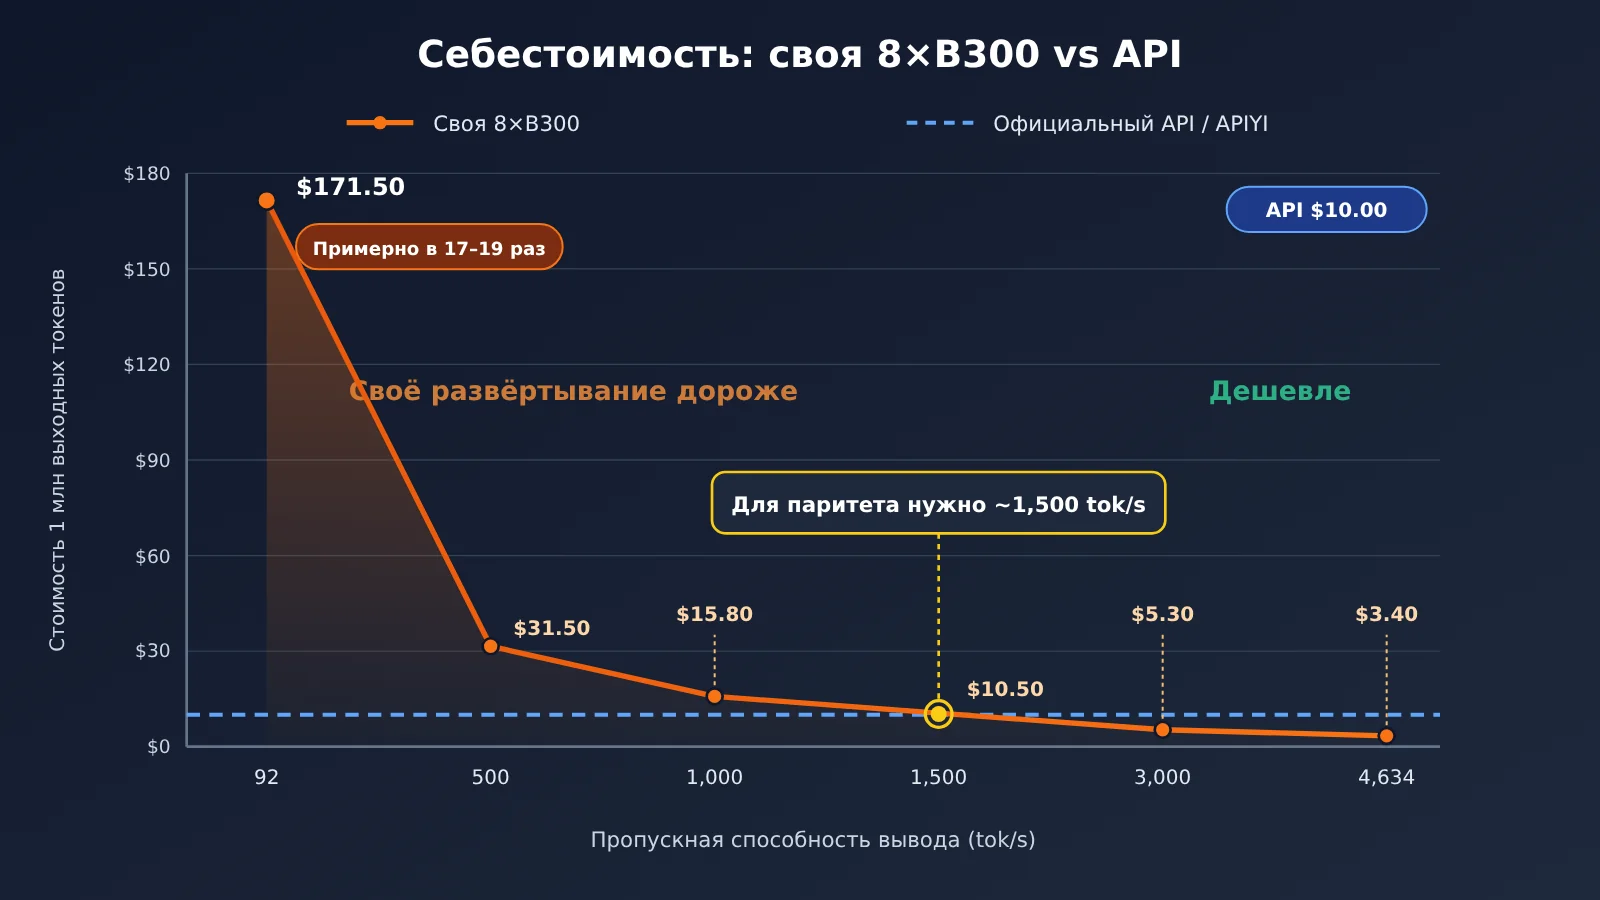
💡 Сравнение цен: за основу на графике взята официальная цена — $10.00 за миллион выходных токенов. Цена выходных токенов kimi-k3.1-pro на APIYI apiyi.com совпадает с официальной, поэтому её можно использовать для сравнения.
Точка безубыточности при локальном развёртывании Kimi K3.1 Pro: сколько токенов нужно расходовать в месяц
Посмотрим на вопрос с другой стороны: сколько токенов нужно расходовать в месяц, чтобы собственная инфраструктура сравнялась по стоимости с API? Для оценки используем такие допущения: официальные тарифы API — $2,00 за входные и $10,00 за выходные токены; соотношение входных и выходных токенов — 5:1, как в типичных сценариях с агентами; попадания в кэш не учитываем.
| Вариант собственного развёртывания | Стоимость в месяц | Необходимый объём входных токенов в месяц | Необходимый объём выходных токенов в месяц |
|---|---|---|---|
| Зарубежная инфраструктура с оплатой по факту, 24/7 | $41 457,00 | около 10,4 млрд | около 2,07 млрд |
| Сервер в Китае с пятилетней оплатой | 190 тыс. юаней | около 6,55 млрд | около 1,31 млрд |
| Покупка оборудования (амортизация + электричество) | 203 тыс. юаней | около 6,98 млрд | около 1,4 млрд |
Что значит расходовать более миллиарда выходных токенов в месяц? По оценкам OpenZeka, одна система с 8×B300 выдерживает 50 пользователей с параллельно работающими агентами. Небольшой команде до десяти человек до такого объёма очень далеко.
Есть и ещё один важный фактор, о котором легко забыть, — кэширование. Официальная цена за токены, попавшие в кэш, составляет всего $0,20 за миллион. А в сценариях с агентами и длинными документами доля попаданий в кэш обычно немаленькая. Чем она выше, тем дешевле обходится API и тем больше становится пороговый объём, при котором собственная инфраструктура начинает окупаться.
В каких случаях стоит самостоятельно развёртывать Kimi K3.1 Pro
Самостоятельное развёртывание — вполне рабочий вариант, но для него нужны веские причины. В следующих случаях оно оправдано:
- Безопасность или работа офлайн — обязательное требование: данные нельзя передавать за пределы внутренней сети, нужна физическая изоляция, и даже самый дешёвый API не подойдёт. Однако официальный API уже поддерживает нулевое хранение данных (ZDR), поэтому сначала стоит проверить, отвечает ли эта возможность вашим требованиям.
- Нужно дообучать модель или дистиллировать её: вы собираетесь проводить предметное постобучение на базе K3.1 Pro или дистиллировать модель в компактную версию на 30–120 млрд параметров — тогда вам потребуются полные веса.
- У вас простаивают GPU и есть специалист по эксплуатации: у вас уже есть 8×B300, 8×MI355X или две H200, которые сейчас не используются, а за эксплуатацию отвечает инженер, знакомый с vLLM или SGLang. Только в этом случае предельные затраты могут оказаться низкими.
- Объёмы действительно оправдывают развёртывание: нагрузка стабильно превышает 1 500 токенов/с, а ежемесячный объём генерации достигает миллиарда токенов.
Заранее изучите и условия лицензии. Для K3 используется Kimi K3 License. Согласно сторонним обзорам, для предоставления модели в качестве сервиса при годовой выручке свыше 20 млн долларов требуется отдельное разрешение. Условия лицензии K3.1 Pro станут известны после публикации весов — ориентироваться нужно на файл LICENSE в репозитории Hugging Face. Пока делать выводы от имени разработчиков нельзя.
В каких случаях точно не стоит самостоятельно разворачивать Kimi K3.1 Pro
В следующих случаях самостоятельное развёртывание, скорее всего, обойдётся дороже:
- Хотите сэкономить: это имеет смысл, только если постоянная нагрузка превышает 1 500 токенов/с. Иначе стоимость токена будет выше, чем при использовании API: для личного использования — примерно в 19 раз
- Нужны длительные задачи и возможность включать и выключать ресурсы по мере необходимости: холодный запуск занимает около 27 минут, поэтому схема с включением и выключением по запросу практически неработоспособна
- Модель нужна только вам или небольшой команде: вы не сможете загрузить её параллельными запросами. В итоге будете платить $56.79 в час за скорость всего 92 токена/с
- Рассчитываете уместить квантованную модель на одном сервере: решения сообщества пока нельзя использовать в продакшене. Unsloth 1-bit (UD-IQ1_S, 594 ГБ) на 8×A100 выдаёт около 9 токенов/с. В пересчёте это $620.00 за миллион выходных токенов — в 3,3 раза дороже, чем полный вариант модели. Доля совпадений top-1 у 1-битной и полной модели — около 79%.
kimi-k3-in-cзапускает полную версию весов при использовании 8,24 ГБ памяти, но генерирует один токен за 10–32 секунды — это скорее техническая демонстрация
Для локального запуска по-настоящему подойдут дистиллированные версии, которые со временем выпустит сообщество. До их появления API — самый удобный вариант для частных пользователей и небольших команд.
Kimi K3.1 Pro: быстрый старт — сначала проверьте рабочую нагрузку через API
Прежде чем принимать решение о самостоятельном развёртывании, рекомендуем в течение месяца использовать API в реальных задачах. Так вы узнаете фактическое соотношение входных и выходных токенов, а также долю попаданий в кэш. После этого можно вернуться к таблице безубыточности выше и пересчитать затраты. Kimi K3.1 Pro уже доступна на APIYI apiyi.com по той же цене, что и у официального провайдера: $2,00 за входные токены / $10,00 за выходные токены / $0,20 за чтение из кэша (в долларах за миллион токенов). Список моделей и цены на платформе могут меняться.
Как подключить модель через интерфейс, совместимый с OpenAI:
- Зарегистрируйтесь на APIYI apiyi.com и создайте API-ключ. Новым пользователям доступен бесплатный тестовый лимит.
- Укажите в SDK
base_url:https://api.apiyi.com/v1. - Введите ID модели
kimi-k3.1-pro. Если важна скорость, выберитеkimi-k3.1-pro-highspeed($4,00 за входные токены / $20,00 за выходные токены). - Для настройки интенсивности рассуждений используйте параметр
reasoning_effortсо значениемlow,highилиmax. По умолчанию у официального провайдера используетсяmax. В официальных тестах задавались параметрыtemperature = 1.0иtop_p = 0.95. - При многоэтапном диалоге и вызове инструментов обязательно передавайте сообщения assistant с полем
reasoning_contentбез изменений — иначе контекст может обрабатываться некорректно. - Настройте сбор статистики: ежедневно записывайте значения
prompt_tokens,completion_tokensи объём попаданий в кэш. Эти данные помогут принять решение о самостоятельном развёртывании.
| Модель | Входные токены | Выходные токены | Чтение из кэша | Доступные платформы |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com, официальный API Kimi |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI, официальный API Kimi |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 Быстрый старт: если ваш проект ещё на этапе проверки гипотез, рекомендуем через APIYI apiyi.com протестировать Kimi K3.1 Pro и другие популярные модели с одним API-ключом. Сначала убедитесь, что K3.1 Pro лучше всего справляется именно с вашими задачами, и только после этого решайте, стоит ли разворачивать модель самостоятельно.
Частые вопросы о локальном развёртывании Kimi K3.1 Pro
Вопрос 1. Можно ли уже скачать веса Kimi K3.1 Pro?
Пока нет. В оригинале сказано: «Полные веса модели будут выпущены до 4 ноября», то есть до 4 ноября 2026 года. Все оценки оборудования в этой статье основаны на уже открытой модели K3. После выхода весов стоит ещё раз проверить расчёты с учётом фактического размера файлов.
Вопрос 2. Почему Kimi K3.1 Pro не запускается на 8 ускорителях H200?
Общий объём видеопамяти 8 ускорителей H200 — 1,13 ТБ, а измеренный размер весов K3 составляет 1560,9 ГБ. Не хватает около 400 ГБ. Кроме того, архитектура Hopper не поддерживает MXFP4 на аппаратном уровне. Даже на двух серверах с 16 H200 потребуется выполнять обратное квантование во время работы, что снизит скорость.
Вопрос 3. Откуда взялась цифра «в 19 раз дороже»?
Расчёт основан на сторонних замерах: 8 ускорителей B300 на Modal стоят $56.79 в час, а стабильная скорость обработки одного запроса — около 92 токенов/с. В пересчёте получается около $190.00 за миллион выходных токенов. Если разделить эту сумму на официальную цену API для выходных токенов — $10.00, — получим 19 раз. При строгом расчёте для скорости 92 токена/с выходит $171.50: в оценке автора также учтены потери, возникающие при реальной работе.
Вопрос 4. Есть ли у небольшой команды способ сэкономить на самостоятельном развёртывании Kimi K3.1 Pro?
По сути, нет. Покупка оборудования обойдётся примерно в 200 тысяч юаней в месяц — и это без учёта затрат на персонал. Квантование и запуск на одном сервере, наоборот, обойдутся дороже, а качество будет хуже. Для небольшой команды реалистичнее использовать API с оплатой по факту, например вызывать kimi-k3.1-pro через APIYI apiyi.com. Платить нужно только за использование, а для токенов, обслуженных из кэша, стоимость составляет всего $0.20 за миллион.
Вопрос 5. Как быстро вызывать Kimi K3.1 Pro через API?
Зарегистрируйтесь на APIYI apiyi.com и получите ключ. Укажите `https://api.apiyi.com/v1` в качестве `base_url`, а в поле модели — `kimi-k3.1-pro`. Существующий код на OpenAI SDK почти не придётся менять. При этом в многошаговых диалогах не забудьте передавать обратно `reasoning_content`.
Вопрос 6. Какие известные ограничения есть у локального развёртывания Kimi K3.1 Pro?
Их три. Во-первых, холодный запуск занимает около 27 минут, поэтому модель не подходит для эластического масштабирования. Во-вторых, образ vLLM доступен только для CUDA 13, а для драйвера требуется версия r580 или новее. Старые кластеры сначала придётся обновить. В-третьих, распределённый кэш KV не поддерживается ни на одном из перечисленных вариантов оборудования, что ограничивает масштабирование на несколько серверов.
Вопрос 7. Когда локальное развёртывание станет реалистичным вариантом?
Когда сообщество выпустит дистиллированные модели объёмом 30–120 млрд параметров: именно такой формат подойдёт для локального запуска частными пользователями и небольшими командами. Полноразмерные модели на 3 трлн параметров в ближайшее время останутся нагрузкой для дата-центров.
Kimi K3.1 Pro: ключевые выводы о локальном развёртывании
- Веса ещё не опубликованы: разработчики обещают выпустить их до 4 ноября. Все приведённые сейчас цифры рассчитаны по аналогии с K3.
- Минимальные требования к оборудованию: веса занимают 1560,9 ГБ. Для работы на одном сервере потребуется как минимум 8×B300, GB300 или MI355X.
- Расходы в месяц: круглосуточная работа на одном сервере обойдётся примерно в 160–340 тыс. юаней — в зависимости от выбранного варианта.
- Стоимость единицы обработки: при самостоятельном развёртывании — около $190.00 за миллион выходных токенов, то есть в 19 раз дороже официального API.
- Когда локальное развёртывание окупится: при стабильной производительности выше 1 500 токенов/с и ежемесячном объёме генерации на уровне миллиарда токенов.
- С чего начать: сначала подключите kimi-k3.1-pro через APIYI (apiyi.com) и проверьте модель на реальных задачах. Решение о самостоятельном развёртывании принимайте на основе данных.
Чек-лист для выбора способа развёртывания Kimi K3.1 Pro
Ответьте на пять вопросов ниже, чтобы понять, что выбрать: аренду, покупку оборудования или API.
- Требования к соответствию нормам запрещают передавать данные за пределы внутренней сети, и даже официальный ZDR не подходит? — Нет: используйте API.
- Нужно дообучать или дистиллировать модель на основе её весов? — Да: рассмотрите краткосрочную аренду серверов с оплатой по факту использования и отключайте их, когда работа закончена.
- Стабильно ли превышает ежемесячный объём выходных токенов 1,3 млрд? — Нет: самостоятельное развёртывание будет дороже API.
- Уже есть простаивающее оборудование уровня 8×B300 или MI355X и специалисты для его обслуживания? — Да: можно рассмотреть самостоятельное развёртывание. Если нет, не покупайте оборудование специально для этого.
- Нужно ли запускать и останавливать сервис в любой момент, а также гибко менять количество ресурсов? — Да: выбирайте API. Холодный запуск самостоятельно развёрнутой модели занимает 27 минут — для таких задач это слишком долго.
Итоги
Главные выводы о локальном развертывании Kimi K3.1 Pro:
- Высокий порог входа: если ориентироваться на K3, веса займут около 1,56 ТБ — их едва хватит разместить на 8×B300.
- Для личного использования дорого: на одной машине миллион выходных токенов обойдётся примерно в $190, то есть в 19 раз дороже API.
- Своя инфраструктура выгодна только при больших масштабах: о самостоятельном развертывании можно задумываться, если пропускная способность стабильно превышает 1 500 токенов/с, а ежемесячный объём выходных токенов достигает миллиарда.
Для большинства разработчиков и небольших команд в Китае разумнее сначала запустить продукт через API и собрать данные об использовании — а уже потом решать, стоит ли разворачивать модель самостоятельно. Для вызова kimi-k3.1-pro рекомендуем APIYI apiyi.com: цены такие же, как у официального API, новым пользователям доступны бесплатные запросы, а с одним ключом можно заодно сравнить модель с другими популярными решениями.
📚 Источники
- Официальный анонс Kimi K3.1 Pro: сроки публикации весов и позиционирование модели
- Ссылка:
kimi.ai/blog/kimi-k3-1-pro -
Примечание: официальный материал подтверждает, что веса опубликуют до 4 ноября
-
Официальные цены Kimi API: стоимость входных и выходных токенов, а также кэширования для K3.1 Pro
- Ссылка:
platform.kimi.ai/docs/pricing/chat -
Примечание: источник цен API для сравнения в статье
-
Карточка модели Kimi K3: архитектура, квантование и лицензия
- Ссылка:
huggingface.co/moonshotai/Kimi-K3 -
Примечание: 2,8 трлн параметров, квантование MXFP4, лицензия Kimi K3
-
Рецепт развертывания Kimi K3 от vLLM: минимальные требования к видеопамяти и развертыванию
- Ссылка:
recipes.vllm.ai/moonshotai/Kimi-K3 -
Примечание: минимум 8×GB300 и 1 680 ГБ видеопамяти
-
Тестирование инференса на 8×B300 в AWS: данные о пропускной способности
- Ссылка:
github.com/aws-samples/sample-llm-inference-on-eks -
Примечание: суммарная пропускная способность при высокой параллельной нагрузке — 4 634 токена/с
-
Тестирование GPUStack на 8×B300: сравнение vLLM и SGLang на длинном контексте
- Ссылка:
cnblogs.com/gpustack/p/22073008 - Примечание: сквозное время обработки входных данных объёмом 64K и 200K токенов
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Больше материалов о подключении моделей — в центре документации docs.apiyi.com