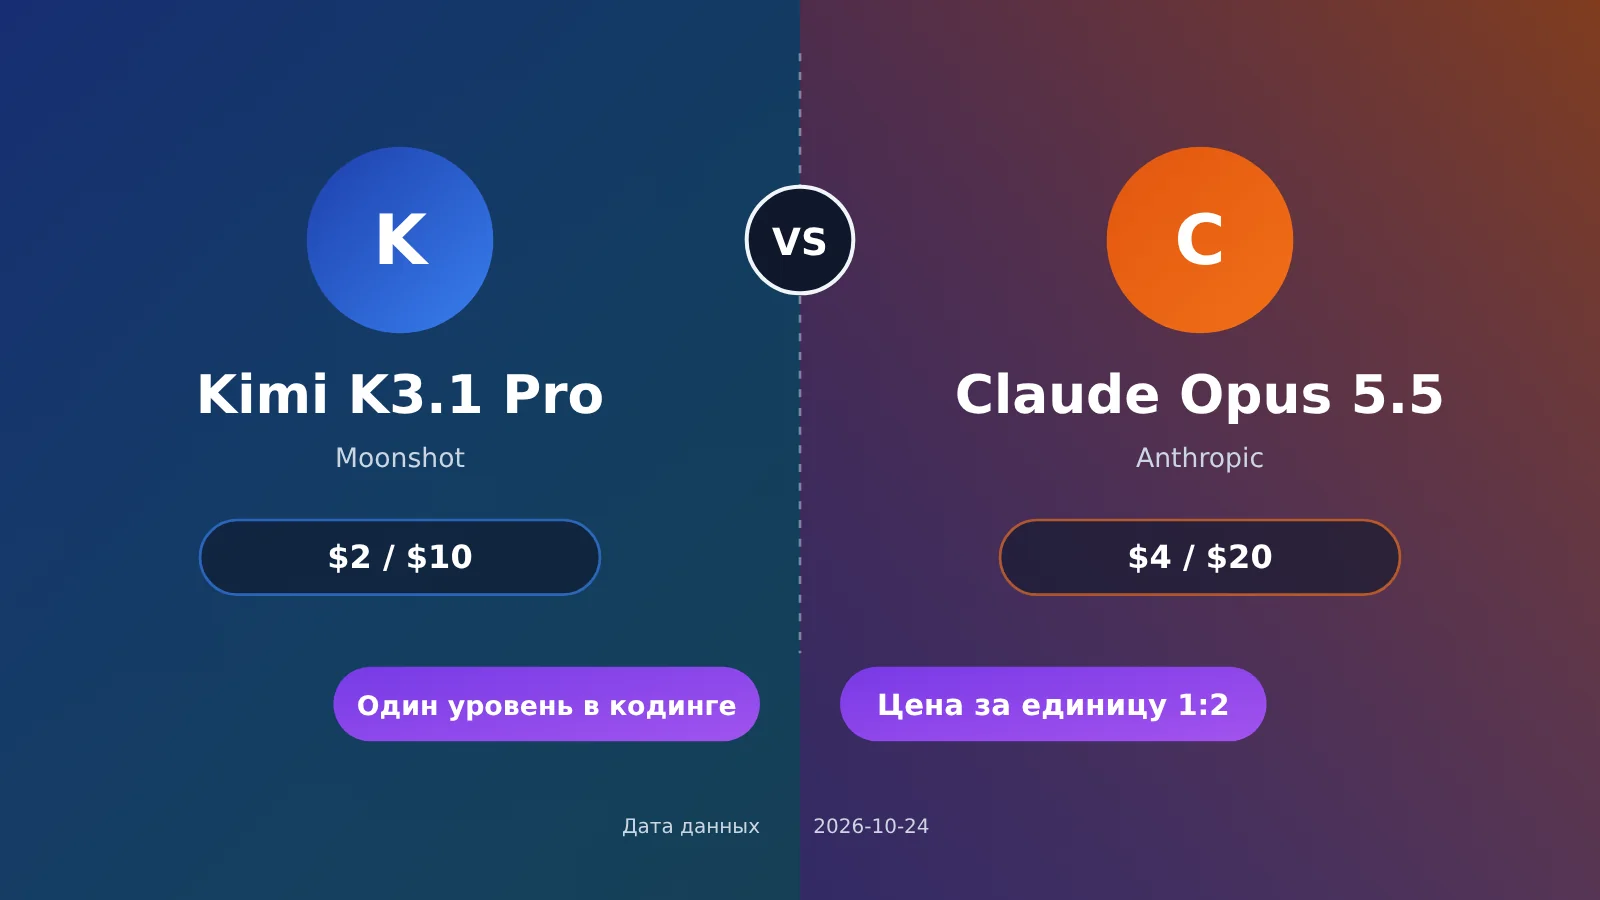
Сразу к выводам: по возможностям в программировании Kimi K3.1 Pro и Claude Opus 5.5 находятся в одном классе. По данным, опубликованным Moonshot, в Terminal-Bench 4.0 K3.1 Pro набрал 65,7%, а Opus 5.5 — 66,4%. Отставание первой модели составляет около 0,7 процентного пункта. А если смотреть только на Terminal-Bench 4.0 по данным стороннего источника Artificial Analysis, K3.1 Pro и вовсе занимает первое место. Что касается цены, входные и выходные токены K3.1 Pro стоят ровно вдвое дешевле, чем у Opus 5.5 ($2/$10 против $4/$20), а цена при попадании в кэш у моделей одинаковая. Однако K3.1 Pro дольше обдумывает задачу, поэтому, по оценкам сторонних аналитиков, фактическая стоимость выполнения одной задачи оказывается не вдвое ниже.
Все данные ниже снабжены указанием источника и разделены на три категории: официальные данные (блог Moonshot, официальная документация Kimi и Anthropic), сторонние данные (Artificial Analysis, далее — AA) и непроверенные данные (публичных данных пока нет, поэтому можно говорить лишь о примерных тенденциях). Под токенами в статье понимается единица, по которой модели рассчитывают стоимость: на один китайский иероглиф приходится чуть больше одного токена. Все цены указаны в долларах за миллион токенов.
Эта статья не о том, «кто кого разгромил». У обеих моделей есть сильные и слабые стороны. Мы приведём данные в сопоставимом формате и поможем выбрать модель для разных задач.
Что вы узнаете: прочитав статью, вы сможете понять, что лучше подойдёт для ваших задач — Kimi K3.1 Pro или Claude Opus 5.5, — и оценить реальную разницу в стоимости.
1. Kimi K3.1 Pro и Claude Opus 5.5: ключевые различия
Для начала сведём основные различия в таблицу, а дальше разберём каждый пункт подробнее. В столбце «Источник» указано, откуда взята каждая цифра, — так её будет проще проверить.
| Параметр | Kimi K3.1 Pro | Claude Opus 5.5 | Источник |
|---|---|---|---|
| Terminal-Bench 4.0 (официальные данные) | 65,7% | 66,4% | Данные самих разработчиков (блог Moonshot) |
| Terminal-Bench 4.0 (данные AA) | 67% — лучший результат среди моделей, протестированных AA | В источниках нет данных | Сторонний источник (AA) |
| Цена за ввод / вывод | $2 / $10 | $4 / $20 | Официальные цены |
| Цена при попадании в кеш | $0,20 | $0,20 | Официальные цены |
| Длина контекстного окна | 1 048 576 токенов | До 1 млн токенов (зависит от модели) | Официальная документация |
| Можно ли отключить режим рассуждений | Нет, можно только настроить его интенсивность | Согласно документации Anthropic | Официальная документация / не проверено |
| Открытые веса | Обещают выпустить до 2026-11-04 | Не открыты | Данные самих разработчиков |
Под «контекстом» здесь имеется в виду весь объём информации, который модель может обработать за один раз. У обеих моделей контекстное окно достигает миллиона токенов, поэтому в него обычно можно поместить целиком средний репозиторий кода. Так что этот параметр вряд ли станет решающим при выборе.
2. Kimi K3.1 Pro и Claude Opus 5.5: сравнение цен по 5 категориям
Сначала разберём два термина, связанные с оплатой. Попадание в кэш: если вы несколько раз отправляете один и тот же фрагмент в начале запроса — например, системный промпт или сводку по репозиторию с кодом, — провайдер сохраняет его в кэше, а при повторном чтении взимает гораздо меньшую плату. Запись в кэш: стоимость первого сохранения этого фрагмента. Цена зависит от того, хранится он 5 минут или 1 час.
| Модель | Ввод | Вывод | Попадание в кэш | Запись в кэш на 5 минут | Запись в кэш на 1 час |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (для сравнения) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Примечание о ценах: данные получены 24.10.2026. Цены указаны в долларах за миллион токенов, без учёта налогов. Источники: официальные страницы цен Kimi и Anthropic.
2.1 В чём разница в цене: ввод и вывод дороже в 2 раза, попадание в кэш стоит одинаково
Ввод и вывод у Opus 5.5 стоят ровно в 2 раза дороже, чем у K3.1 Pro. Цена за попадание в кэш у обеих моделей одинаковая — $0.20. Запись в кэш у Kimi обходится дешевле: $2 против $5 для хранения на 5 минут и $4 против $8 для хранения на 1 час.
Если добавить для сравнения Claude Sonnet 5.5, окажется, что ввод и вывод у него стоят столько же, сколько у K3.1 Pro, а попадание в кэш — вдвое дешевле ($0.10). Поэтому, если вам нужна «чуть более доступная модель флагманского уровня», Kimi стоит сравнивать не только с Opus 5.5, но и с Sonnet 5.5.
2.2 У обеих моделей есть высокоскоростная версия
Обе компании предлагают более быстрые и дорогие версии моделей. При выборе проверяйте, что сравниваете нужные версии:
kimi-k3.1-pro-highspeed: $4 / $20, попадание в кэш — $0.20, запись в кэш на 5 минут — $4, на 1 час — $8 (официальные цены)- Claude Opus 5.5 в режиме Fast: $8 / $40; цена распространяется на контекст любого размера, в том числе свыше 200k (официальные цены)
Видно, что цены на ввод и вывод у высокоскоростной версии Kimi такие же, как у обычной версии Opus 5.5, но запись в кэш на 5 минут всё равно обходится дешевле.
3. Kimi K3.1 Pro и Claude Opus 5.5: результаты в программировании — сравниваем отдельно по двум методикам
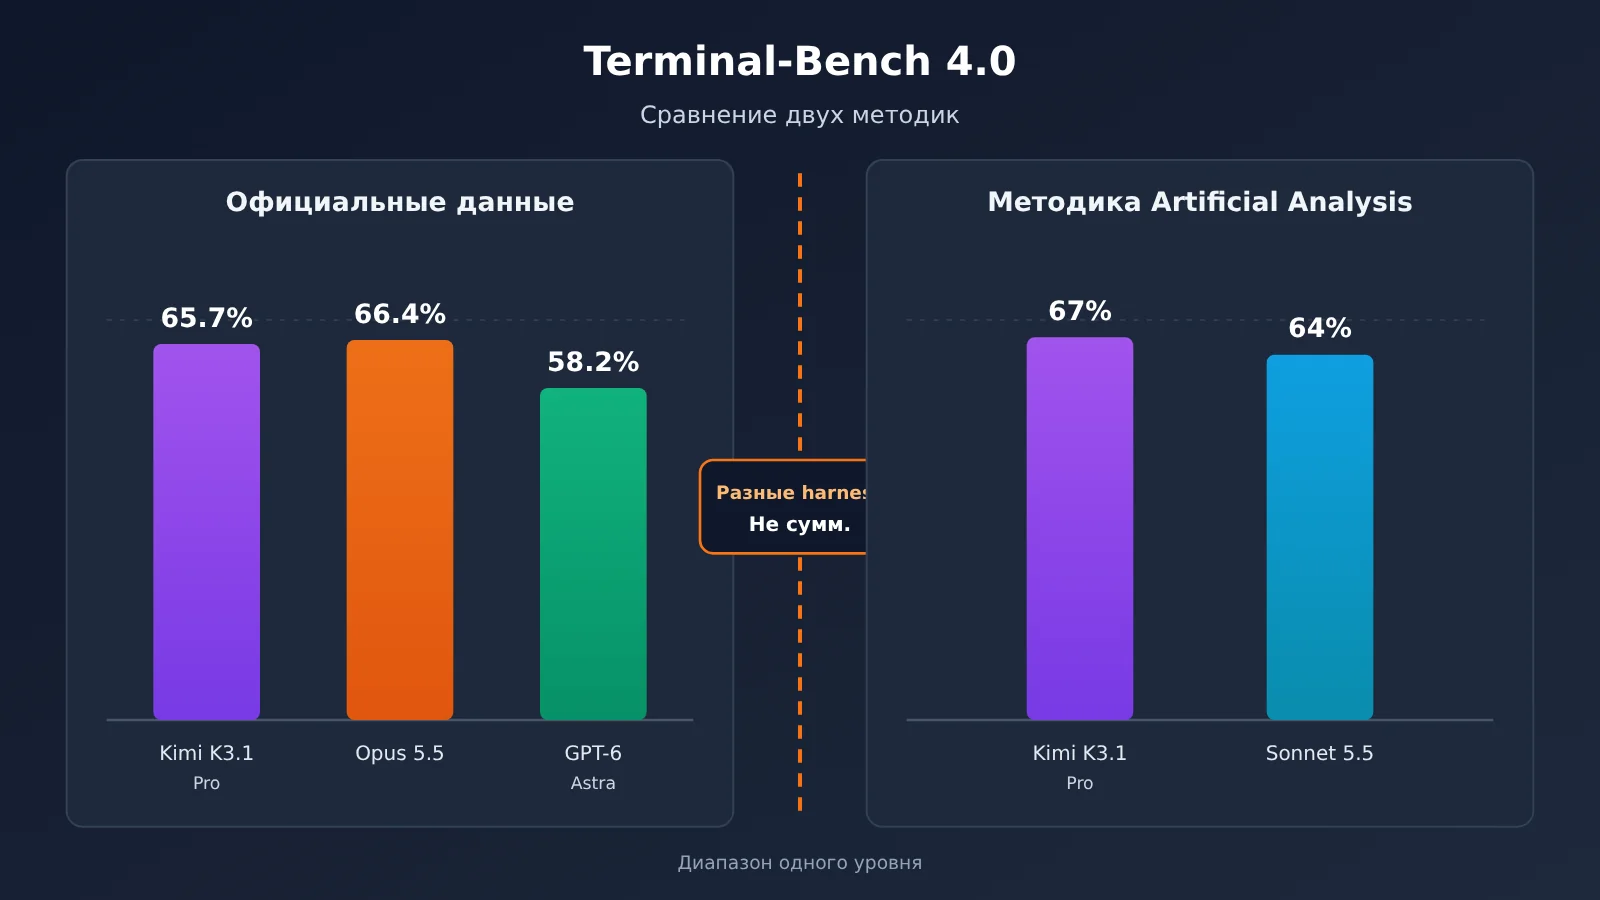
Terminal-Bench 4.0 — это набор тестов, в которых нужно выполнять реальные задачи в терминале: например, устанавливать зависимости, исправлять баги и запускать скрипты. Тест засчитывается, только если в итоге задача выполнена правильно. Две таблицы ниже составлены разными организациями, поэтому сравнивать цифры между собой нельзя.
3.1. По данным самой компании (блог Moonshot)
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD (восстановление 3D-моделей по коду CAD, созданному из изображений с нескольких ракурсов) | 92.7% (с инструментами) | 96.2% | — |
Тестирование проводилось при reasoning_effort = max — то есть интенсивность рассуждений была выставлена на максимум. K3.1 Pro запускали с использованием harness из Claude Code. В блоге Moonshot описывает результат так: «narrowly behind Claude Opus 5.5», то есть модель немного уступает Opus 5.5.
3.2 Данные стороннего источника (Artificial Analysis, 23.10.2026)
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (общий индекс интеллекта) | 55 (4-е место) | 58 | 56 |
| Terminal-Bench 4.0 | 67% (лучший результат среди всех моделей) | В источнике нет данных | 64% |
| GDPval-AA (Elo) | 1846 (3-е место) | 1866 | — |
| AA-Omniscience (надёжность знаний) | Индекс 30, доля галлюцинаций — 44% | В источнике нет данных | — |
Для Opus 5.5 индекс рассчитан в условиях «max with fallback». Muse Wonder Full, которая тоже есть в рейтинге, набрала 56 баллов. Elo — алгоритм, похожий на шахматный рейтинг: он рассчитывается по результатам попарных сравнений, и чем выше балл, тем лучше. Долю галлюцинаций можно понимать как процент случаев, когда модель выдумывает ответ, если не может ответить. Показатель K3.1 Pro в 44% стоит иметь в виду.
3.3 Почему нельзя смешивать данные из двух источников
Официальный результат K3.1 Pro в 65,7% и результат Artificial Analysis в 67% получены в Terminal-Bench 4.0, но с разными harness — тестовыми оболочками. Harness можно представить как программу, которая организует экзамен модели: она определяет, какими инструментами модель может пользоваться, как читать и записывать файлы и сколько времени отводится на выполнение. Если оболочку поменять, изменится и результат той же модели.
Поэтому некорректно утверждать: «K3.1 Pro набрала в AA 67% — это выше, чем официальные 66,4% Opus». Правильнее сравнивать так: по официальным данным K3.1 Pro уступает на 0,7 процентного пункта; по данным AA это лучшая модель из всех, которые тестировала эта организация. Оба вывода верны, а вместе они лишь показывают, что модели находятся примерно на одном уровне.
3.4 Что означает разница в один балл на практике
В Terminal-Bench 4.0 оценка по каждому заданию бинарная: либо зачёт, либо незачёт. Разница в один процентный пункт — это примерно одно дополнительное или пропущенное задание из ста. Такие расхождения часто возникают на редких задачах, например при работе с малоизвестными инструментами или настройке особых окружений. В повседневной работе — при написании API, изменении бизнес-логики и добавлении модульных тестов — разница такого масштаба почти не ощущается.
На удобство разработки сильнее влияют различия в «характерах» моделей. Во-первых, стиль рассуждений: K3.1 Pro всегда работает в режиме размышления, и AA заметила, что на каждое задание она выдаёт более длинный ответ (по данным третьей стороны). Во-вторых, привычки при вызове инструментов: как часто модель запускает команды, предпочитает ли сначала прочитать файл и только потом вносить изменения. Надёжных публичных сравнительных данных по этому вопросу пока нет (не подтверждено), поэтому лучше проверить модели на нескольких реальных задачах в собственном репозитории.
4. Преимущества и ограничения Kimi K3.1 Pro и Claude Opus 5.5
Преимущества Kimi K3.1 Pro (по официальной документации):
- Стоимость входных и выходных токенов вдвое ниже, чем у Opus 5.5; запись в кэш тоже обходится дешевле.
- Контекстное окно на 1 048 576 токенов; значение
max_completion_tokensпо умолчанию — 131072, максимум — 1048576. - Совместимость с форматами API OpenAI и Anthropic. Разработчики рекомендуют использовать модель в программных агентах вроде Kimi Code, Codex и Claude Code.
- Поддерживаются структурированный вывод, вызов инструментов и продолжение генерации с параметром
partial. Клиенты API могут выбрать режим без хранения данных; компания обещает открыть полные веса до 2026-11-04.
Ограничения Kimi K3.1 Pro (по официальной документации и данным третьих сторон):
- Отключить режим размышления нельзя. Для
reasoning_effortдоступны значенияlow,highиmax; по умолчанию установленоmax. - Значение
temperatureзафиксировано на уровне 1.0, аtop_p— 0.95. Передать другие значения этих параметров нельзя. - Для изображений нельзя использовать публичные URL: их можно передать только в кодировке base64 (изображение преобразуется в длинную строку текста) или через
ms://file-id. - По результатам тестов AA, частота галлюцинаций составляет 44%, а ответы на отдельные задания получаются длинными.
Преимущества Claude Opus 5.5: по официальным результатам тестов и сводному индексу AA модель занимает более высокие позиции. В BenchCAD её результат примерно на 3,5 процентного пункта выше, а показатель GDPval-AA также выше. Доступны кэширование на один час и режим Fast, позволяющий выбирать баланс между скоростью и стоимостью. Главный недостаток — цена: обработка входных и выходных токенов обходится вдвое дороже, чем у K3.1 Pro, а режим Fast увеличивает стоимость ещё в два раза.
5. Kimi K3.1 Pro и Claude Opus 5.5: какую модель выбрать для разных задач
«Агент» — это приложение на базе модели, которое самостоятельно планирует шаги, вызывает инструменты и выполняет задачу в несколько этапов. Например, помощник для программирования может сам изменить код, а затем запустить тесты.
| Тип задачи | Рекомендация | Краткий вывод |
|---|---|---|
| Массовая пакетная обработка | Kimi K3.1 Pro | Стоимость вдвое ниже, а запись в кэш тоже дешевле. Экономия особенно заметна при обработке большого числа задач |
| Многошаговый агент для программирования | Подойдут обе модели — рекомендуем протестировать | Результаты бенчмарков сопоставимы. В первую очередь оцените, подходят ли вам длина рассуждений и особенности вызова инструментов при работе с вашим репозиторием |
| Генерация кода для 3D и CAD | Claude Opus 5.5 | По опубликованным самой компанией результатам BenchCAD, Opus 5.5 набрала 96,2% против 92,7% — она работает стабильнее |
| Понимание изображений | Выбирайте с учётом способа интеграции | K3.1 Pro поддерживает изображения, но не принимает общедоступные URL напрямую. Для сравнения возможностей обеих моделей нет данных, полученных по единой методике (не проверено) |
| Корпоративные задачи с требованиями к стабильности и соответствию нормам | Скорее Claude Opus 5.5; если важно контролировать данные — рассмотрите Kimi | Общий индекс у Opus 5.5 выше. Kimi предлагает режим без сохранения данных, а её веса скоро станут открытыми |
| Задачи с низкой задержкой, где нужно отключить рассуждения | Модели Claude | В K3.1 Pro нельзя отключить рассуждения. Настройки рассуждений Claude уточняйте в документации Anthropic; также можно попробовать режим Fast |
6. Kimi K3.1 Pro vs Claude Opus 5.5: считаем расходы — цена за токен вдвое ниже, но затраты не обязательно сократятся вдвое
Для начала посчитаем на простом примере: один и тот же запрос, 50 тысяч входных токенов и 5 тысяч выходных.
- Kimi K3.1 Pro: 50 тыс. × $2 ÷ 1 млн + 5 тыс. × $10 ÷ 1 млн = $0,10 + $0,05 = $0,15
- Claude Opus 5.5: 50 тыс. × $4 ÷ 1 млн + 5 тыс. × $20 ÷ 1 млн = $0,20 + $0,10 = $0,30
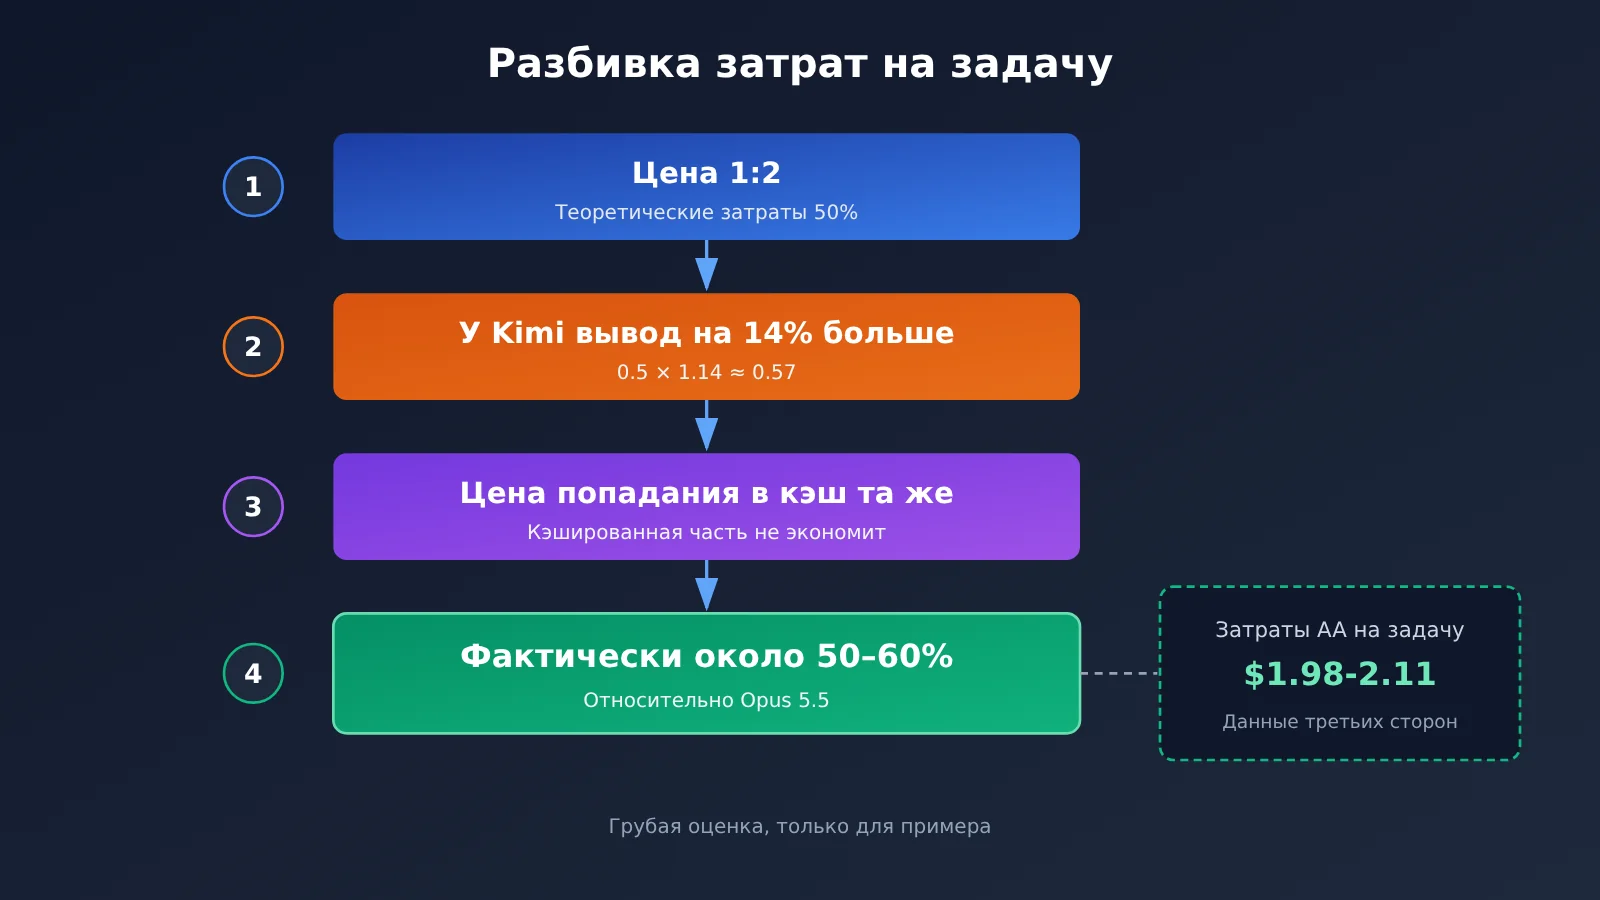
По цене за токен получается ровно вдвое дешевле. Но это справедливо, только если оба модели выдают одинаковое количество токенов. На практике это не так. По данным AA, Kimi генерирует примерно на 14% больше выходных токенов на задачу: в среднем около 55 тыс. токенов, а стоимость одной задачи составляет примерно $1,98 (на странице модели указано $2,11) (сторонний источник). Вывод AA: Kimi стоит за токен вдвое дешевле Opus 5.5, но его рассуждения более многословны, поэтому реальная стоимость одной задачи не сокращается вдвое.
Прикинем приблизительно (оценка не проверена и приведена только для примера): в задачах для программирующих агентов основная часть расходов приходится на генерацию. Если Kimi выдаёт на 14% больше токенов, затраты на генерацию составят примерно 1,14 × 0,5 ≈ 57% от стоимости Opus 5.5. То есть экономия будет чуть больше 40%, а не 50%. Это всё равно заметная экономия — просто при планировании бюджета не стоит рассчитывать на сокращение расходов ровно наполовину.
7. Как вызывать Kimi K3.1 Pro и Claude Opus 5.5 из Китая
Разработчики в Китае при прямом подключении к зарубежным официальным API часто сталкиваются с проблемами оплаты и доступа к сети. APIYI (apiyi.com) — это агрегатор API: с одним API-ключом можно вызывать разные модели. Интерфейс совместим с форматом OpenAI, оплата — по фактическому использованию.
По данным на 24 октября 2026 года, цены на claude-opus-5-5 на платформе составляют $4 за входные токены, $20 за выходные и $0.2 за чтение кэша. Для claude-sonnet-5-5 — $2 / $10 / $0.1 соответственно. Цены совпадают с официальными тарифами Anthropic. На платформе уже доступны следующие модели Kimi:
kimi-k3: $3 / $15, чтение кэша — $0.3kimi-k2.7-code: $0.95 / $3.99kimi-k2.6: $0.6 / $2.4kimi-k2.5: $0.6 / $3.15
На эту дату kimi-k3.1-pro ещё нет в списке. Название модели и её стоимость в APIYI уточняйте в списке моделей платформы. Мы постараемся добавить её как можно скорее. Подключение настраивается так:
- Формат, совместимый с OpenAI: укажите
https://api.apiyi.com/v1в параметреbase_url - Формат Anthropic: укажите
https://api.apiyi.comв качестве базового адреса - Программные агенты (например, Claude Code) обычно используют формат Anthropic, а обычные SDK — формат OpenAI
Совет для быстрого старта: начните с бесплатного лимита для новых пользователей на APIYI apiyi.com. Запустите
claude-opus-5-5иclaude-sonnet-5-5на нескольких реальных задачах в своём репозитории — так вы получите базовые результаты для сравнения. Актуальные названия моделей и цены смотрите в списке на платформе. Мы постараемся как можно скорее добавить Kimi K3.1 Pro: после запуска достаточно будет переключить название модели, чтобы сравнить её с остальными.
8. Kimi K3.1 Pro vs Claude Opus 5.5: рекомендации по выбору
Если у вас большой объём задач, ограниченный бюджет и вы готовы к тому, что модель будет постоянно работать в режиме рассуждений, Kimi K3.1 Pro выгоднее. Если для вас важна общая стабильность, нужно создавать 3D-модели или CAD-проекты либо отключать режим рассуждений ради низкой задержки, лучше подойдут модели Claude — Opus 5.5 или Sonnet 5.5. В задачах с многошаговыми программными агентами результаты у обеих моделей примерно на одном уровне. Вместо того чтобы ориентироваться на рейтинги, лучше протестировать их на собственной кодовой базе в течение недели.
Есть ещё один вариант, который легко упустить: если вы присматриваетесь к Kimi в основном потому, что она «вдвое дешевле», учтите, что цена входных и выходных токенов у Claude Sonnet 5.5 точно такая же, стоимость при попадании в кэш ниже, а общий индекс AA немного выше. Sonnet 5.5 тоже стоит включить в список кандидатов.
Часто задаваемые вопросы
Вопрос 1. Насколько Kimi K3.1 Pro уступает Claude Opus 5.5 в программировании?
По собственным данным Moonshot, в Terminal-Bench 4.0 K3.1 Pro отстаёт на 0,7 процентного пункта: 65,7% против 66,4%. По результатам независимого тестирования AA, K3.1 Pro показала лучший результат среди всех протестированных моделей в Terminal-Bench 4.0. Обе модели находятся примерно на одном уровне, разница составляет около 1–3 процентных пунктов.
Вопрос 2. Во сколько раз отличаются цены?
Цена за ввод и вывод отличается в 2 раза, стоимость попадания в кэш одинаковая — $0,20, а запись в кэш у Kimi дешевле. С учётом того, что Kimi генерирует более длинные ответы, реальная стоимость одной задачи составляет примерно от половины до трёх пятых от стоимости работы с Opus 5.5 (оценка).
Вопрос 3. Почему официальный результат — 65,7%, а у AA — 67%?
В тестах использовались разные оболочки (harness): официальный тест запускался с Claude Code harness. Результаты, полученные по разным методикам, можно сравнивать только в рамках каждой из них — напрямую сопоставлять их нельзя.
Вопрос 4. Можно ли отключить рассуждения в Kimi K3.1 Pro?
Нет. Можно только снизить параметр `reasoning_effort` до `low`; значения `temperature` и `top_p` тоже фиксированы. Если для вас критична задержка, рассмотрите модели Claude.
Вопрос 5. Как в Китае сравнить обе модели, вызывая их через API?
Можно вызывать `claude-opus-5-5` через APIYI apiyi.com, используя один и тот же API-ключ. Достаточно указать `base_url` со значением `https://api.apiyi.com/v1`. Название модели Kimi K3.1 Pro и её цена зависят от списка моделей на платформе. Мы постараемся добавить эту модель как можно скорее. Пока можно для предварительного сравнения использовать `kimi-k3`.
Вопрос 6. С какой модели новичку выгоднее начать?
Советуем начать с Claude Sonnet 5.5 и использовать её результаты как базовый уровень: цена этой модели такая же, как у K3.1 Pro. После регистрации на APIYI apiyi.com доступен бесплатный тестовый лимит. Актуальные названия моделей и цены смотрите в списке моделей на платформе. Мы постараемся добавить K3.1 Pro как можно скорее — после запуска можно будет сравнить модели, просто указав другое название.
Kimi K3.1 Pro vs Claude Opus 5.5: главные выводы
- Программирование — один уровень: по официальным данным K3.1 Pro уступает 0,7 процентного пункта, а по оценке AA показывает лучший результат в Terminal-Bench 4.0
- Цена отличается в 2 раза: $2/$10 против $4/$20; цена при попадании в кэш одинаковая — $0,20
- Расходы не сокращаются вдвое: Kimi генерирует примерно на 14% больше токенов на задачу; по замерам AA одна задача обходится в $1,98–2,11
- Не стоит смешивать методики: официальные 65,7% и 67% от AA получены с разными harness
- Сильные стороны Opus: лидерство по сводному индексу, BenchCAD и GDPval-AA
- Ограничения Kimi: режим мышления нельзя отключить, изображения нельзя передавать по публичному URL, уровень галлюцинаций — 44%
- Как попробовать: Claude можно протестировать на APIYI apiyi.com; модели K3.1 Pro и цены на неё будут указаны в списке моделей платформы. Мы постараемся добавить её как можно скорее
Итоги
Сравнение Kimi K3.1 Pro и Claude Opus 5.5 можно свести к трём пунктам:
- Возможности: модели находятся примерно на одном уровне в программировании и задачах с агентами; разница в результатах укладывается в погрешность тестов и различия в методиках оценки.
- Цена: цена за токен отличается ровно в 2 раза, но Kimi дольше обдумывает задачи, поэтому на практике экономия составляет чуть больше 40%.
- Выбор модели: для пакетной обработки и сценариев с ограниченным бюджетом стоит рассмотреть Kimi; для 3D/CAD, низкой задержки и высокой общей стабильности — Claude.
Надёжнее всего проверить модели на собственных задачах. Для начала можно прогнать Claude через APIYI apiyi.com и получить базовые результаты. Названия моделей и цены смотрите в списке моделей платформы. Мы постараемся добавить Kimi K3.1 Pro как можно скорее: после запуска достаточно будет переключить название модели, чтобы сравнить результаты.
Справочные материалы
- Официальный блог Moonshot и документация Kimi API: результаты K3.1 Pro в бенчмарках, ограничения параметров и цены
- Ссылка:
platform.moonshot.cn/docs -
Примечание: официальные данные о результатах Terminal-Bench 4.0 и BenchCAD, а также описание параметров
-
Официальные цены Anthropic: пять тарифов для Claude Opus 5.5 / Sonnet 5.5
- Ссылка:
anthropic.com/pricing -
Примечание: включает режим Fast и тариф с кэшированием на 1 час
-
Artificial Analysis: сторонние сводные индексы и стоимость выполнения отдельных задач
- Ссылка:
artificialanalysis.ai -
Примечание: данные на 2026-10-23, включая Terminal-Bench 4.0, GDPval-AA и AA-Omniscience
-
Список моделей APIYI: модели платформы и цены
- Ссылка:
docs.apiyi.com/models - Примечание: данные проверены 2026-10-24; актуальную информацию смотрите в списке моделей на платформе
Автор: техническая команда APIYI
Технические обсуждения: больше материалов можно найти в центре документации docs.apiyi.com. Список моделей и цены на платформе могут меняться. Мы постараемся как можно скорее добавить Kimi K3.1 Pro.