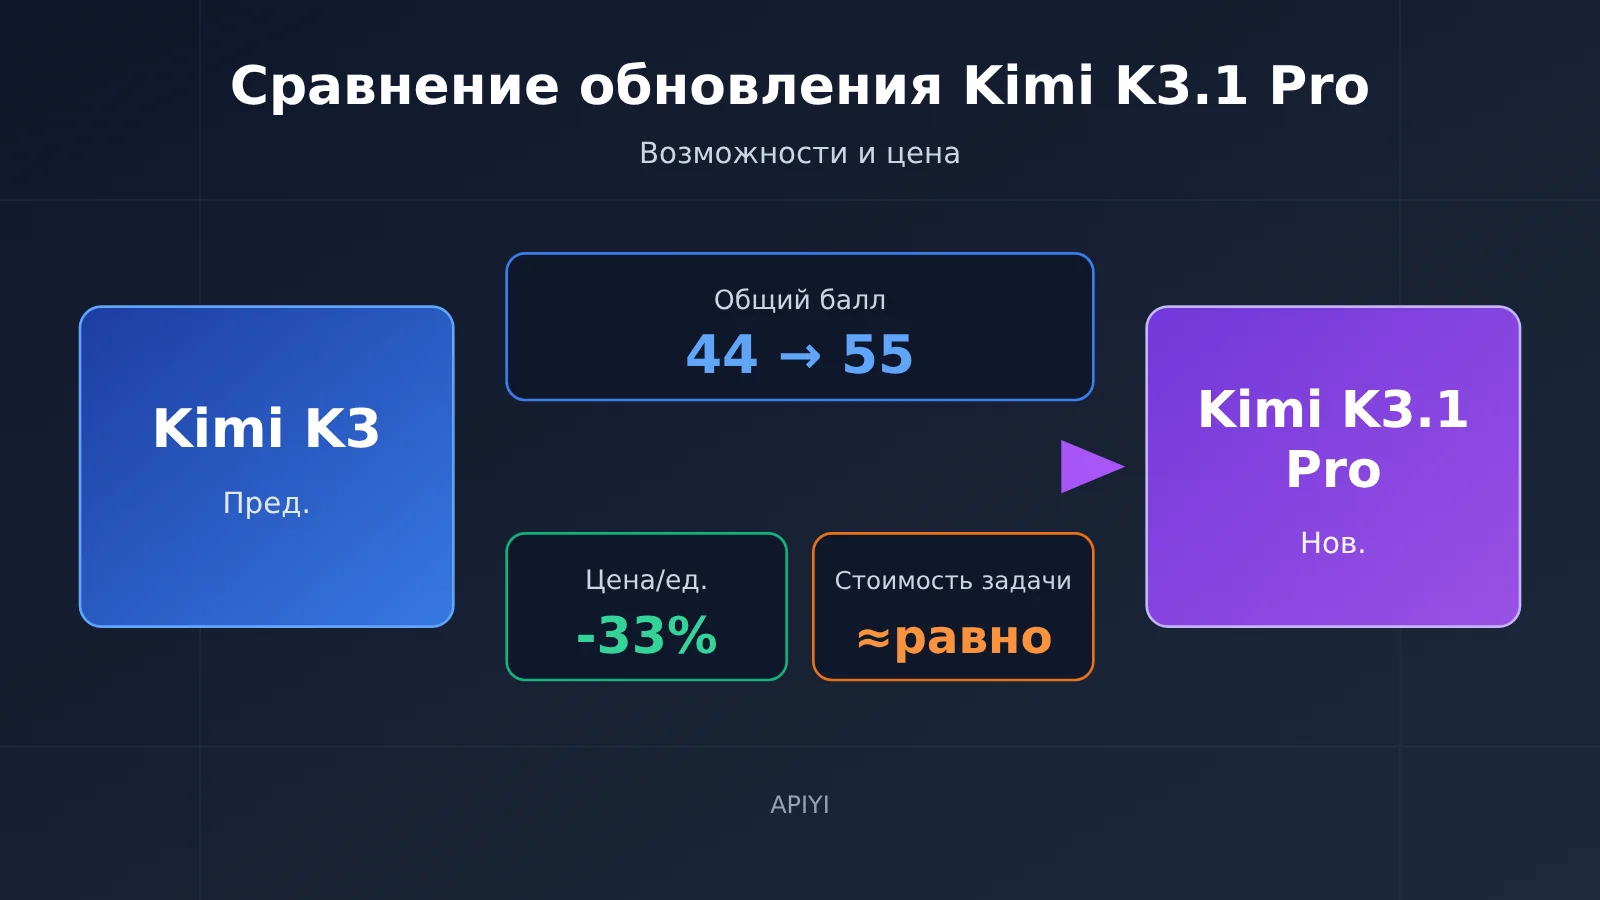
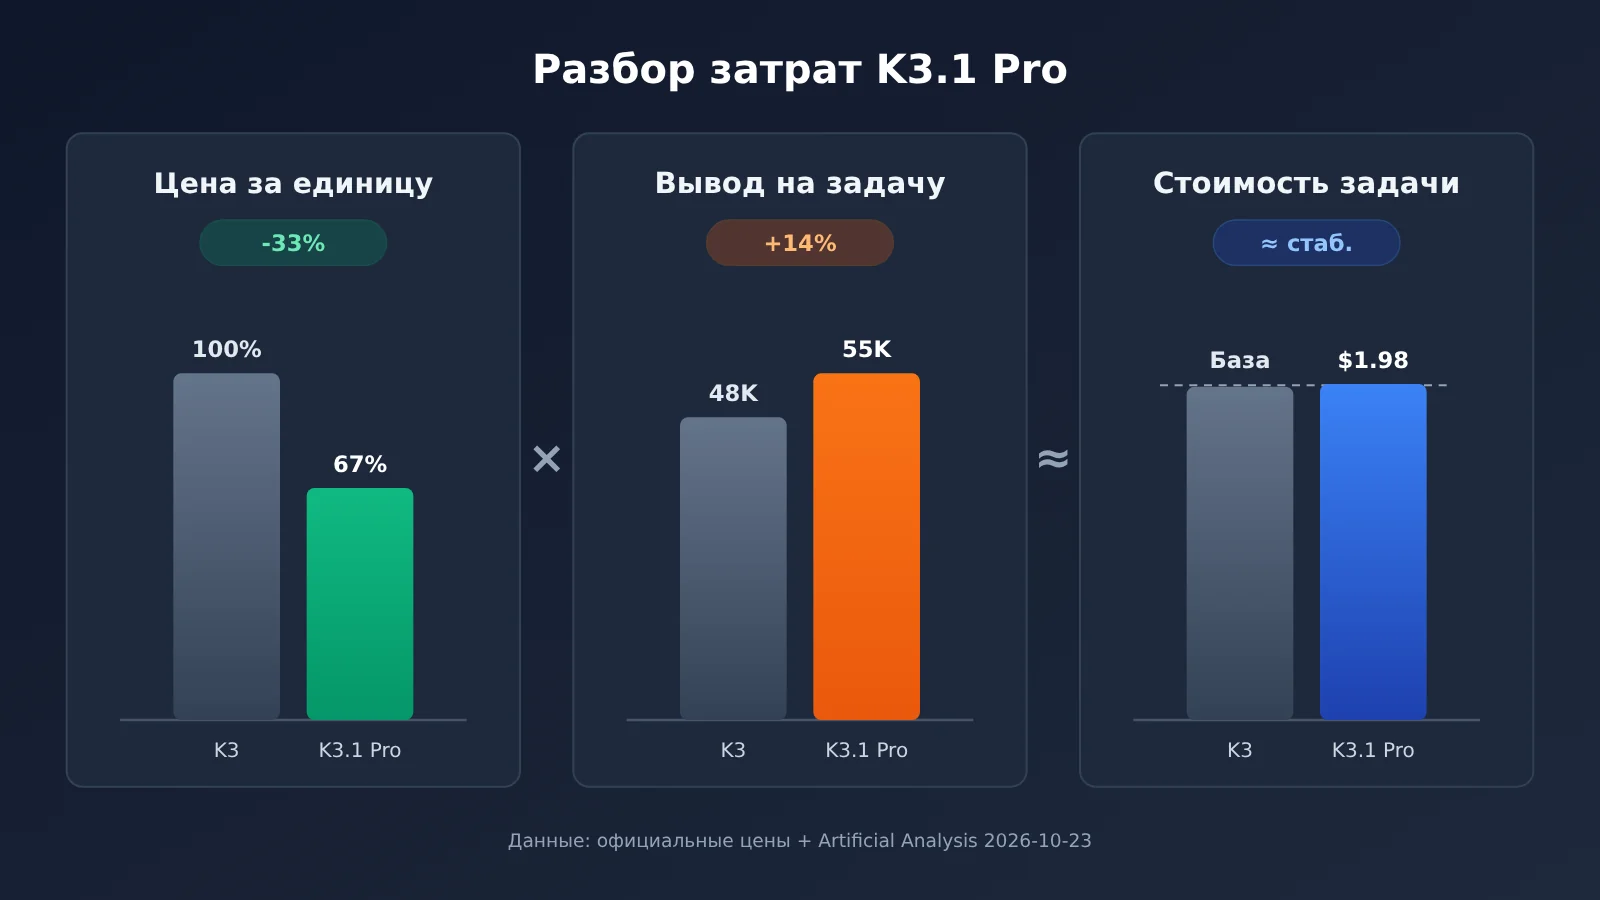
По возможностям Kimi K3.1 Pro заметно превосходит K3: общий балл по оценке сторонней организации Artificial Analysis вырос с 44 до 55, а результат в Terminal-Bench 4.0 — рейтинге терминальных задач для программирующих агентов — поднялся с 13% до 67%. При этом цена снизилась на треть: стоимость входных и выходных данных, а также кэшированных токенов на 33% ниже, чем у K3. Но модель выдаёт больше токенов и всегда рассуждает, поэтому фактическая стоимость выполнения одной задачи примерно такая же, как у K3.
Ниже приведены подтверждающие данные. Для каждого пункта указан источник: «официальные данные», «сторонние данные» или «не проверено». Это не пересказ презентации и не призыв немедленно переходить на новую модель. Цель статьи — помочь разработчикам, которые уже используют K3, понять, стоит ли переносить на неё свои задачи, когда это лучше сделать и на что обратить внимание при переходе.
1. Пять ключевых отличий Kimi K3.1 Pro от предыдущей версии
K3.1 Pro — не новая модель, обученная с нуля, а результат масштабного постобучения K3. Постобучение — это дополнительная настройка модели после обучения базовой версии с помощью новых данных и обратной связи, которая помогает скорректировать её поведение. По словам разработчиков, это «первая модель серии K3.1» и «самая мощная модель с открытыми весами класса 3T». Открытые веса означают, что файлы параметров модели будут доступны для скачивания, и её можно будет развернуть самостоятельно. По данным Artificial Analysis, общее число параметров составляет 2,8T, из них при каждом вычислении активируются 104B.
| Параметр | Kimi K3 | Kimi K3.1 Pro | Источник |
|---|---|---|---|
| Способ обучения | Базовая версия | Постобучение на основе K3 с существенным увеличением вычислительных ресурсов | Официальные данные |
| Общие возможности | Intelligence Index — 44 | 55, 4-е место в общем рейтинге | Сторонние данные (AA, 2026-10-23) |
| Цена | Ввод: $3 / вывод: $15 | Ввод: $2 / вывод: $10, снижение на 33% | Официальные цены |
| Объём вывода на задачу | В среднем 48K токенов | В среднем 55K токенов, на 14% больше | Сторонние данные (AA) |
| Контекстное окно / модальности | 1M / текст и изображения | 1M / текст и изображения, без изменений | Официальные данные |
Токены — базовые единицы измерения и тарификации модели. Условно их можно представить как фрагменты слов: на один китайский иероглиф обычно приходится от одного до двух токенов. При чтении таблицы прежде всего обратите внимание на два изменения: оценка возможностей выросла, а цена снизилась. Строка «Объём вывода на задачу» показывает, насколько на деле удастся сэкономить после снижения цены. Подробнее об этом — в разделе 4.
Разработчики обещают опубликовать полные веса до 2026-11-04. На момент написания статьи (2026-10-24) это пока только обещание, которое ещё не выполнено, поэтому статус пункта — «не проверено». По оценке Artificial Analysis, после публикации весов K3.1 Pro станет моделью с открытыми весами с самым высоким баллом в рейтинге организации. Разрыв между лучшей моделью с открытыми весами и лучшей моделью с закрытыми весами сократится с 12 до 3 баллов.
2. Сравнение результатов Kimi K3.1 Pro: официальные данные и оценки сторонних тестировщиков
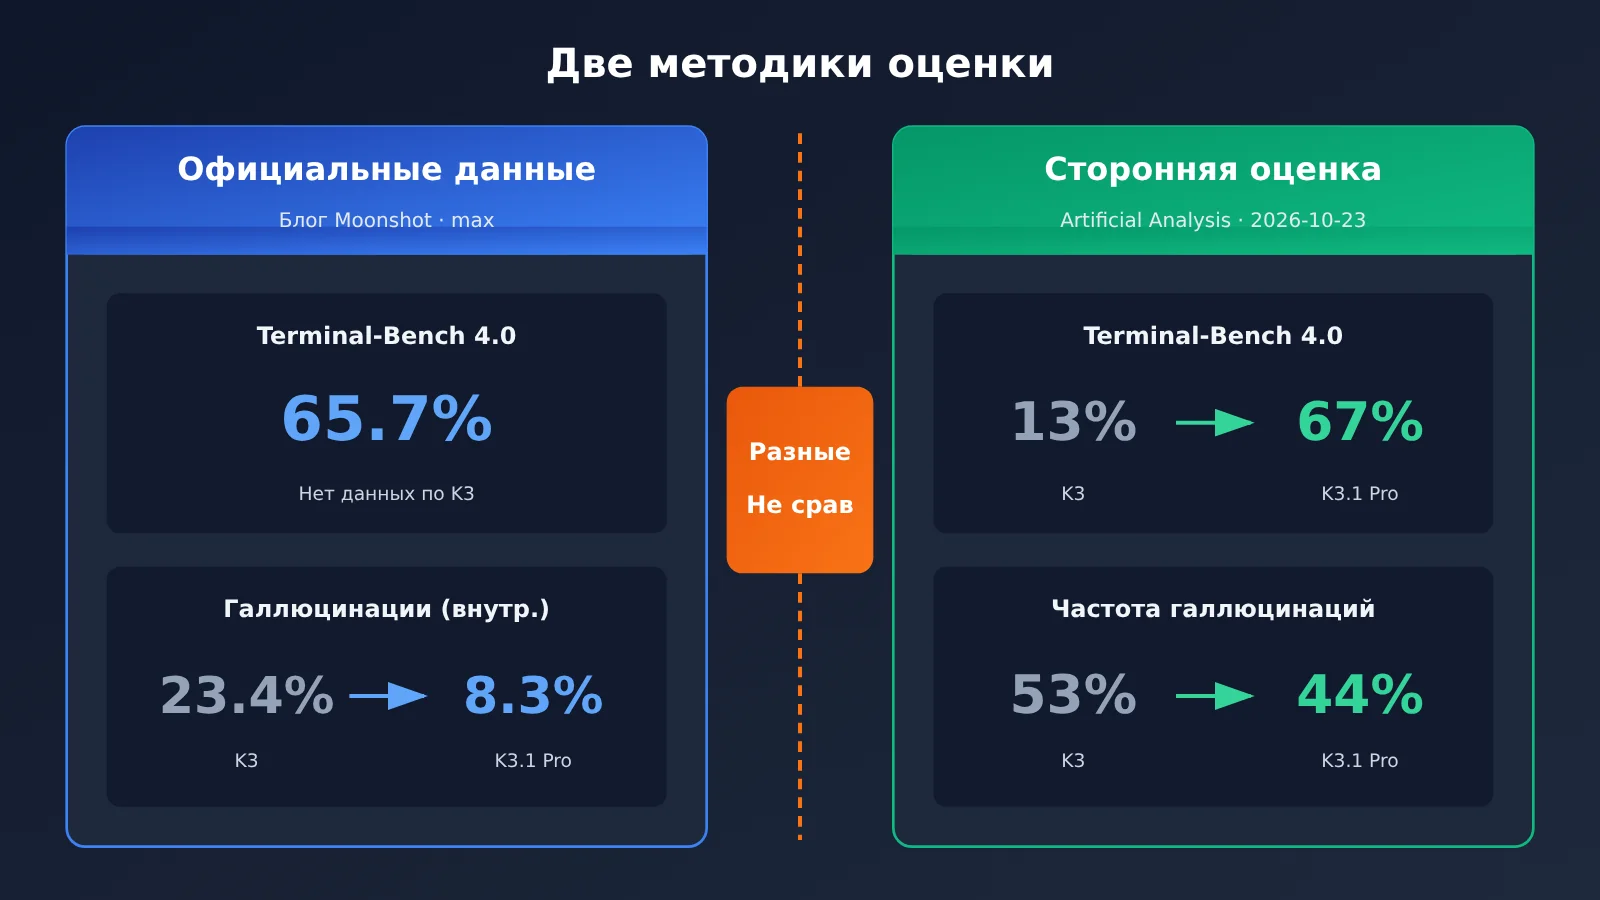
Сначала важное уточнение: две таблицы ниже составлены разными организациями и по результатам тестов в разных условиях, поэтому сравнивать их напрямую нельзя. Особенно наглядный пример — Terminal-Bench 4.0: в официальном отчёте указано 65,7%, а Artificial Analysis независимо получила 67%. Это результаты двух отдельных тестов, а не погрешность одного измерения. Официальных результатов K3 для Terminal-Bench 4.0 тоже нет: показатель 13% приводится только Artificial Analysis.
2.1 Официальные результаты Kimi K3.1 Pro
Источник: официальный блог Moonshot. Условия тестирования: если не указано иное, использовались reasoning_effort=max (максимальная интенсивность рассуждений), temperature=1.0 и top_p=0.95. Пометка «внутренний» означает, что Moonshot использовала собственный тестовый набор, результаты которого нельзя воспроизвести извне.
| Тест | K3.1 Pro | Для сравнения | Примечание |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | GPT-6 Astra — 58,2%, Claude Opus 5.5 — 66,4% | Opus 5.5 тестировали с помощью Claude Code harness |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | K3 — 55,95% | Внутренний тест, задачи на программирование с длинной цепочкой действий |
| BenchCAD | 92,7% (с инструментами) | Opus 5.5 — 96,2%, GPT-6 Astra — 95,9% | Преобразование многовидовых чертежей в CAD-код |
| OfficeQA Pro v2 | 64,4 | Выше, чем у K3 | Анализ реальных финансовых отчётов; по заявлению компании, результат SOTA |
| Financial Modeling / Research | На 7,2 / 11,6 балла выше, чем у K3 | K3 | Внутренний тест |
| Business Operation | Примерно в 4,2 раза выше, чем у K3 | K3 | Внутренняя симуляция управления бизнесом |
| Kimi Hallu Bench Hard | Частота галлюцинаций на уровне утверждений — 8,3% | K3 — 23,4% | Внутренний стресс-тест на фактическую точность |
| xdev-bench-hard (pass@3) | 81,0% | 90,5% у версии без ограничений безопасности | Поиск уязвимостей |
Поясним несколько терминов. Harness — это «обвязка», которая управляет тестированием модели: вызывает инструменты и выполняет команды. Результаты зависят от выбранной обвязки, поэтому показатель Opus 5.5 нужно рассматривать отдельно. pass@3 означает, что модели дают три попытки на одну задачу: достаточно решить её хотя бы один раз. Последняя строка показывает, что ради безопасности разработчики намеренно ограничили способность модели искать уязвимости: результат публичной версии примерно на 9,5 процентного пункта ниже, чем у внутренней версии без этих ограничений.
2.2 Результаты Kimi K3.1 Pro в сторонних бенчмарках (Artificial Analysis)
Источник: Artificial Analysis, данные на 2026-10-23. Тестирование проводилось по единой методике этой организации; для K3 и K3.1 Pro использовался один и тот же набор тестов.
| Показатель | K3.1 Pro | K3 | Изменение |
|---|---|---|---|
| Intelligence Index | 55 (4-е место) | 44 | +11 |
| GDPval-AA (Elo в реальных рабочих задачах) | 1846 (3-е место) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 процентных пункта |
| AutomationBench-AA (рабочие процессы SaaS) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Доля галлюцинаций / точность | 44% / 51% | 53% / 48% | Доля галлюцинаций: −9 |
| Среднее количество выходных токенов на задачу | 55K | 48K | +14% |
В рейтинге Artificial Analysis K3.1 Pro занимает 4-е место. Выше него — Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) и Muse Wonder Full (56). Результат 67% в Terminal-Bench 4.0 — самый высокий среди всех моделей, протестированных этой организацией; у Sonnet 5.5 — 64%.
Оба источника указывают на снижение доли галлюцинаций, но конкретные значения сильно различаются: во внутренних стресс-тестах компании показатель снизился с 23,4% до 8,3%, а в тестах AA — с 53% до 44%. В этих тестах использовались разные задания, различались и их сложность, и методы подсчёта. При цитировании указывайте источник и не объединяйте эти данные в формулировку вроде «доля галлюцинаций снизилась до 8%».
3. В каких 5 направлениях Kimi K3.1 Pro заметно лучше
В этом разделе — только направления, где улучшение подтверждают обе системы тестирования или где его масштаб достаточно велик.
- Программные агенты и задачи в терминале. Агент — это ИИ-помощник, который сам разбивает задачу на этапы, вызывает инструменты и выполняет многошаговые действия. По данным AA, результат Terminal-Bench 4.0 вырос с 13% до 67%, а во внутреннем тесте компании для длинных цепочек программирования — с 55,95% до 61,2%. Если при запуске агента на K3 у вас часто возникают проблемы с выполнением команд, работой с файлами или поиском ошибок в несколько этапов, здесь улучшение заметнее всего.
- Повседневные рабочие задачи. GDPval-AA оценивает в баллах Elo, насколько хорошо модель справляется с реальными профессиональными задачами. Elo — это рейтинговая система для соревнований: её, например, используют в шахматах. Чем больше разница в рейтинге, тем сильнее различаются шансы на победу. K3.1 Pro опережает K3 на 312 баллов и занимает третье место. Это говорит о заметном прогрессе в повседневных задачах — например, при подготовке планов, работе с таблицами и систематизации материалов.
- Автоматизация рабочих процессов в SaaS-сервисах. AutomationBench-AA проверяет, насколько хорошо модель автоматизирует процессы в разных онлайн-сервисах: например, читает письма, обновляет заявки и синхронизирует таблицы. Результат вырос с 58% до 73%. Во внутреннем тесте компании на имитацию управления бизнесом (Business Operation) показатель оказался примерно в 4,2 раза выше, чем у K3. Это тоже говорит об улучшении в выполнении длинных последовательностей действий, но данные внутренние, поэтому относиться к ним стоит с осторожностью.
- Фактическая точность и галлюцинации. Галлюцинация — это когда модель уверенно выдумывает несуществующие факты. Во внутренних тестах компании доля галлюцинаций на уровне отдельных утверждений (то есть подсчёт ведётся для каждого фактического утверждения) снизилась с 23,4% до 8,3%. Ответов хотя бы с одной фактической ошибкой стало 42,4% от количества у K3. По данным AA, доля галлюцинаций снизилась с 53% до 44%, а точность выросла с 48% до 51%.
- Финансовое моделирование и аналитические отчёты. По заявлению компании, результат OfficeQA Pro v2 — 64,4 балла, что соответствует SOTA (лучшему результату на данный момент). Во внутренних тестах Financial Modeling и Financial Research результаты превысили показатели K3 на 7,2 и 11,6 балла соответственно. Независимой проверки этих результатов третьими сторонами пока нет, поэтому отнесём их к категории «по данным компании».
Показатели научного рассуждения (Humanity’s Last Exam, CritPt, SciCode) тоже улучшились, но всего на 2–5 процентных пунктов. Если ваши основные задачи — академические вопросы и научное программирование, прогресс K3.1 Pro будет не таким заметным, как в задачах для агентов. Поэтому переходить на новую модель только из-за этих результатов не обязательно.
4. Что почти не изменилось в Kimi K3.1 Pro и во сколько это обходится
4.1 Три вещи, которые в Kimi K3.1 Pro остались прежними
- Контекстное окно по-прежнему составляет 1 млн токенов: 1 048 576 токенов — столько же, сколько у K3. Контекстное окно можно представить как общий объём информации, которую модель может «видеть» за один раз.
- Модель по-прежнему работает с текстом и изображениями: новые способы ввода, например аудио и видео, не появились.
- Официальных тестов скорости нет: по измерениям AA, скорость генерации составляет 80,7 токена в секунду — это второй из четырёх уровней скорости в классификации этой организации. По заявлению разработчиков, версия highspeed работает в 2–3 раза быстрее, но условия тестирования, которые позволили бы воспроизвести результат, не указаны. Поэтому это утверждение пока считаем «непроверенным».
4.2 Сравнение цен Kimi K3.1 Pro по пяти категориям
Ниже указаны официальные цены: данные получены 24.10.2026, доллары США за миллион токенов, без учёта налогов.
| Модель | Входные токены | Выходные токены | Попадание в кэш | Запись в кэш на 5 минут | Запись в кэш на 1 час |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Попадание в кэш — это повторная отправка того же содержимого префикса, например фиксированного системного промпта или одного и того же длинного документа. Начиная со второго запроса за него взимается меньшая плата. Запись в кэш на 5 минут и 1 час — это плата за сохранение содержимого в кэше: чем дольше оно там хранится, тем выше стоимость. При создании Agent-систем или ответах по длинным документам кэш может заметно снизить расходы. Если структура промпта остаётся неизменной, можно хорошо сэкономить на входных токенах.
4.3 Цена Kimi K3.1 Pro: снижение цены не всегда означает экономию
K3.1 Pro всегда выполняет внутреннее рассуждение — перед каждым ответом модель делает небольшой шаг рассуждения, который тарифицируется как выходные токены. По измерениям AA, в среднем на одну задачу модель выдаёт 55K токенов — на 14% больше, чем K3, у которой этот показатель составляет 48K.
Если смотреть только на цену за токен, снижение на 33% должно заметно сократить расходы. Но по результатам тестов AA стоимость одной задачи составляет около $1.98 (на странице с подробностями о модели указано $2.11) — примерно столько же, сколько у K3. Организация не опубликовала разбивку расходов, поэтому официального объяснения тому, почему экономии не получилось, пока нет. Возможно, при многошаговых вызовах модели в Agent-задачах увеличивается и количество входных токенов, но это лишь предположение, которое пока не подтверждено.
Кроме того, версия highspeed стоит вдвое дороже стандартной. Командам, для которых важны расходы, перед переходом стоит протестировать модель на выборке реальных задач и сравнить общую стоимость, а не только цену за токен.
Если хотите сравнить фактические расходы на K3 и K3.1 Pro в одном и том же коде, сначала подключите совместимый с OpenAI API-интерфейс APIYI apiyi.com и запустите kimi-k3, чтобы получить базовый результат. Название модели и цену K3.1 Pro на платформе смотрите в списке моделей — мы постараемся добавить её как можно скорее.
5. В каких случаях стоит перейти на Kimi K3.1 Pro, а в каких можно не спешить
Рекомендации по типам задач для тех, кто уже пользуется K3.
| Тип задач | Рекомендация | Причина |
|---|---|---|
| Программные агенты и автоматизация через терминал | Стоит перейти как можно скорее | По стороннему тесту Terminal-Bench результат вырос с 13% до 67%, а в официальных тестах для программирования с длинной цепочкой действий — более чем на 5 баллов |
| Анализ документов, исследовательских и финансовых отчётов, финансовое моделирование | Стоит перейти | В тесте GDPval Elo результат вырос на 312 пунктов; в официальных тестах по финансовой отчётности и исследовательским отчётам модель во всём опережает K3, а число галлюцинаций заметно снизилось |
| Рабочие процессы в SaaS и многошаговые бизнес-процессы | Стоит перейти | Результат в AutomationBench-AA вырос с 58% до 73% |
| Массовая обработка простых задач — классификация, извлечение данных, перефразирование | Можно не спешить | Стоимость одной задачи сопоставима с K3. Режим постоянного рассуждения увеличивает объём ответа, а прирост возможностей мало что даёт для простых задач |
| Сценарии, чувствительные к задержкам, — общение в реальном времени, онлайн-поддержка | Сначала протестируйте | Официальных данных о скорости нет. Режим постоянного рассуждения увеличивает время до первого токена, а тариф highspeed стоит вдвое дороже |
«Можно не спешить» не значит, что K3 плоха. Для простых задач возможностей K3 уже хватает, а задержки и расходы проще предсказать. Не нужно переписывать весь конвейер пакетной обработки только ради более высокого общего балла. Можно подождать, пока опубликуют веса K3.1 Pro и появятся более полные данные о скорости от сторонних тестировщиков, а потом уже принять решение.
5.1 Типичные задачи для Kimi K3.1 Pro
- Исправление ошибок, рефакторинг и написание тестов на уровне всего репозитория, когда модели нужно самостоятельно запускать команды, анализировать ошибки и вносить правки.
- Вопросы и краткие пересказы длинных финансовых отчётов, договоров и исследовательских материалов, где особенно важна точность фактов.
- Автоматизация процессов с несколькими онлайн-инструментами, когда для одной задачи нужно выполнить больше десяти шагов.
5.2 Типичные задачи, для которых пока можно оставить Kimi K3
- Классификация меток и извлечение полей из сотен тысяч записей в день, когда расходы рассчитываются за каждую запись.
- Взаимодействие в реальном времени с предсказуемо низкой задержкой, для которого уже настроены параметры тайм-аутов и повторных попыток в K3.
Совет: самый надёжный способ — взять 50–100 реальных примеров из своих задач, запустить их на обеих моделях и сравнить долю успешно выполненных задач и общие расходы. Сервис-прокси API APIYI (apiyi.com) позволяет переключаться между разными моделями с одним API-ключом — удобно для таких сравнительных тестов. Пока K3.1 Pro не вышла, можно снять базовые показатели на
kimi-k3. Название модели и её цена для K3.1 Pro будут указаны в списке моделей на платформе. Мы постараемся добавить эту модель как можно скорее.
6. Рекомендации по переходу на Kimi K3.1 Pro и важные замечания
6.1 График отключения серии Kimi K2
Если вы ещё используете модели серии K2, в первую очередь займитесь миграцией. Согласно официальной документации, с 31 октября 2026 года серия K2 станет недоступна для новых пользователей, а до конца 2026 года её полностью отключат. Старые пользователи пока смогут продолжать работу, но рекомендуем завершить миграцию в ближайшие два месяца — сразу перейти на K3 или K3.1 Pro, не дожидаясь отключения.
6.2 Три рекомендации по переходу на Kimi K3.1 Pro
- Начинайте новый диалог — не переключайте модель на ходу. Официальная рекомендация — использовать K3.1 Pro в новом диалоге. Если продолжить в K3.1 Pro уже начатый диалог с K3, могут возникнуть проблемы совместимости формата контекста или содержимого рассуждений.
- По возможности используйте нативные интерфейсы. По мнению разработчиков, наиболее надёжно работают три нативных интерфейса: Responses, Chat Completions и Messages.
- Точно указывайте название модели. Если при настройке стороннего инструмента допустить опечатку в
kimi-k3.1-pro, запрос будет перенаправлен на K2.8 Preview, и модель не будет рассуждать. Ошибка не появится — просто ухудшится результат, а на поиск причины уйдёт немало времени. Перед запуском проверьте поле с названием модели в ответе.
6.3 Уровни подписки Kimi Code
Для использования новых моделей в Kimi Code есть ограничения по уровню подписки:
- Для
k3.1-proнужна подписка Plus или выше. - Для контекстного окна на 1M токенов нужна подписка Pro или выше.
- Для версии highspeed нужна подписка Pro или выше; она расходует примерно вдвое больше квоты.
Подписка Plus даёт доступ к K3.1 Pro, но не к полному контекстному окну на 1M токенов. Если вы часто анализируете целые репозитории благодаря сверхдлинному контексту, проверьте свой уровень подписки, прежде чем решать, стоит ли его повышать.
6.4 Чек-лист для подключения через API
- Укажите
base_urlкакhttps://api.apiyi.com/v1— это OpenAI-совместимый адрес APIYI apiyi.com. В существующем коде на OpenAI SDK достаточно изменить только этот параметр и API-ключ. - Для начала проверьте работу процесса с моделью
kimi-k3, а затем укажите точное название K3.1 Pro из списка моделей платформы. Ориентируйтесь на этот список: там указаны актуальные названия моделей и цены. Мы постараемся как можно скорее добавить эту модель. - Увеличьте тайм-аут: постоянные рассуждения могут замедлять получение ответа.
- Не задавайте слишком низкое значение
max_tokens, иначе содержимое рассуждений может вытеснить основной ответ.
Часто задаваемые вопросы
Q1: Что такое Kimi K3.1 Pro и как он связан с K3?
K3.1 Pro — новая версия K3, для постобучения которой Moonshot выделила больше вычислительных ресурсов. По словам компании, это первая модель серии K3.1. Контекстное окно и поддерживаемые типы входных данных остались такими же, как у K3. Основные улучшения касаются программных агентов, решения реальных рабочих задач и точности фактов.
Q2: Какой результат Kimi K3.1 Pro показала в Terminal-Bench — 65,7% или 67%?
Верны оба значения, но источники разные. 65,7% — результат, опубликованный разработчиком, а 67% — результат независимого тестирования Artificial Analysis. Условия тестирования и тестовые harness различались, поэтому эти значения нельзя считать одним и тем же результатом. При цитировании указывайте источник.
Q3: Почему Kimi K3.1 Pro не стала дешевле в использовании, хотя цена за единицу снизилась на 33%?
Модель всегда рассуждает, поэтому в среднем выдаёт на 14% больше токенов на задачу, чем K3. По замерам AA, одна задача обходится примерно в $1,98 (на странице модели указано $2,11) — практически столько же, сколько у K3. Причины этой разницы в организации не разбирали. Рекомендуем проверить стоимость на собственных задачах.
Q4: Когда станут доступны веса Kimi K3.1 Pro?
Разработчик обещает опубликовать полные веса до 2026-11-04. По состоянию на 2026-10-24 это пока только обещание, оно ещё не выполнено. Если планируете запускать модель самостоятельно, ориентируйтесь на фактический релиз.
Q5: Как быстро сравнить Kimi K3.1 Pro и K3 через API?
Зарегистрируйтесь на APIYI apiyi.com, чтобы получить ключ и бесплатный тестовый баланс, а затем запустите `kimi-k3` через совместимый с OpenAI интерфейс — он послужит базовой моделью для сравнения. Название модели и цена K3.1 Pro на платформе будут указаны в списке моделей. Мы постараемся добавить её как можно скорее; после запуска для сравнения достаточно будет изменить параметр `model`.
Q6: Какие известные ограничения есть у Kimi K3.1 Pro?
— Разработчик не публиковал бенчмарки скорости, а версия highspeed стоит вдвое дороже.
— Модель всегда рассуждает и не подходит для сценариев, где важна минимальная задержка.
— Некоторые впечатляющие результаты получены на внутренних тестовых наборах, поэтому внешним исследователям их не удаётся воспроизвести.
— Возможности поиска уязвимостей ограничены мерами безопасности и уступают версии без такой фильтрации.
Q7: Я всё ещё использую K2. Стоит ли сразу переходить на K3.1 Pro?
С 2026-10-31 новые пользователи уже не смогут подключить модели серии K2, а до конца года их выведут из эксплуатации, так что переход необходим. Для программных агентов и работы с документами можно сразу выбрать K3.1 Pro. Для массовой обработки небольших задач проще перейти на K3. На APIYI apiyi.com можно начать миграцию с `kimi-k3`. Название модели и цена K3.1 Pro будут указаны в списке моделей платформы. Мы постараемся добавить её как можно скорее.
Ключевые выводы о Kimi K3.1 Pro
- Заметный рост возможностей: общий балл AA вырос с 44 до 55. Модель заняла 4-е место, уступив только трём закрытым моделям.
- Сильнее всего выросли возможности программного агента: по результатам независимого тестирования Terminal-Bench 4.0 показатель увеличился с 13% до 67%.
- Официальные данные и данные AA нужно рассматривать отдельно: методики различаются, поэтому при цитировании всегда указывайте источник.
- Снижение цены не означает снижения затрат: цена за токен упала на 33%, но стоимость одной задачи осталась примерно на уровне K3.
- Базовые характеристики не изменились: контекстное окно на 1 млн токенов, поддержка текста и изображений. Официальных данных о скорости нет.
- При миграции указывайте точное название модели: если ошибиться, запросы переключатся на K2.8 Preview без режима рассуждений.
- Подключение: сначала можно протестировать базовый уровень K3 через APIYI apiyi.com. Название модели и цену K3.1 Pro уточняйте в списке моделей платформы — мы постараемся добавить её как можно скорее.
Итог: стоит ли переходить на Kimi K3.1 Pro с K3
Изменения в Kimi K3.1 Pro по сравнению с предыдущей версией можно свести к трём пунктам:
- Возможности: модель заметно лучше справляется с программными агентами, задачами в терминале, реальными рабочими сценариями, автоматизацией SaaS и проверкой фактов. Данные сторонних тестов и официальные результаты показывают одинаковую тенденцию.
- Цена: цена за токен во всех пяти тарифах на 33% ниже, чем у K3. Но режим постоянных рассуждений увеличивает объём ответа, поэтому стоимость одной задачи почти не снижается.
- Миграция: для программных агентов, а также работы с документами и аналитическими отчётами рекомендуем перейти как можно скорее. Для пакетной обработки небольших задач и сценариев, чувствительных к задержкам, сначала проведите тесты. Пользователям K2 стоит завершить миграцию до конца года.
Сейчас на APIYI apiyi.com доступны модели Kimi, в том числе kimi-k3 (ввод — $3 / вывод — $15). На одном и том же API-ключе и через совместимый с OpenAI интерфейс можно сначала сравнить стоимость и качество. Название модели и цену Kimi K3.1 Pro на платформе уточняйте в списке моделей. Мы постараемся добавить её как можно скорее — после запуска достаточно будет заменить название модели и сравнить результаты.
Источники
- Официальный блог Moonshot: анонс Kimi K3.1 Pro и результаты внутренних бенчмарков
- Примечание: источник данных для раздела «По данным производителя». Условия тестирования:
reasoning_effort=max,temperature=1.0,top_p=0.95. - Официальная документация Moonshot: цены, график отключения K2, рекомендации по переходу на другие модели и информация о подписке Kimi Code
- Примечание: цены получены 2026-10-24, указаны в долларах за миллион токенов, без учёта налогов.
- Artificial Analysis: независимая оценка моделей сторонней организацией
- Ссылка:
artificialanalysis.ai - Примечание: источник данных для раздела «По данным сторонней оценки». Дата данных — 2026-10-23.
Автор: техническая команда APIYI
Технические вопросы: будем рады пообщаться — свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по интеграции доступны в центре документации docs.apiyi.com. Название модели и цены на Kimi K3.1 Pro смотрите в списке моделей платформы. Мы постараемся добавить эту модель как можно скорее.