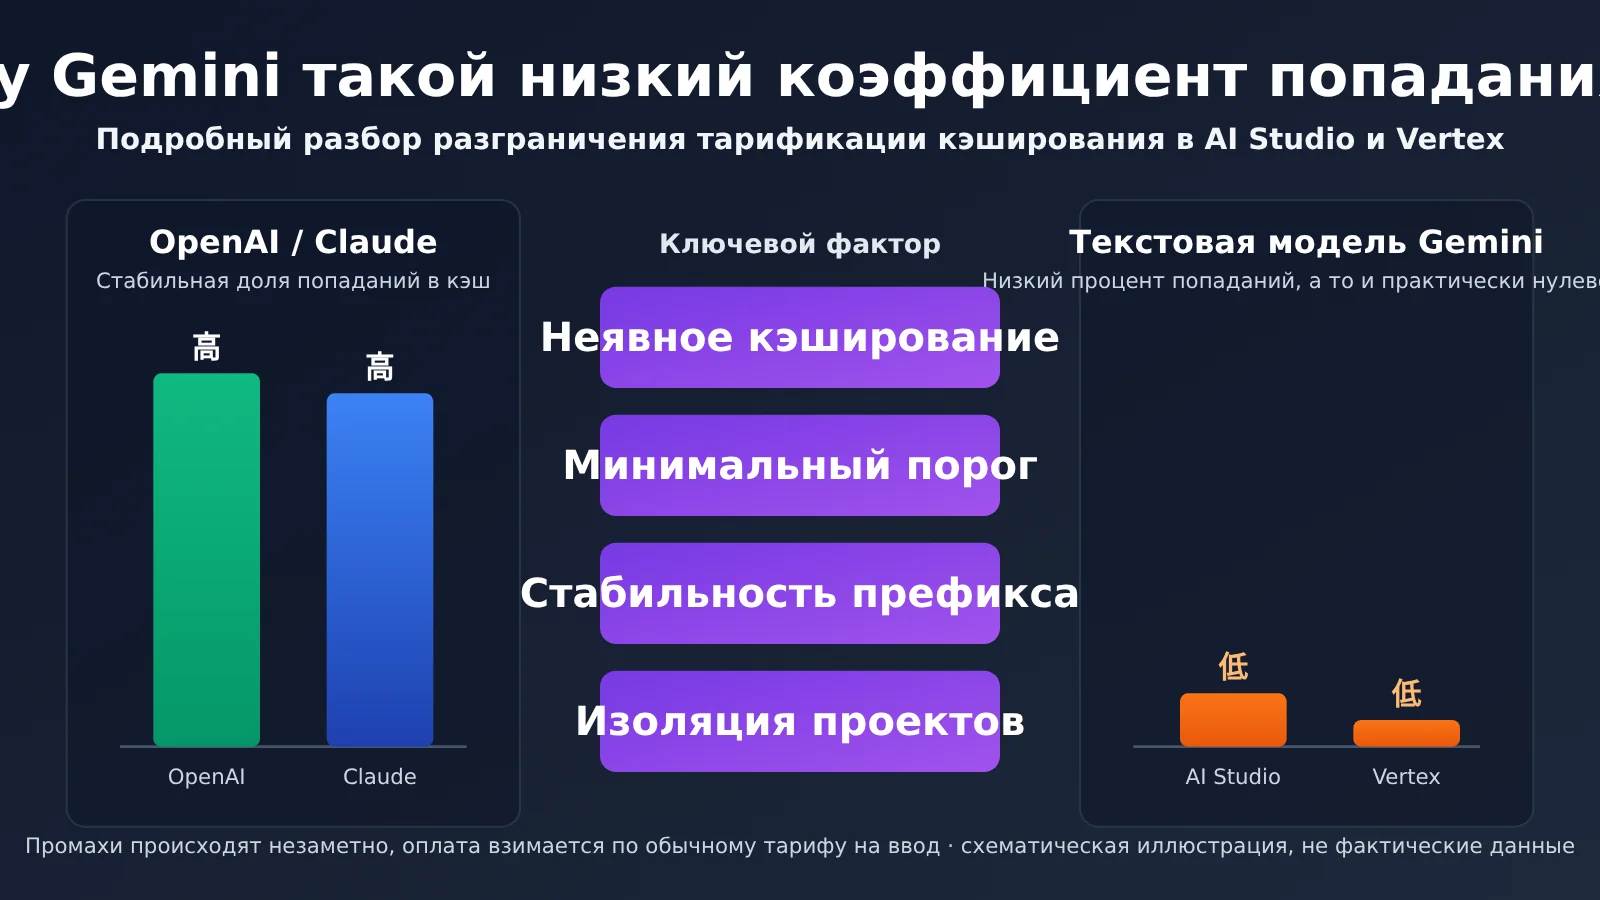
В реальной работе с APIYI кэширование в сериях OpenAI и Claude работает нормально: данные записываются в кэш и извлекаются из него, а доля попаданий высока. С текстовыми моделями Gemini всё иначе: попаданий мало, а иногда их почти нет. Это можно проверить по счетам и детализации использования — именно этот момент часто больше всего сбивает разработчиков при сверке расходов.
В этой статье на основе официальной документации Google (по состоянию на 20 октября 2026 года) разберём 5 причин низкой доли попаданий в кэш Gemini и объясним, как устроена тарификация кэширования в AI Studio (Gemini Developer API) и Vertex AI.
Это не попытка переложить вину на кого-то. В официальной документации Google нет правила, согласно которому «использование сервиса-прокси API снижает долю попаданий в кэш Gemini». И без записей запросов на стороне вышестоящего провайдера мы не можем утверждать, что в конкретном случае точно сработала одна из причин. В этой статье мы сначала разберём официальные правила, затем перечислим условия, при которых кэш может не сработать, и в конце предложим план проверки, который вы сможете выполнить самостоятельно.
Главное: прочитав статью, вы поймёте, когда Gemini использует кэш, а когда нет, разберётесь в важном нюансе тарификации — «общее число входных токенов включает кэшированную часть» — и научитесь самостоятельно сверять счёт по полям в официальном ответе.
Главное о доле попаданий в кэш Gemini
Сначала — выводы. Чтобы разобраться в кэшировании Gemini, нужно различать два механизма: «неявное» и «явное» кэширование. Они работают по-разному и тарифицируются по-разному.
| Тип | Как использовать | Как получить скидку за кэширование | Есть ли плата за хранение |
|---|---|---|---|
| Неявное кэширование Implicit caching | Автоматически включено в поддерживаемых моделях, создавать объект кэша не нужно | После фактического попадания кэшированная часть оплачивается по тарифу для кэшированных данных; попадание не гарантируется при каждом запросе | Нет |
| Явное кэширование Explicit caching | Объект кэша создаётся вручную, а последующие запросы ссылаются на него | Кэшированные входные данные, на которые ссылаются в действующем кэше, тарифицируются по сниженной цене | Да |
В официальной документации для неявного кэширования в Developer API есть важная оговорка: оно не гарантирует экономию. Явное кэширование работает предсказуемее, но требует дополнительной разработки: нужно создавать объекты кэша, управлять сроком их действия и ссылаться на них в последующих запросах.
Почему Gemini работает не так, как OpenAI и Claude
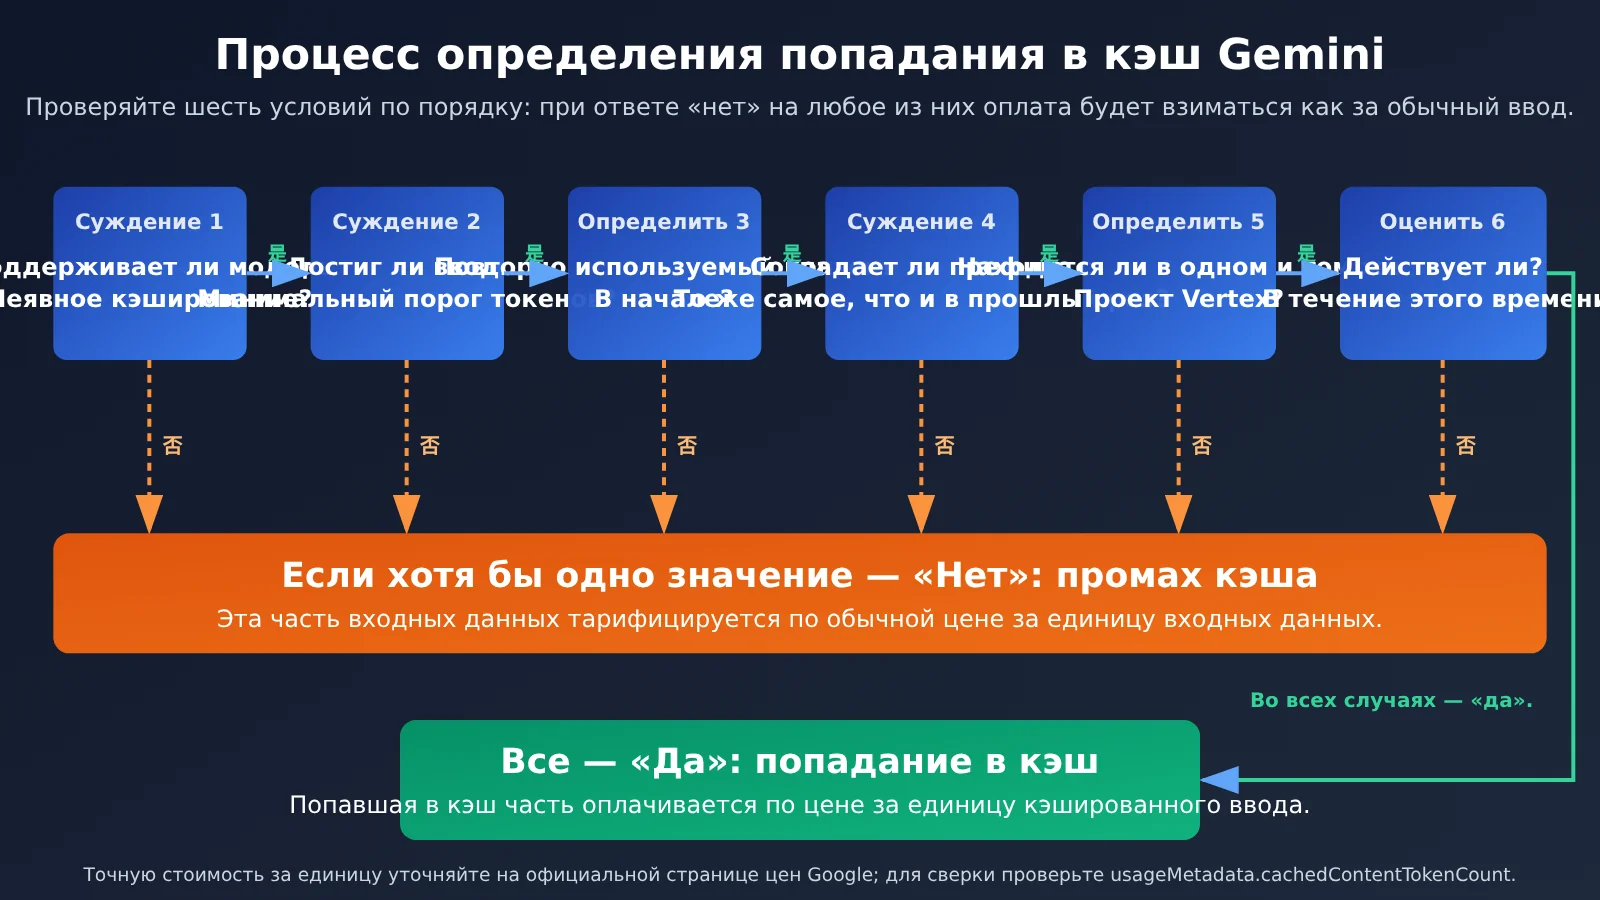
С точки зрения пользователя, в APIYI серии OpenAI и Claude работают так: «Отправляешь один и тот же длинный префикс — и стабильно видишь запись данных в кэш и попадания». Для Gemini должны одновременно выполняться несколько условий: модель поддерживает неявное кэширование, запрос достигает минимального порога токенов для этой модели, повторно используемое содержимое стоит в начале промпта, похожие запросы отправляются с небольшим интервалом, а в Vertex AI они ещё и относятся к одному проекту Google Cloud.
Если не выполнено хотя бы одно условие, запрос тарифицируется по обычной цене входных данных. Ошибки или предупреждения при этом не будет. Именно поэтому низкую долю попаданий часто не замечают: промахи кэша происходят незаметно.
Уточним термин: что здесь называется AI Studio
В этой статье под «каналом AI Studio» понимается Gemini Developer API — путь вызова API с помощью ключа, созданного в AI Studio. Его мы сравниваем с Vertex AI в Google Cloud. Общий принцип кэширования у них одинаковый, но отличаются минимальные пороги, область изоляции и правила платы за хранение. Ниже разберём эти различия по отдельности.
5 причин низкой доли попаданий в кэш Gemini
Разберём проблему в два этапа: первые две причины — это правила, прямо указанные в официальной документации, а последние три — возможные последствия нарушения этих правил на уровне сервиса-прокси или инженерной реализации. По одному лишь факту использования прокси нельзя определить конкретную причину: для диагностики нужны данные проекта и записи запросов на стороне вышестоящего сервиса.
Причина 1. Запрос не достигает минимального порога токенов для кэширования
Для неявного кэширования установлен минимальный порог токенов. Слишком короткие запросы не попадают в кэш. Кроме того, пороги для двух API различаются. Ниже приведены значения для некоторых моделей, указанные в актуальной документации:
| Модель | Порог неявного кэширования в Developer API | Порог неявного кэширования в Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro (предыдущее поколение, для сравнения) | 2,048 | 2,048 |
Здесь есть два нюанса. Во-первых, у новых моделей, например Gemini 3.8 Flash, порог выше, чем у серии 2.5. Если ориентироваться на прежнее значение в 2,048 токенов, оценка будет неверной. Во-вторых, для одной и той же модели порог в Vertex может быть выше: запрос на 5,000 токенов подойдёт для Developer API, но не для Vertex.
В обычных диалогах запросы часто содержат лишь несколько сотен или одну-две тысячи токенов — этого заведомо меньше порога. Это одна из самых очевидных причин низкой доли попаданий в кэш Gemini в чат-сценариях. Важно: достижение порога — необходимое, но не достаточное условие для попадания в кэш.
Причина 2. Повторно используемый контент находится не в начале промпта
Google даёт одинаковую рекомендацию для обоих API: размещайте длинный контент, который используется повторно, в начале промпта и отправляйте запросы с похожим префиксом через небольшие промежутки времени. Кэш опирается на общий префикс, а не на то, что «в запросе есть один и тот же документ».
Иными словами, наличие одного и того же документа в двух запросах ещё не гарантирует попадание в кэш. Важно, где он расположен и насколько стабилен текст перед ним. Такой вариант легко нарушает совпадение префиксов:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
Если в начале отличается хотя бы один символ, длинный документ уже не образует общий префикс с предыдущим запросом. Это вывод на основе официальной рекомендации, но на практике такая ситуация встречается часто.
Причина 3. Прокси меняет префикс (условный сценарий)
Если прокси добавляет в начало промпта меняющиеся дату и время, идентификаторы или поля трассировки либо переставляет, сжимает или обрезает контекст нескольких ходов диалога, общий префикс меняется и вероятность попадания в кэш снижается. Это условный сценарий: нельзя без проверки утверждать, что конкретный сервис ведёт себя именно так.
При диагностике разделяйте два уровня: стабилен ли префикс запроса, который вы отправляете прокси, и стабилен ли префикс запроса, который прокси отправляет в Google. На первом уровне вы можете всё контролировать самостоятельно; второй можно проверить по записям запросов на стороне вышестоящего сервиса.
Причина 4. Запросы распределяются между разными проектами Vertex (условный сценарий)
В Vertex прямо указано: кэш изолирован в пределах проекта Google Cloud и не используется совместно между проектами. Если запросы одного сеанса поочерёдно направляются в разные проекты Vertex, кэш, созданный в проекте A, будет недоступен проекту B.
Здесь важно не делать поспешных выводов: приводит ли «смена ключа» к потере доступа к кэшу, зависит от того, меняется ли при этом проект. Нельзя утверждать, что любая смена API-ключа приводит к потере кэша: сначала нужно выяснить, как ключи связаны с проектами.
Причина 5. Прокси передаёт только запросы на генерацию и не использует явное кэширование
Если цепочка вызовов лишь передаёт запросы generateContent, не создавая объект кэша и не ссылаясь на него в последующих запросах, весь процесс зависит только от неявного кэширования. Для него нет гарантии попадания в кэш, поэтому получить такой же стабильный эффект, как при явном кэшировании — «создать один раз и многократно ссылаться», — не получится.
В таблице ниже эти сценарии работы прокси сопоставлены с официальными правилами:
| Фактическое поведение | Возможное влияние | Соответствующее официальное правило |
|---|---|---|
| Запросы одного сеанса поочерёдно направляются в разные проекты Vertex | Не удаётся использовать кэш, созданный в другом проекте | Кэш изолирован в пределах проекта |
| В начале меняются дата и время или идентификаторы либо переставляется контекст | Общий префикс нарушается, вероятность попадания снижается | Длинный контент следует размещать в начале; префиксы должны быть похожими |
| Запрос короткий, фиксированного повторно используемого контента недостаточно | Не достигается порог кэширования | Минимальный порог токенов |
| Передаются только запросы на генерацию, без создания и использования объекта явного кэша | Остаётся полагаться на неявное кэширование без гарантий | Для явного кэширования объект нужно создать и использовать в запросах |
🎯 Практический совет: при диагностике проблем с кэшированием Gemini отправьте несколько запросов подряд с одним и тем же длинным префиксом через APIYI (apiyi.com), а затем сравните поле с числом токенов, попавших в кэш, в ответах. Сначала проверьте на контролируемых запросах, не связана ли проблема с префиксом или порогом, и только затем выясняйте, не влияет ли на неё цепочка передачи запросов.
Без данных о проекте и записях запросов на стороне вышестоящего сервиса нельзя определить причину только по факту использования прокси. Нет и официальных оснований считать, что доля попаданий в кэш Vertex обязательно выше, чем в Developer API.
Как устроена тарификация кеширования в AI Studio и Vertex
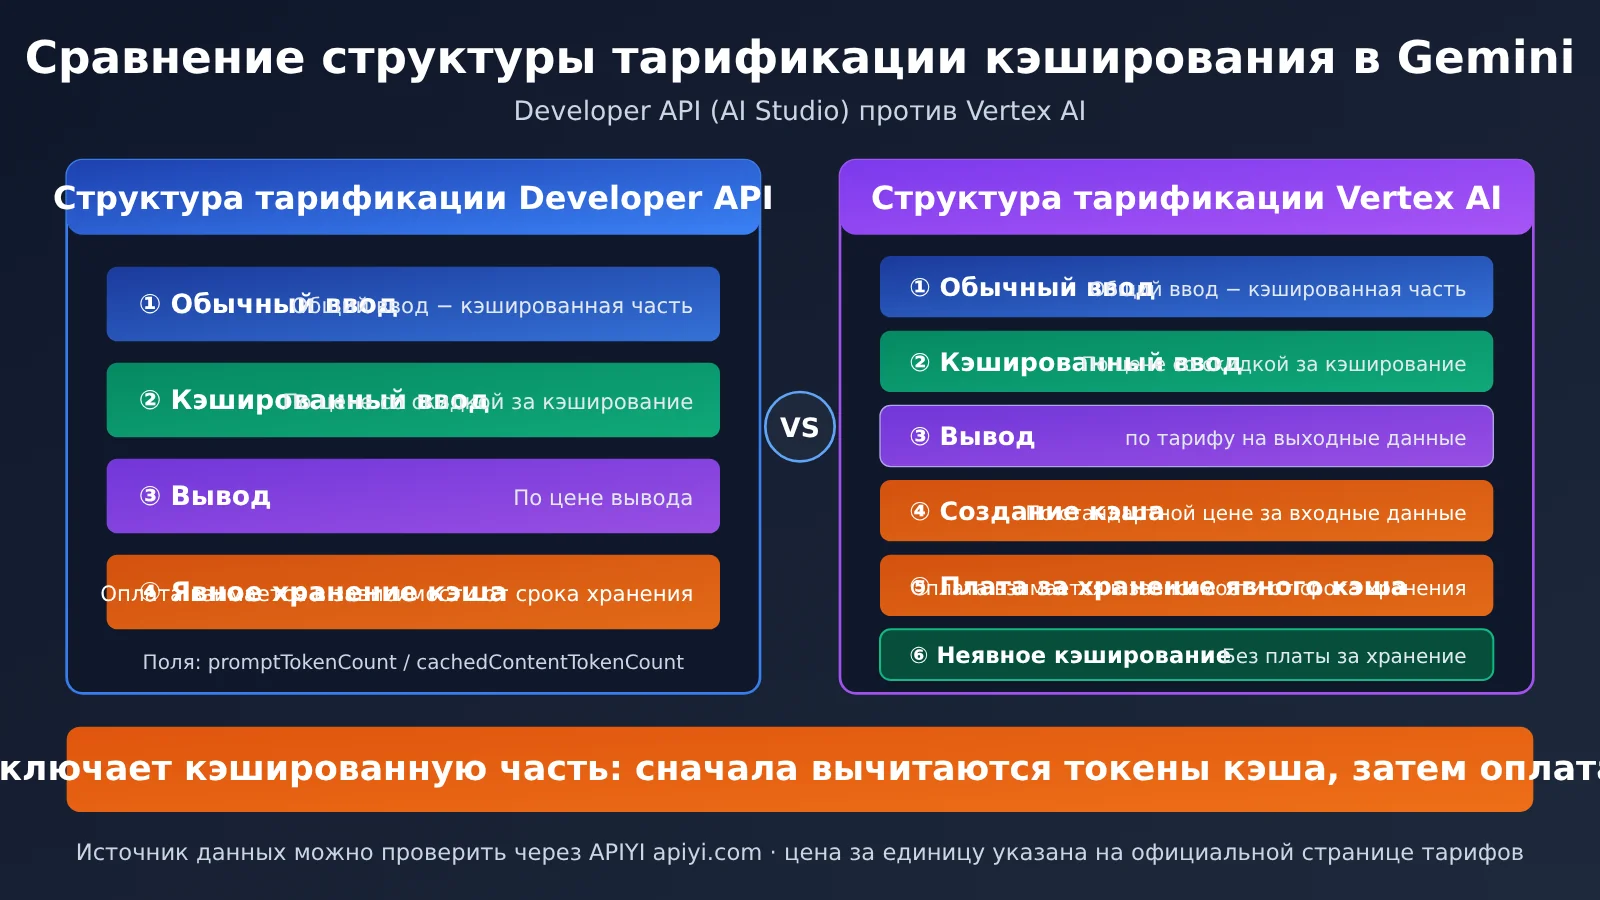
Многие считают, что «попадание в кеш» означает бесплатный запрос или скидку на весь запрос целиком. Это не так. В обоих сервисах нужно различать четыре позиции: обычный ввод, ввод из кеша, вывод и плату за хранение явного кеша.
Сравнение правил тарификации
| Позиция | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Обычный ввод (часть без попадания в кеш) | По стандартной цене ввода | По стандартной цене ввода |
| Ввод из кеша (часть, попавшая в кеш) | По отдельной цене ввода из кеша, указанной на странице с тарифами | По отдельной цене ввода из кеша, указанной на странице с тарифами |
| Вывод | Оплачивается отдельно | Оплачивается отдельно |
| Ввод при создании кеша | Включается в стоимость использования токенов кеша | Оплачивается по стандартной цене ввода |
| Плата за хранение неявного кеша | Нет | Нет |
| Плата за хранение явного кеша | Зависит от срока хранения | Есть |
В документации Developer API в числе факторов, влияющих на стоимость, указаны использование токенов кеша, срок хранения, обычный ввод и вывод. В документации Vertex отдельно уточняется, что ввод при создании кеша оплачивается по стандартной цене, а за неявный кеш плата за хранение не взимается — в отличие от явного кеша. Актуальные цены смотрите на официальных страницах тарифов обоих сервисов: они различаются в зависимости от модели и версии.
Формула расчёта стоимости ввода
Для обычного запроса на генерацию текста стоимость ввода можно представить так:
Стоимость ввода =
(общее число токенов ввода − число токенов, попавших в кеш) × стандартная цена ввода
+ число токенов, попавших в кеш × цена ввода из кеша
Стоимость вывода рассчитывается отдельно, а для явного кеша дополнительно взимается плата за хранение. Например, предположим, что в запросе 10 000 токенов ввода, из которых 8 000 попали в кеш. Тогда 2 000 токенов тарифицируются по стандартной цене, а 8 000 — по цене ввода из кеша.
Что чаще всего считают неправильно: общий ввод уже включает кешированную часть
При сверке смотрите исходный ответ Google, а не только показатель «процент попаданий в кеш» в панели сервиса-прокси API. В usageMetadata ответа generateContent есть два важных поля:
| Поле | Значение | На что обратить внимание при сверке |
|---|---|---|
usageMetadata.promptTokenCount |
Общее число токенов ввода | Включает кешированную часть |
usageMetadata.cachedContentTokenCount |
Число токенов в кешированной части | Количество токенов, попавших в кеш |
Поэтому нельзя сначала посчитать promptTokenCount целиком по стандартной цене, а затем дополнительно прибавить стоимость ввода из кеша: так вы посчитаете кешированную часть дважды. Сначала вычтите число токенов из кеша из общего числа токенов ввода — остаток и будет оплачиваться по стандартной цене. Если вы используете новую Interactions API, для статистики кеша в документации указано поле usage.total_cached_tokens.
Два разных аспекта
Важно разделять две вещи: сколько токенов действительно попало в кеш на стороне Google и как сервис-прокси API учитывает эту скидку в вашем счёте. Первое можно проверить по официальным полям ответа, а второе зависит от правил тарификации самого сервиса-прокси API — документация Google не может это подтвердить. Поэтому при сверке проверяйте и поля кеша в ответе от вышестоящего API, и принципы расчёта в детализации счёта.
💡 Совет по выбору: при сверке сначала смотрите на поля с числом кешированных токенов на уровне запроса, а затем — на итоговые данные в счёте. Если нужно сравнить OpenAI, Claude и Gemini на одинаковых условиях, можно отправлять один и тот же промпт в разные модели через APIYI apiyi.com и быстро переключаться между ними.
Чем отличается тарификация кеша в Gemini, Claude и OpenAI
У трёх сервисов разные подходы к кешированию, поэтому и сверять расходы нужно по-разному. В таблице ниже сравниваются способы активации кеша и тарификации. Скидки и срок действия кеша могут меняться в зависимости от версии модели, поэтому таблица показывает общую картину на момент написания статьи — актуальные значения уточняйте на официальных страницах тарифов.
| Параметр | Gemini | Claude | OpenAI |
|---|---|---|---|
| Как активируется | Два механизма: автоматическое неявное кеширование и явные объекты кеша | Явно: в запросе указывается точка кеширования с помощью cache_control |
Автоматически, изменения в коде не нужны |
| Плата за запись в кеш | Для неявного кеша нет; при создании явного кеша ввод оплачивается отдельно, также взимается плата за хранение | Есть: запись стоит дороже стандартного ввода. Цена различается для срока действия в 5 минут и 1 час | Отдельной платы за запись нет |
| Цена чтения из кеша (при попадании) | Ниже стандартной цены ввода; размер скидки зависит от модели | Около 1/10 стандартной цены ввода | Ниже стандартной цены ввода; размер скидки зависит от модели |
| Плата за хранение | Только для явного кеша, зависит от срока хранения | Нет: стоимость зависит от выбранного при записи срока действия | Нет |
| Минимальный порог | Зависит от модели и канала; в Vertex он может быть выше, чем в Developer API | Зависит от модели; часто — 1 024 токена или больше | Обычно от 1 024 токенов |
| Гарантия попадания | Для неявного кеша гарантии нет, явный кеш предсказуемее | После установки точки кеширования попадание обычно стабильно в течение срока действия | Автоматическое сопоставление префикса, гарантии нет |
| Поля статистики использования | cachedContentTokenCount (включено в promptTokenCount) |
cache_creation_input_tokens, cache_read_input_tokens; указываются отдельно от обычных токенов ввода |
prompt_tokens_details.cached_tokens (включено в prompt_tokens) |
В этой таблице есть три момента, которые чаще всего вызывают путаницу:
- Плата за запись: в Claude за запись в кеш нужно платить больше, а чтение обходится дешевле. Поэтому при сценарии «много записей, мало чтений» кеширование может оказаться дороже, чем его отсутствие. У OpenAI отдельной платы за запись нет, поэтому промах кеша не увеличивает расходы. У Gemini для неявного кеша плата за запись тоже отсутствует, а явный кеш влечёт расходы на создание и хранение.
- Кто управляет кешированием: в Claude отправитель запроса сам указывает точку кеширования, поэтому попадания легче предсказать. В OpenAI и Gemini неявное кеширование автоматически контролирует платформа; разработчик может лишь повысить вероятность попадания за счёт стабильного префикса. Отчасти поэтому кеш в Claude и OpenAI кажется пользователям более стабильным, чем в Gemini: на результаты Gemini одновременно влияют порог, префикс и изоляция по каналам.
- Что считается общим вводом: в Gemini и OpenAI общее число токенов ввода включает кешированную часть — её нужно сначала вычесть, прежде чем считать стоимость. В Claude поле
input_tokensне включает чтение и запись в кеш, поэтому стоимость рассчитывается отдельно для каждого из трёх типов токенов, а затем складывается. Если применить формулу одного сервиса к другому, расчёты будут неверными. При сверке разных моделей через APIYI apiyi.com сначала уточните, что именно учитывают поля в ответах каждого сервиса.
Быстрый старт: проверяем долю попаданий в кэш Gemini
Теория — это хорошо, но надёжнее всего проверить всё на практике. Идея простая: подготовить длинный неизменный префикс, который превышает минимальный порог, добавить в конце меняющийся вопрос, отправить несколько запросов подряд и посмотреть, как меняется поле с количеством токенов из кэша.
Минимальный пример
В примере ниже запросы отправляются в формате, совместимом с OpenAI, а в ответе выводится информация об использовании токенов. Названия полей могут различаться в зависимости от способа подключения, поэтому ориентируйтесь на фактический ответ:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Показать полный код теста и проверки расходов
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Быстрый старт: для такого сравнительного теста рекомендуем использовать APIYI apiyi.com. В одном и том же скрипте достаточно менять параметр
model, чтобы по очереди проверить Gemini, OpenAI и Claude и наглядно сравнить работу кэша у разных моделей.
Какие параметры важно контролировать
Перед запуском проверьте каждый пункт из списка ниже — так вы не примете проблему в собственном тесте за проблему в цепочке запросов:
| Что проверить | Что сделать | Зачем |
|---|---|---|
| Длина префикса | Убедиться, что она превышает текущий минимальный порог для целевой модели | Исключить проблему с порогом |
| Стабильность префикса | Не добавлять в начало временные метки и ID запросов | Убедиться, что префикс не меняется |
| Расположение изменяемой части | Поместить вопрос пользователя в конец | Сохранить максимально длинный общий префикс |
| Интервал между запросами | Отправлять запросы подряд, с небольшим интервалом | Следовать рекомендациям Google |
| Контрольная группа | Проверить ту же подсказку на OpenAI или Claude | Понять, связана ли разница с механизмом модели или с цепочкой запросов |
Как интерпретировать результаты
Если префикс достаточно длинный и стабильный, а запросы отправляются с короткими интервалами, но у Gemini почти нет попаданий в кэш, тогда как та же подсказка нормально срабатывает на OpenAI или Claude, значит, дело в особенностях кэширования Gemini и условиях на стороне вышестоящей инфраструктуры, а не в формулировке промпта. В таком случае можно перейти на явное кэширование: зафиксировать длинный контент, который нужно переиспользовать, создать объект кэша и ссылаться на него в запросах.
Если у вас в основном короткие диалоги, не стоит гнаться за долей попаданий в кэш. В таких сценариях выгода от кэширования Gemini ограничена, поэтому лучше сосредоточиться на выборе модели и контроле длины ответа.
Часто задаваемые вопросы
Вопрос 1: Почему доля попаданий в кэш у Gemini заметно ниже, чем у OpenAI и Claude?
Для неявного кэширования Gemini необходимо, чтобы модель поддерживала эту функцию, был достигнут минимальный порог по токенам, префикс оставался неизменным, а запросы отправлялись с небольшим интервалом. Кроме того, кэш в Vertex изолирован в пределах проекта, а Google прямо предупреждает, что попадания в кэш не гарантируются. Если не выполняется хотя бы одно из условий, запрос незаметно тарифицируется как обычный ввод. Чтобы понять причину в конкретной цепочке запросов, нужно изучить записи запросов на стороне провайдера.
Вопрос 2: Говорила ли Google, что использование сервиса-прокси снижает долю попаданий в кэш?
Нет. В официальной документации указаны условия кэширования: повторно используемый префикс, минимальный порог по токенам и область действия кэша. Если цепочка запросов меняет эти условия, доля попаданий может снизиться. Сравнить работу кэша у разных моделей можно с помощью APIYI apiyi.com — достаточно протестировать их с одним и тем же промптом.
Вопрос 3: Кэшированные данные бесплатны?
Нет. Кэшированная часть тарифицируется по отдельной цене за ввод из кэша. Она ниже цены обычного ввода, но не равна нулю. В таблицах цен обеих платформ отдельно указаны тарифы на обычный ввод и ввод из кэша. Для явного кэширования дополнительно взимается плата за хранение.
Вопрос 4: Нужно ли отдельно прибавлять кэшированные токены к числу входных токенов в счёте?
Нет. `promptTokenCount` — это общий объём входных данных, в который уже входят кэшированные токены. Чтобы получить часть, тарифицируемую по обычной цене, вычтите `cachedContentTokenCount` из общего объёма ввода. Кэшированную часть рассчитайте отдельно.
Вопрос 5: Одинаковы ли пороги кэширования в AI Studio и Vertex?
Не совсем. Согласно текущей документации, порог для Gemini 3.1 Pro Preview и Gemini 3.8 Flash составляет 4 096 токенов в Developer API и 6 144 токена в Vertex. Для предыдущего поколения Gemini 2.5 Pro порог на обеих платформах составляет 2 048 токенов. Порог может меняться вместе с версиями моделей, поэтому сверяйтесь с актуальной официальной документацией.
Вопрос 6: Кэш пропадёт, если заменить API-ключ?
Это зависит от того, меняете ли вы проект. В Vertex кэш изолирован по проектам Google Cloud и не используется совместно между разными проектами. Поэтому при переходе на ключ из другого проекта кэш будет недоступен. Но если новый ключ принадлежит тому же проекту, нельзя автоматически считать, что кэш пропадёт.
Вопрос 7: Что выбрать — неявное или явное кэширование?
Если вы регулярно используете один и тот же объёмный контент — например, длинный документ или системную инструкцию, — явное кэширование надёжнее. Но для него потребуются дополнительные усилия на разработку и оплата хранения. Если контент переиспользуется лишь время от времени, неявное кэширование не требует затрат, однако его эффект непредсказуем. Для начала можно провести небольшой сравнительный тест через APIYI apiyi.com, а затем решить, стоит ли разрабатывать явное кэширование.
Вопрос 8: Можно ли использовать долю попаданий, указанную в панели сервиса-прокси, для сверки счетов?
Не рекомендуем. Ориентируйтесь на исходные поля кэша в официальном ответе API. Кроме того, фактическое попадание в кэш на стороне Google и то, как сервис-прокси учитывает его в вашем счёте, — разные вещи. Правила тарификации сервиса-прокси нужно проверять отдельно.
Ключевые выводы о доле попаданий в кеш
- Это подтверждённое наблюдение: кеш стабильно срабатывает у моделей OpenAI и Claude, а у Gemini доля попаданий низкая или близка к нулю. Эту ситуацию нужно анализировать отдельно.
- Официальной гарантии нет: неявное кеширование Gemini не гарантирует экономию, а для явного кеширования нужно самостоятельно создать кеш и ссылаться на него.
- Порог зависит от модели: у моделей нового поколения он выше, а значения для Vertex и Developer API могут различаться.
- Попадание зависит от префикса: размещайте длинный контент в начале и не добавляйте туда изменяющиеся данные — например, время или ID. Иначе общий префикс будет нарушен.
- В Vertex кеш изолирован в рамках проекта: кеши не используются совместно между проектами, поэтому запросы, распределённые по разным проектам, не попадут в один и тот же кеш.
- Общий объём входных данных включает кеш:
promptTokenCountуже учитывает закешированную часть. При сверке сначала вычтите её, а затем рассчитайте стоимость каждой части отдельно. - Сверяйте данные по полям: ориентируйтесь на поля кеша в официальном ответе и сравнивайте модели с одинаковым промптом через APIYI apiyi.com.
Итоги
Низкая доля попаданий в кеш Gemini объясняется сочетанием нескольких условий: неявное кеширование не гарантирует попаданий, минимальный порог токенов растёт в зависимости от модели, префикс должен оставаться неизменным, кеш Vertex привязан к проекту, а для явного кеширования нужно вручную создать кеш. Если последние условия нарушаются на уровне цепочки обработки запросов, доля попаданий снижается. Но чтобы точно определить причину, нужно изучить проект на стороне поставщика и записи запросов.
При расчёте стоимости помните о трёх моментах: попадание в кеш не означает бесплатное использование; общий объём входных данных уже включает кешированную часть, поэтому её не нужно учитывать повторно; за хранение явного кеша взимается отдельная плата, а за неявное кеширование — нет. При сверке ориентируйтесь на поля в официальном ответе и отдельно проверяйте правила тарификации сервиса-прокси API.
Следующий шаг: запустите приведённый в статье тестовый скрипт с фиксированным длинным префиксом и сравните Gemini с OpenAI и Claude — это поможет решить, стоит ли подключать явное кеширование. Быстро проверить результаты можно через APIYI apiyi.com: для разных моделей используется один интерфейс, поэтому сравнивать затраты проще.
Справочные материалы
- Документация по кэшированию в Gemini API: официальное описание неявного и явного кэширования
- Ссылка:
ai.google.dev/gemini-api/docs/caching -
Примечание: указаны минимальный порог токенов и факторы, влияющие на стоимость
-
Страница с ценами Gemini API: стоимость обычных входных данных, кэшированных входных данных, выходных данных и хранения
- Ссылка:
ai.google.dev/gemini-api/docs/pricing -
Примечание: источник для проверки текущих тарифов
-
Обзор кэширования контекста в Vertex AI: изоляция кэша между проектами и правила тарификации
- Ссылка:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Примечание: поясняется, что кэш Vertex AI не используется совместно между проектами
-
Справочник по методу
generateContentв Gemini API: полеusageMetadataв ответе - Ссылка:
ai.google.dev/api/generate-content - Примечание: содержит поле с числом кэшированных токенов, используемое при сверке расходов
Автор: команда APIYI
Обсуждение технических вопросов: делитесь опытом диагностики проблем с кэшированием в Gemini в комментариях. Больше материалов — в центре документации APIYI: docs.apiyi.com