Примечание автора: 2 ноября 2026 года xAI официально вывела из эксплуатации идентификатор grok-imagine-image-quality. Старые запросы по-прежнему не вызывают ошибок, но за ними теперь работает Image 2.0 Low. На примере этой миграции Grok Imagine разберём риски управления версиями AI API и способы с ними справиться.
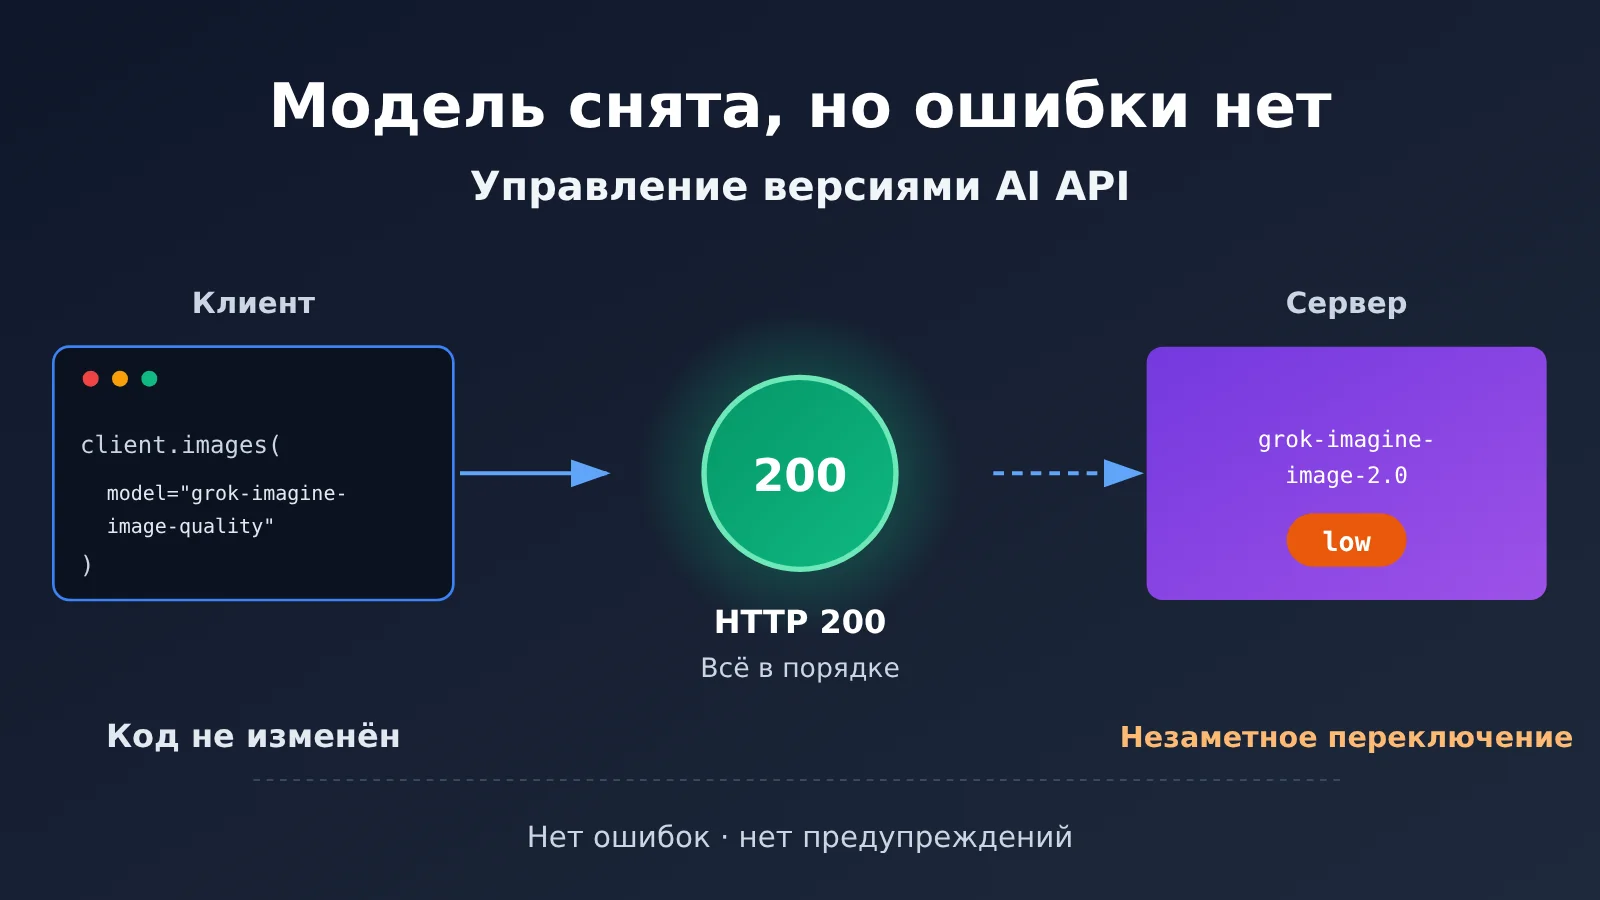
Сегодня, 2 ноября 2026 года, xAI выполнила ранее анонсированную миграцию модели генерации изображений. Старый идентификатор grok-imagine-image-quality по-прежнему работает, но фактически запросы обрабатывает grok-imagine-image-2.0 с фиксированным уровнем качества low. Для большинства приложений ничего внешне не изменилось: код остался прежним, запросы возвращают ответы, а на панели мониторинга нет красных предупреждений.
Это не сообщение об инциденте. Правила миграции xAI опубликовала в официальном уведомлении 2 сентября — за 60 дней до изменений. Пока нет свидетельств масштабных сбоев у пользователей. Но эта ситуация поднимает важный инженерный вопрос: совместимость интерфейса и успешный вызов ещё не означают, что модель, качество результатов и стоимость остались прежними.
Что вы узнаете: прочитав статью, вы поймёте, что именно изменилось при миграции Grok Imagine и почему для AI API нужен контроль версий, отдельный от обычного мониторинга доступности. А ещё получите чек-лист для проверки своей системы, который можно применить сразу.
Вывод модели Grok Imagine из эксплуатации: главное
Начнём с фактов, подтверждённых официальной документацией. Важно: 2 ноября — не дата запуска Image 2.0 (модель вышла ещё 7 августа), а дата вывода из эксплуатации конкретного устаревшего API-идентификатора.
| Параметр | Подробности |
|---|---|
| Дата вступления в силу | 2 ноября 2026 года (анонс 2 сентября, срок уведомления — 60 дней) |
| Источник | Официальное руководство xAI по миграции |
| Выводимый идентификатор | grok-imagine-image-quality |
| Модель на замену | grok-imagine-image-2.0 с фиксированным значением quality — low |
| Затронутые интерфейсы | /v1/images/generations и /v1/images/edits |
| Совместимость | Старый идентификатор по-прежнему распознаётся, структура запросов и ответов остаётся совместимой |
| Что не затронуто | По информации xAI, grok-imagine-image (1.0) не затронута этим изменением |
| Как проверить | Поле model в ответе показывает, какая модель фактически обработала запрос |
Цепочка перенаправлений старых идентификаторов Grok Imagine
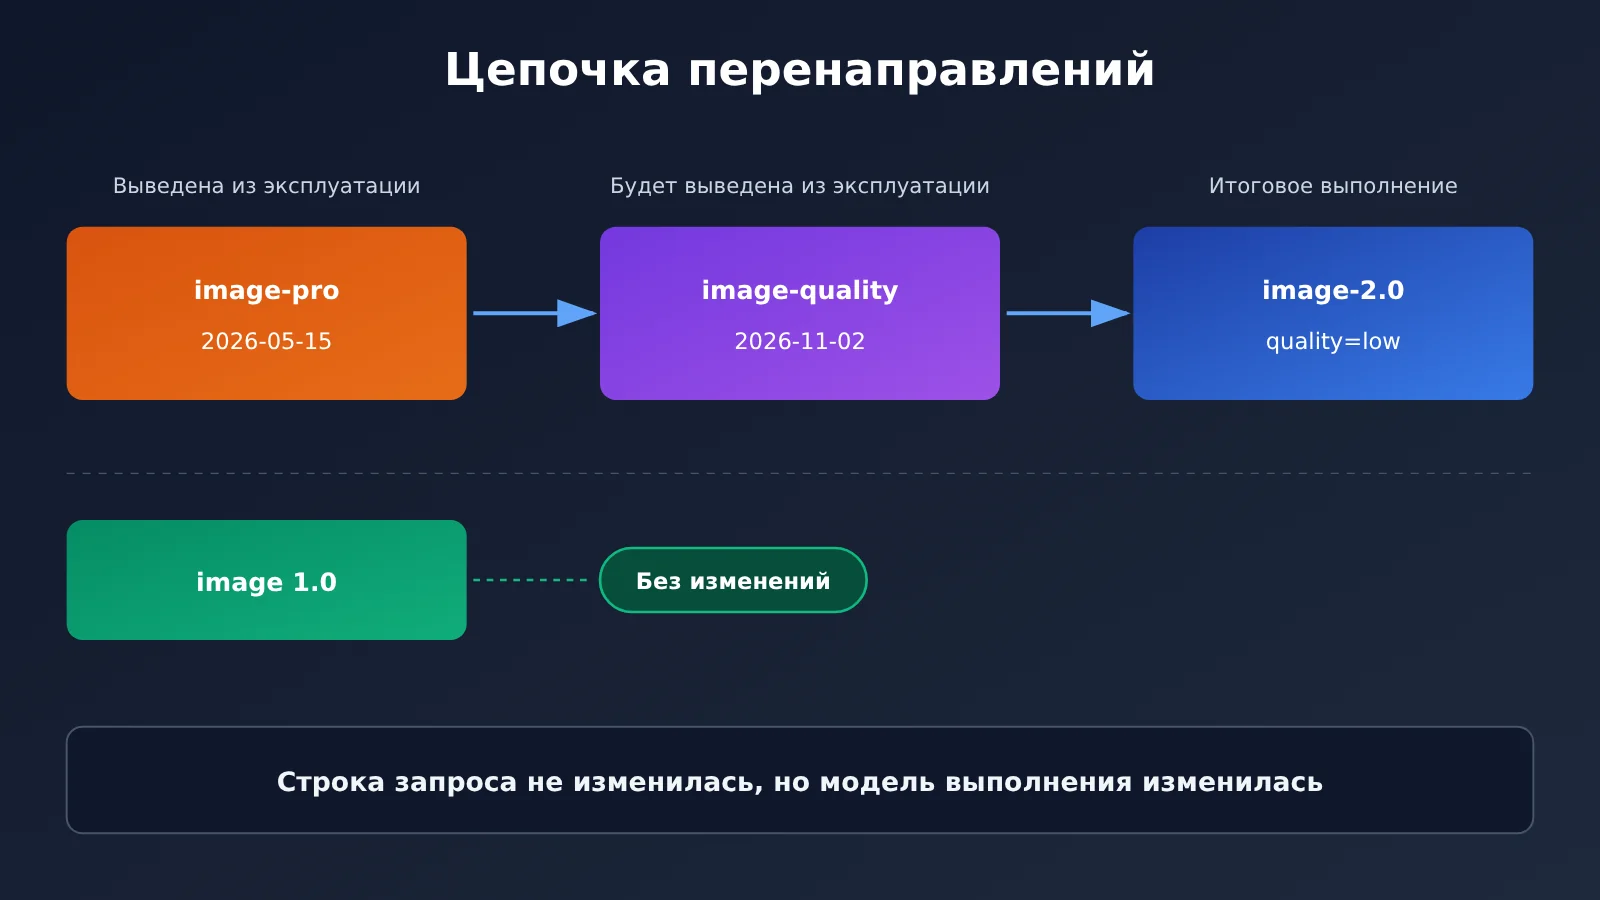
В этой миграции легко упустить из виду цепочку перенаправлений. Ещё 15 мая 2026 года xAI вывела из эксплуатации более старый идентификатор grok-imagine-image-pro и перенаправила его запросы на grok-imagine-image-quality. После 2 ноября цепочка продлилась ещё на одно звено.
Иными словами, приложение, которое ни разу не обновляло конфигурацию и всё ещё использует идентификатор pro, теперь фактически работает с Image 2.0 Low. Просто проверив строку model в файле конфигурации, уже нельзя определить, какая модель используется на самом деле.
| Идентификатор в конфигурации приложения | Статус | Фактический путь после 2 ноября |
|---|---|---|
grok-imagine-image-pro |
Выведен из эксплуатации 15 мая | pro → quality → 2.0 (low) |
grok-imagine-image-quality |
Выведен из эксплуатации 2 ноября | quality → 2.0 (low) |
grok-imagine-image-2.0 |
Официально доступен | 2.0, можно указать low / medium / auto |
grok-imagine-image |
1.0, по-прежнему доступен | Не затронут этим изменением |
4 типа рисков при управлении версиями AI API на примере миграции Grok Imagine
Приведённые ниже риски основаны на анализе официальных механизмов, а не на статистике реальных инцидентов xAI. Их можно разделить на четыре категории: идентичность модели, качество результатов, тарификация и мониторинг.
Риск первый: смена модели
Строка запроса на стороне клиента остаётся прежней, но на сервере её обрабатывает уже другая модель. В xAI поле model в ответе указывает фактически использованную модель — это хорошая новость. Но только при условии, что ваша система действительно записывает и проверяет это поле. Многие приложения просто жёстко задают имя модели в запросе и никогда не читают информацию о модели в ответе.
Риск второй: изменение качества и стиля результата
Официально подтверждена «совместимость структуры запросов», но не обещано, что изображения будут выглядеть одинаково. При выпуске Image 2.0 компания xAI делала акцент на соблюдении промптов с несколькими условиями, работе с мелким текстом и сложной вёрсткой, а также редактировании по нескольким эталонным изображениям. В то же время отдельные пользователи Reddit r/grok отмечали, что с версией 2.0 стало сложнее работать над деталями кожи, естественным освещением и сохранением исходного изображения.
Эти отзывы отражают субъективный опыт и в основном касаются пользовательского продукта. На их основании нельзя сделать вывод, что 2.0 стала хуже во всём. Но они показывают важную вещь: один и тот же промпт после смены модели может дать другую композицию, стиль или результат локального редактирования. Это нужно проверять с помощью регрессионных тестов, а не исходить из того, что «совместимость означает отсутствие проблем».
Риск третий: изменения в тарификации и уровнях качества
В данном случае переход привёл к снижению цены, но именно поэтому хорошо видно, насколько важен выбор уровня качества. Ниже приведены официальные цены xAI за одно выходное изображение в долларах, без учёта платы за входные эталонные изображения:
| Разрешение | Старая Quality | 2.0 Low | 2.0 Medium |
|---|---|---|---|
| 1K | $0.05 | $0.04 | $0.06 |
| 1.5K | $0.06 | $0.05 | $0.07 |
| 2K | $0.07 | $0.06 | $0.08 |
Если выпускать 10 000 изображений в разрешении 1K в месяц, теоретическая стоимость выходных изображений составит около $400 при сохранении старого идентификатора, который автоматически направляет запросы в 2.0 Low. Это на $100 меньше, чем $500 для старой Quality. Если же перейти на 2.0 Medium, стоимость составит $600 — на $100 больше, чем у старой версии. При редактировании изображений дополнительно взимается плата за входные данные: $0.01 за каждое эталонное изображение. Например, при одном эталонном и одном выходном изображении в разрешении 1K стоимость составит $0.06 для старой Quality, $0.05 для 2.0 Low и $0.07 для 2.0 Medium.
Менее очевидное отличие — значения по умолчанию. С 28 августа, если в 2.0 не указать quality, по умолчанию используется auto. При этом auto в настоящее время выбирает low для режима «текст-в-изображение» и medium для редактирования изображений. В официальной документации используется слово currently: это не постоянная привязка. Поэтому для задач редактирования «сохранить старый идентификатор» и «перейти на 2.0, не указав quality» — не одно и то же, и стоимость тоже будет различаться. Кроме того, в прайс-листе указано разрешение 1.5K, но в документации по параметрам генерации для resolution сейчас явно перечислены только 1k и 2k. Можно ли задать 1.5K, нужно проверить на практике.
Риск четвёртый: слепые зоны мониторинга
Если следить только за HTTP-кодами, долей успешных запросов и временем ответа, переключение модели будет практически «невидимым» в метриках. Другой пример — асинхронный режим генерации изображений xAI (deferred): статус pending возвращает HTTP 202, done — HTTP 200, а failed тоже возвращает HTTP 200, но с сообщением об ошибке в ответе. HTTP 200 вовсе не означает, что операция прошла успешно.
Как разные поставщики управляют версиями моделей
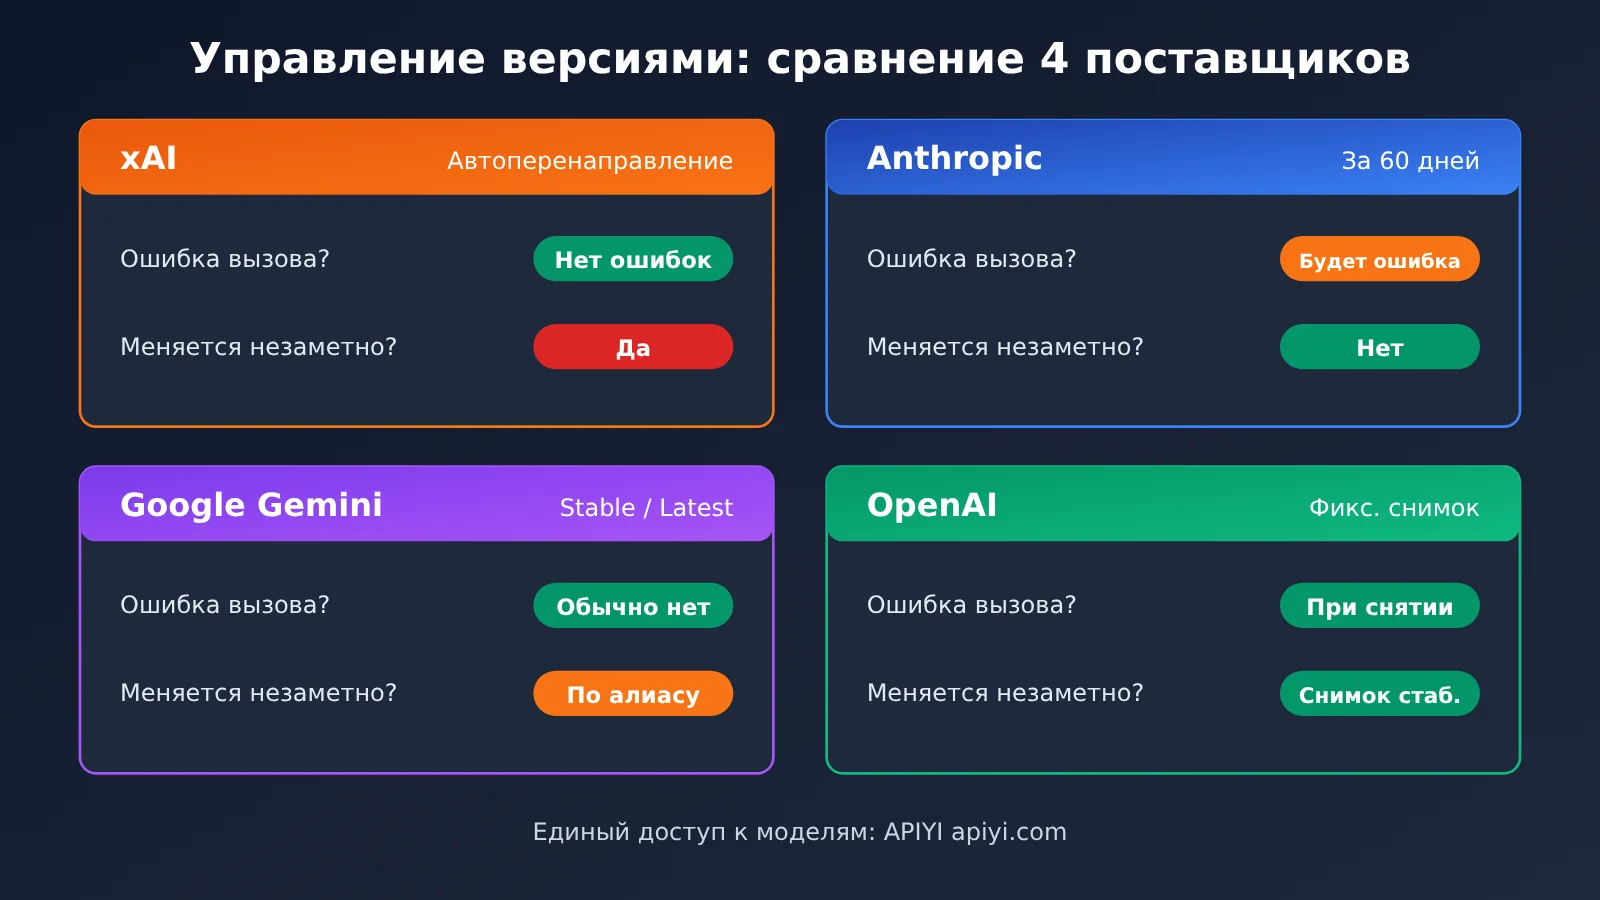
Подход xAI — «старый идентификатор остаётся рабочим, а модель подменяется на стороне сервера» — лишь одна из возможных стратегий. Нельзя считать её общим правилом для всех поставщиков. Сравнение официальной документации показывает существенные различия.
| Поставщик | Официальная политика версий | Что происходит после вывода из эксплуатации или изменения | Что это значит для разработчика |
|---|---|---|---|
| xAI | Идентификатор выведенной из эксплуатации модели остаётся рабочим, сервер перенаправляет запрос | Ошибки нет, фактическая модель меняется | Нужно проверять поле model в ответе |
| Anthropic | Четыре стадии: Active / Legacy / Deprecated / Retired | После перехода в Retired запросы завершаются ошибкой; о выводе общедоступных моделей уведомляют минимум за 60 дней | Ошибка становится заметной сразу; нужно следить за объявлениями об устаревании |
| Google Gemini | Stable / Preview / Latest / Experimental | Псевдоним Latest автоматически переключается на новую версию; о ломающих изменениях уведомляют заранее | Для продакшена рекомендуется Stable, Latest следует использовать с осторожностью |
| OpenAI | Рекомендует закреплять снимок модели в продакшене | Обратная совместимость структуры API не гарантирует одинаковые ответы | Закрепить снимок и создать набор для оценки, но продолжать следить за датами вывода из эксплуатации |
Сравнение с xAI: xAI обеспечивает наиболее «плавную» совместимость на стороне клиента: старый код не перестанет работать внезапно. Но за это приходится платить тем, что смена модели не проявляется в виде ошибки. Для сравнения, стратегия Anthropic с ошибкой после перехода в Retired более «шумная», зато позволяет раньше заметить проблему.
Сравнение с Google и OpenAI: Google явно заложила принцип «идентификатор не меняется, версия меняется» в псевдоним Latest. Это показывает, что такой механизм сам по себе открыт и распространён. OpenAI, напротив, рекомендует закреплять снимок в продакшене и создавать набор для оценки. Оба подхода показывают: управление версиями — не частная проблема одного поставщика, а инженерная задача при работе с любым AI API.
💡 Рекомендация: версии у разных поставщиков работают по-разному, поэтому при подключении нескольких моделей лучше единообразно записывать «запрошенную модель» и «фактическую модель». Если вы подключаете модели разных поставщиков через один OpenAI-совместимый интерфейс APIYI apiyi.com, эти два поля также стоит сохранять на уровне приложения — так будет проще сравнивать результаты между поставщиками.
Как организовать управление версиями AI API: логи, затраты и поэтапное развёртывание
Шаг 1. Разделите запрошенную и фактически использованную модели
В семантических соглашениях OpenTelemetry для генеративного ИИ есть два важных атрибута: gen_ai.request.model обозначает модель, запрошенную клиентом, а gen_ai.response.model — модель, которая фактически сгенерировала ответ. xAI не возвращает автоматически полный набор полей телеметрии, поэтому приложение должно самостоятельно собирать эти данные и сопоставлять поля. Рекомендуемые поля бизнес-логов приведены ниже. Это инженерные рекомендации, а не обязательное требование поставщика.
| Поле | Назначение | Что учесть |
|---|---|---|
requested_model / served_model |
Выявление незаметной переадресации | Значение served берётся из поля model в ответе |
quality_requested / quality_effective |
Отслеживание уровня качества | Если effective можно определить только по документации, пометьте его как предполагаемое значение |
response_status / business_status |
Разграничение HTTP-статуса и бизнес-результата | Асинхронная операция со статусом failed тоже может вернуть HTTP 200 |
cost_usd |
Фактическая стоимость одного запроса | Для xAI можно рассчитать из cost_in_usd_ticks |
reference_image_count / resolution |
Распределение затрат | При редактировании изображений нужно учитывать стоимость входных данных |
prompt_template_version / evaluation_result |
Сравнение при регрессионном тестировании | Не записывайте по умолчанию промпты с конфиденциальными данными и изображения пользователей |
Шаг 2: записываем в коде фактическую модель и стоимость
Согласно официальной документации xAI по отслеживанию затрат (Cost Tracking), обновлённой 10 октября 2026 года, объект usage в ответе может содержать поле cost_in_usd_ticks. Формула пересчёта: cost_usd = cost_in_usd_ticks / 10000000000. В официальном примере 400000000 ticks соответствуют $0.04. Это специфичное для xAI поле: при вызове через SDK или стороннюю платформу стоит проверить, передаётся ли оно без изменений.
Простой пример ниже показывает, как сравнивать запрошенную и фактически использованную модели при каждом запросе:
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
REQUESTED_MODEL = "grok-imagine-image-2.0"  # 示例名称,可用模型以平台实际列表为准

resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"model": REQUESTED_MODEL, "prompt": "A tech magazine cover",
          "quality": "low", "resolution": "1k", "n": 1},
    timeout=180,
).json()

served = resp.get("model")
if served and served != REQUESTED_MODEL:
    print(f"[版本告警] 请求 {REQUESTED_MODEL},实际执行 {served}")
Посмотреть полную реализацию с проверкой стоимости и бизнес-статуса
import time
import logging
import requests
from typing import Optional

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("model_governance")

BASE_URL = "https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
TICKS_PER_USD = 10_000_000_000  # xAI 官方换算:1 美元 = 10^10 ticks


def generate_image(
    prompt: str,
    model: str,
    quality: str = "low",          # 显式填写,避免 auto 默认值随上游变化
    resolution: str = "1k",
    api_key: str = "YOUR_API_KEY",
    expected_unit_cost: Optional[float] = None,
) -> dict:
    start = time.time()
    r = requests.post(
        f"{BASE_URL}/images/generations",
        headers={"Authorization": f"Bearer {api_key}"},
        json={"model": model, "prompt": prompt, "quality": quality,
              "resolution": resolution, "n": 1},
        timeout=180,
    )
    latency_ms = int((time.time() - start) * 1000)
    body = r.json() if r.content else {}

    # 1. 执行模型校验
    served_model = body.get("model")

    # 2. 业务结果校验:HTTP 200 不等于拿到可用图片
    data = body.get("data") or []
    has_image = bool(data and (data[0].get("url") or data[0].get("b64_json")))
    business_ok = r.status_code == 200 and has_image and not body.get("error")

    # 3. 成本:字段可能不被透传,缺失时记录为 None 而不是 0
    ticks = (body.get("usage") or {}).get("cost_in_usd_ticks")
    cost_usd = ticks / TICKS_PER_USD if ticks is not None else None

    record = {
        "requested_model": model,
        "served_model": served_model,
        "quality_requested": quality,
        "resolution": resolution,
        "response_status": r.status_code,
        "business_status": "ok" if business_ok else "failed",
        "latency_ms": latency_ms,
        "cost_usd": cost_usd,
    }

    if served_model and served_model != model:
        log.warning("模型重定向: %s -> %s", model, served_model)
    if cost_usd is not None and expected_unit_cost is not None \
            and abs(cost_usd - expected_unit_cost) > 1e-6:
        log.warning("单价偏离预期: 预期 %.4f 实际 %.4f", expected_unit_cost, cost_usd)

    log.info("generation record: %s", record)
    return record


if __name__ == "__main__":
    generate_image(
        prompt="A clean product shot on white background",
        model="grok-imagine-image-2.0",  # 以平台模型列表为准
        quality="low",
        expected_unit_cost=0.04,
    )
🚀 Быстрый старт: чтобы проверить эту схему логирования, зарегистрируйтесь на APIYI apiyi.com, получите тестовый лимит и запустите несколько промптов из своих рабочих задач, проверив поля журнала. Список доступных моделей для генерации изображений, поддерживаемые параметры качества и актуальные цены уточняйте в каталоге моделей и на странице цен платформы. Цены сторонней платформы не обязательно совпадают с официальными ценами xAI.
Шаг третий: фиксированный тестовый набор и канареечное развёртывание
Опираясь на метод Canary Release из Google SRE и рекомендации OpenAI по оценочным наборам, миграцию модели генерации изображений можно провести так: сначала подготовить фиксированный набор образцов, включающий постеры с текстом, изображения товаров, редактирование портретов, композиции с несколькими объектами и локальные правки. Затем зафиксировать промпт, входное изображение, разрешение, качество, соотношение сторон и количество генерируемых изображений. После этого сравнить следование инструкциям, сохранение основного объекта, точность текста, изменения за пределами редактируемой области, долю изображений, прошедших ручную приёмку, и стоимость одного пригодного изображения. Наконец, при условии управляемой маршрутизации переключить небольшую часть трафика, понаблюдать за метриками и затем расширять переключение.
Важно смотреть на ситуацию реалистично: в этот раз xAI принудительно выводит модель из эксплуатации на стороне поставщика, поэтому разработчикам не стоит рассчитывать на возможность вернуться к снятой с эксплуатации старой модели Quality. Здесь под «откатом» следует понимать переключение на проверенную и всё ещё доступную альтернативную модель, приостановку затронутых функций или изменение параметра quality, а не восстановление старой версии, к которой уже нет доступа.
Как миграция Grok Imagine повлияет на разработчиков и API-платформы
Влияние на разработчиков
- Расширьте область поиска: ищите не только
grok-imagine-image-quality, но и более старые псевдонимы, напримерgrok-imagine-image-pro. - Указывайте параметры явно: при прямой миграции на 2.0 явно задавайте low или medium, чтобы auto не выбирал за вас уровень качества и стоимость редактирования.
- Пересмотрите расчёт затрат: заявление об удешевлении «на $0,01 за изображение» относится к цене выходного изображения. При редактировании с эталонным изображением общее снижение затрат будет другим.
- Проводите независимую приёмку: помимо доли успешных вызовов, отслеживайте результаты приёмки по бизнес-критериям и стоимость одного пригодного изображения.
Влияние на платформы-агрегаторы API
Для платформ, которые предоставляют доступ к нескольким моделям, управление версиями становится реальной потребностью клиентов. Им важно знать, в какую модель поставщика попал запрос, видеть сроки вывода моделей из эксплуатации и перенаправления запросов, а также изменения цен. Кроме того, ключевые параметры, такие как quality, должны корректно передаваться, а сведения о модели и начислениях — быть доступными для проверки. Платформам-агрегаторам стоит оценить и развивать эти возможности.
🎯 Техническая рекомендация: если вы подключаетесь к моделям разных поставщиков через платформу-агрегатор, например APIYI apiyi.com, во время миграции проверьте три вещи: отражает ли поле model в ответе фактическую модель поставщика, передаётся ли параметр quality и соответствуют ли начисления ожидаемой цене за единицу. Если обнаружите расхождения, сохраните ID запроса и обратитесь в техническую поддержку платформы — это гораздо эффективнее, чем потом разбирать счета.
Часто задаваемые вопросы FAQ
Q1: Что именно означает вывод модели Grok Imagine из эксплуатации?
С 2 ноября 2026 года идентификатор `grok-imagine-image-quality` в xAI API выведен из эксплуатации, но по нему по-прежнему можно отправлять запросы. Сервер перенаправляет их на `grok-imagine-image-2.0` с фиксированным уровнем low. Изменение затрагивает оба интерфейса — генерации и редактирования. Модель 1.0 `grok-imagine-image` не затронута.
Q2: Старый код выдаст ошибку 404 или просто перестанет работать?
Нет. По заявлению xAI, старый идентификатор по-прежнему распознаётся, а запросы автоматически перенаправляются. Структура запросов и ответов остаётся совместимой. В этом и заключается риск: отсутствие ошибки не означает, что качество результата и цена не изменились. Это отличается от подхода Anthropic, при котором запросы к моделям в статусе Retired завершаются ошибкой.
Q3: Если просто перейти на grok-imagine-image-2.0, всё будет работать точно так же, как раньше?
Не совсем. Если перейти на 2.0 и не указывать параметр quality, по умолчанию используется auto: сейчас для режима «текст-в-изображение» выбирается low, а для редактирования изображений — medium. Если же оставить старый идентификатор, уровень будет фиксированным — low. При использовании medium для редактирования цена результата в разрешении 1K составляет $0.06, что выше $0.05 у старой Quality. Рекомендуется явно указывать уровень и проверять результат на фиксированном наборе тестов.
Q4: Как узнать, какая модель на самом деле используется в моей системе?
Считывайте и записывайте поле `model` из ответа и сравнивайте его с моделью, указанной в запросе. Также фиксируйте фактическую стоимость, рассчитанную на основе `cost_in_usd_ticks`, если это поле доступно. При вызове через сторонние платформы, например APIYI apiyi.com, дополнительно проверьте, передаются ли эти поля без изменений. Актуальную доступность моделей и цены уточняйте на официальной странице платформы.
Q5: Если результат новой модели не устраивает, можно ли вернуться к старой Quality?
Рассчитывать на это не стоит. Вывод из эксплуатации выполняется на стороне поставщика, и доступ к модели, лежавшей в основе старой Quality, не гарантирован. Можно изменить параметр quality, переключиться на альтернативную модель, проверенную на ваших задачах, или временно отключить затронутую функцию. Лучше заранее подготовить проверенный запасной вариант: например, с помощью единого интерфейса APIYI apiyi.com протестировать переключение между несколькими моделями. Это спокойнее, чем устранять проблему в последний момент.
Q6: Image 2.0 лучше старой версии?
Однозначного ответа нет. При выпуске xAI заявляла, что модель занимала второе место в тогдашних рейтингах Arena для режима «текст-в-изображение» и редактирования изображений. Это исторический результат на 7 августа; снимок рейтингов Arena за конец октября показывает пятое место в общем рейтинге редактирования одного изображения и шестое — в общем рейтинге «текст-в-изображение». Некоторые участники сообщества также жаловались на недостаточно реалистичные текстуры и сохранение исходного изображения. Заявленные возможности, независимые тесты и субъективные предпочтения — разные вещи. Самый надёжный ориентир — результаты на собственном наборе тестов для ваших задач.
Главное об управлении версиями AI API
- Успешный вызов ≠ модель осталась прежней: старый идентификатор Grok Imagine не вызывает ошибки, но запросы уже незаметно перенаправляются на 2.0 Low.
- Алиасы могут перенаправляться по цепочке: pro → quality → 2.0 Low. Проверить только строку в конфигурации недостаточно.
- Значения по умолчанию тоже меняются: сейчас auto выбирает low для генерации и medium для редактирования. Лучше задавать значение явно.
- Стоимость нужно проверять по фактическому счёту: при редактировании взимается плата и за входное эталонное изображение, поэтому снижение общих затрат отличается от снижения цены за выходные данные.
- HTTP 200 не означает успешное выполнение задачи: асинхронная задача со статусом failed тоже может вернуть 200.
- У каждого поставщика своя политика: перенаправление, ошибка, переключение Latest на лету и фиксированные снимки версий требуют разного подхода.
- Начать можно с логов: используйте тестовый баланс на APIYI apiyi.com, чтобы настроить запись двух полей — запрошенной модели и модели, которая фактически выполнила запрос.
Итоги
Главные выводы из миграции Grok Imagine:
- Политика совместимости может скрывать изменения: xAI выбрала максимально плавное для клиентов перенаправление. Изменения модели, уровня качества и цены не проявляются в виде ошибок.
- Для управления версиями нужен отдельный механизм: запись запрошенной и фактически использованной моделей, отслеживание реальных затрат и проверка результатов по бизнес-критериям выходят за рамки обычного мониторинга доступности.
- Откат нужно продумывать заранее: принудительное снятие модели с поддержки на стороне поставщика нельзя отменить. Остаётся рассчитывать только на заранее проверенные альтернативные модели и настройки.
Советуем уже сегодня провести проверку: найдите в коде старые идентификаторы моделей, сравните их с полем model в ответе, явно задайте параметр quality для редактирования и генерации и подготовьте фиксированный набор тестовых примеров. Через APIYI apiyi.com можно настроить среду для сравнительного тестирования нескольких моделей с единым интерфейсом. Это поможет наладить наблюдаемость версий до следующего изменения на стороне поставщика.
📚 Источники
- Руководство xAI по миграции моделей генерации изображений от 02.11.2026: правила вывода из эксплуатации и перенаправления
- Ссылка:
docs.x.ai/developers/migration/imagine-image-quality-nov-2 -
Описание: первоисточник сведений о выводимых идентификаторах, моделях-заменах, уровнях качества и масштабе изменений
-
История вывода моделей xAI из эксплуатации от 15.05.2026: миграция идентификатора pro
- Ссылка:
docs.x.ai/developers/migration/may-15-retirement -
Описание: ключевой источник для понимания цепочек перенаправлений
-
Официальный прайс-лист xAI и страница модели Image 2.0: разрешения и цены по уровням качества
- Ссылка:
docs.x.ai/developers/pricing -
Описание: данные для расчёта стоимости выходных и входных эталонных изображений
-
Документация xAI по параметрам генерации изображений: значение quality по умолчанию и асинхронные статусы
- Ссылка:
docs.x.ai/developers/model-capabilities/images/generation -
Описание: поведение auto и HTTP-статусы в режиме deferred
-
xAI Cost Tracking: поле фактической стоимости отдельного запроса
- Ссылка:
docs.x.ai/developers/cost-tracking -
Описание: значение cost_in_usd_ticks и способ пересчёта
-
Документация Anthropic об устаревании моделей: четыре этапа жизненного цикла модели
- Ссылка:
docs.anthropic.com/en/docs/about-claude/model-deprecations -
Описание: для сравнения — политика отказа в обработке запросов после перехода модели в статус Retired
-
Документация Google по версиям моделей Gemini: разница между Stable и Latest
- Ссылка:
ai.google.dev/gemini-api/docs/models -
Описание: механизм автоматического переключения алиасов
-
Руководство OpenAI по промпт-инжинирингу и обзор API: фиксация снапшотов и рекомендации по оценке
- Ссылка:
developers.openai.com/api/docs/guides/prompt-engineering -
Описание: официальные рекомендации по фиксации снапшотов в продакшене и созданию набора для оценки
-
Google SRE Canary Release: метод канареечного развёртывания
- Ссылка:
sre.google/workbook/canarying-releases/ -
Описание: проверка на небольшой доле трафика помогает снизить масштаб последствий изменений
-
Семантические соглашения OpenTelemetry для генеративного ИИ: атрибуты модели в запросе и ответе
- Ссылка:
opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/ - Описание: определения gen_ai.request.model и gen_ai.response.model
- Ссылка:
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы по интеграции доступны в центре документации docs.apiyi.com