Заключение
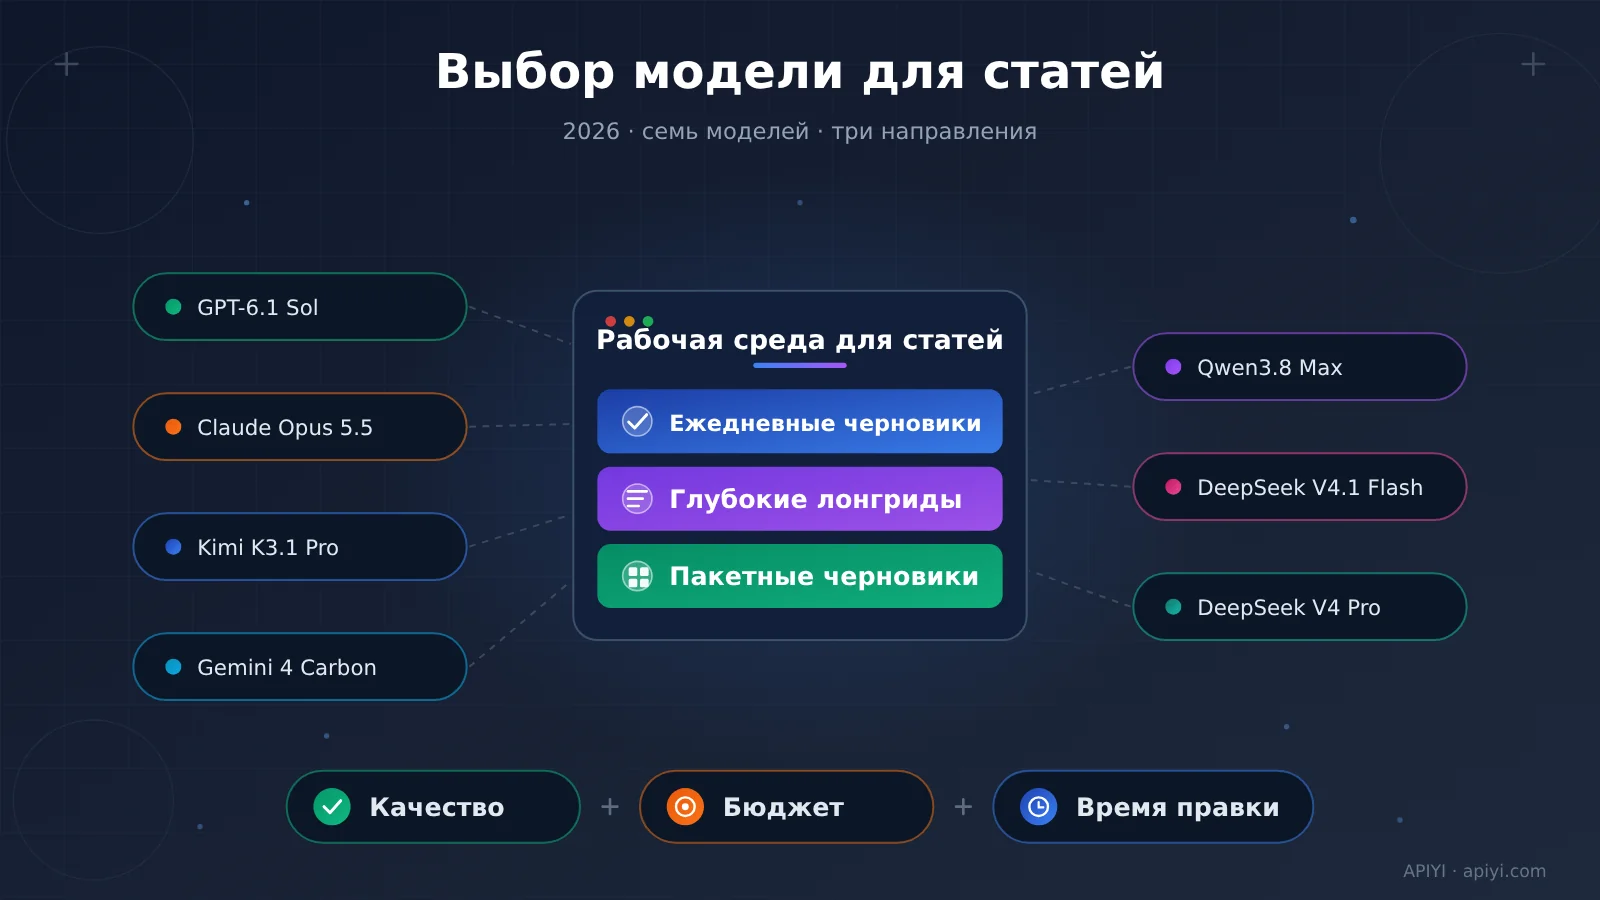
Для повседневных статей сначала тестируйте GPT-6.1 Sol, для важных длинных материалов — Claude Opus 5.5, для массовых черновиков — DeepSeek V4.1 Flash. Для задач с большим объёмом исходных материалов подключайте Kimi и Gemini, для структурированной генерации — Qwen, а DeepSeek Pro проверяйте под конкретные задачи.
Это кандидаты для тестирования, а не список чемпионов по письму на китайском. По-настоящему выгодная комбинация должна учитывать одновременно понимание материалов, качество текста, стоимость вызовов и время на редактуру.
Что будет дальше
- Что показывают три типа тестов письма.
- В чём реальные различия между семью моделями.
- Как распределять основную и запасную модели для разных операционных задач.
- Как считать стоимость и проводить слепое тестирование через единый интерфейс.
Какую большую языковую модель выбрать для написания операционных статей: сначала разберитесь в методике тестирования
Бенчмарк модели — это набор тестов, которые измеряют её производительность на унифицированных задачах. При выборе под операционные задачи в первую очередь стоит смотреть на тесты, близкие к реальному производственному процессу: те же материалы, тот же план, тот же объём — и только потом сравнивать готовые тексты.
Какую большую языковую модель выбрать для статей в контент-маркетинге: английские оценки помогают отобрать кандидатов
AI Writing Benchmark обновлён 11 ноября 2026 года: используются единые задания по письму на английском и сравнение со скрытыми названиями моделей. Охват — 115 моделей и 131,507 слепых оценок.
Общий балл GPT-6.1 Sol за английский — 95.3, за статьи, блоги и редакторские материалы — 98.5. У Claude Opus 5.5 и Kimi K3.1 Pro общие баллы 92.9 и 91.9 соответственно; оба показателя — базовые оценки.
Если говорить прямо, GPT стоит включить в пул кандидатов для написания блогов. А вот сократит ли он число правок для китайского аккаунта в WeChat — покажет локальный тест. Проект ведёт один человек, так что язык и методику оценки тоже стоит учитывать.
С версиями особенно важно не путаться: в категории объяснений и научно-популярных текстов лидирует Kimi K3; в ToneBench отдельный показатель «меньше шаблонности» — 89.0 — относится к GPT-6 Sol. Эти два результата относятся к прежним названиям версий.
Какую большую языковую модель выбрать для статей в контент-маркетинге: тест сценариев ближе к написанию по пакету материалов
Снимок ToneBench от 10 ноября 2026 года проверяет сценарии длинных видео на английском: модель получает творческое задание и пакет исследовательских материалов и генерирует без доступа к внешним источникам. Тест охватывает 87 моделей, 151 конфигурацию и 7,550 черновиков.
В таблице ниже приведены значения Writing Score для выбранных конфигураций. Для Claude указана конфигурация xhigh; в строках сохранены собственные конфигурации инференса из теста, бюджет вычислений не унифицирован, поэтому здесь только баллы — без смешения мест в рейтинге моделей и рейтинге конфигураций.
| Модель | Writing Score | Оценка стоимости одного сценария в тесте |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, версия 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
Главный вывод: Opus стоит тестировать первым, если нужны качественные длинные тексты; Flash показал, что может конкурировать за счёт низкой стоимости. Стоимость в таблице относится к объёму работы над сценарием в этом тесте; переносить её напрямую на расценки за китайские контент-статьи нельзя.
В этом тесте оценку выставляют модели, поэтому возможна предвзятость к производителям; доверительные интервалы лидеров пересекаются, а изменение эталонного сценария тоже может повлиять на первое место. Он подходит, чтобы сузить круг кандидатов, а затем проверить их с редактором.
Пояснение к иллюстрации: ниже распределение кандидатов показано через качество и стоимость; данные — из указанного выше снимка ToneBench. При повторном тестировании через APIYI apiyi.com отдельно фиксируйте свои Token, конфигурацию и время на редактирование.
Какую большую языковую модель выбрать для контентных статей: китайские данные показывают границы применимости
OmniTools с 26 октября по 3 ноября 2026 года тестировал глубокие статьи по китайской финансовой тематике: 10 моделей в сумме создали 26 статей. Оценка в слепом тестировании ИИ у Opus 5.5 — 8.25, у GPT-6.1 Sol — 6.33.
Это даёт основание считать Opus кандидатом для длинных текстов на китайском. Но выборка небольшая, у моделей разное число статей, а у тестировавшей стороны есть коммерческий сервис маршрутизации, поэтому выводы стоит ограничить этим кейсом с финансовыми лонгридами.
Какую большую языковую модель выбрать для контентных статей: разбираем 7 моделей по очереди
Какую большую языковую модель выбрать для контентных статей: как разделить задачи между GPT и Claude
GPT-6.1 Sol: приоритетный кандидат для повседневного написания черновиков. У него заметные результаты в категории англоязычных статей, поэтому его стоит первым тестировать на технологических блогах, разборах продуктов и объяснении новостей. Естественность китайского и точность цитирования нужно оценивать отдельно.
Claude Opus 5.5: приоритетный кандидат для важных лонгридов. Его поддерживают и сценарный тест, и кейс с китайскими финансовыми статьями. Для специальных материалов и брендовых лонгридов можно начать с него; а для частых коротких текстов стоит проверить, оправдывает ли прирост качества более высокую цену.
Какую большую языковую модель выбрать для контентных статей: как использовать Kimi, Gemini и Qwen
Kimi K3.1 Pro: кандидат для задач с длинными материалами. Контекст около 1 млн токенов и результаты по общему письму на английском позволяют включить его в тестирование статей с интенсивным использованием знаний. Оценку K3 в категории научно-популярных текстов нужно рассматривать отдельно.
Gemini 4 Carbon: кандидат для анализа сложных материалов. Сначала можно поручить ему разобрать многошаговые вопросы, связи между доказательствами и структуру статьи, а затем сравнить с результатом прямой генерации готового текста. Текущие данные скорее поддерживают вывод о том, что это кандидат, а не окончательный выбор.
Qwen3.8 Max: кандидат для структурированного производства контента. На нём можно тестировать описания продуктов, постоянные рубрики и шаблонный контент. В пакетном инференсе контекст на один запрос ограничен 256K, поэтому перед подключением нужно проверить поддержку в вашем регионе.
Какую большую языковую модель выбрать для контентных статей: как выбрать между DeepSeek Flash и Pro
DeepSeek V4.1 Flash: приоритетный кандидат для дешёвых черновиков. В упомянутом сценарном тесте он сочетает достойный балл с низкой стоимостью, поэтому подходит для массовых черновиков, переписывания и объяснения знаний. Перед публикацией оставляйте проверку фактов человеком.
DeepSeek V4 Pro: кандидат для узких задач. API по-прежнему работает, но в этом сценарном тесте Flash получил более высокий балл. Повышать бюджет стоит только тогда, когда слепое тестирование на конкретной задаче докажет выгоду.
Какую большую языковую модель выбрать для статей в контент-маркетинге: многоуровневая схема по задачам
Ниже — порядок тестирования, составленный на основе имеющихся данных. Какие результаты на китайском языке взять в работу, решает слепая оценка команды.
| Задача контент-маркетинга | Приоритетные кандидаты | Альтернатива или схема сочетания |
|---|---|---|
| Технологические новости, повседневные блоги | GPT-6.1 Sol | Flash готовит черновик, GPT редактирует |
| Глубокая отраслевая аналитика, длинные брендовые статьи | Claude Opus 5.5 | Слепое тестирование GPT на ту же тему |
| Технические руководства, научно-популярные материалы | GPT, Kimi K3.1 Pro | Flash как недорогой контрольный вариант |
| Синтез длинных материалов, сложные темы | Kimi, Gemini | Сначала собрать доказательства, затем передать модели для финального текста |
| Маркетинговые статьи, короткий контент для соцсетей | Сначала тестировать GPT на коротком контенте | В длинные брендовые статьи добавить Opus |
| Пакетный структурированный контент | Qwen, Flash | Основную модель выбирать по доле принятых материалов |
| Доступные платформы | Официальные API соответствующих моделей | Единый вызов и сравнение через APIYI apiyi.com |
Среди моделей для маркетинга и продаж на английском языке лидирует Claude Sonnet 5.5 — она вне этого списка из семи моделей. Если маркетинговые тексты — ваш основной бизнес, расширьте пул кандидатов, а не выбирайте чемпиона только среди моделей для длинных текстов.
Совет для быстрого старта: APIYI apiyi.com предоставляет OpenAI-совместимый API, через который одним API-ключом можно вызывать несколько моделей; новым пользователям доступен бесплатный тестовый лимит. Сначала сравните три модели на одной и той же теме, затем расширяйте тестирование.
Какую большую языковую модель выбрать для операционных статей: считаем стоимость до готового материала
Токен — это единица измерения текста, который обрабатывает модель; входные токены включают промпт, материалы и контекст, а выходные — сгенерированный контент. Контекстное окно показывает, какой объём можно обработать за один вызов.
Ниже используется снимок цен APIYI на 12 ноября 2026 года, 10:45, UTC+8, в долларах за миллион токенов. В примерах везде берём 10 000 входных и 3 000 выходных токенов.
| Модель | Цена входа | Цена выхода | Стоимость одного примера |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
Формула расчёта: «объём входа ÷ миллион × цена входа + объём выхода ÷ миллион × цена выхода». Эта таблица сравнивает базовую стоимость одной генерации; повторы, проверку и время редактирования нужно считать отдельно.
Различия между маршрутами тоже меняют счёт и возможности:
- Официальные региональные цены Qwen: Сингапур — $2/$6; Пекин и Вирджиния (США) — $1.65/$4.951.
- Прямое официальное подключение Gemini: вводный период до 30 ноября; с 1 декабря — $4/$20, токены рассуждения входят в стоимость выхода. Для сторонних провайдеров сверяйтесь с их объявлениями.
- Прямое официальное подключение DeepSeek: в непиковые часы цена вдвое ниже; применимые интервалы проверяйте по официальным правилам.
- Пакетные возможности Kimi: правила пакетной обработки в канале Moonshot нужно уточнять отдельно; в документации Alibaba Cloud для K3.1 Pro указано, что пакетный инференс не поддерживается.
Кэш промптов — это переиспользование повторяющегося входа по правилам провайдера с соответствующей оплатой. Единый интерфейс удобен для переключения, но кэш, поиск, режимы рассуждения и пакетные возможности всё равно нужно проверять для каждого маршрута отдельно.
Какую большую модель выбрать для написания статей для операционной работы: как провести реальный слепой тест
Минималистичный вызов подойдёт для проверки связи с API. Ниже показана только генерация текста — поиск и другие инструменты не подключены.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Для полноценного сравнения нужны одинаковые материалы и одна и та же задача, а каждая модель должна независимо генерировать результат минимум три раза. Ниже сохраняются черновики и данные о расходе токенов; при оценке метки моделей скрываются, а редактор затем фиксирует время на правки и факт использования материала.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Оценивать стоит фактическую точность, проработку плана, естественность китайского языка, читаемость и прирост содержания. Одновременно фиксируйте долю фрагментов, сохранённых редактором, и стоимость одного пригодного материала: если дешёвый черновик приходится переписывать целиком, экономия — копейки, а потеря — полдня.
Какую большую модель выбрать для написания статей для операционной работы: частые вопросы
Бюджет ограничен — какие модели тестировать первыми?
Сначала сравните Flash, GPT и Opus: они покрывают низкую стоимость, повседневную подготовку текстов и важные длинные статьи. Переключать модели через APIYI apiyi.com удобнее — меньше работы по отдельной настройке каждого подключения.
Может ли один интерфейс сделать сравнение полностью честным?
APIYI apiyi.com может унифицировать форму вызова; для честности всё равно нужны одинаковые материалы, права на инструменты, объём и настройки рассуждения. Записывайте версии моделей и эндпоинты, чтобы не смешивать разные условия работы.
Какую большую языковую модель выбрать для написания операционных статей: заключительные рекомендации
Используйте многоуровневый подбор: для обычных черновиков — недорогие кандидаты, для важных статей — модели высокого качества, проверку фактов — отдельному процессу верификации с обязательной ручной проверкой. Рекомендации по моделям в конечном счёте должны опираться на реальную статистику использования в команде.
Проверить эти комбинации удобно через APIYI apiyi.com: тестируйте в режиме оплаты по факту использования и сверяйте актуальные цены. Конечная цель выбора модели — стабильно получать достойные статьи, а не взваливать всю работу на победителя рейтинга.
Источники
- AI Writing Benchmark: aiwritingbenchmark.com, обновлено 11 ноября 2026 г.
- ToneBench: benchmark.towardsai.com/models/, снимок от 10 ноября 2026 г.
- Практический тест OmniTools на длинных текстах на китайском: omnitools.ai/evals/longform-writing.
- Официальные цены Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing, проверено 12 ноября 2026 г.
- Официальное изменение цен Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Автор: команда технического контента APIYI. Приглашаем к обсуждению вызовов моделей и оценки операционных статей на apiyi.com — при сравнении указывайте версию, конфигурацию и постановку задачи.