Примечание автора: сравниваем три типа каналов GPT-Image (официальный «官转», -all и -vip) по тарификации, поддерживаемым размерам и локальному редактированию, разбираем исторические сбои апреля–октября 2026 года и предлагаем страховочную схему: «ограниченные повторы + circuit breaker (автоматическое отключение канала) + резервный канал».
Разработчики, которые подключают GPT-Image, быстро сталкиваются с проблемой: у одной и той же модели на платформе сразу несколько названий. Официальный канал (官转, например gpt-image-2.5-flare), -all и -vip отличаются способом тарификации и набором доступных параметров, да и ломаются они по разным причинам. В статье сравниваем три типа каналов GPT-Image по этим параметрам и даём схему выбора канала и страховки, которую можно сразу внедрять.
Это не компромиссный разбор в духе «у каждого свои плюсы». Выводы ниже опираются на страницу сравнения каналов в центре документации APIYI, на реестр моделей и на оперативные сообщения о статусе за апрель–октябрь 2026 года. Мы отдельно отмечаем, что из этого официальные объявления платформы, что результаты тестов платформы, а что просто историческая хроника.
Главная ценность: дочитав статью, вы поймёте, какой канал GPT-Image брать основным, какой резервным и как программе реагировать на ошибки 429, 408 и 5xx.
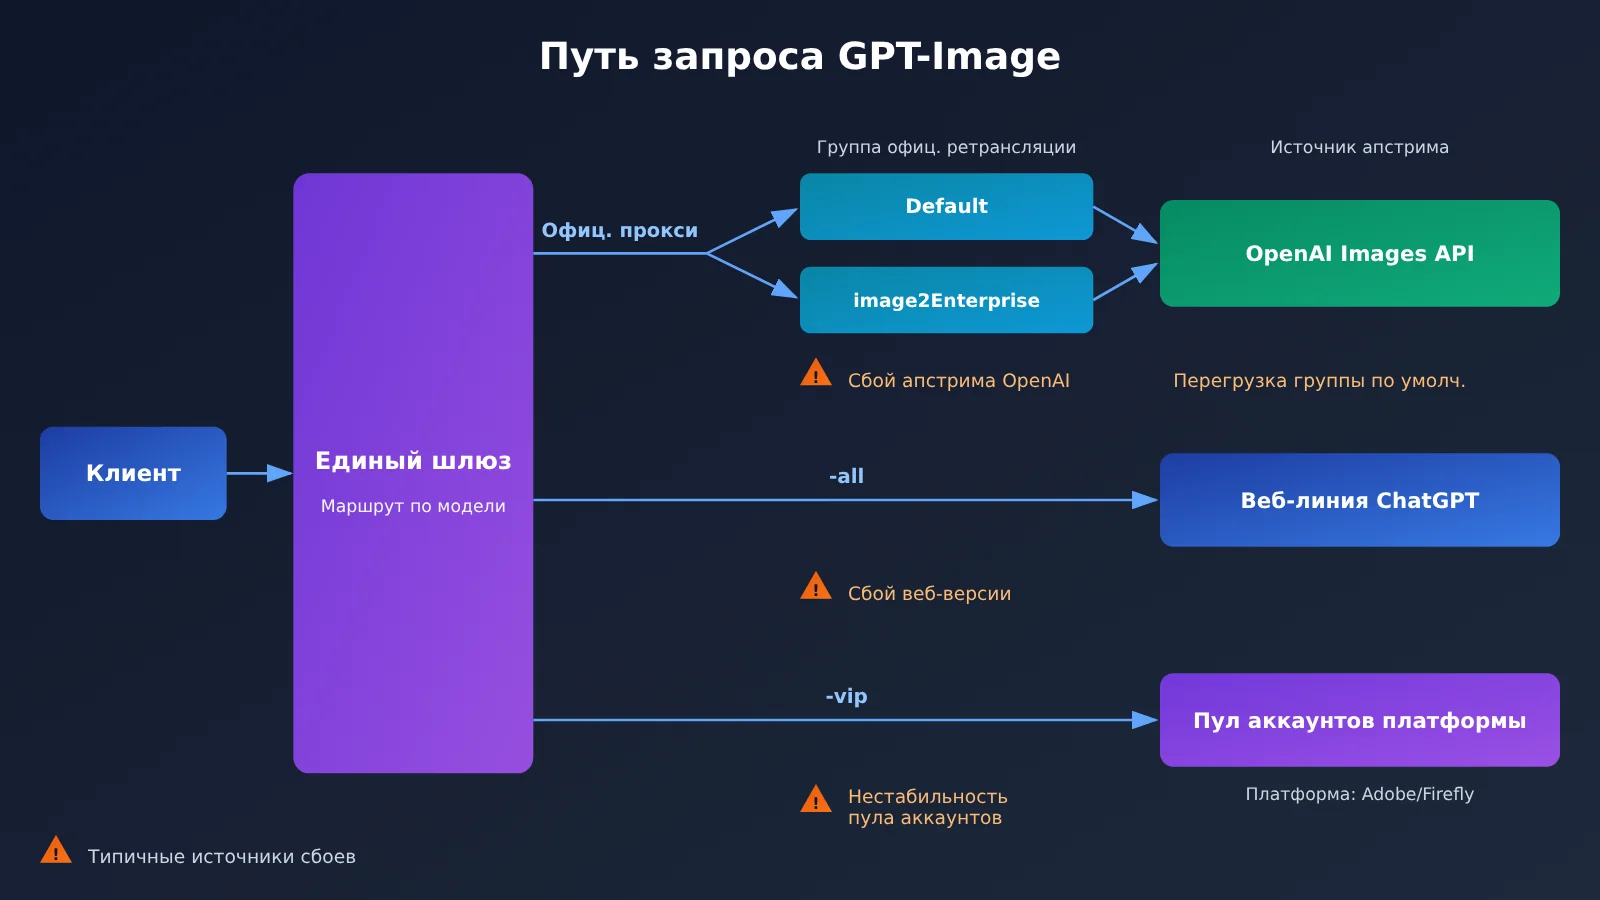
Что такое каналы GPT-Image: официальная пересылка, официальный реверс и корпоративная группа
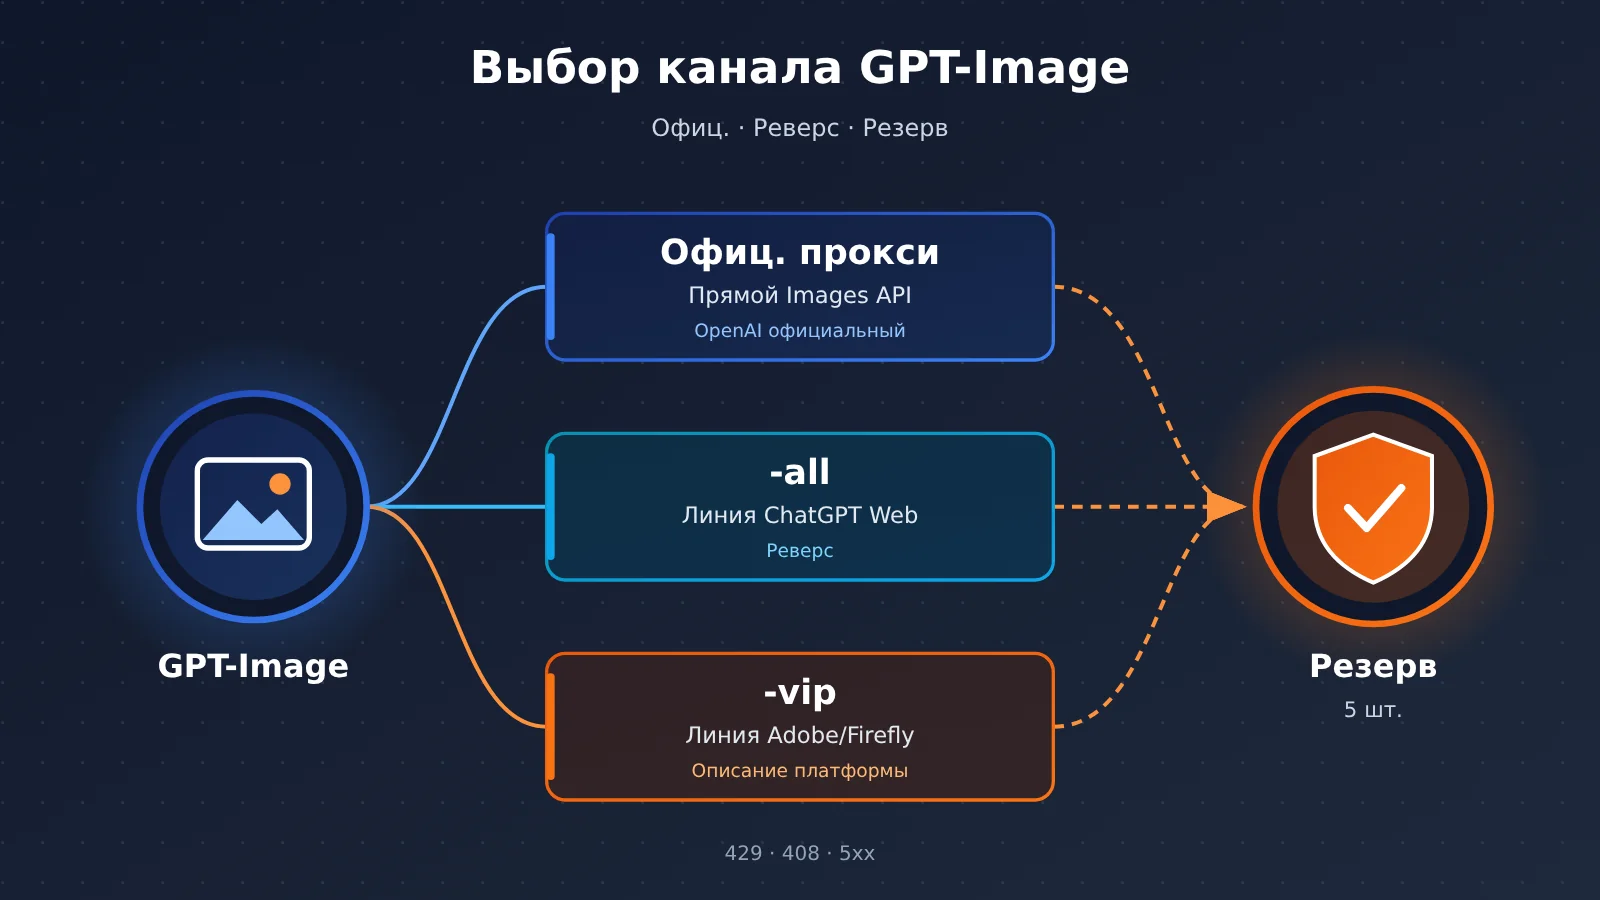
Термины «官转» (официальная пересылка) и «官逆» (официальный реверс) придумали на платформе APIYI, чтобы классифицировать каналы. В терминологии OpenAI их нет. Официальная пересылка — это линия, которая напрямую проксирует запросы к официальному Images API от OpenAI. Официальный реверс — это ресурсы, подключённые неофициальным способом, через обратную разработку (реверс-инжиниринг). Это не значит, что OpenAI сама предоставляет такие API.
| Тип канала | Определение из документации платформы | Типичные модели | Основная зависимость от апстрима |
|---|---|---|---|
| Официальная пересылка (官转) | Прямая пересылка запросов в официальный Images API от OpenAI | gpt-image-2.5-flare, gpt-image-2.5-sunburst | Вычислительные мощности и квоты OpenAI API |
| -all (официальный реверс) | Реверс-доступ к веб-линии ChatGPT | gpt-image-2-all, gpt-image-2.5-all | Доступность веб-версии ChatGPT |
| -vip (официальный реверс) | В документации платформы описан как реверс-ресурс линии Adobe / Firefly | gpt-image-2-vip, gpt-image-2.5-flare-vip, gpt-image-2.5-sunburst-vip | Параллелизм пула аккаунтов платформы и антифрод апстрима |
Корпоративная группа GPT-Image image2Enterprise: зачем она нужна
image2Enterprise часто принимают за отдельную модель, но на самом деле это группа токенов. Её добавили 2026-04-25. Множитель по каталогу у неё 1.2x, а у групп Default, image2_OSS и SVIP — 1.0x. 2026-04-27 и 2026-09-21 ресурсы в группе по умолчанию были на пределе, а корпоративная группа работала стабильно. Поэтому раньше её использовали как запасной путь для официальной пересылки.
У корпоративной группы тоже есть ограничения. 2026-05-07 официальная пересылка в ней так же пострадала от сбоя на стороне OpenAI. Значит, она снижает нагрузку на группу по умолчанию, но не защищает от всех проблем апстрима. Кроме того, если группа указана в реестре моделей, это ещё не значит, что её может использовать любой аккаунт. Условия подключения смотрите в консоли.
GPT-Image 2.6 и границы со старыми каналами
По состоянию на 2026-11-11 в реестре моделей APIYI уже есть две модели с оплатой за токены: gpt-image-2.6-flare и gpt-image-2.6-sunburst. Версий 2.6 с суффиксами -all и -vip в списке нет. Поэтому возможности 2.5 VIP по размерам и качеству нельзя автоматически переносить на 2.6. Ещё один нюанс: на странице сравнения написано, что прямое официальное подключение старой gpt-image-2 закрыли 2026-09-30, но ID этой модели в реестре остался. Для новых проектов в примерах с официальной пересылкой лучше сразу брать 2.5 Flare или Sunburst. Согласно заметкам о запуске на платформе, flare генерирует быстрее, а sunburst лучше справляется с редактированием.
Ключевые различия между GPT-Image 官转, -all и -vip
| Критерий | 官转 (2.5 flare / sunburst) | -all | -vip | Победитель |
|---|---|---|---|---|
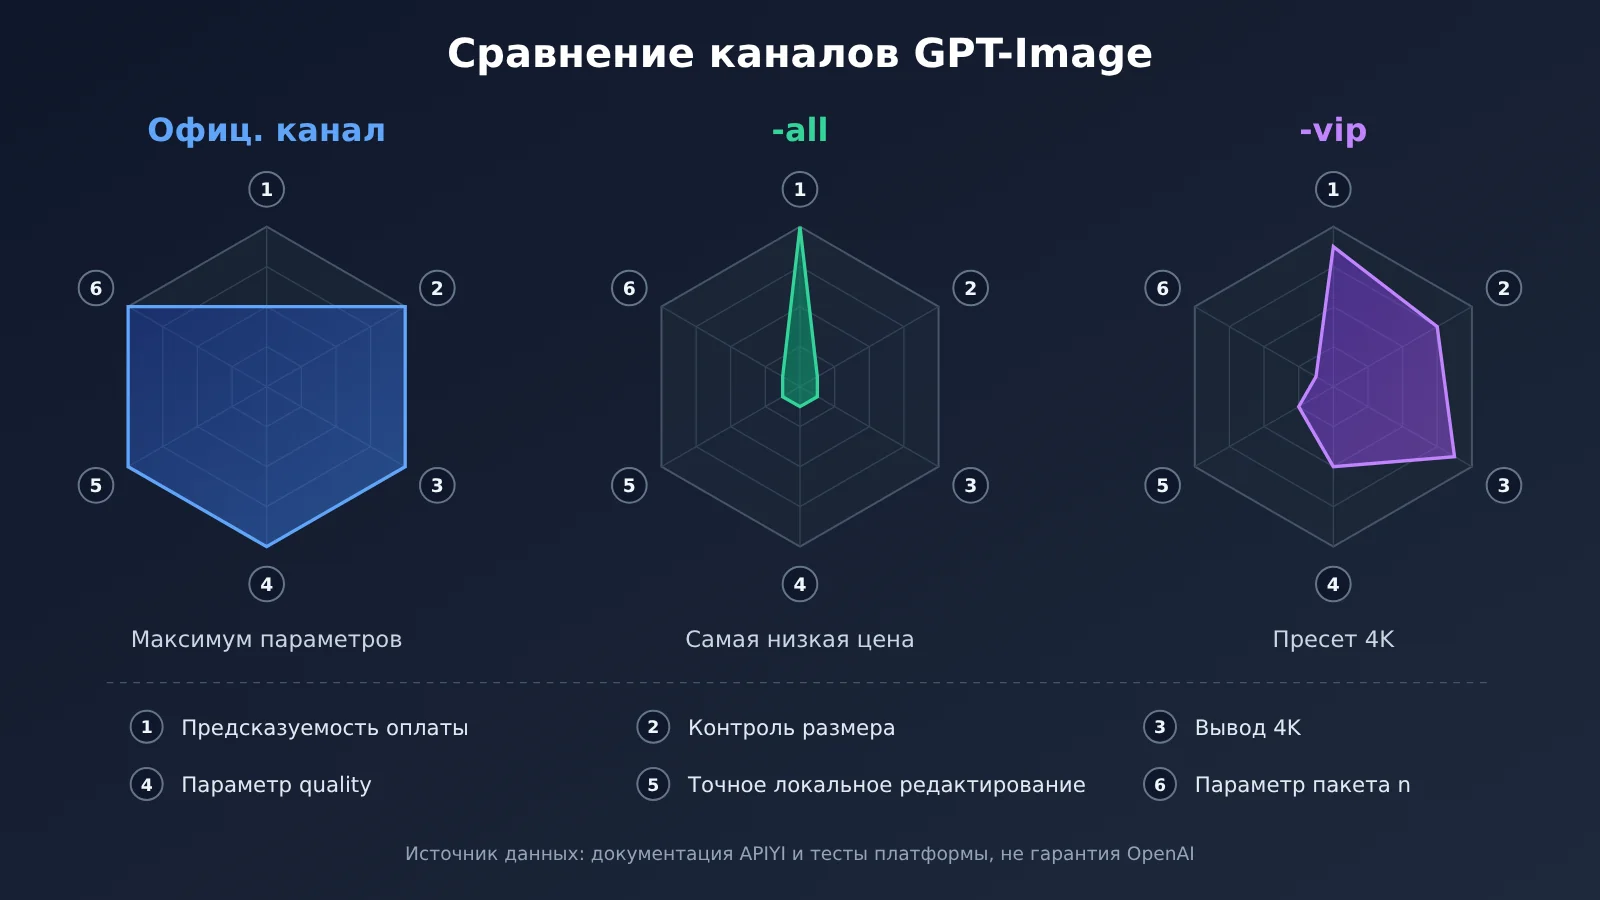
| Биллинг | По токенам, зависит от размера и качества | $0.025 за изображение (с 2026-10-10) | $0.03 за изображение | Предсказуемая стоимость: -all |
| Параметр size | Любой допустимый размер | Не поддерживается | 30 распространённых размеров | 官转 |
| Вывод в 4K | Поддерживается | Не поддерживается | Поддерживаются пресеты 4K | 官转 / -vip |
| Параметр quality | Поддерживаются официальные значения | Не поддерживается | Поведение канала, диапазон зависит от модели | 官转 |
| Генерация нескольких изображений (n) | Поддерживается | Не поддерживается | Не поддерживается | 官转 |
| Точная локальная перерисовка по mask | Поддерживается | Не поддерживается | Не гарантируется, только перерисовка всего изображения | 官转 |
| Типичное применение | Тонкий контроль параметров, точное редактирование | Пакетная генерация по фиксированной цене | Фиксированная цена, пресеты размеров и 4K | — |
Разбор сравнения каналов GPT-Image
官转 (официальный канал): лидирует по полноте параметров — size, quality, n и mask работают так же, как в официальном Images API, поэтому канал подходит для продакшена, где нужен тонкий контроль. Но биллинг идёт по токенам, и стоимость одного изображения растёт с размером и качеством, так что напрямую сравнивать её с ценой за штуку нельзя. Тесты на платформе показали ещё одну деталь: лимит промпта в этом режиме — около 8192 токенов; при превышении ошибки не будет, но изображение получится хаотичным, поэтому длинные промпты приходится обрезать на стороне клиента. Кроме того, функцию прозрачного фона в gpt-image-2 компания OpenAI официально отключила — если нужен прозрачный фон, платформа советует использовать 官转 версии 2.5.
-all: главный плюс — самая низкая и при этом фиксированная цена, что хорошо для массовой генерации, где к композиции нет строгих требований. Параметры size, quality, n и mask не поддерживаются, поэтому при вызове лучше передавать только prompt. Канал опирается на веб-версию ChatGPT, и если веб-версия падает, он страдает вместе с ней.
-vip: промежуточный вариант — платишь за штуку, но получаешь пресеты размеров и 4K. Подходит для сценариев, где нужна и фиксированная стоимость, и высокое разрешение. Поведение его параметров определяется каналом, а не официальными гарантиями. Уровни качества xhigh и max в 2.5 VIP открыты по результатам тестов на платформе, и их нельзя считать возможностью всех «обратных» моделей.
Примечание к сравнению: цены в таблице взяты из каталога платформы APIYI (до бонусов за пополнение и групповых скидок), это не официальный прайс OpenAI за изображение. Итоговую цену смотрите в консоли apiyi.com.
Разбор истории сбоев каналов GPT-Image: почему нельзя делать ставку на одну линию
Если смотреть только на таблицу функций, можно упустить главное: у трёх типов каналов разные источники сбоев и разный темп восстановления. Ниже приведены показательные события из статусных оповещений платформы за период с апреля по октябрь 2026 года. Это исторические записи, а не текущее состояние.
| Дата (2026) | Канал | Симптомы | Комментарий платформы / рекомендация |
|---|---|---|---|
| 23–27 апреля | Официальный прокси, группа по умолчанию | Нехватка параллельных слотов, временные лимиты, ошибки 429 / 408 | Переключиться на image2Enterprise, поднять timeout до 360–600 секунд |
| 7 мая | Официальный прокси, корпоративная группа | Ошибки | Причина на стороне апстрима OpenAI |
| 9 мая | Официальный прокси, группа по умолчанию | Снова перегрузка | Переключить токен на корпоративную группу |
| 16–23 июня | -vip | Параметр size перестал работать, разрешение временами падало до 1.5K и 1K | Сочли изменением правил на стороне апстрима; на короткое время работа восстанавливалась |
| 7–13 июля | -all | Сбой апстрима, таймауты | Трафик временно направляли на канал vip, а за вызовы, завершившиеся таймаутом, потом начислили компенсацию квоты |
| 24–25 августа | -vip | Ограничение скорости из-за риск-контроля апстрима, перегрузка | 429 можно повторять, а ошибки контентной безопасности повторять бессмысленно |
| 10–15 сентября | 2.5 -vip | Ошибки 429, нехватка ресурсов | Официальный прокси и -all в тот же период работали нормально |
| 15 октября | -all / -vip | -all пострадал из-за сбоя веб-версии ChatGPT, -vip был слишком сильно загружен | Если «обратный» официальный канал недоступен, сначала подстраховаться официальным прокси |
| 19 октября | 2.5 -vip | Перегрузка по параллельным запросам | Ресурсы наращиваются |
Типичные сценарии сбоев каналов GPT-Image
Если сложить эти записи вместе, видны четыре характерных сценария:
- Нехватка ресурсов в группе по умолчанию официального прокси. Проявляется ошибками 429 и 408. Корпоративная группа частично помогает, но не защищает от сбоев самого апстрима OpenAI.
- -all повторяет сбои веб-версии. Как только у веб-версии ChatGPT начинаются проблемы, -all сразу же начинает выдавать ошибки или тормозить. По записям платформы время ответа в такие моменты доходило от примерно 40 до примерно 80 секунд.
- Перегрузка пула ресурсов -vip и «плавающие» параметры. Помимо 429 бывало, что size и quality внезапно переставали работать, а потом снова начинали. То есть сама доступность параметров нестабильна.
- Несколько каналов работают одновременно. 10 и 15 сентября, когда -vip был недоступен, официальный прокси и -all работали штатно. Именно в такие моменты подключение по двум каналам и окупается.
Теперь о границах по времени. В архиве на 2026-11-11 последнее оповещение, прямо касающееся состояния каналов GPT-Image, датировано 19 октября. Записи от 5 и 9 ноября посвящены запуску 2.6 и обновлению документации, это не статусные сообщения. Поэтому рейтинга стабильности на сегодняшний день в статье нет, а исторические данные по времени ответа нельзя считать SLA.
Рекомендации по выбору канала GPT-Image
Когда выбирать «официальный» канал (官转)
- Главные картинки для карточек товаров, рекламные баннеры: нужен точный размер или 4K, а качество изображения надо контролировать через параметр quality;
- Локальная перерисовка, замена фона: здесь всё держится на точном редактировании по mask. Канал -vip умеет только перерисовывать изображение целиком, а -all вообще не поддерживает mask;
- У вас уже есть код на OpenAI SDK: у этого канала лучшая совместимость параметров и самая дешёвая миграция.
Когда выбирать -all
- Массовые материалы, быстрые наброски для вдохновения: жёстких требований к размеру нет, а важнее всего фиксированная низкая цена;
- Производство контента при жёстком бюджете: фиксированная цена $0.025 за изображение упрощает подсчёт затрат.
Когда выбирать -vip
- Нужен 4K, но хочется оплаты за запрос: достаточно взять один из готовых размеров, которые предлагает платформа;
- В основном генерация целых изображений, точное локальное редактирование не нужно: вы готовы мириться с тем, что параметры могут «плавать» из-за особенностей канала.
| Бизнес-сценарий | Основной канал | Запасной канал | На что обратить внимание при переключении |
|---|---|---|---|
| Точное локальное редактирование | Официальный sunburst | Официальная корпоративная группа (если есть доступ) | Не переключайтесь на -all / -vip: mask перестанет работать |
| Коммерческие изображения с заданным размером | Официальный flare | -vip с готовыми размерами | Размер для запасного канала нужно сопоставить с одним из 30 готовых вариантов |
| 4K высокого разрешения с фиксированной стоимостью | -vip | Официальный | После переключения оплата пойдёт по токенам |
| Массовая генерация | -all | -vip (тоже оплата за запрос) | Стоимость одного изображения вырастет с $0.025 до $0.03 |
| Нужно n вариантов изображения | Официальный | Несколько вызовов -all в цикле | Реверс-каналы не поддерживают параметр n |
Стратегия подстраховки для канала GPT-Image: повторы, предохранитель и деградация
Надёжная подстраховка — это не «пришла ошибка, значит шлём запрос ещё раз». Сначала надо понять, что за ошибка, и только потом выбирать, что с ней делать.
| Тип ошибки | Частые причины | Повторять? | Что делать |
|---|---|---|---|
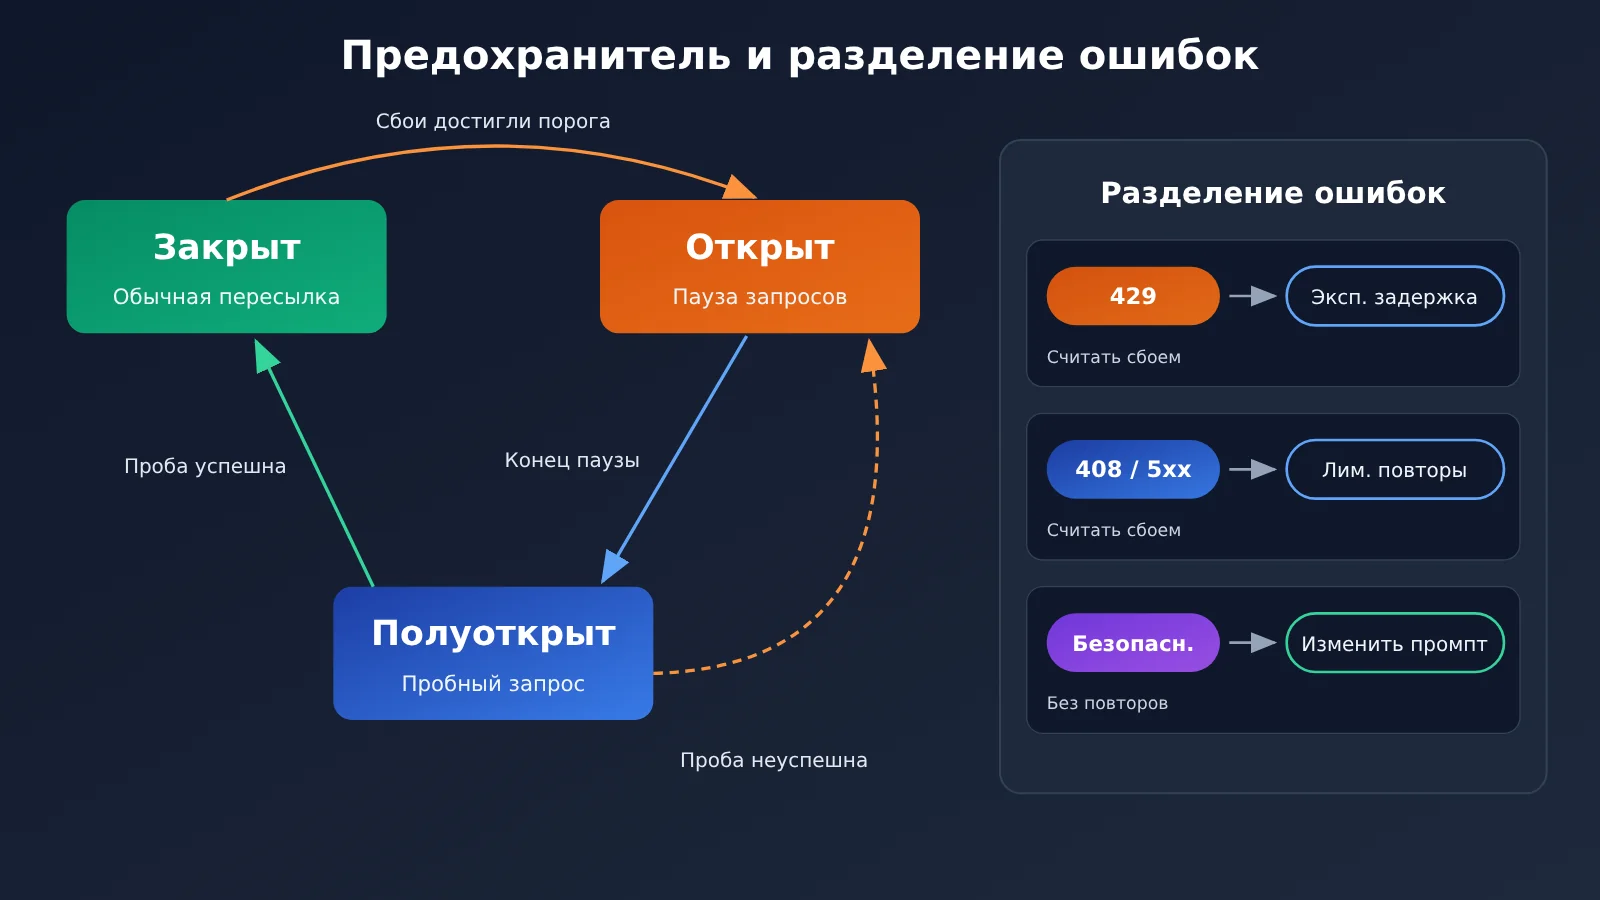
| 429 | Лимит параллельных запросов или скорости, пул ресурсов перегружен | Да, обязательно с задержкой | Экспоненциальная задержка плюс случайный джиттер; после серии неудач — предохранитель и переключение канала |
| 408 / таймаут на клиенте | Вышестоящий сервис медленно отдаёт картинку, timeout выставлен слишком маленьким | Ограниченное число повторов | Поднять таймаут официального релея до 360–600 секунд, повторить не более 2 раз |
| Системные ошибки 5xx | Сбой платформы или вышестоящего сервиса | Ограниченное число повторов | До 2 повторов с экспоненциальной задержкой; не помогло — переключаемся на резервный канал |
| Ошибка контентной безопасности | Промпт или входное изображение не прошли модерацию | Нет | Сначала поправить содержимое и только потом обращаться снова; повтор того же запроса в лоб просто сожжёт квоту |
| Долго не восстанавливается | Массовый сбой у вышестоящего сервиса | Нет | Разомкнуть текущий канал предохранителем и уйти на резервный, прошедший проверку работоспособности |
Тут есть две грабли, на которые легко наступить. Первая: платформа поясняла, что 500, который возвращает -all, обычно означает нарушение правил контента (и не тарифицируется), а с мая безопасностные 500 у -all/-vip отдаются напрямую, без внутренних повторов. Значит, клиент обязан читать текст ошибки и не переотправлять запрос при каждом 5xx. Вторая: у -vip встречалась ошибка Unknown error, и по опыту платформы лечится это сжатием отдельного входного изображения до 1,5 МБ.
Минимальный пример
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
    timeout=600,  # Генерация через официальный канал идёт медленно, платформа рекомендовала 360–600 секунд
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    prompt="一只在咖啡馆窗边看书的橘猫,柔和晨光,写实摄影风格",
    size="1536x1024",
)
item = resp.data[0]
print(item.b64_json[:60] if item.b64_json else item.url)
Показать полный код: повторные попытки по нескольким каналам + circuit breaker + деградация
import time
import random
import logging
import openai
from openai import OpenAI

logging.basicConfig(level=logging.INFO)
BASE_URL = "https://api.apiyi.com/v1"

# Каналы расположены по приоритету; для разных групп используются разные токены
CHANNELS = [
    {"name": "official", "model": "gpt-image-2.5-flare",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024", "quality": "high"}},
    # Включайте, только если у аккаунта есть доступ к группе image2Enterprise
    {"name": "official-enterprise", "model": "gpt-image-2.5-flare",
     "key": "KEY_ENTERPRISE", "params": {"size": "1536x1024", "quality": "high"}},
    # Для -vip значение size нужно заменить на один из 30 пресетов из документации
    {"name": "vip", "model": "gpt-image-2.5-flare-vip",
     "key": "KEY_DEFAULT", "params": {"size": "1536x1024"}},
    # -all не поддерживает size / quality / n, передаём только prompt
    {"name": "all", "model": "gpt-image-2.5-all",
     "key": "KEY_DEFAULT", "params": {}},
]

FAIL_THRESHOLD = 3     # Сколько неудач подряд до срабатывания предохранителя (пример значения)
COOLDOWN = 120         # Время охлаждения предохранителя в секундах (пример значения)
MAX_RETRY = 2          # При 5xx / таймауте — максимум 2 повтора
breaker = {c["name"]: {"fails": 0, "open_until": 0} for c in CHANNELS}


def classify(err: Exception) -> str:
    msg = str(err).lower()
    if any(k in msg for k in ("safety", "content_policy", "moderation", "violat")):
        return "content"
    if isinstance(err, openai.RateLimitError):
        return "rate_limit"
    if isinstance(err, openai.APITimeoutError):
        return "timeout"
    if isinstance(err, openai.APIStatusError):
        if err.status_code == 408:
            return "timeout"
        if err.status_code >= 500:
            return "server"
        return "fatal"
    if isinstance(err, openai.APIConnectionError):
        return "network"
    return "fatal"


def generate(prompt: str, need_mask: bool = False):
    for ch in CHANNELS:
        if need_mask and ch["name"] in ("vip", "all"):
            continue  # Точное редактирование не переключаем на реверс-каналы
        state = breaker[ch["name"]]
        if time.time() < state["open_until"]:
            continue  # Канал отключён предохранителем
        client = OpenAI(api_key=ch["key"], base_url=BASE_URL, timeout=600)
        for attempt in range(MAX_RETRY + 1):
            try:
                resp = client.images.generate(
                    model=ch["model"], prompt=prompt, **ch["params"])
                state["fails"] = 0
                logging.info("ok channel=%s model=%s", ch["name"], ch["model"])
                return ch["name"], resp.data[0]
            except Exception as e:
                kind = classify(e)
                logging.warning("fail channel=%s model=%s kind=%s req_id=%s",
                                ch["name"], ch["model"], kind,
                                getattr(e, "request_id", None))
                if kind in ("content", "fatal"):
                    raise  # Проблема в контенте или параметрах: меняем запрос, без повторов
                if attempt < MAX_RETRY:
                    time.sleep(2 ** (attempt + 1) + random.uniform(0, 1))
        state["fails"] += 1
        if state["fails"] >= FAIL_THRESHOLD:
            state["open_until"] = time.time() + COOLDOWN
    raise RuntimeError("所有 GPT-Image 通道均不可用")
🚀 Быстрый старт: сначала возьмите бесплатные тестовые кредиты для новых пользователей на APIYI (apiyi.com) и проведите A/B-проверку каналов: официального, -vip и -all. Используйте один и тот же промпт и одинаковый размер, фиксируйте время ответа, долю успешных запросов и различия в картинке, а уже потом определяйте порядок основного и резервных каналов.
Рекомендации по выбору канала GPT-Image
Если запомнить только один принцип, пусть будет такой: основной канал выбирайте по жёстким требованиям бизнеса, а резервный — по тому, откуда берутся сбои. Если вам нужно точное редактирование через mask, резервировать можно только внутри официального канала, например, связкой «группа по умолчанию + корпоративная группа». Если достаточно генерации целого изображения, можно скомбинировать «официальный канал + -vip» или «-all + -vip»: две линии с разными источниками сбоев подстрахуют друг друга. Кроме того, в каждом запросе стоит логировать фактически использованную модель, канал и request_id — это пригодится и для сверки, и для разбора инцидентов.
💡 Совет по выбору: качество каналов меняется вместе с ресурсами у апстрима, и стабильность в прошлом не гарантирует стабильность в будущем. Мы рекомендуем подключить через единый интерфейс APIYI (apiyi.com) сразу как минимум два канала и периодически гонять по ним небольшой трафик для проверки работоспособности, а не выбирать один раз по результатам единичного теста и годами с ним жить.
Часто задаваемые вопросы (FAQ)
Q1: Что такое «официальный прокси» (官转) и «официальный реверс» (官逆) у GPT-Image?
«Официальный прокси» (官转) — это линия, которая напрямую пересылает запросы в официальный Images API от OpenAI. «Официальный реверс» (官逆) — это то, как платформа классифицирует ресурсы, подключённые через реверс-инжиниринг. Сюда относятся -all, работающий через веб-линию ChatGPT, и -vip, который в документации платформы описан как линия Adobe/Firefly. Официальным API от OpenAI «официальный реверс» не является.
Q2: Чем GPT-Image -all отличается от -vip?
Оба варианта тарифицируются за запрос. -all стоит $0.025 за изображение и не поддерживает size, quality и 4K. -vip стоит $0.03 за изображение и поддерживает 30 предустановленных размеров и предустановленный 4K. Но поведение параметров зависит от канала: раньше бывало, что size переставал работать, а потом снова начинал.
Q3: У GPT-Image 2.6 тоже есть -all и -vip?
В реестре моделей на 2026-11-11 указаны только две модели с оплатой по токенам: gpt-image-2.6-flare и gpt-image-2.6-sunburst. Вариантов 2.6 с -all или -vip там нет. Не стоит переносить возможности 2.5 VIP на 2.6.
Q4: Гарантирует ли корпоративная группа image2Enterprise отсутствие сбоев?
Нет. Когда группа по умолчанию была перегружена, она не раз работала стабильно, но 2026-05-07 её тоже задел сбой на стороне OpenAI. Её множитель — 1.2x, а доступ к ней нужно уточнять в консоли. Она подходит как резерв внутри официального прокси, но не как универсальная страховка.
Q5: Как быстро протестировать несколько каналов GPT-Image через API?
1. Зарегистрируйте аккаунт на APIYI (apiyi.com) и получите API-ключ и бесплатный тестовый лимит.
2. Укажите base_url `https://api.apiyi.com/v1` и меняйте параметр model, как показано в коде из статьи.
3. Вызовите каждый канал с одним и тем же промптом и запишите время ответа, долю успешных запросов и качество изображения.
При едином интерфейсе для смены канала достаточно поменять название модели. Не нужно держать отдельный SDK под каждый upstream.
Q6: Нужно ли повторять запрос, пока не пройдёт, если пришла ошибка 5xx?
Нет. Документация платформы советует при 5xx и таймаутах делать не более 2 повторов с экспоненциальной задержкой. Ошибка 500 у -all обычно связана с нарушением правил по контенту, и повтор не поможет. Когда лимит повторов исчерпан, нужно отключить текущий канал (circuit breaker) и переключиться на резервный.
Q7: Какие известные ограничения есть у каналов GPT-Image?
— Если промпт в официальном прокси превышает примерно 8192 токена, ошибки не будет, но изображение получится хаотичным.
— Прозрачный фон в gpt-image-2 официально отключён. Если он нужен, используйте официальный прокси 2.5.
— Реверс-каналы не поддерживают параметр n и точные маски.
— Для -vip входные изображения лучше сжимать до 1.5 МБ.
GPT-Image: как выбрать канал. Главное Key Takeaways
- Три типа каналов: официальный ретранслятор («官转») работает через официальный Images API, канал
-allзависит от веб-версии ChatGPT, а-vip— от пула аккаунтов платформы; - Различия в параметрах: только официальный ретранслятор полностью поддерживает произвольный size, n и точное редактирование по маске;
- Различия в тарификации: официальный ретранслятор тарифицируется по токенам,
-allстоит $0.025 за изображение,-vip— $0.03; - Корпоративная группа: image2Enterprise — это группа токенов с коэффициентом 1.2x, а не отдельная модель;
- Закономерности сбоев: у каждого канала источник сбоев свой, и в прошлом нередко бывало так, что один канал падал, а другой работал нормально;
- Принципы повторных попыток: при 429 — повтор с отступом (backoff), при 5xx и таймаутах — не более 2 повторов, ошибки контент-безопасности не повторяем;
- Как начать: подключите оба канала через единый интерфейс APIYI и определите порядок основного и резервного каналов с помощью A/B-проверки.
Итоги
Главное, что нужно знать при выборе канала GPT-Image:
- Основной канал выбирайте по жёстким ограничениям: если нужны точное редактирование и произвольные размеры — берите официальный ретранслятор; если нужна фиксированная низкая цена —
-all; если нужен 4K с оплатой за запрос —-vip; - Резервный канал выбирайте по источнику сбоев: у основной и резервной линий апстрим-зависимости не должны пересекаться. Любой одиночный канал рано или поздно столкнётся с нехваткой ресурсов или сбоем у апстрима;
- Подстраховывайтесь с учётом типа ошибки: нужны все четыре меры — ограниченные повторы, экспоненциальный backoff, circuit breaker с периодом охлаждения и логирование.
История инцидентов показывает: ни один канал GPT-Image не гарантирует нулевых сбоев в долгосрочной перспективе. Надёжность даёт продуманная архитектура, а не ставка на одну-единственную линию. Рекомендуем подключить несколько каналов через APIYI (apiyi.com) с одним и тем же ключом, сначала прогнать небольшой трафик для сравнения, а затем уже определить схему основного и резервного каналов.
📚 Справочные материалы
- Архив оперативных обновлений APIYI: исторические сводки о состоянии каналов GPT-Image, изменениях цен и обновлениях документации.
- Ссылка:
docs.apiyi.com/live/archive -
Пояснение: источник хронологии для этого разбора инцидента; актуальное состояние смотрите в последней сводке.
-
Реестр моделей APIYI: ID моделей, тип тарификации, видимые группы и множители групп.
- Ссылка:
docs.apiyi.com/model-registry.json -
Пояснение: данные, на которые ссылается статья, сформированы 2026-11-11; цены — каталожные, до скидки.
-
Страница статуса OpenAI: официальный статус сервисов OpenAI.
- Ссылка:
status.openai.com - Пояснение: платформа рекомендовала следить за этой страницей, чтобы понять, идёт ли сбой официального канала от апстрима.
Автор: техническая команда APIYI
Технические вопросы: пишите нам через главную страницу сайта APIYI; больше материалов по подключению GPT-Image — в центре документации docs.apiyi.com